Wprowadzenie
Reference-to-video w Kling O3 obsadza ujęcie z do 7 zdjęć referencyjnych – postaci, strojów, przedmiotów lub miejsc – zamiast pojedynczej klatki początkowej. Ponumeruj referencje w prompcie (<<<image_1>>>, <<<image_2>>> i tak dalej) i powiedz, co wnosi każda z nich; pole prompt przyjmuje do 2500 znaków. Wybierz długość od 3 do 15 pełnych sekund, rozdzielczość do 4K, proporcje obrazu oraz to, czy generować natywny dźwięk.
Wybierz tryb Kling O3 według materiału startowego
| Co masz na starcie | Tryb |
|---|---|
| pisaną scenę i nic więcej | Kling O3 – tekst na wideo |
| zatwierdzoną klatkę początkową | Kling O3 – obraz na wideo |
| do 7 zdjęć referencyjnych | Kling O3 – reference-to-video |
| wideo, które już masz | Kling O3 – video-edit |
Najważniejsze funkcje
Wiele referencji, jedno ujęcie
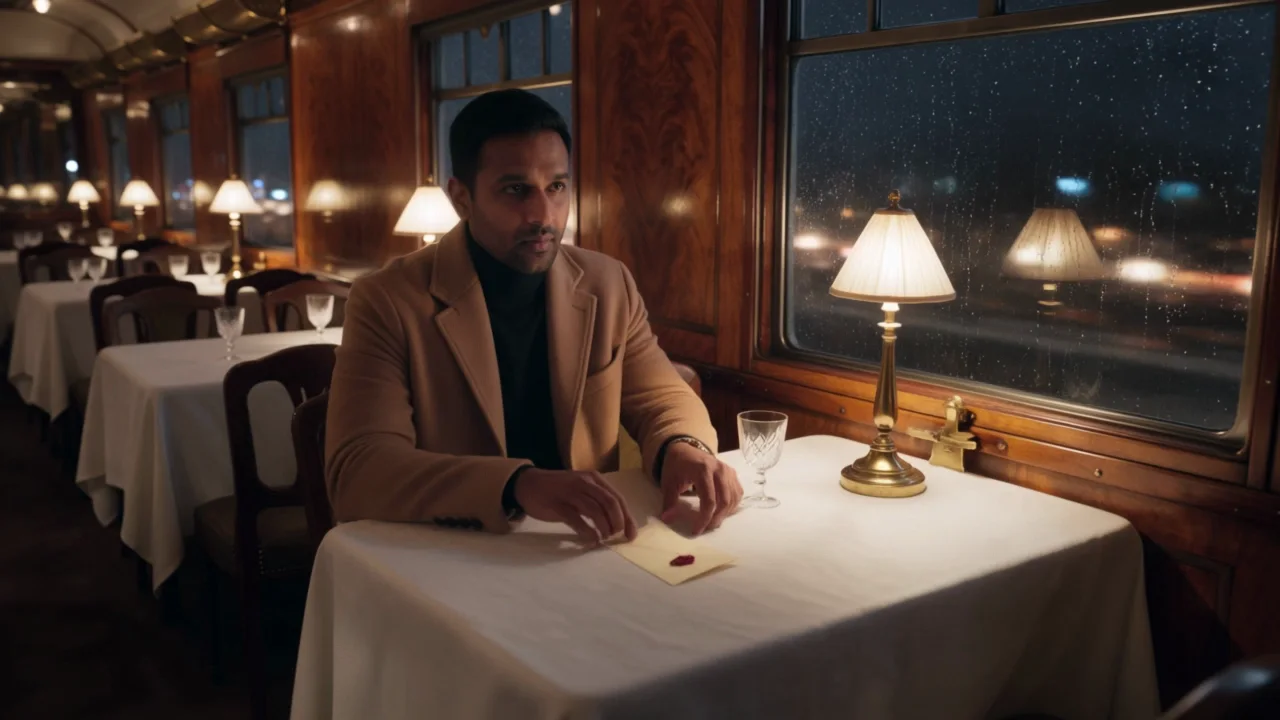
W przeciwieństwie do obrazu na wideo, który zaczyna się od jednej klatki, reference-to-video bierze do 7 osobnych zdjęć i łączy to, co pokazuje każde z nich. Nasz przykład z wagonem restauracyjnym użył trzech: mężczyzny, pomieszczenia i przedmiotu, obsadzonych razem w scenie, której żadne z trzech zdjęć nie przedstawiało samodzielnie.
Każda referencja ma jedno zadanie
Prompt to miejsce, gdzie przydzielasz zadanie: "<<<image_1>>> to mężczyzna, zachowaj jego płaszcz i zarost" to to, co utrzymuje tę twarz i strój nienaruszone, zamiast model uśredniał je z innymi referencjami.
Dźwięk generowany razem z obsadzoną sceną
generate_audio dodaje tło, efekty i dialog w tym samym przebiegu. Zachowaj realistyczne oczekiwania wobec dźwięku tła opisanego tylko w jednym lub dwóch słowach – może wybrzmieć cicho w finalnym miksie, a nie jako dominująca warstwa.
Parametry żądania
| Parametr | Wymagane | Uwaga |
|---|---|---|
prompt | Tak | Powiedz, czym jest każda ponumerowana referencja (<<< |
reference_image_urls | Tak | Do 7 zdjęć referencyjnych dla postaci, przedmiotów, strojów lub miejsc. JPEG lub PNG. od 1 elementów · do 7 elementów |
reference_video_urls | Nie | Opcjonalne wideo referencyjne, jeden klip, z którego nowe ujęcie przejmuje ruch, pracę kamery lub postacie; w prompcie odwołuj się do niego jako <<< |
elements | Nie | Jeden nazwany obiekt do przebiegów w 4K: nadaj mu nazwę, jednozdaniowy opis i 2 do 4 zdjęć tej samej osoby lub rzeczy (próbki głosu od 5 do 30 sekund są opcjonalne), a potem wpi… do 1 elementów |
aspect_ratio | Nie | 16:9, 9:16 lub 1:1. Wybierz przed napisaniem ujęcia, by kompozycja pasowała. |
resolution | Nie | 720p, 1080p lub 4K. Wyższe poziomy kosztują więcej za sekundę. |
generate_audio | Nie | Dodaje generowaną ścieżkę dźwiękową w tym samym przebiegu – dialog w cudzysłowie, efekty, tło. Domyślnie: |
keep_original_audio | Nie | Zachowuje w wyniku oryginalny dźwięk wideo referencyjnego. Domyślnie włączone; ma znaczenie tylko wtedy, gdy podasz wideo referencyjne. Domyślnie: |
duration_seconds | Nie | Pełne sekundy, od 3 do 15. Determinuje cenę razem z rozdzielczością i dźwiękiem. |
shot_type | Nie | single prosi o jedno ciągłe ujęcie (nie jest to twarda gwarancja). multi pozwala modelowi samodzielnie podzielić scenę na kilka ujęć. |
multi_prompt | Nie | Lista ujęć dla |
Cennik
Rozliczane za sekundę wyjścia. Stawka zależy od rozdzielczości, tego, czy natywny dźwięk jest włączony, i tego, czy podasz wideo referencyjne.
| Specyfikacja | Cena |
|---|---|
| $0.0672 / sekundę |
| $0.0896 / sekundę |
| $0.419 / sekundę |
| $0.0896 / sekundę |
| $0.112 / sekundę |
| $0.419 / sekundę |
| $0.1008 / sekundę |
| $0.1344 / sekundę |
Zastosowania
Umieść osobę w miejscu, w którym nigdy nie została sfotografowana
Daj twarzy jej własną referencję, a lokalizacji jej własną, i opisz akcję, która je łączy – rodzaj ujęcia, którego żadne z osobna zdjęcie nie mogłoby dostarczyć.
Utrzymaj rekwizyt lub strój spójny między ujęciami
Odwołaj się do konkretnego przedmiotu – biżuterii, samochodu, charakterystycznego stroju – obok referencji postaci, a powróci on poprawnie zamiast być za każdym razem rysowany nieco inaczej.
Zbuduj scenę wokół trzech zaplanowanych elementów
Gdy ujęcie zależy od konkretnej osoby, konkretnej scenerii i konkretnego przedmiotu pojawiających się razem – jak list, pokój i jego czytelnik – referencje pozwalają zablokować całą trójkę, zamiast opisywać je od zera prozą.
Wskazówki
Ponumeruj każdą referencję i nazwij jej zadanie
Napisz "<<<image_1>>> to X, zachowaj Y" dla każdej referencji po kolei. To pojedynczy najważniejszy czynnik decydujący o tym, czy referencja przeniesie się czysto, czy zleje się z innymi.
Użyj trzech lub czterech wyraźnych zdjęć zamiast siedmiu nakładających się
Więcej referencji nie jest automatycznie lepsze. Garść wyraźnych, odrębnych zdjęć – jedno na twarz, jedno na strój, jedno na pokój – utrzymuje tożsamość lepiej niż siedem zdjęć, które nakładają się w tym, co pokazują.
Opisuj dźwięk jako warstwę tła
Gdy prosisz o tło, takie jak deszcz czy koła pociągu, obok dialogu, spodziewaj się, że usiądzie nisko w miksie. Jeśli tło musi być wyraźne, powiedz to wprost, zamiast wymieniać je krótko obok dialogu.
Szybki start z API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "kling/o3/reference-to-video",
  "input": {
    "aspect_ratio": "16:9",
    "duration_seconds": 5,
    "generate_audio": false,
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "reference_image_urls": [
      "https://example.com/reference.png"
    ],
    "resolution": "720p",
    "shot_type": "single"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Uwierzytelnianie, pełny schemat, odpytywanie i obsługę błędów opisuje dokumentacja API.