Introdução
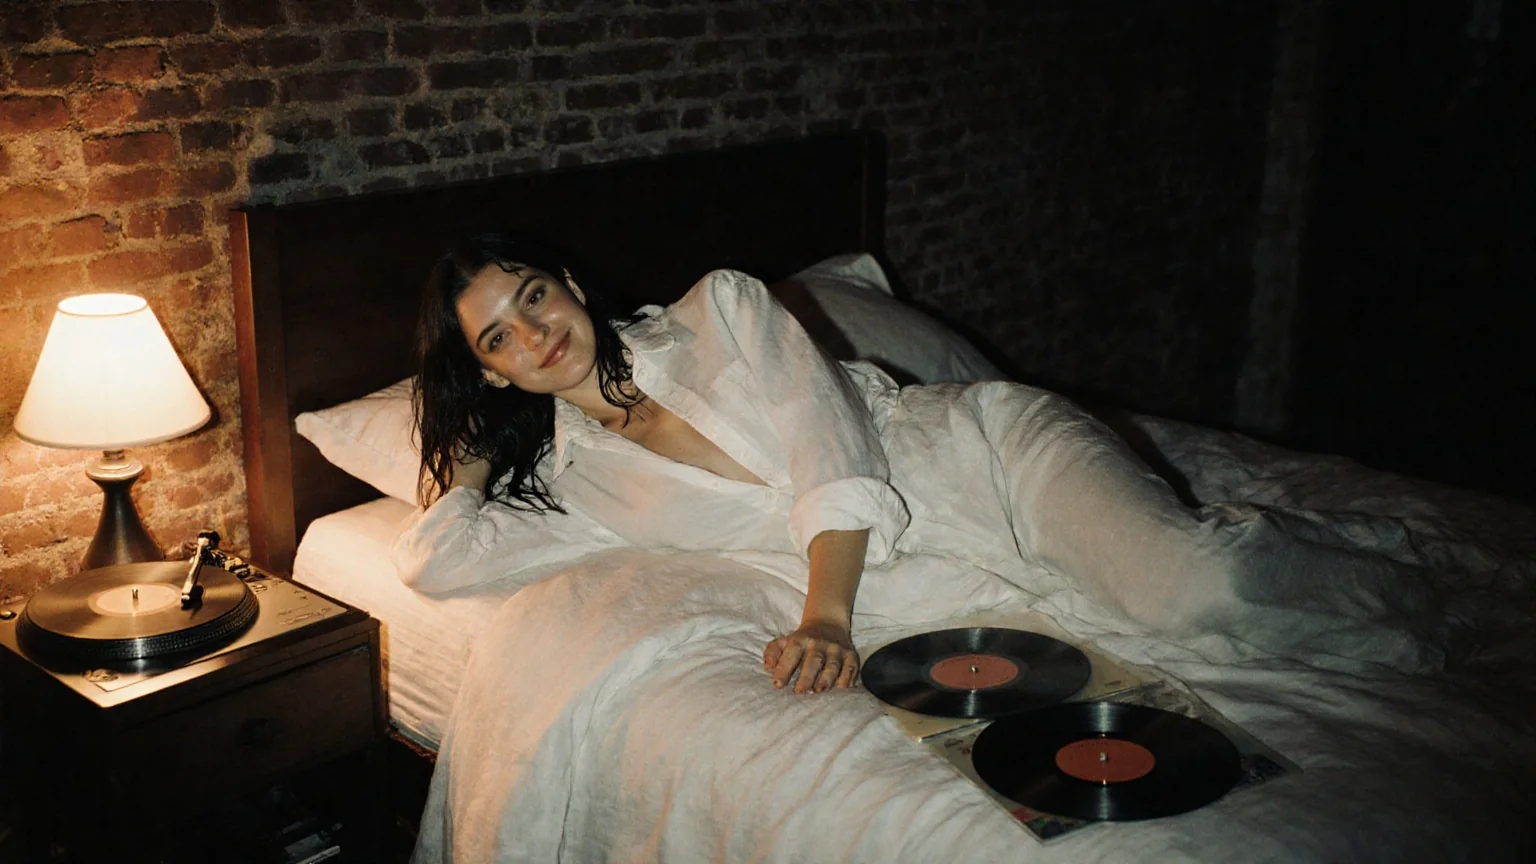
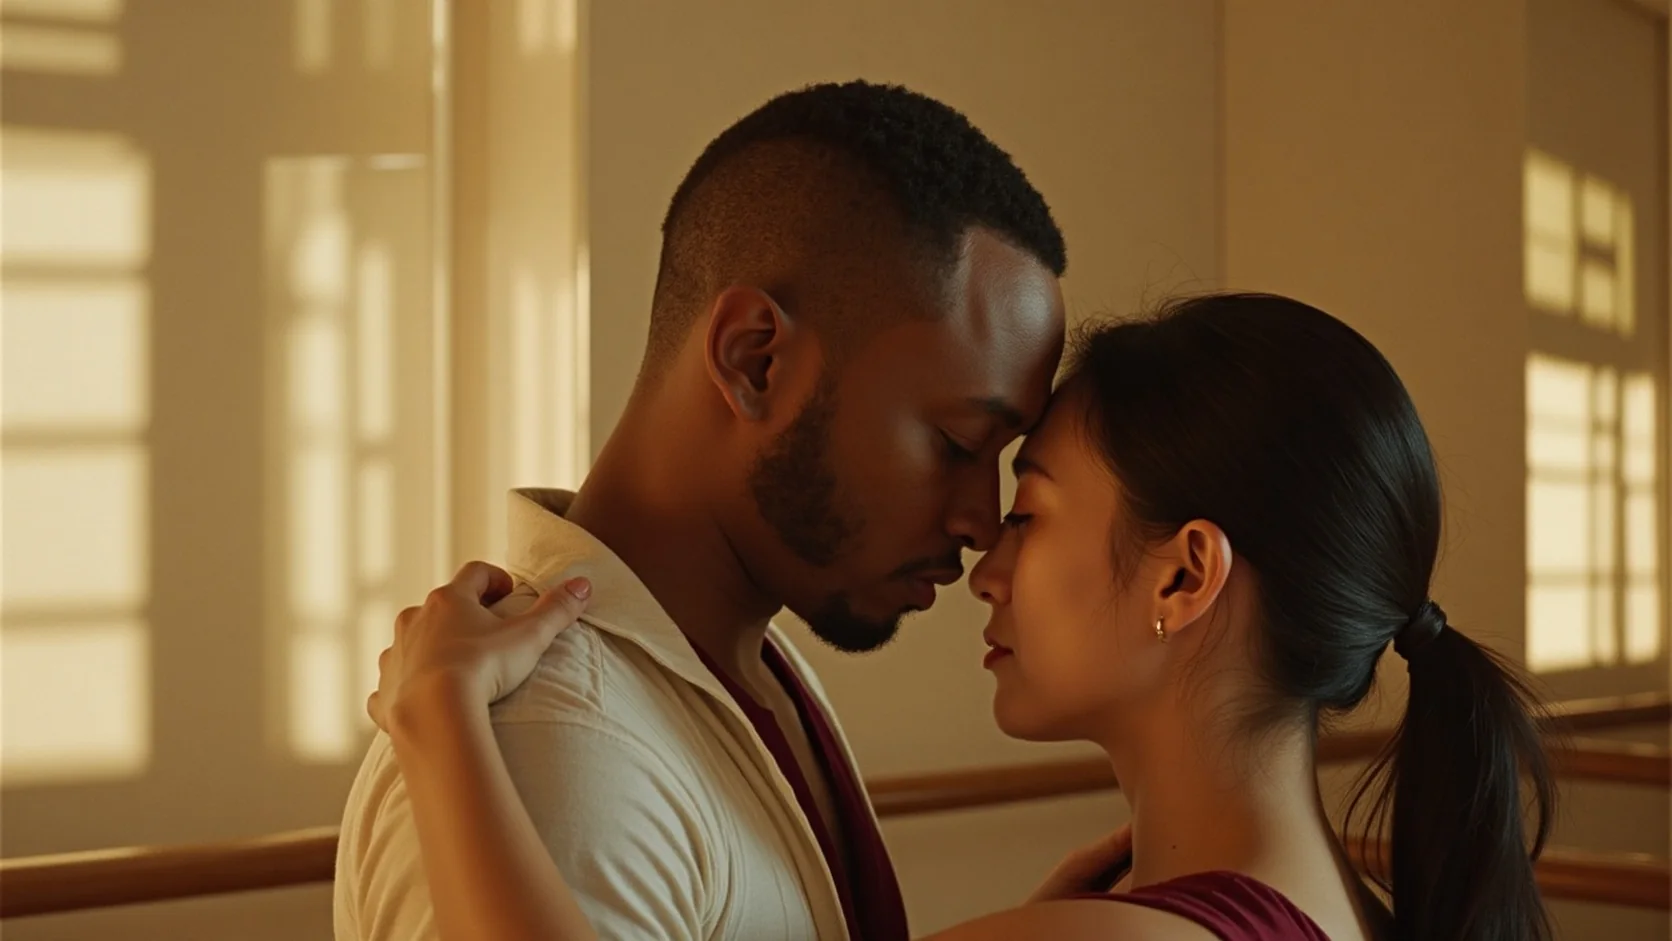
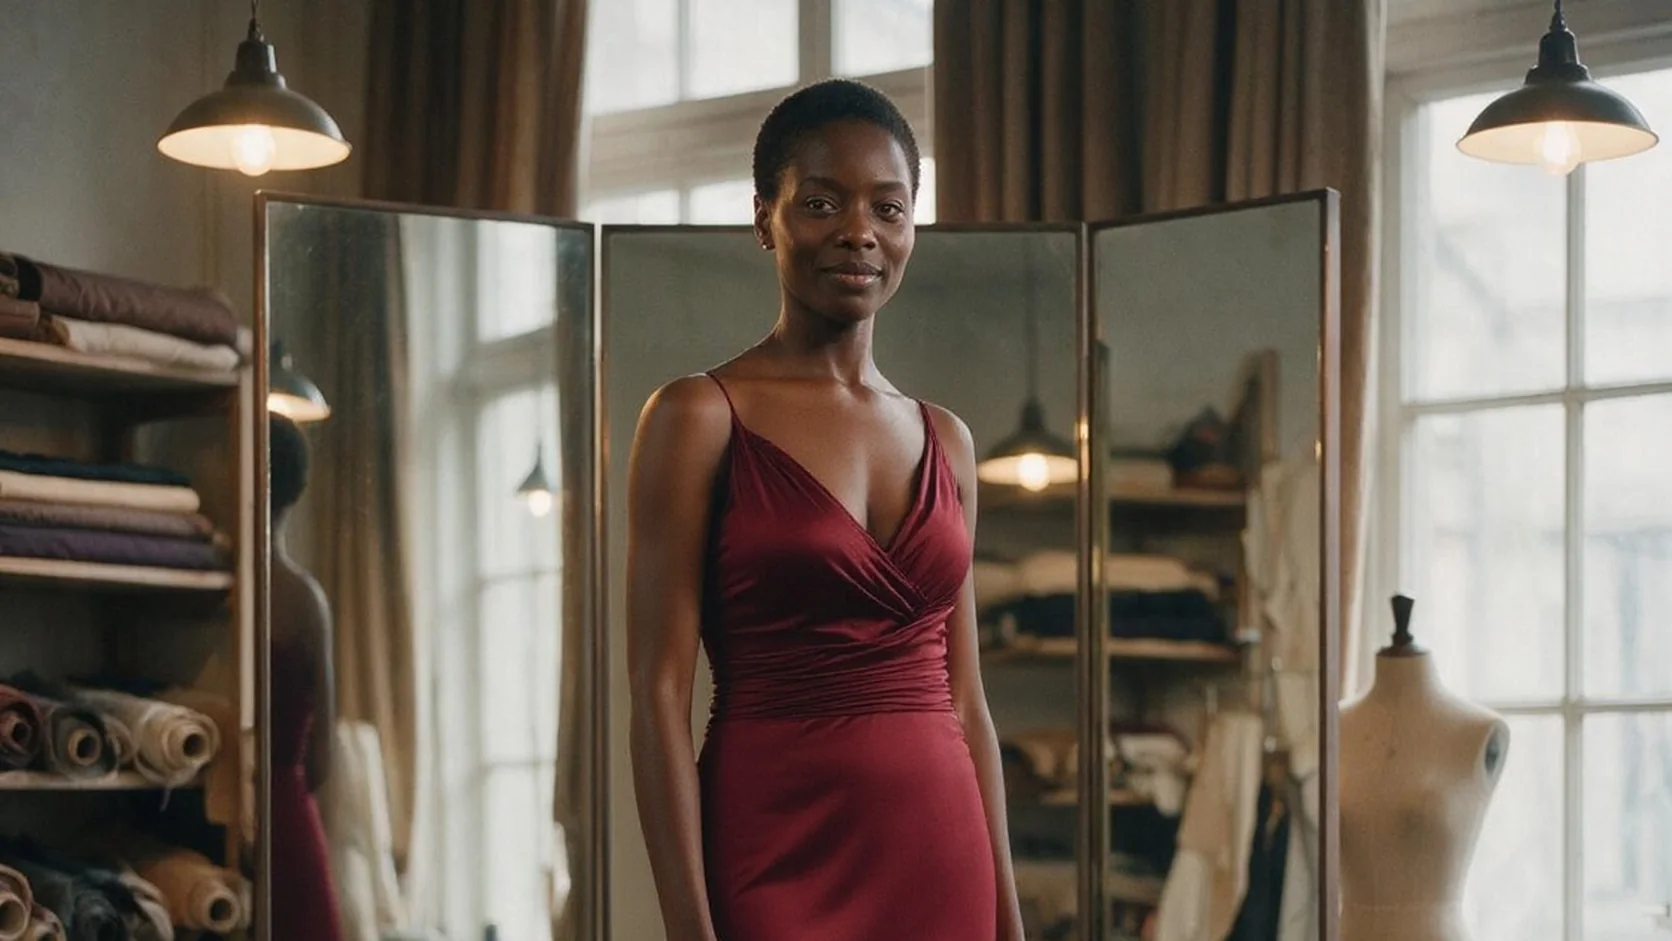
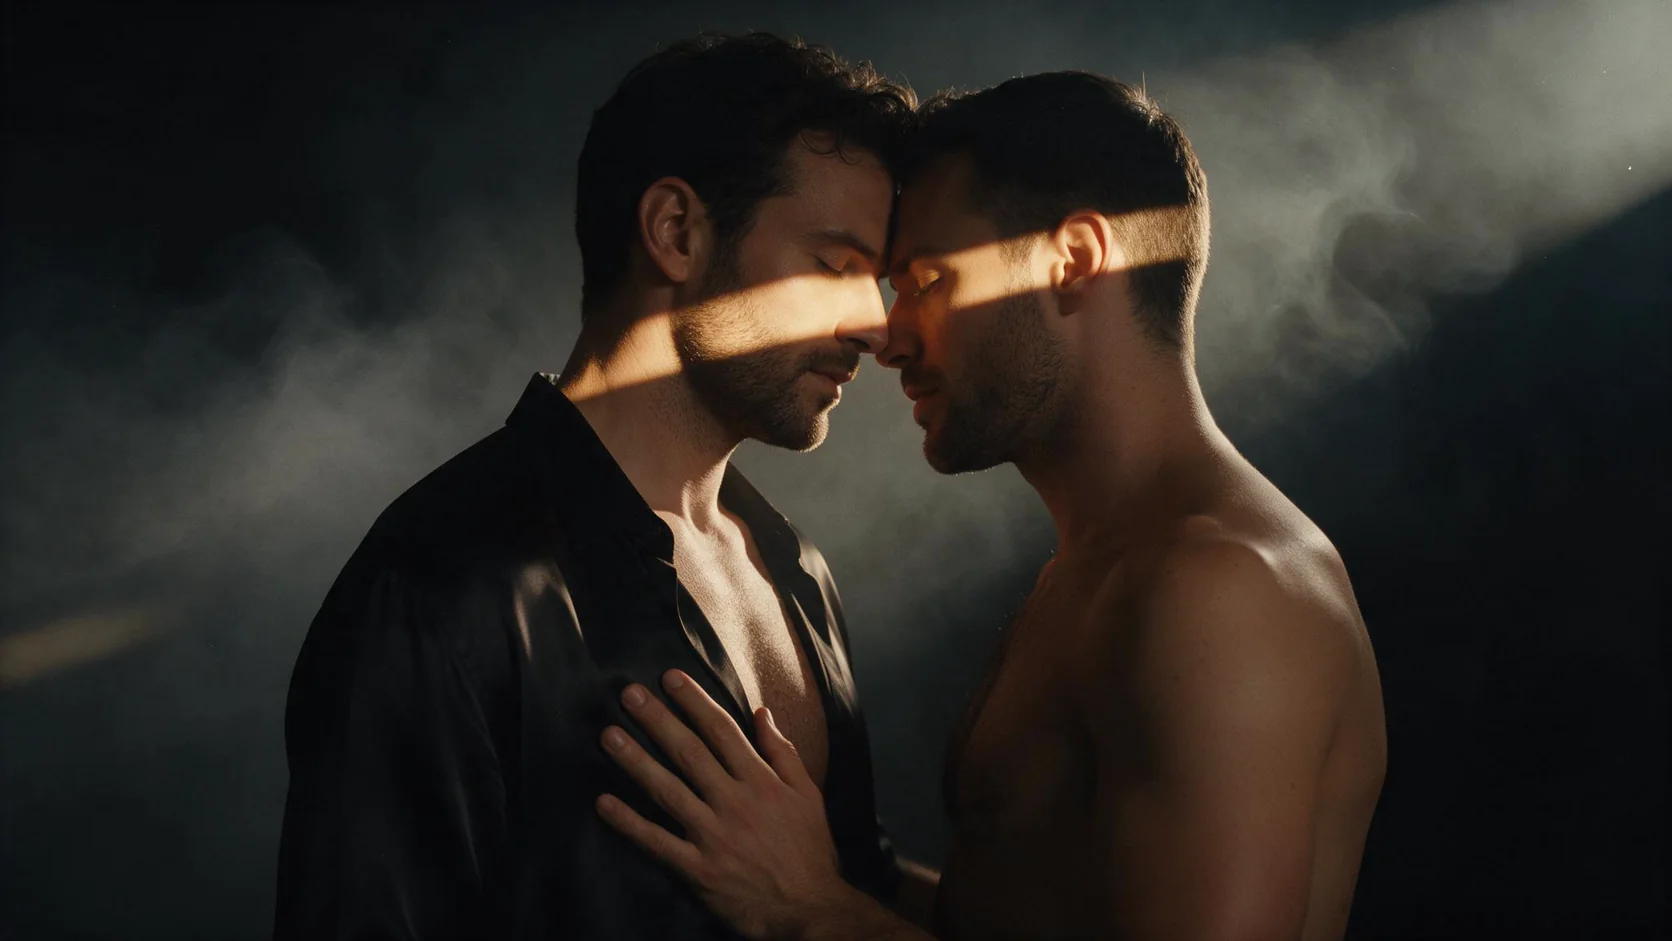
FLUX.2 Klein 9B LoRA Texto para imagem cria uma imagem a partir de um prompt escrito no FLUX.2 [klein] 9B da Black Forest Labs, o modelo de 9 bilhões de parâmetros destilado em poucos passos, com até três arquivos LoRA seus carregados por links diretos. Escolha uma das nove proporções em 1k ou 2k e receba um JPEG, na maioria das vezes em cerca de dez segundos de tempo de modelo. A plataforma não acrescenta nenhum filtro de conteúdo ao prompt, aos pesos nem à imagem, e o preço por imagem é fixo.
Escolha o modo pelo material de partida
| O que você tem | Modo |
|---|---|
| uma descrição escrita e um LoRA | FLUX.2 Klein 9B LoRA Texto para imagem |
| de uma a três imagens para mudar | FLUX.2 Klein 9B LoRA Edição de imagem |
Recursos e destaques
Seus LoRAs, nas duas versões do klein 9B
LoRAs treinados no klein 9B destilado e no klein Base 9B carregaram aqui em nossos testes. Um LoRA treinado na Base para os níveis mais fortes mudou o que o modelo desenhava; um LoRA de still de filme deslocou a gradação de uma cena inteira para o azul-petróleo e o âmbar. LoRAs de FLUX.1 e klein 4B, e arquivos salvos no formato PEFT do diffusers, rodaram sem erro e não mudaram nada, então confira o modelo base na ficha do LoRA antes de usar.
Rápido o bastante para iterar
A maioria das imagens levou cerca de dez segundos de tempo de modelo, tanto em 1k quanto em 2k, e o 2k custa o mesmo que o 1k. Isso torna prático testar um LoRA em três valores de strength e algumas seeds numa só sessão e ficar com o melhor quadro.
Sem filtro de conteúdo
Os prompts e os arquivos LoRA não são revisados. Sozinho, o modelo se contém nos níveis Forte e Muito forte; LoRAs treinados para esse conteúdo no klein 9B renderizaram os dois em nossos testes. O nível Máximo foi renderizado sem nenhum LoRA.
Parâmetros da requisição
| Parâmetro | Obrigatório | Descrição |
|---|---|---|
prompt | Sim | Obrigatório, com até 5.000 caracteres. Coloque primeiro a frase-gatilho do LoRA e depois descreva sujeito, roupa, lugar, luz e lente em frases. pelo menos 1 caracteres · no máximo 5000 caracteres |
aspect_ratio | Não | Nove formatos, de 21:9 a 9:21; 1:1 por padrão. O formato não muda o preço. |
resolution | Não | 1k (padrão) tem cerca de um megapixel, por exemplo 1344 x 768 ou 1024 x 1024; 2k coloca 2048 pixels no lado maior, por exemplo 2048 x 1152. Os dois custam o mesmo. |
loras | Não | Até três entradas {path, scale} treinadas para o FLUX.2 [klein] 9B, destilado ou Base; scale de 0 a 4, sendo 1 o padrão. Nos nossos testes, 0,5 ficou fraco e 4 quebrou a imagem. Valor padrão: |
seed | Não | Opcional, de 0 a 2147483647. Reutilize-a para comparar uma mudança por vez; nos nossos testes, a mesma seed deu a mesma imagem ou uma quase idêntica. |
Preços
$0.018 / imagem
Cobrado por imagem a um preço fixo. A proporção, 1k ou 2k e o carregamento de LoRAs não alteram o preço.
Casos de uso
Rode um LoRA de um hub como uma chamada de API
Cole um link .safetensors direto de um hub de modelos, defina o scale e escreva o prompt. Não há nada para treinar, hospedar ou manter aquecido, e até três LoRAs se combinam numa mesma requisição.
Imagens com cor trabalhada e séries com estilo
Um LoRA de filme ou analógico mantém um conjunto inteiro de imagens na mesma correção de cor em nove formatos, de banners 21:9 a telas de celular 9:16, a um preço fixo por imagem.
Trabalho de personagem com LoRAs empilhados
Carregue um LoRA treinado para o klein 9B para os níveis mais fortes junto com um LoRA de personagem ou de estilo, e mantenha todas as pessoas adultas.
Guia de prompt e dicas práticas
Gatilho primeiro, depois frases
Comece com a frase-gatilho do LoRA, que está no cartão do modelo, e depois descreva sujeito, roupa, lugar, luz e lente em frases completas. O modelo segue bem prompts longos e específicos, e não há prompt negativo, então diga o que você quer em vez do que evitar.
Mexa no scale em passos pequenos
Comece entre 0,8 e 1. Nos nossos testes, 0,5 deu uma versão fraca do estilo e 4 quebrou a imagem em blocos. Suba ou desça 0,2 e olhe primeiro rostos e mãos; são as primeiras coisas a distorcer.
Confira se o LoRA está fazendo o trabalho
Rode o mesmo prompt e a mesma seed com e sem o arquivo. LoRAs de estilo costumam refinar um visual que as palavras já pedem, como grão, correção de cor ou grade de pixels; LoRAs que ensinam conteúdo novo mudam a imagem por completo. Nenhuma mudança visível costuma indicar o modelo base errado.
Descreva o visual, a luz e a lente
Sem LoRA, o modelo escolhe a roupa por conta própria. Use o prompt para o cenário, a luz e a lente, e mantenha a descrição da roupa curta e simples.
Início rápido da API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "black-forest-labs/flux-2-klein-9b-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "resolution": "1k"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulte a referência da API para autenticação, esquema completo, polling e tratamento de erros.