Introdução
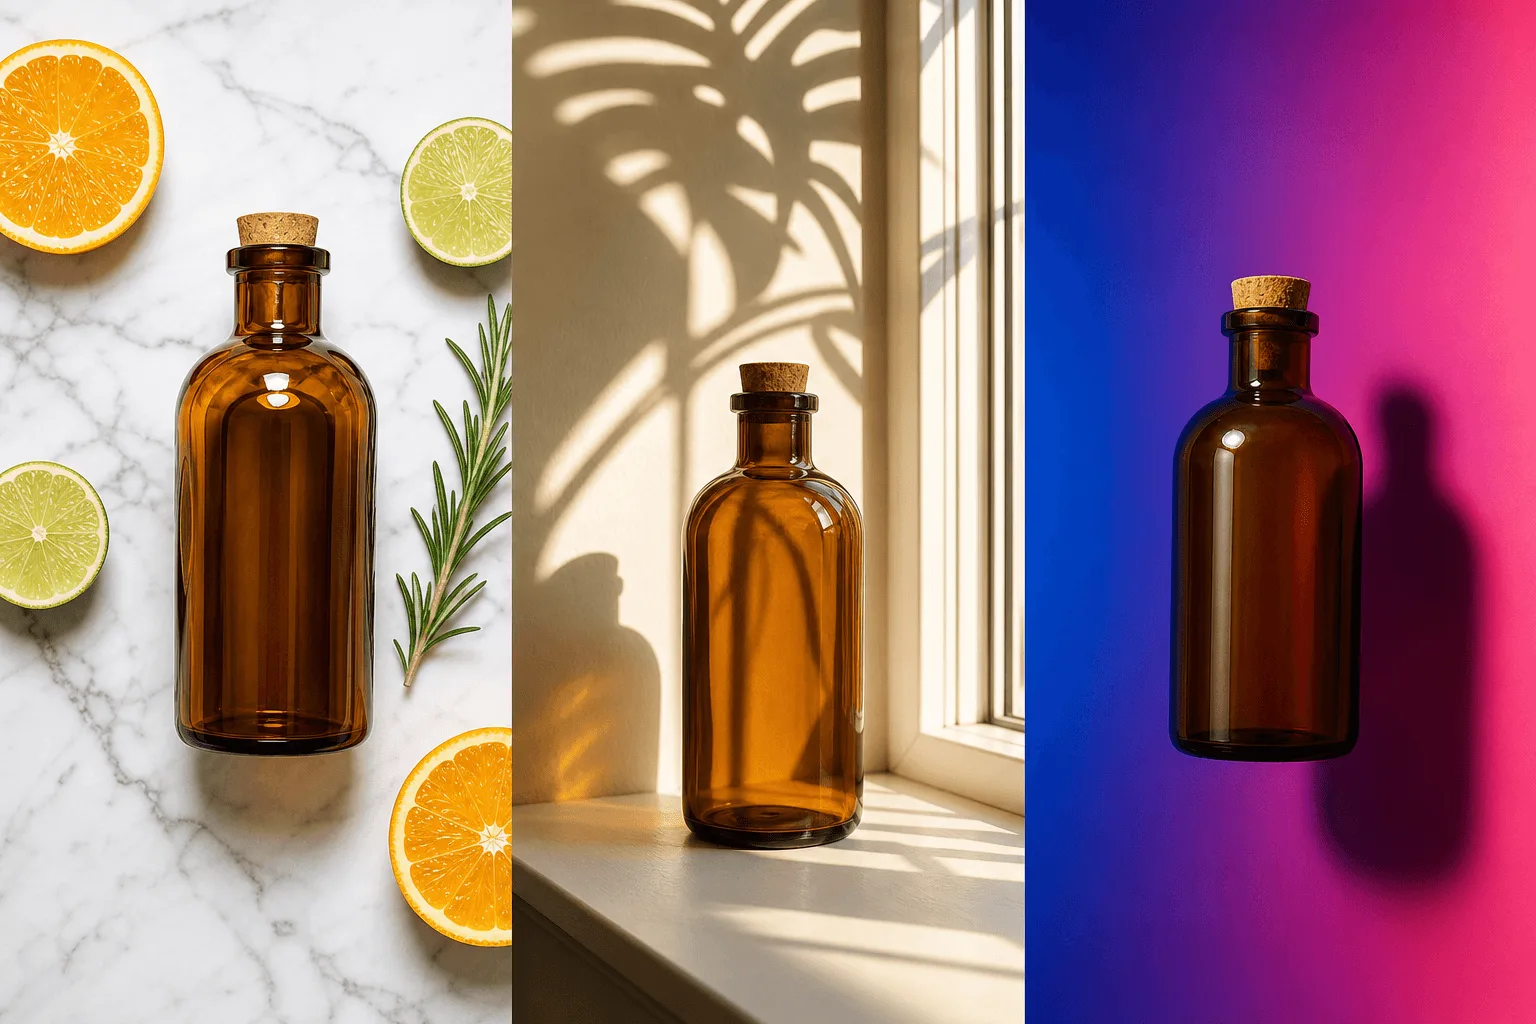
O Z-Image Texto para imagem transforma uma descrição escrita em uma única imagem, normalmente em cerca de um segundo. A velocidade é o ponto: ela deixa a geração tão barata que dá para tratá-la como um ciclo, e não como um compromisso.
O Z-Image é a família compacta de modelos de imagem de 6B da Tongyi, ajustada para resultados fotorrealistas em cerca de um segundo e publicada aqui como um único endpoint de texto para imagem. Cinco proporções, PNG sem perdas, prompts de até 1.000 caracteres. Sem censura.
Recursos e destaques
Vinte iterações em vez de um prompt cuidadoso
A cerca de um segundo por imagem, você para de escrever prompts na defensiva. Escreva uma linha, olhe, ajuste, olhe de novo — o ciclo é curto o bastante para a intuição nascer de evidências e não de palpites, e vinte tentativas aqui ainda custam menos que uma chamada a um modelo pesado de acabamento.
Textura de foto espontânea, não brilho de estúdio
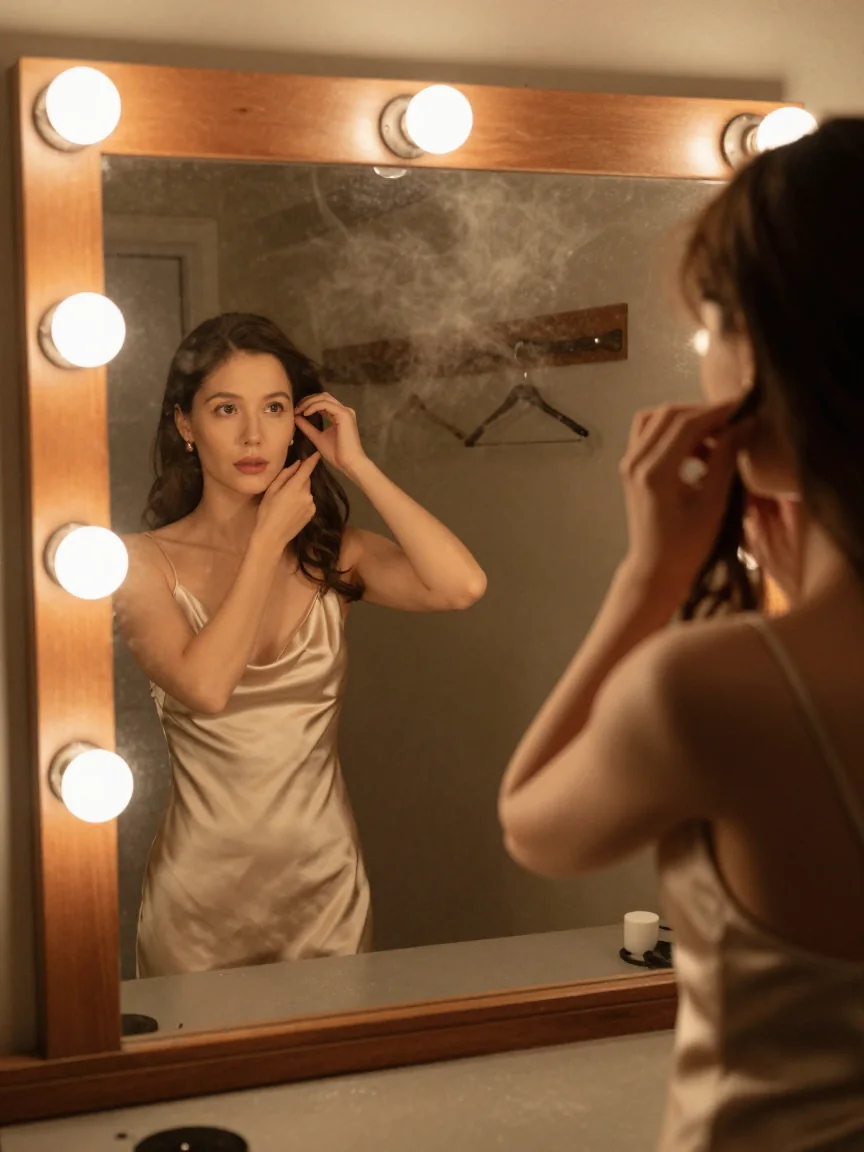
O registro mais forte dele é o menos glamoroso: selfies no espelho com o celular, luz fluorescente no teto, um leve borrão de movimento, cabelo úmido. Peça uma foto espontânea e você recebe algo que parece fotografado, não renderizado — justamente o que modelos mais pesados costumam polir até sumir.
Parâmetros da requisição
| Parâmetro | Obrigatório | Descrição |
|---|---|---|
prompt | Sim | Até 1.000 caracteres — um orçamento pequeno de propósito. pelo menos 1 caracteres · no máximo 1000 caracteres |
aspect_ratio | Não | Formato da saída: cinco valores, quadrado por padrão, de 16:9 deitado a 9:16 em pé. |
enable_prompt_expansion | Não | Desligado por padrão, então o prompt é usado como foi escrito. Valor padrão: |
output_format | Não |
|
seed | Não | Inteiro de 0 a 2147483647 para o ponto de partida aleatório; omita e cada execução sorteia o seu. |
Preços
$0.01 / imagem
Casos de uso
Começar por um brief escrito
Use este endpoint quando quiser ver uma ideia escrita em muitas versões rápidas: cada chamada devolve um PNG sem perdas em cerca de um segundo, em uma de cinco proporções. Guarde todo prompt que acertar junto com o seed.
Séries de personagens em volume
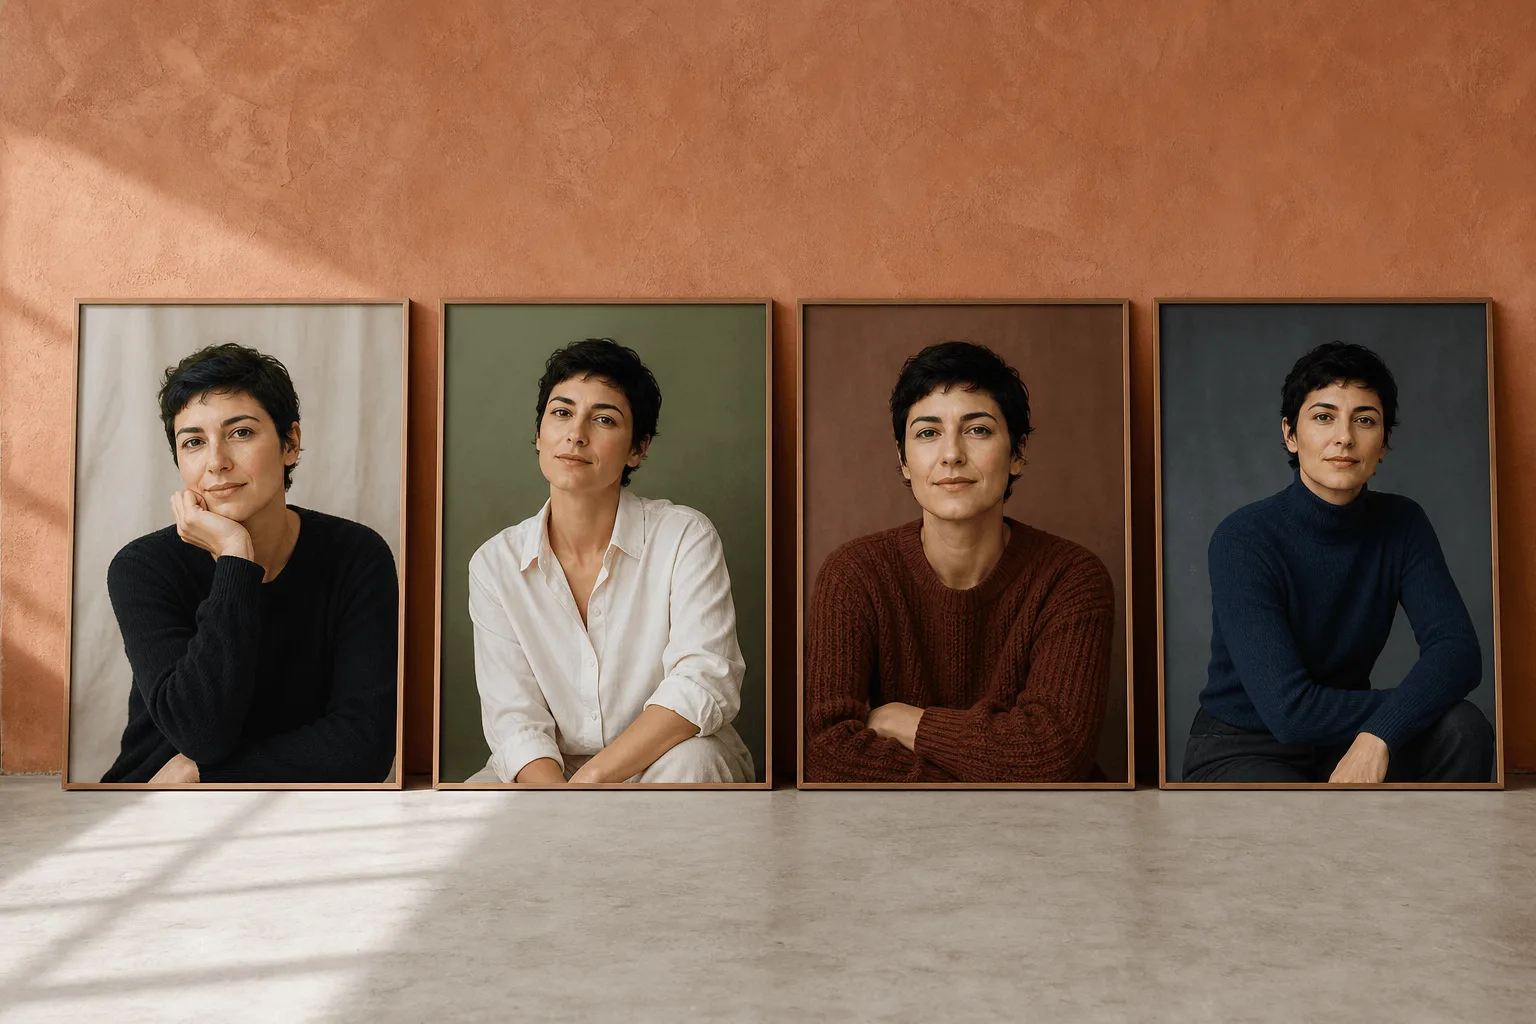
Retratos de personagens e cenários de roleplay explorados em vinte direções por vez, sem nada para sinalizar e sem endpoint separado. Cada execução sorteia a própria imagem, então guarde os prompts que acertam e varie figurino e cenário uma parte por vez.
Conceitos antes de um modelo de acabamento
Encontre a composição aqui, onde uma imagem custa cerca de um segundo, e leve a redação que funcionou para um modelo mais lento e de teto mais alto na versão que vai ser entregue. O mesmo vocabulário fotográfico, sem reestruturar nada.
Conteúdo que parece uma foto espontânea de verdade
Selfies no espelho, luzes fluorescentes de academia e lâmpadas duras no teto, enquadramento casual de câmera de celular: o registro que parece uma foto de verdade num feed. Peça os defeitos explicitamente: dominante de fluorescente, borrão de movimento, foco irregular.
Guia de prompt e dicas práticas
Mantenha o brief curto e concreto
1.000 caracteres é um orçamento pequeno — gaste com luz, lente e textura. A imagem publicada saiu de: “iPhone mirror selfie, an adult woman in a charcoal sports bra and low-slung grey joggers standing in an empty late-night gym, midriff bare, one hand holding the phone, hair damp, casual confident smirk, overhead fluorescent light, slight motion blur, authentic amateur snapshot look.”
Guarde o prompt junto com a imagem boa
Sem seed, requisições idênticas sorteiam imagens diferentes. Salve o prompt e o seed ao lado do arquivo e mude uma parte por vez enquanto procura algo melhor; com o seed fixo, a diferença que você vê vem dessa parte.
Adapte o exemplo incluído
Comece pelo exemplo publicado com aspect_ratio: 1:1 e output_format: png. Troque o assunto e a direção criativa, mas mantenha o contrato de entrada deste modo.
iPhone mirror selfie, an adult woman in a charcoal sports bra and low-slung grey joggers standing in an empty late-night gym, midriff bare, one hand holding the phone, hair damp, casual confident smirk, overhead fluorescent light, slight motion blur, authentic amateur snapshot look.
Uma versão quadrada da requisição por trás da imagem publicada: um brief de foto espontânea que nomeia a fonte de luz, o borrão e o enquadramento em vez de pedir qualidade.
Confira o resultado antes de iterar
O limite do prompt é de 1.000 caracteres, e um prompt mais longo é recusado antes do envio em vez de ser cortado — este modelo recompensa um brief enxuto, não uma lista de planos. Cada proporção corresponde a um tamanho fixo em torno do megapixel nativo do modelo, então não há seletor de resolução nem caminho para uma imagem grande de entrega. Tipografia fina e detalhe pequeno e denso não são para o que um modelo de 6B serve.
Início rápido da API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "alibaba/z-image-turbo/text-to-image",
  "input": {
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "aspect_ratio": "1:1",
    "output_format": "png",
    "enable_prompt_expansion": false
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulte a referência da API para autenticação, esquema completo, polling e tratamento de erros.