Персонаж SillyTavern наконец пишет как нужно. Вы просите картинку, ComfyUI начинает загрузку, и либо изображение не удаётся, либо следующий ответ чата мучительно медленный. Видеокарта 8GB или 16GB вполне справляется с каждой задачей отдельно и всё равно испытывает трудности с обеими сразу.
Для генерации NSFW-изображений SillyTavern при малой VRAM первое полезное решение — какая задача удерживает GPU. Если важнее непрерывный локальный roleplay, генерируйте картинки удалённо. Если важнее локальный checkpoint персонажа и LoRA, переносите разговор на chat API. Если всё должно быть локальным, сначала создайте визуальный промпт, выгрузите текстовый backend, отрендерьте изображение и загрузите текстовый backend обратно. Третий путь сохраняет разговор, но не обещает непрерывной генерации при смене задач GPU.
Это практические варианты настройки, а не benchmark о совместимости конкретной пары моделей с любой картой 8GB. Совместный локальный запуск здесь не измерялся. Инструкции соединения взяты из документации и исходников проектов, а порядок работы изолирует типичные ошибки без одновременной смены пяти настроек.
Проблема ясно проявилась в обсуждении SillyTavern от 2 октября: пользователь AMD 16GB уже занимал память локальным roleplay и хотел добавить Z-Image. Вопрос не в запуске Z-Image на потребительской GPU, а в запуске при вашем существующем chat-моделе, всё ещё занимающей эту GPU.
Распределите GPU до скачивания новой модели
Начните с части вечера, которую меньше всего хотите прерывать. Длинный разговор с любимой локальной моделью, настроенный визуальный процесс и требование ничего не отправлять с компьютера ведут к разным схемам.
| Что важнее | Рекомендуемый путь | Чем жертвуете |
|---|---|---|
| Отзывчивость существующего локального чата персонажа | Локальный чат, удалённые картинки | Промпты и референсы уходят сервису изображений |
| Точный локальный checkpoint, LoRA и процесс картинок | Удалённый чат, локальный ComfyUI | Выбранный chat API получает отправляемый контекст |
| Разговор и картинки на вашей машине | Локальные чат и изображения последовательно | Переключение моделей прерывает темп и может требовать новой обработки промпта |
| Редкие картинки без нового проекта интеграции | Локальный чат и браузерный генератор | Картинки создаются вне нативных настроек SillyTavern |
С 8GB обычно начинайте с одной локальной нагрузки генерации. С 16GB места для экспериментов больше, но решение то же, если LLM уже занимает почти всю карту. Новая квантизованная модель без выбора владельца оставшейся памяти часто даёт ещё скачивание с той же ошибкой.
Не путайте chat API и backend изображений. Модель пишет отличное описание взрослого вымышленного персонажа без способности создать пиксели. Модель с изображениями на входе может лишь анализировать их. Выбор API Connections ведёт разговор; Source в Image Generation рисует картинку. Во всём руководстве это отдельные настройки.
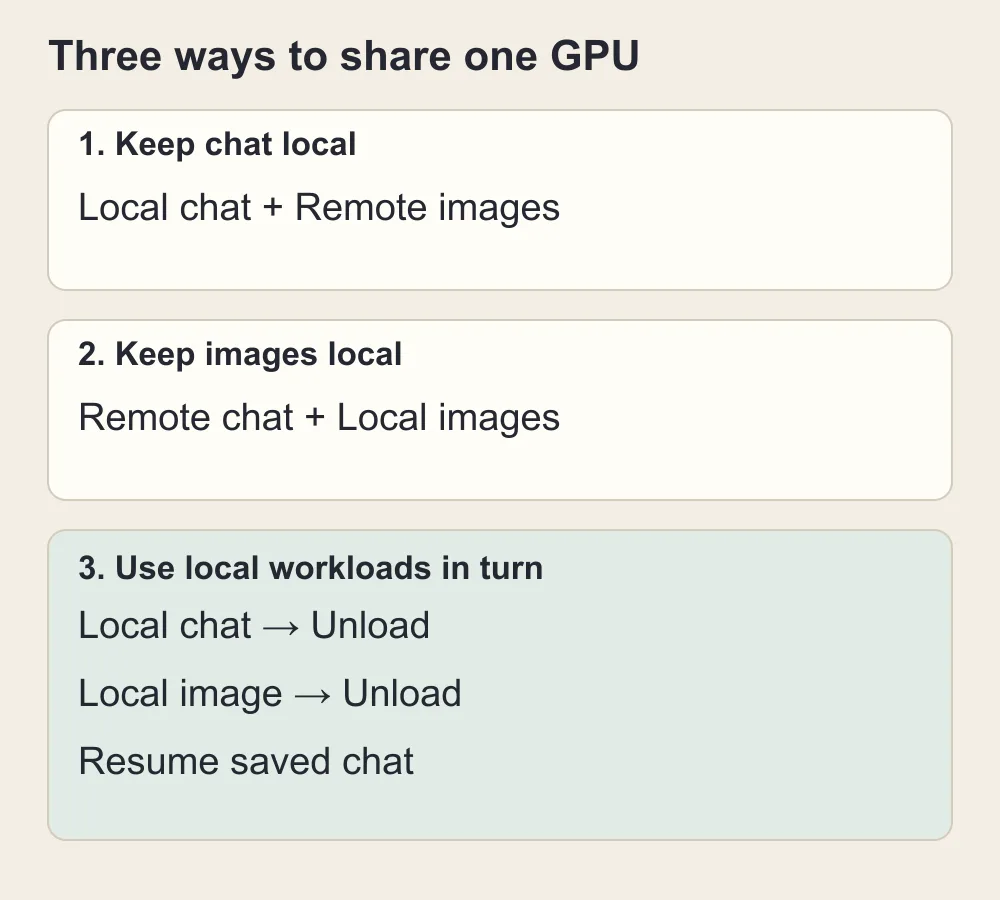
Оставьте одну нагрузку удалённой или дайте локальным чату и картинкам GPU по очереди.
Почему неактивное окно чата всё равно занимает почти всю VRAM
Чат кажется неактивным: ответ не генерируется, загрузка GPU падает, машина тихая. Но ComfyUI не загружает модель. Загрузка процессора измеряет текущую работу; занятость памяти — ресурсы, сохранённые для следующей. Backend может почти ничего не делать при большой зарезервированной памяти.
Размер загрузки модели — лишь часть. LLM также нужны кеш разговора и временные вычисления. Большой контекст увеличивает нагрузку без смены весов. Изображения имеют свои компоненты и временную работу. Пик может возникнуть после кажущейся успешной загрузки, а не первого скачивания или соединения.
Объяснение разработчика llama.cpp о памяти разделяет веса, кеш контекста и вычислительные буферы. Поэтому вычитание размера GGUF из числа на коробке GPU плохо определяет место для ComfyUI.
Для иллюстрации пусть 16GB-карта отдаёт 1GB рабочему столу и приложениям, 11GB текстовому backend. До изображений остаётся около 4GB. Это придуманные числа арифметики, не измерение Z-Image и не рекомендованное распределение. Модель, заявленная для устройства 16GB, не обязательно работает в оставшихся 4GB.
Официальный репозиторий Z-Image описывает Turbo на потребительских устройствах 16GB и CPU offloading при ограниченной памяти. Это утверждение развёртывания изображения. Оно не резервирует место для отдельной roleplay LLM, длинного кеша, нескольких адаптеров и одновременного inference другого процесса.
До изменений смотрите память, а не процент GPU. В Windows откройте диспетчер задач, Performance и фактическую дискретную GPU. Различайте выделенную и общую память. На других системах используйте мониторинг производителя или логи backend. Важно, какой процесс остаётся загруженным, а не мгновенно неактивный график GPU.
Найдите сбой четырьмя короткими проверками
Сделайте это до новой квантизации, переустановки SillyTavern или узла выгрузки. Соединение и VRAM выглядят одинаково из чата: нет картинки.
Сначала проверьте разговор отдельно. Полностью закройте backend изображений, запустите обычный текстовый и создайте нормальную roleplay-реплику. Отметьте, медленна ли она уже. Если да, это ещё не разделение GPU: сама LLM слишком требовательна, использует неподходящий backend или обрабатывает большой промпт.
Затем проверьте изображения отдельно. Остановите текстовый backend, запустите ComfyUI и создайте картинку в его интерфейсе. Одна картинка с предназначенными настройками процесса. Если ошибка без LLM, уменьшение контекста чата не поможет. Сначала исправьте установку, файлы, узлы или потребность памяти изображения.
Далее соедините SillyTavern с работающим backend картинок. LLM оставьте остановленной, выключите Extend free-mode prompts в Image Generation, используйте ручную команду вроде /sd a fictional adult lounge singer age 29 in a black satin evening outfit, seated beside an amber lamp. Это обходит дополнительное написание промпта текстовой моделью. Если ComfyUI работает напрямую, а запрос SillyTavern не отправляется, исследуйте Source, адрес и API-workflow. Низкое разрешение не чинит URL не того сервиса.
Наконец повторите с загруженной LLM. Единственная главная разница — текстовая нагрузка. Если ранее изображение работало, теперь нет, есть основания разделять память. Если работает, но чат после резко замедляется, проверьте сохранённые модели ComfyUI или переход текста к медленному исполнению.
После успеха есть пятое сравнение: ручной промпт и /sd last. Последний добавляет шаг LLM с описанием недавнего разговора. Если ручной достигает ComfyUI, контекстный нет, сбой может быть в написании промпта, не рендере. Отказ, пустой ответ или неправильное описание LLM не чинятся освобождением памяти картинок.
Запишите точный этап сбоя ComfyUI: загрузка модели, кодирование текста, семплирование, декодирование или поздняя детализация. Это указывает, что убирать. Ошибка финального апскейла решается его отсрочкой; загрузка основной модели требует другого плана памяти.
Первый путь: оставьте локальный roleplay, делайте картинки иначе
Я бы выбрала это сначала, если локальная модель уже нравится и картинок немного. Текстовую схему оставьте. Уберите ей с пути нагрузку изображения вместо сокращения разговора до потери желанного опыта.
Источник, уже поддерживаемый SillyTavern
Откройте Extensions, разверните Image Generation. В Source выберите реально присутствующий поддерживаемый сервис. Настройте его credentials и модель, а не адрес текстовой модели в панели изображений. Официальная документация Image Generation — источник списка и настроек интеграций.
Затем создайте скромный портрет без откровенного содержания до автоматических триггеров. Так проверяются сервис, credentials, модель и обработка результата вместе. Наличие интеграции не обещает нужной взрослой сцены каждой моделью внутри неё.
Не заменяйте специальный URL картинок общим API другой компании с ожиданием перевода интеграцией. При принятии промптов оба сервиса всё равно могут отличаться телом запроса, состояниями задач, форматом картинки, авторизацией и ошибками. Поле API URL не означает взаимозаменяемости всех API.
Разместите ComfyUI на другом компьютере
Если нужны собственные checkpoint и LoRA, сохраните процесс, переместите исполнение. Сначала успешный рендер на другой машине. Ей нужны совместимые программы, файлы моделей и узлы. JSON ссылается на компоненты, не упаковывает их все.
В Image Generation SillyTavern выберите ComfyUI и Standard Server. Введите адрес, доступный машине сервера SillyTavern, затем Connect. Открытие страницы ComfyUI телефоном не доказывает доступ хоста SillyTavern.
При разных машинах 127.0.0.1 — машина запроса. Он не найдёт ComfyUI на другом компьютере. Используйте фактический доступный адрес установки. Для онлайн-хоста — защищённое соединение; открывать неограниченный ComfyUI всему интернету не нужно домашней схеме.
После первого рендера добавьте сохранённый API-workflow. Сохраняйте checkpoint и адаптеры для совпадающих результатов. Если удалённая GPU использует другую квантизацию, обновите загрузчик, не предполагая идентичного поведения похожего имени. Локальная LLM остаётся загруженной, поскольку картинка использует память другой машины.
Путь привлекателен знакомым ComfyUI. Менее привлекателен ради двух картинок сегодня с необходимостью сначала учить серверное администрирование. Браузерный генератор практичнее, хотя менее встроен.
Используйте SpicyAPI рядом с чатом
Задачи изображений SpicyAPI не присутствуют нативным Source в просмотренной реализации SillyTavern. Их асинхронный контракт нельзя вставить в ComfyUI URL или считать AUTOMATIC1111-эндпоинтом. Руководство не даёт и не заявляет проверенного адаптера взаимозаменяемости протоколов.
Можно оставлять локальный roleplay открытым и использовать страницу Z-Image Spicy во второй вкладке. Откройте Playground, вставьте визуальное описание текущей сцены, задайте размеры, создайте и скачайте. Локальная GPU остаётся LLM, inference изображения удалённый.
Для первого портрета выберите 832 на 1216 пикселей, отключите расширение, опишите одного вымышленного взрослого в конкретном наряде и комнате. Оба размера входят в диапазон Z-Image Spicy от 256 до 1536 на сторону. Это предлагаемый старт композиции, не заявление о рендере или сравнении с локальным checkpoint.
Удалённый сервис получает визуальный промпт и загруженные изображения. Вся история roleplay для картинки не нужна. Копируйте лишь видимые черты и текущую сцену; убирайте частные заметки, реальные имена и не нужные статичному кадру детали.
Второй путь: оставьте локальные изображения, перенесите чат на API
Выберите, если тщательно настроена именно модель картинок: иллюстрационный checkpoint, LoRA персонажа, управление позой или процесс сцены, не повторяемый браузерным сервисом. Перенос чата часто проще пересборки визуальной работы.
Сначала остановите локальный текстовый backend, а не только измените селектор API. Фоновые llama.cpp, Ollama или другой сервер сохраняют память. Сохраните профиль соединения для возврата, затем подключите выбранный размещённый chat-source.
SillyTavern поддерживает размещённый чат отдельно от картинок. Следуйте API Connections выбранного протокола. Источник может быть локальным или размещённым независимо от Chat Completion или Text Completion: названия описывают отправку промпта, а не место GPU.
Для SpicyAPI-чата руководство подключения roleplay SillyTavern даёт Custom OpenAI-compatible настройки и особенности неподдерживаемых параметров модели. Используйте их, не вставляйте ID image-task в chat-model. Главная задача статьи — освободить GPU картинкам, поэтому все настройки моделей чата не повторяются.
Вернитесь в ComfyUI, запустите точный workflow, работавший отдельно. Не добавляйте сразу этапы из-за свободной GPU. Первый встроенный запрос оставьте идентичным отдельному: сравнение проверяет устранение помех сменой маршрута чата.
Размещённая LLM полезна визуальной цепочке: превращает текущую сцену в промпт до отправки SillyTavern локальному ComfyUI. Это текстовый запрос через chat-service без загрузки другой большой локальной модели на карту.
Цена — приватность разговора и токены. Chat API получает включённый SillyTavern контекст: описание персонажа, инструкции, выбранный lore, сообщения. При обязательной локальности чата это не мелкая настройка; меняется место обработки текста.
Следите за первым ответом после картинки. Если он отзывчив, ComfyUI завершает чисто, конкуренция памяти решена. Если картинка столь же медленная, как отдельно, узкое место в её нагрузке, а не новом удалённом разговоре.
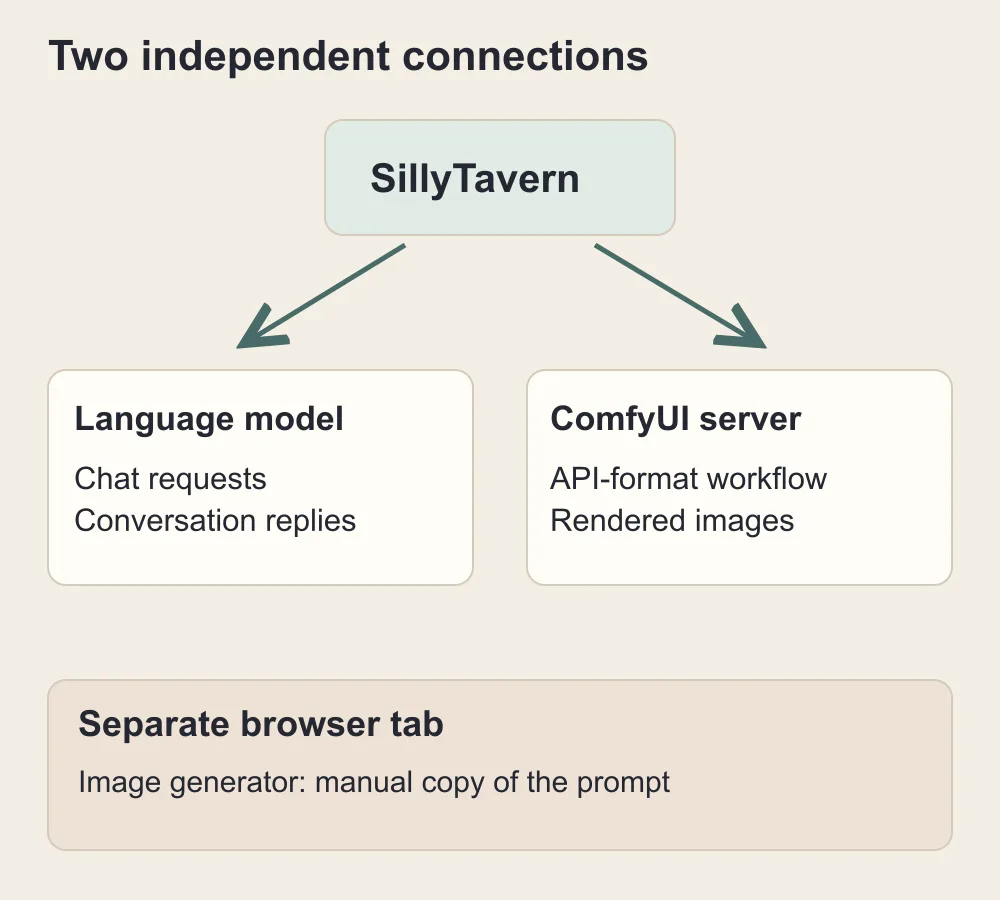
Чат и картинки — отдельные соединения. Генератор рядом с чатом — ручной путь, не нативная интеграция ComfyUI.
Третий путь: всё локально, по очереди
Если ни текст, ни визуальные промпты не должны покидать машину, используйте GPU последовательно. Создание картинки — короткая пауза разговора. Вы не удаляете персонажа и не начинаете новый чат, а временно меняете backend, удерживающий память.
Сохранённый разговор и загруженный кеш — разные вещи. SillyTavern хранит чат, а кеш backend ускоряет следующий запрос. Остановка или выгрузка могут его удалить. Возвращённая модель снова обработает контекст. История доступна, но первый ответ после возврата дольше.
Порядок работы
- Завершите реплику, остановите автоматические повторы и триггеры картинок, способные отправить запрос.
- Создайте и сохраните визуальный промпт при ещё загруженной текстовой модели или напишите вручную.
- Сохраните разговор и описание картинки в доступном для вставки месте.
- Выгрузите или остановите текстовый backend, проверьте реальное уменьшение выделенной памяти GPU.
- Создайте одну картинку ComfyUI по сохранённому описанию.
- Скачайте или сохраните результат, выгрузите модели ComfyUI либо остановите backend.
- Убедитесь в свободной памяти, запустите текстовый backend с сохранёнными настройками, при необходимости переподключитесь.
- Продолжайте тот же разговор; первый ответ может пересобрать контекст при потере кеша.
Создание промпта должно происходить до выгрузки. Если остановить LLM, а затем попросить /sd last описать сцену через тот же backend, вы уберёте сервис, необходимый для первой половины запроса картинки. На этапе изображения используйте уже сохранённое описание в ручном запросе /sd, отключив Extend free-mode prompts.
Начните вручную. Видимая последовательность остановки и перезапуска менее изящна, чем расширение для выгрузки, зато показывает, работает ли сам план использования памяти. Если картинка не создаётся и после остановки текстового процесса, автоматическое переключение лишь быстрее повторит ошибку.
Пользователям Ollama: выгружайте модель, а не закрывайте окно
Ollama документирует отдельную команду остановки и настройку keep_alive. Для немедленной ручной остановки используйте ollama stop YOUR_MODEL_NAME, подставив точное имя из своей установки. Официальный FAQ также описывает значение keep_alive, равное нулю, для поддерживаемых API-запросов: после использования модель выгружается.
В этой конфигурации сначала завершите описание картинки, затем остановите модель и запустите этап изображения. При следующем запросе чата Ollama может снова загрузить модель. Отключите автоматическое фоновое создание промптов, пока ComfyUI использует карту: такие запросы способны вернуть LLM в память в неподходящий момент.
Не считайте, что любой чат-клиент позволяет задавать все параметры Ollama через любой тип API. Используйте явно поддерживаемую настройку или документированную команду остановки. Ползунок контекста или общее поле дополнительных параметров тела запроса сами по себе не реализуют встроенное управление жизненным циклом Ollama.
Пользователям llama.cpp: управляйте жизненным циклом своего backend
Если вы запускаете llama-server с одной моделью, остановка этого процесса — наиболее понятный ручной способ освободить выделенную память перед загрузкой графа изображения. Затем запустите его снова с теми же сохранёнными настройками. Закрытие браузера, бездействующий чат или изменение выбранного имени модели в SillyTavern не останавливают отдельный процесс.
Современные версии сервера llama.cpp также предлагают управление моделями, но доступные операции зависят от способа запуска и установленной версии. Сервер с одной моделью и маршрутизатор нескольких моделей — разные конфигурации. Используйте средства управления, документированные для вашего сервера; не копируйте запрос выгрузки от другого backend.
Пользователям ComfyUI: освобождение его моделей не выгружает LLM
В официальной реализации сервера ComfyUI есть операция /free с параметрами unload_models и free_memory. Она устанавливает флаги, которые обрабатывает система выполнения. Это не команда завершить отдельно запущенный процесс llama.cpp, а принятый запрос ещё не доказывает, что вся запрошенная память уже освобождена.
После создания картинки используйте управление выгрузкой моделей, доступное в вашем интерфейсе или установке ComfyUI. Если подходящего средства нет, остановка backend ComfyUI даёт понятный ручной исходный вариант. Одно лишь закрытие вкладки браузера серверный процесс не останавливает.
Пользовательский узел выгрузки бывает полезен, но только при правильном порядке исполнения. Если он работает до последующего прохода детализации, которому нужна та же модель, модель может загрузиться повторно. Если узел выгружает только модели ComfyUI, backend roleplay остаётся нетронутым. Прочитайте документацию узла, прежде чем считать, что он управляет обоими приложениями.
Сначала настройте соединение с ComfyUI, затем оптимизируйте память
Поддержка ComfyUI в SillyTavern — полноценная интеграция графов, а не универсальный переходник для любых image API. Она отправляет серверу ComfyUI граф в формате API и получает результат. Граф, успешно работающий на вашем компьютере, может не заработать через SillyTavern, если экспортирован неверный формат или промпт остался жёстко заданным.
Начните непосредственно в ComfyUI. Создайте одну картинку с теми же checkpoint, текстовым энкодером, VAE и установленными узлами, которые собираетесь использовать. Сохраните обычный граф, чтобы позже открыть его визуально. Затем экспортируйте API-версию через соответствующую функцию своего интерфейса ComfyUI; названия пунктов меню могут отличаться между версиями.
В SillyTavern выберите ComfyUI в Image Generation, для обычной локальной установки укажите Standard Server и адрес, показанный вашим сервером ComfyUI. Документированный адрес по умолчанию — http://127.0.0.1:8188. Этот локальный адрес относится к настройкам приложения; это не публичный сайт и не адрес, который следует публиковать для чужого использования.
Нажмите Connect, создайте или выберите нужный граф и вставьте граф формата API в его редактор. Интеграция предоставляет подстановки, например %prompt% для положительного промпта. Размещайте их только там, где граф действительно получает соответствующее значение. Граф без подстановок может быть корректным JSON ComfyUI, но каждый раз рисовать исходный демонстрационный промпт.
Для графа с CLIP Text Encode найдите фактическое текстовое поле, формирующее положительное обусловливание, и замените тестовое описание подстановкой промпта. Если текст получает пользовательский загрузчик или другой узел, подстановка нужна именно там. Не добавляйте неподключённый текстовый узел только ради зелёной отметки редактора.
Затем отправьте два намеренно разных визуальных запроса: сначала взрослую певицу в лаунже, затем пустую комнату при свечах. Если оба дают один и тот же объект, проверьте экспортированный граф до смены seed или установки новой модели. Начните с проверки жёстко заданного промпта. Если меняются лишь цвет или настроение, проверьте, не осталось ли исходное описание персонажа в другом префиксе или текстовом поле.
Какие настройки памяти помогают, а какие вводят в заблуждение
Не применяйте сразу все флаги оптимизации из комментария на форуме. Нужно понимать, уменьшаете ли вы текстовую нагрузку, нагрузку изображений или меняете удержание неиспользуемой памяти. Это разные действия, по-разному влияющие на следующую реплику.
Сначала сократите контекст текстового backend, сохраняя качество персонажа
Контекст 32K или больше может резервировать больше памяти, чем нужно для нынешнего вечера. Попробуйте сохранённый профиль с меньшим контекстом backend, например 4096 или 8192 токенами, если туда всё ещё помещаются карточка, инструкции, нужные сведения мира и недавний разговор. Это примеры размеров профиля, а не обещание, что любая модель поместится в память.
Также согласуйте запрашиваемый контекст SillyTavern с backend. Уменьшение только объёма истории, отправляемого клиентом, может не уменьшить кеш, выделенный при запуске сервера. И наоборот, повышение клиентского ползунка не увеличивает фактическую ёмкость сервера. Если настройка относится к выделению памяти backend, измените её там и перезапустите или перезагрузите его так, как требует реализация.
Документация сервера llama.cpp описывает размер контекста, слои GPU, типы кеша и выгрузку KV. Используйте названия из справки установленной версии. В частности, автоматическое размещение текстовой модели по ёмкости устройства не обещает оставить место под будущий пик изображения в другом приложении.
Уменьшение числа слоёв GPU переносит часть текстового инференса с GPU. Это освобождает пространство ценой более медленной обработки. Квантизация кеша разговора — отдельная настройка, отличная от выбора квантизированного файла модели. Файл весов Q4 не означает, что кеш тоже хранится в четырёхбитном виде.
Уменьшите пики изображения более простым проходом
Используйте размер пакета один. Несколько картинок, создаваемых последовательно, отличаются от одновременной обработки пакета. Сохраните обычное для выбранной модели соотношение сторон и разумный начальный размер, а второй проход с высоким разрешением добавляйте лишь после успешного базового изображения.
Если конкретный граф падает при декодировании VAE, стоит попробовать поддерживаемый tiled-декодер. Если ошибка возникает при загрузке основной модели, декодирование по плиткам не уменьшит её веса. Если сбой происходит лишь на детализации лица или upscale, уберите этот этап из живого графа и выполните его позже, остановив backend чата.
Прочитайте, что Low VRAM означает в вашей программе
Текущие определения аргументов ComfyUI различают динамическое управление памятью и старые флаги. --lowvram ничего не делает при включённом DynamicVRAM; без него флаг переносит текстовые энкодеры на CPU. Его смысл уже, чем «поместить любую image-модель в любое оставшееся свободное место».
ComfyUI также предлагает резервирование памяти и более агрессивную выгрузку. Резерв помогает оставить место другим программам, но не является общим планировщиком ComfyUI и backend чата. Если их суммарная минимальная нагрузка не помещается, резерв не создаст дополнительную память. Измените одну настройку и повторите тот же запрос одной картинки.
KoboldCpp использует другие средства управления. Его краткое руководство SillyTavern отдельно предупреждает не включать показанный флажок Low VRAM. Страница описывает старый launcher, поэтому сверяйтесь и со справкой установленной версии. Практический вывод: не копируйте настройку лишь потому, что другая программа использует то же название.
Карта AMD меняет детали настройки, но не арифметику памяти
Недавний вопрос сообщества касался AMD и Vulkan-backend llama.cpp. Это повод внимательно выбирать поддерживаемый путь выполнения, а не вставлять CUDA-команду запуска из руководства для NVIDIA. Доступное ускорение, числовые форматы и поддержка операций зависят от GPU, операционной системы, сборки и реально установленного backend.
Сначала подтвердите, что каждое приложение отдельно работает на карте. Успешная генерация текста через Vulkan не доказывает, что ComfyUI использует подходящий ускоренный backend для изображений. И наоборот, работающая image-модель не доказывает, что локальная LLM собрана с задуманным backend. При отдельных проверках смотрите сообщения запуска и реально используемое устройство.
Если текст отдельно создаётся быстро и картинки отдельно тоже, но совместный запуск падает, спор о производителе GPU вряд ли решит нехватку места. Оставьте одну нагрузку удалённой либо запускайте их по очереди. Если одно приложение медленное даже отдельно, сначала разберитесь с ним, а затем исследуйте одновременное выполнение.
Будьте внимательны к квантизированной image-модели, которую называют «подходящей для 8GB», не описывая всю конфигурацию. Описание может не учитывать текстовый энкодер, полагаться на выгрузку, требовать конкретный пользовательский узел или предполагать свободную GPU. До скачивания прочитайте требования загрузчика именно этой модели и подтвердите поддержку квантизации установленным backend изображений.
Передайте взрослую сцену картинкой, не отправляя всю историю
Когда конфигурация заработала, память перестаёт быть единственной причиной неудачной картинки. Roleplay-модель может описывать чувства персонажа вместо того, что видно камере. Получается правдоподобный портрет, игнорирующий комнату, одежду и текущее действие.
Для вымышленной взрослой Мары отделите постоянный облик от текущей сцены. Постоянными признаками могут быть возраст 29 лет, короткое тёмное каре, серебряный кафф и небольшая татуировка-полумесяц на плече. Текущими — чёрный атласный наряд, бархатное кресло, тёплый приглушённый свет и уверенный взгляд в сторону. Только вторая группа должна изменяться при переходе истории в другую комнату.
Ниже предложено визуальное описание, которое можно адаптировать; оно не использовалось для тестирования модели в этой статье:
Вымышленная взрослая певица лаунжа, 29 лет, с коротким тёмным каре и серебряным каффом, в облегающем чёрном атласном вечернем наряде, сидит боком в глубоком бордовом бархатном кресле. Выражение уверенное и игривое. Тёплый янтарный свет падает от настольной лампы, позади мягко размытый ночной лаунж. Портрет средней крупности, руки расслаблены и видны, камерное журнальное настроение, без надписей.
Если персонаж перешёл из лаунжа на балкон, поменяйте место и свет вместо переписывания всех отличительных черт. Если в разговоре изменилась одежда, ясно укажите новую и уберите старую. Противоречащие описания гардероба способны дать неверную сцену, даже когда image-модель старается следовать тексту.
Префиксы конкретного персонажа помогают сохранять последовательность описания, но не гарантируют одинаковое лицо. Если визуальная идентичность настолько важна, что нужны согласованные референсы или отдельная LoRA, потребуется граф, действительно поддерживающий этот метод. Текст карточки персонажа и её аватар не становятся автоматически референсом для любого источника изображений.
Сохраните визуальное описание до выгрузки текстовой модели; затем продолжите сохранённый чат.
Сколько стоят редкие удалённые картинки
Картинки в отдельной вкладке браузера стоит рассмотреть прежде, чем покупать оборудование только ради устранения редких переключений моделей. В текущем публичном каталоге SpicyAPI Z-Image Spicy стоит $0.01235 за картинку с выключенным расширением промпта и $0.0133 с включённым. Z-Image Spicy Pro — $0.019 за картинку. Это плата за изображения, а не подписка или стоимость удалённого чата.
| Планируемые запросы изображений | Spicy, расширение выключено | Spicy, расширение включено | Spicy Pro |
|---|---|---|---|
| 10 | $0.1235 | $0.133 | $0.19 |
| 50 | $0.6175 | $0.665 | $0.95 |
| 100 | $1.235 | $1.33 | $1.90 |
Расчёт — простое умножение показанного тарифа за картинку. Он не оценивает, сколько попыток дадут изображение, которое вы сохраните. Если создаёте четыре варианта и оставляете один, оплачивать в бюджете нужно четыре запрошенные генерации. Запросы чата для написания промптов, дальнейшее редактирование и upscale — отдельная работа, если вы их добавляете.
Для десяти картинок за вечер указанный компонент стоимости достаточно мал, чтобы сравнить его с неудобством остановки и повторной загрузки локальной модели. Однако это не решает выбор, если вам нужна автономная работа, конкретные локальные LoRA или хранение промптов только на своём компьютере. Эти требования могут перевесить низкую цену за картинку.
Выберите страницу Spicy Pro, если нужен публичный диапазон размеров до 2560 пикселей по каждой стороне; обычный endpoint Spicy подходит, если максимальных сторон по 1536 пикселей достаточно для портрета. Более высокий публичный предел размера — подтверждённое различие функций, а не доказательство превосходства Pro в любой сцене со взрослым персонажем.
Исправляйте конкретный наблюдаемый симптом
ComfyUI создаёт картинки, но SillyTavern сообщает, что изображения недоступны
Откройте Image Generation и выберите настроенный источник. В новой или старой установке может оставаться источник без соединения. Проверяйте адрес в панели изображений, а не URL API чата. Для облачного сервиса используйте его собственные image-credentials и настройки. Работающее соединение текста не устанавливает соединение изображений.
Затем попробуйте короткий ручной запрос картинки. Если он работает, переходите к промптам из контекста. Сложный автоматический триггер вначале мешает понять, недоступен ли источник или триггер просто не сработал на сообщение.
SillyTavern подключается, но каждая картинка похожа на пример графа
Откройте граф формата API и найдите положительный текст, который он реально использует. Замените фиксированный пример подстановкой промпта в этом входном поле. Проверьте другие активные текстовые поля и префиксы на прежнего персонажа. Смена seed даст лишь новые варианты всё ещё жёстко заданного промпта.
Картинка не создаётся только при загруженной модели чата
Не меняйте успешно работающий отдельный граф изображений и разделите использование памяти: удалённые картинки, удалённый чат или последовательная локальная работа. Если хотите одновременно запускать всё локально, сначала уменьшите фактически выделяемый контекст backend или число его слоёв GPU. Повторение той же совместной нагрузки не изменит объём доступной памяти.
Первая картинка работает, затем следующая реплика чата становится медленной
Проверьте память после завершения картинки. ComfyUI может удерживать модели для быстрого повторного использования, а текстовый backend — перенести работу в более медленную память. Выгрузите завершённую нагрузку изображения до следующей реплики либо перенесите картинки на удалённый сервис. Если перезапуск чата возвращает нормальную скорость, сохраните более компактный профиль совместной работы вместо нового соперничества с полноразмерным профилем чата.
Вы выгрузили ComfyUI, но VRAM по-прежнему выглядит заполненной
Определите процесс, удерживающий оставшуюся память. ComfyUI освобождает собственные модели, но не выгружает LLM другого приложения. Также различайте выделенный кеш и память, действительно возвращённую устройству. Для ручной исходной проверки намеренно остановите backend-процессы и подтвердите изменение памяти до повторного запуска любого из них.
Картинка не запускается после запроса последней сцены
Попробуйте ту же сцену как вручную написанный запрос изображения в свободном режиме с отключённым расширением промпта. Если он работает, проверьте этап создания промпта текстовой моделью. Endpoint может быть остановлен, ответ — пустым, а инструкции — выдавать обычный текст вместо формата, ожидаемого графом. Освобождение памяти изображений не исправляет отсутствие текстового ответа.
Генерация начинается, но падает на финальной доработке
Уберите detailer, второй проход семплирования или upscaler из рабочего графа и создайте базовую картинку. Если она успешно получилась, сохраните её и выполните дополнительный этап отдельно, выгрузив текстовый backend. Более сложный граф можно оставить для законченной работы, не заставляя каждую спонтанную картинку чата проходить все его этапы.
GPU не заполнена, но всё по-прежнему мучительно медленно
Проверьте, выполняется ли фактическая работа на нужном ускоренном устройстве и не исчерпана ли системная RAM. Активная выгрузка на CPU может сделать конфигурацию технически рабочей, но неудобной для живого разговора. Тогда очередная оптимизация VRAM может ещё сильнее пожертвовать скоростью ради выгрузки; перенос одной нагрузки на удалённый сервис способен дать более ясное улучшение.
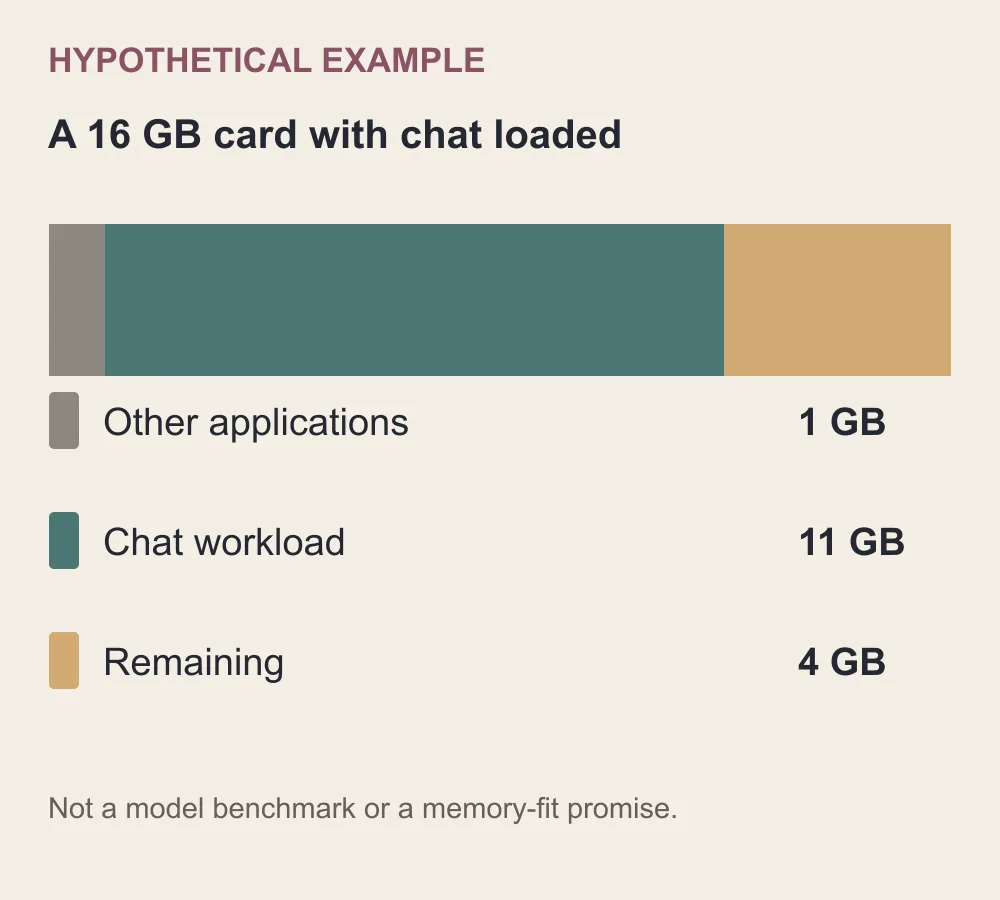
Числа только иллюстрируют ситуацию: модель, помещающаяся на свободной карте 16GB, может не поместиться рядом с LLM, уже занимающей большую её часть.
Реалистичный план следующего сеанса
Для 8GB оставьте локально одну требовательную генеративную нагрузку. Если у вас уже хорошая локальная roleplay-модель, держите её загруженной, а редкие картинки создавайте через поддерживаемый удалённый источник или во второй вкладке браузера. Если уже есть хороший локальный image-граф, остановите текстовый backend и используйте удалённый чат. Полностью локальное переключение выбирайте, когда хранение материала на своём компьютере важнее непрерывного темпа.
Для 16GB начните с такого же простого плана, если локальная LLM сейчас занимает большую часть карты. Если есть пространство для эксперимента, сначала подтвердите отдельную работу графа изображений, затем протестируйте меньший профиль чата с одной картинкой, без прохода детализации и с ограниченным контекстом. Стабильная пара полезна; конфигурация, помещающаяся лишь до разрастания разговора, ненадёжна для всего вечера.
Цель — сеанс, в котором можно читать и писать, а не постоянно перезапускать провалившиеся задачи. Дайте GPU понятную работу, подключите источник изображений по протоколу, действительно поддерживаемому SillyTavern, и сделайте первый рабочий граф достаточно небольшим для диагностики. Когда он заработает, добавляйте наиболее нужное управление персонажем или этап доработки — по одному.