Tu personaje de SillyTavern por fin escribe como quieres. Pides una imagen, ComfyUI empieza a cargar y la imagen falla o la siguiente respuesta se vuelve desesperadamente lenta. Una tarjeta de 8 GB o 16 GB puede servir perfectamente para cada trabajo por separado y sufrir con ambos activos.
Para generar imágenes NSFW en SillyTavern con poca VRAM, la primera decisión útil es qué trabajo conserva la GPU. Si importa más mantener roleplay local sin interrupción, genera imágenes remotamente. Si importan más checkpoint y LoRA locales del personaje, mueve la conversación a una API de chat. Si todo debe ser local, crea primero el prompt visual, descarga el backend de texto de memoria, genera imagen y vuelve a cargarlo. La tercera ruta conserva conversación guardada, pero no promete generación ininterrumpida mientras la GPU cambia de trabajo.
Son elecciones prácticas, no un benchmark según el cual cualquier pareja cabe en toda tarjeta 8 GB. No cronometramos una ejecución local combinada. Las conexiones proceden de documentación y código de los proyectos; el orden propuesto aísla fallos comunes sin cambiar cinco ajustes juntos.
El problema apareció claramente en una conversación SillyTavern del 2 de octubre: alguien con AMD de 16 GB ya usaba la memoria para roleplay y quería añadir Z-Image. No se trata de si Z-Image funciona en GPU de consumo, sino de si funciona con tu modelo de chat ya ocupándola.
Decide el destino de la GPU antes de descargar otro modelo
Empieza por la parte de la sesión que menos quieres interrumpir. Una conversación larga con modelo favorito, un flujo de imagen afinado y exigir que nada salga de tu computadora llevan a configuraciones distintas.
| Qué importa más | Ruta recomendada | Qué sacrificas |
|---|---|---|
| Mantener rápido tu chat local de personaje | Chat local, imágenes remotas | Prompts y referencias de imagen van al servicio |
| Conservar checkpoint, LoRA y flujo exactos de imagen | Chat remoto, ComfyUI local | La API recibe el contexto de conversación enviado |
| Mantener conversación e imágenes en tu máquina | Texto e imagen locales, por turnos | Cambiar modelos interrumpe ritmo y puede reprocesar prompt |
| Imágenes ocasionales sin otro proyecto de integración | Chat local y generador de navegador | Las imágenes se crean fuera de controles nativos SillyTavern |
Con 8 GB, normalmente conviene empezar con una sola carga de generación local. Con 16 GB hay más margen, pero la misma decisión aplica si el LLM ya usa casi toda la tarjeta. Comprar otro checkpoint cuantizado sin decidir quién usa la memoria restante suele añadir una descarga y el mismo fallo.
No confundas API de chat y backend de imagen. El modelo puede describir perfectamente un personaje adulto ficticio sin producir píxeles. Uno que acepte imágenes quizá solo las analice. API Connections ejecuta conversación; Image Generation dibuja. Son ajustes separados durante toda la guía.
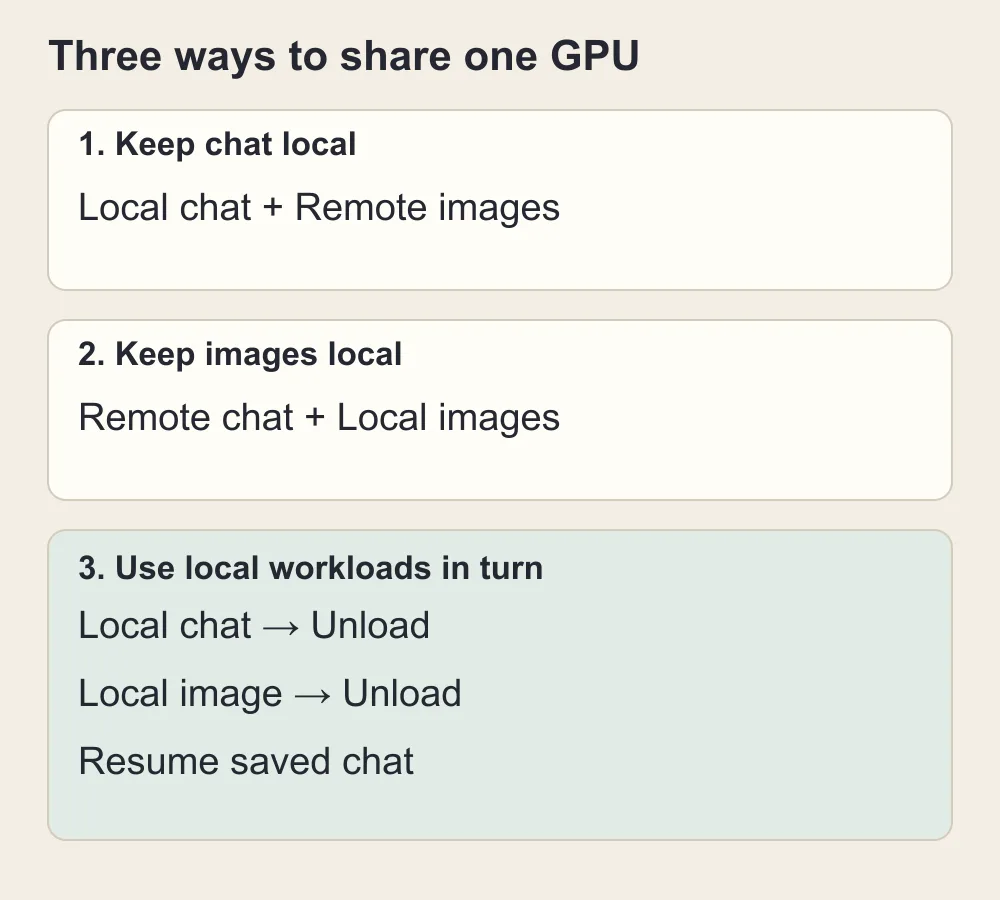
Mantén una carga remota o deja que chat e imagen locales se turnen en la GPU.
Por qué una ventana de chat inactiva puede ocupar casi toda la VRAM
Confunde que parezca inactivo: no hay respuesta generándose, baja utilización y la máquina está tranquila, pero ComfyUI no carga. Utilización mide trabajo actual; ocupación mide recursos retenidos para el próximo. Un backend puede no hacer casi nada y mantener gran asignación.
El tamaño del archivo del modelo solo explica una parte del consumo de memoria. El LLM también necesita caché de conversación y cálculos temporales. Un contexto mayor aumenta carga sin cambiar pesos. La imagen tiene sus componentes y trabajo temporal. El pico puede llegar después de cargar con éxito, no en descarga o conexión inicial.
Una explicación de un responsable de llama.cpp sobre memoria documenta asignaciones separadas de pesos, caché de contexto y buffers de cálculo. Por eso restar tamaño GGUF al número de la caja de GPU no determina bien el margen de ComfyUI.
Como ejemplo, supón 16 GB con 1 GB de escritorio y aplicaciones y 11 GB de texto. Quedan unos 4 antes de imagen. Son cifras inventadas para la aritmética, no medición Z-Image ni asignación recomendada. Decir que funciona en 16 GB no significa que funcione en esos 4 restantes.
El repositorio oficial Z-Image describe Turbo en equipos de consumo 16 GB y descarga de componentes a CPU para poca memoria. Es una declaración de despliegue de imagen. No reserva espacio para otro LLM, caché larga, adaptadores y otro proceso de inferencia simultáneo.
Antes de cambiar, mira memoria, no porcentaje GPU. En Windows abre Administrador de tareas, Rendimiento y GPU dedicada real. Distingue memoria dedicada y compartida. En otros sistemas usa herramientas del fabricante o registros de asignación. Importa qué proceso sigue cargado, no si el gráfico está momentáneamente inactivo.
Identifica la fase fallida con cuatro comprobaciones breves
Hazlo antes de otra cuantización, reinstalar o añadir nodo de descarga de modelos. Conexión y VRAM pueden parecer iguales desde chat: ambas terminan sin imagen.
Primero, prueba solo la conversación. Cierra por completo el backend de imagen, inicia tu backend de texto habitual y genera una respuesta normal de roleplay. Anota si ya es lenta. Si lo es, todavía no existe un conflicto con las imágenes: el LLM puede ser demasiado exigente, el entorno de ejecución puede ser inadecuado o el prompt puede ser demasiado grande.
Segundo, prueba solo la imagen. Detén el backend de texto, inicia ComfyUI y genera una imagen desde su interfaz con los ajustes que piensas utilizar. Si falla sin el LLM, reducir el contexto del chat no resolverá el problema. Revisa la instalación, los archivos, los nodos y la memoria necesaria para la imagen.
Tercero, conecta SillyTavern al backend de imagen funcional. Mantén LLM detenido, desactiva Extend free-mode prompts y usa un comando manual como /sd a fictional adult lounge singer age 29 in a black satin evening outfit, seated beside an amber lamp. Evita el paso adicional de escribir prompt con texto. Si ComfyUI funciona directo pero no recibe solicitud SillyTavern, revisa fuente, dirección y grafo API. No bajes resolución para arreglar URL de otro servicio.
Cuarto, repite con LLM cargado. El cambio principal es añadir texto. Si antes funciona y ahora falla, hay motivos para separar memoria. Si imagen funciona y luego chat se ralentiza, revisa modelos retenidos o texto movido a ejecución más lenta.
Una quinta comparación sirve cuando lo anterior funciona: prompt manual frente a /sd last. Este añade texto para describir la conversación reciente. Si manual llega y contextual no, puede fallar escritura de prompt, no renderizado. Negativa, respuesta vacía o descripción malformada del LLM no se arreglan liberando memoria de imagen.
Anota la fase exacta en la que falla ComfyUI: carga, codificación de texto, muestreo, decodificación o detalle posterior. Esto te orienta sobre qué etapa conviene quitar. Si falla el reescalado final, puedes posponerlo; si falla la carga del modelo principal, necesitas otro plan de memoria.
Ruta uno: conserva roleplay local y crea imágenes fuera
Es mi primera elección si te encanta el modelo local y haces pocas imágenes. Deja el texto igual. Aparta carga visual en vez de reducir conversación hasta perder la experiencia deseada.
Una fuente ya compatible con SillyTavern
Abre Extensions y Image Generation. En Source elige un servicio que realmente esté en la lista actual. Configura credenciales y modelo propios, no dirección de texto. La documentación oficial de Image Generation es referencia de fuentes y controles específicos.
Antes de automatizar, genera un retrato de un adulto con contenido moderado y no explícito. Así compruebas el servicio, las credenciales, el modelo y el resultado en conjunto. Que una integración aparezca en la lista no garantiza que todos sus modelos acepten la escena adulta que necesitas.
No sustituyas la URL específica de un servicio por la API genérica de otra empresa esperando que SillyTavern traduzca la solicitud. Aunque ambas acepten un prompt, pueden diferir en el cuerpo, los estados, el formato de respuesta, la autenticación y los errores. El campo API URL no hace que cualquier API sea intercambiable.
Coloca ComfyUI en otra computadora
Si quieres checkpoint y LoRA existentes, conserva flujo y mueve ejecución. Haz que funcione en la otra máquina, con software, archivos y nodos propios compatibles. JSON referencia componentes; no los empaqueta.
En Image Generation elige ComfyUI y Standard Server. Pon dirección accesible desde la máquina del servidor SillyTavern y Connect. Que tu teléfono abra ComfyUI no prueba que el host SillyTavern lo alcance.
En máquinas distintas, 127.0.0.1 indica la que hace solicitud, no tu otra computadora. Usa dirección real accesible. En alojamiento en línea usa conexión protegida; no necesitas exponer ComfyUI sin restricciones públicamente para casa.
Tras primer renderizado, añade flujo guardado en formato API. Conserva checkpoint y adaptadores para resultados comparables. Si GPU remota usa otra cuantización, cambia cargador, no asumas mismo comportamiento por nombre. LLM local puede seguir cargado porque imagen usa otra memoria.
Encaja si ya conoces ComfyUI. Menos si solo quieres dos imágenes esta noche y debes aprender administración. El navegador puede ser más práctico pese a menor integración.
Usa SpicyAPI junto al chat
Las tareas de imagen SpicyAPI no aparecen como fuente nativa en la implementación SillyTavern inspeccionada. Su contrato asíncrono no se pega en URL ComfyUI ni equivale a endpoint AUTOMATIC1111. Esta guía no proporciona ni afirma haber probado un adaptador intercambiable.
Puedes mantener roleplay y abrir Z-Image Spicy en otra pestaña. En Playground, introduce la descripción visual de la escena actual, elige las dimensiones, genera la imagen y descarga el resultado. La GPU local sigue disponible porque inferencia ocurre remotamente.
Para retrato inicial elige 832 por 1216 píxeles, expansión desactivada, una persona adulta ficticia con ropa y habitación concretas. Ambas dimensiones están en rango público de 256 a 1536 por lado. Es propuesta de composición, no una escena renderizada ni comparación con checkpoint local.
El servicio remoto recibe prompt y subidas. No necesita historial completo. Copia solo rasgos visibles y escena; elimina notas privadas, nombres reales y detalles innecesarios para una imagen.
Ruta dos: conserva imagen local y mueve chat a API
Elígela si has afinado imagen: checkpoint de ilustración, LoRA, pose o flujo que un navegador no reproduce. Mover texto suele ser más sencillo que reconstruir todo eso fuera.
Primero detén el backend local; cambiar solamente el selector no lo detiene. llama.cpp, Ollama u otro servidor cargado pueden mantener memoria. Guarda perfil para volver y conecta chat alojado.
SillyTavern admite chat por separado. Sigue API Connections para el protocolo. Chat Completion y Text Completion pueden ser locales o remotos; indican envío del prompt, no ubicación GPU.
Para chat SpicyAPI, nuestra guía de conexión roleplay SillyTavern da ajustes Custom OpenAI-compatible y tratamiento de parámetros por modelo. Usa esa configuración, no ID de imagen en caja de chat. Aquí liberamos GPU; no hace falta repetir ajustes de cada modelo.
Vuelve a ComfyUI y ejecuta exactamente el flujo aislado funcional. No añadas etapas porque hay memoria. Mantén primera solicitud integrada idéntica para comprobar que mover chat quitó interferencia.
El LLM alojado puede convertir escena a prompt antes de enviar flujo local. Es una solicitud de texto al servicio, sin cargar otro modelo grande en tarjeta.
El costo de esta opción está en el procesamiento remoto de la conversación y el consumo de tokens. La API recibe el contexto incluido en la solicitud: la descripción, las instrucciones, el lore seleccionado y los mensajes. Si para ti es obligatorio mantener el chat local, esto cambia dónde se procesa la conversación y no es un ajuste menor.
Observa primera respuesta tras imagen. Si vuelve rápida y ComfyUI termina, resolviste competencia principal. Si imagen sigue igual de lenta que sola, el cuello está en imagen, no conversación alojada.
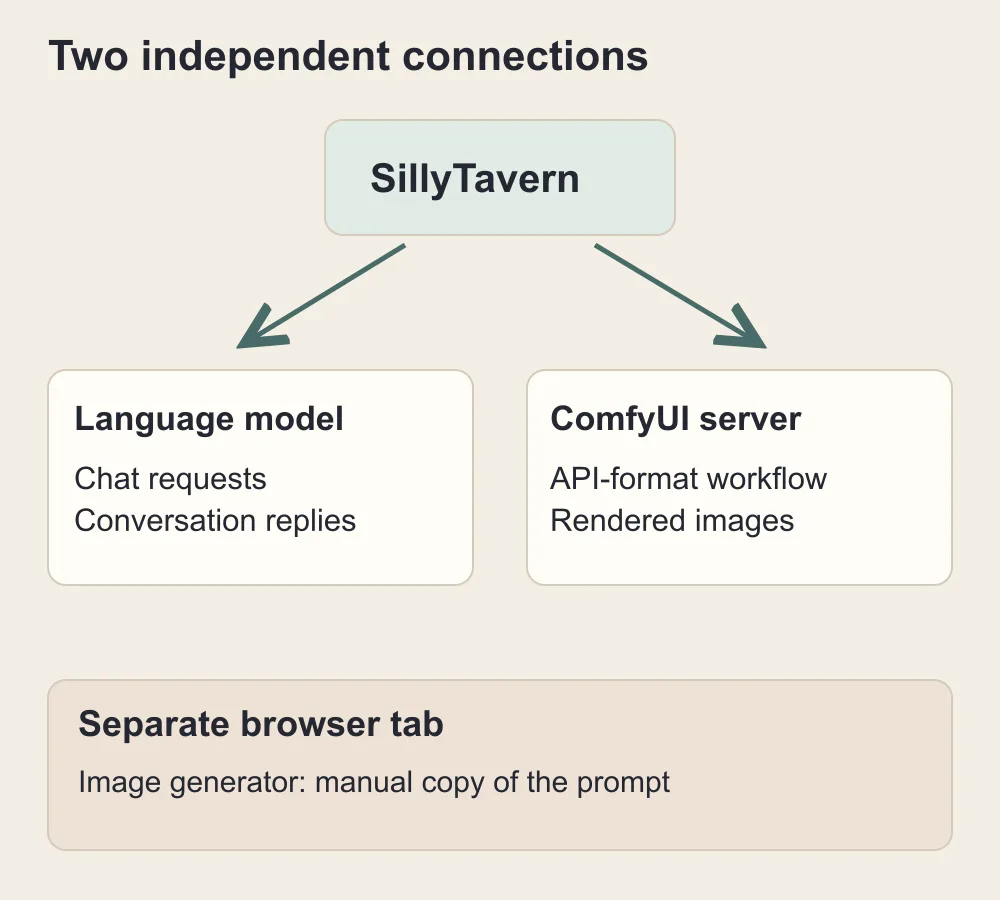
Chat e imagen son conexiones separadas. El navegador junto al chat es ruta manual, no integración ComfyUI nativa.
Ruta tres: todo local y por turnos
Si ni texto ni prompts deben salir, usa GPU secuencialmente. Trata imagen como pausa breve. No borras personaje ni reinicias conversación; cambias temporalmente quién conserva asignaciones GPU.
Conversación guardada y caché cargada son diferentes. SillyTavern retiene datos; la caché del backend acelera próxima solicitud. Detener o descargar puede descartarla. Al volver texto quizá deba procesar contexto de nuevo. La historia existe, pero primera respuesta puede tardar.
Orden de trabajo
- Termina respuesta y detén regeneración o activadores automáticos.
- Crea y guarda prompt visual con modelo de texto cargado, o escríbelo.
- Guarda chat y descripción en lugar donde copiarla.
- Descarga o detén texto y confirma caída real de memoria dedicada.
- Genera una imagen en ComfyUI con descripción guardada.
- Descarga o conserva resultado y descarga modelos ComfyUI o detén backend.
- Confirma memoria disponible, reinicia texto con ajustes guardados y reconecta si hace falta.
- Sigue el mismo chat; primera respuesta reconstruirá contexto si perdió caché.
Escribe prompt antes de descargar. Si detienes LLM y luego /sd last debe describir escena con él, quitaste el servicio de la primera mitad. Usa descripción guardada en /sd manual con Extend free-mode prompts desactivado durante imagen.
Empieza manualmente. Parar y reiniciar es menos elegante que extensión, pero prueba plan de memoria. Si sigue fallando sin proceso de texto, automatizar reproduce el fallo más rápido, no lo resuelve.
Usuarios Ollama: descarga modelo, no solo ventana
Ollama documenta stop y keep_alive. La acción manual inmediata es ollama stop YOUR_MODEL_NAME, con nombre real. Sus FAQ oficiales describen keep_alive cero en solicitudes compatibles para descargar después del uso.
Termina descripción, detén modelo y pasa a imagen. La próxima solicitud puede recargarlo. Desactiva prompts automáticos de fondo mientras ComfyUI ocupa tarjeta o volverán a cargar LLM en mal momento.
No asumas todos los parámetros Ollama desde cualquier tipo API. Usa ajuste compatible explícito o stop. Contexto genérico o campo de cuerpo personalizado no implementan automáticamente su ciclo de vida nativo.
Usuarios llama.cpp: usa su ciclo de vida
Con llama-server de un modelo, detener proceso es la vía manual más clara de liberar asignaciones. Reinícialo después con ajustes guardados. Cerrar navegador, dejar chat inactivo o cambiar nombre SillyTavern no detiene proceso separado.
Versiones recientes también gestionan modelos, pero operaciones dependen de lanzamiento y versión. Servidor de un modelo y router multimodelo son configuraciones distintas. Sigue controles de tu servidor, no una solicitud de descarga de otro backend.
Usuarios ComfyUI: liberar sus modelos no libera LLM
ComfyUI expone /free con unload_models y free_memory en su servidor oficial. Activa indicadores que maneja ejecución. No mata llama.cpp separado, y aceptar solicitud no prueba que haya devuelto ya cada byte.
Usa control de descarga de tu interfaz o instalación al terminar. Si no lo encuentras, detener backend es base manual sencilla. Cerrar pestaña no detiene servidor.
Un nodo personalizado sirve solo con orden correcto. Si se ejecuta antes de un detalle que necesita modelo, puede recargarlo. Si descarga solo ComfyUI, roleplay queda intacto. Lee documentación antes de asumir que coordina ambas apps.
Haz funcionar conexión ComfyUI antes de ajustar memoria
SillyTavern integra grafos reales, no puente universal API. Envía formato API y recoge resultado. Un flujo correcto en escritorio puede fallar con formato equivocado o prompt fijo.
Empieza dentro de ComfyUI: genera con checkpoint, codificador, VAE y nodos exactos. Guarda grafo normal para abrir visualmente. Después exporta versión API con opción de tu interfaz; nombres varían.
En SillyTavern elige ComfyUI, Standard Server y dirección impresa por servidor. La predeterminada documentada es http://127.0.0.1:8188. Va en ajuste de app; no es web pública ni dirección para publicar a otros.
Pulsa Connect, crea o selecciona el flujo y pega el grafo en formato API en el editor. Hay sustituciones como %prompt% para positivo. Úsalas donde el grafo reciba ese valor. Un JSON válido que no utilice estas sustituciones puede seguir dibujando siempre la imagen de demostración.
En CLIP Text Encode, identifica texto que alimenta condicionamiento positivo y reemplázalo. Si un cargador o nodo distinto recibe texto, sustitución va ahí. No añadas nodo desconectado para conseguir visto bueno.
Envía dos solicitudes distintas: cantante adulta de salón y habitación vacía con velas. Si ambas dan mismo sujeto, revisa grafo antes de semillas o modelos nuevos. Empieza por prompt fijo. Si solo cambia color o ambiente, revisa prefijos u otro texto con personaje original.
Ajustes de memoria útiles y engañosos
No apliques cada indicador de foro a la vez. Distingue reducir texto, imagen o retención de memoria inactiva. Cambian cosas distintas y afectan próxima respuesta de otro modo.
Acorta contexto antes de recortar calidad del personaje
Un contexto 32K o mayor puede reservar más de lo necesario. Prueba perfil menor, 4096 u 8192 tokens, si cabe ficha, instrucciones, lore y conversación reciente. Son ejemplos, no promesas de memoria para todo modelo.
Ajusta también contexto de solicitud SillyTavern al backend. Reducir solo historial del cliente quizá no reduzca caché asignada al arrancar servidor. Subir selector tampoco aumenta capacidad real. Cambia asignación en backend y reinicia o recarga según implementación.
La referencia de servidor llama.cpp documenta contexto, capas GPU, tipos de caché y descarga KV. Usa nombres de tu versión. Ajuste automático a dispositivo no promete margen para pico futuro de otra aplicación.
Reducir las capas que se ejecutan en la GPU libera espacio al trasladar parte del trabajo de texto fuera de ella, aunque puede reducir la velocidad. Cuantizar la caché es distinto de cuantizar los pesos. Un archivo Q4 no implica que la caché también use cuatro bits.
Reduce picos de imagen con renderizado sencillo
Usa un lote de una imagen. Generar varias imágenes sucesivamente no equivale a procesar un lote simultáneo. Mantén tu proporción habitual y un tamaño inicial razonable, y omite el segundo muestreo de alta resolución hasta que funcione la imagen base.
Si falla en VAE, prueba decodificación en bloques compatible. Si falla al cargar principal, eso no reduce pesos. Si solo falla detalle facial o ampliación, quita etapa del vivo y hazla después sin texto.
Lee qué significa Low VRAM en tu programa
Los argumentos actuales ComfyUI distinguen gestión dinámica e indicadores antiguos. --lowvram no hace nada con DynamicVRAM activo; sin él mueve codificadores de texto a CPU. No significa «hacer caber cualquier imagen en el espacio sobrante».
También reserva memoria y descarga más agresivamente. Reservar puede ayudar a otras apps, pero no coordina ComfyUI y chat. Si mínimos combinados no caben, no crea memoria. Prueba un cambio y repite misma imagen.
KoboldCpp tiene otros controles. Su inicio rápido SillyTavern advierte no marcar Low VRAM de la captura. Describe lanzador antiguo: consulta también tu versión. No copies un ajuste solo por nombre igual.
AMD cambia detalles, no aritmética de memoria
La pregunta reciente usaba AMD y Vulkan de llama.cpp. Hay que mirar rutas compatibles, no pegar CUDA de tutorial NVIDIA. Aceleración, formatos numéricos y operadores dependen de GPU, sistema, compilación y backend instalados.
Comprueba cada aplicación por separado. Que el texto funcione con Vulkan no demuestra que ComfyUI utilice la aceleración adecuada. Que la imagen funcione tampoco demuestra que el LLM esté compilado con el backend previsto. Durante estas pruebas aisladas, revisa los registros de inicio y el dispositivo que realmente utiliza cada aplicación.
Si ambos son rápidos solos y fallan juntos, discutir marca probablemente no arregla falta de espacio. Usa remoto o turnos. Si uno va lento solo, resuélvelo antes de simultaneidad.
Desconfía de «amigable con 8 GB» sin configuración completa. Puede excluir codificador, depender de descarga a CPU, nodo concreto o GPU libre. Lee cargador exacto y confirma cuantización compatible antes de descargar.
Haz que la imagen coincida con escena adulta sin enviar historia completa
Cuando funciona instalación, memoria ya no es única causa de decepción. El modelo de roleplay puede describir sentimientos y no lo visible. Obtienes retrato plausible que ignora habitación, ropa o acción.
Para Mara adulta ficticia, separa apariencia permanente y escena. Constantes: 29 años, bob corto oscuro, pendiente plateado tipo ear cuff, tatuaje creciente pequeño en hombro. Actual: conjunto negro de satén, sillón terciopelo, luz cálida baja, mirada lateral segura. Solo cambia segundo grupo al moverse historia.
Una descripción propuesta adaptable, sin prueba de modelo en este artículo:
Cantante ficticia adulta de salón, 29 años, bob corto oscuro y ear cuff plateado, con conjunto de noche ajustado de satén negro, sentada de lado en sillón de terciopelo borgoña profundo. Expresión segura y juguetona. Luz ámbar cálida de lámpara de mesa; salón nocturno desenfocado detrás. Retrato medio, manos relajadas visibles, ambiente editorial íntimo, sin texto.
Si pasa al balcón, cambia entorno y luz, no todos los rasgos. Si cambia ropa, dilo y quita la anterior. Vestuarios contradictorios fallan aunque el modelo siga texto lo mejor posible.
Prefijos del personaje ayudan a continuidad descriptiva, no garantizan cara. Identidad que requiera referencias o LoRA exige flujo compatible. Texto de ficha y avatar no pasan automáticamente a toda fuente visual como referencia.
Guarda descripción antes de descargar texto; reanuda chat guardado después.
Cuánto cuestan realmente imágenes remotas ocasionales
Considera navegador antes de comprar hardware solo para evitar cambios ocasionales. En catálogo público actual, Z-Image Spicy cuesta $0.01235 por imagen sin expansión y $0.0133 con expansión. Z-Image Spicy Pro cuesta $0.019. Son tarifas de imagen, no suscripciones ni chat.
| Solicitudes previstas | Spicy sin expansión | Spicy con expansión | Spicy Pro |
|---|---|---|---|
| 10 | $0.1235 | $0.133 | $0.19 |
| 50 | $0.6175 | $0.665 | $0.95 |
| 100 | $1.235 | $1.33 | $1.90 |
La tabla multiplica la tarifa publicada por el número de solicitudes; no indica cuántas solicitudes necesitarás para obtener una imagen que quieras conservar. Si haces cuatro alternativas y eliges una, presupuesta cuatro. Texto para prompts, edición y ampliación son trabajos separados.
Si quieres diez imágenes durante una noche, el costo de la parte visual es pequeño y puedes compararlo con la incomodidad de detener y recargar los modelos. Esta opción no satisface la necesidad de trabajar sin conexión, utilizar tus LoRA exactos o mantener los prompts en local; esos requisitos pueden pesar más que el ahorro.
Elige Spicy Pro si necesitas hasta 2560 píxeles por lado; ordinario si basta máximo 1536. Es diferencia de dimensiones verificada, no prueba de superioridad Pro en toda escena adulta.
Corrige el síntoma real
ComfyUI renderiza, pero SillyTavern indica imágenes no disponibles
Selecciona fuente configurada en Image Generation. Instalación nueva o antigua puede conservar una desconectada. Comprueba dirección de imagen, no API de chat. En nube usa credenciales y configuración propias. Texto funcionando no prueba conexión visual.
Prueba solicitud manual corta. Si funciona, pasa a contexto. Un activador complejo dificulta saber si fuente inaccesible o activación no coincidió.
Conecta, pero todas las imágenes parecen el ejemplo del flujo
Abre grafo API y encuentra texto positivo real. Sustituye ejemplo por variable en entrada correcta. Revisa otros campos y prefijos. Cambiar semillas solo varía prompt todavía fijo.
Falla solo con chat cargado
Conserva flujo aislado exitoso y separa memoria: imagen remota, chat alojado o turnos. Para simultáneo local, reduce asignación real de contexto o capas GPU. Repetir misma carga no cambia memoria disponible.
Primera imagen funciona y siguiente respuesta va lenta
Revisa memoria tras terminar. ComfyUI puede conservar modelos y texto pasar a memoria lenta. Descarga imagen antes de responder o muévela remotamente. Si reiniciar texto restaura velocidad, guarda perfil menor compartido en vez de competir otra vez con uno de memoria completa.
Descargaste ComfyUI y la VRAM sigue llena
Identifica proceso restante. La descarga de ComfyUI solo libera sus propios modelos; no descarga el LLM de otro proceso. Distingue caché asignada y memoria devuelta. Como comprobación manual inicial, detén de forma deliberada los procesos correspondientes y verifica la memoria antes de volver a iniciarlos.
La imagen no inicia al pedir última escena
Prueba descripción manual en modo libre sin extensión. Si funciona, revisa texto escritor: endpoint detenido, respuesta vacía o prosa en vez de formato esperado. Liberar imagen no arregla respuesta textual ausente.
Inicia y falla al acabado final
Quita detallador, segundo muestreo o ampliador y genera base. Si funciona, guarda y realiza extra sin texto. Conserva flujo elaborado para obra final sin exigirlo a cada imagen espontánea.
GPU no está llena y todo sigue lento
Revisa dispositivo acelerado real y RAM de sistema. Descargar gran parte del trabajo a la CPU puede funcionar técnicamente y, aun así, ofrecer una experiencia de chat muy lenta. Más optimización VRAM quizá añada descarga y lentitud; mover una carga fuera mejora más claramente.
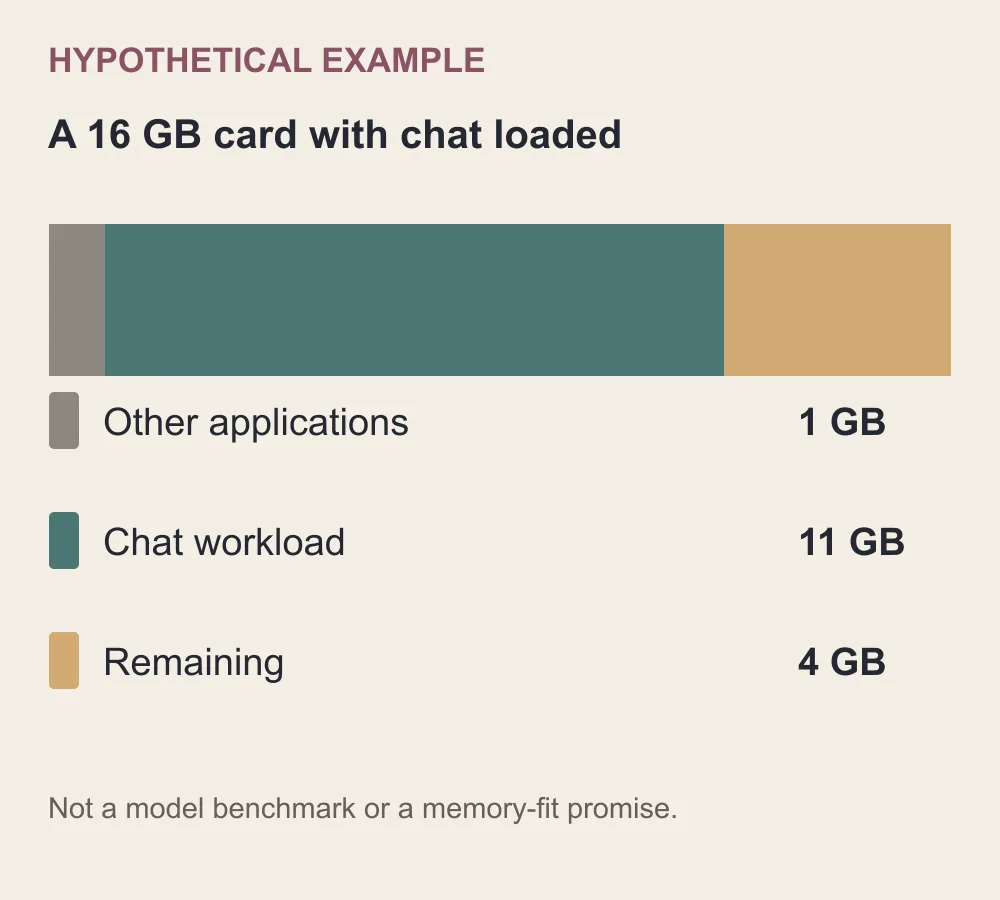
Solo ilustrativo: caber en una tarjeta libre de 16 GB no implica caber junto a LLM que ocupa casi toda.
Plan inicial realista para la próxima sesión
Con 8 GB, conserva una carga exigente local. Si tienes buen roleplay, déjalo y crea imágenes ocasionales en fuente remota compatible o pestaña. Si tienes buen flujo visual, detén texto y usa chat alojado. Elige turnos totalmente locales cuando mantener material importa más que fluidez.
Con 16 GB, usa mismo plan simple si LLM ocupa casi todo. Si experimentas, prueba primero imagen sola y luego perfil de chat menor con una imagen, sin detalle y contexto acotado. Una pareja estable sirve; caber solo antes de crecer conversación no es un plan fiable.
Busca una sesión para leer y escribir sin reiniciar fallos repetidos. Asigna trabajo claro a GPU, conecta por protocolo realmente compatible y mantén primer flujo pequeño para diagnosticar. Después añade control de personaje o acabado que más echas de menos, uno a uno.