Seu personagem no SillyTavern finalmente escreve como você quer. Você pede uma imagem, ComfyUI começa a carregar e a imagem falha ou a próxima resposta do chat fica dolorosamente lenta. Uma placa de 8GB ou 16GB pode ser perfeitamente utilizável para cada tarefa isolada e ainda sofrer quando ambas ficam ativas.
Para gerar imagens NSFW no SillyTavern com pouca VRAM, a primeira decisão mais útil é qual tarefa fica com a GPU. Se roleplay local sem interrupção importa mais, gere imagens remotamente. Se seu checkpoint de personagem e LoRAs locais de imagem importam mais, passe a conversa para uma API de chat. Se tudo precisa ficar local, gere primeiro o prompt visual, descarregue o backend de texto, renderize a imagem e recarregue o texto. A terceira rota preserva a conversa salva, mas não promete geração ininterrupta enquanto a GPU troca de tarefa.
São escolhas práticas de configuração, não um benchmark afirmando que um par específico de modelos cabe em toda placa de 8GB. Não cronometramos uma execução local conjunta para este guia. As instruções de conexão vêm da documentação e do código dos projetos, enquanto a ordem sugerida foi feita para isolar falhas comuns sem mudar cinco configurações de uma vez.
O problema apareceu claramente numa discussão de 2 de outubro no SillyTavern: um usuário com placa AMD de 16GB já usava a memória para roleplay local e queria adicionar Z-Image. A pergunta útil não é se Z-Image roda numa GPU de consumidor. É se roda com seu modelo atual de chat ainda ocupando aquela GPU.
Escolha para onde vai a GPU antes de baixar outro modelo
Comece pela parte da sessão que você menos aceita interromper. Uma conversa longa com seu modelo local favorito, um fluxo de imagem ajustado cuidadosamente e uma exigência de não enviar nada para fora do computador levam a configurações diferentes.
| O que mais importa | Rota recomendada | O que você abre mão |
|---|---|---|
| Manter responsivo seu chat local atual de personagem | Chat local, imagens remotas | Prompts de imagem e referências vão para o serviço de imagem |
| Manter checkpoint, LoRAs e fluxo locais exatos de imagem | Chat remoto, ComfyUI local | A API de chat escolhida recebe o contexto de conversa enviado |
| Manter conversa e imagens na máquina | Chat e imagens locais, em sequência | Trocar modelos interrompe o ritmo e pode exigir reprocessar o prompt |
| Imagens ocasionais, sem outro projeto de integração | Chat local e gerador de imagem no navegador | As imagens são feitas fora dos controles nativos de imagem do SillyTavern |
Quem tem 8GB normalmente deve começar com uma carga local de geração. Quem tem 16GB tem mais espaço para experimentar, mas a mesma decisão vale se o LLM atual já usa quase toda a placa. Comprar outro checkpoint quantizado antes de decidir qual carga ocupa a memória restante costuma gerar outro download e a mesma falha.
Não confunda API de chat com backend de imagem. O modelo pode escrever uma ótima descrição de personagem adulto fictício sem conseguir produzir os pixels. Um modelo que aceita imagens como entrada talvez apenas as analise. A conexão escolhida em API Connections executa a conversa; a fonte escolhida em Image Generation desenha a imagem. Trate-as como configurações separadas neste guia.
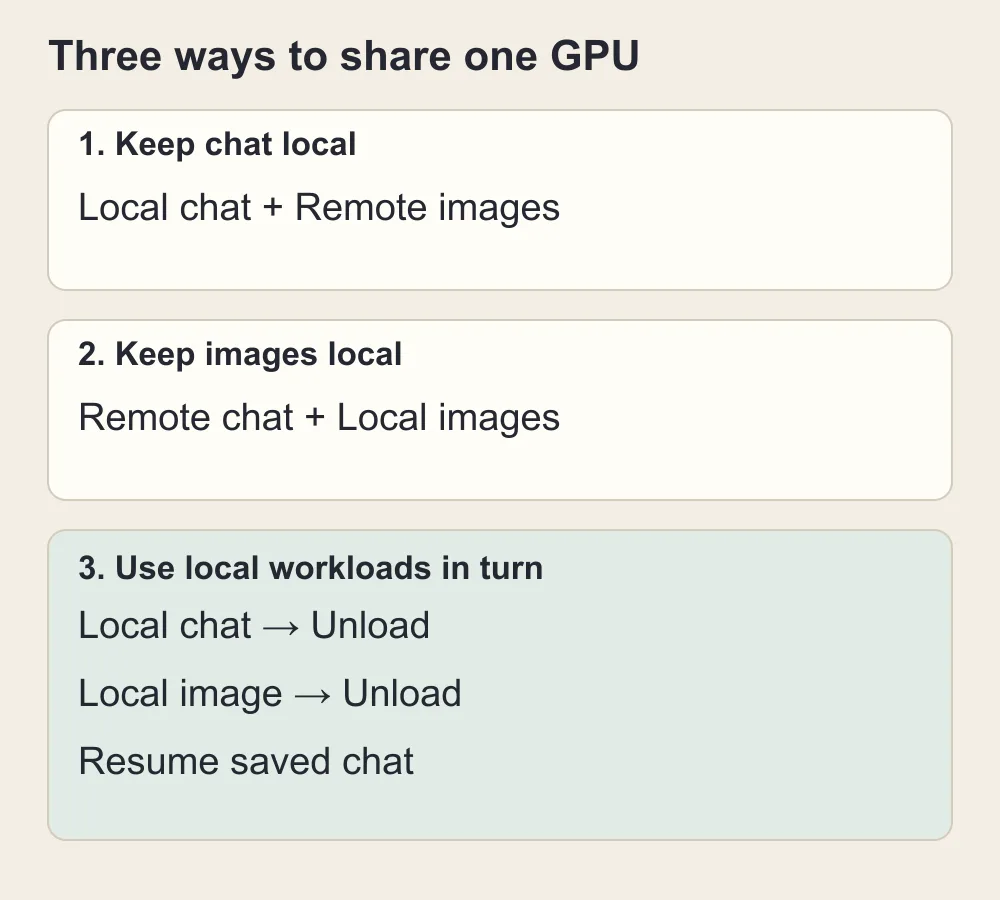
Mantenha uma carga remota ou deixe chat e imagens locais se alternarem na GPU.
Por que uma janela de chat parada ainda pode ocupar quase toda a VRAM
A parte confusa é o chat parecer inativo. Você não gera uma resposta, a utilização da GPU cai e a máquina fica silenciosa. Ainda assim, ComfyUI não consegue carregar o modelo de imagem. Utilização mede trabalho acontecendo agora; ocupação de memória mede recursos retidos para o próximo trabalho. Um backend pode fazer quase nada e manter uma grande alocação.
O tamanho do download do modelo explica apenas parte. O LLM também precisa de espaço para cache da conversa e cálculos temporários. Um contexto maior pode aumentar a carga mesmo sem mudar os pesos. Geração de imagem tem seus próprios componentes e trabalho temporário. O pico pode chegar depois de o carregamento parecer bem-sucedido, não no primeiro download ou conexão.
Essa diferença está documentada numa explicação de mantenedor do llama.cpp sobre alocação de memória: pesos, cache de contexto e buffers de cálculo são alocações separadas. Por isso, subtrair o tamanho do GGUF do número impresso na caixa da GPU é uma forma ruim de decidir se ComfyUI tem espaço.
Num orçamento ilustrativo, suponha que uma placa de 16GB tenha 1GB comprometido com desktop e outros aplicativos, enquanto o backend de texto ocupa 11GB. Restam cerca de 4GB antes da carga de imagem começar. São números inventados para explicar a conta, não uma medição de Z-Image nem alocação recomendada. Uma alegação publicada de que o modelo roda num dispositivo de 16GB não significa que rode nos 4GB restantes.
O repositório oficial Z-Image descreve Turbo rodando em dispositivos de consumidor de 16GB e oferece offloading para CPU em configurações limitadas de memória. É uma declaração de implantação do modelo de imagem. Não reserva espaço para um LLM separado de roleplay, cache de conversa longo, vários adaptadores e outro processo inferindo ao mesmo tempo.
Antes de mudar qualquer coisa, observe memória, não porcentagem da GPU. No Windows, abra o Gerenciador de Tarefas, escolha Desempenho e selecione a GPU dedicada real. Distinga memória dedicada de compartilhada. Em outros sistemas, use monitoramento do fabricante ou logs de alocação do backend. A observação importante é qual processo permanece carregado, não se o gráfico mostra a GPU momentaneamente parada.
Encontre a etapa que falha com quatro verificações curtas
Faça isso antes de tentar outra quantização, reinstalar SillyTavern ou adicionar um nó personalizado de descarregamento de modelos. Problema de conexão e problema de VRAM podem parecer idênticos no chat porque ambos terminam sem imagem.
Primeiro, teste só a conversa. Feche completamente o backend de imagem, inicie seu backend de texto habitual e gere uma resposta normal de roleplay. Registre se já está lento. Se estiver, ainda não é um problema de compartilhamento com imagens: o próprio LLM local é exigente demais, usa um backend de execução inadequado ou processa um prompt grande.
Segundo, teste só o fluxo de imagem. Pare o backend de texto, inicie ComfyUI e renderize uma imagem na própria interface dele. Use uma imagem e as configurações pretendidas do fluxo. Se falhar sem LLM local presente, reduzir o contexto de chat não resolve. Corrija primeiro instalação de imagem, arquivos ausentes, nós incompatíveis ou requisito de memória da imagem.
Terceiro, conecte SillyTavern a esse backend de imagem funcional. Mantenha o LLM parado, desative Extend free-mode prompts em Image Generation e use um comando manual como /sd a fictional adult lounge singer age 29 in a black satin evening outfit, seated beside an amber lamp. Isso ignora a etapa adicional de escrita de prompt pelo modelo de texto. Se ComfyUI funciona diretamente, mas SillyTavern nunca envia a solicitação, investigue fonte de imagem, endereço do servidor e fluxo em formato de API. Não reduza resolução para corrigir uma URL que aponta ao serviço errado.
Quarto, repita com o LLM carregado. Agora a única mudança principal é a carga adicional de texto. Se a imagem funcionava nas verificações anteriores e falha aqui, há boa razão para separar memória. Se ainda funciona, mas o chat fica muito lento depois, examine se ComfyUI reteve modelos ou se o backend de texto passou a uma execução mais lenta.
Há uma quinta comparação útil depois que essas verificações funcionarem. Compare um prompt de imagem escrito manualmente com /sd last. O segundo acrescenta uma etapa do modelo de texto que descreve a conversa recente. Se a solicitação manual chega ao ComfyUI e a contextual não, a falha pode estar na escrita do prompt, não na renderização. Recusa, resposta vazia ou descrição malformada do LLM não se corrigem liberando memória no backend de imagem.
Anote a etapa exata mostrada no ComfyUI ao falhar: carregar modelo, codificar texto, amostrar, decodificar imagem ou uma etapa posterior de detalhe. Isso informa o que remover. Um erro na ampliação final pode ser corrigido adiando-a, enquanto erro no carregamento do modelo principal exige outro plano de memória.
Rota um: mantenha roleplay local e faça imagens em outro lugar
É a rota que eu escolheria primeiro se você já gosta do modelo local de personagem e faz poucas imagens na sessão. Mantenha a configuração de texto. Tire a carga de imagem do caminho, em vez de reduzir a conversa até deixar de ser o que queria.
Uma fonte já suportada pelo SillyTavern
Abra Extensions e expanda Image Generation. Em Source, escolha um serviço que realmente apareça na lista atual de fontes compatíveis. Configure credenciais e modelo próprios da fonte, em vez de colar o endereço do modelo de texto no painel de imagem. A documentação oficial de Image Generation é a referência da lista de fontes e dos controles específicos de integração.
Depois gere um retrato modesto, sem conteúdo explícito, antes de habilitar gatilhos automáticos. Isso verifica se serviço, credenciais, modelo escolhido e tratamento do resultado funcionam juntos. Uma integração aparecer na lista não promete que todo modelo por trás dela aceite a cena adulta desejada.
Não substitua a URL de imagem específica de um serviço pela API genérica de outra empresa esperando que a integração traduza. Mesmo quando ambos aceitam prompt, podem diferir em corpo de solicitação, status do trabalho, retorno de imagem, autenticação e erros. Um campo chamado API URL não significa que toda API seja intercambiável.
Coloque ComfyUI em outro computador
Se quiser seu checkpoint e LoRAs existentes, mantenha o fluxo e mova sua execução. Comece fazendo o fluxo renderizar naquele outro computador. Ele precisa de software compatível próprio, arquivos de modelo e nós instalados. Um JSON de fluxo referencia componentes; não os inclui todos no arquivo.
No painel Image Generation do SillyTavern, selecione ComfyUI e Standard Server. Insira o endereço do ComfyUI que seja acessível a partir da máquina que executa o servidor SillyTavern e use Connect. Seu celular conseguir abrir a página remota do ComfyUI não comprova que o host do SillyTavern consiga alcançá-la.
Se os serviços rodam em máquinas diferentes, 127.0.0.1 se refere à máquina que faz a solicitação. Não encontra ComfyUI no outro computador. Use o endereço realmente acessível daquela instalação. Num host online, use conexão devidamente protegida; expor publicamente uma instância ComfyUI irrestrita é desnecessário numa configuração doméstica.
Depois da primeira renderização, adicione o fluxo salvo em formato de API. Preserve checkpoint e adaptadores se quiser resultados correspondentes. Se a GPU remota usa outra variante quantizada, atualize seu nó carregador, em vez de supor comportamento idêntico de um arquivo com nome parecido. O LLM local pode permanecer carregado porque o modelo de imagem usa a memória de outra máquina.
A rota é atraente quando você já conhece ComfyUI. É menos atraente se só quer duas imagens hoje e teria de aprender administração de servidor primeiro. Um gerador no navegador pode ser mais prático, embora menos integrado.
Use SpicyAPI ao lado do chat
As tarefas de imagem da SpicyAPI não aparecem como fonte nativa na implementação Image Generation do SillyTavern examinada. Seu contrato assíncrono de geração não pode ser colado no campo de URL ComfyUI nem tratado como endpoint de imagem AUTOMATIC1111. Este guia não fornece nem afirma ter testado um adaptador que torne esses protocolos intercambiáveis.
Ainda pode manter roleplay local aberto e usar a página Z-Image Spicy em outra aba. Abra Playground, cole a descrição visual da cena atual, defina dimensões, gere e baixe a imagem. A GPU local continua disponível ao LLM porque a inferência de imagem acontece remotamente.
Para um retrato inicial, escolha 832 por 1216 pixels, deixe expansão de prompt desativada e descreva um adulto fictício numa roupa e cômodo específicos. Ambas as dimensões estão na faixa pública Z-Image Spicy de 256 a 1536 pixels por lado. A configuração é uma composição inicial proposta, não uma afirmação de que renderizamos a cena ou comparamos sua qualidade com seu checkpoint local.
Um serviço remoto recebe o prompt visual e imagens enviadas. Não precisa enviar todo o histórico de roleplay para criar uma imagem. Copie apenas traços visíveis do personagem e a cena atual; remova notas privadas, nomes reais e detalhes desnecessários a uma imagem estática.
Rota dois: mantenha o fluxo local de imagem e passe o chat a uma API
Escolha esta rota se o modelo de imagem é a parte da configuração que você ajustou cuidadosamente. Pode ter checkpoint específico de ilustração, LoRA de personagem, controle de pose ou fluxo de cena que um serviço de navegador não reproduz. Mover o chat costuma ser mais simples que reconstruir todo esse trabalho de imagem fora.
A primeira ação é parar o backend local de texto, não apenas mudar o seletor de API. Se llama.cpp, Ollama ou outro servidor continua carregado em segundo plano, pode reter a memória que queria recuperar. Salve o perfil de conexão existente para voltar depois e conecte sua fonte hospedada de chat.
SillyTavern suporta conexões hospedadas de chat separadas das fontes de imagem. Siga a documentação API Connections do protocolo escolhido. Uma fonte de chat pode ser local ou hospedada independentemente de sua categoria se chamar Chat Completion ou Text Completion; os nomes descrevem como o prompt é enviado, não onde fica a GPU.
Para chat SpicyAPI especificamente, nosso guia de conexão de roleplay no SillyTavern fornece as configurações Custom OpenAI-compatible e o tratamento de parâmetros incompatíveis por modelo. Use aquela configuração real, em vez de inserir um ID de tarefa de imagem na caixa de modelo de chat. O objetivo principal aqui é liberar a GPU para imagens; não precisa repetir todas as configurações de modelos de chat.
Agora volte ao ComfyUI e execute o fluxo exato que funcionou isoladamente. Não adicione etapas extras imediatamente só porque a GPU parece livre. Mantenha a primeira solicitação integrada idêntica à isolada; a comparação verifica se mudar a rota de chat removeu a interferência.
Um LLM hospedado ainda ajuda no processo visual. Pode transformar a cena atual num prompt antes de SillyTavern enviar o fluxo ComfyUI local. É uma solicitação de texto, então usa o serviço de chat sem carregar outro modelo local grande na placa.
O custo é privacidade da conversa e cobrança por token. A API recebe o contexto incluído pelo SillyTavern, que pode conter descrição de personagem, instruções, lore selecionada e mensagens. Se chat exclusivamente local era um requisito inegociável, esta rota não é um pequeno ajuste técnico; muda onde o texto é processado.
Observe a primeira resposta do chat depois de cada imagem. Se agora é responsiva e ComfyUI termina sem problemas, você resolveu a principal disputa de memória da GPU. Se a imagem continua lenta da mesma forma que sozinha, o gargalo está na carga de imagem, não na conversa recém-hospedada.
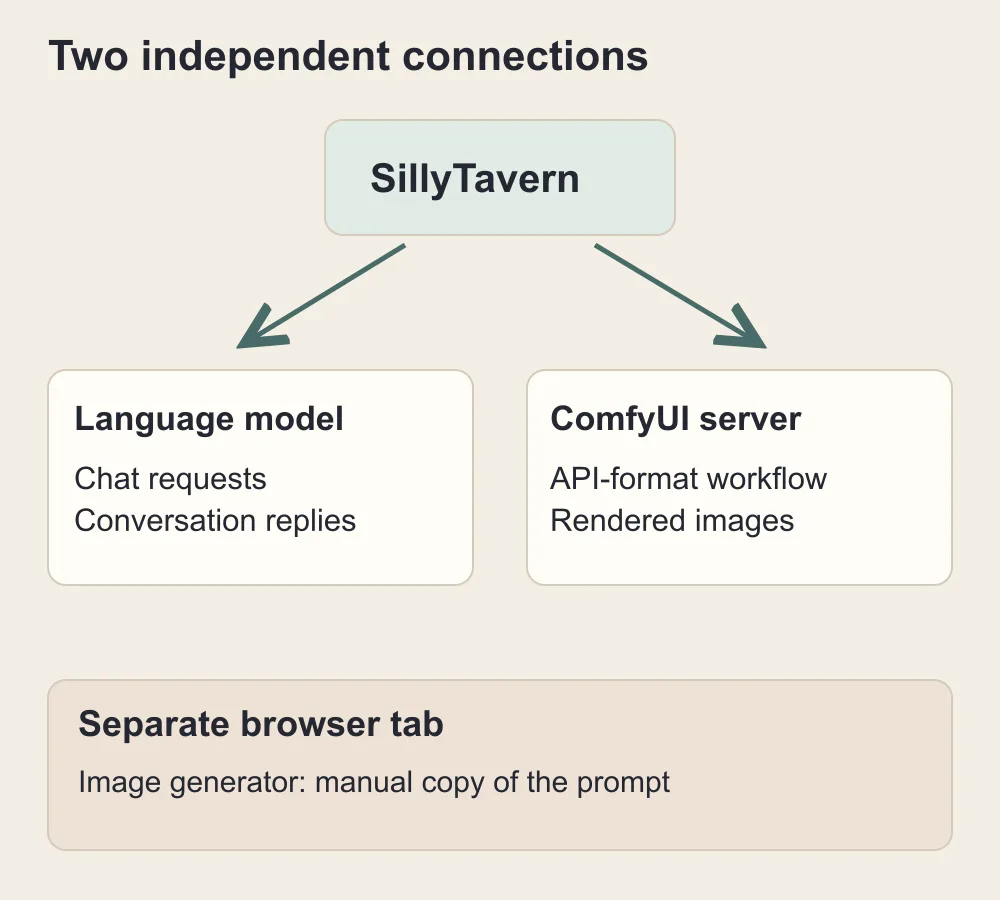
Fontes de chat e imagem são conexões separadas. Um gerador de navegador junto ao chat é uma rota manual, não uma integração nativa ComfyUI.
Rota três: mantenha tudo local e alterne
Se nem conversa nem prompts de imagem devem sair da máquina, use a GPU em sequência. Isso trata a criação de imagem como pausa curta na conversa. Você não apaga o personagem nem começa outro chat; muda temporariamente qual backend mantém as alocações da GPU.
Uma conversa salva e um cache carregado são diferentes. SillyTavern retém os dados do chat, enquanto o cache em memória do backend ajuda a processar rapidamente a próxima solicitação. Parar ou descarregar o backend pode eliminar esse cache. Quando o modelo voltar, a próxima solicitação pode precisar processar contexto de novo. A história continua disponível, mas a primeira resposta retomada pode demorar mais.
A ordem de trabalho
- Termine a resposta atual e pare qualquer regeneração automática ou gatilho de imagem que possa enviar outra solicitação.
- Crie e salve o prompt visual enquanto o modelo de texto ainda está carregado ou escreva-o manualmente.
- Salve a conversa atual e mantenha a descrição de imagem pretendida num lugar de onde possa colar.
- Descarregue ou pare o backend de texto e confirme que a memória dedicada da GPU realmente caiu.
- Execute uma imagem no ComfyUI com a descrição salva.
- Baixe ou guarde a imagem pronta e descarregue os modelos ComfyUI ou pare seu backend.
- Confirme que há memória novamente, reinicie o texto com as configurações salvas e reconecte se necessário.
- Continue a mesma conversa; espere reconstrução do contexto na primeira resposta se o cache anterior se perdeu.
A escrita do prompt vem antes do descarregamento. Se parar o LLM e depois pedir que /sd last descreva a cena naquele mesmo backend, você removeu o serviço necessário à primeira metade da solicitação de imagem. Use a descrição já salva num pedido manual /sd com Extend free-mode prompts desativado durante a fase de imagem.
Comece manualmente. Uma sequência visível de parar e reiniciar é menos elegante que uma extensão de descarregamento, mas revela se o plano fundamental de memória funciona. Se a imagem ainda falhar com o processo de texto encerrado, uma ferramenta automática de troca apenas reproduzirá a falha mais rápido.
Usuários Ollama: descarreguem o modelo, não apenas a janela
Ollama documenta um comando explícito de parada e a configuração keep_alive. A ação manual imediata é ollama stop YOUR_MODEL_NAME, usando o nome exato mostrado na instalação. Seu FAQ oficial também descreve definir keep_alive como zero em solicitações compatíveis da API para descarregar depois do uso.
Nesta configuração, termine primeiro a descrição da imagem, pare o modelo e inicie a fase de imagem. Na próxima solicitação de chat, Ollama pode carregar o modelo novamente. Desative geração automática de prompts em segundo plano enquanto ComfyUI usa a placa, ou essas solicitações podem recarregar o LLM na hora errada.
Não suponha que o cliente de chat deixe definir todo parâmetro específico do Ollama por todo tipo de API. Use uma configuração explicitamente suportada ou o comando documentado. Um controle chamado contexto ou campo genérico de corpo personalizado não implementa automaticamente os controles nativos de ciclo de vida do Ollama.
Usuários llama.cpp: usem o ciclo de vida do próprio backend
Se inicia um processo llama-server de modelo único, pará-lo é a forma manual mais clara de liberar alocações antes de carregar o fluxo de imagem. Depois reinicie com as mesmas configurações de inicialização salvas. Não dependa de fechar o navegador, deixar o chat parado ou mudar o nome do modelo selecionado no SillyTavern para encerrar outro processo.
Versões recentes do servidor llama.cpp também expõem gerenciamento de modelos, mas as operações disponíveis dependem de como iniciou o servidor e da versão instalada. Inicialização de modelo único e roteador de vários modelos são configurações diferentes. Use os controles documentados para o servidor real; não copie uma solicitação de descarregamento de outro backend.
Usuários ComfyUI: liberar seus modelos não libera o LLM
ComfyUI expõe uma operação /free com controles unload_models e free_memory na implementação oficial do servidor. Ela define sinalizadores tratados pelo sistema de execução. Não é uma instrução para encerrar um processo llama.cpp separado, e uma solicitação aceita não comprova que todos os bytes pedidos já foram liberados.
Use o controle de descarregamento disponível na interface ou instalação ComfyUI ao terminar. Se não encontrar um controle apropriado, parar o backend ComfyUI é uma base manual simples. Fechar apenas sua aba não para o processo do servidor.
Um nó personalizado de descarregamento pode ajudar, mas só com ordem de execução correta. Se rodar antes de uma etapa posterior de detalhes que ainda precisa do modelo, ele pode ser recarregado. Se descarrega apenas modelos do próprio ComfyUI, o backend de roleplay permanece intacto. Leia a documentação do nó antes de supor que coordena os dois aplicativos.
Faça a conexão ComfyUI funcionar antes de ajustar memória
O suporte ComfyUI do SillyTavern é uma integração real de fluxo, não uma ponte universal de APIs de imagem. Envia um grafo em formato de API a um servidor ComfyUI e obtém o resultado. Um fluxo correto no desktop ainda pode falhar pelo SillyTavern se você exportou o formato errado ou deixou o prompt fixo.
Comece no próprio ComfyUI. Renderize uma imagem com checkpoint, encoder de texto, VAE e nós instalados exatos que pretende usar. Salve o fluxo comum para reabri-lo visualmente depois. Exporte então a versão API pela opção disponível na interface; nomes de menus podem variar conforme a versão.
No SillyTavern, escolha ComfyUI em Image Generation, selecione Standard Server numa instalação local normal e use o endereço impresso pelo servidor ComfyUI. O padrão documentado é http://127.0.0.1:8188. Esse endereço local pertence à configuração do aplicativo; não é um site público nem um endereço para publicar a outra pessoa.
Escolha Connect, crie ou selecione o fluxo pretendido e coloque o grafo em formato de API no editor de fluxo. A integração fornece substituições como %prompt% para o prompt positivo. Use-as apenas onde o grafo realmente recebe o valor correspondente. Um fluxo sem substituições pode ser JSON ComfyUI válido e ainda desenhar o prompt original de demonstração toda vez.
Num grafo com CLIP Text Encode, encontre o campo de texto real que alimenta o condicionamento positivo e substitua a descrição de teste pela substituição de prompt. Se um carregador personalizado ou outro nó recebe o texto, a substituição pertence ali. Não adicione um nó desconectado só para o editor exibir uma verificação verde.
Envie então duas solicitações visuais deliberadamente diferentes: primeiro a cantora adulta da sala, depois um cômodo vazio à luz de velas. Se ambas produzirem o mesmo sujeito, examine o grafo exportado antes de mudar seeds ou instalar outro modelo. O prompt fixo é o ponto provável para começar. Se mudar só cor ou atmosfera, confira se outro prefixo ou campo ainda contém a descrição original do personagem.
Configurações de memória que vale mudar — e as que enganam
Não aplique todas as opções de otimização de um comentário de fórum de uma vez. Precisa saber se está reduzindo a carga de texto, a de imagem ou mudando como memória não usada é retida. São intervenções diferentes, com efeitos distintos na próxima resposta.
Encurte o contexto do backend de texto antes de reduzir qualidade do personagem
Um contexto de 32K ou mais pode reservar mais espaço que a sessão atual precisa. Experimente um perfil salvo com contexto menor no backend, como 4096 ou 8192 tokens, se ainda acomodar ficha, instruções, lore relevante e conversa recente. São tamanhos de exemplo, não promessa de caber na memória para qualquer modelo.
Defina também o contexto solicitado pelo SillyTavern de forma adequada ao backend. Reduzir apenas o histórico enviado pelo cliente pode não diminuir um cache alocado ao iniciar o servidor. Aumentar o controle do cliente também não aumenta magicamente a capacidade real do servidor. Se a configuração trata de alocação no backend, mude-a nele e reinicie ou recarregue conforme a implementação exige.
A referência do servidor llama.cpp documenta contexto, camadas de GPU, tipos de cache e offloading KV. Use os nomes da ajuda da versão instalada. Em particular, ajustar automaticamente um modelo de texto ao dispositivo não promete deixar espaço suficiente para o pico futuro de imagem de outro aplicativo.
Reduzir camadas de GPU move parte da inferência de texto para fora da GPU. Isso pode liberar espaço ao custo de processamento mais lento. Quantizar cache de conversa é um controle diferente de escolher um arquivo de modelo quantizado. Não suponha que pesos Q4 signifiquem cache armazenado em quatro bits.
Reduza picos de imagem com uma renderização mais simples
Use tamanho de lote um. Gerar várias imagens em sequência é diferente de pedir ao fluxo um lote simultâneo. Mantenha a proporção habitual do modelo e um tamanho inicial razoável, evitando outra passagem de amostragem de alta resolução até a imagem básica funcionar.
Se um grafo falha na decodificação VAE, pode valer tentar um decodificador em blocos suportado. Se falha carregando o modelo principal, decodificação em blocos não diminui esses pesos. Se falha só no detalhamento facial ou ampliação, remova essa etapa do fluxo ao vivo e execute-a depois com o texto parado.
Leia o que Low VRAM significa no programa real
As definições atuais de argumentos ComfyUI distinguem gerenciamento dinâmico de memória das opções antigas. --lowvram não faz nada quando DynamicVRAM está ativo; sem ele, move encoders de texto para CPU. Seu significado é mais restrito que “faça qualquer modelo de imagem caber no espaço livre restante”.
ComfyUI também oferece opções para reservar memória e offloading mais agressivo. Reservar espaço pode ajudar a deixá-lo disponível a outros programas, mas não cria um agendador compartilhado entre ComfyUI e backend de chat. Se as cargas mínimas combinadas não cabem, uma reserva não fabrica memória extra. Teste uma mudança e repita a mesma solicitação de uma imagem.
KoboldCpp usa outros controles. Seu guia rápido SillyTavern alerta especificamente para não marcar a caixa Low VRAM mostrada. A página descreve um inicializador antigo; consulte também a ajuda da versão instalada. A lição prática é não copiar uma configuração apenas porque outro aplicativo usa o mesmo nome.
Uma placa AMD muda os detalhes de configuração, não a conta de memória
A pergunta recente da comunidade envolvia AMD e o backend Vulkan do llama.cpp. É motivo para observar caminhos de execução suportados, em vez de colar um comando CUDA de um tutorial NVIDIA. Aceleração, formatos numéricos e suporte a operadores dependem de GPU, sistema operacional, build e backend realmente instalados.
Primeiro confirme que cada aplicativo funciona sozinho na placa. Uma execução de texto Vulkan bem-sucedida não comprova que ComfyUI esteja usando um backend adequado de imagem acelerada. Um modelo de imagem funcionando tampouco comprova que o LLM foi compilado com o backend pretendido. Observe mensagens de início e o dispositivo real usado nas verificações isoladas.
Se texto é rápido sozinho e imagens são rápidas sozinhas, mas a execução conjunta falha, mudar a discussão sobre marca de GPU provavelmente não resolve a falta básica de espaço. Mantenha uma carga remota ou alterne. Se um aplicativo é lento até sozinho, resolva-o antes de pesquisar execução simultânea.
Tenha cuidado com um modelo de imagem quantizado descrito como “adequado a 8GB” sem especificar toda a configuração. A descrição pode excluir encoder de texto, depender de offloading, usar um nó personalizado específico ou supor GPU livre. Antes de baixar, leia os requisitos exatos do carregador e confirme que o backend instalado suporta a quantização.
Faça a imagem combinar com a cena adulta sem enviar a história inteira
Depois de a configuração funcionar, memória já não é o único motivo de uma imagem decepcionar. O modelo de roleplay pode escrever o que o personagem sente, em vez do que uma câmera vê. Isso produz um retrato plausível que ignora cômodo, roupa ou ação atual.
Para uma adulta fictícia chamada Mara, separe aparência permanente de cena atual. Fatos permanentes podem ser idade de 29 anos, bob escuro curto, ear cuff prateado e pequena tatuagem de crescente no ombro. Fatos atuais podem ser roupa preta de cetim, poltrona de veludo, luz baixa quente e olhar lateral confiante. Só o segundo grupo deve mudar porque a história passou a outro cômodo.
Aqui está uma descrição visual proposta para adaptar; não foi usada como teste de modelo neste artigo:
Uma cantora adulta fictícia de lounge, 29 anos, com bob escuro curto e ear cuff prateado, usando roupa de noite preta ajustada de cetim, sentada de lado numa poltrona de veludo bordô profundo. Sua expressão é confiante e divertida. Luz âmbar quente vem de uma luminária de mesa, com um lounge de fim de noite suavemente desfocado atrás. Retrato médio, mãos relaxadas e visíveis, atmosfera editorial íntima, sem letras.
Se a personagem saiu da sala para uma varanda, mude ambiente e luz em vez de reescrever todos os traços identificadores. Se a roupa mudou na conversa, descreva claramente a nova e remova a antiga. Descrições conflitantes de roupa podem produzir a cena errada mesmo quando o modelo segue o texto o melhor possível.
Prefixos específicos de personagem podem ajudar na continuidade descritiva, mas não garantem o mesmo rosto. Uma identidade visual importante o suficiente para exigir referências correspondentes ou LoRA dedicado precisa de um fluxo que suporte esse método. O texto da ficha e seu avatar não viram automaticamente referência de entrada de toda fonte de imagem.
Salve a descrição visual antes de descarregar o texto; retome o chat salvo depois.
Quanto imagens remotas ocasionais realmente custam
Vale considerar uma rota de imagem no navegador antes de comprar hardware só para evitar troca ocasional de modelos. No catálogo público atual da SpicyAPI, Z-Image Spicy custa $0.01235 por imagem com expansão de prompt desativada e $0.0133 com expansão ativa. Z-Image Spicy Pro custa $0.019 por imagem. São tarifas de imagem, não assinaturas nem custo de chat hospedado.
| Solicitações de imagem planejadas | Spicy, expansão desativada | Spicy, expansão ativa | Spicy Pro |
|---|---|---|---|
| 10 | $0.1235 | $0.133 | $0.19 |
| 50 | $0.6175 | $0.665 | $0.95 |
| 100 | $1.235 | $1.33 | $1.90 |
A conta é a multiplicação simples da tarifa por imagem exibida. Não estima quantas tentativas produzirão uma imagem que você guardará. Se fizer quatro alternativas e guardar uma, reserve orçamento para as quatro gerações solicitadas. Chamadas de chat para escrever prompts, edições posteriores e ampliação são trabalhos separados se adicioná-los.
Para dez imagens numa sessão, o componente de imagem anunciado é pequeno o suficiente para comparar com o incômodo de parar e recarregar o modelo local. Isso não decide a escolha se precisar de uso offline, LoRAs locais exatos ou prompts mantidos na máquina. Esses requisitos podem superar um preço baixo por imagem.
Escolha a página Spicy Pro se precisar de sua faixa pública de dimensões até 2560 pixels por lado; escolha Spicy comum se o máximo de 1536 pixels por lado atender ao retrato. O limite público maior é uma diferença verificada de recurso, não prova de que Pro seja melhor em toda cena adulta.
Corrija o sintoma que realmente vê
ComfyUI renderiza, mas SillyTavern diz que imagens estão indisponíveis
Abra Image Generation e selecione uma fonte configurada. Uma instalação nova ou antiga pode manter uma fonte desconectada. Confira o endereço daquele painel de imagem, não a URL da API de chat. Se a fonte é um serviço de nuvem, use suas próprias credenciais e configuração de imagem. Uma conexão de texto funcionando não estabelece conexão de imagem.
Depois tente uma solicitação manual curta. Se funcionar, avance para prompts derivados do contexto. Começar com gatilho automático elaborado dificulta saber se a fonte é inacessível ou se o gatilho nunca correspondeu à mensagem.
SillyTavern conecta, mas toda imagem parece o exemplo do fluxo
Abra o fluxo em formato de API e encontre o texto positivo realmente usado pelo grafo. Substitua o exemplo fixo pela substituição de prompt na entrada real. Confira outros campos e prefixos ativos com o sujeito antigo. Mudar seeds só dá versões diferentes do prompt ainda fixo.
A imagem falha apenas com o modelo de chat carregado
Mantenha intacto o fluxo que funcionou isoladamente e escolha separação de memória: imagens remotas, chat hospedado ou uso local sequencial. Se quiser execução local simultânea, reduza primeiro a alocação real de contexto ou camadas de GPU do backend. Não repita a mesma carga combinada esperando outra quantidade de memória disponível.
A primeira imagem funciona e a próxima resposta do chat fica lenta
Examine memória depois de a imagem terminar. ComfyUI pode reter modelos para reutilização rápida, enquanto o texto pode ter movido trabalho para memória mais lenta. Descarregue a carga de imagem finalizada antes da próxima resposta ou mova imagens para serviço remoto. Se reiniciar o chat restaurar a velocidade, preserve um perfil menor de uso compartilhado em vez de colocar novamente o perfil de memória completa em disputa.
Você descarregou ComfyUI, mas a VRAM ainda parece cheia
Identifique o processo com a alocação restante. ComfyUI libera seus modelos; não descarrega o LLM de outro aplicativo. Distinga também cache alocado de memória realmente devolvida ao dispositivo. Na base manual, pare deliberadamente os processos de backend e confira a mudança antes de iniciar qualquer um novamente.
A imagem não começa depois de pedir a última cena
Tente a mesma cena como solicitação manual de imagem em modo livre com extensão de prompt desativada. Se funcionar, examine a escrita de prompt pelo texto. Seu endpoint pode estar parado, a resposta vazia ou as instruções gerando prosa em vez do formato esperado pelo fluxo. Liberar memória de imagem não corrige uma resposta de texto ausente.
A renderização começa e falha no polimento final
Remova detalhador, segunda amostragem ou ampliador do grafo ao vivo e renderize a imagem-base. Se funcionar, salve-a e faça a etapa extra separadamente com texto descarregado. Pode manter o fluxo elaborado para arte final sem exigir que toda imagem espontânea de chat o use.
A GPU não está cheia, mas tudo continua muito lento
Confira se a carga real usa o dispositivo acelerado pretendido e se a RAM do sistema está esgotada. Offloading pesado para CPU pode tornar a configuração tecnicamente funcional, mas desagradável numa conversa ao vivo. Nesse caso, outra otimização de VRAM pode trocar velocidade por ainda mais offloading; mover uma carga para serviço remoto pode melhorar de forma mais clara.
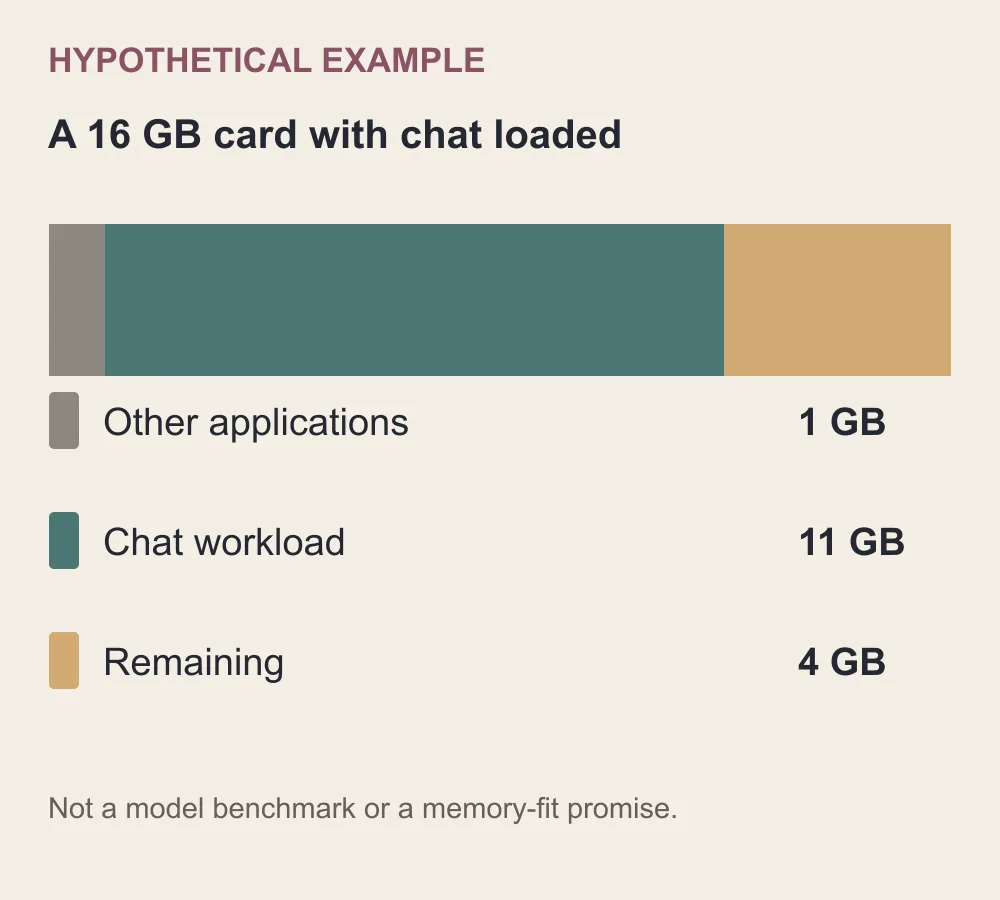
Números apenas ilustrativos: um modelo que cabe numa placa livre de 16GB pode não caber junto a um LLM que já ocupa quase toda a memória.
Um plano inicial realista para a próxima sessão
Com 8GB, mantenha local uma carga exigente de geração. Se já tem um bom modelo local de roleplay, deixe-o carregado e faça imagens ocasionais por fonte remota compatível ou outra aba. Se já tem um bom fluxo local de imagem, pare o texto e use chat hospedado. Escolha a troca inteiramente local quando manter o material na própria máquina importar mais que um ritmo sem pausas.
Com 16GB, comece pelo mesmo plano simples se o LLM ocupa quase toda a placa. Se houver espaço para experimentar, comprove primeiro que a imagem funciona sozinha e depois teste um perfil menor de chat com uma imagem, sem etapa de detalhe e contexto limitado. Um par estável é útil; uma configuração que cabe só antes de a conversa crescer não é um plano confiável para a sessão.
O objetivo é uma sessão em que você continue lendo e escrevendo, em vez de reiniciar repetidamente tarefas que falham. Dê uma função clara à GPU, conecte a fonte por um protocolo realmente suportado pelo SillyTavern e mantenha o primeiro fluxo ao vivo pequeno o suficiente para diagnosticar. Depois acrescente o controle de personagem ou a finalização de que mais sente falta, uma etapa por vez.