Il personaggio SillyTavern scrive finalmente come desideri. Chiedi un'immagine, ComfyUI comincia a caricare e l'immagine fallisce oppure la risposta chat successiva diventa dolorosamente lenta. Una scheda da 8 GB o 16 GB può essere perfettamente utilizzabile per ciascun compito separatamente e faticare quando entrambi sono attivi.
Per generare immagini NSFW in SillyTavern con poca VRAM, la prima decisione più utile è quale lavoro possa mantenere la GPU. Se conta soprattutto un roleplay locale senza interruzioni, genera immagini da remoto. Se contano soprattutto checkpoint e LoRA locali del personaggio, sposta la conversazione su un'API chat. Se tutto deve restare locale, genera prima il prompt visivo, scarica dalla memoria il backend testuale, crea l'immagine e poi ricarica il backend. Il terzo percorso conserva la conversazione salvata, ma non promette generazione ininterrotta mentre la GPU cambia compito.
Sono scelte pratiche, non un benchmark secondo cui una coppia particolare di modelli entra in ogni scheda da 8 GB. Non abbiamo cronometrato un'esecuzione locale combinata per questa guida. Le istruzioni di collegamento vengono da documentazione e sorgenti dei progetti; l'ordine proposto isola errori comuni senza cambiare cinque impostazioni contemporaneamente.
Il problema emergeva chiaramente in una discussione SillyTavern del 2 ottobre: un utente con scheda AMD 16 GB occupava già la memoria per roleplay locale e voleva aggiungere Z-Image. La domanda utile non è se Z-Image giri su una GPU consumer, ma se possa girare con il tuo modello chat ancora su quella GPU.
Scegli a cosa destinare la GPU prima di scaricare un altro modello
Parti dall'aspetto della serata che vuoi meno interrompere. Una conversazione lunga con il modello locale preferito, un workflow immagini curato e il requisito che nulla lasci il computer portano a configurazioni diverse.
| Cosa conta di più | Percorso consigliato | A cosa rinunci |
|---|---|---|
| Chat locale del personaggio reattiva | Chat locale, immagini remote | Prompt visivi ed eventuali riferimenti vanno al servizio immagini |
| Checkpoint, LoRA e workflow immagini locali esatti | Chat remota, ComfyUI locale | L'API chat riceve il contesto inviato |
| Conversazione e immagini sulla tua macchina | Chat e immagini locali usate in sequenza | Il cambio di modello interrompe il ritmo e può richiedere di rielaborare il prompt |
| Immagini occasionali senza altro progetto d'integrazione | Chat locale più generatore nel browser | Immagini create fuori dai controlli nativi SillyTavern |
Con 8 GB conviene normalmente partire da un solo carico generativo locale. Con 16 GB puoi sperimentare di più, ma la decisione resta se l'LLM occupa già quasi tutta la scheda. Acquistare un altro checkpoint quantizzato prima di decidere a chi assegnare la memoria restante porta spesso a un altro download e allo stesso errore.
Non confondere un'API chat con un backend immagini. Il modello può descrivere benissimo un adulto di fantasia senza poter produrre pixel. Un modello che accetta immagini può limitarsi ad analizzarle. La connessione scelta in API Connections esegue la conversazione; la fonte scelta in Image Generation disegna l'immagine. Tienile separate per tutta la guida.
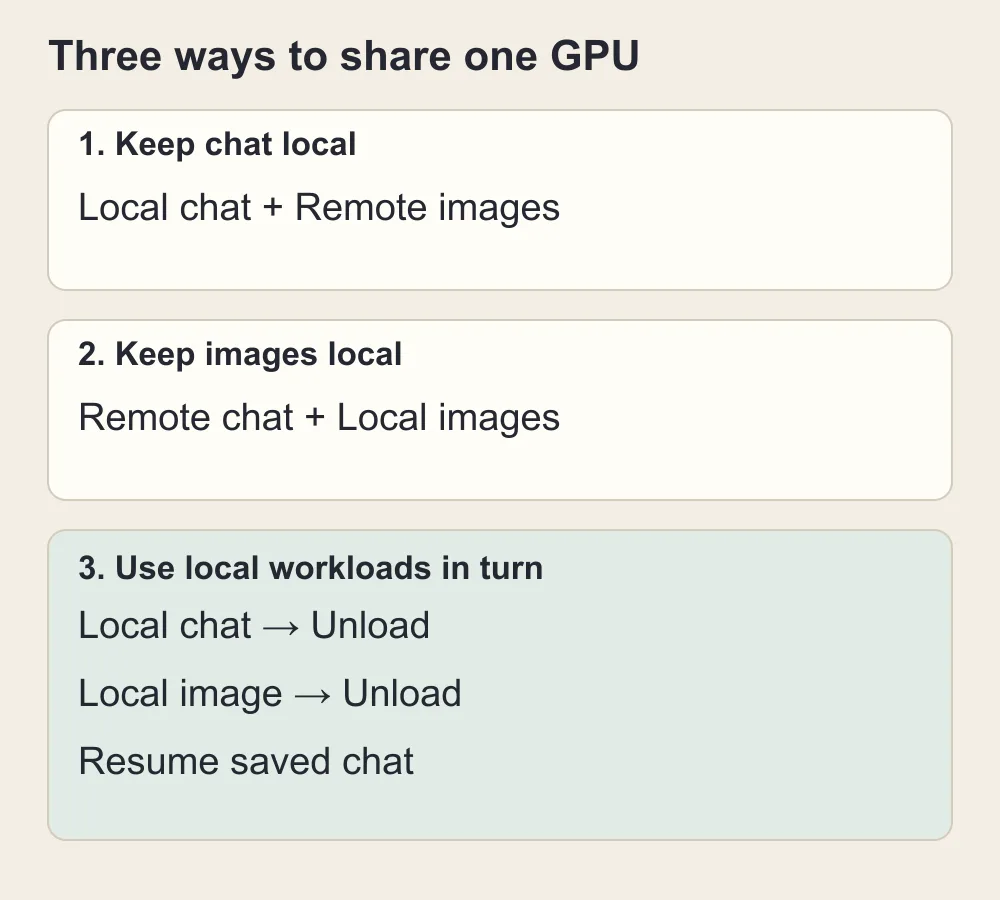
Mantieni un carico remoto oppure lascia che chat e immagini locali usino la GPU a turno.
Perché una chat inattiva può ancora occupare quasi tutta la VRAM
La parte confusa è che la chat sembra inattiva. Non generi risposte, l'utilizzo GPU cala e la macchina è silenziosa. Eppure ComfyUI non carica il modello immagini. L'utilizzo misura il lavoro attuale; l'occupazione della memoria misura risorse trattenute per il prossimo lavoro. Un backend può fare quasi nulla mantenendo un'allocazione grande.
Le dimensioni del download spiegano solo una parte. L'LLM richiede spazio per cache della conversazione e calcoli temporanei. Un contesto più grande può aumentare il peso senza cambiare i pesi del modello. La generazione immagini ha componenti e lavoro temporaneo propri. Il picco può arrivare dopo un caricamento apparentemente riuscito, non al primo download o collegamento.
La distinzione è documentata nella spiegazione di un manutentore llama.cpp sulle allocazioni: pesi, cache del contesto e buffer di calcolo sono allocazioni separate. Per questo sottrarre le dimensioni GGUF dal numero sulla confezione della GPU è un metodo debole per capire se ComfyUI abbia spazio.
Come esempio, supponi che una scheda 16 GB abbia 1 GB dedicato a desktop e altre app e il backend testuale occupi 11 GB. Restano circa 4 GB prima del lavoro immagini. Sono numeri inventati per spiegare il calcolo, non una misurazione di Z-Image o un'allocazione consigliata. Dichiarare che un modello gira su 16 GB non significa che giri nei 4 GB rimasti.
Il repository ufficiale Z-Image descrive Turbo su dispositivi consumer entro 16 GB e offre offloading CPU per configurazioni limitate. È una dichiarazione sul modello immagini. Non riserva spazio a un LLM di roleplay separato, lunga cache, diversi adapter e un altro processo d'inferenza simultaneo.
Prima di cambiare qualcosa, guarda la memoria invece della percentuale GPU. Su Windows apri Gestione attività, Prestazioni e la GPU discreta reale. Distingui memoria dedicata e condivisa. Altrove usa strumenti del produttore GPU o log di allocazione del backend. Conta quale processo resta caricato, non se il grafico dica che la GPU è momentaneamente inattiva.
Trova la fase che fallisce con quattro brevi controlli
Fallo prima di provare una quantizzazione, reinstallare SillyTavern o aggiungere un nodo personalizzato di scaricamento. Un problema di connessione e uno di VRAM possono sembrare identici dalla chat: entrambi finiscono senza immagine.
Primo, prova la conversazione da sola. Chiudi completamente il backend immagini, avvia quello testuale consueto e genera una normale risposta roleplay. Annota se è già lenta. Se sì, non hai ancora un problema di condivisione con le immagini: l'LLM è troppo pesante, usa un backend d'esecuzione inadatto o elabora un prompt grande.
Secondo, prova il workflow immagini da solo. Ferma il backend testuale, avvia ComfyUI e crea un'immagine nella sua interfaccia. Usa un'immagine e le impostazioni previste. Se fallisce senza LLM presente, ridurre il contesto chat non lo risolve. Correggi prima installazione, file mancanti, nodi non supportati o requisito di memoria immagini.
Terzo, collega SillyTavern al backend immagini funzionante. Mantieni fermo l'LLM, disattiva Extend free-mode prompts in Image Generation e usa un comando manuale come /sd a fictional adult lounge singer age 29 in a black satin evening outfit, seated beside an amber lamp. Salta così il passaggio aggiuntivo del modello testuale che scrive il prompt. Se ComfyUI funziona direttamente ma SillyTavern non invia mai, controlla fonte immagini, indirizzo server e workflow in formato API. Non ridurre la risoluzione per correggere un URL che punta al servizio sbagliato.
Quarto, ripeti con l'LLM caricato. L'unico grande cambiamento è ora il carico testuale aggiuntivo. Se l'immagine funzionava prima e qui fallisce, hai buone ragioni per separare la memoria. Se funziona ma la chat rallenta molto dopo, esamina se ComfyUI mantiene modelli o il backend testuale passa a un'esecuzione più lenta.
Dopo questi controlli c'è un quinto confronto utile. Confronta un prompt manuale con /sd last. Quest'ultimo aggiunge un passaggio testuale che descrive la conversazione recente. Se la richiesta manuale arriva a ComfyUI ma quella contestuale no, l'errore può essere nella scrittura del prompt anziché nel rendering. Rifiuto, risposta vuota o descrizione malformata dell'LLM non si correggono liberando memoria nel backend immagini.
Annota la fase esatta mostrata da ComfyUI: caricamento del modello, codifica del testo, campionamento, decodifica o rifinitura successiva. Ti dice cosa rimuovere. Un errore nell'upscaling finale può risolversi rinviandolo; uno nel caricamento principale richiede un piano di memoria diverso.
Percorso uno: mantieni il roleplay locale, crea immagini altrove
Lo sceglierei per primo se ami già il modello locale e crei poche immagini per sessione. Lascia invariato il testo. Sposta il carico immagini invece di restringere la conversazione finché non è più quella desiderata.
Una fonte già supportata da SillyTavern
Apri Extensions ed espandi Image Generation. In Source scegli un servizio realmente presente nell'elenco attuale. Configura credenziali e modello di quella fonte anziché incollare l'indirizzo testuale nel pannello immagini. La documentazione ufficiale Image Generation è il riferimento per elenco e controlli specifici.
Genera poi un ritratto modesto non esplicito prima di attivare trigger automatici. Verifichi insieme servizio, credenziali, modello e gestione del risultato. Essere nell'elenco non promette che ogni modello dietro quell'integrazione accetti la scena adulta desiderata.
Non sostituire un URL immagini specifico del servizio con l'API generica di un'altra azienda aspettandoti la traduzione dell'integrazione. Anche accettando entrambi un prompt possono differire body, stati dei job, ritorno immagini, autenticazione ed errori. Un campo API URL non significa intercambiabilità universale.
Metti ComfyUI su un altro computer
Se vuoi checkpoint e LoRA esistenti, conserva il workflow e spostane l'esecuzione. Fallo prima funzionare sull'altro computer. Servono software compatibile, modelli e nodi installati propri. Il JSON fa riferimento ai componenti, non li include tutti nel file.
Nel pannello Image Generation seleziona ComfyUI e Standard Server. Inserisci l'indirizzo raggiungibile dalla macchina che esegue il server SillyTavern e usa Connect. Che il telefono apra la pagina remota non dimostra che l'host SillyTavern la raggiunga.
Su macchine diverse, 127.0.0.1 indica quella che fa la richiesta. Non trova ComfyUI sull'altro computer. Usa l'indirizzo realmente accessibile dell'installazione. Per un host online usa una connessione protetta; non serve esporre pubblicamente un'istanza ComfyUI senza restrizioni per un uso domestico.
Dopo il primo rendering, aggiungi il workflow API salvato. Mantieni checkpoint e adapter uguali per risultati corrispondenti. Se la GPU remota usa un'altra variante quantizzata, aggiorna il loader anziché presumere comportamento identico da un file simile. L'LLM locale può restare caricato perché le immagini usano la memoria di un'altra macchina.
È interessante se conosci già ComfyUI. Lo è meno se vuoi due immagini stasera e dovresti imparare l'amministrazione server. Un generatore nel browser può essere più pratico pur essendo meno integrato.
Usa SpicyAPI accanto alla chat
I task immagini SpicyAPI non appaiono come fonte nativa nell'implementazione SillyTavern Image Generation esaminata. Il contratto asincrono non si incolla nel campo URL ComfyUI né si tratta come un endpoint AUTOMATIC1111. La guida non fornisce né afferma di aver testato un adapter che renda intercambiabili i protocolli.
Puoi comunque mantenere aperto il roleplay e usare la pagina Z-Image Spicy in un'altra scheda browser. Apri Playground, incolla la descrizione visiva della scena attuale, imposta dimensioni, genera e scarica. La GPU locale resta disponibile all'LLM perché l'inferenza immagini avviene da remoto.
Per un ritratto introduttivo, scegli 832 per 1216 pixel, espansione disattivata e un adulto di fantasia in outfit e stanza specifici. Entrambe le dimensioni rientrano nel range pubblico Z-Image Spicy di 256–1536 pixel per lato. È una composizione iniziale proposta, non l'affermazione di averla generata o confrontata col checkpoint locale.
Un servizio remoto riceve prompt visivo e immagini caricate. Non serve inviare tutta la cronologia per una foto. Copia soltanto tratti visibili e scena attuale; elimina appunti privati, nomi reali e dettagli inutili all'immagine fissa.
Percorso due: mantieni il workflow immagini locale, sposta la chat su un'API
Sceglilo se hai curato soprattutto il modello immagini. Potresti avere un checkpoint d'illustrazione specifico, LoRA del personaggio, controllo della posa o workflow di scena non riproducibile nel browser. Spostare chat è spesso più semplice che ricostruire quel lavoro altrove.
Il primo passo è fermare il backend testuale locale, non solo cambiare selettore API. Se llama.cpp, Ollama o altro server restano caricati in background possono mantenere la memoria da recuperare. Salva il profilo di connessione per ritornarci, poi collega la fonte chat ospitata scelta.
SillyTavern supporta chat ospitate separatamente dalle fonti immagini. Segui la documentazione API Connections per il protocollo. Una fonte chat può essere locale o ospitata indipendentemente dai nomi Chat Completion o Text Completion; descrivono l'invio del prompt, non la posizione della GPU.
Per chat SpicyAPI, la guida al collegamento roleplay SillyTavern fornisce impostazioni Custom OpenAI-compatible e gestione specifica dei parametri non supportati. Usa quella configurazione invece di un ID task immagini nella casella del modello chat. Qui l'obiettivo è liberare la GPU, quindi non occorre ripetere ogni impostazione dei modelli chat.
Torna ora a ComfyUI ed esegui esattamente il workflow riuscito da solo. Non aggiungere subito fasi perché la GPU sembra libera. Mantieni la prima richiesta integrata identica a quella isolata; il confronto verifica che spostare chat abbia rimosso l'interferenza.
Un LLM ospitato è comunque utile alla pipeline visiva. Può trasformare la scena in prompt prima che SillyTavern invii il workflow ComfyUI locale. È una richiesta testuale: usa il servizio chat invece di caricare un altro modello grande sulla scheda.
Il costo è privacy della conversazione e fatturazione per token. L'API riceve il contesto incluso da SillyTavern: descrizione del personaggio, istruzioni, lore selezionata e messaggi. Se chat solo locale era un requisito inderogabile, questo non è un piccolo aggiustamento tecnico; cambia dove viene elaborato il testo.
Controlla la prima risposta dopo ogni immagine. Se ora è reattiva e ComfyUI termina bene, hai risolto la competizione principale della memoria. Se l'immagine resta lenta come quando girava sola, il collo di bottiglia è nel carico immagini, non nella conversazione ora ospitata.
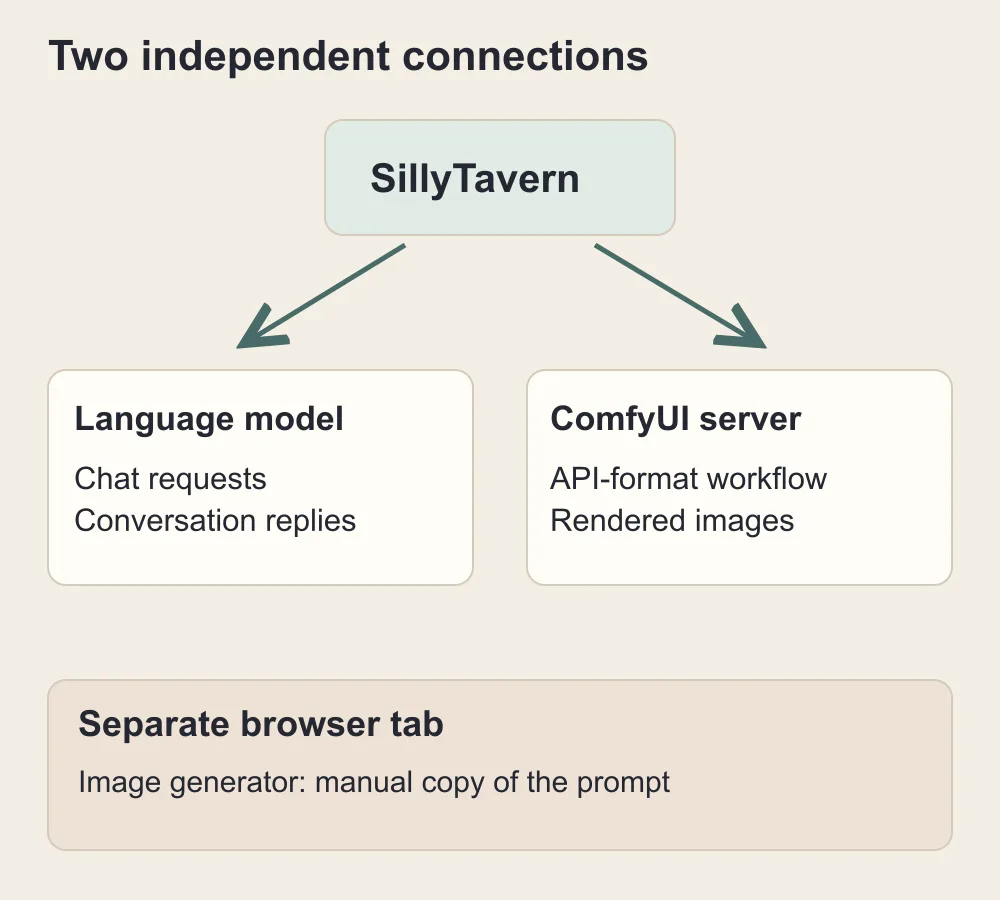
Chat e immagini hanno connessioni separate. Un generatore browser accanto alla chat è un percorso manuale, non un'integrazione ComfyUI nativa.
Percorso tre: mantieni tutto locale e alterna i compiti
Se né conversazione né prompt visivi devono lasciare la macchina, usa la GPU in sequenza. Considera la creazione immagini una pausa breve. Non elimini il personaggio né inizi una chat nuova; cambi temporaneamente quale backend mantiene le allocazioni.
Conversazione salvata e cache caricata sono diverse. SillyTavern conserva i dati chat; la cache in memoria del backend accelera la prossima richiesta. Fermare o scaricare il backend può perderla. Al ritorno, il modello può dover rielaborare il contesto. La storia resta disponibile, ma la prima risposta ripresa può richiedere più tempo.
L'ordine operativo
- Termina la risposta attuale e ferma rigenerazione automatica o trigger immagini che possano inviare altre richieste.
- Crea e salva il prompt visivo con il modello testuale ancora caricato oppure scrivilo tu.
- Salva la conversazione e tieni la descrizione immagini dove puoi copiarla.
- Scarica o ferma il backend testuale e conferma che la memoria GPU dedicata sia diminuita.
- Esegui un'immagine ComfyUI usando la descrizione salvata.
- Scarica o conserva l'immagine, poi scarica i modelli ComfyUI o ferma il backend.
- Verifica la memoria libera, riavvia il backend testuale con impostazioni salvate e riconnetti se necessario.
- Continua la stessa conversazione; la prima risposta potrebbe ricostruire il contesto se la cache è persa.
La scrittura del prompt viene prima dello scaricamento. Se fermi l'LLM e poi chiedi /sd last allo stesso backend, hai rimosso il servizio della prima metà della richiesta immagini. Usa la descrizione salvata in una richiesta /sd manuale con Extend free-mode prompts disattivato durante la fase immagini.
Inizia manualmente. Fermare e riavviare visibilmente è meno elegante di un'estensione, ma verifica il piano fondamentale di memoria. Se l'immagine fallisce ancora senza processo testuale, uno strumento automatico riprodurrà l'errore più velocemente anziché correggerlo.
Utenti Ollama: scaricate il modello, non soltanto la finestra
Ollama documenta un comando stop esplicito e keep_alive. L'azione manuale immediata è ollama stop YOUR_MODEL_NAME, con il nome esatto dell'installazione. Le FAQ ufficiali descrivono anche keep_alive a zero nelle richieste supportate perché il modello venga scaricato dopo l'uso.
Completa prima la descrizione, ferma il modello e avvia la fase immagini. Alla prossima chat Ollama può ricaricarlo. Disattiva scrittura automatica dei prompt in background mentre ComfyUI usa la scheda: potrebbe riportare l'LLM in memoria nel momento sbagliato.
Non presumere che un client chat consenta ogni parametro Ollama tramite ogni API. Usa un'impostazione esplicitamente supportata o il comando documentato. Un cursore context o un campo generico custom-body non implementa automaticamente i controlli nativi di ciclo di vita Ollama.
Utenti llama.cpp: usate il ciclo di vita del backend
Se avvii un processo llama-server a modello singolo, fermarlo è il modo manuale più chiaro di liberare allocazioni prima delle immagini. Riavvialo dopo con gli stessi parametri salvati. Non confidare in chiudere il browser, lasciare inattiva la chat o cambiare il nome selezionato in SillyTavern per fermare un processo separato.
Versioni recenti espongono anche gestione dei modelli, ma operazioni disponibili dipendono da avvio e versione. Un lancio singolo e un router multi-modello sono configurazioni diverse. Usa controlli documentati per il server reale; non copiare una richiesta di scaricamento di un altro backend.
Utenti ComfyUI: liberarne i modelli non libera l'LLM
ComfyUI espone /free con controlli unload_models e free_memory nell'implementazione ufficiale del server. Imposta flag gestiti dal sistema d'esecuzione. Non ordina di terminare llama.cpp separato e una richiesta accettata non prova che ogni byte sia già rilasciato.
Usa il controllo di scaricamento disponibile nel frontend o nell'installazione quando finisci. Se non trovi quello adatto, fermare il backend è una base manuale semplice. Chiudere solo la scheda browser non ferma il server.
Un nodo personalizzato può essere utile con ordine d'esecuzione corretto. Se precede una rifinitura che richiede ancora il modello, questo può ricaricarsi. Se scarica solo modelli ComfyUI, il roleplay resta intatto. Leggi la documentazione prima di presumere che coordini entrambe le applicazioni.
Fai funzionare il collegamento ComfyUI prima di regolare la memoria
Il supporto ComfyUI SillyTavern è un'integrazione reale di workflow, non un ponte universale API immagini. Invia un grafo in formato API al server e recupera il risultato. Un workflow visivamente corretto può fallire se esporti il formato sbagliato o lasci il prompt fisso.
Parti da ComfyUI. Crea un'immagine con checkpoint, text encoder, VAE e nodi previsti. Salva il workflow normale per riaprirlo visivamente, poi esporta la versione API dall'opzione del frontend; i nomi dei menu possono cambiare con la versione.
In SillyTavern scegli ComfyUI in Image Generation, Standard Server per un'installazione locale normale e l'indirizzo stampato dal server. Il valore predefinito documentato è http://127.0.0.1:8188. Va nell'impostazione dell'applicazione, non è un sito pubblico né un indirizzo da pubblicare per altri.
Usa Connect, crea o scegli il workflow e metti il grafo API nel suo editor. L'integrazione offre sostituzioni come %prompt% per il prompt positivo. Usale solo dove il grafo riceve quel valore. Un workflow senza sostituzioni può essere JSON valido e disegnare sempre la descrizione dimostrativa originale.
Con CLIP Text Encode, trova il campo testo reale che alimenta il condizionamento positivo e sostituisci la descrizione di prova. Se il testo entra in un loader personalizzato o altro nodo, la sostituzione va lì. Non aggiungere un nodo scollegato solo per mostrare una spunta verde.
Invia poi due richieste deliberatamente diverse: la cantante adulta in salotto e una stanza vuota a lume di candela. Se producono lo stesso soggetto, esamina il grafo prima di cambiare seed o modello. Parti dal prompt fisso. Se cambiano solo colore o atmosfera, verifica un altro prefisso o campo che contenga ancora il personaggio originale.
Impostazioni di memoria utili e quelle fuorvianti
Non applicare tutte le ottimizzazioni di un commento insieme. Devi sapere se riduci lavoro testuale, lavoro immagini o trattenimento della memoria inattiva. Sono interventi diversi con effetti diversi sulla prossima risposta.
Accorcia il contesto del backend testuale prima di ridurre la qualità del personaggio
Un contesto 32K o maggiore può riservare più spazio di quanto serva stasera. Prova un profilo salvato più piccolo, come 4096 o 8192 token, se contiene ancora scheda, istruzioni, lore pertinente e conversazione recente. Sono esempi di profilo, non promesse che un modello entri in memoria.
Imposta anche il contesto richiesto da SillyTavern in modo adatto al backend. Ridurre solo la cronologia inviata dal client può non ridurre una cache allocata all'avvio del server. Aumentare il cursore client non aumenta magicamente la capacità server. Se l'impostazione riguarda allocazione del backend, cambiala lì e riavvia o ricarica secondo l'implementazione.
Il riferimento server llama.cpp documenta contesto, livelli GPU, tipi di cache e offloading KV. Usa i nomi dell'help installato. In particolare, adattare automaticamente il modello alla GPU non promette di lasciare spazio al futuro picco immagini di un'altra app.
Ridurre i livelli GPU sposta parte dell'inferenza testuale fuori dalla GPU. Libera spazio a costo di velocità. Quantizzare la cache è diverso da scegliere pesi quantizzati. Un file Q4 non significa automaticamente cache a quattro bit.
Riduci i picchi immagini con un rendering più semplice
Usa batch size uno. Generare immagini una dopo l'altra è diverso da gestire un lotto simultaneo. Mantieni rapporto d'aspetto usuale del modello e dimensioni iniziali ragionevoli, evitando un secondo campionamento ad alta risoluzione finché l'immagine base non riesce.
Se il grafo fallisce nel VAE decode, prova un decoder tiled supportato. Se fallisce caricando il modello principale, tiled decode non riduce quei pesi. Se fallisce solo in face detailer o upscale, rimuovi la fase dal workflow live ed eseguila dopo con chat ferma.
Leggi cosa significa Low VRAM nel programma reale
Le definizioni attuali degli argomenti ComfyUI distinguono gestione dinamica e vecchi flag. --lowvram non fa nulla con DynamicVRAM attivo; senza di esso sposta i text encoder sulla CPU. È più circoscritto di «fai entrare ogni modello immagini nello spazio rimasto».
ComfyUI offre anche riserva di memoria e offloading più aggressivo. Riservare può mantenere spazio per altro software, ma non è un pianificatore condiviso col backend chat. Se i carichi minimi combinati non entrano, non crea memoria aggiuntiva. Prova una modifica singola e ripeti la stessa richiesta di un'immagine.
KoboldCpp ha controlli diversi. La sua guida rapida SillyTavern avverte specificamente di non selezionare la casella Low VRAM mostrata. Descrive un launcher vecchio, quindi consulta anche l'help installato. Evita di copiare un'impostazione solo perché un'altra app usa lo stesso nome.
Una scheda AMD cambia la configurazione, non il calcolo della memoria
La domanda recente riguardava AMD e backend Vulkan llama.cpp. È un motivo per seguire percorsi d'esecuzione supportati invece di incollare un comando CUDA da un tutorial NVIDIA. Accelerazione, formati numerici e operatori dipendono da GPU, sistema, build e backend installati.
Conferma prima che ogni app funzioni da sola. Un testo Vulkan riuscito non prova un backend accelerato immagini appropriato in ComfyUI. Un modello immagini funzionante non prova che l'LLM sia compilato col backend desiderato. Leggi messaggi iniziali e dispositivo reale nei controlli isolati.
Se testo e immagini sono veloci da soli ma insieme falliscono, cambiare argomento sul marchio GPU probabilmente non risolve la mancanza di spazio. Tieni un carico remoto o alternali. Se un'app è lenta già sola, risolvila prima di cercare esecuzione simultanea.
Diffida di un modello immagini quantizzato definito «adatto a 8 GB» senza l'intera configurazione. Può escludere text encoder, dipendere dall'offloading, usare un nodo speciale o presumere GPU altrimenti libera. Prima del download leggi requisiti del loader esatto e conferma il supporto della quantizzazione nel backend installato.
Fai corrispondere l'immagine alla scena adulta senza inviare tutta la storia
Quando la configurazione funziona, la memoria non è l'unica causa di delusione. Il modello roleplay può descrivere cosa prova il personaggio invece di ciò che vede la fotocamera. Produce così un ritratto plausibile che ignora stanza, outfit o azione attuale.
Per Mara, adulta di fantasia, separa aspetto permanente e scena corrente. I fatti permanenti possono essere età 29, caschetto corto scuro, ear cuff d'argento e tatuaggio a mezzaluna sulla spalla. Quelli attuali possono essere outfit di satin nero, poltrona di velluto, luce calda bassa e sguardo laterale sicuro. Solo il secondo gruppo deve cambiare quando la storia passa in un'altra stanza.
Ecco una descrizione proposta adattabile; non è stata usata come test nell'articolo:
Cantante da lounge adulta di fantasia di 29 anni, con caschetto corto scuro ed ear cuff d'argento, indossa un outfit da sera aderente di satin nero ed è seduta lateralmente in una poltrona di velluto bordeaux intenso. Espressione sicura e giocosa. Luce calda ambrata da una lampada da tavolo, salotto notturno delicatamente sfocato dietro. Ritratto medio, mani rilassate e visibili, atmosfera editoriale intima, nessuna scritta.
Se passa dal salotto al balcone, cambia ambiente e luce anziché ogni dettaglio distintivo. Se nella conversazione cambia outfit, specificalo chiaramente ed elimina quello vecchio. Descrizioni contraddittorie possono produrre una scena errata anche se il modello segue il testo al meglio.
Prefissi specifici aiutano la continuità descrittiva, ma non garantiscono lo stesso volto. Un'identità che richiede riferimenti corrispondenti o LoRA dedicata necessita di un workflow che supporti davvero il metodo. Il testo e l'avatar della scheda non diventano automaticamente input di riferimento per ogni fonte immagini.
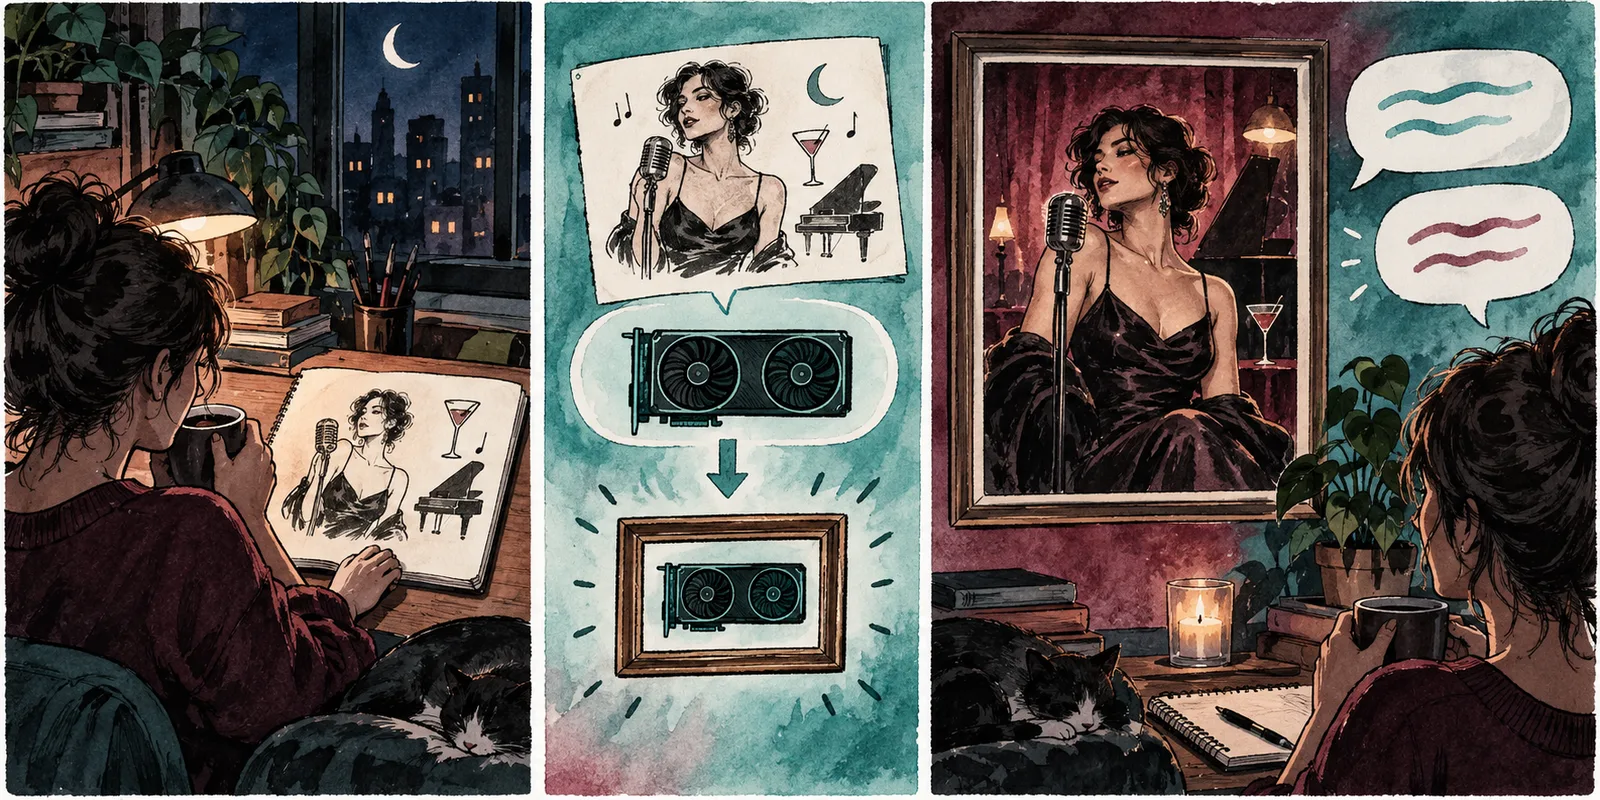
Salva la descrizione visiva prima di scaricare il modello testuale; riprendi la chat salvata dopo.
Quanto costano realmente immagini remote occasionali
Un percorso browser merita valutazione prima di acquistare hardware soltanto per evitare cambi occasionali di modello. Nel catalogo pubblico attuale, Z-Image Spicy costa $0.01235 per immagine con espansione disattivata e $0.0133 attivata. Z-Image Spicy Pro costa $0.019 per immagine. Sono tariffe immagini, non abbonamenti o costi chat ospitata.
| Richieste immagini pianificate | Spicy, espansione disattivata | Spicy, espansione attivata | Spicy Pro |
|---|---|---|---|
| 10 | $0.1235 | $0.133 | $0.19 |
| 50 | $0.6175 | $0.665 | $0.95 |
| 100 | $1.235 | $1.33 | $1.90 |
È una moltiplicazione della tariffa mostrata. Non stima quanti tentativi producano una scelta da conservare. Se crei quattro alternative e ne tieni una, prevedi tutte e quattro. Chiamate chat per scrivere prompt, editing e upscaling sono separati se aggiunti.
Per dieci immagini in una serata, la componente indicata è abbastanza piccola da confrontarla con la scomodità di fermare e ricaricare il modello locale. Non risolve la scelta se servono offline, LoRA locali esatte o prompt sulla macchina. Tali requisiti possono prevalere sul prezzo basso.
Scegli la pagina Spicy Pro se serve il range fino a 2560 pixel per lato; scegli Spicy ordinario se i lati massimi 1536 coprono il ritratto. Il limite maggiore è una differenza verificata della funzione, non la prova che Pro sia migliore in ogni scena adulta.
Correggi il sintomo reale
ComfyUI genera ma SillyTavern dice che le immagini non sono disponibili
Apri Image Generation e scegli una fonte configurata. Un'installazione nuova o vecchia può mantenere una fonte non collegata. Controlla l'indirizzo nel pannello immagini anziché l'URL chat. Se è cloud, usa credenziali e configurazione proprie. Una connessione testuale funzionante non stabilisce quella immagini.
Poi prova una richiesta manuale breve. Se funziona, passa ai prompt dal contesto. Un trigger automatico elaborato rende difficile capire se la fonte sia irraggiungibile o il trigger non corrisponda al messaggio.
SillyTavern si collega ma ogni immagine sembra l'esempio del workflow
Apri il formato API e trova il testo positivo usato realmente. Sostituisci l'esempio fisso con la sostituzione del prompt all'input vero. Controlla altri campi e prefissi attivi con il vecchio soggetto. Cambiare seed produce solo versioni diverse del prompt ancora fisso.
L'immagine fallisce solo col modello chat caricato
Mantieni invariato il workflow isolato riuscito e separa memoria: immagini remote, chat ospitata o uso locale sequenziale. Per simultaneità, riduci prima allocazione effettiva del contesto o livelli GPU. Non riprovare lo stesso carico combinato aspettandoti memoria disponibile diversa.
La prima immagine funziona, poi la chat rallenta
Esamina la memoria dopo. ComfyUI può mantenere modelli per riusarli; il backend testuale può aver spostato lavoro su memoria lenta. Scarica il carico immagini prima della risposta o sposta immagini remote. Se riavviare chat ripristina velocità, conserva un profilo ridotto per uso condiviso invece di rimettere in competizione quello a piena memoria.
Hai scaricato ComfyUI ma la VRAM sembra ancora piena
Identifica il processo con l'allocazione restante. ComfyUI libera i propri modelli, non l'LLM altrui. Distingui anche cache allocata e memoria realmente restituita al dispositivo. Per la base manuale, ferma deliberatamente i processi backend e verifica il cambiamento prima di rilanciarli.
L'immagine non parte dopo la richiesta dell'ultima scena
Prova la stessa scena come richiesta manuale free-mode senza estensione. Se funziona, esamina il passaggio testuale di scrittura del prompt. Endpoint fermo, risposta vuota o istruzioni che producono prosa invece del formato atteso possono essere la causa. Liberare memoria immagini non corregge una risposta testuale mancante.
Il rendering parte e fallisce nella rifinitura finale
Rimuovi detailer, secondo campionamento o upscaler dal grafo live e genera la base. Se riesce, salvala ed esegui la fase extra con backend testuale scaricato. Puoi mantenere il workflow elaborato per opere finite senza usarlo per ogni immagine spontanea della chat.
La GPU non è piena ma tutto resta dolorosamente lento
Controlla che il carico giri sul dispositivo accelerato previsto e che la RAM di sistema non sia esaurita. Un forte offloading CPU può renderlo tecnicamente funzionante ma sgradevole per conversazione live. Un'altra ottimizzazione VRAM può scambiare velocità con ancora più offloading; spostare un carico remoto può migliorare più chiaramente.
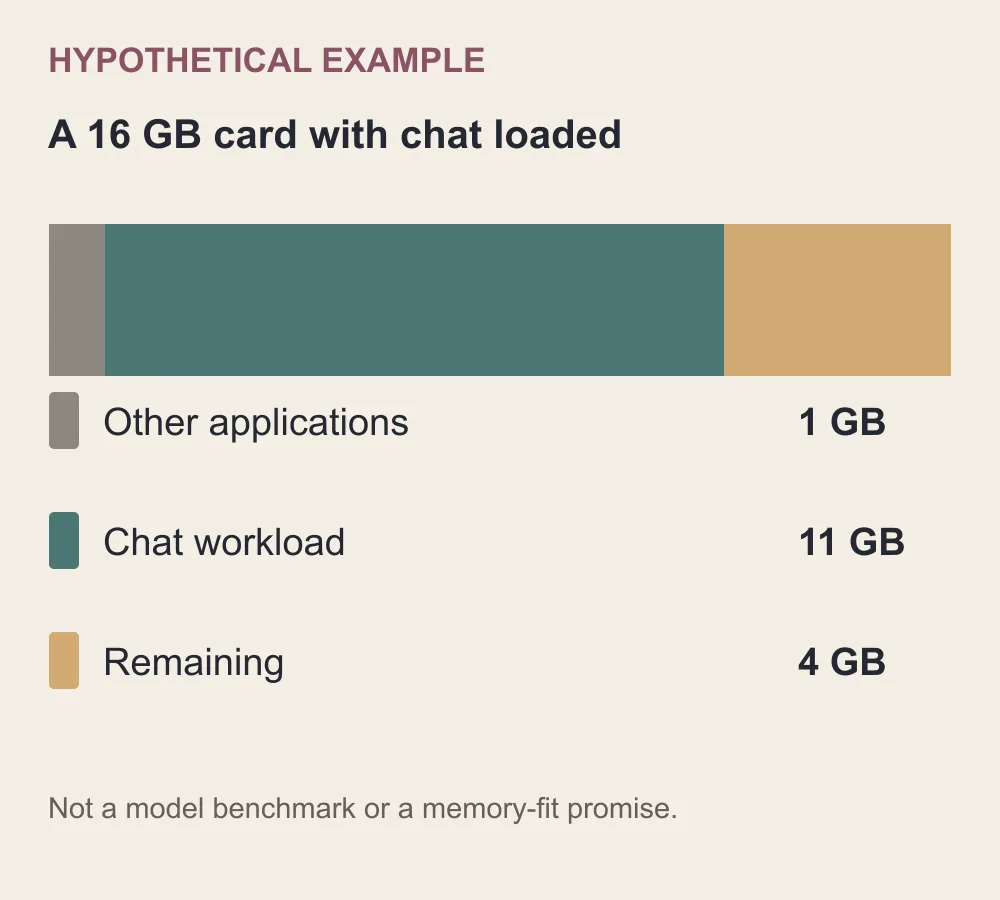
Numeri soltanto illustrativi: un modello che entra in una scheda 16 GB libera può non entrare accanto a un LLM che ne usa quasi tutta la memoria.
Un piano iniziale realistico per la prossima sessione
Per 8 GB, mantieni locale un solo carico generativo pesante. Se hai un buon modello roleplay, lascialo caricato e genera immagini occasionali tramite fonte remota supportata o scheda browser separata. Se hai un buon workflow immagini, ferma testo e usa chat ospitata. Scegli alternanza completamente locale quando conservare il materiale sulla macchina conta più di un ritmo fluido.
Per 16 GB, parti dallo stesso piano semplice se l'LLM occupa quasi tutta la scheda. Se puoi sperimentare, dimostra prima che il workflow immagini funzioni solo, poi prova un profilo chat ridotto con un'immagine, nessuna rifinitura e contesto limitato. Una coppia stabile è utile; una configurazione che entra solo prima che cresca la conversazione non è un piano serale affidabile.
L'obiettivo è continuare a leggere e scrivere invece di riavviare continuamente task falliti. Assegna alla GPU un compito chiaro, collega immagini con un protocollo davvero supportato e mantieni il primo workflow live abbastanza piccolo da diagnosticare. Poi aggiungi il controllo del personaggio o la rifinitura che ti manca di più, uno alla volta.