SillyTavern 캐릭터가 드디어 원하는 방식으로 글을 씁니다. 사진을 요청하자 ComfyUI가 로드되기 시작하고 이미지가 실패하거나 다음 대화가 너무 느려집니다. 8GB 또는 16GB 그래픽 카드는 각각의 작업에 충분해도 동시에 활성화하면 어려울 수 있습니다.
적은 VRAM에서 SillyTavern NSFW 이미지 생성을 할 때 첫 판단은 어느 작업이 GPU를 계속 차지할지입니다. 끊김 없는 로컬 역할극이 가장 중요하면 이미지를 원격 생성하세요. 로컬 캐릭터 체크포인트와 LoRA가 중요하면 대화를 API로 옮기세요. 모두 로컬이어야 한다면 시각 프롬프트부터 만든 뒤 텍스트 백엔드를 언로드하고 이미지를 렌더링한 다음 텍스트를 다시 로드하세요. 세 번째는 저장 대화를 보존하지만 GPU 작업 전환 중 끊김 없는 생성을 약속하지는 않습니다.
실용적인 설정 선택이지 특정 모델 조합이 모든 8GB 카드에 들어간다는 벤치마크가 아닙니다. 이 가이드에서 로컬 쌍 실행 시간을 측정하지 않았습니다. 연결 안내는 프로젝트 문서와 소스에 근거하고, 권장 순서는 설정 다섯 개를 동시에 바꾸지 않고 흔한 실패를 분리하도록 구성했습니다.
10월 2일 SillyTavern 토론에 문제가 명확하게 나타났습니다. 16GB AMD 카드 사용자가 이미 로컬 역할극으로 메모리를 쓰며 Z-Image를 추가하려 했습니다. 질문은 Z-Image가 일반 GPU에서 실행되는지가 아니라 기존 대화 모델이 그 GPU를 차지한 상태에서 실행되는지입니다.
새 모델 다운로드 전에 GPU의 역할을 정하세요
저녁 작업에서 가장 끊고 싶지 않은 부분부터 고르세요. 좋아하는 로컬 모델의 긴 대화, 조정한 이미지 워크플로, 컴퓨터 밖으로 아무것도 보내지 않는 조건은 다른 구성으로 이어집니다.
| 가장 중요한 것 | 권장 경로 | 포기하는 것 |
|---|---|---|
| 기존 로컬 캐릭터 대화 응답성 | 로컬 대화, 원격 이미지 | 시각 프롬프트와 참조가 이미지 서비스로 감 |
| 정확한 로컬 이미지 체크포인트·LoRA·워크플로 | 원격 대화, 로컬 ComfyUI | 보낸 대화 맥락을 선택 API가 받음 |
| 대화와 이미지를 기기에 유지 | 로컬 작업 순차 사용 | 모델 전환으로 흐름이 끊기고 프롬프트 재처리 가능 |
| 가끔 사진만, 새 통합 프로젝트 없이 | 로컬 대화와 브라우저 생성기 | SillyTavern 기본 이미지 제어 밖에서 만듦 |
8GB에서는 대체로 로컬 생성 작업 하나로 시작하세요. 16GB는 실험 여유가 더 있지만 현재 LLM이 대부분을 쓰면 같은 판단이 필요합니다. 남은 메모리 주인을 정하기 전에 양자화 체크포인트를 더 사면 다운로드만 늘고 실패는 같을 때가 많습니다.
대화 API와 이미지 백엔드를 혼동하지 마세요. 모델이 가상 성인 캐릭터를 훌륭하게 묘사해도 픽셀을 만들지는 못할 수 있습니다. 이미지 입력을 받는 모델도 분석만 할 수 있습니다. API Connections 연결은 대화를, Image Generation 소스는 그림을 실행합니다. 계속 별도 설정으로 다루세요.
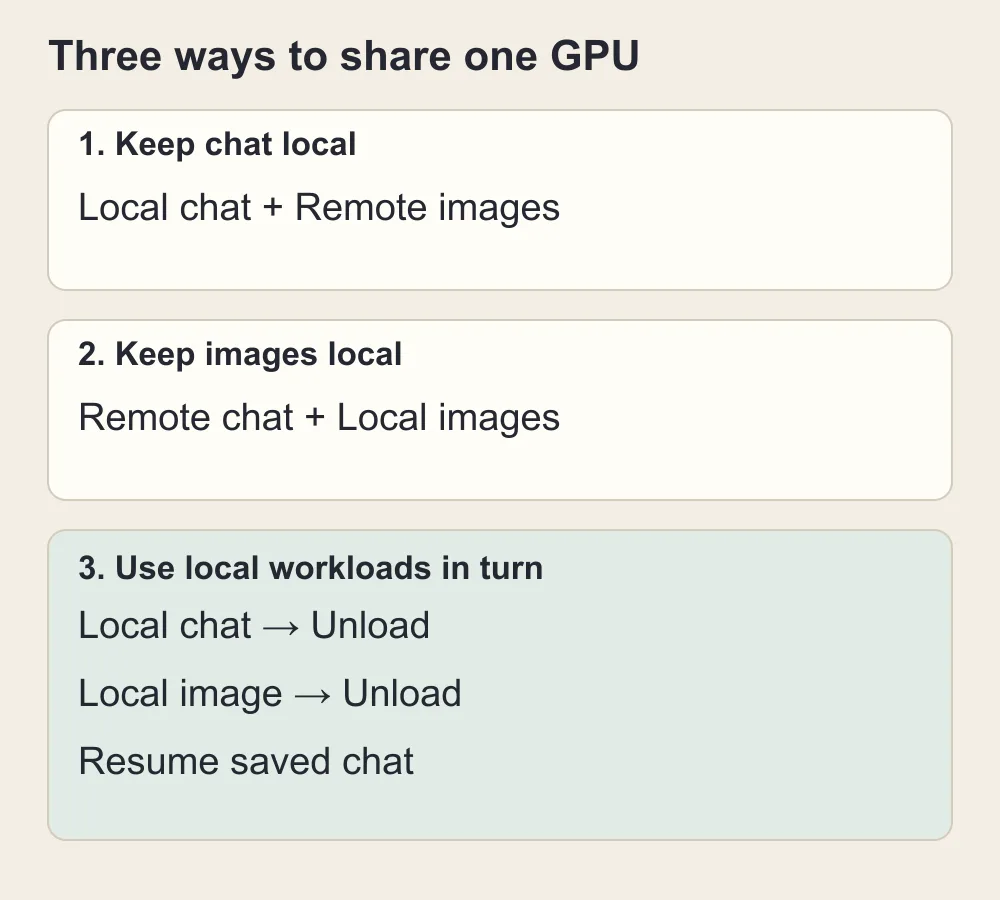
작업 하나를 원격에 두거나 로컬 대화와 이미지가 GPU를 번갈아 쓰게 하세요.
가만히 있는 대화창도 VRAM 대부분을 쓸 수 있습니다
혼란스러운 부분은 대화가 비활성처럼 보인다는 것입니다. 답을 생성하지 않아 GPU 사용률이 떨어지고 조용해도 ComfyUI는 모델을 못 올립니다. 사용률은 현재 연산, 메모리 점유는 다음 작업용 자원입니다. 거의 아무 일도 안 하는 백엔드가 큰 할당을 유지할 수 있습니다.
다운로드 크기는 일부 설명일 뿐입니다. LLM에는 대화 캐시와 임시 연산 공간도 필요합니다. 가중치를 안 바꿔도 긴 컨텍스트 설정이 부담을 늘립니다. 이미지도 모델 구성 요소와 임시 공간이 필요합니다. 연결·다운로드 때가 아니라 로딩이 성공한 뒤 최대 사용량이 올 수 있습니다.
llama.cpp 관리자의 메모리 설명은 가중치, 컨텍스트 캐시, 연산 버퍼를 별도 할당으로 설명합니다. GPU 상자의 용량에서 GGUF 파일 크기만 빼서 ComfyUI 여유를 판단하기 어려운 이유입니다.
예를 들어 16GB 중 데스크톱·앱이 1GB, 텍스트 백엔드가 11GB를 쓰면 이미지 전에 약 4GB가 남습니다. 계산 설명용 가상 수치이며 Z-Image 측정이나 추천 할당은 아닙니다. 16GB 기기에서 실행된다는 주장이 남은 4GB에서 실행된다는 뜻은 아닙니다.
공식 Z-Image 저장소는 Turbo의 16GB 소비자 기기 실행과 메모리 부족 시 CPU 오프로딩을 설명합니다. 이미지 배포에 관한 설명입니다. 별도 역할극 LLM, 긴 캐시, 여러 어댑터, 동시 추론 프로세스의 공간을 예약하지 않습니다.
변경 전에 GPU 퍼센트보다 메모리를 보세요. Windows 작업 관리자의 성능에서 실제 외장 GPU를 고르고 전용·공유 메모리를 구분합니다. 다른 시스템은 GPU 제조사 모니터나 백엔드 할당 로그를 쓰세요. 잠시 유휴인 차트보다 어떤 프로세스가 로드된 채인지가 중요합니다.
네 가지 짧은 점검으로 실패 단계를 찾으세요
새 양자화, SillyTavern 재설치, 모델 언로드 커스텀 노드 전에 확인하세요. 연결과 VRAM 문제 모두 사진 없음으로 끝나므로 대화창에서는 같게 보일 수 있습니다.
첫째, 대화만 시험합니다. 이미지 백엔드를 완전히 닫고 평소 텍스트 백엔드로 일반 역할극 응답 하나를 만드세요. 이미 느린지 기록합니다. 그렇다면 이미지 공유 문제가 아니라 LLM 부담, 맞지 않는 실행 백엔드, 큰 프롬프트 처리 문제부터입니다.
둘째, 이미지 워크플로만 시험합니다. 텍스트를 멈추고 ComfyUI 자체에서 이미지 한 장을 렌더링하세요. 의도한 설정과 한 장을 씁니다. LLM 없이도 실패하면 대화 컨텍스트 감소로 해결되지 않습니다. 이미지 설치, 누락 파일, 지원 안 되는 노드, 메모리 요구부터 고치세요.
셋째, 작동하는 이미지 백엔드를 SillyTavern에 연결합니다. LLM은 멈추고 Image Generation의 Extend free-mode prompts를 끈 뒤 /sd a fictional adult lounge singer age 29 in a black satin evening outfit, seated beside an amber lamp 같은 수동 명령을 쓰세요. 추가 텍스트 프롬프트 작성 단계를 우회합니다. 직접은 되는데 제출이 안 되면 이미지 소스, 서버 주소, API 형식 워크플로를 봅니다. 잘못된 서비스 URL을 해상도 감소로 고치지 마세요.
넷째, LLM을 로드하고 반복합니다. 큰 변경은 추가 텍스트 작업뿐입니다. 이전에 되다가 실패하면 메모리 분리를 살필 근거가 있습니다. 이미지는 되지만 이후 대화가 급격히 느리면 ComfyUI 모델 유지나 텍스트의 느린 실행 전환을 확인하세요.
이후 다섯 번째 비교도 유용합니다. 수동 이미지 프롬프트와 /sd last를 비교하세요. 후자는 최근 대화를 설명하는 텍스트 단계가 추가됩니다. 수동은 전달되는데 맥락 요청은 안 되면 렌더가 아닌 글 작성 실패일 수 있습니다. LLM 거절, 빈 응답, 잘못된 묘사는 이미지 메모리를 비워 고칠 수 없습니다.
ComfyUI가 실패한 단계를 적으세요. 모델 로드, 텍스트 인코딩, 샘플링, 이미지 디코딩, 후속 디테일 단계입니다. 마지막 업스케일 오류는 나중으로 미루고, 주요 모델 로드 오류는 다른 메모리 계획이 필요합니다.
경로 1: 로컬 역할극을 유지하고 이미지를 다른 곳에서 만들기
좋아하는 로컬 모델이 있고 세션에서 몇 장만 만든다면 먼저 고를 경로입니다. 원하는 대화가 아니게 될 만큼 줄이기보다 텍스트 설정을 두고 이미지 작업을 옮깁니다.
SillyTavern이 이미 지원하는 소스
Extensions의 Image Generation을 열어 Source에서 현재 지원 목록에 실제 있는 서비스를 고르세요. 텍스트 모델 주소를 넣지 말고 해당 소스의 자격 증명과 모델을 설정합니다. 공식 이미지 생성 문서가 목록·통합별 제어의 기준입니다.
자동 트리거 전에 절제된 비노골적 캐릭터 인물 사진 하나를 만드세요. 서비스, 인증, 모델, 결과 처리가 함께 작동하는지 확인합니다. 목록에 있다고 그 뒤 모든 모델이 원하는 성인 장면을 받는 것은 아닙니다.
특정 서비스 이미지 URL을 다른 회사 범용 URL로 바꾸면 통합이 변환할 것이라 기대하지 마세요. 둘 다 프롬프트를 받아도 본문, 상태, 반환 이미지 형식, 인증, 오류가 다를 수 있습니다. API URL 필드가 모든 API의 호환을 뜻하지는 않습니다.
ComfyUI를 다른 컴퓨터에 두기
기존 체크포인트·LoRA가 필요하면 워크플로를 두고 실행을 옮기세요. 다른 컴퓨터 자체에서 먼저 렌더를 성공시킵니다. 호환 소프트웨어, 모델 파일, 설치 노드가 필요합니다. JSON은 구성 요소를 참조하지 모두 포장하지 않습니다.
Image Generation에서 ComfyUI·Standard Server를 선택하고 SillyTavern 서버 기기에서 접근 가능한 주소를 넣어 Connect를 쓰세요. 휴대폰이 원격 페이지를 연다고 서버 호스트도 접근된다는 증명은 아닙니다.
서비스가 다른 기기에 있으면 127.0.0.1은 요청 기기를 뜻하고 다른 컴퓨터의 ComfyUI를 찾지 못합니다. 실제 접근 주소를 쓰세요. 온라인 호스트는 보호된 연결을 사용합니다. 가정용에서 제한 없는 ComfyUI를 공개할 필요는 없습니다.
첫 렌더 뒤 저장 API 형식 워크플로를 넣습니다. 같은 결과가 필요하면 체크포인트·어댑터를 유지하세요. 원격이 다른 양자화이면 비슷한 이름이 같다고 보지 말고 로더를 갱신합니다. 이미지 메모리가 다른 기기에 있으므로 로컬 LLM을 계속 로드할 수 있습니다.
ComfyUI에 익숙하면 매력적입니다. 오늘 사진 두 장을 위해 서버 관리부터 배워야 한다면 덜 매력적입니다. 덜 통합된 브라우저 생성기가 더 실용적일 수 있습니다.
대화 옆에서 SpicyAPI 쓰기
확인한 SillyTavern Image Generation 구현에 SpicyAPI 이미지 작업은 기본 소스로 없습니다. 비동기 생성 계약을 ComfyUI URL에 붙이거나 AUTOMATIC1111 엔드포인트처럼 쓸 수는 없습니다. 이 가이드가 프로토콜을 교환하는 어댑터를 제공·검증했다는 주장은 없습니다.
그래도 로컬 역할극을 켠 채 둘째 탭에서 Z-Image Spicy 페이지를 쓸 수 있습니다. Playground에서 현재 시각 설명을 붙이고 크기를 설정해 생성·다운로드하세요. 원격 추론이므로 GPU는 LLM에 남습니다.
소개 인물 사진은 832×1216픽셀, 확장 비활성, 가상 성인 하나의 구체적 옷·방으로 시작하세요. 두 변은 공개 범위 256~1536 안입니다. 제안 구도이지 렌더했거나 로컬과 품질 비교했다는 뜻은 아닙니다.
원격 서비스는 시각 프롬프트와 업로드 이미지를 받습니다. 사진 하나에 전체 대화 기록은 필요 없습니다. 눈에 보이는 캐릭터 특징과 현재 장면만 복사하고 비공개 메모, 실명, 정지 이미지에 불필요한 내용을 빼세요.
경로 2: 로컬 이미지 워크플로를 유지하고 대화를 API로 옮기기
이미지를 신중하게 조정했다면 이 경로입니다. 특정 일러스트 체크포인트, 캐릭터 LoRA, 포즈 제어, 장면 워크플로를 브라우저가 재현하지 못할 수 있습니다. 전체 이미지를 옮기는 것보다 대화 이동이 간단할 때가 많습니다.
첫 조치는 API 선택 변경만이 아니라 로컬 텍스트 백엔드 중지입니다. llama.cpp, Ollama 등이 뒤에서 로드된 채면 회복하려던 메모리를 유지합니다. 연결 프로필을 저장하고 호스팅 소스에 연결하세요.
SillyTavern은 대화·이미지 연결을 별도로 지원합니다. 프로토콜별 API Connections 문서를 따르세요. Chat Completion·Text Completion이라는 범주는 프롬프트 전송 방식이며 GPU 위치가 아닙니다. 둘 다 로컬·호스팅일 수 있습니다.
SpicyAPI 대화는 SillyTavern 역할극 연결 가이드의 Custom OpenAI-compatible 설정과 지원 안 되는 매개변수의 모델별 처리를 쓰세요. 대화 모델 칸에 이미지 작업 ID를 넣지 마세요. 여기서는 사진용 GPU 확보가 목적이므로 모든 대화 설정을 반복하지 않습니다.
ComfyUI에서 단독 성공했던 정확한 워크플로를 실행하세요. 여유가 보인다고 바로 단계를 더하지 마세요. 첫 통합 요청을 단독과 같게 해 대화 경로 변경이 간섭을 제거했는지 확인합니다.
호스팅 LLM도 시각 파이프라인에 유용합니다. 로컬 ComfyUI 제출 전에 현재 장면을 프롬프트로 바꿀 수 있습니다. 텍스트 요청이므로 또 큰 로컬 모델 대신 대화 서비스가 처리합니다.
대가는 대화의 처리 위치와 토큰 과금입니다. API는 캐릭터 설명, 지시, 선택한 로어, 메시지 등 SillyTavern이 보낸 맥락을 받습니다. 로컬 전용 대화가 필수면 작은 기술 수정이 아니라 텍스트 처리 위치 변경입니다.
이미지 뒤 첫 대화를 보세요. 응답성이 있고 ComfyUI도 깨끗하게 끝나면 주요 경쟁을 해결했습니다. 그림이 단독 때와 똑같이 느리면 병목은 새 호스팅 대화가 아니라 이미지 안입니다.
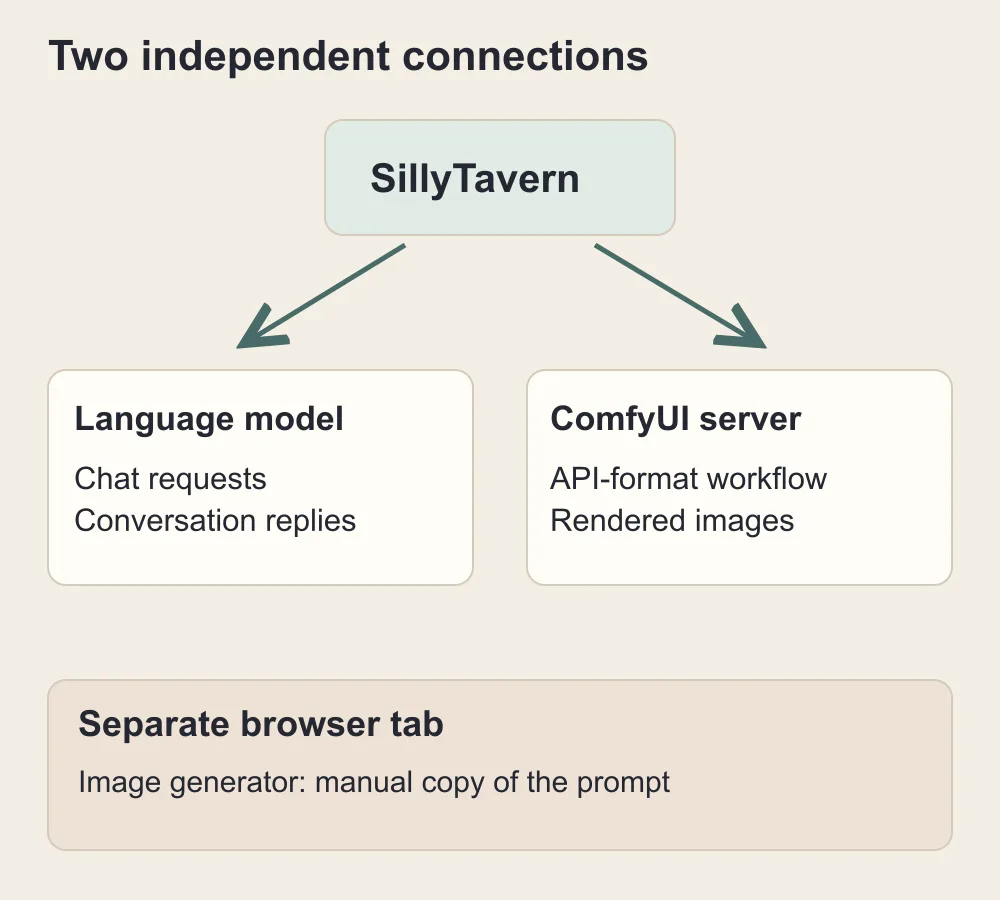
대화와 이미지는 별도 연결입니다. 옆 브라우저 생성기는 수동 경로이며 기본 ComfyUI 통합이 아닙니다.
경로 3: 모두 로컬로 두고 번갈아 실행하기
대화·이미지 프롬프트 모두 밖으로 나가면 안 되면 GPU를 순차 사용하세요. 이미지를 짧은 대화 휴식으로 봅니다. 캐릭터 삭제나 새 대화가 아니라 어느 백엔드가 GPU 할당을 갖는지 잠시 바꾸는 것입니다.
저장 대화와 로드 대화 캐시는 다릅니다. SillyTavern은 데이터를 남기고 백엔드 메모리 캐시는 다음 처리를 빠르게 합니다. 중지·언로드하면 캐시가 없어질 수 있습니다. 복귀 때 맥락을 다시 처리하므로 이야기는 남아도 첫 답은 느릴 수 있습니다.
작업 순서
- 현재 답을 끝내고 다른 요청을 낼 자동 재생성·이미지 트리거를 멈춥니다.
- 텍스트 모델이 로드된 동안 시각 프롬프트를 만들어 저장하거나 직접 씁니다.
- 대화를 저장하고 이미지 설명을 붙여 넣을 곳에 남깁니다.
- 텍스트를 언로드·중지하고 전용 GPU 메모리가 실제로 줄었는지 봅니다.
- 저장 설명으로 ComfyUI 이미지 하나를 실행합니다.
- 완료 이미지를 보관하고 ComfyUI 모델을 언로드하거나 백엔드를 멈춥니다.
- 메모리 여유를 확인해 저장 설정으로 텍스트를 재시작하고 필요하면 재연결합니다.
- 같은 대화를 계속하며 캐시가 없으면 첫 답의 맥락 재구성을 예상합니다.
프롬프트 작성은 언로드 전입니다. LLM을 멈춘 뒤 같은 백엔드로 /sd last를 요청하면 이미지 요청의 첫 절반에 필요한 서비스를 없앤 것입니다. 이미지 단계에서는 Extend free-mode prompts를 끄고 저장 설명의 수동 /sd를 쓰세요.
수동으로 시작하세요. 언로드 확장보다 덜 우아하지만 기본 계획의 작동을 알려 줍니다. 텍스트가 없어도 이미지가 실패하면 자동 전환은 같은 실패를 더 빨리 반복합니다.
Ollama: 창이 아니라 모델을 언로드하세요
Ollama는 명시적 중지 명령과 keep_alive를 문서화합니다. 정확한 설치 이름으로 ollama stop YOUR_MODEL_NAME을 쓰세요. 공식 FAQ는 지원 API 요청에서 keep_alive를 0으로 해 사용 후 언로드하는 것도 설명합니다.
설명을 먼저 완성하고 모델을 멈춘 뒤 이미지로 갑니다. 다음 대화가 모델을 다시 로드할 수 있습니다. ComfyUI가 쓸 때 배경 자동 프롬프트를 끄지 않으면 잘못된 시점에 LLM이 돌아옵니다.
모든 API 유형에서 클라이언트가 모든 Ollama 전용 매개변수를 설정한다고 가정하지 마세요. 명시 지원 설정·중지 명령을 쓰세요. context 슬라이더나 범용 body가 자동으로 Ollama 생명주기 제어를 구현하지는 않습니다.
llama.cpp: 백엔드 자체 생명주기를 쓰세요
단일 모델 llama-server라면 프로세스 중지가 이미지 전에 할당을 푸는 가장 명확한 수동 방식입니다. 이후 같은 저장 실행 설정으로 재시작하세요. 브라우저 닫기, 유휴, SillyTavern 모델 이름 변경으로 별도 프로세스가 멈출 것이라 기대하지 마세요.
최신 서버에는 모델 관리 기능도 있지만 실행 방식·버전별입니다. 단일 실행과 다중 모델 라우터는 다른 구성입니다. 실제 서버 문서의 제어를 쓰고 다른 백엔드용 unload 요청을 복사하지 마세요.
ComfyUI: 자체 모델 해제가 LLM 해제는 아닙니다
공식 서버 구현의 /free는 unload_models와 free_memory 제어로 실행 시스템 처리 플래그를 설정합니다. 별도 llama.cpp 종료 명령이 아니고 요청 수락이 모든 바이트 즉시 해제의 증명도 아닙니다.
렌더 후 프런트엔드·설치의 모델 언로드 제어를 쓰세요. 못 찾으면 백엔드 중지가 명확한 수동 기준입니다. 브라우저 탭만 닫아도 서버는 안 멈춥니다.
커스텀 언로드 노드는 실행 순서가 맞을 때 유용합니다. 후속 디테일 단계 전에 실행하면 필요한 모델을 다시 로드할 수 있습니다. 자체만 언로드하면 역할극 백엔드는 남습니다. 둘을 조율한다고 가정하기 전에 문서를 읽으세요.
메모리 조정 전에 ComfyUI 연결부터 작동시키세요
ComfyUI 지원은 실제 워크플로 통합이지 범용 이미지 API 브리지가 아닙니다. API 형식 그래프를 서버에 제출해 결과를 가져옵니다. 데스크톱에서 맞아도 형식을 잘못 내보내거나 프롬프트를 고정하면 실패할 수 있습니다.
ComfyUI에서 정확한 체크포인트, 텍스트 인코더, VAE, 설치 노드로 한 장을 렌더하세요. 시각 재개용 일반 워크플로를 저장한 뒤 프런트엔드 옵션으로 API 버전을 내보냅니다. 메뉴는 버전별입니다.
Image Generation에서 ComfyUI, 일반 로컬은 Standard Server, 서버가 표시한 주소를 쓰세요. 문서 기본값은 http://127.0.0.1:8188입니다. 앱 설정용 로컬 주소이지 공개 웹사이트나 다른 사람에게 게시할 주소가 아닙니다.
Connect 후 워크플로를 만들거나 선택해 API 그래프를 편집기에 넣습니다. 양성 프롬프트 %prompt% 같은 치환을 실제 해당 값 입력에 쓰세요. 치환 없는 그래프도 유효 JSON이지만 매번 원래 데모를 그릴 수 있습니다.
CLIP Text Encode 그래프면 양성 조건화로 연결된 실제 text를 찾아 치환하세요. 커스텀 로더·다른 노드가 텍스트를 받으면 거기에 둡니다. 초록 체크만 위해 연결 안 된 노드를 더하지 마세요.
성인 라운지 가수와 빈 촛불 방처럼 의도적으로 다른 두 요청을 보내세요. 같은 주체면 시드·모델 전에 내보낸 그래프의 고정 프롬프트를 보세요. 색·분위기만 바뀌면 다른 prefix·text에 예전 인물이 남았는지 확인합니다.
바꿀 가치가 있는 메모리 설정과 오해하기 쉬운 설정
댓글의 최적화 플래그를 모두 동시에 쓰지 마세요. 텍스트 작업 감소, 이미지 작업 감소, 유휴 메모리 유지 변경을 구분해야 합니다. 다음 대화에 영향도 다릅니다.
캐릭터 품질을 깎기 전에 백엔드 컨텍스트 줄이기
32K 이상은 오늘 필요한 것보다 공간을 더 예약할 수 있습니다. 캐릭터 카드, 지시, 관련 로어, 최근 대화가 들어간다면 4096·8192토큰 같은 작은 백엔드 프로필을 시험하세요. 예시 크기이지 모델별 메모리 보장은 아닙니다.
SillyTavern 요청 컨텍스트도 맞추세요. 클라이언트 기록만 줄여도 서버 시작 시 할당한 캐시가 안 줄 수 있습니다. 반대로 슬라이더를 올려 서버 용량이 늘지도 않습니다. 백엔드 할당이면 그곳에서 바꾸고 요구되는 재시작·재로드를 하세요.
llama.cpp 서버 참고는 컨텍스트, GPU 레이어, 캐시 타입, KV 오프로딩을 설명합니다. 설치 버전 help 이름을 쓰세요. 텍스트를 기기에 자동으로 맞추는 것이 미래 이미지 최대 사용량 여유 보장은 아닙니다.
GPU 레이어 감소는 텍스트 일부를 GPU 밖으로 옮겨 공간 대신 속도를 교환합니다. 대화 캐시 양자화와 모델 파일 양자화는 다릅니다. Q4 가중치라고 캐시도 4비트라고 가정하지 마세요.
단순 렌더로 이미지 최대 사용량 줄이기
배치 크기 하나를 쓰세요. 차례대로 여러 장과 동시에 배치를 처리하는 것은 다릅니다. 의도 모델의 일반 비율과 합리적 시작 크기를 쓰고 기본 성공 전 두 번째 고해상도 샘플링은 피합니다.
VAE 디코딩 실패에는 지원 타일 디코더를 시험할 수 있습니다. 주요 모델 로딩 실패라면 타일이 가중치를 줄이지 못합니다. 얼굴 디테일·업스케일만 실패하면 라이브 흐름에서 빼고 텍스트 중지 후 나중에 하세요.
실제 프로그램의 Low VRAM 의미 읽기
현재 ComfyUI 인수 정의는 동적 메모리와 이전 플래그를 구분합니다. DynamicVRAM이면 --lowvram은 효과가 없고, 아니면 텍스트 인코더를 CPU로 옮깁니다. ‘어떤 남은 공간에도 모든 이미지 모델을 맞춤’보다 좁은 의미입니다.
예약 메모리와 적극 오프로딩도 있지만 예약이 대화와의 공유 스케줄러는 아닙니다. 합친 최소 작업이 안 맞으면 새 메모리를 만들지 못합니다. 변경 하나씩 같은 한 장 요청을 반복하세요.
KoboldCpp는 제어가 다릅니다. SillyTavern 빠른 시작은 그림의 Low VRAM 체크를 하지 말라고 명시합니다. 이전 실행기 문서이므로 현재 help도 보세요. 다른 앱과 이름이 같다는 이유로 복사하지 않는 것이 핵심입니다.
AMD는 설정 세부를 바꾸지만 메모리 계산은 같습니다
최근 질문은 AMD와 llama.cpp Vulkan이었습니다. NVIDIA 튜토리얼의 CUDA 명령 대신 지원 실행 경로를 봐야 합니다. 가속, 수치 형식, 연산 지원은 GPU, OS, 빌드, 설치 백엔드별입니다.
각 앱이 단독으로 작동하는지 먼저 보세요. Vulkan 텍스트 성공이 ComfyUI의 적합 이미지 가속을 증명하지 않고 이미지 성공도 LLM의 의도 빌드를 증명하지 않습니다. 시작 메시지와 단독 점검의 실제 장치를 확인하세요.
둘 다 따로 빠른데 합쳐 실패하면 GPU 브랜드 논쟁으로 기본 공간 부족이 해결될 가능성은 낮습니다. 하나를 원격에 두거나 번갈아 씁니다. 단독부터 느리면 동시 실행 연구 전에 그 앱을 고치세요.
전체 구성 없는 ‘8GB 친화적’ 양자화 설명은 신중하게 읽으세요. 텍스트 인코더 제외, 오프로딩 의존, 특정 노드, 빈 GPU 가정일 수 있습니다. 다운로드 전 정확한 로더 조건과 이미지 백엔드 양자화 지원을 보세요.
전체 이야기를 보내지 않고 현재 성인 장면에 사진 맞추기
구성이 된 뒤에는 메모리만이 실망 원인이 아닙니다. 모델이 카메라에 보이는 것 대신 감정을 설명하면 방·옷·현재 행동을 무시한 그럴듯한 사진이 됩니다.
가상 성인 Mara에서 지속 외형과 현재 장면을 분리하세요. 지속 정보는 29세, 짧은 짙은 단발, 은색 이어커프, 어깨의 작은 초승달 문신입니다. 현재는 검은 새틴 의상, 벨벳 라운지 의자, 따뜻한 낮은 조명, 자신 있는 옆 시선입니다. 다른 방으로 가면 두 번째만 바뀌어야 합니다.
다음은 수정용 시각 설명 제안이며 이 글의 모델 테스트에 사용하지 않았습니다.
짧은 짙은 단발과 은색 이어커프가 있는 가상 29세 성인 라운지 가수. 몸에 맞는 검은 새틴 이브닝 의상을 입고 짙은 버건디 벨벳 의자에 옆으로 앉아 있다. 자신 있고 장난스러운 표정. 테이블 램프의 따뜻한 호박색 빛, 부드럽게 흐린 늦은 밤 라운지 배경. 중간 인물 사진, 편안하고 보이는 손, 친밀한 편집 화보 분위기, 글자 없음.
발코니로 이동하면 모든 특징을 다시 쓰기보다 장소·빛을 바꾸세요. 대화에서 의상이 바뀌면 새 옷을 명확히 쓰고 옛 옷을 빼세요. 충돌 의상은 모델이 최선을 다해도 잘못된 장면을 만들 수 있습니다.
캐릭터 prefix는 묘사 연속성에 도움 되지만 같은 얼굴 보장은 아닙니다. 참조 이미지·전용 LoRA가 필요한 정체성에는 그 방법을 지원하는 흐름이 필요합니다. 카드 텍스트와 아바타가 모든 이미지 소스의 참조 입력이 되지는 않습니다.
텍스트 언로드 전에 시각 설명을 저장하고 이후 저장 대화로 돌아오세요.
가끔 쓰는 원격 이미지의 실제 비용
가끔 전환을 피하려고 하드웨어를 사기 전에 브라우저 경로를 고려할 가치가 있습니다. 현재 SpicyAPI의 Z-Image Spicy는 확장 비활성 이미지당 $0.01235, 활성 $0.0133, Spicy Pro는 $0.019입니다. 이미지 요금이지 구독이나 대화 비용은 아닙니다.
| 계획 이미지 요청 | Spicy, 확장 비활성 | Spicy, 확장 활성 | Spicy Pro |
|---|---|---|---|
| 10 | $0.1235 | $0.133 | $0.19 |
| 50 | $0.6175 | $0.665 | $0.95 |
| 100 | $1.235 | $1.33 | $1.90 |
표시 요금 단순 곱셈이지 채택까지 시도 수 예측이 아닙니다. 대안 넷 중 하나를 쓰면 넷 예산을 잡으세요. 추가 대화 프롬프트 작성, 편집, 업스케일은 별도입니다.
저녁 사진 열 장의 이미지 비용은 모델 중지·재로드 불편과 비교할 만큼 작습니다. 오프라인, 정확한 로컬 LoRA, 프롬프트 로컬 조건이 있으면 결론은 다릅니다. 낮은 가격보다 중요할 수 있습니다.
한 변 최대 2560픽셀이 필요하면 Spicy Pro 페이지, 1536까지로 충분하면 일반을 고르세요. 큰 공개 크기 한도는 확인된 기능 차이지 모든 성인 장면에서 Pro가 좋다는 증명은 아닙니다.
실제 보이는 증상을 고치세요
ComfyUI는 되는데 SillyTavern이 이미지를 사용할 수 없다고 합니다
Image Generation에서 설정된 소스를 고르세요. 새·오래된 설치에는 미연결 소스가 남을 수 있습니다. 대화 URL이 아닌 이미지 패널 주소를 확인합니다. 클라우드는 자체 인증·설정을 씁니다. 텍스트 연결 성공이 이미지 성공은 아닙니다.
짧은 수동 사진 요청 후 맥락 프롬프트로 가세요. 복잡한 자동 트리거부터 하면 소스 불가와 메시지 미일치가 구분되지 않습니다.
연결은 되는데 모든 그림이 예시 같습니다
API 워크플로에서 실제 양성 텍스트를 찾고 그 입력의 고정 예시를 치환하세요. 다른 활성 텍스트·prefix도 보세요. 시드 변경은 남아 있는 고정 프롬프트의 다른 버전만 줍니다.
대화 모델이 로드됐을 때만 실패합니다
성공한 단독 이미지 흐름은 두고 원격 이미지, 호스팅 대화, 순차 로컬을 고르세요. 동시 로컬이면 실제 컨텍스트 할당이나 GPU 레이어부터 줄입니다. 같은 합친 작업을 반복해 여유가 달라지길 기대하지 마세요.
첫 이미지는 되는데 다음 대화가 느립니다
이미지 후 메모리를 보세요. ComfyUI는 재사용용 모델을 유지하고 텍스트는 느린 메모리로 이동했을 수 있습니다. 다음 답 전에 이미지를 언로드하거나 원격으로 옮깁니다. 대화 재시작으로 정상이라면 전체 메모리 프로필을 다시 경쟁시키기보다 작은 공유 프로필을 남기세요.
ComfyUI를 언로드했는데 VRAM이 찼습니다
남은 할당의 프로세스를 찾으세요. 자체 모델은 풀어도 다른 LLM은 못 풉니다. 할당 캐시와 실제 장치에 반환된 메모리도 구분하세요. 수동 기준에서는 의도적으로 백엔드를 멈추고 변경을 확인한 뒤 재시작합니다.
마지막 장면 요청 뒤 이미지가 시작되지 않습니다
확장 비활성 수동 자유 모드로 같은 장면을 보내세요. 된다면 텍스트 작성 단계의 중지 엔드포인트, 빈 응답, 기대 형식 대신 산문을 보세요. 이미지 메모리 해제로 누락 텍스트는 고쳐지지 않습니다.
렌더는 시작되지만 마지막 마무리에서 실패합니다
디테일러, 두 번째 샘플링, 업스케일을 라이브 그래프에서 빼고 기본을 만드세요. 성공하면 저장하고 텍스트 언로드 후 추가 단계만 합니다. 완성 아트에는 복잡한 흐름을 남겨도 즉흥 대화 사진마다 필요는 없습니다.
GPU가 안 찼는데 모두 느립니다
의도한 가속 장치와 시스템 RAM을 보세요. 강한 CPU 오프로딩은 기술적으로 되지만 실시간 대화에는 불편할 수 있습니다. 또 최적화는 더 오프로딩해 속도를 줄일 수 있어 하나를 원격으로 옮기는 것이 명확한 개선일 수 있습니다.
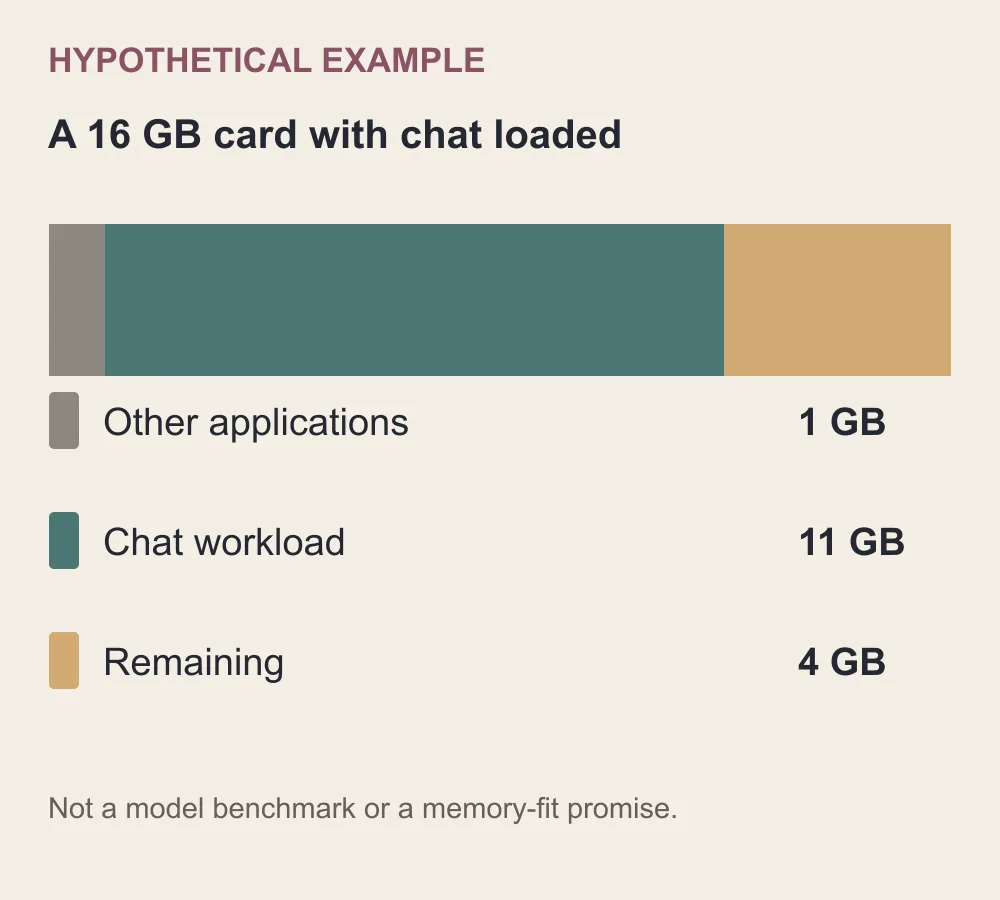
계산용 수치입니다. 빈 16GB에서 맞는 모델도 대부분을 차지한 LLM 옆에는 안 맞을 수 있습니다.
다음 세션의 현실적인 시작 계획
8GB는 부담 큰 생성 작업 하나를 로컬에 두세요. 좋은 역할극 모델이 있으면 로드한 채 지원 원격 소스나 둘째 탭에서 이미지를 만듭니다. 좋은 로컬 이미지가 있으면 텍스트를 멈추고 호스팅 대화를 씁니다. 매끄러운 흐름보다 로컬 보관이 중요하면 전부 로컬 전환을 고르세요.
16GB도 LLM이 대부분이면 같은 단순 계획부터입니다. 여유가 있으면 이미지 단독 성공 후 작은 대화 프로필, 한 장, 디테일 없음, 제한 컨텍스트로 시험하세요. 안정된 쌍은 유용하지만 대화가 길어지기 전만 맞는 구성은 신뢰할 저녁 계획이 아닙니다.
목표는 실패 작업 재시작 대신 계속 읽고 쓰는 세션입니다. GPU 역할을 정하고 실제 지원 프로토콜로 이미지를 연결하며 첫 라이브 흐름을 진단할 만큼 작게 유지하세요. 성공 뒤 가장 필요한 캐릭터 제어나 마무리를 하나씩 더합니다.