SillyTavernのキャラクターが、ようやく好みの文章を書いてくれるようになりました。そこで画像を頼むとComfyUIの読み込みが始まり、画像が失敗するか、次の会話の返答がひどく遅くなります。8GBや16GBのグラフィックカードは、片方の処理には十分使えても、両方が動くと苦しくなることがあります。
低VRAMでのSillyTavern NSFW画像生成で最初に決めたいのは、どちらの処理にGPUを使い続けさせるかです。ローカルのロールプレイを途切れさせたくなければ、画像をリモートで生成します。ローカルのキャラクター用チェックポイントやLoRAが大切なら、会話をチャットAPIへ移します。すべてローカルに置く必要があるなら、先に画像用プロンプトを作り、テキストバックエンドをアンロードし、画像を生成してからテキストバックエンドを読み直します。最後の方法でも保存済みの会話は残りますが、GPUの仕事を切り替える間も生成が途切れないとは保証できません。
これは実用的な構成の選択肢であり、特定のモデルの組み合わせがどの8GBカードにも収まるというベンチマークではありません。本ガイドではローカルの同時実行時間を測っていません。接続手順は各プロジェクトの文書とソースに基づき、作業順は5つの設定を一度に変えずに、よくある失敗を切り分けるために提案しています。
問題がよく表れているのが、10月2日のSillyTavernの議論です。16GBのAMDカードでローカルのロールプレイにメモリを使っているユーザーが、Z-Imageを加えたいと相談していました。役立つ問いは、Z-Imageが一般向けGPUで動くかではなく、すでに使っているチャットモデルがそのGPUを占有したままでも動くかです。
別のモデルをダウンロードする前にGPUの使い道を選ぶ
まず、その晩に最も中断したくないことを選びます。お気に入りのローカルモデルとの長い会話、調整済みの画像ワークフロー、何もコンピューターの外へ出さないという要件では、適した構成が異なります。
| 最も大切なこと | 推奨する構成 | 引き換えになること |
|---|---|---|
| 今のローカルのキャラクター会話を快適に保つ | ローカル会話、リモート画像 | 画像プロンプトと参照素材を画像サービスへ送る |
| 特定のローカル画像チェックポイント、LoRA、ワークフローを保つ | リモート会話、ローカルComfyUI | 送信した会話のコンテキストを選択したチャットAPIが受け取る |
| 会話も画像も自分のマシンに置く | ローカル会話と画像を順番に使う | モデル切り替えでテンポが途切れ、プロンプトの再処理が必要になる場合がある |
| たまに画像が欲しいだけで、新たな連携作業は避けたい | ローカル会話とブラウザーの画像生成ツール | SillyTavern内蔵の画像操作の外で画像を作る |
8GBなら、まず生成処理を1つだけローカルで動かすのが一般的な出発点です。16GBには試す余地がありますが、現在のLLMがカードの大半を使っているなら判断は同じです。残りのメモリをどちらに使うか決めずに別の量子化チェックポイントを入手しても、ダウンロードが増えて同じ失敗に戻りがちです。
チャットAPIと画像バックエンドを混同しないでください。 架空の成人キャラクターを見事に描写できるモデルでも、画素を作れるとは限りません。画像を入力できるモデルが、画像の分析だけをすることもあります。API Connectionsで選ぶ接続は会話を動かし、Image Generationで選ぶソースは画像を描きます。本ガイドでは、この2つを別々の設定として扱います。
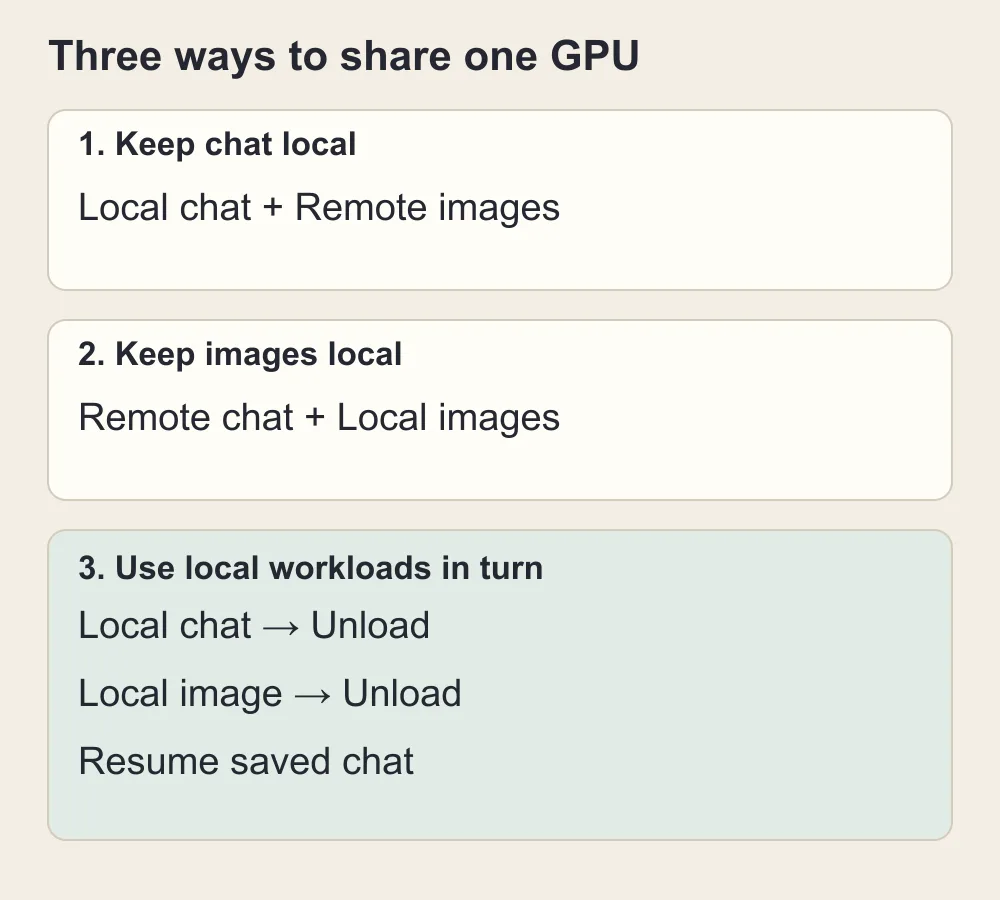
片方をリモートにするか、ローカルの会話と画像が順番にGPUを使うようにします。
何もしていないチャット画面でもVRAMの大半を使う理由
分かりにくいのは、チャットが休んで見えることです。返答を生成しておらず、GPU使用率が下がり、マシンも静かなのに、ComfyUIが画像モデルを読み込めません。使用率は今行っている仕事を表し、メモリ占有量は次の仕事のために保持する資源を表します。ほとんど何も処理していないバックエンドでも、大きな領域を確保したままにできます。
モデルのダウンロードサイズだけでは説明できません。LLMには会話キャッシュと一時的な計算領域も必要です。重みが同じでも、コンテキスト設定を大きくすると負担が増える場合があります。画像生成にもモデルの構成要素と一時領域があります。負荷のピークは、最初のダウンロードや接続ではなく、読み込みに成功したように見えた後に来ることもあります。
この違いは、llama.cppのメンテナーによるメモリ確保の説明にもあります。重み、コンテキストキャッシュ、計算バッファーは別々に確保されます。GPUの箱に書かれた容量からGGUFファイルのサイズを引くだけでは、ComfyUIのための余裕を判断できない理由です。
説明用に、16GBカードでデスクトップなどが1GBを使い、テキストバックエンドが11GBを占めるとします。画像処理の開始前に残るのは約4GBです。これは計算の意味を示す仮の数値で、Z-Imageの測定値でも推奨配分でもありません。あるモデルが16GBの機器で動くという公表は、残った4GBの中でも動くという意味ではありません。
Z-Imageの公式リポジトリは、Turboが16GB以内の一般向け機器で動くことを説明し、メモリに制約がある構成向けにCPUへのオフロードを提供しています。これは画像モデルの導入条件の説明です。別のロールプレイLLM、長い会話キャッシュ、複数のアダプター、同時推論する別プロセスの領域まで確保してくれるわけではありません。
変更前に、GPUの使用率ではなくメモリを見ます。Windowsならタスクマネージャーのパフォーマンスで、実際の独立GPUを選びます。専用GPUメモリと共有メモリを区別してください。ほかの環境ではGPUメーカーの監視ツールやバックエンドの確保ログを使います。重要なのは一時的にGPUが暇かではなく、どのプロセスが読み込まれたままかです。
4つの短い確認で失敗する段階を見つける
別の量子化版を試したり、SillyTavernを入れ直したり、モデルをアンロードするカスタムノードを追加したりする前に確認します。接続の問題もVRAMの問題も画像が出ないため、チャット画面では同じ失敗に見えることがあります。
最初に会話だけを試します。 画像バックエンドを完全に閉じ、普段のテキストバックエンドを起動して、通常のロールプレイの返答を1つ生成します。すでに遅いか記録します。ここで遅ければ、まだ画像との共用の問題ではありません。ローカルLLM自体の負荷が大きい、実行バックエンドが適切でない、あるいは大きなプロンプトを処理している可能性があります。
次に画像ワークフローだけを試します。 テキストバックエンドを止め、ComfyUIを起動し、ComfyUI自身の画面で画像を1枚生成します。ワークフローが想定する設定で1枚だけ使います。ローカルLLMなしでも失敗するなら、会話のコンテキストを短くしても解決しません。まず画像側の導入、足りないファイル、対応しないノード、必要メモリを直します。
次に動作した画像バックエンドへSillyTavernを接続します。 LLMを止めたまま、Image GenerationのExtend free-mode promptsを無効にし、/sd a fictional adult lounge singer age 29 in a black satin evening outfit, seated beside an amber lampのような手動コマンドを使います。テキストモデルによる追加のプロンプト作成を飛ばすためです。ComfyUIでは動くのにSillyTavernが送信しないなら、画像ソース、サーバーのアドレス、API形式のワークフローを調べます。別サービスを指すURLは解像度を下げても直りません。
最後にLLMを読み込んで同じ確認をします。 大きな違いは、テキスト処理が加わったことだけです。それまで画像が動いてここで失敗するなら、メモリを分ける対策を試す理由があります。画像は動いても、その後の会話が極端に遅くなるなら、ComfyUIがモデルを保持していないか、テキスト側が遅い処理方式へ切り替わっていないか調べます。
ここまで動いたら、5つ目の比較も有用です。手書きの画像プロンプトと/sd lastを比べます。後者は最近の会話を説明するテキストモデルの段階を追加します。手動ならComfyUIへ届くのに会話に基づく要求が届かない場合、失敗は画像描画ではなくプロンプト作成にあるかもしれません。LLMの拒否、空の返答、形式が崩れた説明は、画像バックエンドのメモリを空けても直りません。
ComfyUIの失敗時の段階をそのまま記録します。モデル読み込み、テキストのエンコード、サンプリング、画像のデコード、後続の細部処理のどれかが分かれば、外す処理が分かります。最後の拡大処理で失敗するなら後回しにでき、メインモデルの読み込み失敗なら別のメモリ配分が必要です。
構成1:ローカルのロールプレイを保ち、画像は別の場所で作る
今のローカルキャラクターモデルが気に入っていて、1回の会話で画像を数枚しか作らないなら、私なら最初にこの構成を選びます。テキストの設定はそのままにします。望んだ会話でなくなるほど履歴を削る代わりに、画像生成の負荷を移します。
SillyTavernがすでに対応しているソースを使う
Extensionsを開き、Image Generationを展開します。Sourceでは、現在の対応ソース一覧に実際にあるサービスを選びます。テキストモデルのアドレスを画像パネルへ貼るのではなく、そのソースの認証情報とモデルを設定します。ソース一覧と各連携の操作は、公式のImage Generation文書を参照します。
自動トリガーを有効にする前に、露骨な表現を含まない控えめなキャラクターポートレートを1枚生成します。サービス、認証情報、選んだモデル、結果の処理が一緒に動くか確認できます。連携が一覧にあることは、その先の全モデルが望む成人向け場面を受け付けるという約束ではありません。
サービス固有の画像URLを別会社の汎用API URLに置き換えても、連携が変換してくれるとは考えないでください。どちらもプロンプトを受け付けても、要求本文、ジョブの状態、画像の返し方、認証、エラーが異なることがあります。API URLという欄があっても、すべてのAPIを交換できるわけではありません。
別のコンピューターでComfyUIを動かす
今のチェックポイントとLoRAを使いたいなら、ワークフローを残して実行場所を移します。まず別のマシンで生成に成功させます。対応するソフトウェア、モデルファイル、導入済みノードが必要です。ワークフローJSONは部品を参照するだけで、すべての部品をファイル内へ詰め込むものではありません。
SillyTavernのImage GenerationパネルでComfyUIを選び、Standard Serverを選択します。SillyTavernサーバーが動くマシンから届くアドレスを入力してConnectを使います。スマートフォンでリモートComfyUIのページを開けるだけでは、SillyTavernのホストから到達できる証拠になりません。
両サービスが別のマシンで動くとき、127.0.0.1は要求を出すマシン自身を指します。別のコンピューターのComfyUIには届きません。その環境へ実際に接続できるアドレスを使います。オンラインのホストなら適切に保護された接続を使います。家庭用の構成で、制限のないComfyUIを一般公開する必要はありません。
最初の生成に成功したら、保存したAPI形式のワークフローを追加します。同じ結果を狙うならチェックポイントとアダプターを維持します。リモートGPUで別の量子化版を使う場合はローダーノードを更新し、似た名前のファイルだから同じ挙動だと決めつけません。画像モデルが別マシンのメモリを使うため、ローカルLLMは読み込んだままにできます。
ComfyUIをすでに使い慣れているなら魅力的です。今夜2枚の画像が欲しいだけなのに、まずサーバー管理を覚える必要があるなら適しません。連携が少なくても、ブラウザーの生成ツールのほうが実用的な場合があります。
チャットの隣でSpicyAPIを使う
確認したSillyTavernのImage Generation実装には、SpicyAPIの画像タスクはネイティブソースとしてありません。その非同期生成契約は、ComfyUIのURL欄へ貼ったり、AUTOMATIC1111の画像エンドポイントとして扱ったりできるものではありません。本ガイドは、両プロトコルを交換可能にするアダプターを提供せず、テスト済みとも主張しません。
それでもローカルのロールプレイを開いたまま、別タブでZ-Image Spicyのモデルページを使えます。Playgroundを開き、現在の場面の視覚的な説明を貼り、寸法を設定して生成し、画像をダウンロードします。画像の推論はリモートで行うため、ローカルGPUはLLMに使えます。
最初のポートレートなら832×1216画素を選び、プロンプト拡張を無効にして、特定の服と部屋にいる架空の成人を1人描写します。両辺ともZ-Image Spicyの公開範囲256〜1536画素以内です。これは最初の構図案であり、この場面を生成したり、ローカルのチェックポイントと品質を比較したりしたという主張ではありません。
リモート画像サービスには、視覚的なプロンプトとアップロード画像が送られます。画像を作るためにロールプレイ履歴全体を送る必要はありません。外見の特徴と現在の場面だけをコピーし、非公開のメモ、実名、静止画に不要な情報を除きます。
構成2:ローカル画像ワークフローを保ち、会話をAPIへ移す
画像モデルのほうを細かく調整しているなら、この構成を選びます。特定のイラスト用チェックポイント、キャラクターLoRA、ポーズ制御、場面のワークフローをブラウザーサービスで再現できない場合があります。画像の仕組みを別の場所で作り直すより、会話を移すほうが簡単なことがあります。
最初にすることは、API選択を変えるだけでなく、ローカルのテキストバックエンドを止めることです。llama.cppやOllamaなどのサーバーが裏で読み込まれたままだと、回収したかったメモリを使い続ける可能性があります。戻せるように接続プロファイルを保存してから、選んだホスト型チャットソースへ接続します。
SillyTavernは画像ソースとは別にホスト型チャットへ対応しています。選んだプロトコルのAPI Connections文書に従います。分類がChat CompletionでもText Completionでも、ソースはローカルにもホスト型にもできます。名前はプロンプトの送信方法を示し、GPUの場所を示すものではありません。
SpicyAPIのチャットには、SillyTavernのロールプレイ接続ガイドにCustom OpenAI-compatibleの設定と、モデル別の非対応パラメーターの扱いがあります。チャットモデル欄へ画像タスクのモデルIDを入れるのではなく、実際の設定を使います。本記事の目的は画像用にGPUを空けることなので、全チャットモデルの設定を繰り返す必要はありません。
ComfyUIへ戻り、単独で成功したワークフローをそのまま実行します。GPUが空いて見えても、すぐに画像処理の段階を増やしません。最初の連携要求を単独実行時と同じにすると、会話の経路変更で干渉が消えたか比較できます。
ホスト型LLMも画像処理の流れに役立ちます。SillyTavernがローカルComfyUIへ送る前に、現在の場面を画像プロンプトにできます。テキスト要求なのでチャットサービスを使い、別の大きなローカルモデルをGPUへ読み込まずに済みます。
引き換えになるのは会話のプライバシーとトークン課金です。チャットAPIにはSillyTavernが含めたコンテキストが送られ、キャラクター説明、指示、選択された設定資料、会話メッセージなどが入る可能性があります。会話をローカルだけで処理することが必須なら、小さな技術調整ではありません。テキストを処理する場所を変える選択です。
各画像の後の最初の返答を見ます。会話が快適になり、ComfyUIも正常に終わるなら、GPUメモリの主な競合は解決しました。画像が単独のときと同じように遅いなら、問題はホスト型へ移した会話ではなく画像処理の内部にあります。
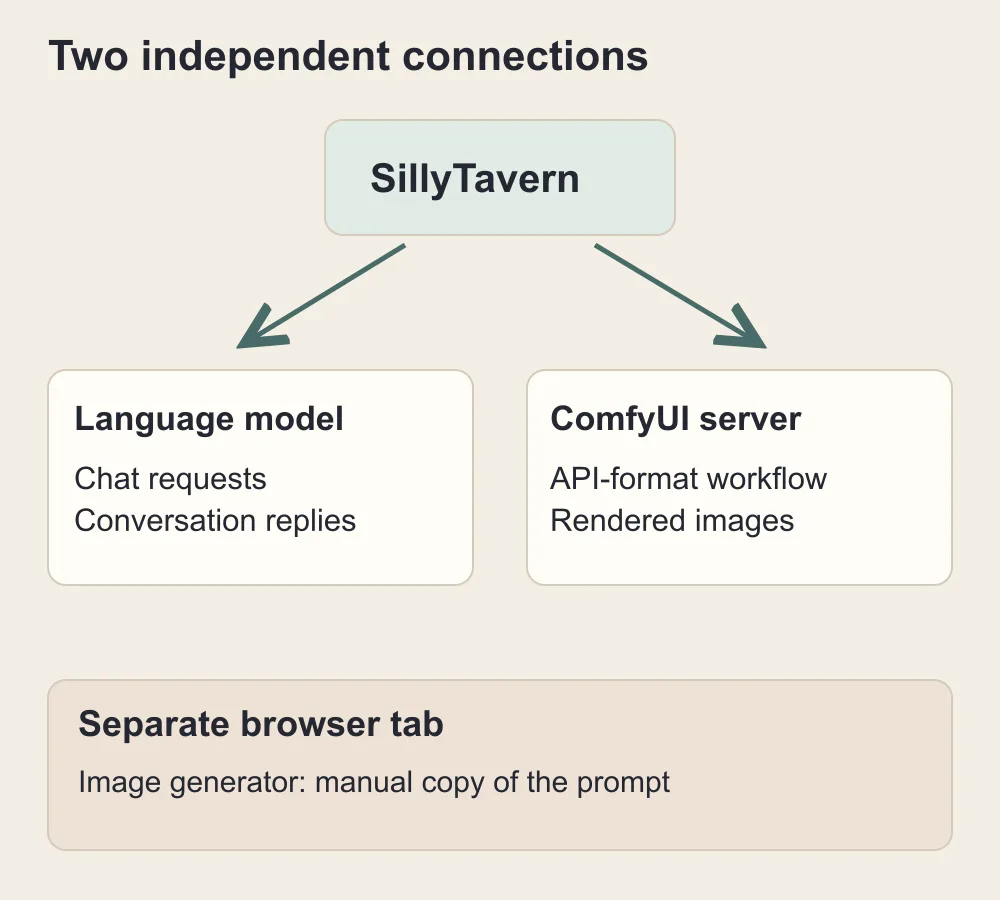
会話と画像ソースは別々の接続です。チャットの隣のブラウザー生成は手動の方法で、ネイティブのComfyUI連携ではありません。
構成3:すべてローカルに置き、順番に使う
会話の文章も画像プロンプトもマシンの外に出したくなければ、GPUを順番に使います。画像作成を会話の短い休憩として扱います。キャラクターを削除したり新しいチャットを始めたりするのではなく、GPU領域を保持するバックエンドを一時的に変えます。
保存した会話と、読み込まれた会話キャッシュは別です。SillyTavernはチャットデータを保持し、バックエンドのメモリ内キャッシュは次の要求を速く処理する助けになります。停止やアンロードでキャッシュを失う場合があります。モデルを戻した後の最初の要求では、コンテキストを再処理する可能性があります。物語は残りますが、再開後の最初の返答は長くかかることがあります。
作業の順序
- 現在の返答を終え、別の要求を送る自動再生成や画像トリガーを止めます。
- テキストモデルが読み込まれている間に視覚的なプロンプトを作って保存するか、自分で書きます。
- 現在の会話を保存し、画像説明を貼り付けられる場所に置きます。
- テキストバックエンドをアンロードまたは停止し、専用GPUメモリが実際に減ったことを確認します。
- 保存した説明でComfyUIの画像を1枚生成します。
- 完成画像をダウンロードまたは保存し、ComfyUIのモデルをアンロードするかバックエンドを止めます。
- メモリが再び使えることを確認し、保存設定でテキストバックエンドを起動し、必要なら接続し直します。
- 同じ会話を続けます。前のキャッシュが失われていれば、最初の返答でコンテキストを再構築します。
プロンプト作成はアンロードの前です。LLMを止めてから/sd lastで同じバックエンドに場面説明を求めると、画像要求の前半に必要なサービスを外してしまいます。画像生成中は、すでに保存した説明を手動の/sd要求で使い、Extend free-mode promptsは無効にします。
最初は手動で行います。停止と再起動が見える手順はアンロード拡張より洗練されていませんが、基本のメモリ配分が動くか分かります。テキストプロセスを止めても画像が失敗するなら、自動切り替えは失敗を素早く再現するだけで、修復しません。
Ollama:ウィンドウだけでなくモデルをアンロードする
Ollamaには明示的な停止コマンドとkeep_alive設定があります。すぐに使える手動操作は、導入環境に表示される正確なモデル名を使ったollama stop YOUR_MODEL_NAMEです。公式FAQでは、対応するAPI要求でkeep_aliveをゼロにし、使用後にモデルをアンロードする方法も説明しています。
この構成では、先に画像説明を完成し、モデルを止め、それから画像の処理へ移ります。次のチャット要求でOllamaがモデルを再び読み込むことがあります。ComfyUIがカードを使う間はバックグラウンドの自動プロンプト生成を止めます。そうした要求で、都合の悪い時にLLMが戻る可能性があるからです。
どのチャットクライアントでも、どのAPI種別からでも、全Ollama固有パラメーターを設定できるとは考えません。明示的に対応する設定か文書化された停止コマンドを使います。contextというスライダーや汎用の要求本文欄が、Ollama固有のライフサイクル制御を実装しているとは限りません。
llama.cpp:バックエンド自身のライフサイクルを使う
単一モデルのllama-serverプロセスなら、画像ワークフローの読み込み前にプロセスを止めるのが、確保領域を解放する分かりやすい手動操作です。後で同じ起動設定で再開します。ブラウザーを閉じる、チャットを放置する、SillyTavernの選択モデル名を変えるだけで別プロセスが止まるとは考えません。
最近のllama.cppサーバーにはモデル管理機能もありますが、操作は起動方法と導入バージョンによります。単一モデルと複数モデルのルーターは別の構成です。実際のサーバーに文書化された操作を使い、別バックエンド向けのアンロード要求をコピーしません。
ComfyUI:自分のモデルを解放してもLLMは解放しない
ComfyUIの公式サーバー実装には、/free操作とunload_models、free_memory制御があります。実行システムが処理するフラグを設定します。別で動くllama.cppプロセスを終了する指示ではなく、要求を受理したことも、求めた全メモリがすでに解放された証拠ではありません。
画像生成後は、自分のComfyUIフロントエンドや環境で利用できるモデルのアンロード操作を使います。適した操作が見つからなければ、ComfyUIバックエンドの停止が分かりやすい手動の基準です。ブラウザーのタブだけを閉じてもサーバープロセスは止まりません。
アンロード用カスタムノードも役立ちますが、実行順が正しい場合に限ります。後の細部処理がモデルを必要とする前に実行すると、モデルが再び読み込まれる可能性があります。ComfyUIのモデルしか外さないなら、ロールプレイのバックエンドは残ります。両アプリケーションを制御すると思い込む前に、ノードの文書を読みます。
メモリ調整の前にComfyUIの接続を動かす
SillyTavernのComfyUI対応は本物のワークフロー連携で、あらゆる画像APIを橋渡しする仕組みではありません。API形式のグラフをComfyUIサーバーへ送り、結果を取得します。デスクトップで正しく見えるワークフローでも、書き出した形式が違う、プロンプトが固定されたまま、といった理由でSillyTavern経由では失敗します。
ComfyUI自身で始めます。使う予定のチェックポイント、テキストエンコーダー、VAE、導入済みノードで1枚生成します。後で画面から開けるように通常のワークフローを保存します。その後、フロントエンドが提供する操作でAPI版を出力します。メニュー名はバージョンにより変わります。
SillyTavernのImage GenerationでComfyUIを選び、通常のローカル導入ならStandard Serverを選択し、ComfyUIサーバーが表示したアドレスを使います。文書にある初期値はhttp://127.0.0.1:8188です。このローカルアドレスはアプリケーション設定に入れるもので、公開サイトや他人に公開するアドレスではありません。
Connectを選び、目的のワークフローを作成または選択し、API形式のグラフをワークフローエディターに入れます。連携は正のプロンプト用の%prompt%などの置換を提供します。実際にその値を受け取る場所だけに使います。置換のないワークフローは有効なComfyUI JSONでも、毎回元のデモ用プロンプトを描くことがあります。
CLIP Text Encodeを使うグラフなら、正のコンディショニングへつながる実際のテキスト欄を探し、試用の説明をプロンプト置換に変えます。カスタムローダーなど別ノードが文章を受け取るなら、置換もそこに置きます。エディターで緑のチェックを出すためだけに、つながっていないテキストノードを増やしません。
意図的に違う2つの画像要求を送ります。最初は成人のラウンジ歌手、次はろうそくの灯る無人の部屋です。両方で同じ人物が出るなら、シード変更や新モデルの導入より先に書き出したグラフを調べます。固定されたプロンプトから調べるのが妥当です。色や雰囲気しか変わらないなら、別の接頭辞やテキスト欄に元の人物説明が残っていないか確認します。
変える価値のあるメモリ設定と、誤解しやすい設定
フォーラムのコメントにある最適化フラグを全部まとめて使わないでください。テキストの負荷を減らすのか、画像の負荷を減らすのか、使わないメモリの保持方法を変えるのかを理解する必要があります。それぞれ別の対策で、次の返答への影響も異なります。
キャラクター品質を削る前にテキスト側のコンテキストを短くする
32K以上のコンテキスト設定は、その晩に必要な量より多く確保する場合があります。キャラクターカード、指示、関連する設定資料、最近の会話が収まるなら、4096や8192トークンなど、小さいバックエンドコンテキストの保存プロファイルを試します。これはプロファイルサイズの例で、どのモデルもメモリに収まるという約束ではありません。
SillyTavernの要求コンテキストもバックエンドに合わせます。クライアント側の送信履歴だけを減らしても、起動時に確保したキャッシュは減らない場合があります。逆にクライアントのスライダーを上げても、サーバーの実容量は増えません。バックエンドの確保に関わる設定は、バックエンド側で変え、実装が求める再起動や再読み込みをします。
llama.cppのサーバー資料にはコンテキストサイズ、GPUレイヤー、キャッシュ種別、KVオフロードが説明されています。導入バージョンのヘルプにある名称を使います。テキストモデルが機器に自動で収まることは、別アプリケーションが後で画像生成のピークを迎えても余裕が残るという約束ではありません。
GPUレイヤーを減らすとテキスト推論の一部をGPUから移します。処理が遅くなる代わりに領域を空けられます。会話キャッシュの量子化は、量子化モデルファイルを選ぶこととは別の操作です。Q4の重みならキャッシュも4ビットだとは限りません。
単純な生成で画像のピークを下げる
バッチサイズを1にします。複数の画像を順に作ることと、ワークフローに同時バッチを処理させることは違います。モデルの通常の縦横比と妥当な初期サイズを使い、基本画像が成功するまでは2回目の高解像度サンプリングを避けます。
VAEのデコードで失敗するグラフなら、対応するタイル分割デコーダーを試す価値があります。メインモデルの読み込みで失敗するなら、タイル分割デコードで重みは小さくなりません。顔の細部処理や拡大だけで失敗するなら、その段階を会話中のワークフローから外し、テキスト側を止めて後から行います。
実際のプログラムでLow VRAMが何を意味するか読む
ComfyUIの現在の引数定義は、動的メモリ管理と従来のフラグを区別しています。DynamicVRAMが有効なら--lowvramは何もしません。無効ならテキストエンコーダーをCPUへ移すフラグです。「どの画像モデルも残りの空き領域に収める」より限定的な意味です。
ComfyUIにはメモリの予約や、より積極的なオフロードの選択肢もあります。予約は別ソフトウェアの領域を残す助けになりますが、ComfyUIとチャットバックエンドを共同で管理するスケジューラーではありません。最低限必要な負荷の合計が収まらなければ、予約から追加メモリは生まれません。1つだけ変更し、同じ1枚の要求を繰り返します。
KoboldCppでは操作が違います。SillyTavernのクイックスタートは、掲載画面のLow VRAMチェック欄を選ばないよう明示しています。古いランチャーの説明なので、導入済みバージョンのヘルプも見ます。同じ名前を別アプリケーションが使っているだけで設定をコピーしない、というのが実用上の教訓です。
AMDカードでも設定の詳細が変わるだけで、メモリの計算は同じ
最近のコミュニティの質問はAMDとllama.cppのVulkanバックエンドに関するものでした。NVIDIA向けチュートリアルのCUDA起動コマンドを貼るより、対応する実行経路を見る理由になります。使える高速化、数値形式、演算子は、GPU、OS、ビルド、実際のバックエンドによって変わります。
まず各アプリケーションがカード上で単独で動くことを確認します。Vulkanのテキスト処理が成功しても、ComfyUIが適切な高速化された画像バックエンドを使う証拠にはなりません。画像モデルが動いても、ローカルLLMが意図したバックエンドでビルドされたとは限りません。起動メッセージと、単独確認中の実際の使用機器を見ます。
テキストも画像も単独なら速く、組み合わせると失敗する場合、GPUブランドに関する設定を変えても、基本的な領域不足は解決しそうにありません。片方をリモートへ移すか順番に使います。片方だけでも遅いなら、同時実行を調べる前に、そのアプリケーションを解決します。
全構成の説明なしに「8GB向け」と書かれた量子化画像モデルには注意します。テキストエンコーダーが容量から除かれ、オフロードや特定ノードに依存し、GPUが空いている前提かもしれません。ダウンロード前に、そのモデルのローダー要件を読み、導入済みバックエンドが量子化方式に対応するか確認します。
物語全体を送らずに成人キャラクターの場面へ画像を合わせる
構成が動くようになっても、画像に失望する原因はメモリだけではありません。ロールプレイモデルが、カメラに映るものではなくキャラクターの気持ちを描写していることがあります。それでは、もっともらしいポートレートでも部屋、服、現在の動作を無視した画像になります。
Maraという架空の成人なら、変わらない外見と現在の場面を分けます。固定情報は29歳、短い黒髪のボブ、銀のイヤーカフ、肩の小さな三日月のタトゥーなどです。現在の情報は黒のサテンの服、ベルベットのラウンジチェア、暖かい薄明かり、自信のある横目などです。物語が別の部屋へ移ったとき変えるのは後者だけです。
調整して使える視覚的な説明案です。本記事のモデルテストには使っていません。
29歳の架空の成人ラウンジ歌手。短い黒髪のボブと銀のイヤーカフがあり、身体に合った黒いサテンの夜の服を着て、深いバーガンディーのベルベットチェアに横向きに座る。表情は自信があり遊び心がある。テーブルランプから暖かい琥珀色の光が落ち、背後には深夜のラウンジが柔らかくぼけて見える。ミディアムポートレート。手は力を抜いて見える位置に置く。親密なエディトリアルの雰囲気で、文字は入れない。
ラウンジからバルコニーへ移ったなら、識別の特徴をすべて書き直さず、場所と照明を変えます。会話で着替えたなら新しい服を明示し、古い服を外します。画像モデルが文章にできる限り従っていても、服の説明が矛盾すると違う場面になります。
キャラクター固有の接頭辞は説明の一貫性に役立ちますが、同じ顔の保証ではありません。対応する参照画像や専用LoRAが必要なほどキャラクターの外見の一貫性が重要なら、実際にその方法へ対応するワークフローが必要です。キャラクターカードの文章とアバターが、すべての画像ソースへ自動で参照入力されるわけではありません。
テキストモデルをアンロードする前に画像説明を保存し、後で保存済みのチャットを再開します。
たまに使うリモート画像の実際の費用
時々のモデル切り替えを避けるために機器を買う前に、ブラウザーの画像生成を検討する価値があります。現在のSpicyAPI公開カタログで、Z-Image Spicyはプロンプト拡張なしで1枚$0.01235、拡張ありで$0.0133です。Z-Image Spicy Proは1枚$0.019です。画像料金であり、サブスクリプションやホスト型チャットの料金ではありません。
| 予定する画像要求 | Spicy、拡張なし | Spicy、拡張あり | Spicy Pro |
|---|---|---|---|
| 10 | $0.1235 | $0.133 | $0.19 |
| 50 | $0.6175 | $0.665 | $0.95 |
| 100 | $1.235 | $1.33 | $1.90 |
表示された1枚の料金を掛けた計算です。残したくなる画像までの試行数を見積もるものではありません。4案作って1枚を選ぶなら、要求した4回分を予算に入れます。追加するなら、プロンプトを書くチャット呼び出し、さらなる編集、拡大は別の作業です。
1晩で10枚なら、掲載の画像部分の費用は小さく、ローカルモデルを止めて読み直す手間と比べられます。オフライン使用、特定のローカルLoRA、プロンプトをマシン内に保つ要件があるなら、価格だけで決まりません。低い1枚料金より、それらの要件が重要な場合があります。
1辺2560画素までの公開寸法範囲が必要ならSpicy Proページを選びます。最大1536画素の辺でポートレートを作れるなら通常のSpicyエンドポイントを選びます。最大寸法の違いは確認された機能差であり、あらゆる成人キャラクター場面でProが優れる証拠ではありません。
実際に見えている症状を直す
ComfyUIで生成できるのにSillyTavernで画像が使えない
Image Generationで設定済みソースを選びます。新規導入や古い環境に、未接続ソースが残っていることがあります。チャットAPI URLではなく画像パネルのアドレスを確認します。クラウドなら、その画像用認証と設定を使います。テキスト接続の成功は画像接続の成立を意味しません。
短い手動画像要求を試します。動いたら会話に基づくプロンプトへ進みます。複雑な自動トリガーから始めると、ソースへ届かないのか、メッセージにトリガーが一致しなかったのか判断しにくくなります。
接続するが、全画像がワークフローの例と似ている
API形式のワークフローを開き、グラフが実際に使う正のテキストを探します。固定例を、その実入力のプロンプト置換へ変えます。ほかの有効なテキスト欄や接頭辞にも古い被写体が残っていないか見ます。シード変更だけでは、固定されたプロンプトの別案が出るだけです。
チャットモデルを読み込んでいる間だけ画像が失敗する
単独で成功した画像ワークフローはそのままにし、リモート画像、ホスト型チャット、ローカルの順次利用のどれかでメモリを分けます。同時ローカル実行を望むなら、まずバックエンドの実コンテキスト確保量かGPUレイヤーを減らします。同じ組み合わせを何度も試しても空きメモリは変わりません。
最初の画像は動くが、次の会話が遅くなる
画像完成後のメモリを調べます。ComfyUIが再利用のためにモデルを保持し、テキストバックエンドが遅いメモリへ処理を移した可能性があります。次の返答前に画像処理をアンロードするかリモートへ移します。チャットプロセス再起動で速度が戻るなら、全容量を使う設定を再び競合させず、小さめの共用プロファイルを保存します。
ComfyUIをアンロードしてもVRAMが埋まっている
残る領域を持つプロセスを特定します。ComfyUIが解放できるのは自分のモデルで、別アプリのLLMは外せません。確保されたキャッシュと、実際に機器へ返されたメモリも区別します。手動の基準では、バックエンドのプロセスを意図的に止め、メモリ変化を確かめてから再起動します。
最後の場面を頼んでも画像が始まらない
プロンプト拡張を無効にし、同じ場面を手書きのfree-mode要求で試します。動くならテキストモデルのプロンプト作成を調べます。エンドポイントが停止中、返答が空、あるいは指示がワークフローの期待形式ではなく散文を出している可能性があります。画像メモリを空けても、ないテキスト返答は直りません。
描画が始まってから最後の仕上げで失敗する
会話中のグラフからdetailer、2回目のサンプリング、アップスケーラーを外して基本画像を生成します。成功したら保存し、テキスト側をアンロードして追加段階を別に行います。仕上げ用の複雑なワークフローを残しつつ、会話中の即興画像すべてに使う必要はありません。
GPUが埋まっていないのに極端に遅い
意図した高速化機器で実行されているか、システムRAMが足りなくなっていないか確認します。大量のCPUオフロードは技術的には動いても、会話には不快なほど遅くなります。別のVRAM最適化でさらにオフロードを増やすより、片方をリモートへ移すほうが明確な改善になる場合があります。
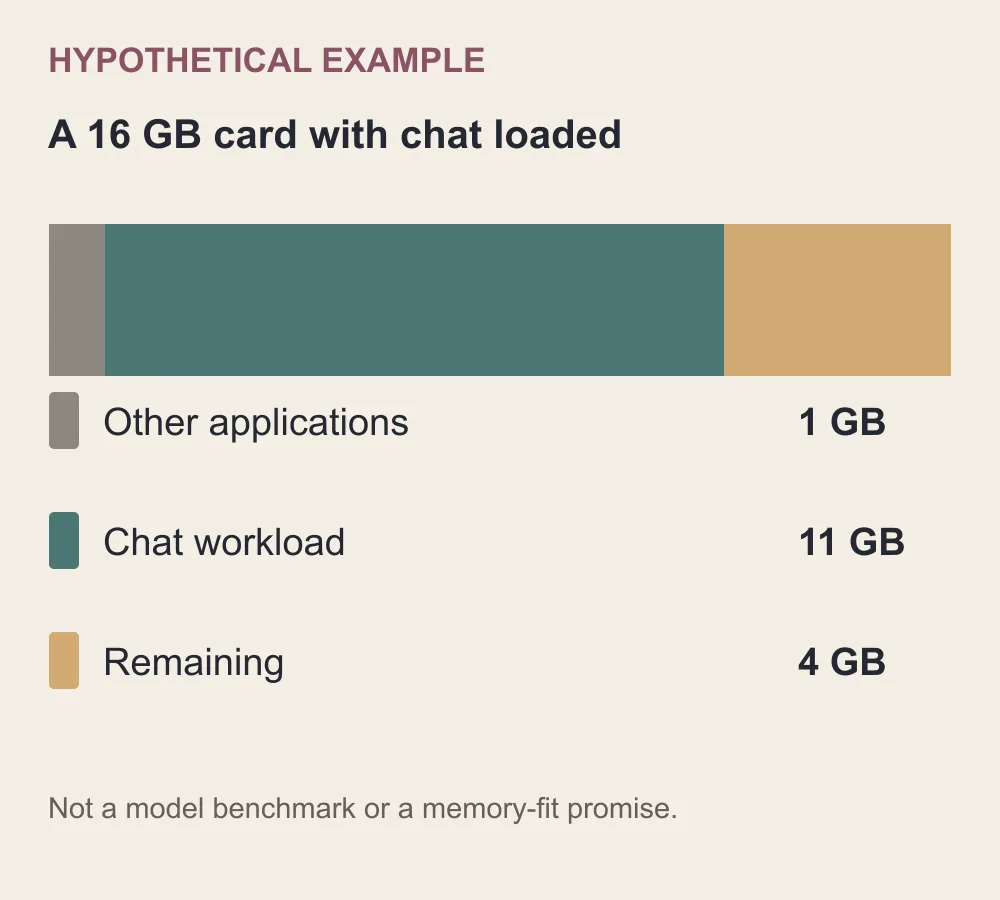
説明用の数値です。空の16GBカードに収まるモデルでも、大半をLLMが使う状態では収まらない場合があります。
次のセッションに向けた現実的な出発点
8GBなら、負荷の大きな生成処理をローカルでは1つにします。良いローカルのロールプレイモデルがあるなら読み込んだままにし、対応するリモートソースか別ブラウザータブで時々画像を作ります。良いローカル画像ワークフローがあるならテキストバックエンドを止め、ホスト型チャットを使います。滑らかなテンポより素材を自分のマシンへ保つことが大切なら、完全ローカルの切り替えを選びます。
16GBでも、LLMが大半を使うなら同じ単純な構成から始めます。試せる余裕があれば、まず画像が単独で動くことを示し、小さなチャットプロファイル、画像1枚、細部処理なし、制限したコンテキストで試します。安定した組み合わせは役立ちますが、会話が長くなる前しか収まらない構成は、一晩使える計画にはなりません。
目指すのは、失敗したタスクを何度も再起動する代わりに、読み書きを続けられるセッションです。GPUの仕事を明確にし、SillyTavernが実際に対応するプロトコルで画像ソースへ接続し、最初の会話中ワークフローを原因を調べられるほど小さくします。動いたら、最も欲しいキャラクター制御や仕上げを1つずつ加えます。