Un générateur NSFW accepte le prompt, commence à travailler et renvoie une tâche terminée. Vous ouvrez l’image : la scène est devenue bien plus sobre. Un autre service rejette immédiatement le même brief. Un troisième accepte le texte, mais refuse la référence nécessaire à votre série.
Ce sont trois expériences différentes. Un classement qui donne une simple coche « sans censure » à chacun masque la différence importante pour vous.
Pour un workflow adulte, choisissez l’endpoint exact de génération ou d’édition adapté à votre catégorie, puis jugez l’image livrée. Acceptation du prompt et réussite de la tâche sont nécessaires, mais aucune ne prouve que la scène demandée est arrivée. Sur SpicyAPI, génération et édition Qwen Image 3.0 sont classées sans censure ; Wan 2.7 Pro illustre l’importance de la tâche, avec texte vers image atténué et édition sans censure. Ces labels d’endpoints ne promettent pas la réussite de toute composition.
Pour comprendre les niveaux, séparez le traitement du prompt, de la référence et de la sortie, sans oublier les limites apprises du modèle. Ce sont des points observables, pas la preuve que chaque service possède exactement trois filtres internes. La sélection des données d’entraînement est autre chose et ne s’audite pas avec quelques prompts.
Ce guide explique les résultats, les choix qui en découlent et quand relancer revient simplement à dépenser sur le mauvais outil.
Ce que doit vous dire un classement à trois niveaux
Vous préparez une galerie payante avec un protagoniste adulte fictif : style photographique, scènes adultes et visage reconnaissable. Les questions sont simples :
- Le service accepte-t-il le brief adulte légal réellement voulu ?
- L’éditeur accepte-t-il votre source autorisée et conserve-t-il le personnage ?
- L’image livrée respecte-t-elle le brief ou change-t-elle discrètement l’élément important ?
Un modèle doué pour la mode suggestive peut devenir peu fiable dans une catégorie plus intense. Un éditeur peut accepter une source mais remplacer le visage, et ainsi mal convenir à la série sans aucun refus.
Pour une présélection, séparez compatibilité de contenu et qualité d’image. La première dit si la tâche mérite même d’être envisagée. La seconde concerne visage, pose, éclairage et style attendus par le client. Un large label NSFW n’est pas une note de qualité.
Un classement utile nomme la tâche, la catégorie testée et le résultat visuel réel. Il devient trompeur si « l’API a renvoyé quelque chose » signifie « tout a été livré ».
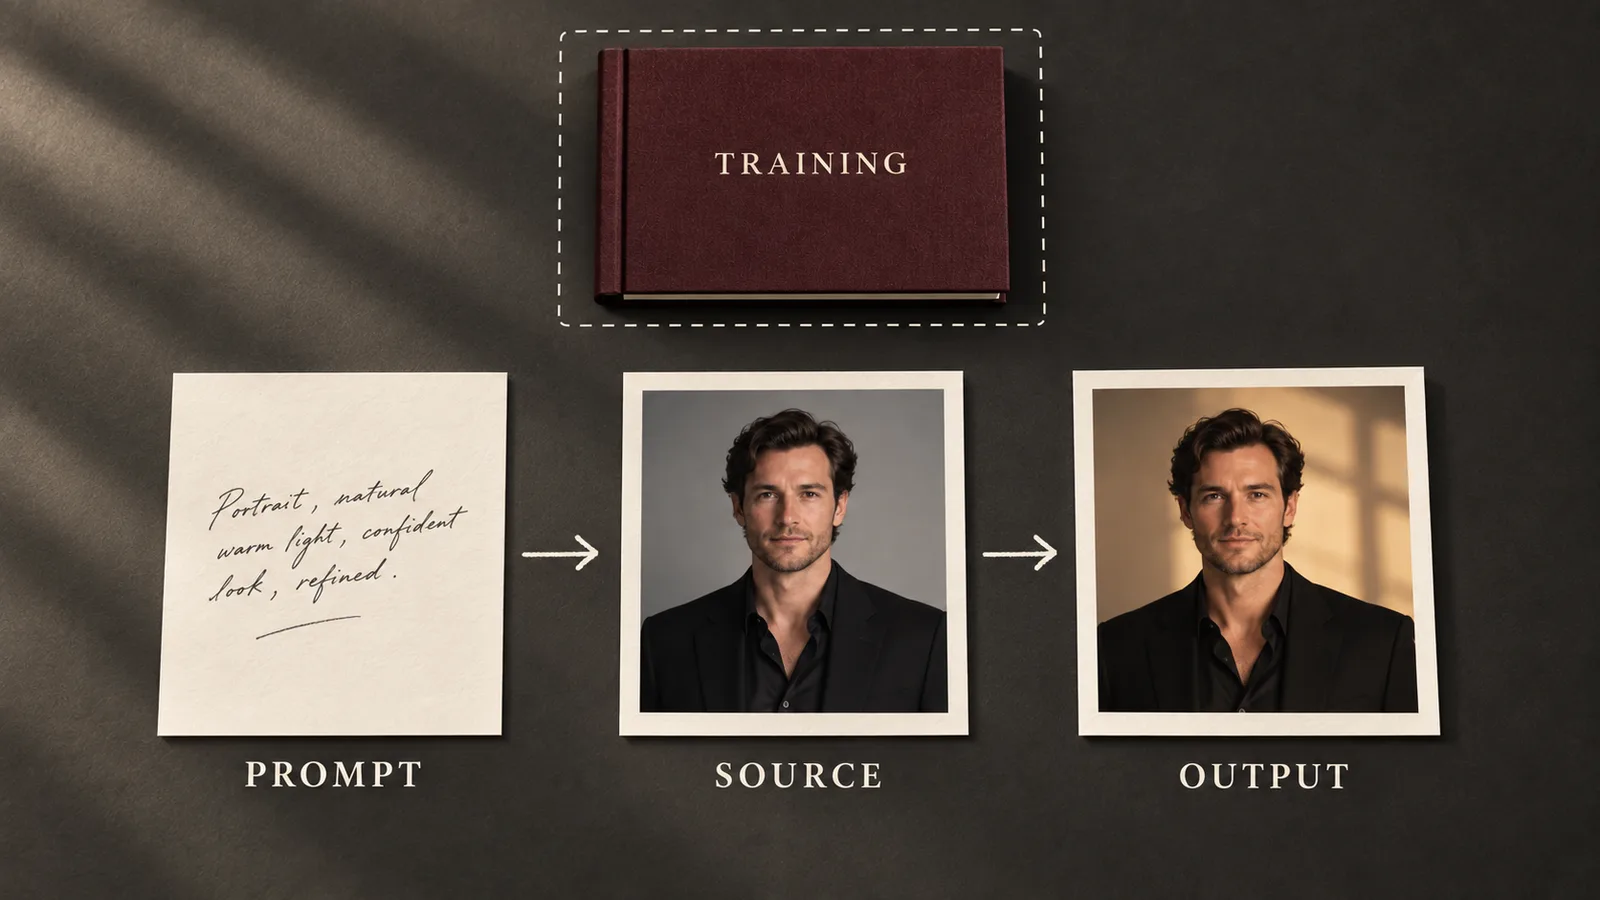
Illustration : trois points observables dans le workflow ; les décisions d’entraînement restent hors de ce diagramme de requête.
Une présélection pratique selon le comportement de contenu
Les entrées suivantes illustrent de vraies différences du catalogue public SpicyAPI. C’est une présélection de workflows, pas un nouveau benchmark visuel. Les prix sont en USD par image au réglage nommé ; confirmez le devis de vos entrées avant soumission.
| Tâche exacte | Comportement annoncé | Prix affiché | Conséquence pour le choix |
|---|---|---|---|
| Qwen Image 3.0 texte vers image | Sans censure | $0.03 en 1k ou 2k | Candidat pour de nouvelles images adultes ; examiner la scène plutôt que chercher un indicateur de déblocage |
| Édition Qwen Image 3.0 | Sans censure | $0.03 en 1k ou 2k | Candidat si un personnage existe déjà à réviser |
| Wan 2.7 Pro texte vers image | Atténué | $0.075 | Ne pas attendre le comportement de contenu de l’éditeur |
| Édition Wan 2.7 Pro | Sans censure | $0.075 | Évaluer l’édition depuis une source séparément de la génération |
| Z-Image Spicy texte vers image | Sans censure | $0.01235 sans expansion du prompt | Candidat peu cher pour des brouillons ; cette tâche n’édite pas un personnage enregistré |
| Nano Banana 2 texte vers image | Filtré | Dès $0.036 en 0.5k | À garder pour les briefs compatibles, pas pour acheter des sorties adultes sans restriction |
Pour un nouveau workflow photographique NSFW continuant en édition, commencez par évaluer les deux tâches Qwen Image 3.0. Pour des brouillons indépendants peu chers, envisagez Z-Image Spicy. Si une source nécessite l’édition Wan, évaluez cet éditeur directement ; le nom de famille ne rend pas le texte vers image équivalent.
Ces choix reposent sur disponibilité, labels et prix publics. Ils n’établissent pas de gagnant universel en anatomie, identité ou fidélité au prompt. Le comparatif des générateurs fournit une comparaison visuelle publique existante et ses limites d’échantillon. Utilisez ses observations pour ce qu’elles montrent ; une scène de mode publique ne définit pas l’étendue NSFW maximale.
Premier niveau : ce qui arrive au prompt
Un prompt peut échouer avant toute image. La cause peut être une restriction de contenu, mais aussi entrée invalide, modèle indisponible ou problème de compte. La correction dépend de la cause.
Si la réponse nomme explicitement un rejet de contenu, vérifiez si la scène appartient au périmètre de cet endpoint. Soumettre sans cesse le même brief à la même tâche restrictive est un mauvais réflexe. Si le brief adulte est légal et permis par le service, choisissez une tâche compatible plutôt qu’une astuce de formulation.
Si l’erreur concerne plutôt champ manquant, taille incompatible ou référence inaccessible, corrigez l’entrée. Ajouter « sans censure » ne valide pas un paramètre. Un paiement échoué ou un solde épuisé ne dit rien du comportement de contenu.
Le début de génération prouve que la requête a atteint une étape ultérieure. Il ne révèle pas vérification de mots-clés, analyse du sens, réécriture ou autre mécanisme. Seule une documentation ou réponse diagnostique claire étaye ces affirmations précises.
La documentation de sécurité d’images Google, par exemple, distingue refus du modèle, blocage du prompt et blocage de réponse. Elle nomme les retours de prompt et raisons de fin de sa propre API. Ces champs sont des preuves utiles pour cette interface documentée, sans exister nécessairement sur les autres.
Quand modifier le prompt est raisonnable
Clarifier un brief et contourner une politique sont différents. Si une scène légale est ambiguë, précisez adulte fictif, action, vêtements et composition. L’intention devient compréhensible. Cela ne garantit pas l’acceptation et ne doit pas être présenté comme un déblocage de catégorie interdite.
Pour un endpoint déjà adapté, simplifiez les directives concurrentes. « Gros plan », « en pied » et « plan large lointain » sont contradictoires. Un recadrage peut suivre l’une d’elles plutôt que retirer quelque chose par filtrage. Résolvez cette contradiction avant de conclure à une censure.
Deuxième niveau : la référence peut changer la réponse
Texte vers image et édition nécessitent des preuves différentes. Une génération textuelle ne teste jamais acceptation de référence, interprétation et conservation du personnage.
Chez certains services, les entrées d’images appartiennent à une sécurité documentée. La fiche système ChatGPT Images 2.5 d’OpenAI décrit contrôles des demandes textuelles, images entrantes, intention combinée et sorties. C’est un exemple concret de plusieurs niveaux, sans prouver le même fonctionnement ailleurs ou le même stade de refus.
Pour votre projet, rejet de référence et upload cassé peuvent paraître identiques dans « génération échouée ». Examinez l’explication. Un message de contenu demande une tâche compatible. Une erreur de format ou téléchargement demande un fichier valide accessible. Une image chargée mais ignorée demande d’examiner instruction et comportement d’édition.
Utilisez un adulte fictif ou une ressource avec consentement et droits documentés pour l’édition prévue. Commencez par une source et un changement clair. Modifier la lumière en gardant visage et tenue apprend plus sur l’éditeur que changer à la fois sujet, pose, lieu, tenue et style.
Si cette édition simple réussit, ajoutez le changement suivant. Si elle échoue seulement avec une deuxième référence, retirez celle-ci et vérifiez son rôle. Une référence de style peut influencer visage ou tenue au lieu d’apporter une palette. C’est un problème de commande de référence sauf preuve de blocage de contenu.
Un « éditeur sans censure » peut mal convenir s’il redessine trop. La liberté de contenu ne garantit pas l’identité ; un badge ne remplace pas l’inspection avant/après.
Troisième niveau : l’image réellement reçue
Après l’acceptation, deux problèmes diffèrent : une image peut être bloquée à la livraison, ou une image livrée peut manquer ou atténuer le brief. Les deux déçoivent mais demandent des explications différentes.
Un blocage de sortie documenté indique une retenue pour raison de contenu. Une tâche réussie avec image téléchargeable indique la livraison d’un visuel, pas la présence de tous les détails. Dans un produit adulte, cadrage changé, ambiance perdue ou relation visuelle omise peuvent rendre la scène inutilisable.
Avant de dire « atténué », comparez à l’instruction exacte. Un portrait glamour vaguement décrit devenu sobre peut simplement être sous-spécifié. Deux adultes demandés mais un seul rendu peuvent indiquer un problème de comptage ou composition. Ces échecs comptent sans suffire à diagnostiquer une couche interne de sécurité.
La preuve pratique la plus forte est un motif répété : scènes ordinaires permises bien suivies, catégorie adulte particulière régulièrement réduite. Enregistrez-le comme comportement de sortie observé. Sans explication du service, la cause reste inconnue : entraînement, guidage à l’exécution, réécriture ou autre détail.
Wan 2.7 Pro illustre l’achat. Son texte vers image est publiquement classé atténué, même si la plateforme décrit une transmission sans scan ajouté. Acheter davantage d’essais ne le transforme pas en son éditeur sans censure séparé. Choisissez la tâche au comportement adapté.
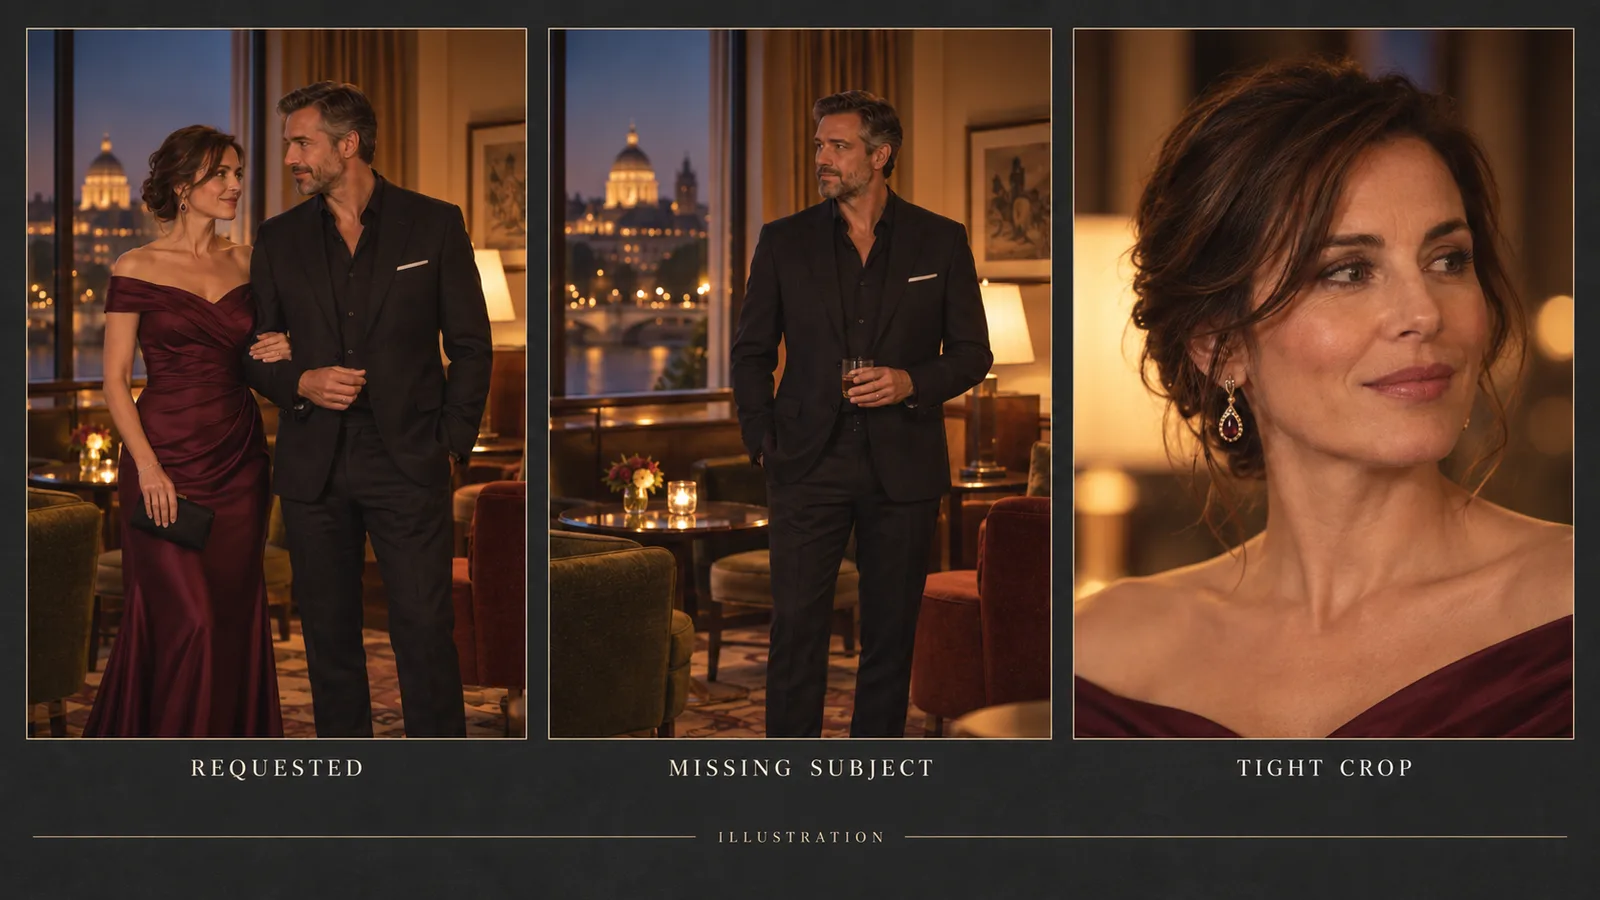
Illustration : sujet manquant et cadrage modifié sont deux écarts au brief ; ce ne sont pas des sorties de test.
Les filtres d’entraînement ne sont pas un interrupteur auditable par prompt
Certains articles parlent de filtrage du prompt, de la sortie et des données d’entraînement. Cette terminologie mélange les opérations d’une requête et les décisions de développement.
Sélection des données et développement ultérieur influencent connaissances et tendances de génération. Mais un utilisateur externe ne détermine pas un dataset non divulgué en essayant quelques prompts adultes. Une image ratée ne prouve pas l’absence des données pertinentes. Une réussite ne prouve pas la suppression de tous les filtres.
Des méthodes ne suivent pas non plus un simple schéma mots-clés puis contrôle de sortie. L’article de recherche PromptGuard décrit un guidage de sécurité par soft prompt appris dans l’espace d’embedding texte vers image. Il explique pourquoi observer le comportement ne reconstruit pas un système inconnu. C’est une méthode de recherche, pas une preuve d’usage par un générateur commercial précis.
Pour l’acheteur, la question utile est plus étroite : cette tâche hébergée exacte produit-elle fiablement la catégorie légale vendue par mon produit ? Demandez résultats et exemples propres à la tâche. « Filtre d’entraînement retiré », « trois niveaux désactivés » et « tous les prompts fonctionnent » exigent plus de preuves que quelques images choisies.
L’auto-hébergement donne accès au moteur sans améliorer automatiquement les capacités apprises. La documentation Stable Diffusion de Diffusers décrit le safety checker comme composant séparé du modèle. Savoir s’il existe diffère de savoir si le checkpoint rend bien la scène voulue.
Une image finale étrange n’est pas automatiquement de la censure
Une plainte récurrente : l’aperçu intermédiaire paraît prometteur, puis le résultat change. Dans une discussion Stable Diffusion sur un filtrage caché soupçonné, l’auteur soupçonne d’abord un filtre puis indique que le checkpoint d’inpainting recommandé par le créateur a résolu le problème. C’est une correction rapportée pour ce workflow, pas la preuve d’un filtre caché universel. D’autres explications des commentaires, dont le décodage d’aperçu, n’étaient pas confirmées.
Cette distinction compte pour diagnostiquer localement ou juger un hébergeur. Un aperçu intermédiaire n’est pas l’image livrée. Décodage, édition incompatible ou instruction surchargée peuvent donner un mauvais résultat sans rejet de contenu.
Si « le visage est devenu cireux », examinez pleine taille et réglages avant de chercher un interrupteur de censure. Si « toute la pose a changé », réduisez l’édition à un changement avec conservation explicite. Si une catégorie devient répétitivement plus sobre alors que les versions ordinaires fonctionnent, cela justifie d’examiner l’atténuation plutôt qu’un défaut aléatoire.
Gardez la même précision dans l’application. « Contenu rejeté », « référence impossible à charger » et « image hors brief » ne doivent pas tous devenir « erreur de modération IA ». Mal nommer l’échec mène à la mauvaise correction et complique le support.
L’effet de l’atténuation sur le budget réel
Une image facturée inutilisable peut rendre la production chère malgré un faible tarif affiché. Comparez le coût d’un résultat utile, essais créatifs ratés inclus, plutôt que compter les tâches terminées comme travail fini.
Au prix affiché Qwen Image 3.0 de $0.03, vingt générations dont huit gardées coûtent $0.60, soit $0.075 par image retenue. Avec quinze gardées sur les mêmes vingt, le prix utile est $0.04.
Ces nombres sont hypothétiques, pas des taux Qwen mesurés. Atténuation, mauvaise anatomie, perte d’identité et mauvaise composition affectent le même budget malgré leurs causes distinctes. L’application doit distinguer les causes, tandis que le budget inclut les essais perdus.
Un refus peut être facturé autrement qu’une image réussie mais inadéquate. Vérifiez conditions et montant réel ; ne supposez pas toutes les erreurs facturées ou tous les refus gratuits sur toutes les API.
Pour une série, incluez les éditions après la première image retenue. Un générateur sans éditeur peut sembler moins cher jusqu’à devoir recréer plusieurs fois le visage. Faites correspondre tâche et étape avant de comparer le total.
Illustration : le budget inclut les candidates et les images utiles conservées.
Une petite évaluation répondant à une vraie question d’achat
Pas besoin d’un immense classement avant le premier endpoint. Il faut une courte évaluation représentative du travail vendu, avec le même personnage adulte, objectif visuel et ressources autorisées. La séquence suivante est proposée, pas exécutée par cet article.
D’abord, générez une scène ordinaire dans votre style et format. Elle montre la maîtrise du brief photographique ou illustré de base. Si nombre de personnes ou pose échouent déjà, corrigez avant d’attribuer un échec plus complexe au filtrage.
Ensuite, essayez la catégorie adulte légale réellement proposée. Comparez aux éléments qui la définissent, pas seulement au témoin ordinaire. Un témoin de mode public ne prouve pas un NSFW plus large. Répétez juste assez pour distinguer accident et motif, avec une limite de dépense préalable.
Enfin, si l’édition est nécessaire, utilisez la source sélectionnée sur l’endpoint edit avec un changement nommé. Examinez visage, pose et scène conservée. Cela vérifie ce qu’une nouvelle génération textuelle n’a jamais testé.
Si deux outils diffèrent, traduisez le même objectif dans leur style attendu. Un modèle illustré à tags et un modèle photographique en prose ne se comparent pas seulement sur la ponctuation. Gardez scène et exigences équivalentes en adaptant la syntaxe.
Décidez explicitement : catégorie compatible, parties nécessaires conservées et coût utile acceptable ? Si une réponse est non, choisissez autre tâche ou modèle. Résolution supérieure, offre payante ou prompt rallongé ne résolvent pas automatiquement cet échec.
Que choisir ensuite ?
Pour des images adultes poursuivies en série, évaluez d’abord un générateur sans censure avec édition disponible. Qwen Image 3.0 est un candidat concret. Pour explorer des premières images indépendantes, le tarif Z-Image Spicy aide si les sorties conviennent. Pour Wan 2.7 Pro, séparez génération et édition.
Utilisez un modèle filtré pour les briefs pris en charge dans un produit mêlant SFW et NSFW, sans promettre toutes les catégories sur tous les modèles. Séparez consentement, droits et limites produit du label technique ; la politique de contenu SpicyAPI s’applique aussi aux routes sans censure.
Un bon classement apporte les preuves de ces choix. Le badge « trois niveaux retirés » ne dit pas si le client recevra personnage, scène ou édition achetés.
FAQ
Un prompt NSFW accepté signifie-t-il l’absence de filtre ?
Non. Il montre le passage d’une étape. Traitement de référence, sortie et comportement du modèle peuvent encore intervenir.
Une tâche terminée peut-elle encore être atténuée ?
Oui. Une tâche réussie peut livrer une scène réduite ou omise. Examinez le visuel ; l’achèvement ne garantit pas la fidélité de contenu.
Le label sans censure d’une famille s’applique-t-il à toutes ses tâches ?
Vérifiez chacune. Wan 2.7 Pro distingue publiquement texte vers image atténué et édition sans censure ; la famille ne suffit pas.
Des prompts peuvent-ils prouver la suppression des filtres d’entraînement ?
Non. Ils montrent le comportement testé, pas un dataset ou une architecture internes non divulgués. L’entraînement demande d’autres preuves.
Faut-il continuer à réessayer un refus de contenu ?
Ne resoumettez pas automatiquement la même requête refusée. Vérifiez explication et périmètre. Corrigez les entrées techniques, clarifiez une ambiguïté légale ou choisissez une tâche compatible dans les règles du service.