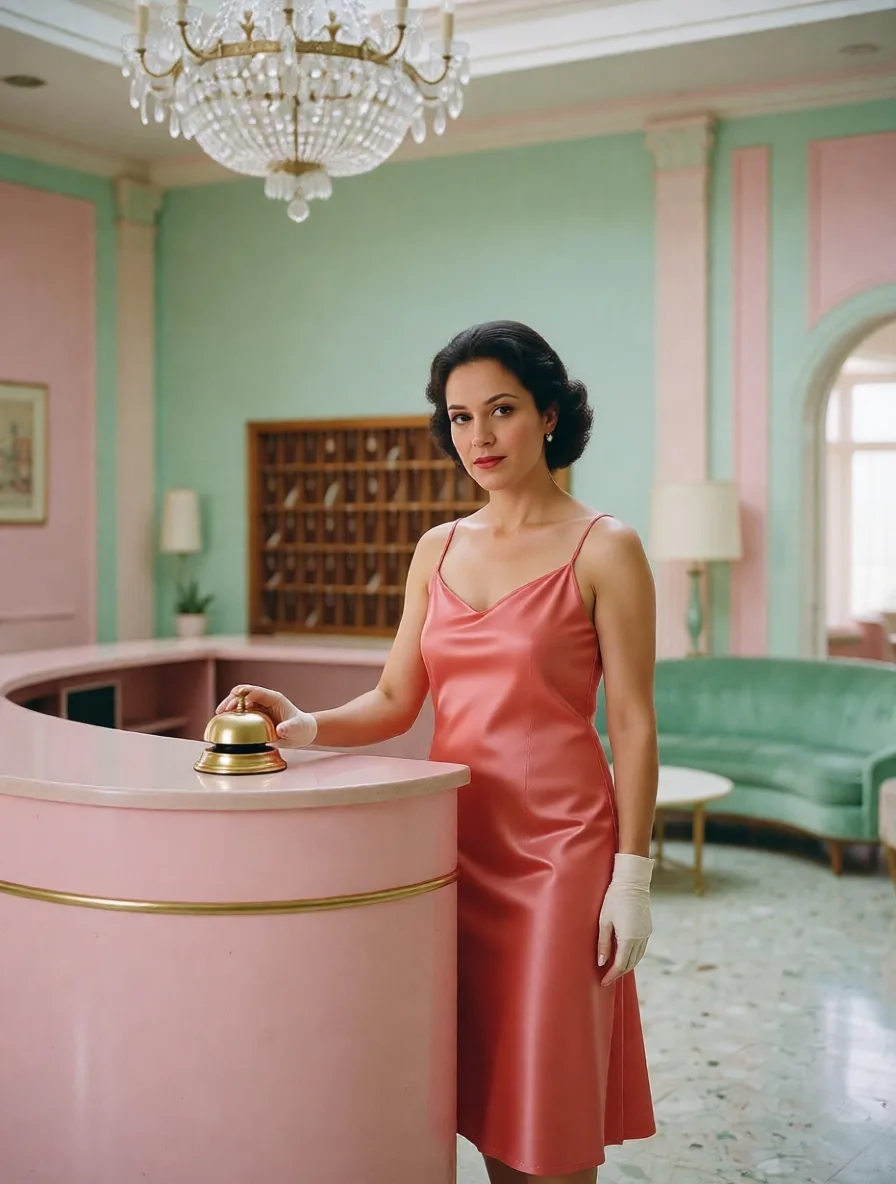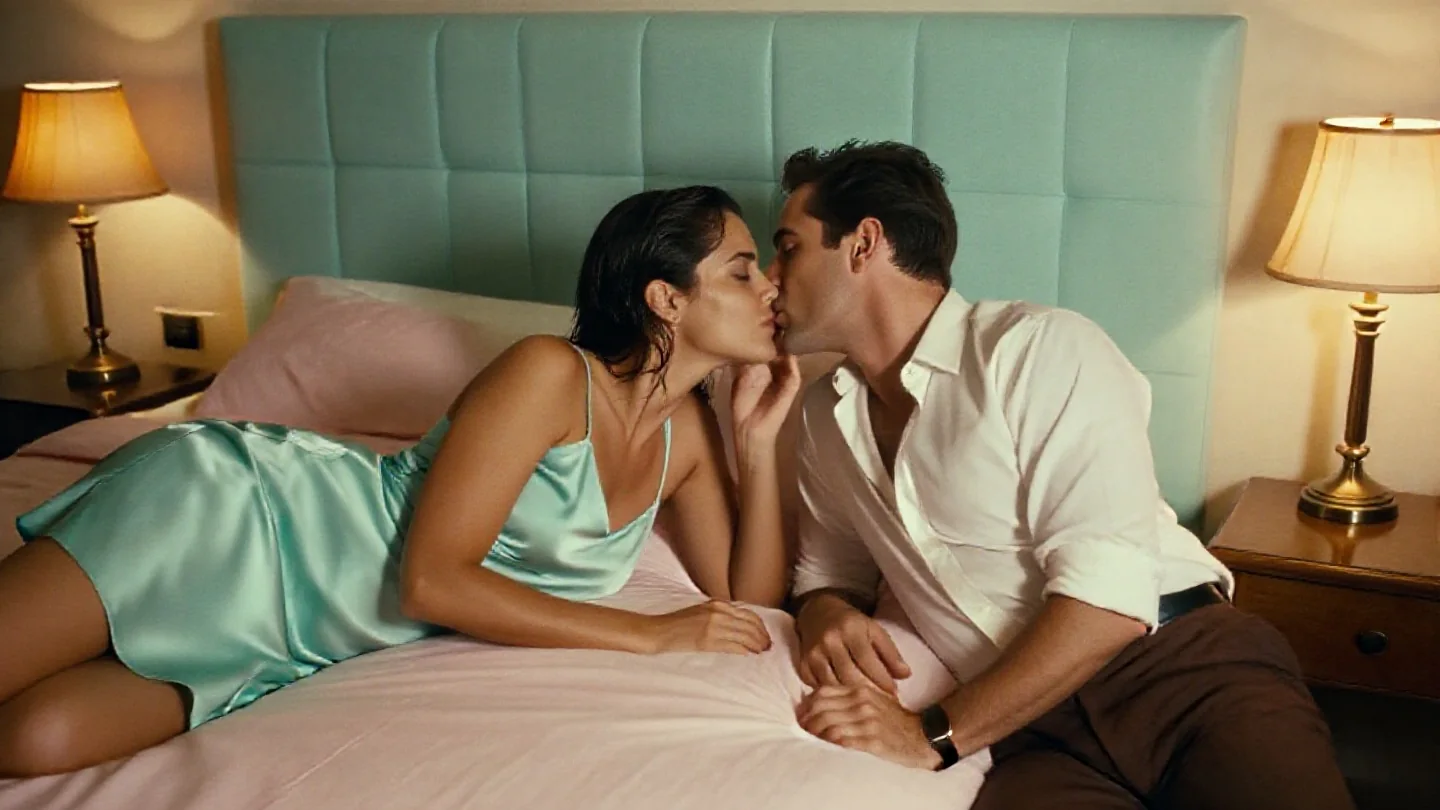
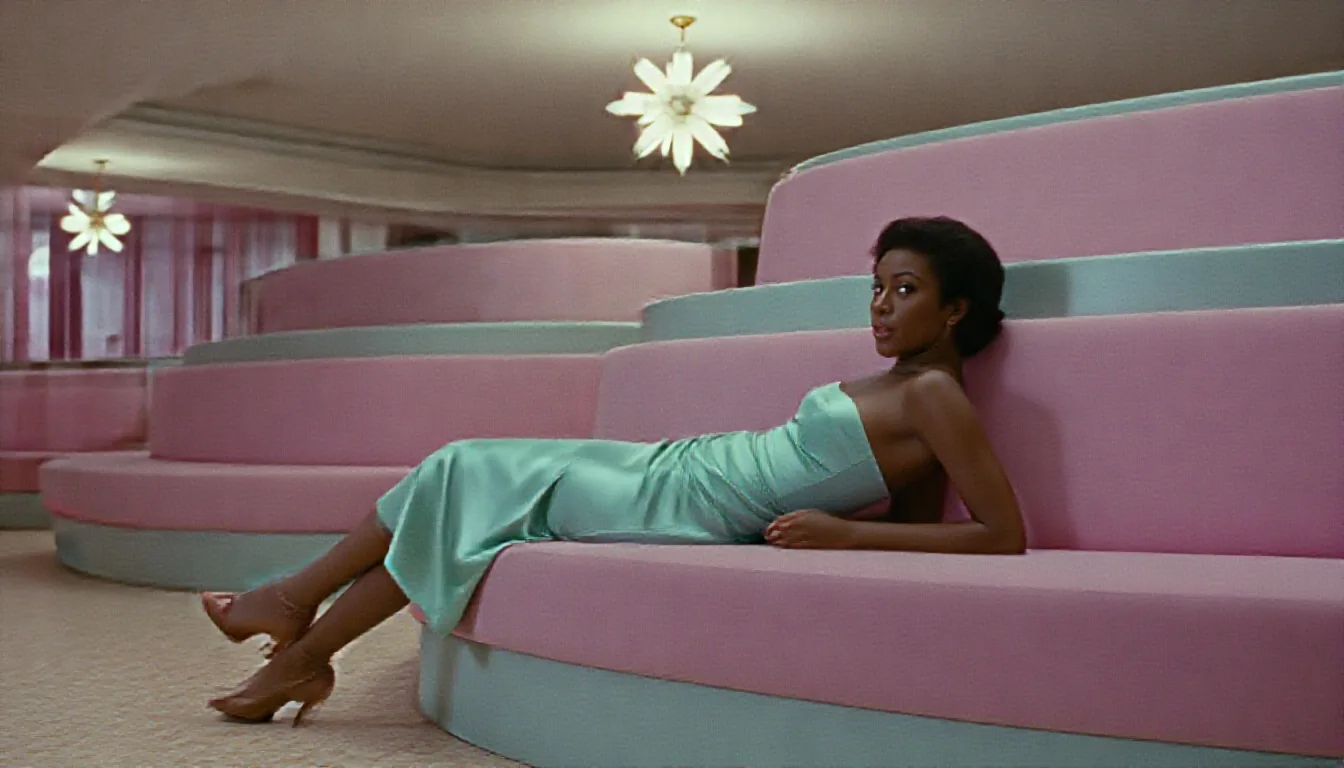
Introduction
P-Image LoRA Texte vers image dessine une image à partir d’un prompt écrit sur P-Image, le modèle de texte vers image de Pruna AI conçu pour la vitesse, en chargeant un fichier LoRA de votre choix. Choisissez l’un des sept ratios d’image ou fixez une taille libre jusqu’à 1440 pixels par côté. La plateforme n’ajoute aucun filtre de contenu au prompt, aux poids ni à l’image.
Choisir un mode selon le point de départ
| Ce que vous avez | Mode |
|---|---|
| une description écrite | P-Image LoRA Texte vers image |
| une ou plusieurs images à modifier | P-Image LoRA Retouche d’image |
Fonctionnalités et points forts
Quelques secondes par image
Pruna a conçu P-Image pour la vitesse. Lors de nos essais, le modèle a mis environ trois à cinq secondes par image sans LoRA, et quelques secondes de plus la première fois qu’un fichier LoRA était récupéré.
Un LoRA, un tout autre rendu
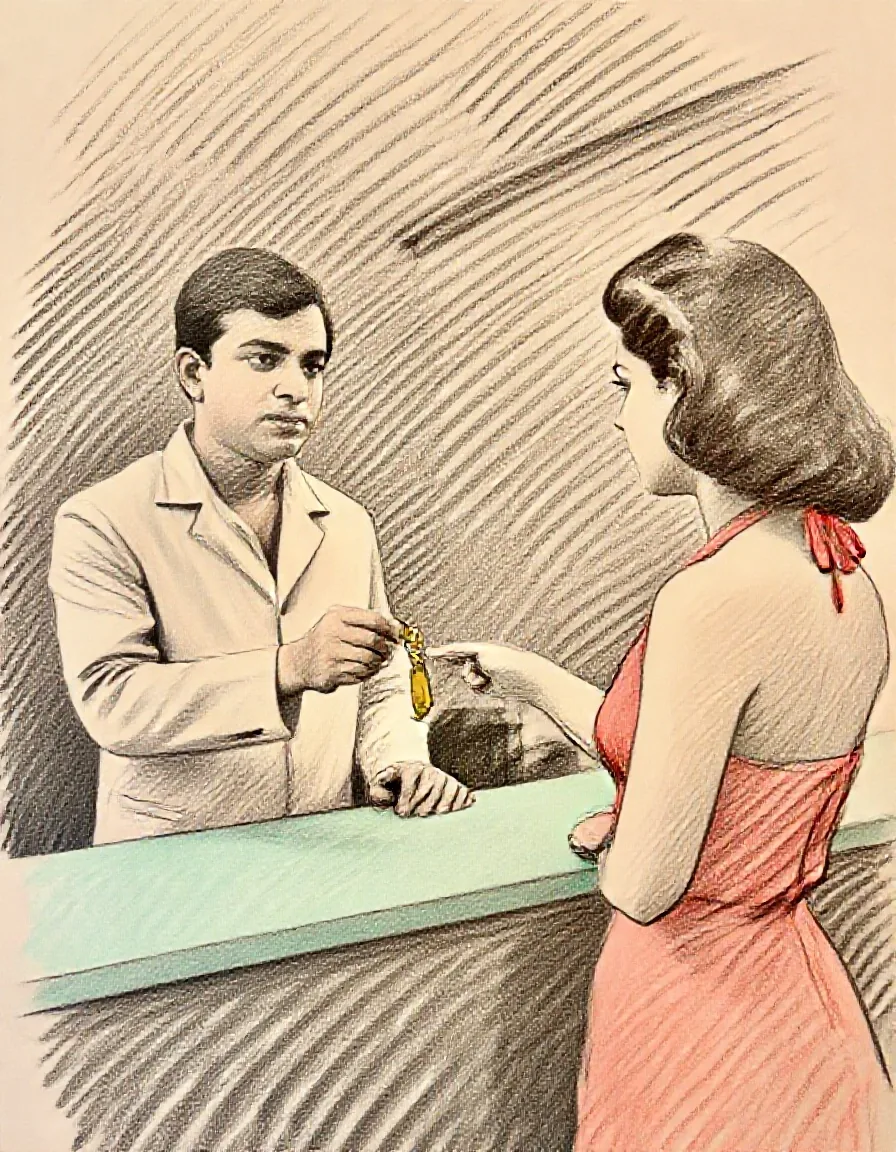
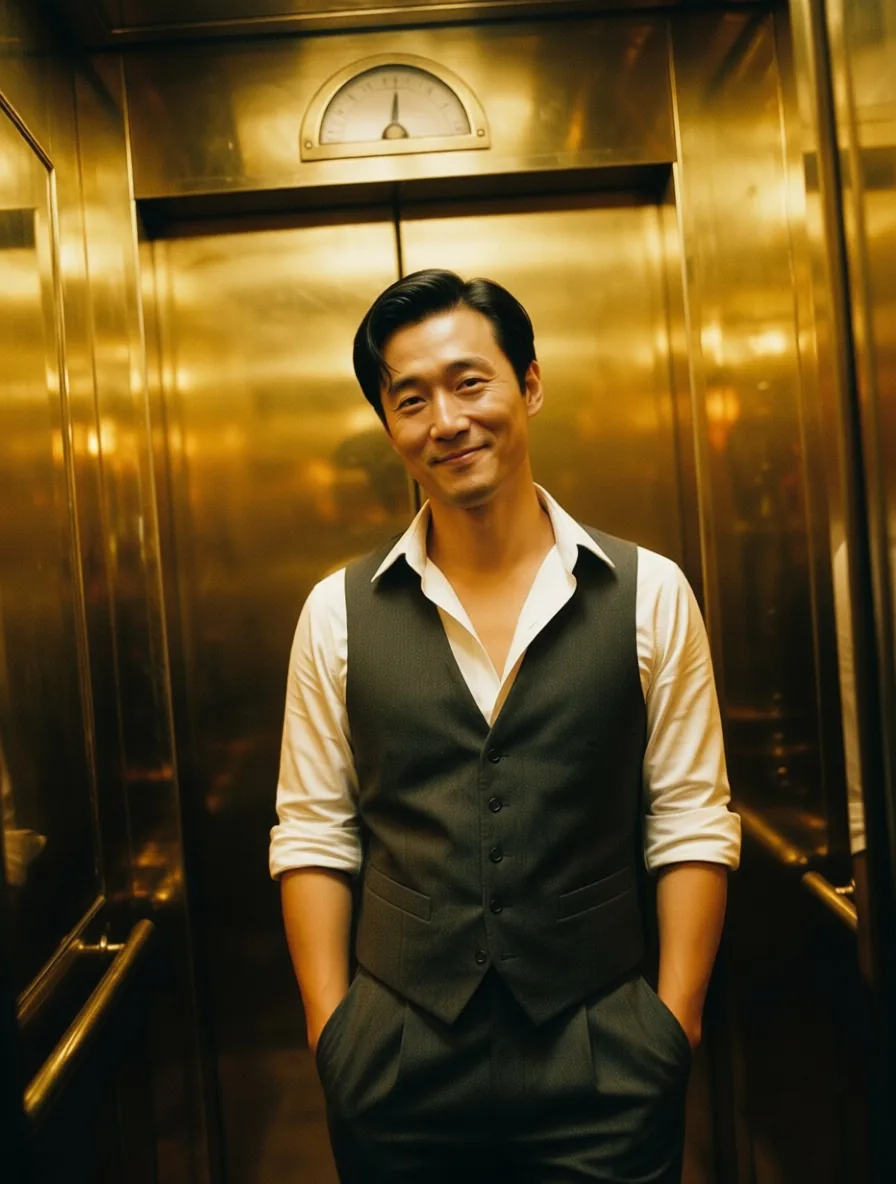
Un LoRA de couleurs de film, un LoRA de photo au flash et un LoRA de crayon de couleur ont chacun changé toute l’image lors de nos essais. Le LoRA se charge depuis un lien public ; rien n’est téléversé chez nous à l’avance et le fichier n’est pas examiné.
Des tailles libres
En plus des sept ratios d’environ un mégapixel, n’importe quelle largeur et hauteur de 256 à 1440 pixels par pas de 16 fonctionnent, des vignettes carrées aux panoramas larges de 1440 x 608.
Aucun filtre de contenu
Rien n'est filtré ni refusé. Le modèle livre chaque niveau jusqu'à Fort pour les femmes et les hommes tel qu'écrit, et le niveau Maximum aussi ; les demandes de niveau Très fort sont sorties avec des erreurs d'anatomie dans nos tests, et c'est à cela que sert une LoRA sans filtre.
Paramètres de requête
| Paramètre | Obligatoire | Description |
|---|---|---|
prompt | Oui | Les phrases complètes marchent le mieux : sujet, vêtements, lieu, lumière et objectif. Placez d’abord le mot déclencheur du LoRA. 1 caractères minimum · 5000 caractères maximum |
aspect_ratio | Non | Sept ratios d’environ un mégapixel : le 1:1 donne 1024 x 1024, le 16:9 donne 1344 x 768, le 3:2 donne 1216 x 832, le 4:3 donne 1152 x 896. |
width | Non | Utilisé seulement avec le ratio d’image custom : de 256 à 1440 pixels par pas de 16, 1024 par défaut. Ne change pas le prix. |
height | Non | Utilisé seulement avec le ratio d’image custom : de 256 à 1440 pixels par pas de 16, 1024 par défaut. Ne change pas le prix. |
loras | Non | Une entrée {path, scale}. Utilisez un lien public direct vers un fichier .safetensors créé avec l’outil d’entraînement P-Image ou entraîné pour Z-Image Turbo. Valeur par défaut: |
output_format | Non | JPEG par défaut, ou PNG ou WebP. Le format ne change pas le prix. |
seed | Non | Garde une série d’images comparable pendant que vous changez un mot ou la force (strength) du LoRA. Il ne garantit pas les mêmes pixels à chaque exécution. |
Tarification
$0.006 / image
Facturé à l’image. Le ratio d’image, une taille libre, le format de sortie et le chargement d’un LoRA ne changent pas le prix.
Cas d’utilisation
Un style maison à la vitesse du brouillon
Chargez un LoRA de style, gardez son mot déclencheur en tête et enchaînez une liste de prompts. Toutes les images partagent le même rendu et chacune prend quelques secondes.
Essayer des LoRA publics
Testez un LoRA de la communauté sur un vrai prompt avant de construire quoi que ce soit autour : une image coûte le même prix avec ou sans le fichier.
Des formats atypiques
Bannières, panoramas et bandes verticales à des tailles en pixels exactes, sans recadrage ensuite.
Guide de prompt et conseils pratiques
Écrivez des phrases
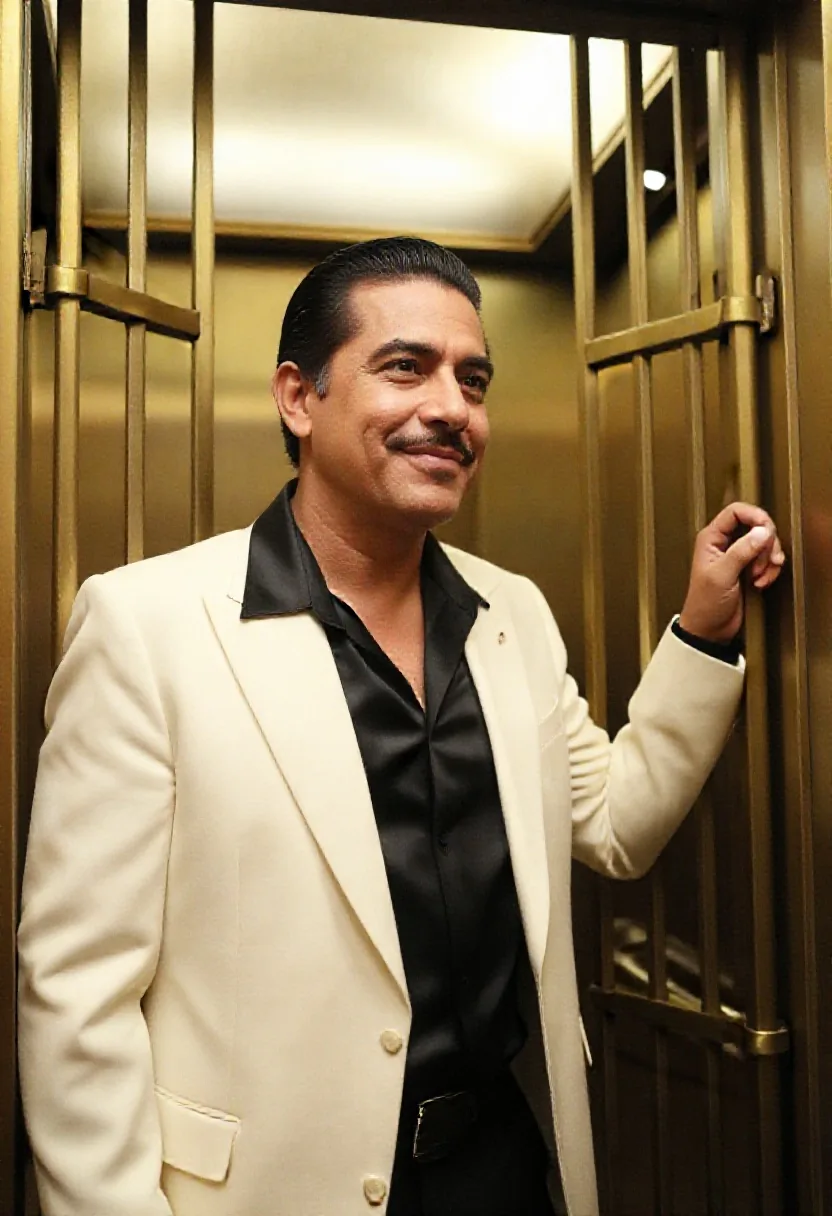
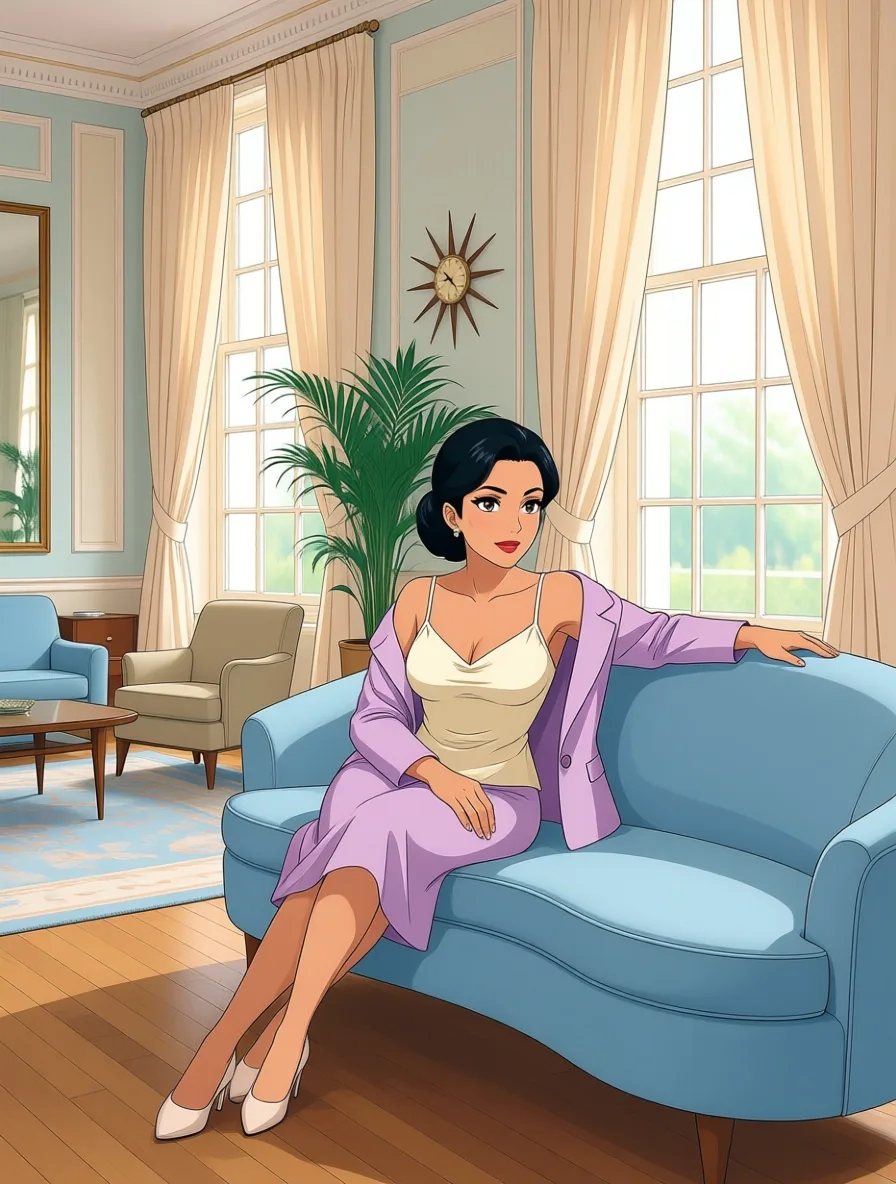
Décrivez le sujet, les vêtements, le lieu, la lumière et l’objectif. Des détails comme une grille d’ascenseur en laiton ou un lustre en étoile sont ressortis tels qu’écrits.
Le mot déclencheur d’abord
Les LoRA de style attendent leur déclencheur au début du prompt. Comparez le même seed avec et sans le fichier pour voir ce qu’apporte le LoRA lui-même.
Gardez une force (strength) modérée
Vers 0,6 à 1, un LoRA de style se voit nettement ; à 2, l’image a commencé à se défaire lors de nos essais, et à 3 elle est devenue du bruit. Les valeurs négatives éloignent du rendu du LoRA mais ont donné des résultats inégaux.
Choisissez des LoRA pour ce modèle
Les LoRA créés avec l’outil d’entraînement P-Image et, lors de nos essais, des LoRA communautaires entraînés pour Z-Image Turbo se sont chargés. Les LoRA pour des modèles FLUX ou SDXL ont fait échouer la requête.
Démarrage rapide de l’API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "pruna-ai/p-image-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
La référence API détaille l’authentification, le schéma complet, le polling et la gestion des erreurs.