Hai un'immagine finita, come un ritratto, una foto di prodotto o una scena per un progetto creativo per adulti, e vuoi animarla. La scelta decisiva è il suo ruolo nel clip: il primo frame esatto, un riferimento visivo per una nuova inquadratura o un estremo di una transizione. Ogni ruolo richiede un task diverso; quello sbagliato spreca un buon fermo immagine e un rendering a pagamento.
In breve: usa un modello con primo frame quando l'immagine deve aprire il clip. Usa il flusso da riferimento a video quando fornisce soltanto una persona, un abito o un luogo per una nuova inquadratura. Aggiungi un frame finale solo se il finale è definito. Le opzioni senza censura accettano materiale adulto, ma un task riuscito può comunque produrre un risultato più moderato della richiesta. Valuta l'MP4 completo, non lo stato del task o l'anteprima.
| Hai | Usa | Controlla nel video finito |
|---|---|---|
| Un'immagine approvata che deve aprire il clip | Da immagine a video con primo frame | Primo frame, volto, abito e azione prevista restano riconoscibili |
| Un'immagine del personaggio e una separata di stanza o stile | Da riferimento a video | La nuova inquadratura riprende i tratti corretti senza copiare un riferimento come primo frame |
| Due composizioni per l'inizio e la fine di un movimento | Video con primo frame e immagine finale | Il movimento intermedio le collega senza salti |
Per raccolte di prompt per scena, leggi la guida ai prompt video senza censura. Per durata, risoluzione e prezzi tra famiglie, consulta come scegliere un'API da immagine a video. I risultati sui limiti di contenuto di otto modelli sono nei migliori modelli video AI senza censura. Gli esempi seguenti vengono dai nostri test di settembre 2026: un'immagine originale, due clip con primo frame e uno con due riferimenti.
Decidi prima che cosa rappresenta l'immagine
L'immagine iniziale definisce la prima composizione visibile: se il clip comincia altrove, il task ha fallito. Un riferimento può fornire volto, abito, stanza o estetica senza diventare la prima inquadratura. L'immagine finale è un obiettivo per l'ultimo frame, non un secondo riferimento del personaggio.
Adatta l'azione al taglio. Un ritratto ravvicinato consente un'espressione, una rotazione della testa o un movimento di camera. Una camminata a figura intera richiede pavimento visibile e direzione di avanzamento. Se l'immagine è sbagliata, rigenerala o modificala prima; un prompt più lungo non risolve una premessa inadatta.
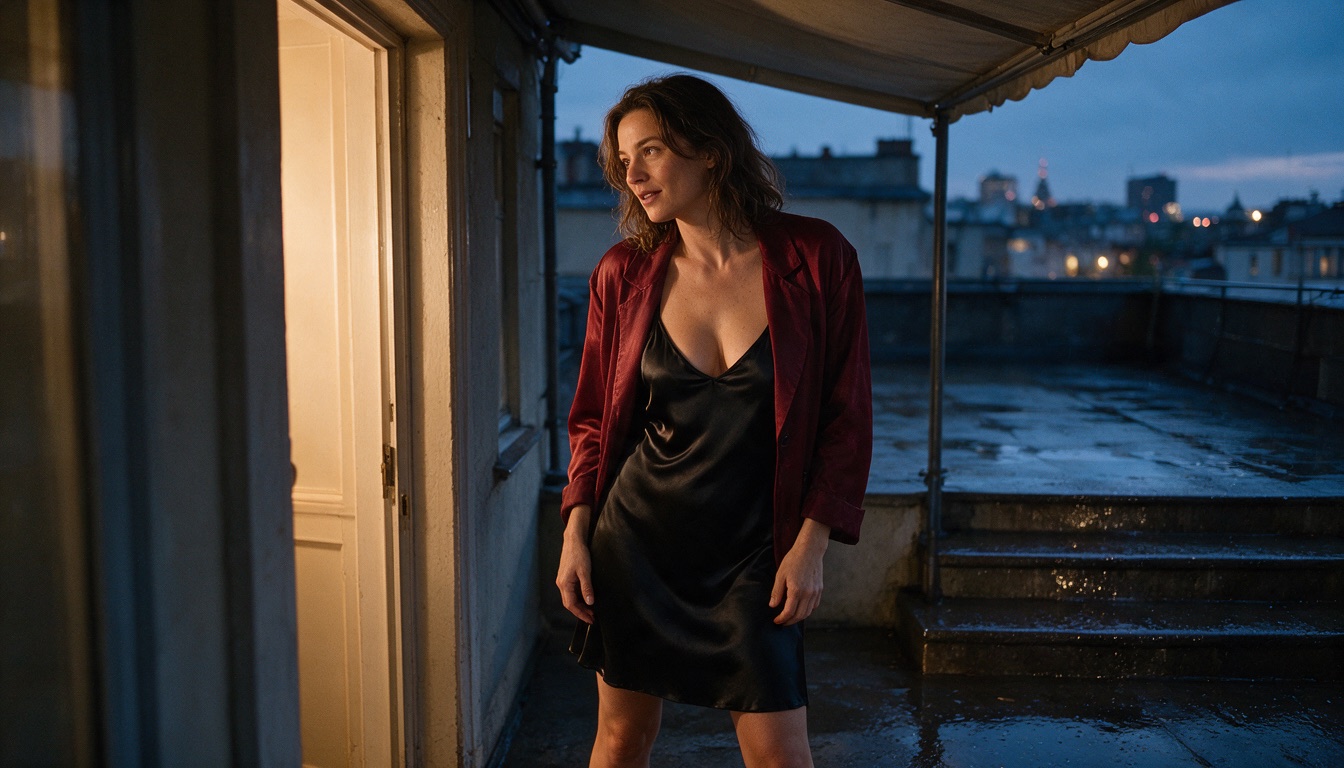
Un'immagine originale generata con SpicyAPI, usata invariata come apertura di entrambi i clip seguenti. Il taglio consente una rotazione e una posa mantenuta, non due passi completi.
Prepara l'immagine prima di pagare il rendering
La maggior parte dei clip falliti dipende dalla sorgente:
- Un soggetto adulto, luce semplice e silhouette leggibile. Sfondi affollati e forti occlusioni (mani sul volto, arti incrociati) spingono il modello a inventare dettagli nascosti durante una rotazione, causando deformazioni e cambiamenti del volto.
- Spazio per il movimento. Lascia pavimento visibile per camminare, spazio sopra la testa per sollevarsi e sul lato verso cui il soggetto si gira.
- Ritaglia al rapporto d'aspetto di consegna mantenendo volti e mani interamente nell'inquadratura.
- Rimuovi gli indizi di movimento contrari al prompt. Mosso, polvere in volo, un piede sollevato o capelli al vento suggeriscono movimento; rimuovi l'indizio o adatta il prompt, come consiglia la guida di Runway.
- Un movimento per clip. Più movimenti di camera in un clip breve causano stacchi. Genera inquadrature brevi separate e montale insieme.
Per concatenare le inquadrature, salva l'ultimo frame di un clip approvato e usalo come apertura del successivo:
ffmpeg -sseof -0.1 -i approved-clip.mp4 -frames:v 1 -q:v 2 next-opening.pngScegli l'opzione in base all'inquadratura
| Compito creativo | Opzione | Perché è adatta |
|---|---|---|
| Movimento breve da un'immagine esatta, con azione decisa dopo averla vista | MiniMax H3 Spicy da immagine a video | Primo frame obbligatorio, prompt e frame finale facoltativi |
| Stessa immagine, ma ripresa più lunga o suono sincronizzato | Seedance 2.5 Spicy da immagine a video | Primo frame con 4–30 secondi, audio nativo e frame finale facoltativo |
| Persona e luogo da immagini separate, composti in una nuova apertura | Wan 3.0 da riferimento a video o Seedance 2.5 da riferimento a video | Ogni riferimento riceve un ruolo nominato; nessuno deve essere il primo frame |
Usa solo immagini di adulti create da te o che hai diritto e consenso di elaborare. L'opzione di riferimenti Wan 3.0 rifiuta spesso foto di persone reali (il controllo del volto fa fallire il task, e i task rifiutati non vengono addebitati); usa personaggi illustrati, 3D o generati. H3 Spicy, Seedance 2.5 Spicy e Wan 3.0 da immagine a video accettano frame finali. Nomi dei campi e limiti variano per task: apri la sua pagina per i requisiti attuali e il preventivo.
Servizio ospitato o locale
Un'API ospitata addebita al secondo, non richiede GPU e definisce le condizioni di input per ogni task, quindi è adatta a test, app e lotti. Un flusso locale offre pieno controllo e nulla lascia la tua macchina, ma richiede hardware, configurazione e attenzione ai pesi esatti eseguiti. Scegli locale se ti serve quel controllo e puoi mantenerlo; ospitato se vuoi un risultato oggi e pagare solo i clip generati.
Quanto costa un test di cinque secondi
Le tariffe del catalogo attuale sono moltiplicate per cinque secondi di output, prima del preventivo specifico. Le impostazioni variano: il confronto riguarda il costo, non la qualità.
| Opzione | Ruolo dell'immagine | Durata dell'output | Esempio di cinque secondi |
|---|---|---|---|
| MiniMax H3 Spicy da immagine a video | Apertura obbligatoria; finale facoltativo | Da 3 a 15 s | 768p a $0.084/s → $0.42 |
| Seedance 2.5 Spicy da immagine a video | Apertura obbligatoria; finale e audio nativo facoltativi | Da 4 a 30 s | 720p a $0.432/s → $2.16 |
| Wan 3.0 da riferimento a video | Da una a dieci immagini guidano una nuova inquadratura | Da 2 a 30 s o durata intelligente | 720p a $0.09/s → $0.45 (solo riferimenti immagine) |
H3 è la diagnosi più economica per un movimento breve da un'immagine approvata. Seedance costa di più al secondo e offre riprese più lunghe e audio nativo. Wan risponde a un'altra esigenza: la sorgente non deve apparire come primo frame. I secondi dei video di riferimento si aggiungono a quelli fatturati, quindi $0.45 non è un prezzo universale di Wan.
Che cosa ha prodotto lo stesso primo frame
Entrambe le opzioni hanno ricevuto l'immagine invariata e la stessa indicazione di movimento di cinque secondi. Il primo rendering H3 ha cambiato l'abito, quindi il clip H3 pubblicato usa un prompt più preciso che imponeva di mantenere abito opaco e giacca (vedi la sezione dei prompt). I prompt differiscono: i clip mostrano comportamenti, non una classifica. H3 era a 768p, Seedance a 720p.
MiniMax H3 Spicy, cinque secondi a 768p, dopo il nuovo tentativo sul guardaroba. Lei si gira verso la camera e avanza fino a un'inquadratura dal petto in su; abito opaco e giacca restano indossati.
Seedance 2.5 Spicy, cinque secondi a 720p, indicazione di movimento originale. Lei si gira e avanza verso la camera fino a un'inquadratura dal petto in su; la giacca scivola da entrambe le spalle, mentre l'abito resta opaco.
La quantità di movimento è simile; cambia il guardaroba. Dai a H3 un'istruzione di continuità breve ed esplicita ("opaque dress and jacket stay unchanged"). Seedance ha seguito l'indicazione originale lasciando scivolare la giacca. Controlla tutto il clip: apertura sulla tua immagine, coerenza di volto, giacca e sfondo all'inizio del movimento, rotazione richiesta visibile e ultimo secondo utile per un taglio o un punto di loop.
Quando l'immagine deve essere un riferimento
Se ti piace lo stile dell'interprete ma vuoi aprire in un'altra stanza, un primo frame rigido obbliga il modello a partire dalla terrazza e poi muoversi. Il flusso di riferimenti definisce direttamente il compito: un'immagine identifica l'interprete, un'altra la stanza, e il prompt chiede una nuova apertura lì.
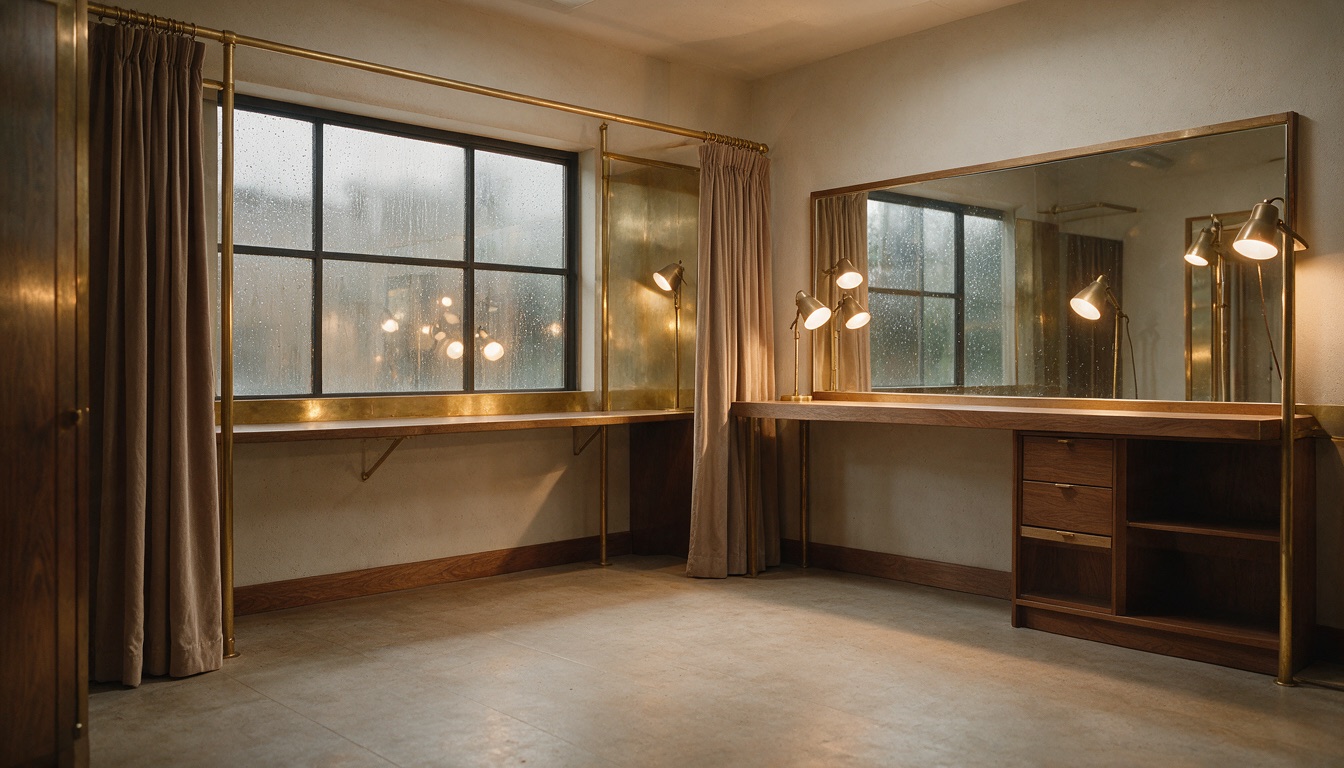
Riferimento B: stanza e illuminazione. A è il ritratto in terrazza sopra, che fornisce interprete e guardaroba.
Wan 3.0 da riferimento a video, cinque secondi a 720p. Il clip apre in una stanza appena composta con uno specchio; un'interprete vestita in modo simile si gira verso la camera. Identità e dettagli della stanza sono vicini, ma non esatti.
I riferimenti conservano atmosfera e identità generale ma possono perdere disposizione scenica e dettagli precisi. Se cambia la persona, rafforza il riferimento del personaggio o semplifica il movimento. Se la stanza è sbagliata, migliora la sua immagine o la richiesta di composizione. Cambia una cosa per esecuzione.
Scrivi un prompt di movimento, non una descrizione
L'immagine mostra già soggetto, abito e luce; il prompt deve dire che cosa cambia nel tempo: un'azione del soggetto, un'istruzione di camera e solo il movimento ambientale rilevante, nell'ordine visto dallo spettatore. Entrambe le opzioni con primo frame hanno ricevuto questo prompt:
The adult performer turns toward the camera as a light breeze lifts the edge of her jacket. She takes two measured steps across the terrace and settles into a held look. One slow camera push; keep her face, outfit and terrace recognisable. Rain moves softly in the background. One continuous shot.
Il taglio mostra poco pavimento, quindi una camminata diventa uno o due passi verso la camera; immagini più ampie gestiscono meglio camminate lunghe. Se il primo tentativo modifica il guardaroba, riprova con una riga di continuità, per esempio: "Keep the opaque dress and jacket exactly as in the image; one slight turn toward the camera, then a held look."
Per un task di riferimenti, assegna a ogni immagine un ruolo nominato e chiedi una nuova apertura:
Use reference A for the adult performer's face and tailored wardrobe. Use reference B for the dressing room, warm lamps and mirror. Compose a new opening medium shot inside that room. She turns from the mirror toward the camera, takes one step and pauses. Slow lateral camera move, one continuous shot.
Associa A e B all'ordine reale di caricamento e verifica la sintassi delle etichette del task: i modelli differiscono.
| Richiesta debole | Indicazione di ripresa verificabile |
|---|---|
| "Make this image cinematic and sexy." | "She turns toward camera; the jacket hem moves in a light breeze; hold a medium shot." |
| "Animate everything in the image." | "Keep the face and wardrobe stable while she takes one step; the camera slowly pushes in." |
| "Use these references and create a masterpiece." | "A defines the performer; B defines the room. Start on a newly composed medium shot inside B." |
Un frame finale è lo strumento di stabilità più diretto nelle opzioni che lo supportano: anche una copia leggermente riposizionata dell'apertura dà al movimento intermedio un obiettivo più preciso del solo testo, come osserva la guida al movimento di Vidu.
Correggi in base al sintomo. Se lo stesso difetto compare nello stesso punto in due esecuzioni, cambia gli input anziché rigenerare senza modifiche:
| Sintomo | Causa probabile | Soluzione |
|---|---|---|
| Volto che cambia durante una rotazione | Movimento ampio, volto parzialmente nascosto | Accorcia la rotazione, usa un'immagine frontale o aggiungi un frame finale |
| Sfarfallio nei dettagli o nello sfondo | Scena complessa o cambiamento di luce | Semplifica lo sfondo, tieni ferma la camera |
| Stacco brusco a metà clip | Troppi eventi per la durata | Un'azione per clip o durata maggiore |
| Stesso difetto nello stesso punto in tentativi ripetuti | Problema dell'immagine sorgente | Modifica o rigenera l'immagine |
Il tutorial dedicato a Seedance approfondisce costruzione del primo frame e comportamento dei prompt specifico dell'opzione.
Prova nel Playground, poi chiama l'API
Nel Playground. Apri la pagina MiniMax H3 Spicy da immagine a video (o Seedance 2.5 Spicy o Wan 3.0 della tabella) e accedi o registrati. Poi:
- Aggiungi l'immagine in Input image, caricandola (JPG, PNG, WEBP o GIF, fino a 10 MB) o incollando un'Asset URL.
- Incolla il prompt di movimento in Prompt. È facoltativo su questa opzione.
- Aggiungi Closing frame solo se il finale è definito.
- Imposta Duration (da 3 a 15 s) e Resolution. Il valore predefinito è 480p, la fascia più economica: prepara lì le bozze.
- Premi Run model. Il prezzo appare prima di qualsiasi addebito.
Nella pagina di Wan 3.0 da riferimento a video, il primo campo è invece Reference images: nomina ogni immagine nel prompt come nell'esempio sopra.
Poi l'API, quando un movimento funziona e vuoi usarlo nella tua app. Installa il Python SDK (pip install spicyapi), imposta SPICY_API_KEY nell'ambiente del server ed esegui questa richiesta H3 Spicy (una bozza di cinque secondi a 480p ha un preventivo di $0.19):
import uuid
from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

task = client.create_task(
    model="minimax/h3-spicy/image-to-video",
    input_data={
        "image_url": "https://cdn.spicyapi.ai/blog/uncensored-ai-image-to-video-guide/m1-shared-source-2026-09-27.jpg",
        "prompt": "The adult performer turns toward the camera as a light breeze lifts the edge of her jacket. "
                  "One slow camera push; keep her face, outfit and terrace recognisable. One continuous shot.",
        "resolution": "480p",
        "duration_seconds": 5,
    },
    idempotency_key=str(uuid.uuid4()),
)

final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"{task['taskId']} ended as {final['state']}: {final.get('errorCode')}")
print(output_assets(final)[0]["url"])  # copy the clip to your own storage now
Le altre opzioni usano nomi di campo diversi: leggi la pagina del task prima di cambiare modello. Campi, risultati ed errori sono nella documentazione API. Conserva la chiave sul server.
Oppure lascia eseguire a un agente. Un agente può fare la stessa chiamata tramite CLI, server MCP o Agent Skill. Tutti e tre leggono lo schema attuale; CLI e MCP mostrano il prezzo e chiedono conferma prima di creare un task. Con SPICY_API_KEY impostata:
# CLI
npx @spicyapi/cli tasks create --model minimax/h3-spicy/image-to-video \
  --input-json '{"image_url": "https://cdn.spicyapi.ai/blog/uncensored-ai-image-to-video-guide/m1-shared-source-2026-09-27.jpg", "prompt": "She turns toward the camera; one slow camera push.", "resolution": "480p", "duration_seconds": 5}' --wait

# MCP server: the command your assistant's MCP config runs
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Quale opzione usare
| Sceglila quando | Cerca altrove quando |
|---|---|
| MiniMax H3 Spicy: l'immagine deve essere il primo frame e vuoi la diagnosi breve più economica | Ti serve una ripresa oltre 15 secondi o una traccia audio controllabile |
| Seedance 2.5 Spicy: l'immagine deve essere il primo frame e vuoi una ripresa più lunga (fino a 30 s) o audio nativo | Stai solo provando un movimento; costa circa cinque volte di più al secondo |
| Wan 3.0 o Seedance 2.5 da riferimento a video: le immagini forniscono persona e stanza per una nuova apertura | L'immagine deve aprire letteralmente il clip o la persona è una foto reale (il controllo del volto Wan spesso la rifiuta) |
| H3 Spicy, Seedance 2.5 Spicy o Wan 3.0 da immagine a video con frame finale: il finale è definito | Le composizioni non possono collegarsi plausibilmente nella durata del clip |
Nei nostri clip H3 ha richiesto un prompt più stretto sul guardaroba per conservare la giacca; Seedance ha prodotto un movimento simile ma l'ha lasciata scivolare, e Wan ha creato una nuova stanza senza riprodurre esattamente le fonti. Decidi prima in base al ruolo dell'immagine, poi a movimento e continuità sullo schermo. Se una ripresa lunga presenta deriva, accorciala o dividi la scena.
Domande frequenti
Da immagine a video è sempre il task giusto se carico un'immagine?
Solo se l'immagine deve essere l'apertura letterale. Se fornisce persona, abito o stanza per un'altra apertura, usa riferimenti e spiega il contributo di ciascuna immagine.
Posso animare una foto senza scrivere un prompt?
In alcune opzioni, compresa MiniMax H3 Spicy, il prompt è facoltativo e il modello deduce il movimento. Aggiungi un prompt breve se contano un'azione, un movimento di camera o un finale precisi.
La persona rimarrà identica in tutto il clip?
Il primo frame è un ancoraggio forte, non una garanzia d'identità frame per frame. Guarda tutto il clip per cambiamenti di volto, capelli e abito. Mantieni il movimento nel taglio originale, usa un'immagine migliore oppure accorcia e dividi la ripresa.
Due immagini possono definire inizio e fine?
Solo se la pagina del task accetta sia il frame iniziale sia quello finale. Il modello collega le due composizioni: è diverso da due riferimenti liberi che guidano una nuova inquadratura.
Posso confrontare direttamente clip da riferimento e da immagine a video?
Solo in modo approssimativo. Confronta le opzioni con primo frame usando la stessa apertura e indicazione di movimento; giudica i riferimenti per il loro compito: persona e stanza corrette in una nuova ripresa. Un clip con un ruolo diverso dell'immagine iniziale non è inferiore per qualità.
“Senza censura” significa che ogni scena adulta richiesta verrà generata?
No. Il comportamento varia con task e versione; un lavoro finito può essere più moderato della richiesta. Usa materiale adulto legale e consensuale e verifica i frame effettivi.
Qual è il modo più economico per provare da immagine a video senza censura?
Qui è MiniMax H3 Spicy: $0.038 al secondo a 480p, circa $0.19 per cinque secondi o $0.42 a 768p. Prova clip brevi alla risoluzione minima che mostra il movimento e aumentala quando la direzione funziona.
Posso aggiungere suono?
Dipende dall'opzione. Seedance 2.5 Spicy ha un interruttore per l'audio nativo; Wan 3.0 da riferimento a video accetta riferimenti audio. MiniMax H3 Spicy da immagine a video non offre impostazioni audio e può produrre una traccia generata non controllabile: prevedi di sostituire o aggiungere audio in montaggio.