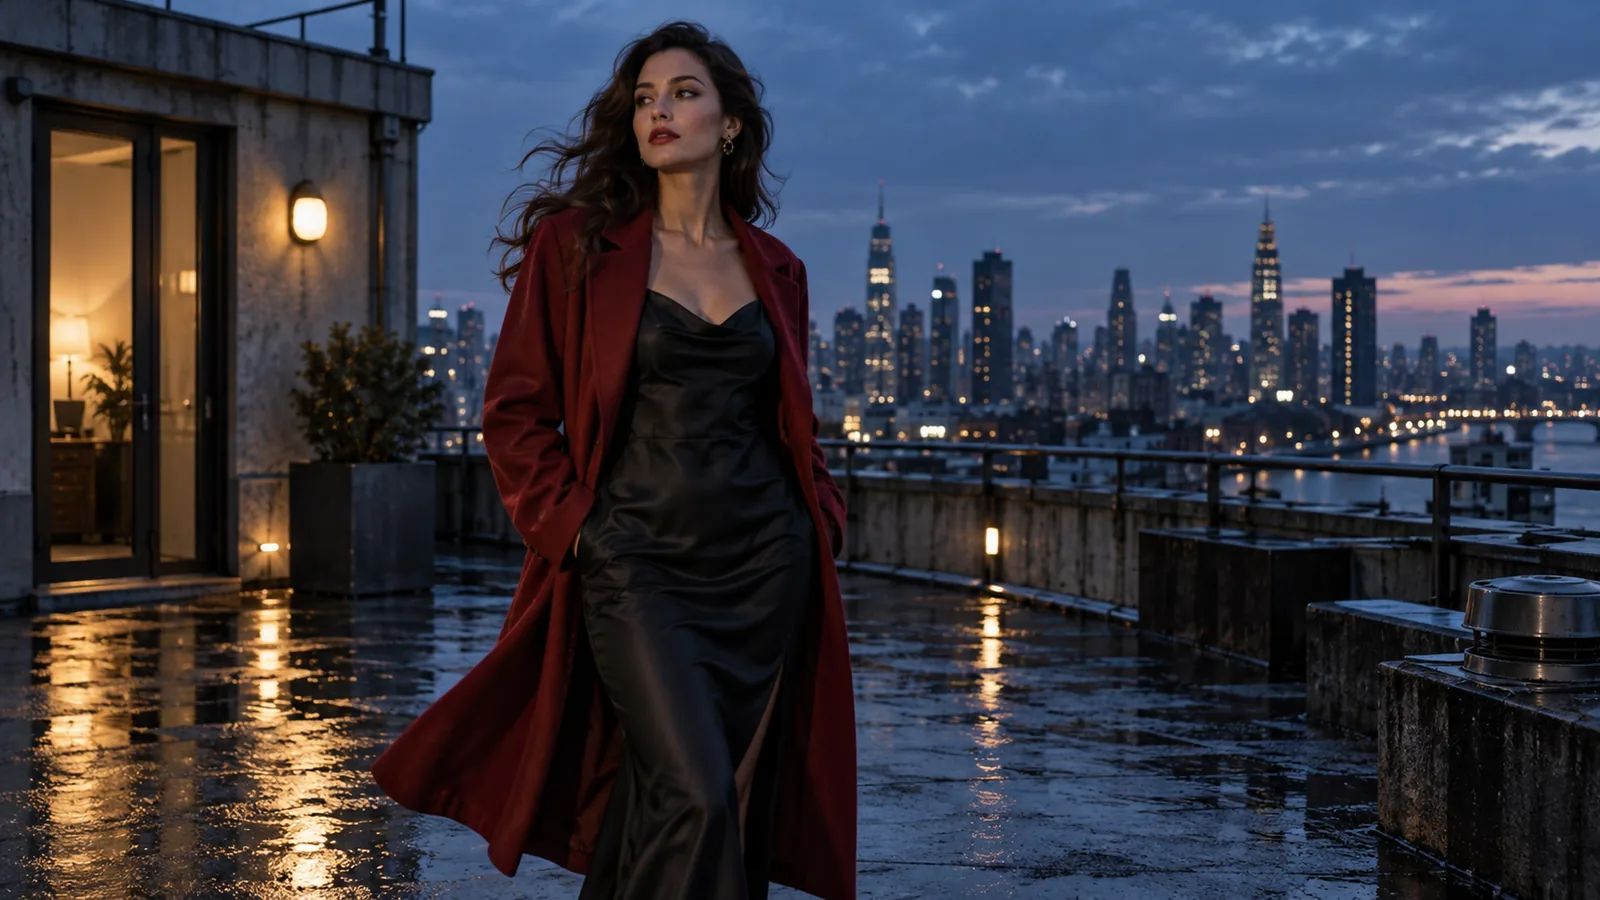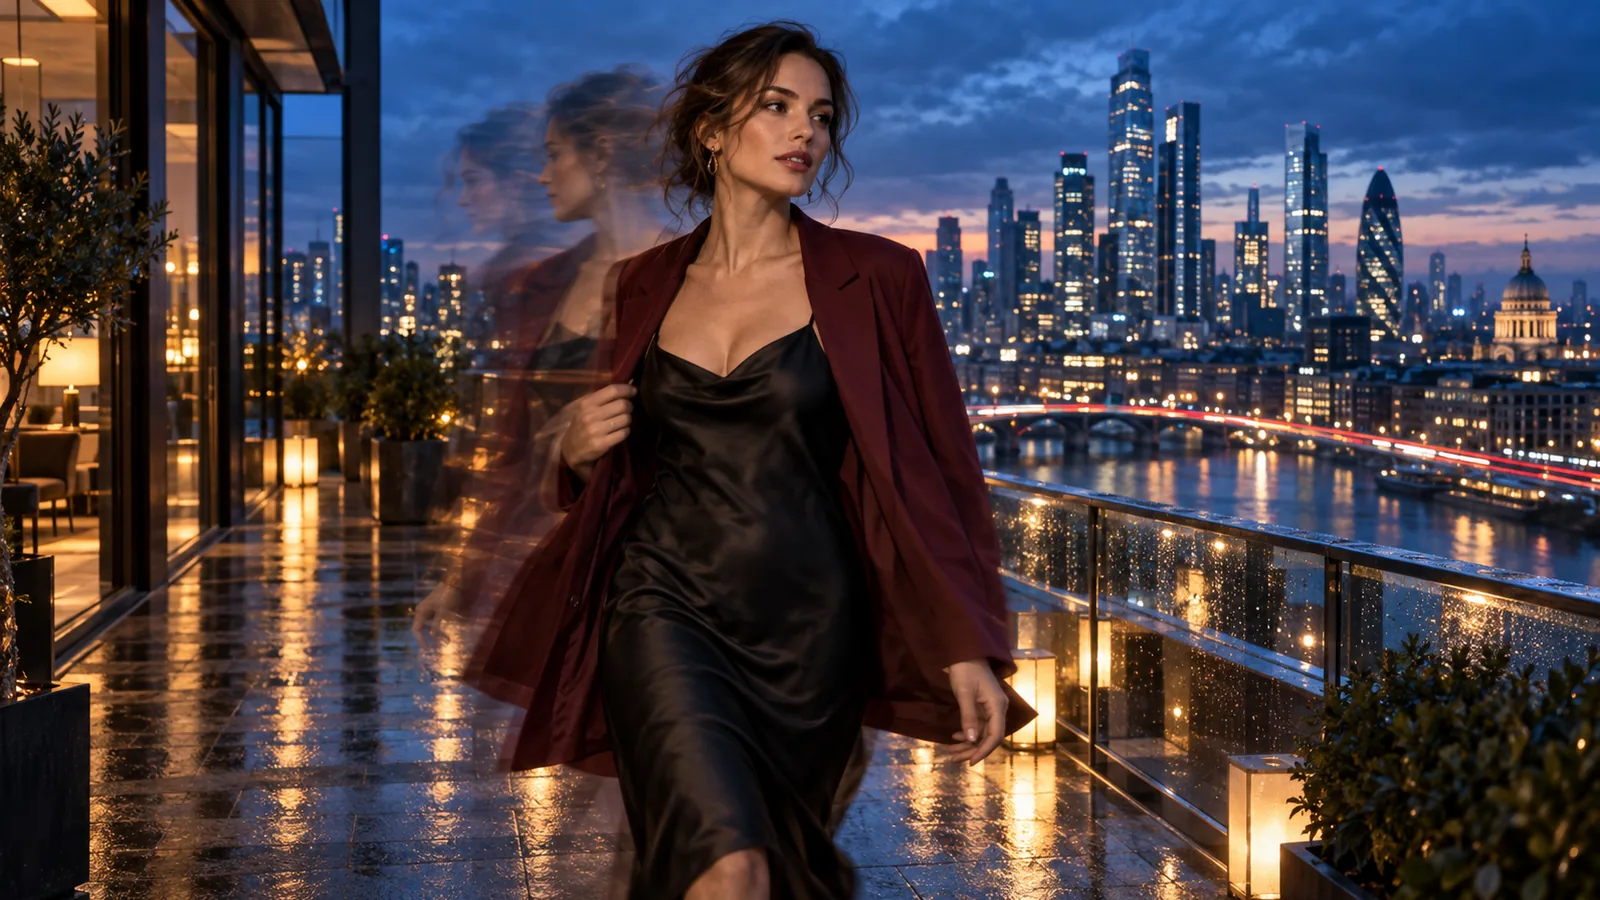
ポートレート、商品写真、成人向け創作の場面など、完成した静止画を動かしたいとします。最も重要なのは、その画像が動画で果たす役割です。正確な開始フレーム、新しく構成するショットの視覚的な参照、あるいは場面転換の片方の端点なのかを決めます。それぞれに異なるモデルのタスクが必要で、選択を誤ると良い静止画と有料の生成を無駄にします。
結論から: 画像を最初のフレームにする必要があるなら、開始フレームを指定するモデルを使います。新しいショットの人物、衣装、場所だけを提供するなら、参照から動画を使います。終了場面が決まっている場合だけ、終了フレーム画像を追加します。規制なしの生成経路は成人向け素材を受け付けますが、タスクが成功しても指示より控えめな結果になることがあります。タスクの状態やサムネイルではなく、完成したMP4を評価してください。
| 用意したもの | 使うタスク | 完成動画で確認する点 |
|---|---|---|
| 動画の冒頭にそのまま使いたい、確認済みの画像 | 開始フレーム指定の画像から動画 | 最初のフレーム、顔、衣装、意図した動作が保たれるか |
| 人物画像と、別の部屋またはスタイルの画像 | 参照から動画 | 新しいショットが適切な特徴を取り入れ、参照画像を開始フレームとしてコピーしていないか |
| 動きの始まりと終わりにしたい二つの構図 | 終了画像付きの開始フレーム動画 | 途中の動きが飛躍せずに両者をつなぐか |
場面別のプロンプト集は規制なしの動画プロンプトガイドをご覧ください。動画モデル群の長さ、解像度、料金は画像から動画APIの選び方、八つのモデルのコンテンツ境界の結果は規制なしのAI動画モデル比較で紹介しています。以下は2026年9月のテスト例です。元の静止画一枚、開始フレーム指定の動画二本、二枚の参照を使った動画一本を示します。
最初に画像の役割を決める
開始画像は最初に見える構図を定義します。別の場面から始まったら、そのタスクは目的を満たしていません。参照画像は顔、服、部屋、雰囲気を提供できますが、冒頭になる必要はありません。終了画像は最後のフレームの目標であり、二つ目の人物参照ではありません。
動作を画角に合わせます。寄りのポートレートには表情、頭の向き、カメラの動きが適しています。全身の歩行には床と進む方向が見える必要があります。静止画自体が不適切なら、先に作り直すか編集してください。長い動作プロンプトでは、悪い出発点を修正できません。
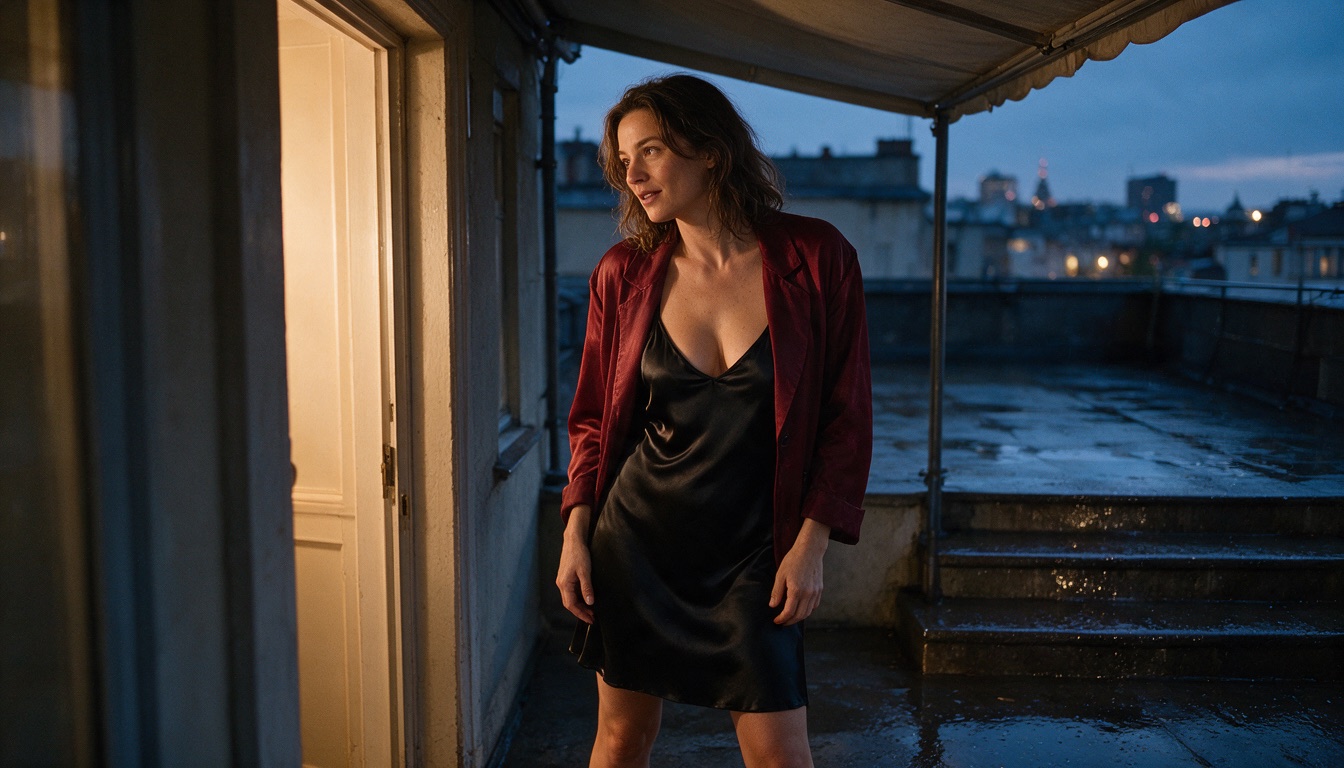
SpicyAPIで生成した元の静止画です。以下の開始フレーム動画二本に、変更せず開始画像として使いました。この画角は体の向きを変えてポーズを保つ動作には適していますが、完全な二歩には適していません。
有料生成の前に静止画を整える
失敗した動画の多くは元画像に原因があります。
- 成人の被写体一人、シンプルな照明、わかりやすい輪郭。 複雑な背景や大きな遮り(顔を覆う手、交差した手足)があると、回転中にモデルが隠れた部分を想像します。それが変形や顔の変化につながります。
- 動くための余白。 歩くなら床、上に動くなら頭上、向きを変えるならその側に空間を残します。
- 納品時のアスペクト比に切り抜き、顔と手を完全に画面内に収めます。
- プロンプトと矛盾する動きの手掛かりを取り除く。 モーションブラー、舞うほこり、浮いた足、風になびく髪は動きを示唆します。Runwayのガイドが勧めるように、手掛かりを消すか、それに合う指示を書きます。
- 一本に一つの動き。 短い動画で複数のカメラ移動を要求するとカットが生じます。短いショットを別々に生成し、編集でつなぎます。
ショットを連続させるには、確認済み動画の最後のフレームを保存し、次の開始画像にします。
ffmpeg -sseof -0.1 -i approved-clip.mp4 -frames:v 1 -q:v 2 next-opening.png必要なショットから生成経路を選ぶ
| 創作上の目的 | 生成経路 | 適している理由 |
|---|---|---|
| 一枚の正確な静止画から短く動かし、画像を見てから動作を決める | MiniMax H3 Spicy 画像から動画 | 開始画像必須、プロンプトと終了画像は任意 |
| 同じ静止画で、より長いテイクや同期した音を作る | Seedance 2.5 Spicy 画像から動画 | 4〜30秒、ネイティブ音声、任意の終了画像に対応する開始フレーム経路 |
| 別々の画像の人物と場所を、新しい開始構図にまとめる | Wan 3.0 参照から動画またはSeedance 2.5 参照から動画 | 各参照の役割を明示でき、どちらも開始フレームになる必要がない |
自分で作成した成人の画像、または処理する権利と同意のある成人の画像だけを使ってください。Wan 3.0の参照経路は実在人物の写真を拒否することが多くあります(顔のチェックでタスクが失敗し、拒否されたタスクは課金されません)。ここではイラスト、3D、生成した人物を使います。H3 Spicy、Seedance 2.5 Spicy、Wan 3.0の画像から動画タスクは終了画像を受け付けます。フィールド名と制限はタスクごとに異なるため、タスクページで現在の入力仕様と見積もりを確認してください。
ホスト型かローカルか
ホスト型APIは秒単位で課金され、GPUが不要で、タスクごとの入力仕様が決まっています。テスト、アプリ、バッチ処理に適しています。ローカルなら完全に制御でき、素材が端末の外に出ませんが、ハードウェア、セットアップ、使用するウェイトの正確な選択に注意が必要です。その制御が必要で維持できるならローカル、今日結果が欲しく、生成した動画だけに支払いたいならホスト型を選びます。
五秒のテストにかかる料金
現在のカタログ料金を出力五秒分に換算した金額で、タスクごとの見積もり前の値です。設定が異なるため、品質ではなく費用の比較です。
| 生成経路 | 画像の役割 | 出力の長さ | 五秒の例 |
|---|---|---|---|
| MiniMax H3 Spicy 画像から動画 | 開始画像必須、終了画像任意 | 3〜15 s | 768p、$0.084/s → $0.42 |
| Seedance 2.5 Spicy 画像から動画 | 開始画像必須、終了画像とネイティブ音声は任意 | 4〜30 s | 720p、$0.432/s → $2.16 |
| Wan 3.0 参照から動画 | 一〜十枚の参照画像で新しいショットを導く | 2〜30 s、または自動の長さ | 720p、$0.09/s → $0.45(画像参照のみ) |
確認済みの静止画から短い動きを試すなら、H3が最も安価です。Seedanceは秒単価が高い一方、長いテイクとネイティブ音声を提供します。Wanは別の目的に応えます。元画像を最初のフレームにする必要がないためです。参照動画の秒数は請求対象秒数に加算されるので、$0.45はWan共通の料金ではありません。
同じ開始フレームから生まれた結果
両方の開始フレーム経路に、変更していない静止画と同じ五秒の動作指示を渡しました。H3の最初の生成では衣装が変わったため、公開したH3動画は不透明なドレスとジャケットを維持するよう要求した、より限定的なプロンプトを使っています(プロンプト節参照)。プロンプトが違うので、これは順位ではなく挙動を示す動画です。H3は768p、Seedanceは720pで生成しました。
MiniMax H3 Spicy、衣装維持の再試行後、768pで五秒。演者はカメラに向き直って近づき、胸から上の画角になります。不透明なドレスとジャケットは着たままです。
Seedance 2.5 Spicy、元の動作指示、720pで五秒。カメラに向き直り、胸から上の画角まで近づきます。ジャケットは両肩から滑り落ちますが、ドレスは不透明なままです。
動きの量は似ていますが、衣装が違います。H3には短く明確な連続性の指示("opaque dress and jacket stay unchanged")を与えます。Seedanceは元の指示に従い、ジャケットが滑り落ちる結果になりました。動画全体で、元画像から始まるか、動き出しても顔・ジャケット・背景が整合するか、指定した回転が見えるか、最後の一秒が編集用のカットやループ地点として使えるかを確認します。
画像を開始フレームではなく参照にする場合
演者のスタイルは好きでも、別の部屋から始めたい場合、厳密な開始画像はモデルをテラスから出発させます。参照ワークフローなら目的を直接指定できます。一枚で演者を、もう一枚で部屋を定義し、そこから始まる新しい構図を要求します。
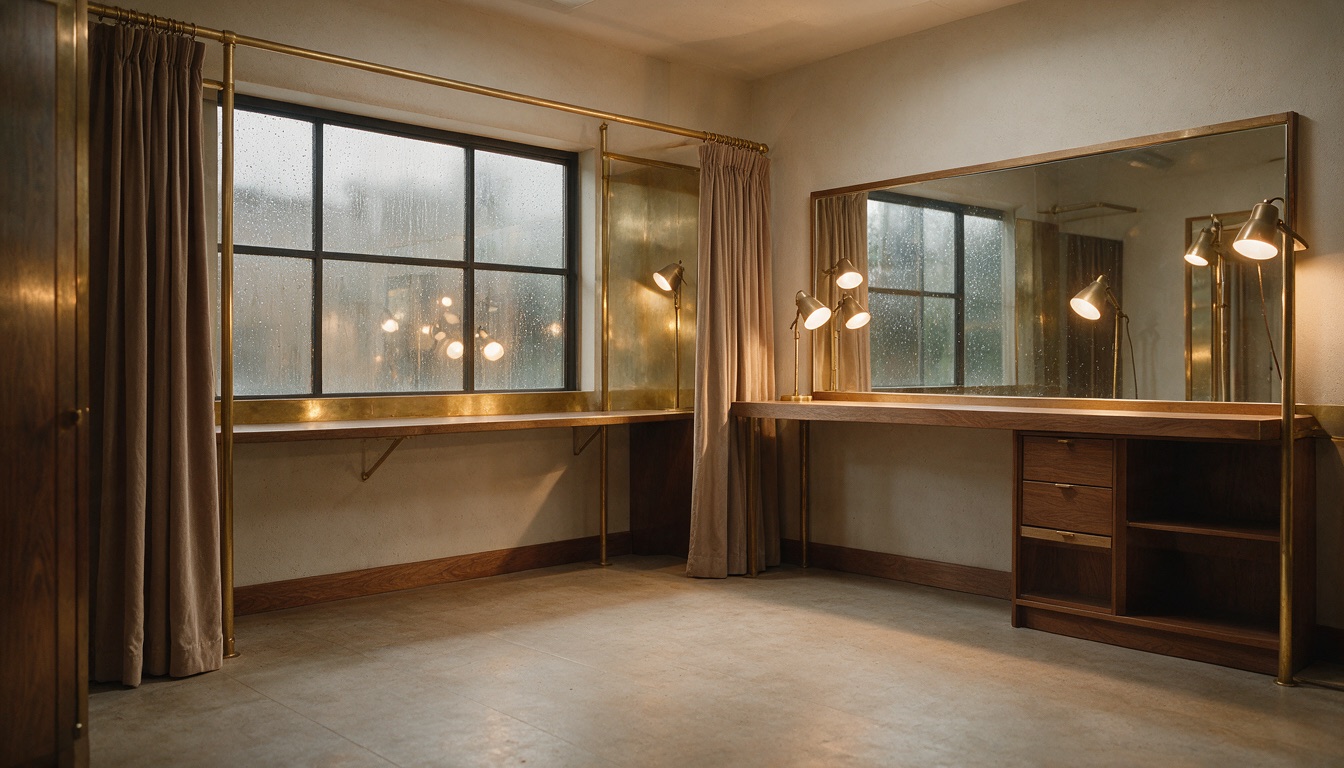
参照Bは部屋と照明です。参照Aは上のテラスのポートレートで、演者と衣装を提供します。
Wan 3.0 参照から動画、720pで五秒。鏡のある新しく構成した部屋から始まり、似た衣装の演者がカメラの方を向きます。人物の特徴と部屋の細部は近いものの、完全な一致ではありません。
参照は雰囲気と大まかな人物像を保ちますが、正確な配置や細部を再現しない場合があります。人物が変わるなら人物参照を強めるか、動きを単純にします。部屋が違うなら部屋画像や構図の要求を改善します。一回に変更するのは一つだけにします。
画像の説明ではなく動きのプロンプトを書く
被写体、衣装、照明はすでに画像に示されています。プロンプトは時間とともに変わるものを指定します。被写体の動作一つ、カメラ指示一つ、必要な環境の動きだけを、見る順序で書きます。両方の開始フレーム経路には次のプロンプトを渡しました。
The adult performer turns toward the camera as a light breeze lifts the edge of her jacket. She takes two measured steps across the terrace and settles into a held look. One slow camera push; keep her face, outfit and terrace recognisable. Rain moves softly in the background. One continuous shot.
床がほとんど見えない画角なので、歩行はカメラに向かう一〜二歩として表れます。長い歩行には広い静止画が向いています。最初の生成で衣装が変わったら、連続性の一文を加えて再試行します。例:"Keep the opaque dress and jacket exactly as in the image; one slight turn toward the camera, then a held look."
参照タスクでは、各画像に名前付きの役割を割り当て、新しい開始構図を要求します。
Use reference A for the adult performer's face and tailored wardrobe. Use reference B for the dressing room, warm lamps and mirror. Compose a new opening medium shot inside that room. She turns from the mirror toward the camera, takes one step and pauses. Slow lateral camera move, one continuous shot.
AとBを実際のアップロード順に対応させます。モデルによって異なるので、タスク固有のラベル構文も確認してください。
| 曖昧な要求 | 確認できるショットの指示 |
|---|---|
| "Make this image cinematic and sexy." | "She turns toward camera; the jacket hem moves in a light breeze; hold a medium shot." |
| "Animate everything in the image." | "Keep the face and wardrobe stable while she takes one step; the camera slowly pushes in." |
| "Use these references and create a masterpiece." | "A defines the performer; B defines the room. Start on a newly composed medium shot inside B." |
終了画像を受け付ける経路では、それが最も直接的な安定化の手段です。開始画像の位置を少し変えたコピーでも、テキストだけより途中の動きの目標を絞れます。Viduの動作ガイドもこの点に触れています。
症状に応じて修正します。二回の生成で同じ場所に同じ不具合が出たら、同じ条件で再生成するのではなく入力を変えます。
| 症状 | 考えられる原因 | 対処 |
|---|---|---|
| 回転中に顔が変わる | 大きな動き、顔が一部隠れている | 回転を小さくする、正面の静止画を使う、終了画像を追加する |
| 細部や背景がちらつく | 複雑な場面や照明の変化 | 背景を簡単にし、カメラを固定する |
| 途中で突然カットが入る | 長さに対して出来事が多すぎる | 一本につき一動作にするか、長さを延ばす |
| 再試行でも同じ場所に同じ不具合 | 元画像の問題 | 静止画を編集または再生成する |
Seedance単体のチュートリアルでは、開始フレームの作り方と経路固有のプロンプト挙動を詳しく説明しています。
Playgroundで試してからAPIを呼び出す
Playgroundで試す。 MiniMax H3 Spicyの画像から動画ページ(または表のSeedance 2.5 Spicy、Wan 3.0)を開き、ログインまたは登録します。その後:
- Input imageに静止画をアップロード(JPG、PNG、WEBP、GIF、最大10 MB)するか、Asset URLを貼り付けます。
- Promptに動作プロンプトを貼り付けます。この経路では任意です。
- 終わりが決まっている場合だけClosing frameを追加します。
- Duration(3〜15 s)とResolutionを設定します。既定値は最も安い480pなので、まずそこで試作します。
- Run modelを押します。課金前に料金が表示されます。
Wan 3.0の参照ページでは、最初のフィールドはReference imagesです。上の例と同じように各画像をプロンプト内で指定します。
次にAPIを使う。 動きがうまくでき、自分のアプリに組み込みたくなったら、Python SDK(pip install spicyapi)をインストールします。サーバー環境にSPICY_API_KEYを設定し、このH3 Spicyリクエストを実行してください(480p、五秒の試作の見積もりは$0.19です)。
import uuid
from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

task = client.create_task(
    model="minimax/h3-spicy/image-to-video",
    input_data={
        "image_url": "https://cdn.spicyapi.ai/blog/uncensored-ai-image-to-video-guide/m1-shared-source-2026-09-27.jpg",
        "prompt": "The adult performer turns toward the camera as a light breeze lifts the edge of her jacket. "
                  "One slow camera push; keep her face, outfit and terrace recognisable. One continuous shot.",
        "resolution": "480p",
        "duration_seconds": 5,
    },
    idempotency_key=str(uuid.uuid4()),
)

final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"{task['taskId']} ended as {final['state']}: {final.get('errorCode')}")
print(output_assets(final)[0]["url"]) # copy the clip to your own storage now他の経路ではフィールド名が違うので、モデルを変更する前にタスクページを読んでください。フィールド、結果、エラーはAPIリファレンスにあります。キーはサーバーで保管します。
エージェントに実行させる方法もあります。 エージェントはCLI、MCPサーバー、Agent Skillから同じ呼び出しを行えます。すべて現在のモデルスキーマを読み取り、CLIとMCPは料金を表示し、タスク作成前に確認を求めます。SPICY_API_KEYを設定した状態で:
# CLI
npx @spicyapi/cli tasks create --model minimax/h3-spicy/image-to-video \
  --input-json '{"image_url": "https://cdn.spicyapi.ai/blog/uncensored-ai-image-to-video-guide/m1-shared-source-2026-09-27.jpg", "prompt": "She turns toward the camera; one slow camera push.", "resolution": "480p", "duration_seconds": 5}' --wait

# MCP server: the command your assistant's MCP config runs
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
どの経路を使うか
| この経路を選ぶ条件 | 別の経路を探す条件 |
|---|---|
| MiniMax H3 Spicy: 画像を最初のフレームにし、最も安く短い診断をしたい | 15秒より長いテイクや、制御できる音声トラックが必要 |
| Seedance 2.5 Spicy: 画像を最初のフレームにし、長いテイク(最大30 s)かネイティブ音声が欲しい | 動きを試すだけで、秒単価が約五倍かかる |
| Wan 3.0またはSeedance 2.5の参照から動画: 画像の人物と部屋を使って新しい開始構図を作りたい | 画像自体が冒頭になる必要がある、または人物が実写写真(Wanの顔チェックで拒否されやすい) |
| 終了画像付きのH3 Spicy、Seedance 2.5 Spicy、Wan 3.0画像から動画: 終わりが固定されている | 動画の長さの中で二つの構図を自然につなげられない |
今回の動画では、H3はジャケットを維持するため衣装への指示を厳しくする必要があり、Seedanceは似た動きでジャケットを滑り落としました。Wanは両方の元画像を正確には再現せず、新しい部屋を作りました。まず画像の役割で、次に画面で見える動きと連続性で判断します。長いショットでずれが生じたら、短くするか場面を分けます。
よくある質問
画像をアップロードしたら、必ず画像から動画を選びますか?
画像そのものを冒頭にする場合だけです。別の開始構図の人物、衣装、部屋を提供するなら参照タスクを使い、各画像の役割を説明します。
プロンプトなしで写真を動かせますか?
MiniMax H3 Spicyなど一部の経路ではプロンプトが任意で、モデルが動きを推測します。特定の動作、カメラ移動、終わり方が重要なら短い指示を追加します。
動画全体で人物は完全に同じままですか?
開始フレームは強い基準ですが、全フレームの人物一致を保証しません。顔、髪、衣装のずれを動画全体で確認します。元の画角内に動きを収める、より良い静止画を使う、ショットを短く分割する方法を試します。
二枚の画像で始まりと終わりを決められますか?
タスクページで開始画像と終了画像の両方を受け付ける経路だけです。モデルは二つの構図をつなぎます。二枚の緩やかな参照から新しいショットを作る方法とは異なります。
参照から動画と画像から動画を直接比較できますか?
大まかな比較に限られます。開始フレーム経路は同じ開始画像と動作指示で比較し、参照経路は新しいショットに適切な人物と部屋を作るという目的で評価します。開始画像の役割が違う動画を、品質で劣ると判断してはいけません。
「規制なし」なら、要求した成人向け場面はすべて生成されますか?
いいえ。タスクとバージョンで挙動が異なり、完了しても指示より控えめになる場合があります。合法で同意のある成人向け素材を使い、実際のフレームを確認してください。
規制なしの画像から動画を最も安く試す方法は?
ここではMiniMax H3 Spicyです。480pで一秒あたり$0.038、五秒で約$0.19、768pなら$0.42です。動きが見える最低解像度で短い動画を試し、指示どおりになってから解像度を上げます。
音を追加できますか?
経路によります。Seedance 2.5 Spicyにはネイティブ音声の切り替えがあり、Wan 3.0の参照から動画は音声参照に対応します。MiniMax H3 Spicyの画像から動画には音声設定がなく、制御できない生成音声が付くことがあります。編集時に音声を差し替えるか追加する計画にしてください。