Wan 2.6 reference-to-video accetta da uno a tre clip brevi delle persone, degli animali o degli oggetti che vuoi, più un prompt che descrive una scena nuova. I clip decidono chi o cosa appare; il prompt decide dove si trovano, cosa fanno e come li trattano la telecamera e la luce. Il risultato dura da 2 a 10 secondi a 720p o 1080p, in uno di cinque formati d'immagine, come ripresa unica o come più riprese montate. Costa $0.065 al secondo a 720p e $0.0975 a 1080p, e anche i secondi di materiale di riferimento che invii vengono fatturati.
Usalo quando il materiale è il soggetto e il contesto è nuovo: una presentatrice registrata una volta e collocata in più luoghi, oppure un clip di prodotto rimesso in scena per una nuova stagione. Usa invece Wan 2.6 image-to-video quando un fermo immagine approvato deve stabilire il fotogramma iniziale, la scenografia e le proporzioni. Accetta anche fino a due fermi immagine, insieme ai clip o al loro posto; non ha ancora un campo di riferimento audio, ed è l'unica attività Wan 2.6 sul livello Filtered.
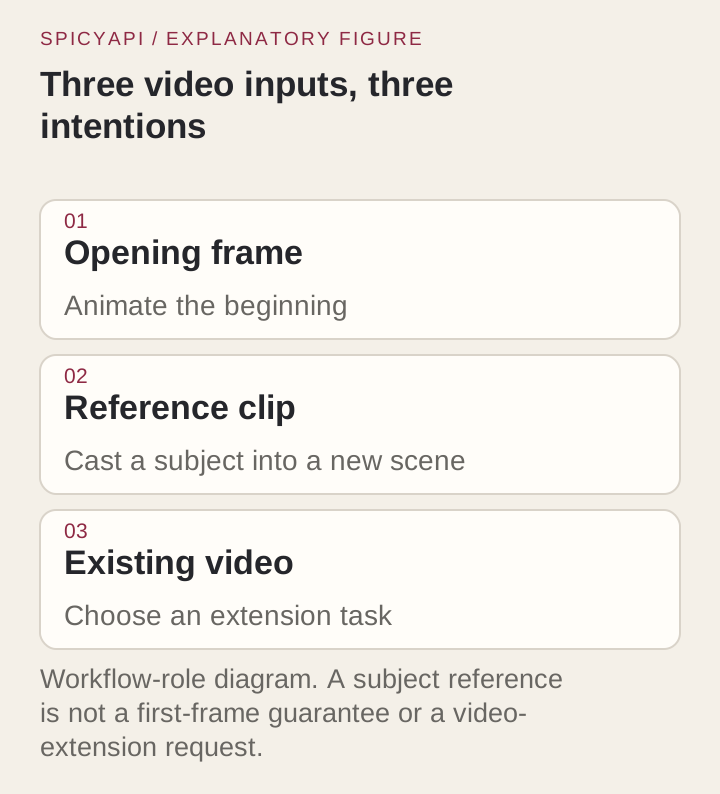
Provalo prima nel Playground
- Apri la pagina reference-to-video e resta nella scheda Playground nella vista Form. Accedi con un account con credito per eseguire.
- Sotto Reference videos aggiungi da uno a tre clip ritagliati con Add a file, oppure incolla i link con Asset URL. Il primo clip che aggiungi nel prompt si chiama character1, il secondo character2, il terzo character3.
- Scrivi il Prompt come mostrato nella sezione sulla scena qui sotto: cosa porta ogni clip, poi contesto, azione, telecamera e luce.
- Imposta Resolution su 720p, Duration su un 5 breve, Aspect ratio sul formato che consegnerai e Shot structure su Single take per il primo test.
- Imposta un Seed e conservalo mentre cambi un clip alla volta. Aggiungi Negative prompt solo per qualcosa che continua a ricomparire.
- Controlla la stima del prezzo, che include i secondi di riferimento, ed esegui. Passa a 1080p quando il casting è corretto.
Cosa accetta la richiesta
L'attività è alibaba/wan-2.6/reference-to-video.
| Campo | Regola |
|---|---|
Prompt (prompt, obbligatorio) | La scena nuova, fino a 1500 caratteri |
Reference videos (reference_video_urls) | Da uno a tre clip, MP4 o WebM, 90 MB massimo |
Reference images (reference_image_urls) | Fino a due fermi immagine, numerati dopo i clip e non fatturati; invia almeno un clip o un'immagine |
Negative prompt (negative_prompt) | Ciò che non deve comparire, fino a 1500 caratteri |
Duration (duration_seconds) | Qualsiasi numero intero da 2 a 10, 5 per impostazione predefinita |
Resolution (resolution) | 720p (predefinita) o 1080p |
Aspect ratio (aspect_ratio) | 16:9 (predefinito), 9:16, 1:1, 4:3 o 3:4 a entrambe le risoluzioni |
Shot structure (shot_type) | single (predefinita) o multi |
Seed (seed) | Da 0 a 2147483647 |
Non copiare un campo da un'altra attività Wan 2.6: un image_url o un campo audio in questo payload è un errore di contratto, non un prompt debole.
Scegli e ritaglia i clip di riferimento
Ogni clip dovrebbe mostrare un soggetto grande nell'inquadratura, ben illuminato e, se possibile, da più di un angolo. Un soggetto che resta piccolo o in controluce torna solo in modo approssimativo, e un clip di un luogo vuoto non dà al modello nulla da portare: il contesto viene dal prompt. Un clip con più persone rende poco chiaro chi debba comparire, quindi ritaglia o taglia fino al passaggio in cui il tuo soggetto è più nitido.
Taglia prima di caricare. I secondi di riferimento vengono fatturati, e pochi secondi nitidi si trasferiscono meglio di una ripresa lunga che divaga.
Aggiungi un secondo o terzo clip solo per un soggetto nuovo
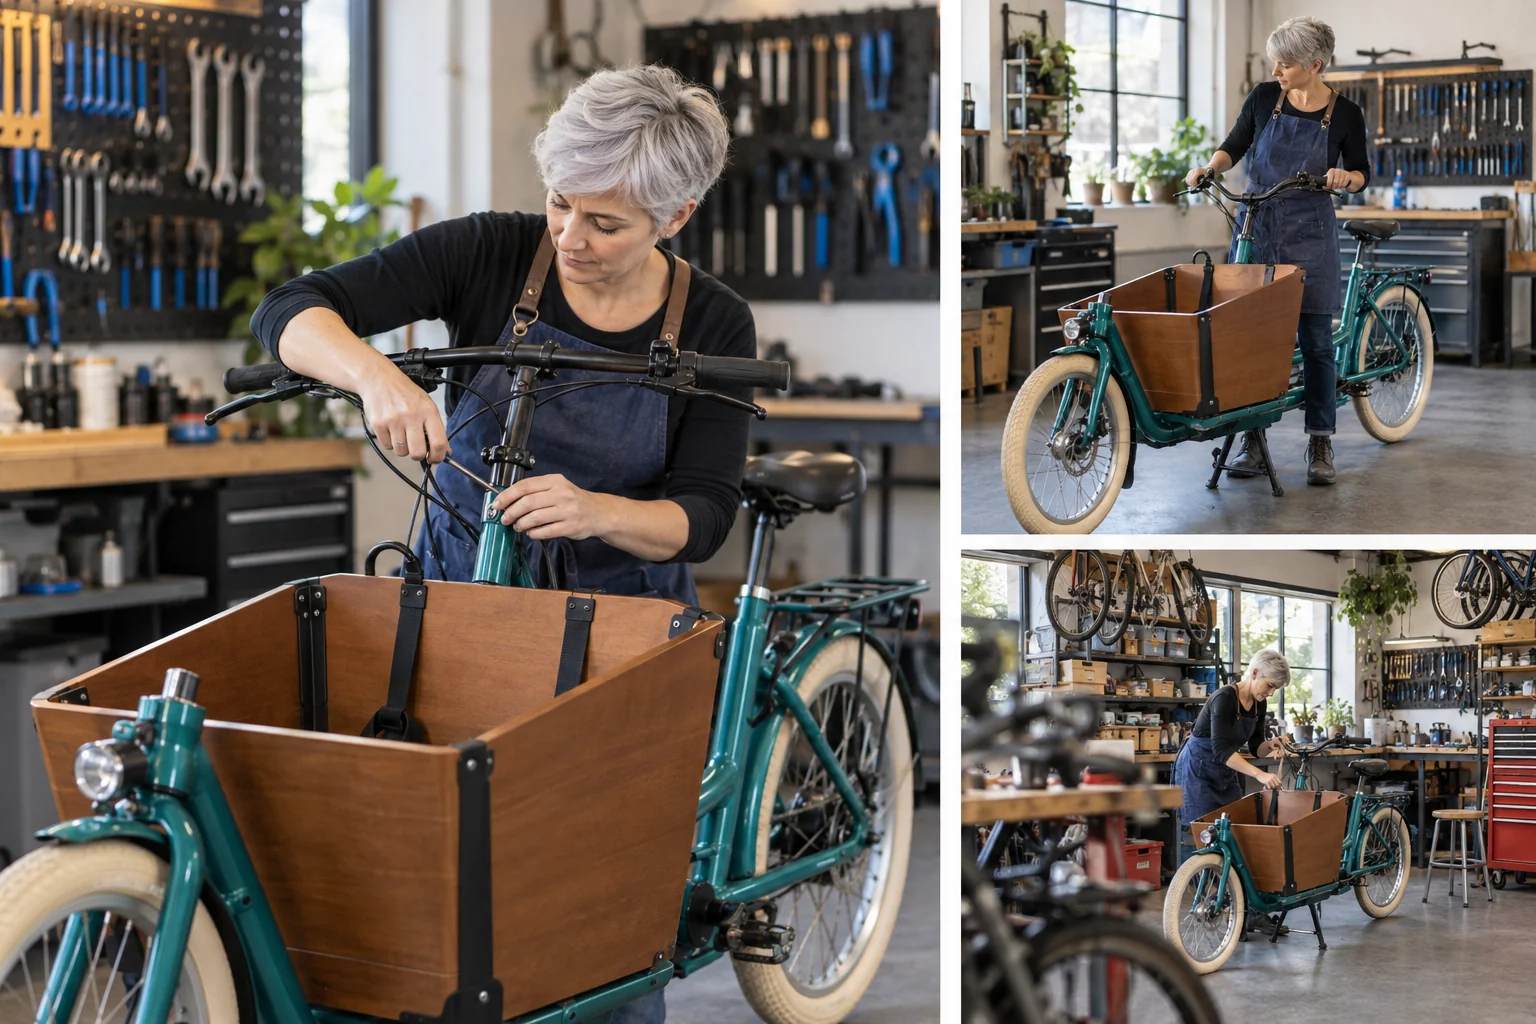
Ogni clip in più aggiunge identità, movimento e sfondo che il modello deve districare. Invia un secondo clip quando la scena richiede un altro soggetto (un venditore accanto al meccanico) o quando il primo clip nasconde un tratto decisivo di un oggetto, come il cassone di carico anteriore di una bicicletta. Dai a una seconda persona una posizione e un'azione proprie, perché volti simili in posti simili si sfocano insieme. Se due clip mostrano lo stesso soggetto in abiti diversi, scegline uno prima di inviare; un prompt che li chiede entrambi restituisce un compromesso.
Per capire se un clip aggiunto aiuta, tieni fissi seed, durata, risoluzione, proporzioni e tipo di ripresa e cambia solo i clip. Il seed mantiene costante l'estrazione casuale tra un'esecuzione e l'altra, quindi il clip che hai aggiunto è la sola cosa che si muove; non promette una riesecuzione identica fotogramma per fotogramma.
Scrivi la scena intorno ai clip
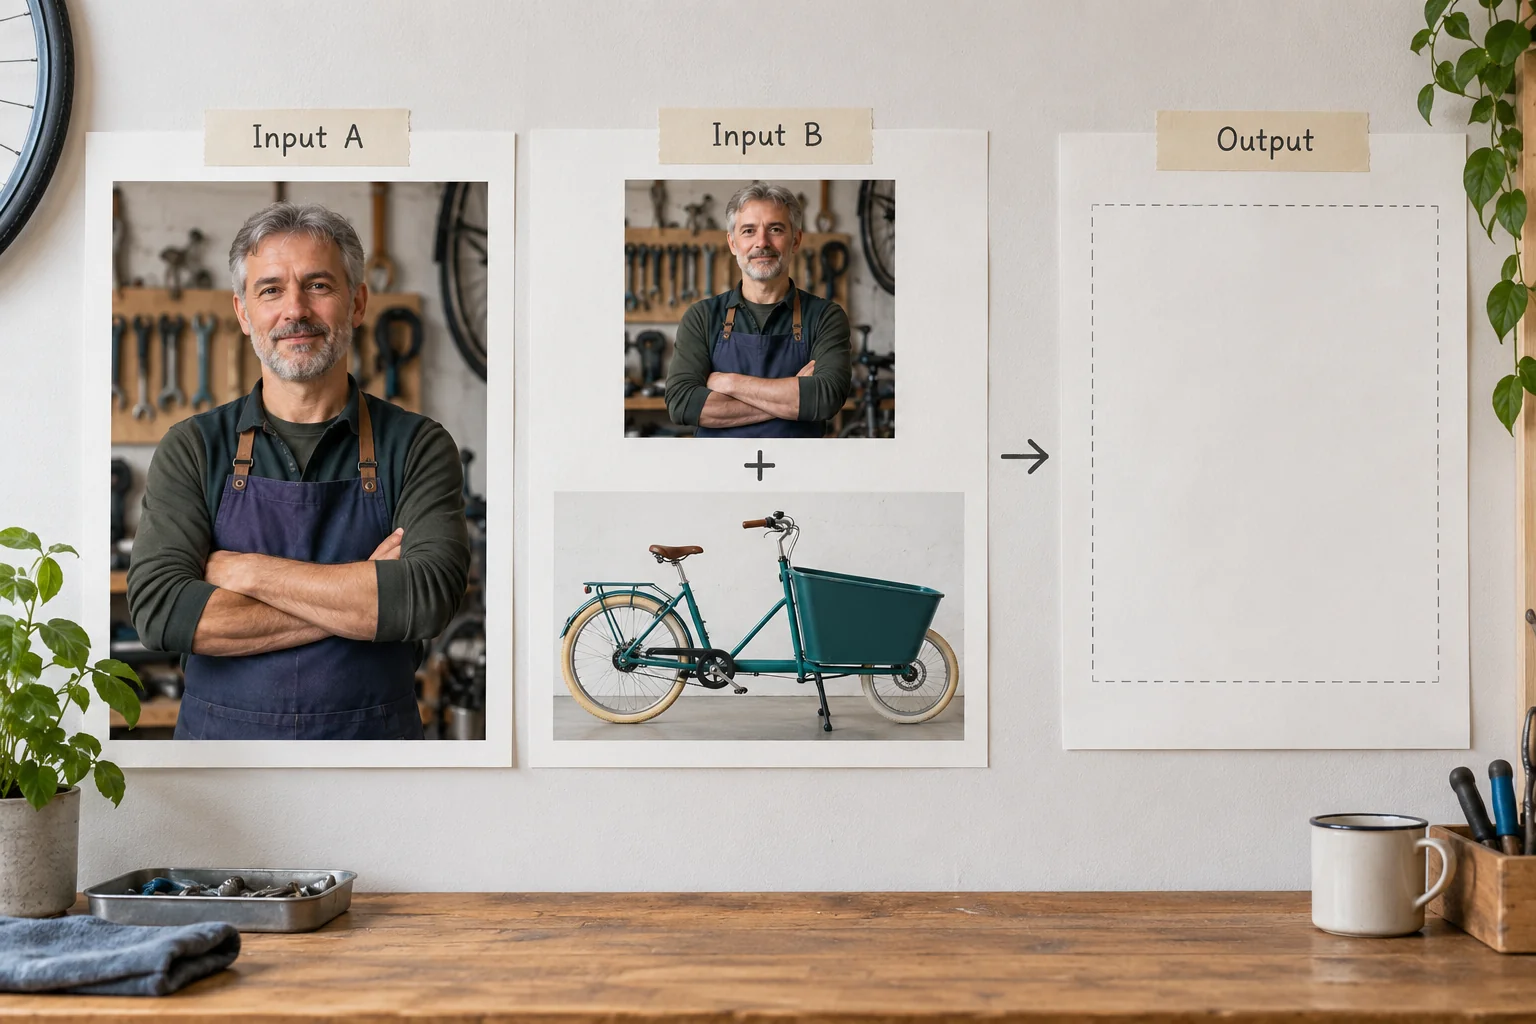
Chiama ogni clip character1, character2 o character3, nell'ordine in cui li hai inviati: il modello riconosce i soggetti solo da questi nomi, e scrivendo «Clip 1» o «il clip del meccanico» può solo tirare a indovinare. Indica cosa porta ciascuno, poi dai contesto, azione, telecamera e luce. Non riscrivere ciò che il materiale mostra già: consuma i 1500 caratteri e fa concorrenza ai clip. Scrivi una ripresa con un'azione netta, così puoi capire se il casting ha funzionato prima di chiedere una storia.
character1 is the mechanic: keep the short silver hair and indigo apron.
character2 is the teal cargo bicycle: keep its front box and cream tires.
Place them in a quiet produce market at dawn. One continuous medium-wide shot:
character1 wheels character2 a few steps and stops beside a vegetable stall.
Slow sideways camera move, soft morning light, distant market ambience.
Usa negative_prompt per ciò che ricompare a ogni esecuzione, come una persona in più, sottotitoli sovrapposti o un accessorio del clip, invece di elencare in anticipo tutte le esclusioni. Cambia una cosa sola tra un tentativo e l'altro. Se l'officina trapela nel mercato, chiarisci la destinazione e taglia il clip; cambiare insieme abbigliamento, telecamera e durata non ti dice quale correzione ha funzionato.
Ripresa unica o più tagli
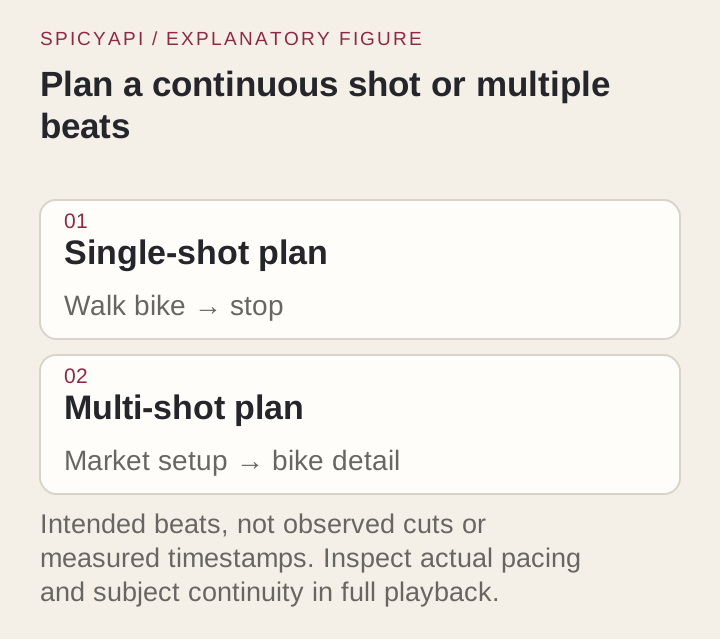
single mantiene una ripresa continua ed è il primo test giusto perché vedi se il soggetto cambia durante il movimento. multi lascia che il modello tagli fra riprese dentro la scena; rende a partire da circa 6 secondi, perché un clip di 2 o 3 secondi raramente ha spazio per un taglio. Dirigi i tagli con un elenco numerato di riprese nel prompt, per esempio un arrivo in campo medio largo seguito da un primo piano della bicicletta che si ferma, e verifica che il soggetto sembri lo stesso dopo il taglio.
Formato, dimensione e durata
Le proporzioni si scelgono nella richiesta e non derivano dai clip, quindi un unico set di riferimenti può essere consegnato in più formati e una consegna verticale non richiede materiale sorgente verticale. Scrivi la scena per l'inquadratura che scegli: un panorama di mercato a tutta larghezza non entra in una consegna 9:16. Prova le proporzioni definitive invece di ritagliare dopo un risultato largo, perché un ritaglio può nascondere la parte che è andata storta.
| Proporzioni | 720p | 1080p |
|---|---|---|
| 16:9 | 1280 x 720 | 1920 x 1080 |
| 9:16 | 720 x 1280 | 1080 x 1920 |
| 1:1 | 960 x 960 | 1440 x 1440 |
| 4:3 | 1088 x 832 | 1632 x 1248 |
| 3:4 | 832 x 1088 | 1248 x 1632 |
La durata è il principale fattore di prezzo ed è anche il punto in cui la somiglianza deriva. Guarda tutto il clip, non il primo secondo, e osserva bene l'ultimo secondo prima di impegnarti su una durata lunga. La risoluzione fissa la tariffa e il tempo di rendering; non corregge un soggetto sbagliato, quindi definisci il casting a 720p e passa a 1080p per il risultato finale.
Poi esegui da codice
Installa l'SDK Python (pip install spicyapi), imposta SPICY_API_KEY nell'ambiente del tuo server, sostituisci i link segnaposto con clip che hai il diritto di usare ed esegui:
import uuid
from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

task = client.create_task(
    model="alibaba/wan-2.6/reference-to-video",
    input_data={
        "prompt": "character1 is the mechanic and character2 is the teal cargo bike. At a quiet "
                  "produce market at dawn, character1 wheels character2 forward and stops beside "
                  "a vegetable stall. One medium-wide continuous shot, slow sideways camera move, "
                  "distant market ambience.",
        "reference_video_urls": [
            "https://example.com/mechanic.mp4",
            "https://example.com/cargo-bike.mp4",
        ],
        "duration_seconds": 5,
        "resolution": "720p",
        "aspect_ratio": "16:9",
        "shot_type": "single",
        "seed": 26017,
    },
    idempotency_key=str(uuid.uuid4()),
)

final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"{task['taskId']} ended as {final['state']}: {final.get('errorCode')}")
print(output_assets(final)[0]["url"])  # copy the clip to your own storage now
Preventivi, attese, nuovi tentativi, callback e codici di errore sono descritti nella guida alle attività e nel riferimento dell'SDK Python; i risultati scadono, vedi conservazione e consegna. L'attività non ha ingresso né impostazione audio, ma il clip torna con suono generato: descrivi nel prompt cosa vuoi sentire (per esempio un'ambientazione) e sostituiscilo nel tuo montaggio se ti serve un audio specifico.
Oppure lascia che sia un agente a eseguire
Quando le generazioni le deve avviare un assistente, tutti e tre gli strumenti ufficiali mostrano il prezzo e chiedono conferma prima di una chiamata a pagamento.
- CLI. Metti lo stesso oggetto
inputininput.json, poi eseguispicyapi tasks create --model alibaba/wan-2.6/reference-to-video --input-file input.json --wait. Per un clip sul tuo computer,spicyapi files upload ./mechanic.mp4restituisce un indirizzospicy://da usare inreference_video_urls. Vedi la documentazione della CLI. - Server MCP. Aggiungi il server MCP al tuo assistente, poi chiedi: "Cast the person in /path/to/mechanic.mp4 into a dawn produce market on Wan 2.6 reference-to-video, 5 seconds, 720p.". Carica il file con
spicyapi_upload_file, poi chiamaspicyapi_task_create, che si ferma per la tua conferma del prezzo. - Skill.
npx skills add spicyapi-ai/spicy-skillinstalla l'Agent Skill, che fa leggere a un assistente di programmazione lo schema del modello in tempo reale invece di indovinare i campi.
Metti in bilancio i secondi di riferimento
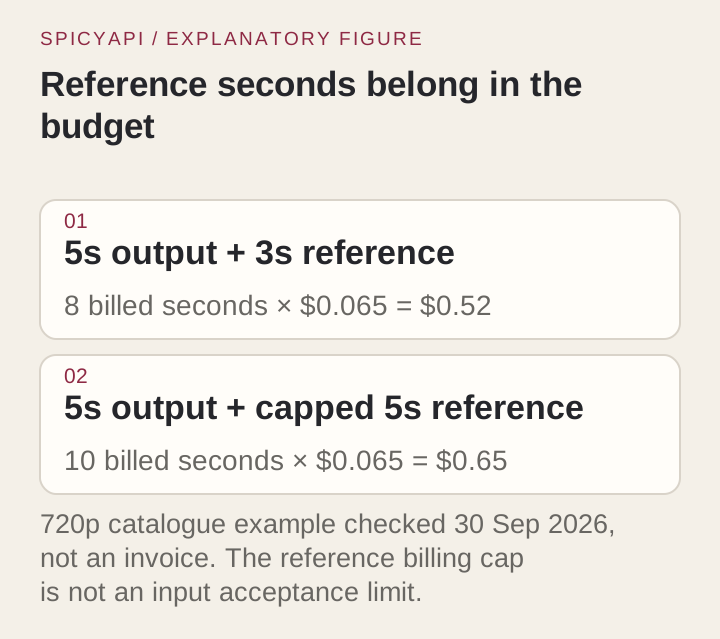
I secondi fatturabili sono la durata dell'output più la durata dei clip di riferimento, con ogni clip arrotondato per eccesso al secondo intero e al massimo cinque secondi di riferimento contati in totale. Una resa di 5 secondi con un clip di 3 secondi fattura 8 secondi; la stessa resa con tre clip che sommano a nove secondi fattura 10. La stima in tempo reale prima dell'invio mostra l'importo. Se la durata di un clip non è leggibile in anticipo, la trattenuta assume cinque secondi di riferimento e l'addebito finale usa la durata misurata.
| Durata output | 720p, 3 s di riferimenti | 720p, 5 s o più | 1080p, 3 s di riferimenti | 1080p, 5 s o più |
|---|---|---|---|---|
| 2 s | $0.325 | $0.455 | $0.4875 | $0.6825 |
| 5 s | $0.52 | $0.65 | $0.78 | $0.975 |
| 10 s | $0.845 | $0.975 | $1.2675 | $1.4625 |
I prezzi sono le tariffe del catalogo in vigore al momento della scrittura. Un riferimento più corto e più pulito è il risparmio più economico: toglie secondi fatturati e dà al modello un soggetto più chiaro, e un nuovo tentativo costa un'intera esecuzione.
Controlla il risultato e correggilo
Valuta la persona e l'oggetto separatamente, perché uno può riuscire mentre l'altro fallisce. Per la persona: il viso e l'abito restano uguali attraverso le rotazioni e dopo qualsiasi taglio, e nessuna persona in più sostituisce il soggetto. Per l'oggetto: sopravvive la forma, non solo il colore (il cassone di carico, il numero di ruote), perché una normale bicicletta turchese è anch'essa turchese. Cerca anche elementi di scena riportati dal clip, come la porta dell'officina o uno scaffale di attrezzi.
| Cosa vedi | Cosa provare |
|---|---|
| La persona sbagliata, o due soggetti fusi | Un soggetto per clip; nel prompt nomina ogni clip come character1, character2 e così via; dai a ciascuno una posizione e un'azione distinte |
| La bicicletta diventa un'altra bicicletta | Usa un clip che mostri cassa e telaio; semplifica il movimento di telecamera, perché un'orbita chiede al modello di inventare superfici mai viste |
| Il contesto vecchio trapela | Taglia il clip sul soggetto, indica prima il nuovo contesto, aggiungi l'elemento che trapela a negative_prompt |
| Il primo secondo è giusto e la fine deriva | Accorcia la durata o l'azione; fai muovere la telecamera o il soggetto, non entrambi |
| L'identità cambia tra un taglio e l'altro | Riesegui in single, oppure semplifica la seconda ripresa |
| Le mani o i piccoli accessori si deformano | Tienili fuori dai primi piani; è una caratteristica della linea Wan, non dei tuoi clip |
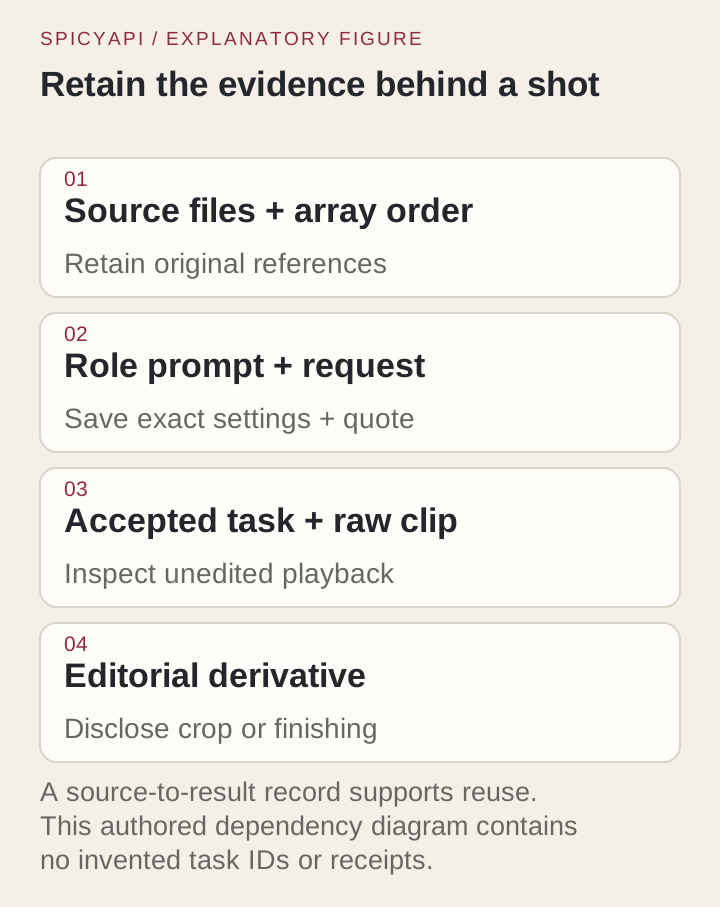
Se due o tre revisioni non assestano il soggetto, cambia attività invece di forzare: un fermo immagine composto con image-to-video, oppure uno dei modelli qui sotto. Per una ripresa che riutilizzerai, conserva insieme i clip, la richiesta completa e l'output non montato.
Livello di contenuto e consenso
Wan 2.6 image-to-video e text-to-video sono Uncensored, ma reference-to-video è Filtered. Sui nostri test di settembre 2026 un clip di riferimento esplicito è stato rifiutato, quindi un casting per adulti appartiene a un'altra attività; vedi quali versioni di Wan sono uncensored. Il casting di riferimento porta un volto riconoscibile in una scena mai avvenuta, quindi usa personaggi fittizi o materiale di persone reali che hanno acconsentito, ed etichetta i risultati generati come generati dove un pubblico potrebbe scambiarli per una registrazione.
Il livello più veloce: Wan 2.6 Flash reference-to-video
Dal 14 ottobre Wan 2.6 Flash reference-to-video offre lo stesso casting sul livello Flash di Wan 2.6, più rapido e meno costoso, con tre differenze che cambiano ciò che invii:
- Più fermi immagine.
reference_image_urlsaccetta fino a cinque immagini invece di due, insieme a un massimo di tre clip inreference_video_urls, cinque riferimenti in tutto. Le immagini non vengono fatturate su nessuna delle due attività; i clip aggiungono i propri secondi come descritto sopra, fino a cinque in totale. - L'audio si attiva a parte.
generate_audioè disattivato per impostazione predefinita e restituisce solo l'immagine, a $0.0225 al secondo a 720p o $0.03375 a 1080p. Se lo attivi, aggiunge voci, effetti e ambiente generati a $0.045 o $0.0675. L'attività di questa pagina restituisce sempre l'audio, a $0.065 al secondo a 720p. - È Uncensored. Nei nostri test del 14 ottobre le richieste con riferimenti per adulti sono tornate come richiesto, senza alcun rifiuto.
Nel prompt chiama i riferimenti character1, character2 e così via, prima i clip e poi i fermi immagine; la chiamata è alibaba/wan-2.6-flash/reference-to-video. Flash cede un po' di dettaglio fine in cambio della velocità, quindi è adatto a bozze di casting, grandi volumi e scene per adulti. Resta su questa attività quando una sola ripresa deve portare la texture più curata del livello Wan 2.6 completo.
Quando un altro modello è più adatto
| Ti serve | Usa |
|---|---|
| Un fermo immagine per fissare il primo fotogramma, 5, 10 o 15 s | Wan 2.6 image-to-video, $0.09 al secondo a 720p, Uncensored |
| Più immagini, audio come riferimento, più clip, fino a 30 s | Wan 3.0 reference-to-video: fino a dieci immagini, cinque clip e cinque tracce audio, $0.09 al secondo a 720p, Uncensored; il suo controllo dei volti può rifiutare foto di persone reali, quindi usa clip o personaggi generati; la guida al flusso di Wan 3.0 copre le tre attività |
| Fermi immagine, clip e audio insieme | Seedance 2.0 reference-to-video: fino a nove fermi immagine, tre clip e tre tracce audio, da $0.043 al secondo a 480p, Uncensored; le versioni Fast e Mini costano ancora meno |
Resta su Wan 2.6 reference-to-video quando i tuoi riferimenti sono fino a tre clip e due fermi immagine e vuoi il casting Wan a 720p più economico ($0.065 al secondo contro $0.09 su Wan 3.0) con tagli a più riprese opzionali. Taglia i clip, nomina ciascuno nel prompt, prova a 720p in ripresa unica e apri l'attività reference-to-video per controllare il prezzo in tempo reale dei tuoi clip prima di eseguire.