Wan 2.6 reference-to-video przyjmuje od jednego do trzech krótkich klipów wybranych osób, zwierząt lub obiektów plus prompt opisujący nową scenę. Klipy decydują, kto lub co pojawia się w kadrze; prompt decyduje, gdzie ta osoba czy obiekt się znajduje, co robi i jak traktują go kamera i światło. Wynik trwa od 2 do 10 sekund w 720p lub 1080p, w jednym z pięciu formatów obrazu, jako jedno ujęcie albo kilka montowanych ujęć. Kosztuje 0,065 $ za sekundę w 720p i 0,0975 $ w 1080p, a sekundy materiału referencyjnego, który wysyłasz, są też rozliczane.
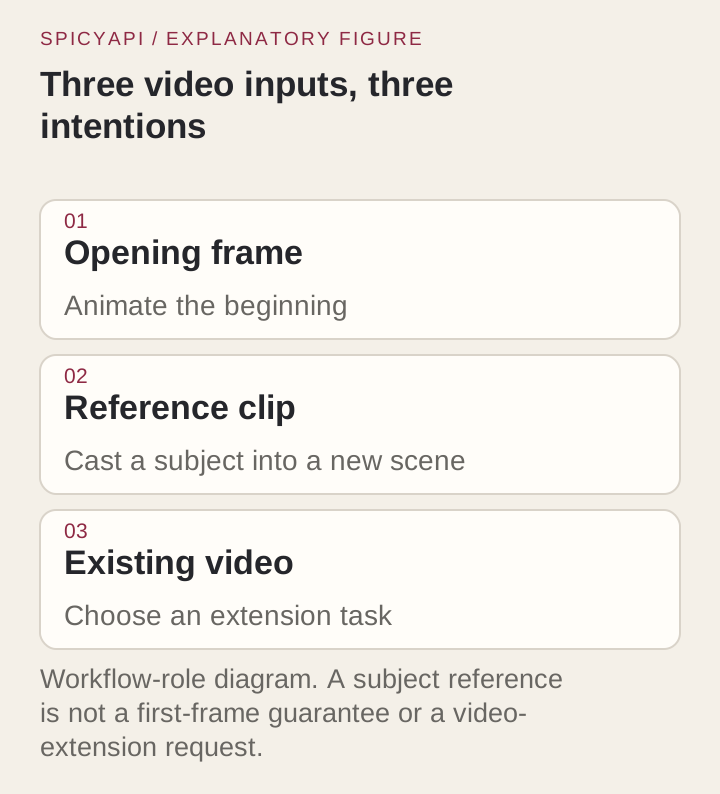
Używaj tego, gdy materiał jest bohaterem, a otoczenie jest nowe: prowadząca nagrana raz i umieszczona w kilku lokalizacjach albo klip produktowy przestawiony na nowy sezon. Zamiast tego użyj Wan 2.6 image-to-video, gdy zatwierdzony obraz ma wyznaczać pierwszą klatkę, dekorację i proporcje. Przyjmuje też do dwóch statycznych obrazów, razem z klipami albo zamiast nich; nadal nie ma pola referencji dźwięku i jest jedynym zadaniem Wan 2.6 na poziomie Filtered.
Najpierw spróbuj w Playground
- Otwórz stronę reference-to-video i zostań w zakładce Playground w widoku Form. Zaloguj się kontem z saldem, aby uruchomić.
- W sekcji Reference videos dodaj od jednego do trzech przyciętych klipów przez Add a file albo wklej linki przez Asset URL. Pierwszy dodany klip w prompcie nazywa się character1, drugi character2, trzeci character3.
- Napisz Prompt tak, jak pokazano w sekcji sceny poniżej: co wnosi każdy klip, potem otoczenie, akcja, kamera i światło.
- Ustaw Resolution na 720p, Duration na krótkie 5, Aspect ratio na format, w którym dostarczasz, a Shot structure na Single take przy pierwszym teście.
- Ustal Seed i utrzymuj go, zmieniając po jednym klipie. Negative prompt dodawaj tylko dla rzeczy, które wracają za każdym razem.
- Sprawdź szacunek ceny, który obejmuje sekundy referencyjne, i uruchom zadanie. Przejdź na 1080p, gdy obsada będzie poprawna.
Co przyjmuje żądanie
Zadanie to alibaba/wan-2.6/reference-to-video.
| Pole | Reguła |
|---|---|
Prompt (prompt, wymagane) | Nowa scena, do 1500 znaków |
Reference videos (reference_video_urls) | Od jednego do trzech klipów, MP4 lub WebM, maksymalnie 90 MB |
Reference images (reference_image_urls) | Do dwóch statycznych obrazów, numerowanych po klipach i nierozliczanych; wyślij co najmniej jeden klip albo jeden obraz |
Negative prompt (negative_prompt) | To, czego nie może być, do 1500 znaków |
Duration (duration_seconds) | Dowolna liczba całkowita od 2 do 10, domyślnie 5 |
Resolution (resolution) | 720p (domyślnie) lub 1080p |
Aspect ratio (aspect_ratio) | 16:9 (domyślnie), 9:16, 1:1, 4:3 lub 3:4 w obu rozdzielczościach |
Shot structure (shot_type) | single (domyślnie) lub multi |
Seed (seed) | Od 0 do 2147483647 |
Nie kopiuj pola z innego zadania Wan 2.6: image_url lub pole audio w tym ładunku to błąd kontraktu, a nie słaby prompt.
Wybierz i przytnij klipy referencyjne
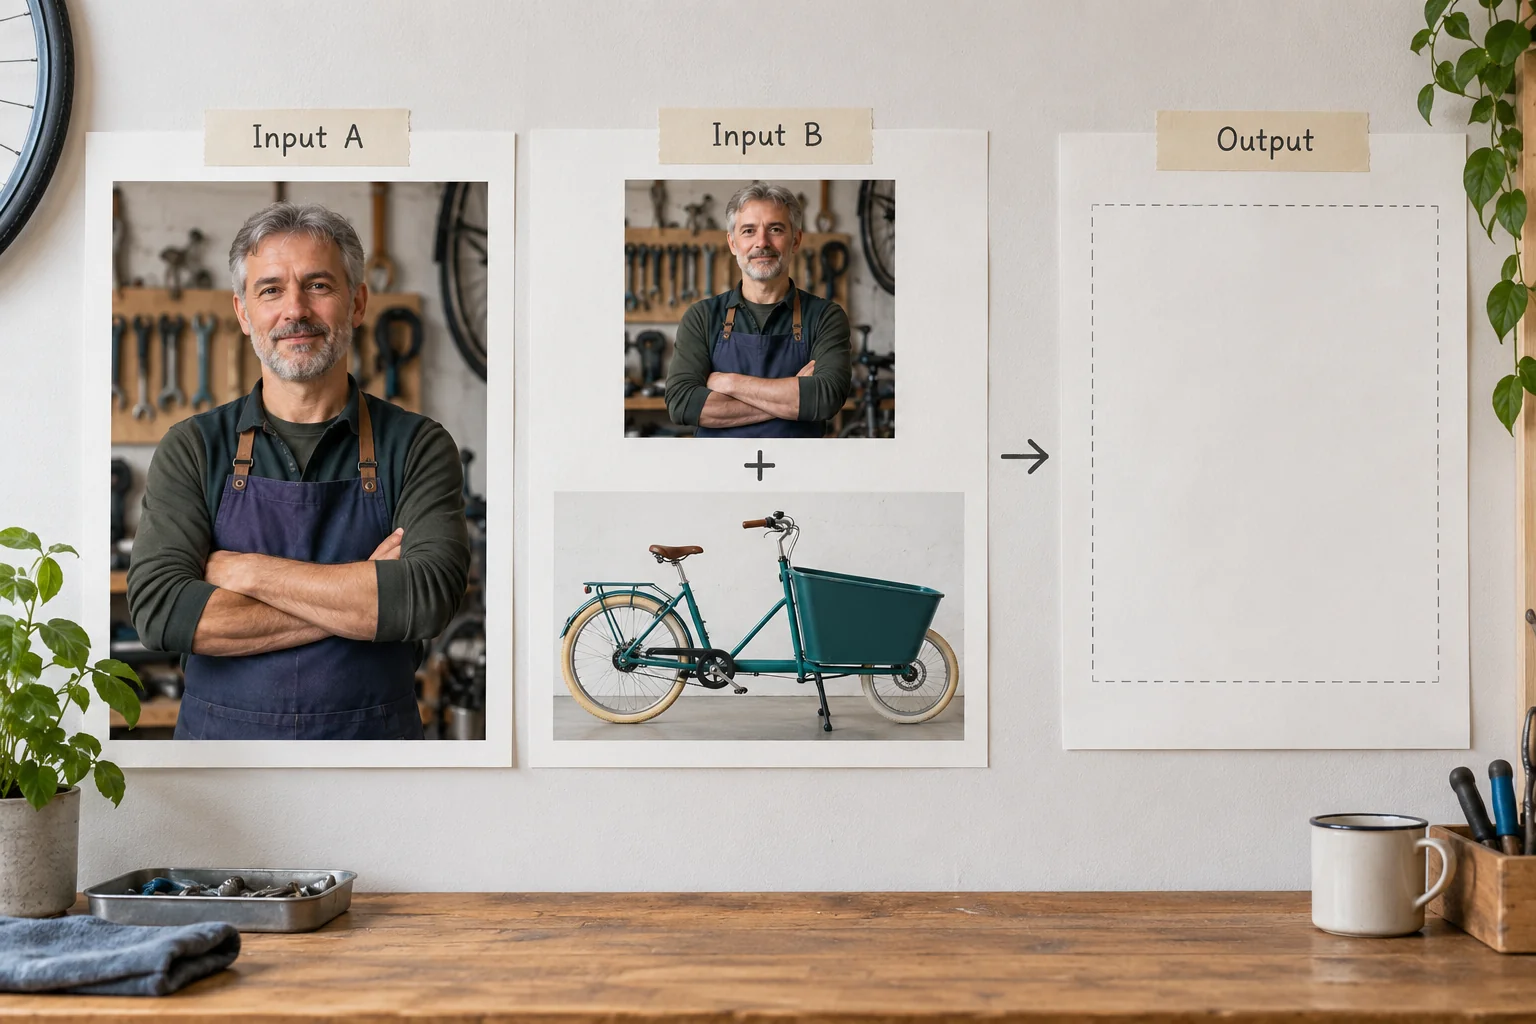
Każdy klip powinien pokazywać jedną postać, dużą w kadrze, dobrze oświetloną i, jeśli to możliwe, z więcej niż jednego kąta. Postać, która pozostaje mała lub jest podświetlona z tyłu, wraca tylko w przybliżeniu, a klip pustego miejsca nie daje modelowi nic do przeniesienia: otoczenie pochodzi z promptu. Klip z kilkoma osobami nie pokazuje jasno, kto ma zostać przeniesiony, więc przytnij go do fragmentu, w którym twoja postać jest najwyraźniejsza.
Przytnij przed przesłaniem. Sekundy referencyjne są rozliczane, a kilka wyraźnych sekund przenosi się lepiej niż długie ujęcie, które się rozłazi.
Dodaj drugi lub trzeci klip tylko dla nowej postaci
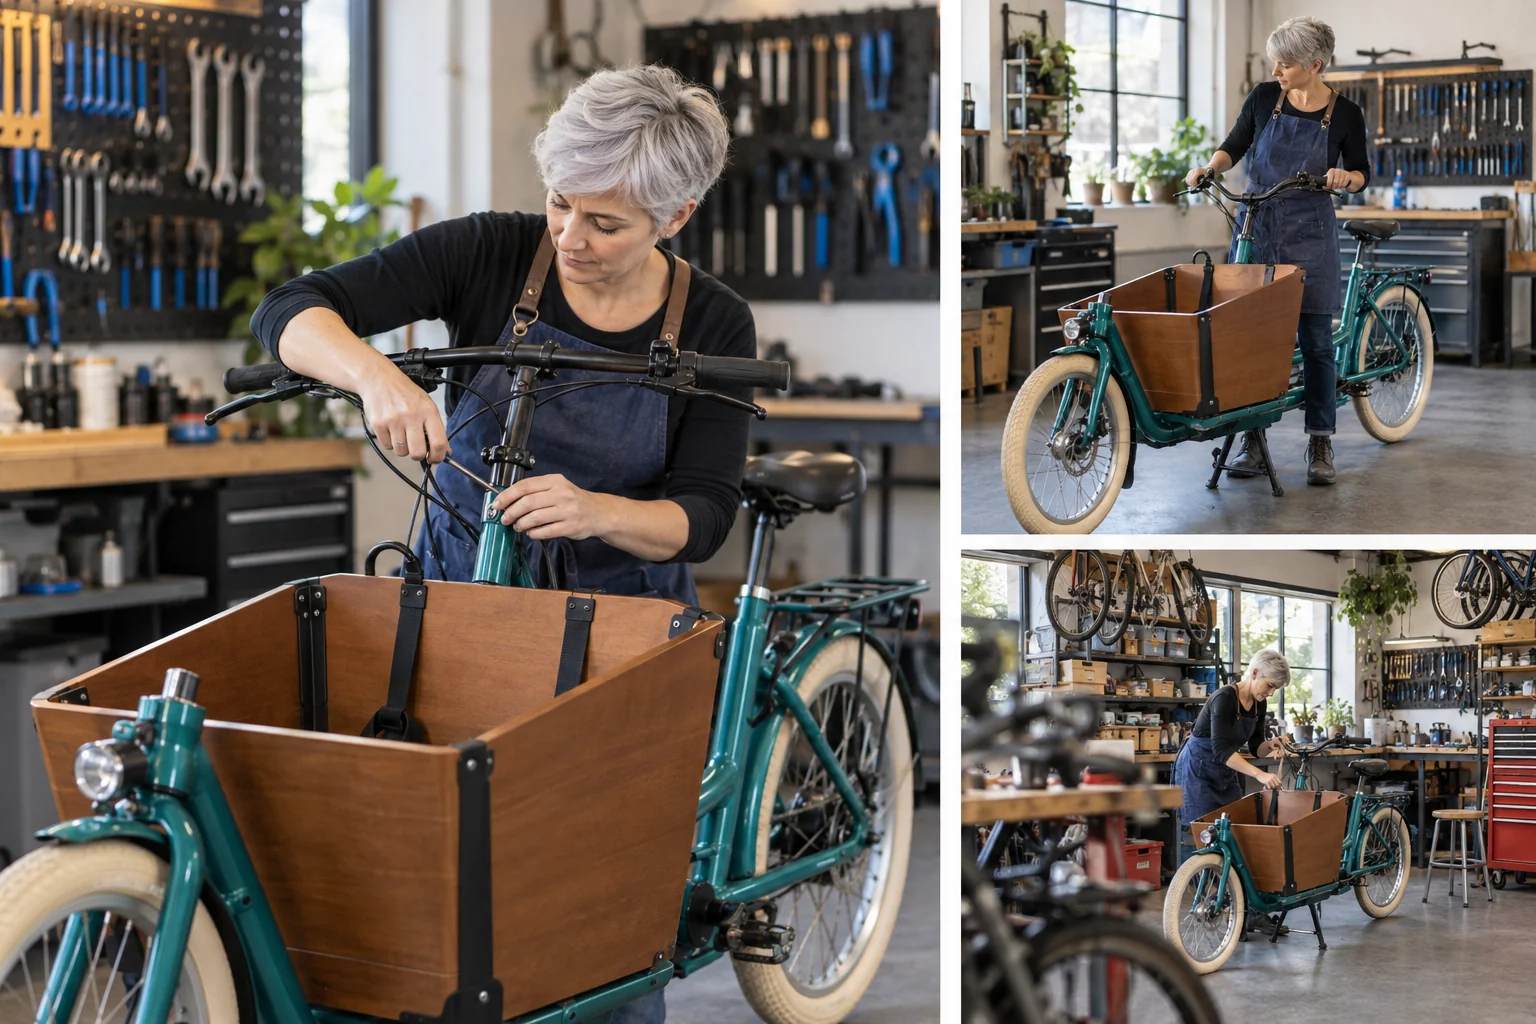
Każdy dodatkowy klip wnosi tożsamość, ruch i tło, które model musi rozdzielić. Wyślij drugi klip, gdy scena potrzebuje kolejnej postaci (sprzedawca stojący obok mechanika) albo gdy pierwszy klip zasłania cechę definiującą obiektu, na przykład przedni koszyk cargo w rowerze. Drugiej osobie nadaj własne miejsce i własne działanie, bo podobne twarze w podobnych miejscach zlewają się. Jeśli dwa klipy pokazują tę samą postać w różnych ubraniach, wybierz jeden przed wysłaniem; prompt proszący o oba zwróci kompromis.
Żeby sprawdzić, czy dodany klip pomaga, ustaw stały seed, czas trwania, rozdzielczość, format obrazu i typ ujęcia, a zmieniaj tylko klipy. Seed utrzymuje losowanie stałe między uruchomieniami, więc dodany klip jest jedyną rzeczą, która się zmienia; nie obiecuje powtórki identycznej klatka po klatce.
Napisz scenę wokół klipów
Nazywaj każdy klip character1, character2 lub character3, w kolejności wysłania: model rozpoznaje obsadę tylko po tych nazwach, więc przy „Clip 1” albo „klipie z mechanikiem” musi zgadywać. Napisz, co wnosi każdy z nich, a potem podaj otoczenie, akcję, kamerę i światło. Nie opisuj ponownie tego, co materiał już pokazuje: to zużywa 1500 znaków i konkuruje z klipami. Napisz jedno ujęcie z jedną jasną akcją, żebyś mógł ocenić, czy przeniesienie postaci zadziałało, zanim poprosisz o jakąkolwiek historię.
character1 is the mechanic: keep the short silver hair and indigo apron.
character2 is the teal cargo bicycle: keep its front box and cream tires.
Place them in a quiet produce market at dawn. One continuous medium-wide shot:
character1 wheels character2 a few steps and stops beside a vegetable stall.
Slow sideways camera move, soft morning light, distant market ambience.
Użyj negative_prompt na coś, co wraca przy każdym uruchomieniu, na przykład na dodatkową osobę, napisy na ekranie albo rekwizyt z klipu, zamiast wcześniej wyliczać wszystkie wykluczenia. Między próbami zmieniaj jedną rzecz. Jeśli warsztat przebija się na targ, doprecyzuj miejsce docelowe i przytnij klip; jednoczesna zmiana stroju, kamery i czasu trwania nie pokaże, która poprawka zadziałała.
Jedno ujęcie czy wiele ujęć
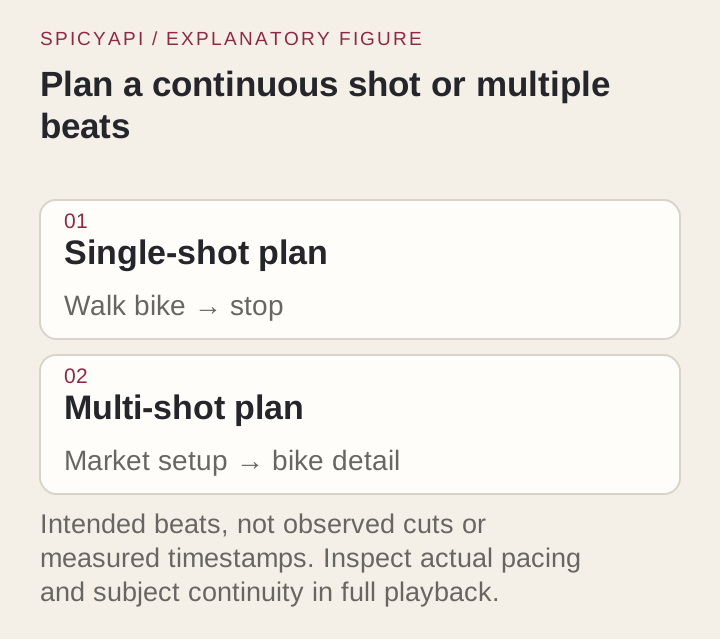
single utrzymuje jedno ciągłe ujęcie i jest właściwym pierwszym testem, bo widzisz, czy postać zmienia się w ruchu. multi pozwala modelowi ciąć między ujęciami wewnątrz sceny; to się opłaca od około 6 sekund, bo klip od 2 do 3 sekund rzadko zostawia miejsce na cięcie. Steruj cięciami numerowaną listą ujęć w prompcie, na przykład wejściem w planie ogólnym na pół sylwetki, po którym następuje zbliżenie na rower, który się zatrzymuje, i sprawdź, czy postać wygląda tak samo po cięciu.
Kształt, rozmiar i długość
Format obrazu to wybór w żądaniu, a nie coś, co bierze się z klipów, więc jeden zestaw referencji można dostarczyć w kilku kształtach, a dostawa pionowa nie wymaga pionowego materiału źródłowego. Napisz scenę pod wybrany kadr: panorama targu na całą szerokość nie zmieści się w dostawie 9:16. Przetestuj końcowy format zamiast później przycinać szeroki wynik, bo kadrowanie może ukryć część, która poszła nie tak.
| Format obrazu | 720p | 1080p |
|---|---|---|
| 16:9 | 1280 x 720 | 1920 x 1080 |
| 9:16 | 720 x 1280 | 1080 x 1920 |
| 1:1 | 960 x 960 | 1440 x 1440 |
| 4:3 | 1088 x 832 | 1632 x 1248 |
| 3:4 | 832 x 1088 | 1248 x 1632 |
Czas trwania to główny czynnik ceny, a zarazem miejsce, w którym podobieństwo się rozjeżdża. Odtwórz cały klip, nie tylko pierwszą sekundę, i przyjrzyj się uważnie ostatniej sekundzie, zanim zdecydujesz się na długie ujęcie. Rozdzielczość ustala stawkę i czas renderowania; nie naprawi złej postaci, więc ustal obsadę w 720p, a na finał przejdź na 1080p.
Potem uruchom to z kodu
Zainstaluj SDK Pythona (pip install spicyapi), ustaw SPICY_API_KEY w środowisku swojego serwera, zamień przykładowe linki na klipy, na które masz prawo, i uruchom:
import uuid
from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

task = client.create_task(
    model="alibaba/wan-2.6/reference-to-video",
    input_data={
        "prompt": "character1 is the mechanic and character2 is the teal cargo bike. At a quiet "
                  "produce market at dawn, character1 wheels character2 forward and stops beside "
                  "a vegetable stall. One medium-wide continuous shot, slow sideways camera move, "
                  "distant market ambience.",
        "reference_video_urls": [
            "https://example.com/mechanic.mp4",
            "https://example.com/cargo-bike.mp4",
        ],
        "duration_seconds": 5,
        "resolution": "720p",
        "aspect_ratio": "16:9",
        "shot_type": "single",
        "seed": 26017,
    },
    idempotency_key=str(uuid.uuid4()),
)

final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"{task['taskId']} ended as {final['state']}: {final.get('errorCode')}")
print(output_assets(final)[0]["url"])  # copy the clip to your own storage now
Wyceny, oczekiwanie, ponowne próby, callbacki i kody błędów opisuje przewodnik po zadaniach oraz referencja SDK Pythona; wyniki wygasają, zobacz przechowywanie i dostarczanie. Zadanie nie ma wejścia ani ustawienia dźwięku, ale klip wraca z wygenerowanym dźwiękiem: opisz w prompcie, co chcesz usłyszeć (na przykład atmosferę targu), i podmień go w swoim montażu, jeśli potrzebujesz konkretnego audio.
Albo niech to wykona agent
Gdy generacje ma uruchamiać asystent, wszystkie trzy oficjalne narzędzia pokazują cenę i pytają przed płatnym wywołaniem.
- CLI. Włóż ten sam obiekt
inputdoinput.json, a potem uruchomspicyapi tasks create --model alibaba/wan-2.6/reference-to-video --input-file input.json --wait. Dla klipu na twoim komputerzespicyapi files upload ./mechanic.mp4zwraca adresspicy://, którego użyjesz wreference_video_urls. Zobacz dokumentację CLI. - MCP server. Dodaj serwer MCP do swojego asystenta, a potem zapytaj: "Cast the person in /path/to/mechanic.mp4 into a dawn produce market on Wan 2.6 reference-to-video, 5 seconds, 720p." Wysyła plik przez
spicyapi_upload_file, a następnie wywołujespicyapi_task_create, które zatrzymuje się na twoim potwierdzeniu ceny. - Skill.
npx skills add spicyapi-ai/spicy-skillinstaluje Agent Skill, dzięki któremu asystent programistyczny czyta bieżący schemat modelu zamiast zgadywać nazwy pól.
Zaplanuj budżet na sekundy referencyjne
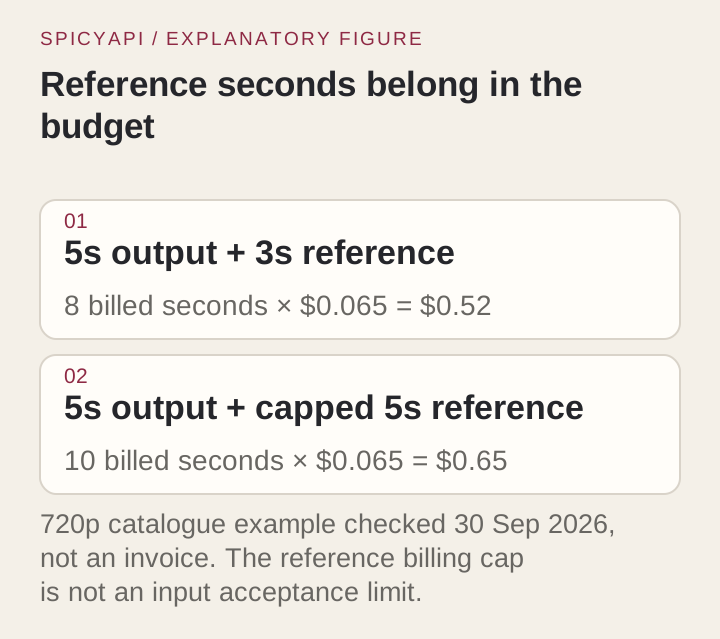
Rozliczane sekundy to długość wyniku plus długość klipów referencyjnych, przy czym każdy klip zaokrąglany jest w górę do pełnej sekundy, a łącznie liczy się najwyżej pięć sekund referencyjnych. Render trwający 5 sekund z jednym klipem 3-sekundowym rozlicza 8 sekund; ten sam render z trzema klipami o łącznej długości dziewięciu sekund rozlicza 10 sekund. Szacunek na żywo przed wysłaniem pokazuje kwotę. Jeśli długości klipu nie da się odczytać z góry, blokada zakłada pięć sekund referencyjnych, a ostateczne obciążenie używa zmierzonej długości.
| Długość wyniku | 720p, 3 s referencji | 720p, 5 s lub więcej | 1080p, 3 s referencji | 1080p, 5 s lub więcej |
|---|---|---|---|---|
| 2 s | 0,325 $ | 0,455 $ | 0,4875 $ | 0,6825 $ |
| 5 s | 0,52 $ | 0,65 $ | 0,78 $ | 0,975 $ |
| 10 s | 0,845 $ | 0,975 $ | 1,2675 $ | 1,4625 $ |
Ceny to obowiązujące stawki katalogowe w chwili pisania. Krótsza i czystsza referencja to najtańsza oszczędność: usuwa rozliczane sekundy i daje modelowi wyraźniejszą postać, a ponowienie kosztuje całe uruchomienie.
Sprawdź wynik i popraw go
Oceniaj osobno osobę i obiekt, bo jedno może się utrzymać, a drugie zawieść. W przypadku osoby: twarz i strój pozostają takie same podczas obrotów i po każdym cięciu, a żadna dodatkowa osoba nie zastępuje bohatera. W przypadku obiektu: zachowany musi być kształt, a nie tylko kolor (skrzynia cargo, liczba kół), bo zwykły rower też bywa turkusowy. Szukaj też elementów otoczenia przeniesionych z klipu, takich jak drzwi warsztatu czy stojak z narzędziami.
| Co widzisz | Spróbuj |
|---|---|
| Zła osoba albo dwie postacie zlane w jedną | Jedna postać na klip; w prompcie nazwij każdą postać jako character1, character2 i tak dalej; daj każdej własne miejsce i własne działanie |
| Rower zmienia się w inny rower | Użyj klipu pokazującego skrzynię i ramę; uprość ruch kamery, bo orbita każe modelowi wymyślać niewidoczne powierzchnie |
| Przebija stare otoczenie | Przytnij klip do bohatera, najpierw opisz nowe otoczenie, dodaj przeniesiony element do negative_prompt |
| Pierwsza sekunda jest dobra, a końcówka się rozjeżdża | Skróć czas trwania lub akcję; niech porusza się albo kamera, albo bohater, nie oba naraz |
| Tożsamość zmienia się po cięciu | Uruchom ponownie jako single albo uprość drugie ujęcie |
| Dłonie lub drobne rekwizyty się deformują | Nie pokazuj ich w zbliżeniach; to cecha linii Wan, a nie twoich klipów |
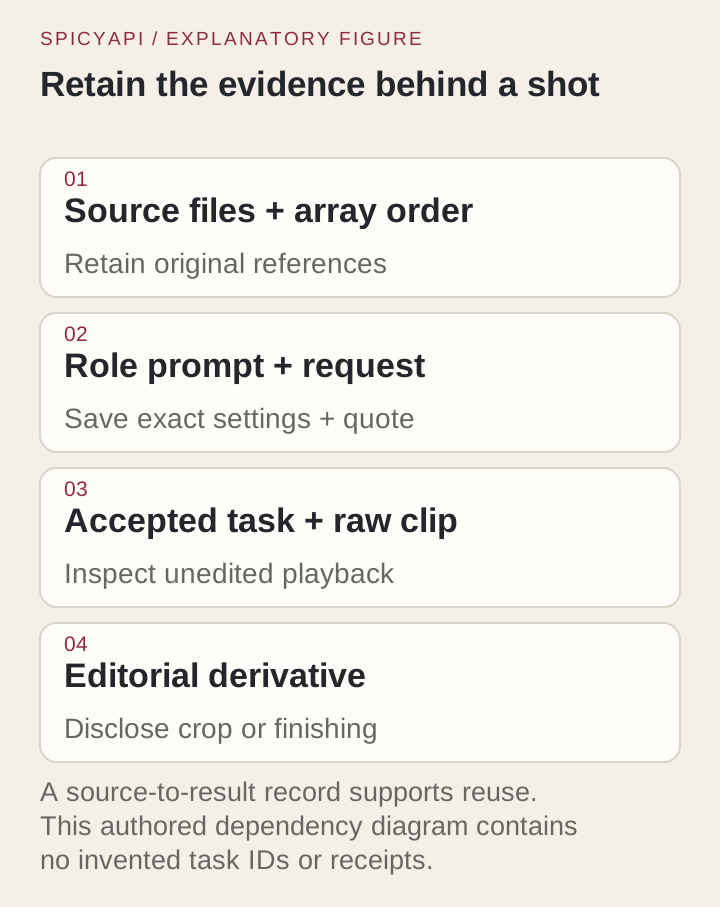
Jeśli dwie lub trzy poprawki nie ustabilizują bohatera, zmień zadanie zamiast go wymuszać: złożony obraz z image-to-video albo jeden z modeli poniżej. Przy ujęciu, które będziesz powtarzać, trzymaj razem klipy, pełne żądanie i niezmontowany wynik.
Poziom treści i zgoda
Wan 2.6 image-to-video i text-to-video są Uncensored, ale reference-to-video jest Filtered. Według naszych testów z września 2026 jawny klip referencyjny został odrzucony, więc obsada dla dorosłych należy do innego zadania; zobacz które wersje Wan są uncensored. Obsada z referencji przenosi rozpoznawalną twarz do sceny, która nigdy się nie wydarzyła, więc używaj postaci fikcyjnych albo materiału z osobami, które się na to zgodziły, i oznaczaj wygenerowane wyniki jako wygenerowane tam, gdzie odbiorca mógłby wziąć je za nagranie.
Szybszy poziom: Wan 2.6 Flash reference-to-video
Od 14 października Wan 2.6 Flash reference-to-video daje tę samą obsadę na szybszym, tańszym poziomie Flash w Wan 2.6, z trzema różnicami, które zmieniają to, co wysyłasz:
- Więcej zdjęć.
reference_image_urlsprzyjmuje do pięciu obrazów zamiast dwóch, obok maksymalnie trzech klipów wreference_video_urls, razem pięć referencji. Obrazy nie są rozliczane w żadnym z tych zadań; klipy dodają swoje sekundy, jak opisano wyżej, w sumie do pięciu. - Dźwięk to przełącznik.
generate_audiojest domyślnie wyłączone i zwraca sam obraz, za 0,0225 $ za sekundę w 720p lub 0,03375 $ w 1080p. Po włączeniu dodaje generowane głosy, efekty i tło za 0,045 $ lub 0,0675 $. Zadanie z tej strony zawsze zwraca dźwięk, za 0,065 $ za sekundę w 720p. - Jest Uncensored. W naszych testach z 14 października żądania z referencjami dla dorosłych wracały zgodnie z prośbą, bez żadnej odmowy.
Nazywaj referencje w prompcie character1, character2 i tak dalej, najpierw klipy, potem zdjęcia; wywołanie to alibaba/wan-2.6-flash/reference-to-video. Flash oddaje trochę drobnych detali za krótszy czas oczekiwania, więc pasuje do szkiców obsady, dużych serii i scen dla dorosłych. Zostań przy tym zadaniu, gdy jedno ujęcie ma udźwignąć drobniejszą fakturę pełnego poziomu Wan 2.6.
Kiedy lepszy jest inny model
| Czego potrzebujesz | Użyj |
|---|---|
| Obrazu wyznaczającego pierwszą klatkę, 5, 10 lub 15 s | Wan 2.6 image-to-video, 0,09 $ za sekundę w 720p, Uncensored |
| Więcej obrazów, dźwięk jako referencja, więcej klipów, do 30 s | Wan 3.0 reference-to-video: do dziesięciu obrazów, pięciu klipów i pięciu ścieżek audio, 0,09 $ za sekundę w 720p, Uncensored; jego kontrola twarzy może odrzucić zdjęcia prawdziwych osób, więc używaj klipów albo wygenerowanych postaci; przewodnik po Wan 3.0 opisuje te trzy zadania |
| Obrazów, klipów i dźwięku razem | Seedance 2.0 reference-to-video: do dziewięciu obrazów, trzech klipów i trzech ścieżek audio, od 0,043 $ za sekundę w 480p, Uncensored; wersje Fast i Mini są jeszcze tańsze |
Zostań przy Wan 2.6 reference-to-video, gdy twoje referencje to najwyżej trzy klipy i dwa obrazy i chcesz najtańszej obsady w Wan 720p (0,065 $ za sekundę wobec 0,09 $ w Wan 3.0) z opcjonalnymi cięciami multi-shot. Przytnij klipy, nazwij każdy w prompcie, przetestuj w 720p w jednym ujęciu i otwórz zadanie reference-to-video, aby sprawdzić aktualną cenę dla swoich klipów, zanim uruchomisz.