Introduzione
L’API MiniMax H3 X combina una versione ottimizzata di H3 con controllo dei fotogrammi e riferimenti multimodali, da $0.022/s su SpicyAPI; non è una versione ufficiale di MiniMax.
Una scena H3 X accetta fino a 9 immagini, 2 video per 15 secondi complessivi e 3 clip audio; assegna i ruoli con Image 1, Video 1 e Audio 1. Per una scena prodotto H3 X assegna immagini diverse a interprete, abito e ambiente, poi descrivi come interagiscono.
Per una sequenza H3 X scegli da 2 a 15 secondi interi; il valore iniziale è 5 e l’uscita è a 24 fps. H3 X offre 480p, 720p predefinito e 1080p; i ritagli SpicyAPI non hanno mostrato un aumento visibile dei dettagli nel file 1920 x 1088. Per testo e riferimenti H3 X offre 16:9 predefinito, 9:16, 1:1, 4:3, 3:4 e 21:9; con un’immagine iniziale le proporzioni seguono invece il fotogramma. H3 X restituisce H.264 MP4 con stereo AAC; scrivi le battute tra virgolette doppie e descrivi separatamente i suoni dell’ambiente.
I tre endpoint H3 X sono classificati come video NSFW senza censura; SpicyAPI non ha registrato rifiuti, ma alcuni risultati da testo o fotogramma iniziale hanno attenuato la richiesta. Per H3 X ottieni il consenso delle persone di cui usi aspetto o voce e rappresenta soltanto adulti.
In H3 X l’ordine determina Image 1 fino a Image 9; separa identità, abiti e ambiente, considerando che solo le prime 5 immagini rientrano nel costo base. H3 X può riprendere il movimento da un massimo di 2 video per 15 secondi complessivi; la loro durata si fattura come quella dell’uscita. Fino a 3 riferimenti audio possono guidare la voce H3 X; il file fornisce il timbro, il prompt fornisce le parole e il riferimento audio non ha supplementi. H3 X si fattura per secondi prodotti e risoluzione; si aggiungono i secondi dei video di riferimento, 5 immagini sono incluse, le successive sono a pagamento e l’audio di riferimento è gratuito.
Nei test H3 X con riferimenti di SpicyAPI sono state realizzate 5 richieste su 5 con soggetti maschili; la categoria di prova Very strong è stata raggiunta in 6 casi su 8.
| Campo | Valore |
|---|---|
| Input | Testo |
| Output | Video |
| Produttore | SpicyAPI / MiniMax H3 X |
| Modello | MiniMax H3 X |
| Uscita | 26 ottobre 2026 |
| Endpoint | MiniMax H3 X — Da testo / Da immagine / Da riferimenti |
| Durata | Per una sequenza H3 X scegli da 2 a 15 secondi interi; il valore iniziale è 5 e l’uscita è a 24 fps. |
| Risoluzione | 480p, 720p (predefinito), 1080p |
| Proporzioni | Per testo e riferimenti H3 X offre 16:9 predefinito, 9:16, 1:1, 4:3, 3:4 e 21:9; con un’immagine iniziale le proporzioni seguono invece il fotogramma. |
| Lunghezza del prompt | Da 1 a 7.000 caratteri |
| Riferimenti | Una scena H3 X accetta fino a 9 immagini, 2 video per 15 secondi complessivi e 3 clip audio; assegna i ruoli con Image 1, Video 1 e Audio 1. |
| Policy sui contenuti | I tre endpoint H3 X sono classificati come video NSFW senza censura; SpicyAPI non ha registrato rifiuti, ma alcuni risultati da testo o fotogramma iniziale hanno attenuato la richiesta. |
| Esecuzione | H3 X si fattura per secondi prodotti e risoluzione; si aggiungono i secondi dei video di riferimento, 5 immagini sono incluse, le successive sono a pagamento e l’audio di riferimento è gratuito. |
Caratteristiche principali
Una battuta sotto la pioggia
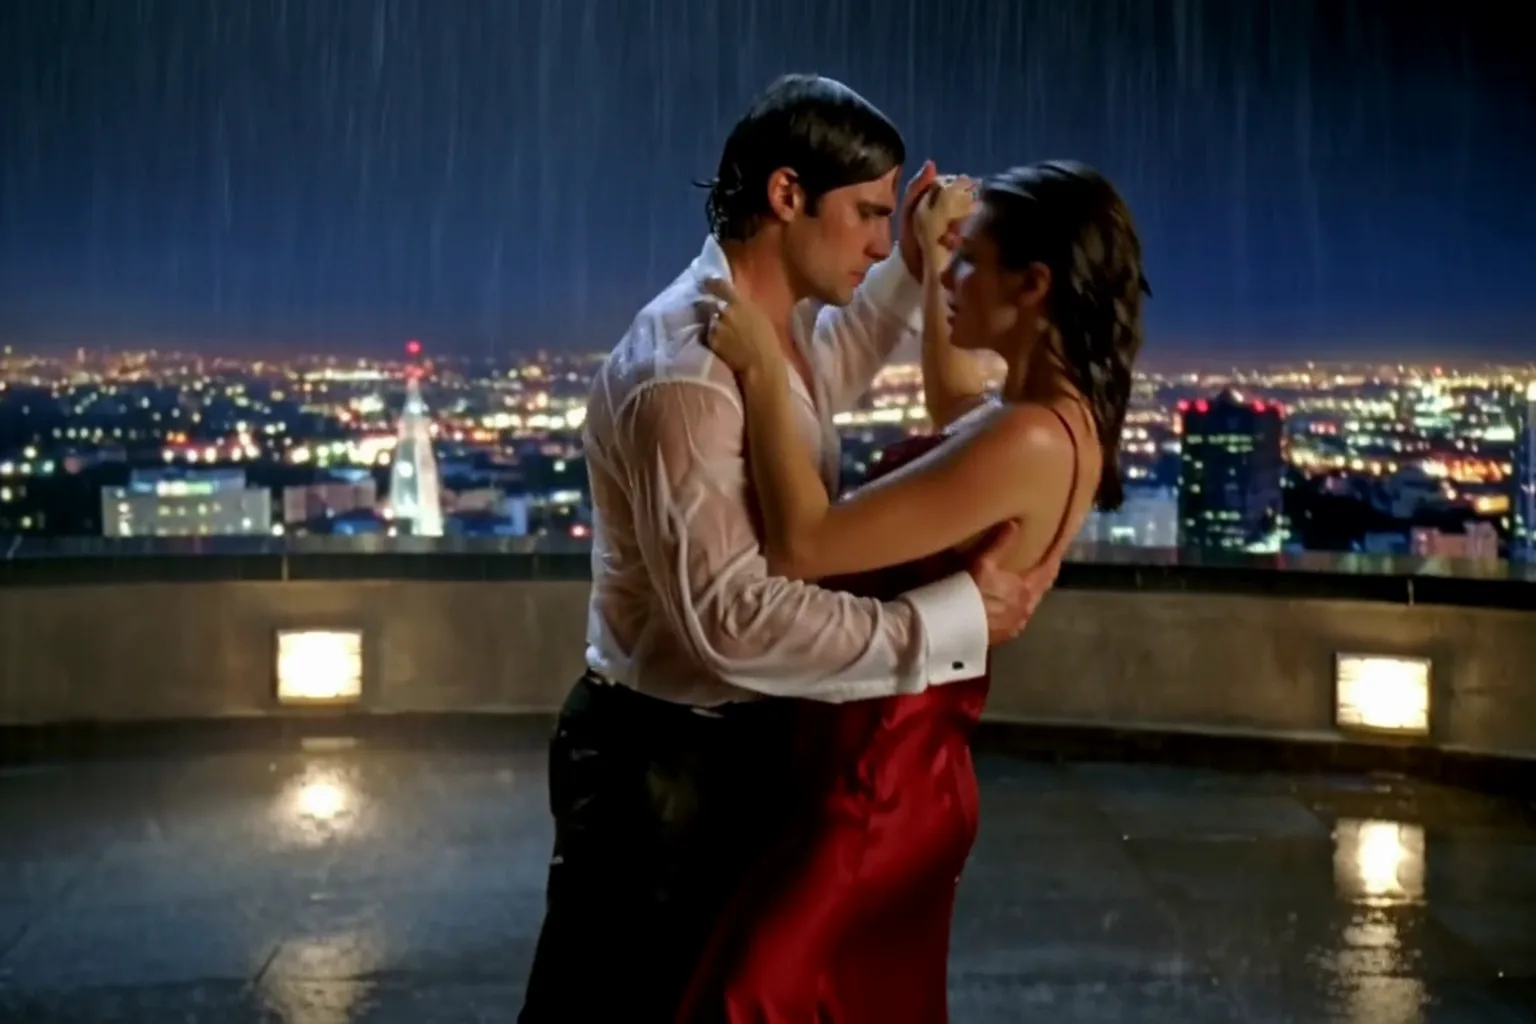
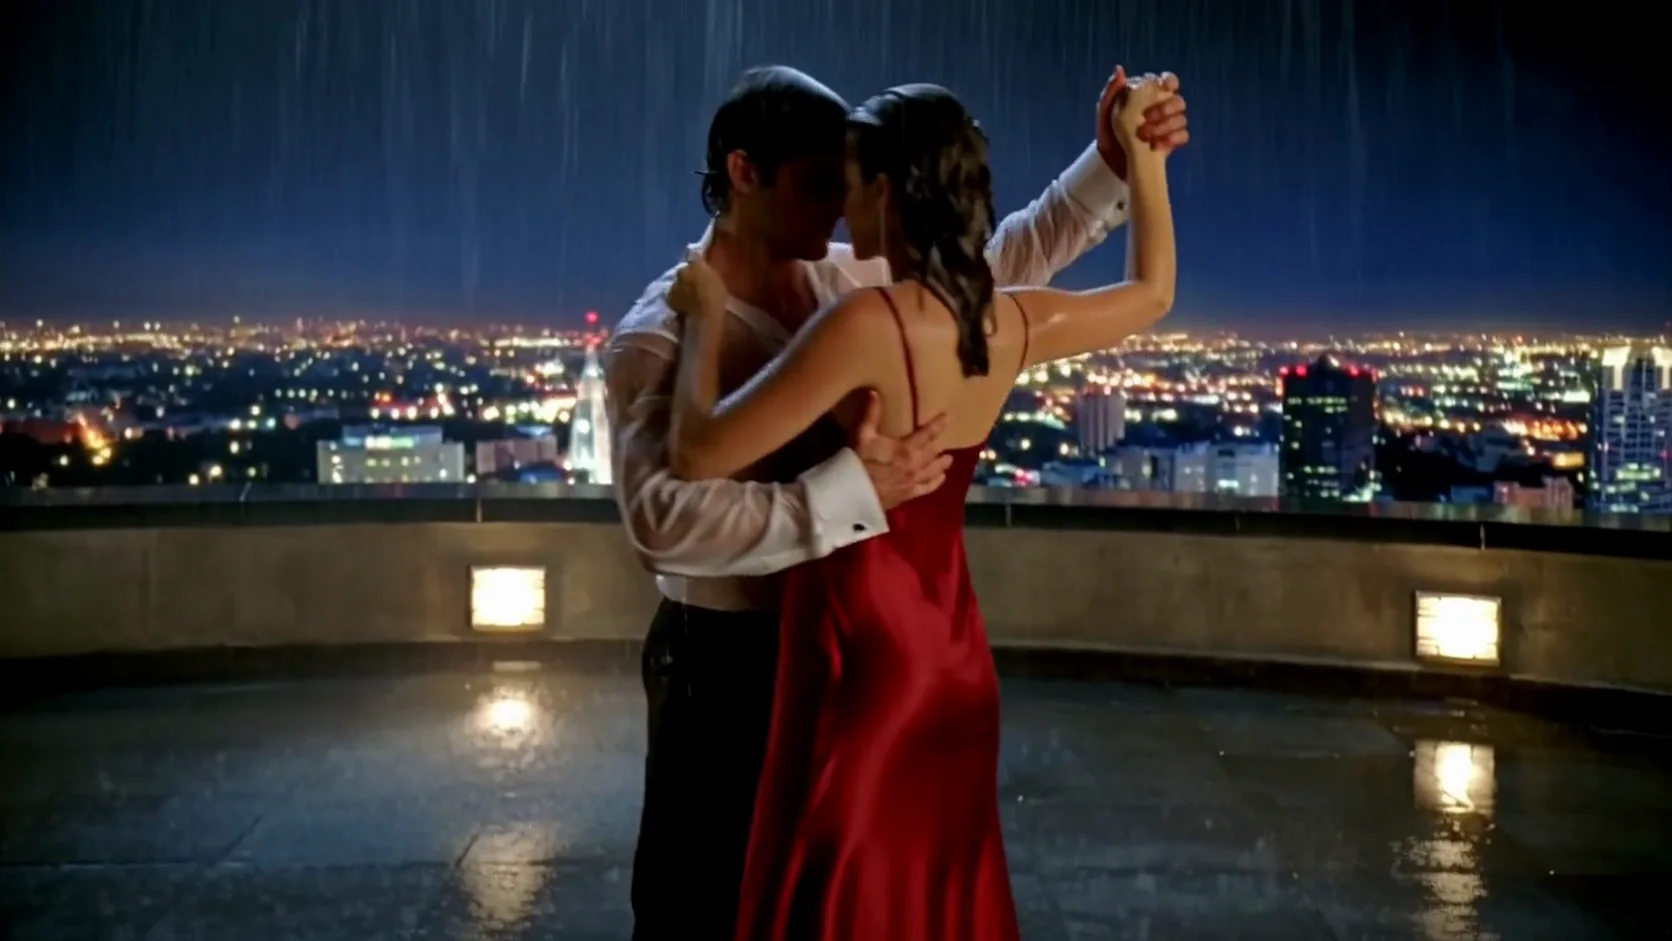
Una coppia balla un tango lento su un tetto sferzato dalla pioggia. Lui la inclina all’indietro e, in primo piano, lei lo tira su per il colletto della camicia e dice "Not yet." Il prompt elenca anche la pioggia, il traffico e il bandoneon. Nella clip la battuta si sente su una musica lenta e malinconica. Le battute tra virgolette sono state pronunciate parola per parola nei nostri controlli con riconoscimento vocale.
Tre inquadrature in una clip da 12 secondi
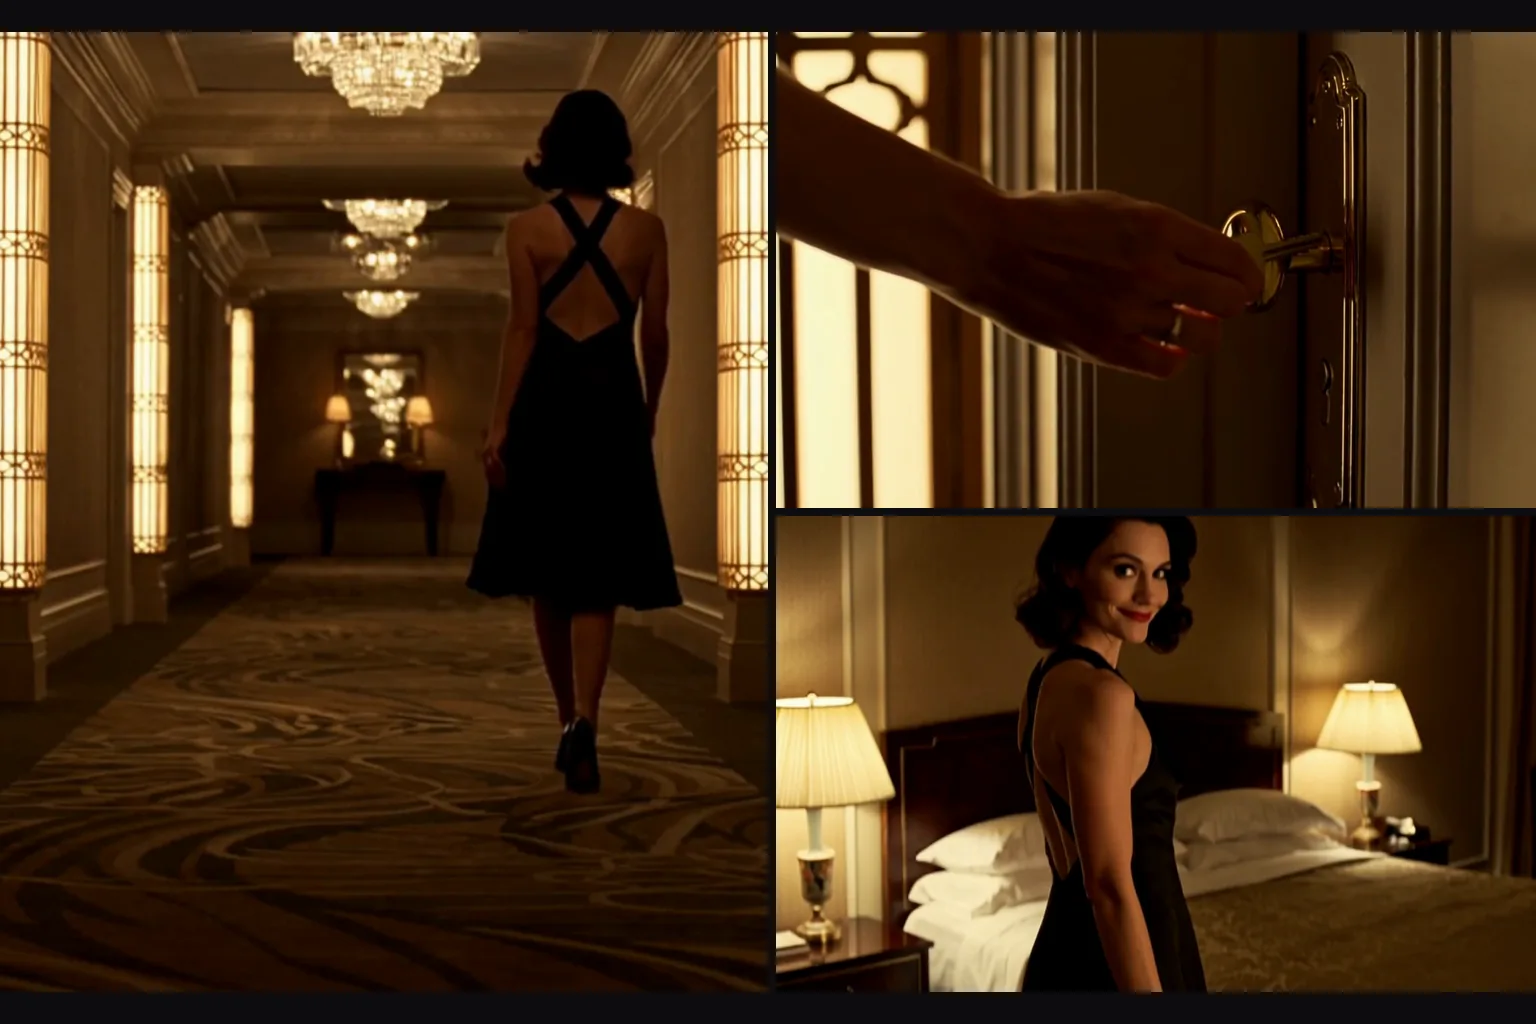
Un solo prompt elenca tre inquadrature con i tempi di inizio: una camminata in un corridoio in campo lungo, una mano che gira una chiave nella serratura ai 4 secondi e un piano medio nella stanza agli 8 secondi. Nella clip i tagli sono caduti intorno ai 3,9 e agli 8,3 secondi, con la stessa donna dall’inizio alla fine.
Un fotogramma che sussurra
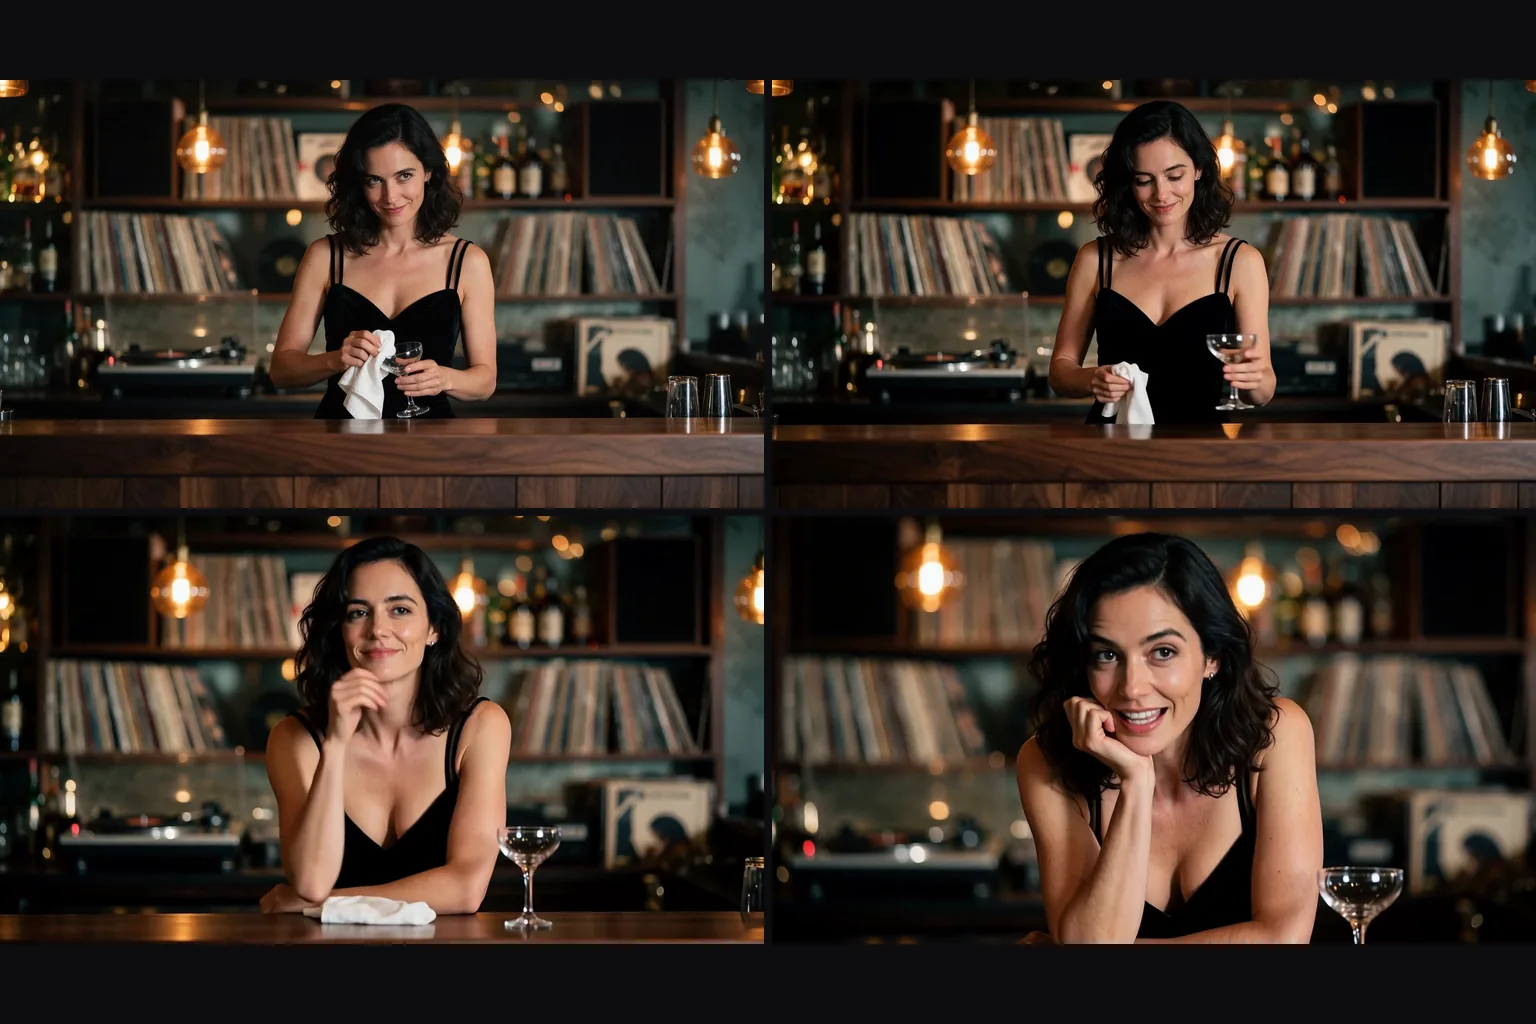
Una donna dai capelli scuri e ondulati, con un abito di velluto nero dietro un bancone di noce, entra come fotogramma iniziale. Il prompt dice solo cosa segue: posa il bicchiere, si china verso la camera e dice "Last call." La clip ha una musica piano sotto la battuta.
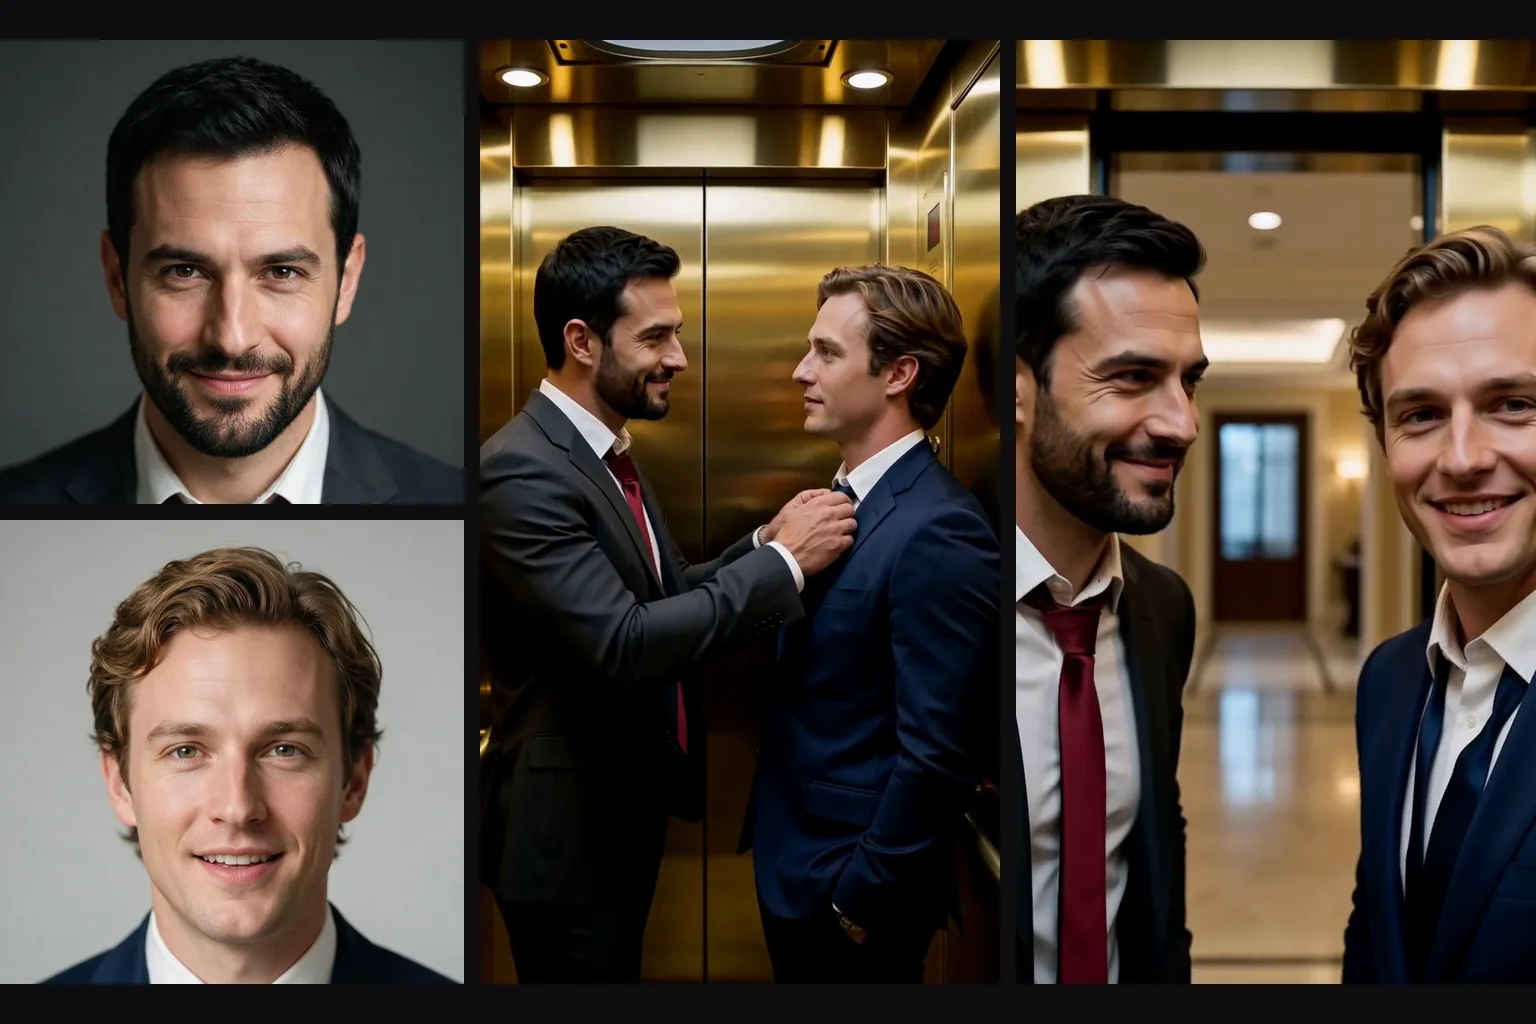
Tre riferimenti, una scena
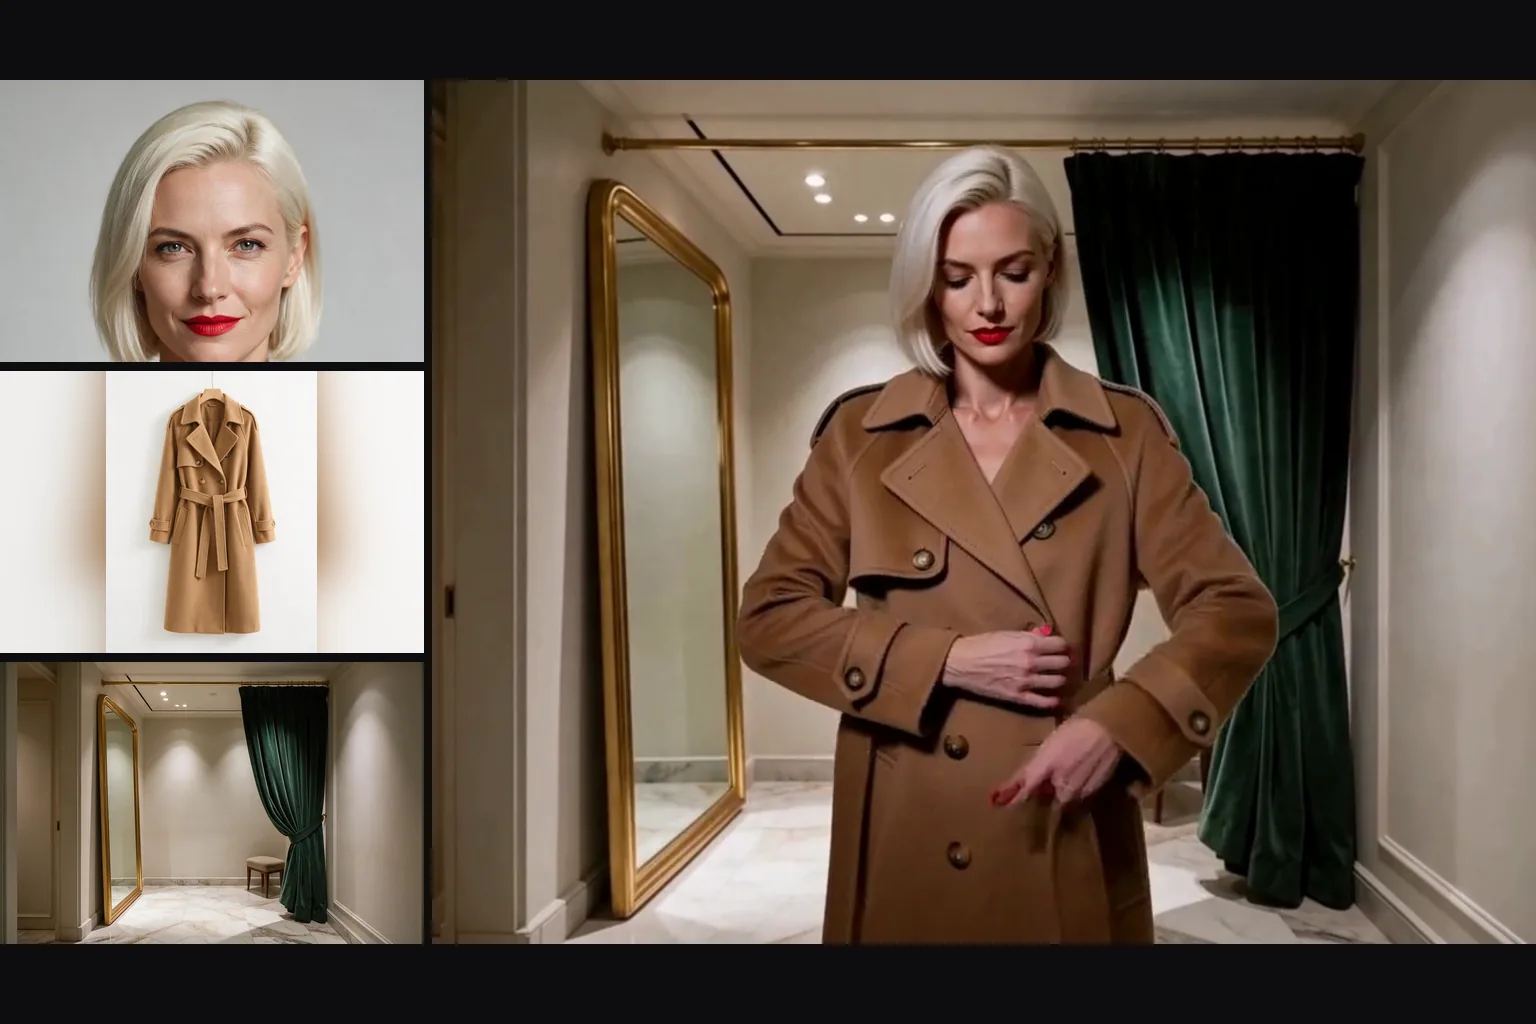
Un ritratto, la foto di prodotto di un trench e un camerino vuoto entrano come Image 1, 2 e 3. Il prompt li chiama per posizione e chiede un’unica scena con tutti e tre. Nella clip il volto, l’outfit, il cappotto e la stanza corrispondono ai riferimenti.
Parametri della richiesta
| Parametro | Obbligatorio | Nota |
|---|---|---|
prompt | Sì | H3 X richiede un prompt da 1 a 7.000 caratteri per azione, camera e suono; metti le battute tra virgolette doppie. almeno 1 caratteri · al massimo 7000 caratteri |
reference_image_urls | No | In H3 X l’ordine determina Image 1 fino a Image 9; separa identità, abiti e ambiente, considerando che solo le prime 5 immagini rientrano nel costo base. almeno 1 elementi · al massimo 9 elementi |
reference_video_urls | No | H3 X può riprendere il movimento da un massimo di 2 video per 15 secondi complessivi; la loro durata si fattura come quella dell’uscita. almeno 1 elementi · al massimo 2 elementi |
reference_audio_urls | No | Fino a 3 riferimenti audio possono guidare la voce H3 X; il file fornisce il timbro, il prompt fornisce le parole e il riferimento audio non ha supplementi. almeno 1 elementi · al massimo 3 elementi |
aspect_ratio | No | Per testo e riferimenti H3 X offre 16:9 predefinito, 9:16, 1:1, 4:3, 3:4 e 21:9; con un’immagine iniziale le proporzioni seguono invece il fotogramma. |
resolution | No | H3 X offre 480p, 720p predefinito e 1080p; i ritagli SpicyAPI non hanno mostrato un aumento visibile dei dettagli nel file 1920 x 1088. |
duration_seconds | No | Per una sequenza H3 X scegli da 2 a 15 secondi interi; il valore iniziale è 5 e l’uscita è a 24 fps. |
enable_prompt_expansion | No | L’espansione del prompt H3 X parte disattivata; attivandola, le istruzioni vengono riscritte prima della generazione senza cambiare il prezzo. Predefinito: |
Prezzi
H3 X si fattura per secondi prodotti e risoluzione; si aggiungono i secondi dei video di riferimento, 5 immagini sono incluse, le successive sono a pagamento e l’audio di riferimento è gratuito.
| Specifiche | Prezzo |
|---|---|
| $0.022 / secondo |
| $0.032 / secondo |
| $0.045 / secondo |
Casi d’uso
Scene di dialogo
Un’inquadratura parlata H3 X può associare un giro verso la camera a una breve battuta citata e al suono dell’ambiente.
Sequenze con più inquadrature
Per H3 X assegna un intervallo a ogni inquadratura e ripeti la descrizione del personaggio quando cambia l’angolo della camera.
Film di moda, prodotto e location
Per una scena prodotto H3 X assegna immagini diverse a interprete, abito e ambiente, poi descrivi come interagiscono.
Copia del movimento
H3 X può riprendere il movimento da un massimo di 2 video per 15 secondi complessivi; la loro durata si fattura come quella dell’uscita.
App senza filtro dei contenuti
Per H3 X ottieni il consenso delle persone di cui usi aspetto o voce e rappresenta soltanto adulti.
Consigli avanzati
Metti le battute tra virgolette doppie
Un’inquadratura parlata H3 X può associare un giro verso la camera a una breve battuta citata e al suono dell’ambiente.
Dai i tempi alle inquadrature
Per H3 X assegna un intervallo a ogni inquadratura e ripeti la descrizione del personaggio quando cambia l’angolo della camera.
Indica i riferimenti per tipo e posizione
Una scena H3 X accetta fino a 9 immagini, 2 video per 15 secondi complessivi e 3 clip audio; assegna i ruoli con Image 1, Video 1 e Audio 1.
Limiti osservati
Per H3 X ottieni il consenso delle persone di cui usi aspetto o voce e rappresenta soltanto adulti.
Direzione della scena
In una scena H3 X da immagine dedica il prompt al gesto, movimento di camera o risposta che segue il fotogramma fornito.
MiniMax H3 X
L’API MiniMax H3 X combina una versione ottimizzata di H3 con controllo dei fotogrammi e riferimenti multimodali, da $0.022/s su SpicyAPI; non è una versione ufficiale di MiniMax.
Direzione della scena
Una scena H3 X accetta fino a 9 immagini, 2 video per 15 secondi complessivi e 3 clip audio; assegna i ruoli con Image 1, Video 1 e Audio 1. Per una scena prodotto H3 X assegna immagini diverse a interprete, abito e ambiente, poi descrivi come interagiscono. Un’inquadratura parlata H3 X può associare un giro verso la camera a una breve battuta citata e al suono dell’ambiente.
Uscita e audio
Per una sequenza H3 X scegli da 2 a 15 secondi interi; il valore iniziale è 5 e l’uscita è a 24 fps. H3 X offre 480p, 720p predefinito e 1080p; i ritagli SpicyAPI non hanno mostrato un aumento visibile dei dettagli nel file 1920 x 1088. H3 X restituisce H.264 MP4 con stereo AAC; scrivi le battute tra virgolette doppie e descrivi separatamente i suoni dell’ambiente.
Fatturazione
H3 X si fattura per secondi prodotti e risoluzione; si aggiungono i secondi dei video di riferimento, 5 immagini sono incluse, le successive sono a pagamento e l’audio di riferimento è gratuito.
Limiti osservati
I tre endpoint H3 X sono classificati come video NSFW senza censura; SpicyAPI non ha registrato rifiuti, ma alcuni risultati da testo o fotogramma iniziale hanno attenuato la richiesta. Per H3 X ottieni il consenso delle persone di cui usi aspetto o voce e rappresenta soltanto adulti.
| solo un’idea | MiniMax H3 X Text to video | | un fotogramma da animare, con un fotogramma finale facoltativo | MiniMax H3 X Image to video | | persone, abiti, luoghi, clip di movimento o voci | MiniMax H3 X Reference to video |
Nei test H3 X con riferimenti di SpicyAPI sono state realizzate 5 richieste su 5 con soggetti maschili; la categoria di prova Very strong è stata raggiunta in 6 casi su 8.
Avvio rapido dell’API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "minimax/h3-x/reference-to-video",
  "input": {
    "aspect_ratio": "16:9",
    "duration_seconds": 5,
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "resolution": "720p",
    "reference_image_urls": [
      "https://example.com/reference.png"
    ]
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Nel riferimento dell’API trovi autenticazione, schema completo, polling e gestione degli errori.