Przejdź do treści głównej

daVinci-MagiHuman API

sand-ai/davinci-magihuman/image-to-video

Obraz na wideo daVinci-MagiHuman ożywia twoje zdjęcie w klip 5-10 sekund, nadając mu ruch i głos: zapisz kwestię w cudzysłowie w prompcie albo dołącz własne audio. 256p, 720p albo 1080p, 16:9 lub 9:16.

Od $0.024/s

Obszar roboczy

Wejście

Obraz na wideo
211/5000
Wymagany. Opisz, co dzieje się po zdjęciu: co robi osoba i, w cudzysłowie, co mówi. Gdy ustawiasz audio_url, pomiń słowa i opisz nastrój, ruch i światło. od 3 znaków · do 5000 znaków
1/1

Upuść pliki albo odnośniki do mediów, wklej lub wybierz z dysku · 1 plik · maks. 10 MB · JPG · PNG · WEBP

  • 1
1 / 1 plików
Pierwsza klatka. Publiczny link, z którego da się pobrać plik bezpośrednio; klip zaczyna się od tego zdjęcia.
0/1

Upuść tutaj plik dźwiękowy albo wybierz z dysku · 1 plik · maks. 90 MB · MP3 · WAV

0 / 1 plików
Opcjonalnie. Publiczny link do pliku z mową albo piosenką; wideo powstaje w synchronizacji z nim zamiast wymyślania głosu. W naszym przebiegu użyliśmy 5-sekundowego nagrania do 5-sekundowego klipu.
16:9 (domyślnie) albo 9:16. Nasze przebiegi obraz na wideo używały 16:9. Kształt nie zmienia ceny.
wpływa na cenę
256p, 720p (domyślnie) albo 1080p. Wyższe poziomy kosztują więcej za sekundę. Model renderuje w małej rozdzielczości, a jego własny etap super-rozdzielczości tworzy wyższe poziomy; nasze przebiegi w 720p wyszły około 1358 x 678.
Czas trwaniawpływa na cenę
5-10 sekund, domyślnie 5, rozliczane za sekundę. nie mniej niż 5 · nie więcej niż 10
Seed
Opcjonalna liczba całkowita. Ten sam seed przy tych samych danych wejściowych daje wyniki podobne, a nie gwarantowane identyczne. nie mniej niż 0 · nie więcej niż 2147483647
Filtr bezpieczeństwaWyłączony

SpicyAPI nie uruchamia przy tym modelu żadnego filtra bezpieczeństwa. Twój prompt i media trafiają do modelu w takiej postaci, w jakiej je zapisałeś, a o tym, co wraca, decyduje sam model.

Sprawdzamy twoje konto, zanim odblokujemy wysyłkę i wycenę.

Wyjście

Gotowe do nowego uruchomienia
Wynik przykładowy

Brakuje modelu, którego potrzebujesz?

Napisz, co dodać i do czego chcesz tego użyć. Zgłoszenia trafiają do osób, które decydują o kolejności wdrożeń.

API WIDEO Z MÓWIĄCĄ OSOBĄ

API daVinci-MagiHuman w skrócie

Jeden model o 15 mld parametrów, który generuje obraz i głos razem: osoba mówiąca do kamery, z tekstu albo ze zdjęcia, 5-10 sekund w rozdzielczości do 1080p.

Parametry
15 mld
Jeden model generuje obraz i ścieżkę dźwiękową razem. Wagi są otwarte na licencji Apache 2.0.
Długość klipu
5-10 s
Wybierz długość od 5 do 10 sekund; domyślnie 5. Nasze klipy miały 25 fps.
Maks. rozdzielczość
1080p
256p, 720p (domyślnie) albo 1080p. Model renderuje w małej rozdzielczości, a jego własny etap super-rozdzielczości tworzy wyższe poziomy; rozmiary wychodzą blisko nominalnych, np. około 1904 x 1088 w 1080p.
Kształty kadru
2
Poziomo 16:9 (domyślnie) albo pionowo 9:16, w obu endpointach. Dźwięk i kształt nie zmieniają ceny.
Własne audio
Opcja
Wyślij plik z mową albo piosenką jako audio_url, a wideo powstanie w synchronizacji z nim, zamiast wymyślać głos.
Języki mowy
6
Chiński (mandaryński i kantoński), angielski, japoński, koreański, niemiecki i francuski, według listy wydawcy. Testowaliśmy angielski.

Efekty

Co możesz stworzyć z daVinci-MagiHuman

  • Tekst na wideo

    Kwestia wypowiedziana na balkonie

    Jeden prompt z kwestią w cudzysłowie dał klip 1080p: kobieta z platynowym bobem na nocnym balkonie, światła miasta rozmyte za nią. Wyszedł około 1904 x 1088 przy 25 fps, 5,0 sekundy, z dźwiękiem, a transkrypcja ścieżki dźwiękowej zgadzała się z kwestią słowo w słowo. Przetwarzanie zajęło około 3 min 53 s.

    Tekst na wideo, 1080p, 16:9, pięć sekund, z kwestią w cudzysłowie wypowiedzianą na ścieżce dźwiękowej.

  • Portret

    Pionowy klip ze śmiechem i kwestią

    Przy kształcie 9:16 piegowaty mężczyzna o rudych włosach na mokrej, neonowej ulicy śmieje się i wypowiada swoją kwestię. W 720p wyszło około 726 x 1270, 5,0 sekundy, a transkrypcja zgadzała się słowo w słowo. Przetwarzanie zajęło około minuty. Zamiast prosić o selfie, napisaliśmy „looks straight into the camera”.

    Tekst na wideo w pionie, 9:16 w 720p, pięć sekund, z kwestią w cudzysłowie wypowiedzianą na ścieżce dźwiękowej.

  • Obraz na wideo

    Zdjęcie, które się odwraca i mówi

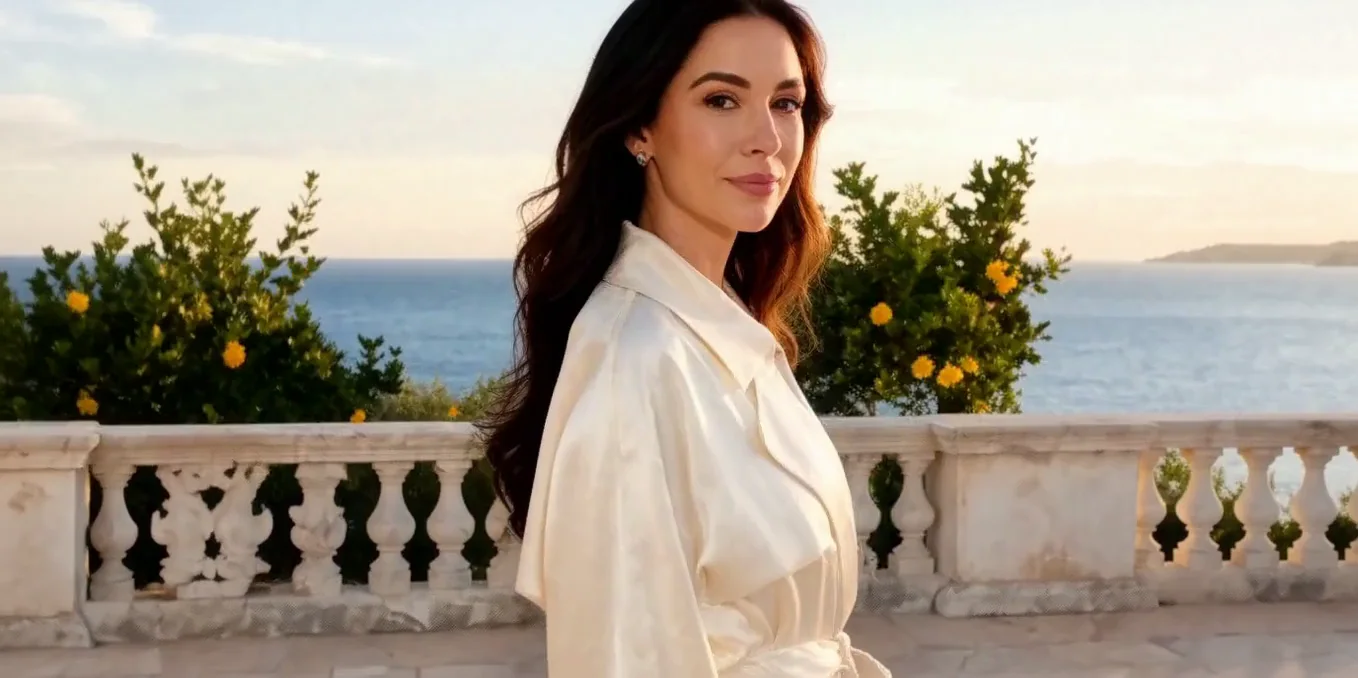
    Z pierwszej klatki i promptu, bez pliku audio, ona odwraca się od morza, zakłada włosy za ucho i wypowiada kwestię. Transkrypcja zgadzała się słowo w słowo. W 720p wyszło około 1358 x 678, 5,0 sekundy, po około 1 min 45 s.

    Obraz na wideo bez pliku audio, 16:9 w 720p, pięć sekund, z kwestią w cudzysłowie wypowiedzianą na ścieżce dźwiękowej.

  • Własne audio

    Portret, który podąża za twoim nagraniem

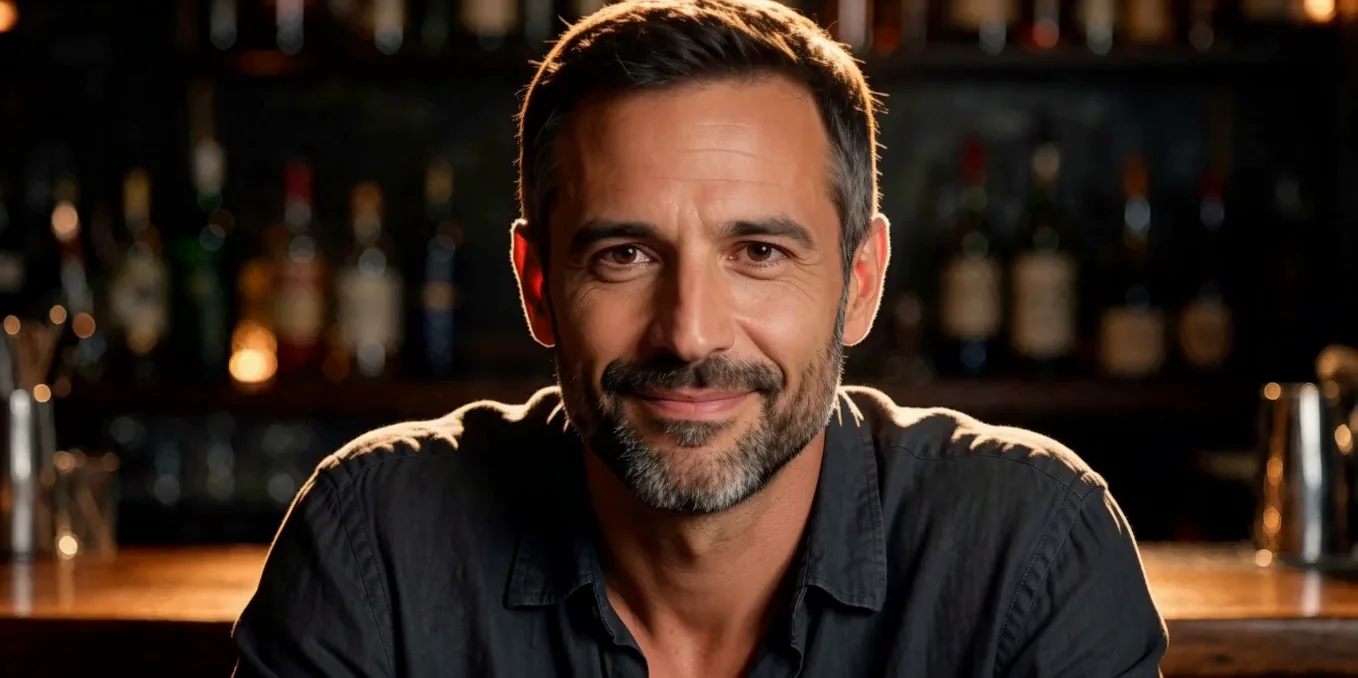
    Z 5-sekundowym nagraniem mowy jako audio_url usta podążały za dostarczonym dźwiękiem, z półuśmiechem i ruchem brwi, a twarz została blisko portretu wejściowego. W 720p wyszło około 1358 x 678, 5,0 sekundy, po około 3 min 7 s.

    Obraz na wideo z 5-sekundowym nagraniem mowy jako audio_url, 16:9 w 720p, pięć sekund.

Zanim uruchomisz

Co warto wiedzieć przed użyciem daVinci-MagiHuman

Wszystkie tryby
Klipy trwają 5-10 sekund, w 256p, 720p albo 1080p, w 16:9 lub 9:16. Rozmiary wychodzą blisko nominalnych, ale nie dokładnie: 720p w 16:9 dało około 1358 x 678, a 1080p około 1904 x 1088. Testowaliśmy mowę po angielsku i nie testowaliśmy śpiewu. Co może pokazywać klip, zależy od promptu i naszej polityki użycia.
Tekst na wideo
Osoba i scena pochodzą z twoich słów, więc opisz kadr; prośba o selfie z telefonem w jednym dodatkowym przebiegu umieściła telefon w kadrze. Na tym endpoincie nie uruchamialiśmy audio_url.
Obraz na wideo
Obraz pierwszej klatki jest wymagany, a klip zaczyna się od niego. Wszystkie nasze przebiegi obraz na wideo użyły 16:9. Z audio_url testowaliśmy 5-sekundowe nagranie przy 5-sekundowym klipie, a nie testowaliśmy nagrania krótszego lub dłuższego od klipu.

Zastosowania

Co zbudować z API daVinci-MagiHuman

  • Krótkie wypowiedzi w kadrze

    Osoba mówi jedną kwestię do kamery w ciągu 5-10 sekund: wstęp, zapowiedź albo powitanie, a głos zostanie wygenerowany za ciebie.

  • Pionowe klipy do telefonu

    Ustaw kształt na 9:16 do feedów i relacji. Nasz pionowy przebieg w 720p wyszedł około 726 x 1270.

  • Portret, który mówi twoim nagraniem

    Zacznij od zdjęcia i dodaj plik z mową jako audio_url; usta podążają za twoim dźwiękiem, a twarz zostaje blisko zdjęcia.

  • Testy postaci i dialogu

    Sprawdź, jak postać wygląda i brzmi na zdjęciu pierwszej klatki z krótką kwestią w cudzysłowie, zanim zbudujesz dłuższą całość. Testowaliśmy angielski; wydawca wymienia jeszcze pięć języków.

Prompty

Przykładowe prompty do daVinci-MagiHuman do skopiowania

Wklej jeden bez zmian do playgroundu, a potem zmieniaj jedną rzecz naraz.

  • Tekst na wideo

    Kto, gdzie, kwestia w cudzysłowie, potem światło

    Wynik tego promptu

    Close-up at night on a hotel balcony, city lights blurred behind. A woman in her thirties with a short platinum bob and a black slip dress leans on the rail, looks into the camera with a sly smile and says softly: "You really thought I'd leave without saying goodbye?" Warm practical light, shallow depth of field.

    Dlaczego to działa. Osoba i miejsce są na początku, kwestia stoi w cudzysłowie razem z tym, jak ma zostać powiedziana, a światło zamyka prompt. Nasza transkrypcja zgadzała się z kwestią słowo w słowo.

  • Tekst na wideo

    Powiedz, dokąd patrzą oczy

    Wynik tego promptu

    Vertical medium close-up on a rainy neon-lit street at night. A man in his late twenties with freckles, short ginger hair and a wet denim jacket looks straight into the camera, laughs and says: "Okay, I'm lost, but honestly? Best night of the trip." Rain drips from his hair, pink and blue sign reflections on the wet pavement behind him. Handheld, eye level.

    Dlaczego to działa. „Looks straight into the camera” ustawiło kadr. W dodatkowym przebiegu prośba o selfie z telefonem umieściła w kadrze telefon.

  • Obraz na wideo

    Daj zdjęciu następny moment

    Wynik tego promptu

    On a sunlit stone terrace above the sea, she turns from the view to the camera, tucks her hair behind her ear and says warmly: "Stay for one more sunset. The boat can wait." Gentle sea breeze, soft golden light.

    Dlaczego to działa. Prompt mówi, co ona robi po zdjęciu: odwraca się do kamery, zakłada włosy za ucho i mówi. Wszystkie trzy rzeczy się wydarzyły, a transkrypcja się zgadzała.

    Ten tryb zaczyna od Twojego obrazu: dodaj go w playgroundzie przed uruchomieniem.

  • Obraz na wideo

    Z własnym głosem reżyseruj wygląd

    Wynik tego promptu

    Leaning on the bar, he speaks low and teasing, a slow half smile and a raised eyebrow, warm amber light.

    Dlaczego to działa. Słowa pochodzą z przesłanego nagrania, więc prompt tylko ustawia nastrój, ruch i światło. Usta podążały za nagraniem, z półuśmiechem i ruchem brwi.

    Ten tryb zaczyna od Twojego obrazu: dodaj go w playgroundzie przed uruchomieniem.

Porównanie

daVinci-MagiHuman a podobne modele: który wybrać

ModelTrybyOdTreśćWybierz, gdy
OmniHuman 2.0Mówiący awatar$0.108 / sekundę wynikuFiltrowany — Ten model wprost odrzuca żądania wykraczające poza jego własne granice. To wynik zmierzony, a nie przypuszczenie – modele, których nie zmierzyliśmy, nie mają żadnej etykiety.Masz już nagranie głosu i portret i chcesz dłuższego klipu, do 300 sekund, sterowanego tym dźwiękiem. Wybierz daVinci-MagiHuman, gdy chcesz, żeby model wypowiedział kwestię, którą napiszesz w cudzysłowie, albo potrzebujesz klipu 9:16.
Kling Avatar 2.0Mówiący awatar$0.051 / sekundę wynikuFiltrowany — Ten model wprost odrzuca żądania wykraczające poza jego własne granice. To wynik zmierzony, a nie przypuszczenie – modele, których nie zmierzyliśmy, nie mają żadnej etykiety.Masz portret i własne audio i chcesz klipu sterowanego tym dźwiękiem, czyli tego samego pomysłu co OmniHuman 2.0. Wybierz daVinci-MagiHuman, gdy chcesz, żeby model wypowiedział kwestię w cudzysłowie.

Cennik

Cennik API daVinci-MagiHuman

Klip trwający 5 s kosztuje od $0.12 w 256p i od $0.36 w 1080p.

Playground pokazuje dokładną cenę Twoich ustawień przed uruchomieniem. Nieudane zadania i zadania po upływie limitu czasu zwykle nie są płatne. Niektóre modele pobierają opłatę za odmowę wygenerowania treści zgodnie z opisem na stronie modelu; sprawdź te zasady przed wysłaniem.

Zobacz wszystkie progi cenowe

Pierwsze kroki

Jak korzystać z API daVinci-MagiHuman w trzech krokach

  1. Krok 1

    Wpisz kwestię w cudzysłowie

    Model mówi to, co jest w cudzysłowie. Napisz, kto mówi i jak (cicho, ciepło, śmiejąc się), a potem samą kwestię. Nasze trzy kwestie w cudzysłowie miały od 8 do 10 słów przy 5-sekundowym klipie, a każda została wypowiedziana słowo w słowo.

  2. Krok 2

    Opisz kadr, nie urządzenie

    W dodatkowym przebiegu 9:16 prośba o selfie z telefonem umieściła w kadrze telefon zwrócony do kamery, widziany od tyłu. Zamiast tego napisz „looks straight into the camera” i wielkość planu („vertical medium close-up”).

  3. Krok 3

    Przynieś własny głos przez audio_url

    Gdy dołączysz plik z mową albo piosenką, prompt nie musi zawierać słów. Opisz nastrój, ruch i światło, a usta podążą za nagraniem. W naszym przebiegu 5-sekundowe nagranie pasowało do 5-sekundowego klipu.

Opis parametrów i przykłady kodu znajdziesz w zakładkach API i Readme na górze tej strony.

Dlaczego SpicyAPI

Dlaczego korzystać z daVinci-MagiHuman w SpicyAPI

  • Żadnego filtra z naszej strony

    Nie dodajemy własnego filtra treści. Otrzymujesz to, co wygeneruje model.

  • Sprawdzone, nie zgadywane

    Poziomy treści pochodzą z prawdziwych generacji, które uruchomiliśmy i sprawdziliśmy, z datą testu na stronie.

  • Płacisz za wynik, w dolarach

    Bez abonamentu i bez systemu punktowego. Nieudane zadania i zadania po upływie limitu czasu zwykle nie są płatne. Niektóre modele pobierają opłatę za odmowę wygenerowania treści zgodnie z opisem na stronie modelu; sprawdź te zasady przed wysłaniem.

  • Jeden klucz do wszystkich modeli

    Jeden klucz API i jedno saldo obsługują modele obrazu, wideo, audio i czatu, dzięki czemu możesz poznawać kolejne modele na tym samym koncie.

FAQ

FAQ dotyczące API daVinci-MagiHuman

O daVinci-MagiHuman

daVinci-MagiHuman udostępnia otwarty model o 15 mld parametrów od Sand.ai i SII-GAIR w jednym API: tekst na wideo i obraz na wideo z obrazem i głosem generowanymi razem, 5-10 sekund w 256p, 720p albo 1080p, w 16:9 lub 9:16, z opcją własnego audio. Rozliczane jest za sekundę zamówionej długości, a nieudane żądania nie są obciążane opłatą.

Powiązane modele i kolejne zadania