Em 9 de outubro de 2026, a equipe Qwen da Alibaba lançou o Qwen-Image-2.1-Turbo com pesos abertos. Se você pesquisou "Qwen Image 2.1 Turbo" antes disso, provavelmente só encontrou acelerações da comunidade; esta vem do próprio Qwen.
Resposta curta: o Qwen Image 2.1 Turbo é o mesmo modelo Qwen Image 2.1 de 7B, acelerado para rodar em 8 passos de denoising em vez dos 40 usados nos exemplos oficiais do modelo base. Ele faz texto para imagem e edição de imagens em linguagem natural em 2K, e a Alibaba afirma que menos passos não significam menos qualidade. Na SpicyAPI, ele está no ar desde 13 de outubro de 2026 para texto para imagem e edição: de uma a seis imagens por requisição, com um preço único por imagem, mais baixo que o do Qwen Image 2.1. A API hospedada da própria Alibaba cobra CNY 0.10 por imagem, contra CNY 0.25 do Qwen Image 2.1 Pro.
A versão de 30 segundos
- O que é: um checkpoint acelerado do Qwen Image 2.1, com a mesma arquitetura de 7B, publicado pelo Qwen no Hugging Face e no ModelScope. Não é um LoRA nem um modelo diferente.
- O que muda: 8 passos em vez de 40, guidance (CFG) em 1 por padrão e um cache que reaproveita o prompt e as imagens de referência entre os passos. Ambos servem à velocidade; as tarefas e a saída em 2K continuam as mesmas.
- Quanto custa: na SpicyAPI, um preço único por imagem em 1K, 1.5K e 2K, menor que o do Qwen Image 2.1 (o valor está na seção da API, mais abaixo). Na API hospedada da Alibaba Cloud, CNY 0.10 por imagem (CNY 0.113362 em Singapura). Os pesos são um download gratuito sob a Qwen Research License, que não é uma licença comercial geral.
- É sem censura? Na SpicyAPI, sim, com a expansão de prompt desligada. Nenhuma das nossas 23 requisições de teste foi recusada; com a expansão ligada, o reescritor de prompts da Alibaba suavizou os prompts adultos. Os detalhes estão na seção sobre conteúdo, mais abaixo.
- Não confunda com o turbo da Viggle: aquele é um LoRA da comunidade sobre o modelo base, que roda em 6 passos (ou 9 no modo mais novo).
Abrir o Qwen Image 2.1 Turbo em texto para imagem →
Editar uma foto com o Qwen Image 2.1 Turbo →
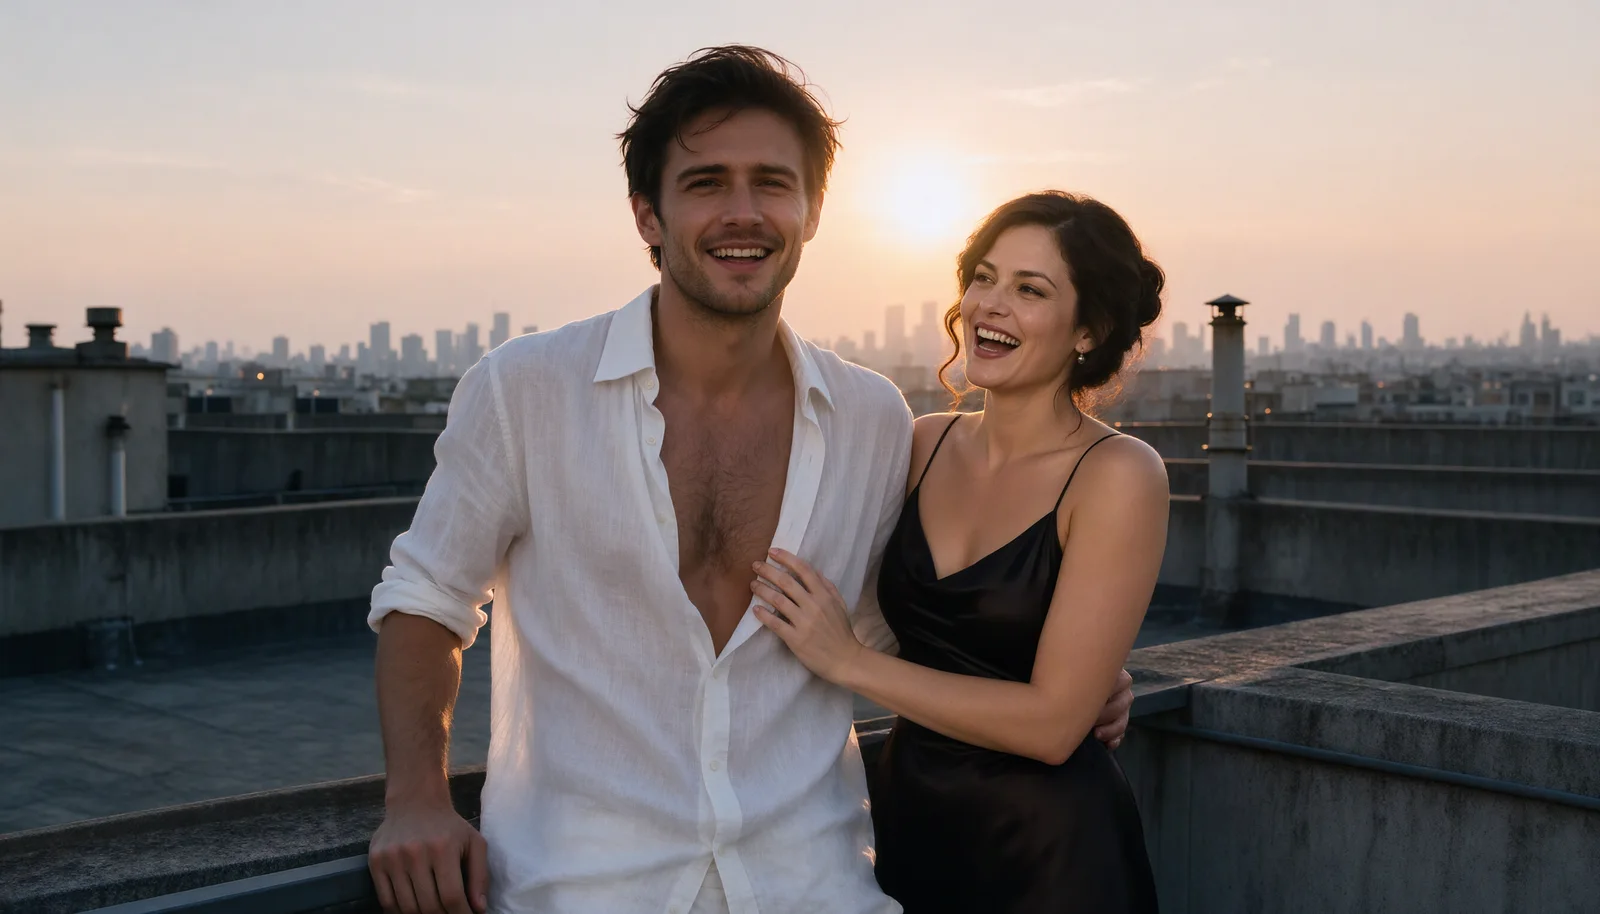
Todas as imagens deste artigo são resultados reais do Qwen Image 2.1 Turbo na SpicyAPI, gerados no nível 2K com a expansão de prompt desligada.
O que o Qwen Image 2.1 Turbo realmente é
O Turbo é construído sobre o Qwen Image 2.1, que a Alibaba lançou em setembro de 2026 como um único modelo de 7B para gerar e editar imagens. O Turbo mantém essa arquitetura e a saída em 2K, e corta o número de passagens de denoising. No anúncio de lançamento, o Qwen o descreve como capaz de "criar e editar imagens em apenas 8 passos de denoising", gerar "imagens 2K sólidas a partir de texto" e continuar editando com instruções em linguagem natural, "de adicionar acessórios a mudar uma cena".
| Qwen Image 2.1 | Qwen Image 2.1 Turbo | |
|---|---|---|
| Lançamento | Setembro de 2026 | 9 de outubro de 2026 |
| Arquitetura | Modelo de geração visual de 7B | Mesma arquitetura de 7B, checkpoint acelerado |
| Passos de denoising (exemplos oficiais) | 40 | 8, com o cronograma distribuído no checkpoint |
| Guidance (CFG) | Não definido nos exemplos oficiais | 1 por padrão |
| Tarefas | Texto para imagem e edição | Texto para imagem e edição |
| Imagens de referência na edição | Até 10 | De 1 a 10 na SpicyAPI; o card do Qwen não informa limite |
| Tamanhos 2K | 1:1 2048×2048 · 4:3 2400×1792 · 3:2 2528×1696 · 16:9 2752×1536, e as versões em retrato | Na SpicyAPI: 1:1 2048×2048 · 4:3 2368×1760 · 3:2 2496×1664 · 16:9 2688×1536, além de 2:3 1664×2496 e 9:16 1536×2688 |
| Licença dos pesos | Qwen Research License | Qwen Research License |
| Na SpicyAPI | No ar | No ar desde 13 de outubro de 2026 |
A vitrine oficial cobre retratos, poses e movimento, imagens transparentes (RGBA), tipografia e pôsteres, layouts de interface e infográficos, edições de uma única imagem, composição com várias referências e uma composição de interior com quatro imagens. São exemplos do próprio Qwen, não um benchmark: a Alibaba não publicou tempos de velocidade, notas de qualidade nem comparação lado a lado com o modelo de 40 passos.
O que 8 passos em vez de 40 significam na prática
Um modelo de difusão constrói uma imagem removendo ruído em passagens, e cada passo é uma passagem pelo modelo de 7B. O Turbo faz 8 passagens onde os exemplos oficiais do modelo base fazem 40, então o modelo de imagem faz 80% menos passagens por imagem.
Isso não é o mesmo que "cinco vezes mais rápido". Uma requisição completa também codifica o seu prompt e as imagens de referência, decodifica o resultado em pixels e, em uma API hospedada, espera em uma fila. Essas etapas não encolhem com o número de passos, e o Qwen não publicou tempos. Na SpicyAPI, nossas requisições ao Turbo levaram de 13 a 39 segundos em texto para imagem e de 26 a 59 segundos em edição, do início ao fim. A expansão de prompt aumenta esse tempo, porque a reescrita roda antes do primeiro passo: em 1K, nossas gerações de texto para imagem sem expansão terminaram em 13 a 21 segundos.
Onde a diferença aparece para você:
- Iteração. Mude uma expressão do prompt e olhe de novo, muitas vezes numa mesma sessão, em vez de se comprometer com uma renderização longa para cada ideia.
- Lotes. Gere várias versões de um mesmo briefing e fique com a melhor. Na SpicyAPI, uma requisição devolve até seis imagens, cada uma cobrada. Escolher dentro de um lote de rascunhos é o fluxo para o qual um modelo de poucos passos foi feito.
- Do rascunho ao final. Defina a composição, o figurino e a luz no Turbo e depois decida se a escolhida precisa mesmo do modelo de 40 passos.
- A conta da sua GPU. Quando você roda os pesos por conta própria, menos passagens significam menos tempo de GPU por imagem. Em uma API hospedada, você paga por imagem, não por passo, então a economia aparece na tabela de preços: CNY 0.10 pelo Turbo contra CNY 0.25 pelo Pro na API da Alibaba, e na SpicyAPI o Turbo custa menos por imagem que o Qwen Image 2.1.
Turbo, 2.1 ou 2.1 Pro: qual usar
Os três vêm da mesma geração do Qwen Image 2.1, então a escolha depende de quantas imagens você faz, do quanto cada uma é exigente e de onde você roda.
- Escolha o Turbo para volume e iteração: esboçar composições, testar a redação do prompt, gerar muitas variantes e escolher a melhor. Um quinto das passagens por imagem é justamente a ideia.
- Escolha o 2.1 base quando uma única imagem precisa estar certa ou precisa de algo que o Turbo não tem: uma máscara para mudar só uma área, a opção de fundo transparente ou saída em JPEG e WebP. Edições difíceis com várias referências e letras pequenas e densas são os outros casos delicados: versões de poucos passos deste modelo tiveram dificuldade aí, e o card do turbo da Viggle, por exemplo, alerta para figuras duplicadas, deriva de identidade e texto pequeno embaralhado. O Qwen não publicou comparação de qualidade para o Turbo oficial. Nos nossos testes, o Turbo manteve os dois rostos reconhecíveis em uma composição feita a partir de dois retratos e escreveu duas linhas curtas de pôster sem errar uma letra; então comece pelo Turbo e passe uma imagem para o 2.1 só quando ela não ficar boa o bastante.
- Considere o Pro quando letras e retratos importam. O Qwen Image 2.1 Pro é o nível hospedado superior da Alibaba, a CNY 0.25 por imagem contra CNY 0.10 do Turbo na API da Alibaba, e a Alibaba lista para ele tipografia, iluminação de retrato e detalhe fino melhorados. Desde 14 de outubro ele também está no ar na SpicyAPI com a mesma requisição do Turbo, para texto para imagem e edição. A Alibaba não publicou uma comparação lado a lado entre Pro, Turbo e o modelo base, então rode os mesmos prompts seus nos dois antes de comprometer um orçamento.
- Não espere que uma seed seja transferida. Uma seed define o ruído inicial para um checkpoint e um cronograma. A mesma seed no Turbo e no 2.1 gera duas imagens diferentes, então guarde o arquivo de que você gostou, não a seed.
O fluxo prático: faça os rascunhos no Turbo, guarde o prompt que funcionou e renderize o quadro final no 2.1 se a versão do Turbo não for boa o bastante. O nosso guia do Qwen Image 2.1 traz prompts que funcionam no modelo base, com exemplos.
Como escrever prompts para o Qwen Image 2.1 Turbo
A maioria são regras gerais para modelos de imagem de poucos passos e para o Qwen Image 2.1; a última vem dos nossos testes com o Turbo. Um modelo que trabalha em 8 passagens tem menos margem para deduzir o que você quis dizer, então diga.
- Nomeie seis coisas, nesta ordem: quem, o que veste, uma pose, a luz, a lente, a paleta. O que você deixar de fora recebe um padrão genérico.
- Uma cena por prompt. Dois climas ou dois locais na mesma frase costumam voltar como um meio-termo entre eles.
- Descreva a luz como fontes. "Um abajur quente de cabeceira à direita, o resto do ambiente na sombra" funciona melhor que "iluminação dramática".
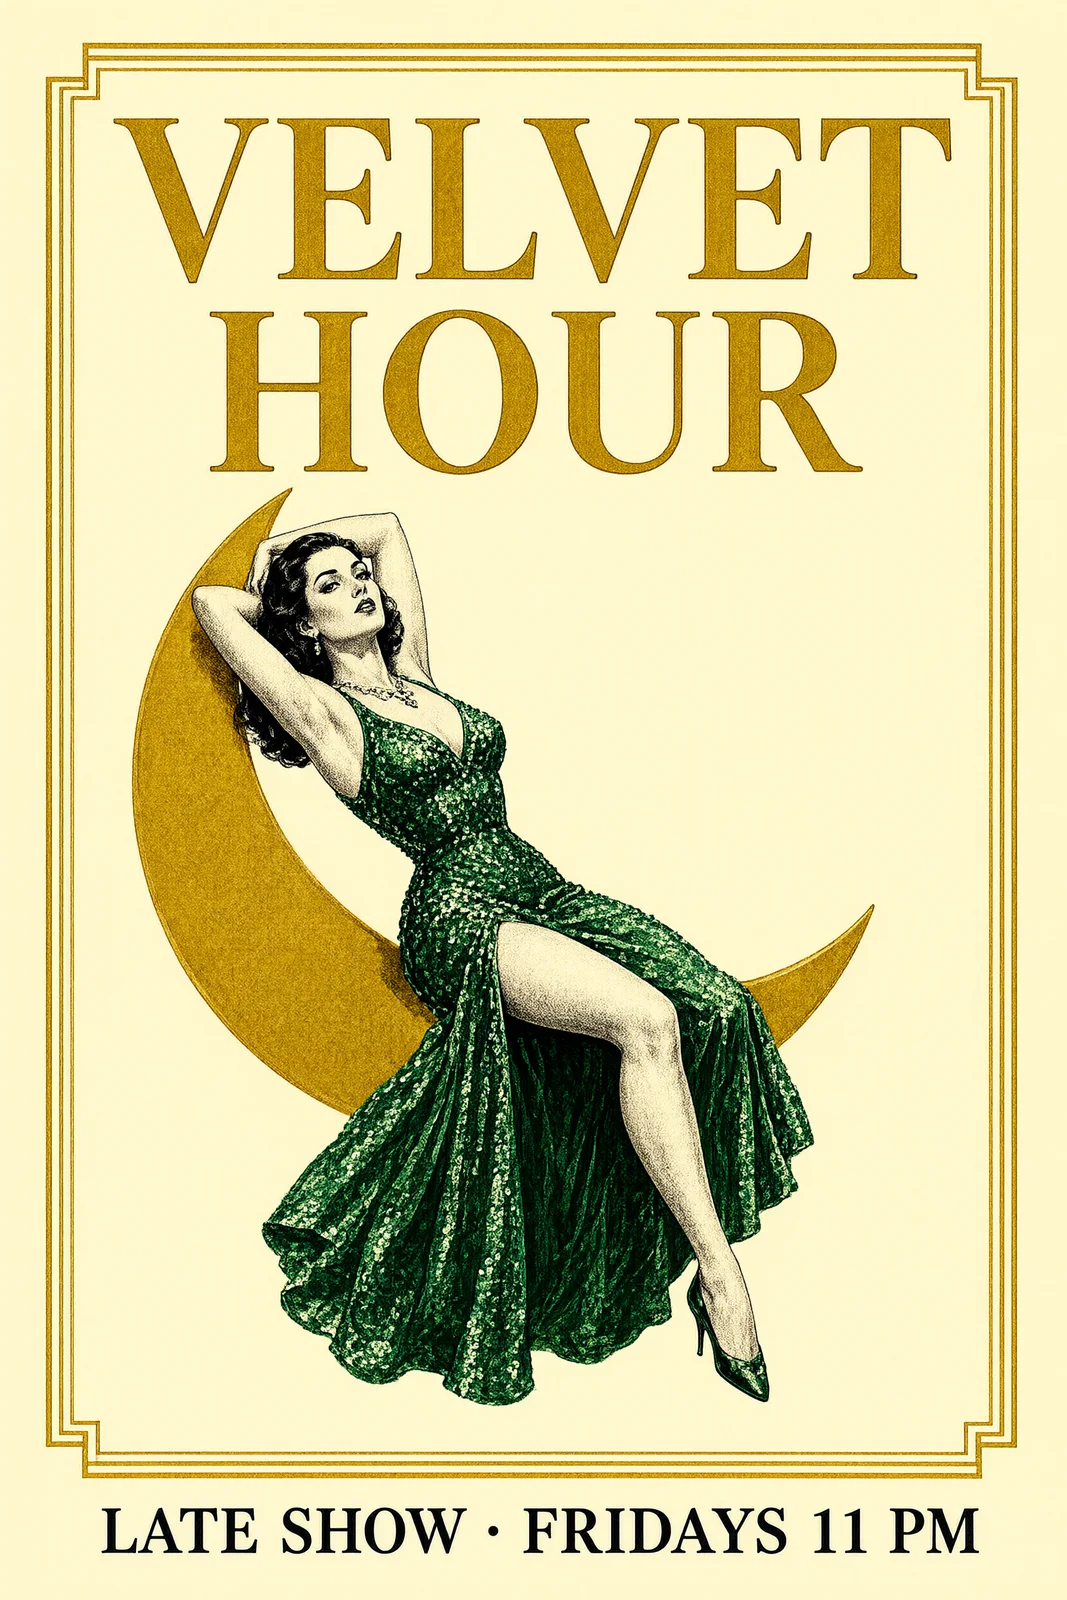
- Para texto na imagem, coloque as palavras exatas entre aspas e diga onde elas ficam ("uma manchete de pôster com a frase 'LATE SHOW' no alto").
- Nas edições, escreva primeiro a mudança e depois o que manter. "Troque o vestido dela por cetim esmeralda. Mantenha o rosto, o cabelo, a pose, a cama e a luz do abajur como estão."
- Com várias imagens de referência, diga o que cada uma contribui: a pessoa da primeira imagem, a jaqueta da segunda, o ambiente da terceira.
- Na SpicyAPI, decida sobre a expansão de prompt. No Turbo ela vem desligada por padrão, então suas palavras são desenhadas como estão; no Qwen Image 2.1 ela vem ligada. Ligue-a para um prompt curto do dia a dia que você queira enriquecer. Deixe-a desligada quando o seu prompt já define a luz, a lente e a paleta, e em prompts adultos: a reescrita da Alibaba os suaviza e, nas edições, pode descartar a instrução inteira (veja a seção sobre conteúdo, mais abaixo).
Fraco: "uma mulher de vestido em um quarto".
Forte:
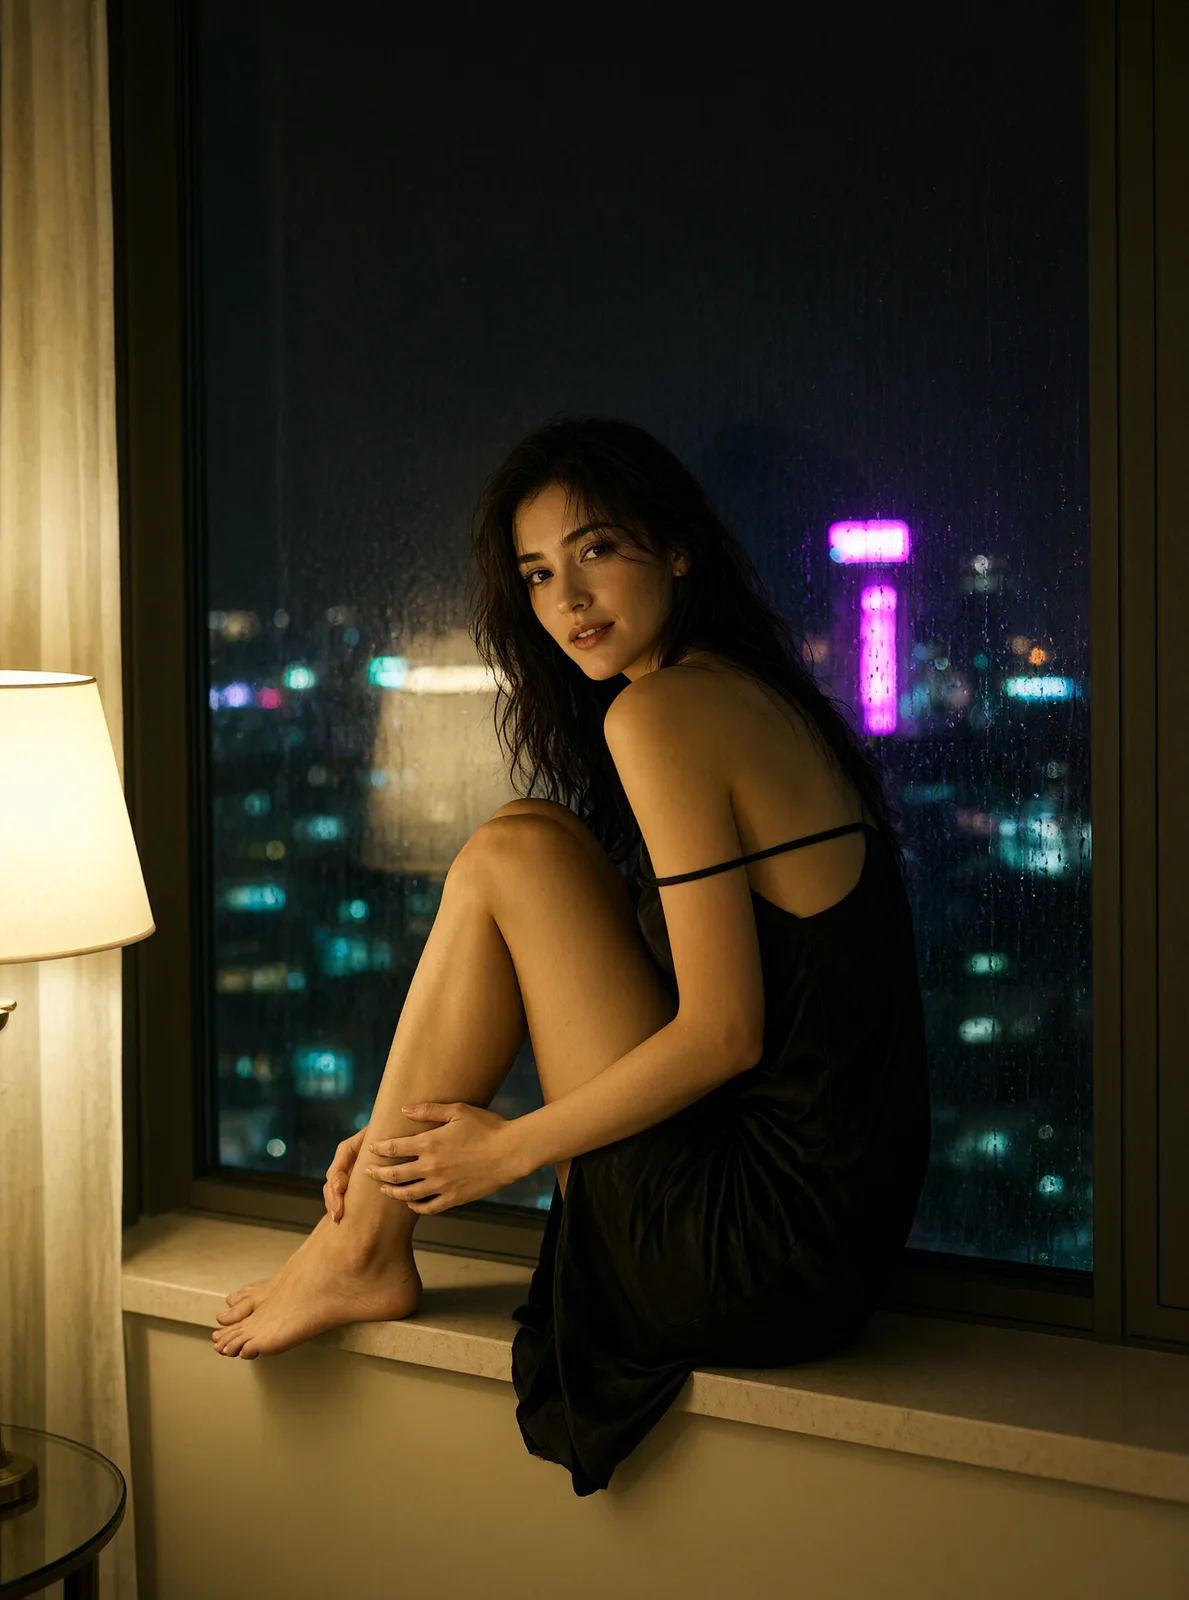
Fotografia de uma mulher de pouco mais de trinta anos em um slip de seda preta de costas baixas, uma alça caída do ombro, sentada na beira de uma cama desfeita e olhando para trás por cima do ombro. Um abajur quente de cabeceira à direita, o resto do ambiente na sombra. Lente de 85mm, pouca profundidade de campo, leve granulação de filme, paleta de vinho, preto e mel.
A versão fraca deixa o figurino, a pose, a luz e a lente por conta do modelo. A forte decide cada um deles, que é o que você quer quando itera rápido e compara rascunhos.
O que o Turbo pode fazer: tamanhos 2K, PNGs transparentes, edição e pôsteres
A vitrine do Qwen para o Turbo cobre o mesmo terreno do modelo base. Veja o que cada parte significa na SpicyAPI, junto com o que vimos nos nossos próprios testes.
Tamanhos 2K. Estes são os tamanhos 2K que o Turbo devolveu na SpicyAPI. Eles diferem um pouco dos presets dos exemplos do modelo base do Qwen:
| Proporção | Tamanho em pixels | Bom para |
|---|---|---|
| 1:1 | 2048 × 2048 | Fotos de perfil, miniaturas de produto, capas de álbum |
| 4:3 | 2368 × 1760 | Molduras clássicas, slides |
| 3:2 | 2496 × 1664 | Fotografia de paisagem, cabeçalhos de blog |
| 2:3 | 1664 × 2496 | Pôsteres, capas de livros e revistas |
| 16:9 | 2688 × 1536 | Banners, miniaturas de vídeo, papel de parede de desktop |
| 9:16 | 1536 × 2688 | Stories, papel de parede de celular, anúncios verticais |
O Turbo aceita uma proporção, quinze no total, mais um nível 1k, 1.5k ou 2k, e todos os níveis custam o mesmo, por isso 2K é o padrão. Se você não informar a proporção em uma edição, o resultado segue o formato da imagem original em cerca de 2K: nossas imagens de 1024 × 1536 voltaram em 1680 × 2512 ou 1664 × 2496.
Imagens transparentes. Os exemplos do Qwen incluem resultados transparentes (RGBA): um produto ou personagem sem fundo, pronto para ser colocado em um layout. Na SpicyAPI, o Turbo não tem opção de fundo e sempre devolve arquivos PNG. A Alibaba diz que um prompt pedindo fundo transparente ou um adesivo devolve um PNG com canal alfa; não verificamos isso. Quando o recorte precisa funcionar, use o Qwen Image 2.1, em que background definido como transparent com saída PNG ou WebP gera um.
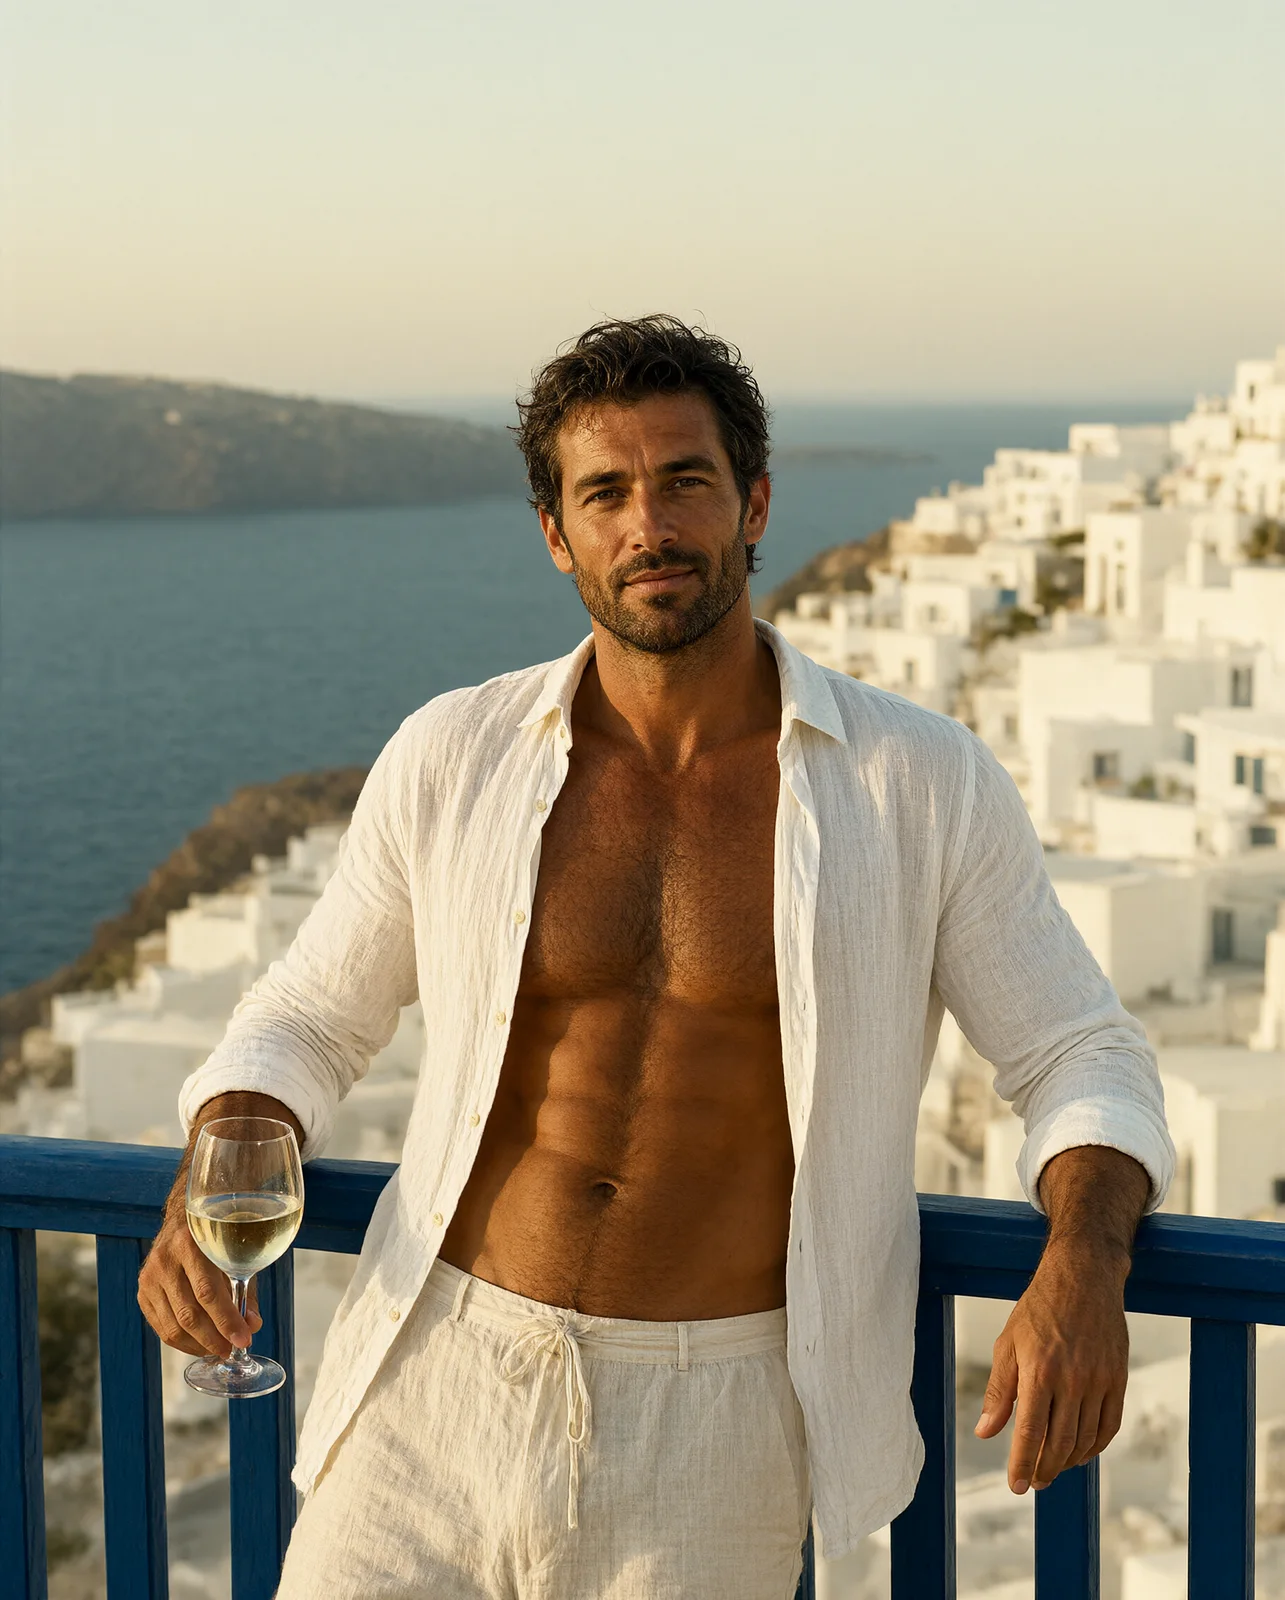
Edição e várias referências. O Turbo edita a partir de instruções simples, de adicionar um acessório a trocar a cena inteira. Na SpicyAPI, ele aceita de uma a dez imagens de referência por edição; no prompt, chame-as de Image 1, Image 2 e assim por diante. A imagem no topo deste artigo saiu de dois retratos separados, um homem em um terraço e uma cantora de vestido de veludo, e os dois rostos continuaram reconhecíveis. Não há máscara: descreva com palavras a área a mudar e diga o que precisa ficar.
Pôsteres, tipografia e layouts. A vitrine inclui tipografia, pôsteres, telas de interface e layouts de infográficos. O Qwen não dá números de precisão. No nosso teste de pôster, as duas linhas entre aspas saíram letra por letra, mas as notas da Viggle sobre a própria versão de poucos passos dizem que texto pequeno quebra com mais frequência do que no modelo base, então confira as letras em tamanho real antes de imprimir ou publicar.
API do Qwen Image 2.1 Turbo: onde chamar e quanto custa
API hospedada da Alibaba Cloud. O Qwen anunciou as APIs Turbo e Pro no dia do lançamento. A página oficial de preços lista o preço original, antes de promoções, por imagem:
| Modelo | Pequim, EUA (Virgínia), Frankfurt, Tóquio, Hong Kong | Singapura | Limite de requisições |
|---|---|---|---|
| Qwen Image 2.1 Turbo | CNY 0.10 | CNY 0.113362 | 20 requisições por minuto |
| Qwen Image 2.1 Pro | CNY 0.25 | CNY 0.283404 | 20 requisições por minuto |
A Alibaba lista esses valores apenas em yuan. O Turbo custa 40% do preço do Pro.
SpicyAPI. O Turbo está no ar aqui desde 13 de outubro de 2026, com dois endpoints: texto para imagem e edição. Ele custa $0.0144 por imagem, o mesmo em 1k, 1.5k e 2k, e o mesmo para uma edição com uma ou dez imagens de referência. Você paga por cada imagem devolvida, então uma requisição de seis imagens custa seis vezes isso. Uma requisição aceita um prompt de até 5.000 caracteres, de uma a seis imagens de saída, quinze proporções, um nível 1k, 1.5k ou 2k, a expansão de prompt (desligada por padrão; quando ligada, um modo de raciocínio opcional e, em texto para imagem, uma reescrita direct ou agent) e uma seed; as edições acrescentam de uma a dez imagens de referência. A saída é sempre PNG. Não há máscara, prompt negativo nem escolha de formato de saída.
Para comparar, o Qwen Image 2.1 custa $0.024 por imagem em 1k e $0.048 em 2k em texto para imagem, e as edições começam em $0.036. Migrar uma integração do 2.1 para o Turbo é, na maior parte, trocar o nome do modelo. O Turbo acrescenta num_outputs, enable_thinking e, em texto para imagem, prompt_optimization_mode; ele não tem background nem output_format, e o endpoint de edição não tem mask_url. Os dois modelos rejeitam campos que não conhecem, então remova esses ao trocar.
Uma requisição mínima de texto para imagem:
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "alibaba/qwen-image-2.1-turbo/text-to-image",
    "input": {
      "prompt": "Golden-hour photograph of an adult man in his thirties on a whitewashed balcony on a Greek island, white linen shirt open, leaning on a blue railing with a glass of white wine, 85mm, medium-format film look.",
      "aspect_ratio": "4:5",
      "resolution": "2k",
      "num_outputs": 2
    }
  }'
Rodando os pesos abertos: Hugging Face, Diffusers e GGUF
Os pesos oficiais são Qwen/Qwen-Image-2.1-Turbo no Hugging Face e no ModelScope, publicados em 9 de outubro de 2026 em BF16. O checkpoint é carregado com QwenImage21Pipeline. Você precisa do Diffusers instalado a partir do código-fonte (ele depende de sigmas de amostragem configurados no pipeline, adicionados no PR #14950), transformers>=5.17.0, accelerate, pillow e um build do PyTorch com CUDA.
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1-Turbo", dtype=torch.bfloat16
).to("cuda")

image = pipe(
    prompt="Studio portrait of an adult woman in a charcoal wool coat, one warm key light from the left, 85mm, shallow depth of field",
    width=2048,
    height=2048,
    use_kv_cache=True,
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]
image.save("turbo.png")
Três pontos em que o model card é específico:
- Você não define os passos. O cronograma recomendado de 8 passos acompanha o checkpoint e é carregado automaticamente. Definir só
num_inference_stepsnão o substitui. Passarsigmasexplícitos substitui, mas o Qwen diz que outros cronogramas não foram avaliados. - O CFG é 1 por padrão, então não há guidance scale para ajustar nos exemplos oficiais.
- A edição usa o mesmo pipeline: passe a imagem de origem como
image=com uma instrução de edição e o tamanho de saída. O exemplo oficial abre a imagem de entrada com.convert("RGBA").
Para width e height, os próprios exemplos do Qwen usam 2048 × 2048 para um quadrado e 1696 × 2528 para um retrato. O card não informa um requisito de VRAM; os pesos são 7B parâmetros em BF16.
Builds GGUF para ComfyUI e stable-diffusion.cpp
O Qwen publica só o checkpoint em BF16. Os arquivos GGUF são builds da comunidade, e vários apareceram no dia seguinte ao lançamento, como unsloth/Qwen-Image-2.1-Turbo-GGUF e AtomicChat/Qwen-Image-2.1-Turbo-GGUF no Hugging Face. A Unsloth recomenda o arquivo de 4 bits Q4_K_M (4,2 GB) para a maioria das GPUs e o Q8_0 (7,6 GB) para a saída mais próxima do BF16. Três coisas para saber antes de baixar um:
- Um GGUF traz só o modelo de imagem. Você ainda precisa do codificador de texto Qwen3-VL-8B e do VAE do Qwen Image 2.1, os mesmos do modelo base.
- Mantenha o cronograma do Turbo: 8 passos, CFG 1 e a lista de sigmas que vem no checkpoint. O ComfyUI carrega os arquivos pelos nós do ComfyUI-GGUF; o stable-diffusion.cpp recebe os sigmas pela linha de comando.
- A licença acompanha o arquivo. Mesmo quantizado, continua sendo o Qwen-Image-2.1-Turbo sob a Qwen Research License.
O download mais conhecido com "Uncensored" no nome é outra coisa. O Qwen-Image-2.1-Turbo-Uncensored-GGUF da AtomicChat é o codificador de texto com o comportamento de recusa removido, usado junto com o modelo de imagem Turbo sem alterações. Segundo o card, o pipeline padrão de pesos abertos não tem filtro de conteúdo e, em 45 prompts sensíveis de teste, o codificador modificado não mudou nenhum resultado.
Auto-hospedar os pesos abertos ou chamar uma API?
| Rodar os pesos abertos por conta própria | Chamar uma API hospedada | |
|---|---|---|
| Licença | Qwen Research License; leia antes de qualquer uso comercial | Os termos do provedor |
| Hardware | Uma GPU CUDA com espaço para 7B parâmetros em BF16 (cerca de 14 GB de pesos) mais as ativações em 2K, ou um GGUF de 4 bits de cerca de 4 GB mais o codificador de texto e o VAE | Nenhum |
| Configuração | Diffusers a partir do código-fonte, transformers>=5.17.0 e acompanhar as mudanças do pipeline | Uma chave de API |
| Custo | Tempo de GPU, que menos passos reduzem diretamente | Por imagem: preço único na SpicyAPI, CNY 0.10 na API da Alibaba |
| Regras de conteúdo | As suas; os pesos abertos não vêm com filtro de conteúdo | As do provedor; a SpicyAPI não adiciona nenhum filtro próprio e deixa a expansão de prompt do Turbo desligada por padrão |
| Escala | Quantas GPUs você rodar | A Alibaba lista 20 requisições por minuto |
Rode os pesos por conta própria para pesquisa, para experimentos com LoRAs e cronogramas de amostragem, ou quando as imagens não podem sair da sua máquina. Use uma API quando for lançar um produto, não quiser manter GPUs ou precisar de imagens hoje, sem configuração.
Turbo oficial vs turbo da Viggle
Antes de 9 de outubro, "Qwen Image 2.1 turbo" significava aceleradores da comunidade. O mais conhecido é o da Viggle, e outros circulam com nomes parecidos. São um tipo diferente de arquivo:
| Qwen-Image-2.1-Turbo (oficial) | Qwen-Image-2.1-viggle-turbo (comunidade) | |
|---|---|---|
| Feito por | Equipe Qwen da Alibaba | Viggle |
| O que você baixa | Um checkpoint completo | Um LoRA carregado sobre o modelo 2.1 base (também há arquivos mesclados em int8, fp8 e GGUF) |
| Passos | 8 | 6, ou um modo de 9 passos adicionado na v0.3 |
| Guidance | CFG 1 por padrão | Sem classifier-free guidance |
| Imagens de referência na edição | Não informado pelo Qwen; de 1 a 10 na SpicyAPI | 1 a 3 |
| Versão mais recente | 9 de outubro de 2026 | v0.3, 29 de setembro de 2026 |
| Licença | Qwen Research License | Qwen Research License (descrita como não comercial) |
A Viggle relata que o modo de 6 passos é cerca de cinco vezes mais rápido que o modelo base de 40 passos de ponta a ponta, e que o modo de 9 passos leva cerca de 1,4 a 1,5 vez o tempo do de 6. O card dela também lista as concessões: figuras duplicadas ou com efeito fantasma e desvio de identidade em edições complicadas, texto pequeno que se embaralha mais do que no modelo base e cores algumas unidades percentuais menos saturadas. Essas observações descrevem o LoRA da Viggle, não o Turbo oficial, que ainda não tem comparação publicada. Se você roda a versão da comunidade no ComfyUI, confira qual número de passos o seu workflow usa: as configurações recomendadas variam entre versões e builds quantizadas.
O Qwen Image 2.1 Turbo é sem censura?
Na SpicyAPI, sim, desde que a expansão de prompt fique desligada. Em 13 de outubro de 2026, enviamos ao Turbo 23 requisições por toda a nossa escala, de lingerie a uma cena de contenção consensual entre adultos e uma cena violenta cinematográfica, e nenhuma foi recusada. Com a expansão desligada, tudo voltou como escrito, exceto uma de duas cenas íntimas entre dois adultos; com a expansão ligada, o reescritor de prompts da Alibaba suavizou três requisições e devolveu duas edições sem nenhuma mudança.
Os resultados dos testes de conteúdo e as configurações recomendadas também estão na página do modelo Qwen Image 2.1 Turbo; o que os downloads de "GGUF sem censura" realmente mudam está explicado na seção de GGUF, mais acima. A SpicyAPI não adiciona nenhum filtro de conteúdo próprio.
Dá para usar o Turbo comercialmente?
Os pesos abertos são publicados sob a Qwen Research License Agreement, a mesma licença do Qwen Image 2.1 base. O card da Viggle, que usa a mesma licença, a descreve como uso não comercial para pesquisa ou avaliação, com o uso comercial exigindo uma licença separada do licenciante. Se você pretende rodar os pesos na sua própria GPU dentro de um produto comercial, leia a licença primeiro. Uma API hospedada é outro arranjo, coberto pelos termos do próprio provedor.
Perguntas sobre o Qwen Image 2.1 Turbo
Quando o Qwen Image 2.1 Turbo foi lançado?
Em 9 de outubro de 2026, com pesos abertos no Hugging Face e no ModelScope e as APIs hospedadas Turbo e Pro na Alibaba Cloud no mesmo dia.
O Qwen Image 2.1 Turbo é gratuito?
Os pesos são gratuitos para baixar, sob uma licença de pesquisa. Rodá-los ainda exige uma GPU capaz. A API hospedada da Alibaba cobra CNY 0.10 por imagem, e a SpicyAPI cobra um preço único por imagem em qualquer tamanho.
O Qwen Image 2.1 Turbo é de código aberto?
Os pesos dele são abertos: você pode baixá-los e rodá-los. A licença é a Qwen Research License, não uma licença de código aberto como a Apache 2.0, então "pesos abertos" é o termo correto.
Posso usar o Qwen Image 2.1 Turbo em trabalhos comerciais?
Para os pesos auto-hospedados, leia antes a Qwen Research License: é uma licença de pesquisa, e a Viggle descreve a mesma licença como não comercial. Por meio de uma API hospedada, valem os termos do provedor.
Quantos passos o Qwen Image 2.1 Turbo usa, e posso mudar isso?
Oito. O cronograma é carregado com o checkpoint; só sigmas explícitos o substituem, e o Qwen não avaliou outros cronogramas.
Existe uma versão GGUF do Qwen Image 2.1 Turbo?
Não do Qwen, que publica pesos em BF16. Builds GGUF da comunidade surgiram no Hugging Face em menos de um dia, por exemplo da Unsloth e da AtomicChat. Eles precisam do codificador de texto Qwen3-VL e do VAE junto, e do cronograma de 8 passos com CFG 1.
O Qwen Image 2.1 Turbo edita imagens?
Sim. Ele edita a partir de instruções em linguagem natural, de adicionar um acessório a trocar a cena inteira. Na SpicyAPI, uma edição aceita de uma a dez imagens de referência, e o resultado mantém o formato da original se você não informar a proporção.
O Qwen Image 2.1 Turbo aceita fundos transparentes?
A vitrine do Qwen inclui imagens transparentes (RGBA), e a Alibaba diz que pedir um fundo transparente no prompt devolve um PNG com canal alfa. Não verificamos isso no Turbo, que na SpicyAPI não tem opção de fundo. Para um recorte garantido, use o Qwen Image 2.1 com background definido como transparent.
Que resolução o Qwen Image 2.1 Turbo gera?
2K: 2048 × 2048 para um quadrado e 2688 × 1536 em 16:9 no nível 2K da SpicyAPI, com quinze proporções e os níveis 1k e 1.5k pelo mesmo preço.
Qwen Image 2.1 Turbo ou Pro: qual devo usar?
Na API da Alibaba, o Turbo custa CNY 0.10 por imagem e o Pro CNY 0.25. A Alibaba não publicou uma comparação, então teste os dois com os seus próprios prompts. Os pesos do Turbo também são abertos, então você pode rodá-lo por conta própria.
O Qwen Image 2.1 Turbo é o mesmo turbo da Viggle?
Não. O Turbo oficial é um checkpoint completo do Qwen com um cronograma de 8 passos. O da Viggle é um LoRA da comunidade sobre o modelo base que roda em 6 ou 9 passos.
O Qwen Image 2.1 Turbo é sem censura?
Na SpicyAPI, sim, com a expansão de prompt desligada: nenhuma das nossas 23 requisições de teste foi recusada. Com a expansão ligada, o reescritor da Alibaba suavizou os prompts adultos. Os detalhes estão na seção sobre conteúdo, mais acima.
Dá para usar o Qwen Image 2.1 Turbo por API?
Sim. A Alibaba Cloud oferece, e na SpicyAPI ele está no ar desde 13 de outubro de 2026 com endpoints de texto para imagem e de edição; o preço ao vivo aparece antes do envio.
Resumindo
O Qwen Image 2.1 Turbo é a versão rápida oficial de um modelo que talvez você já use: mesma arquitetura de 7B, mesma edição, saída em 2K, em 8 passos. Na SpicyAPI ele já está no ar, custa menos por imagem que o Qwen Image 2.1, devolve até seis imagens por requisição e deixa a expansão de prompt desligada por padrão. Use-o para rascunhos, volume e composições, passe uma imagem para o modelo base de 40 passos quando precisar de máscara, de um recorte transparente garantido ou de arquivos JPEG e WebP, e confira a licença de pesquisa antes de montar um produto sobre os pesos abertos. Comece pela página de texto para imagem do Turbo.