Le 9 octobre 2026, l’équipe Qwen d’Alibaba a publié Qwen-Image-2.1-Turbo avec des poids ouverts. Si vous aviez cherché « Qwen Image 2.1 Turbo » avant cette date, vous étiez surtout tombé sur des accélérations communautaires ; celle-ci vient de Qwen lui-même.
En bref : Qwen Image 2.1 Turbo est le même modèle Qwen Image 2.1 de 7B, accéléré pour tourner en 8 pas de débruitage au lieu des 40 des exemples officiels du modèle de base. Il fait à la fois du texte vers image et de la retouche d’image en langage naturel en 2K, et Alibaba affirme que moins de pas ne veut pas dire moins de qualité. Sur SpicyAPI, il est disponible depuis le 13 octobre 2026 en texte vers image et en retouche : une à six images par requête, à un prix unique par image, inférieur à celui de Qwen Image 2.1. L’API hébergée d’Alibaba l’affiche à CNY 0.10 l’image, contre CNY 0.25 pour Qwen Image 2.1 Pro.
La version en 30 secondes
- Ce que c’est : un checkpoint accéléré de Qwen Image 2.1, même architecture 7B, publié par Qwen sur Hugging Face et ModelScope. Ni un LoRA, ni un autre modèle.
- Ce qui change : 8 pas au lieu de 40, un guidage (CFG) à 1 par défaut, et un cache qui réutilise le prompt et les images de référence d’un pas à l’autre. Les deux touchent à la vitesse ; les tâches et la sortie 2K restent les mêmes.
- Ce que ça coûte : sur SpicyAPI, un prix unique par image en 1K, 1.5K et 2K, inférieur à celui de Qwen Image 2.1 (le montant figure dans la section API plus bas). Sur l’API hébergée d’Alibaba Cloud, CNY 0.10 par image (CNY 0.113362 à Singapour). Les poids se téléchargent gratuitement sous la Qwen Research License, qui n’est pas une licence commerciale générale.
- Est-il non censuré ? Sur SpicyAPI, oui, avec l’expansion du prompt désactivée. Aucune de nos 23 requêtes de test n’a été refusée ; avec l’expansion activée, le réécrivain de prompts d’Alibaba a adouci les prompts pour adultes. Les détails sont dans la section sur le contenu plus bas.
- À ne pas confondre avec le turbo de Viggle : celui-ci est un LoRA communautaire posé sur le modèle de base, qui tourne en 6 pas (ou 9 dans son mode plus récent).
Ouvrir Qwen Image 2.1 Turbo en texte vers image →
Retoucher une photo avec Qwen Image 2.1 Turbo →
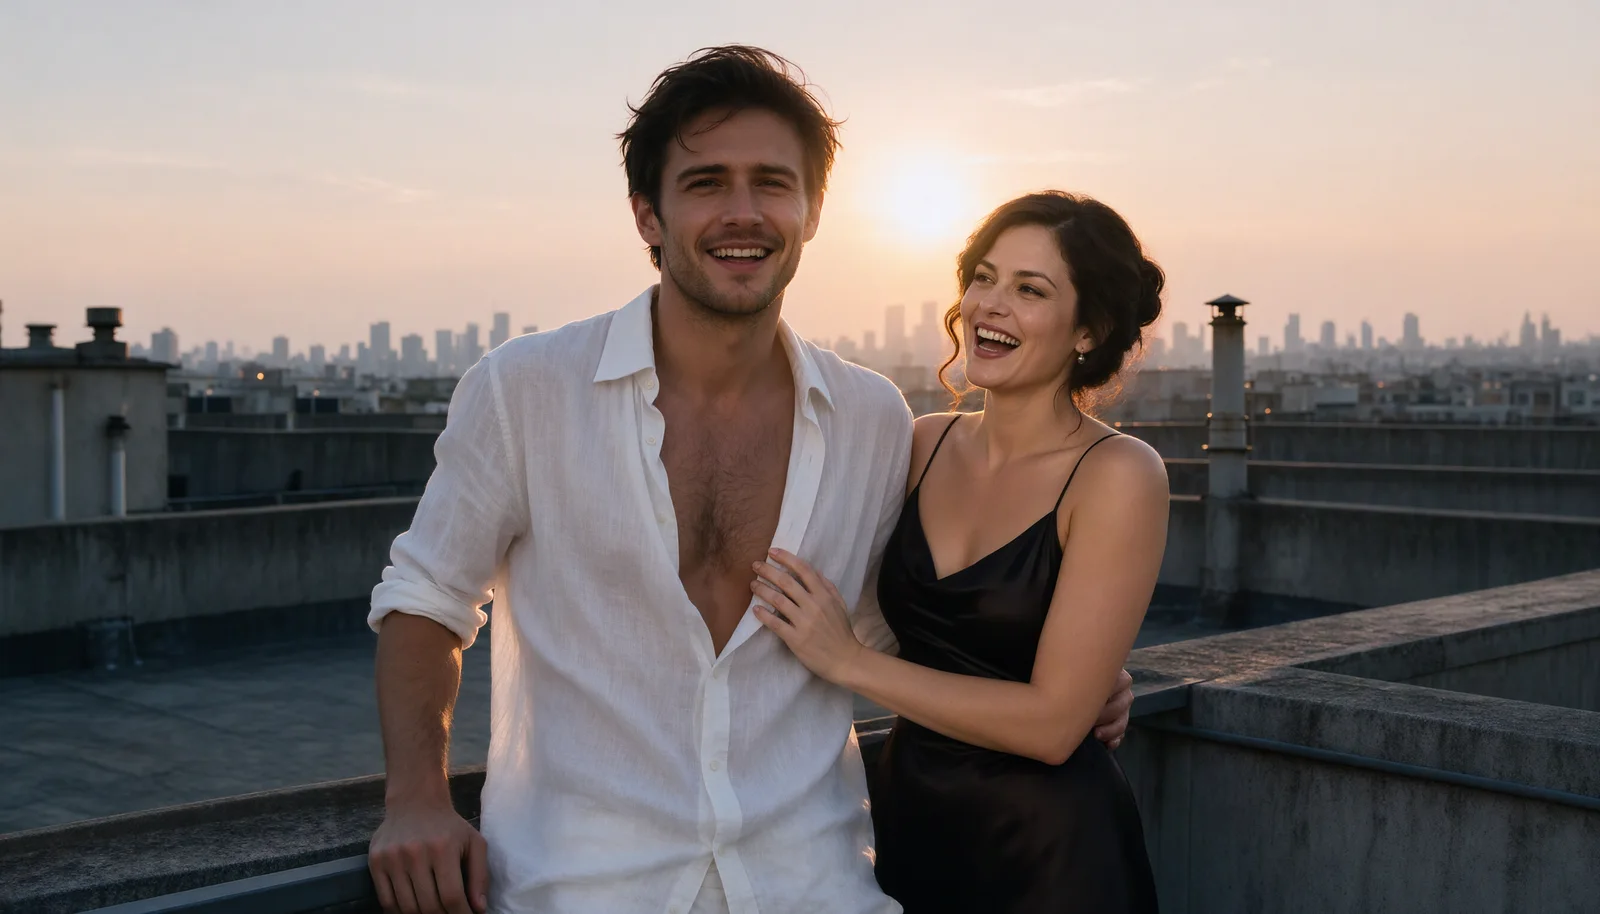
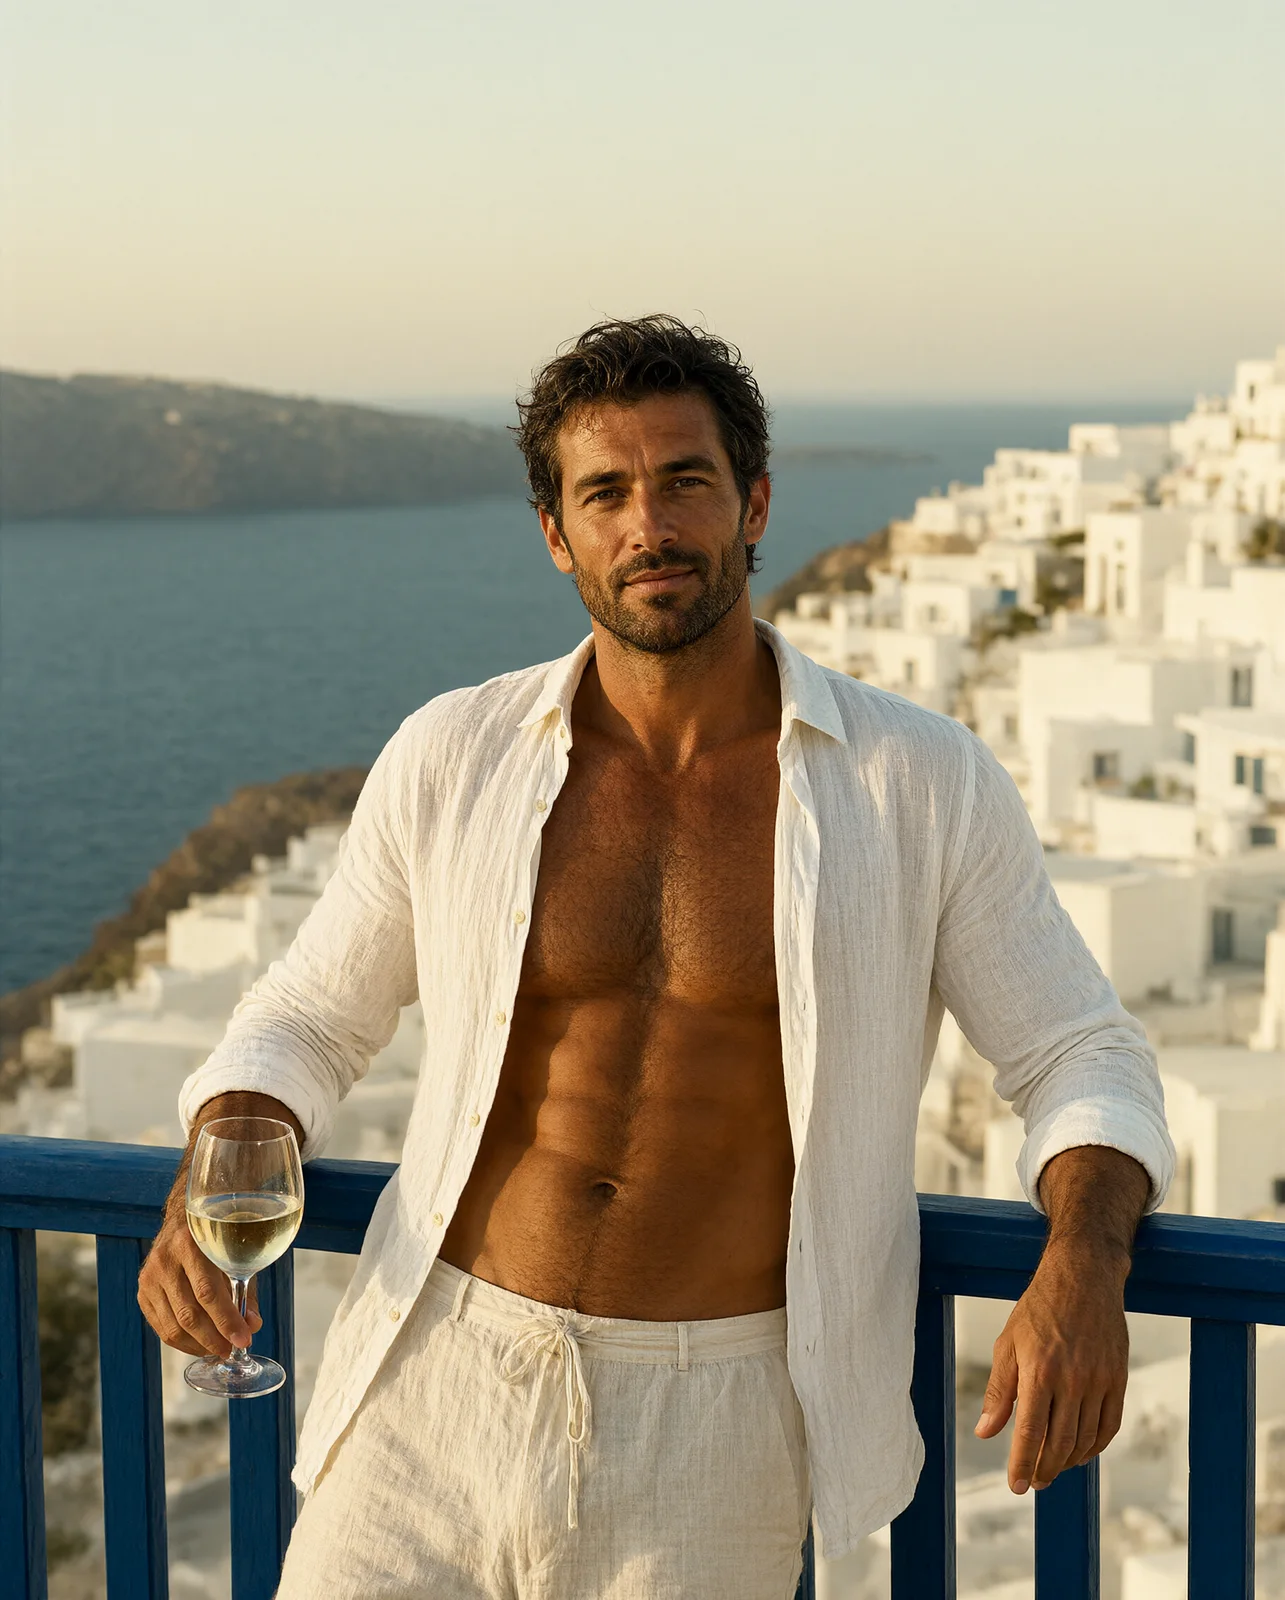
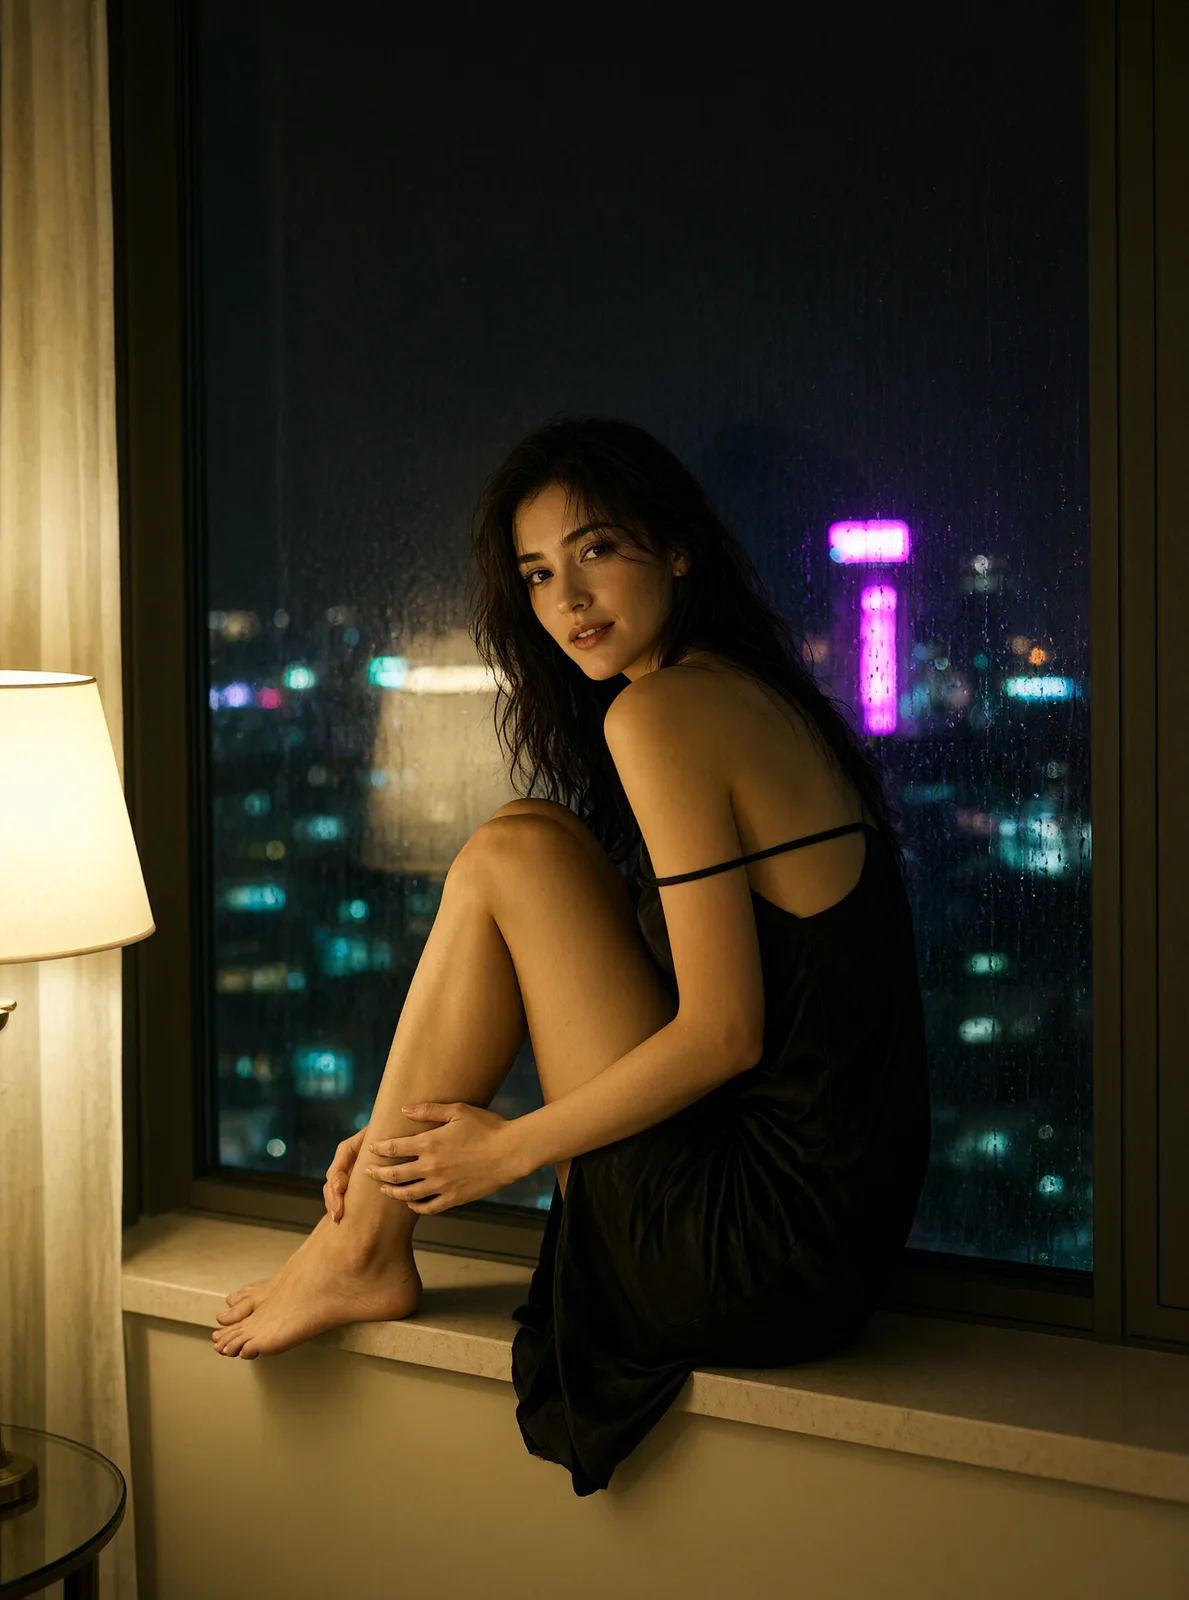
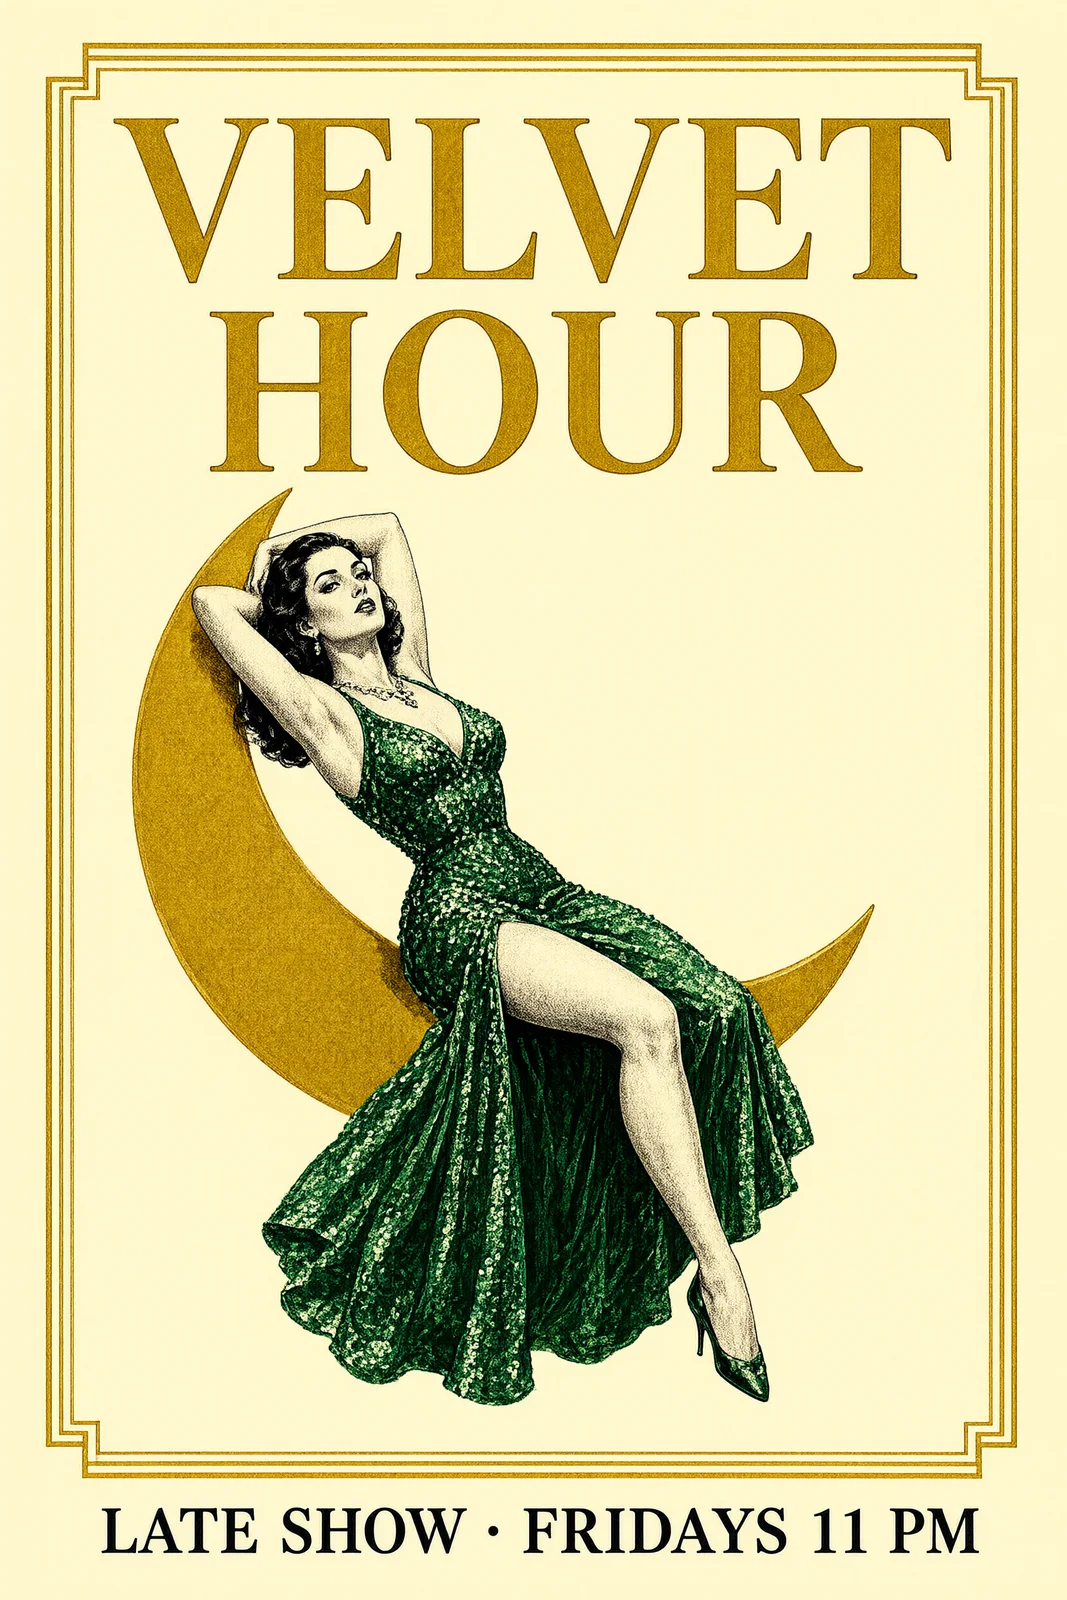
Toutes les images de cet article sont de vrais résultats de Qwen Image 2.1 Turbo sur SpicyAPI, générés au palier 2K avec l’expansion du prompt désactivée.
Ce qu’est vraiment Qwen Image 2.1 Turbo
Turbo repose sur Qwen Image 2.1, qu’Alibaba a publié en septembre 2026 comme un seul modèle 7B pour générer et retoucher des images. Turbo garde cette architecture et la sortie 2K, et réduit le nombre de passes de débruitage. Dans l’annonce de lancement, Qwen le décrit comme capable de « créer et retoucher des images en seulement 8 pas de débruitage », de générer « de solides images 2K à partir de texte » et de poursuivre la retouche par instructions en langage naturel, « de l’ajout d’accessoires au changement de scène ».
| Qwen Image 2.1 | Qwen Image 2.1 Turbo | |
|---|---|---|
| Sortie | Septembre 2026 | 9 octobre 2026 |
| Architecture | Modèle de génération visuelle 7B | Même architecture 7B, checkpoint accéléré |
| Pas de débruitage (exemples officiels) | 40 | 8, avec le calendrier livré dans le checkpoint |
| Guidage (CFG) | Non précisé dans les exemples officiels | 1 par défaut |
| Tâches | Texte vers image et retouche | Texte vers image et retouche |
| Images de référence pour la retouche | Jusqu’à 10 | 1 à 10 sur SpicyAPI ; la fiche de Qwen n’indique pas de limite |
| Tailles 2K | 1:1 2048×2048 · 4:3 2400×1792 · 3:2 2528×1696 · 16:9 2752×1536, et leurs versions portrait | Sur SpicyAPI : 1:1 2048×2048 · 4:3 2368×1760 · 3:2 2496×1664 · 16:9 2688×1536, plus 2:3 1664×2496 et 9:16 1536×2688 |
| Licence des poids | Qwen Research License | Qwen Research License |
| Sur SpicyAPI | Disponible | Disponible depuis le 13 octobre 2026 |
La vitrine officielle couvre portraits, poses et mouvements, images transparentes (RGBA), typographie et affiches, interfaces et infographies, retouches d’une seule image, composition multi-références et une composition d’intérieur à quatre images. Ce sont les exemples de Qwen, pas un benchmark : Alibaba n’a publié ni temps de calcul, ni score de qualité, ni comparaison côte à côte avec le modèle à 40 pas.
Ce que changent concrètement 8 pas au lieu de 40
Un modèle de diffusion construit une image en retirant du bruit par passes, et chaque pas est une passe dans le modèle 7B. Turbo fait 8 passes là où les exemples officiels du modèle de base en font 40 : le modèle d’image effectue donc 80 % de passes en moins par image.
Ce n’est pas la même chose que « cinq fois plus rapide ». Une requête complète encode aussi votre prompt et les éventuelles images de référence, décode le résultat en pixels et, sur une API hébergée, attend dans une file. Ces étapes ne diminuent pas avec le nombre de pas, et Qwen n’a publié aucun temps de traitement. Sur SpicyAPI, nos requêtes Turbo ont pris de 13 à 39 secondes en texte vers image et de 26 à 59 secondes en retouche, de bout en bout. L’expansion du prompt ajoute du temps, parce que la réécriture passe avant le premier pas : en 1K, nos générations texte vers image sans expansion se sont terminées en 13 à 21 secondes.
Ce que cela change pour vous :
- Itération. Modifier une expression du prompt et regarder à nouveau, de nombreuses fois en une séance, au lieu de s’engager dans un long rendu par idée.
- Lots. Générer plusieurs prises d’un même brief et garder la meilleure. Sur SpicyAPI, une requête renvoie jusqu’à six images, chacune facturée. Choisir dans un lot de brouillons, c’est le flux pour lequel un modèle à peu de pas est conçu.
- Du brouillon au final. Fixer la composition, la tenue et la lumière avec Turbo, puis décider si l’image retenue a vraiment besoin du modèle à 40 pas.
- Votre facture de GPU. Quand vous exécutez vous-même les poids, moins de passes veut dire moins de temps de GPU par image. Sur une API hébergée, vous payez à l’image et non au pas : l’économie se lit donc dans la grille tarifaire, CNY 0.10 pour Turbo contre CNY 0.25 pour Pro sur l’API d’Alibaba, et sur SpicyAPI Turbo coûte moins cher par image que Qwen Image 2.1.
Turbo, 2.1 ou 2.1 Pro : lequel choisir
Les trois appartiennent à la même génération Qwen Image 2.1 : le choix dépend donc du nombre d’images que vous produisez, de l’exigence de chacune et de l’endroit où vous l’exécutez.
- Choisissez Turbo pour le volume et l’itération : ébaucher des compositions, tester la formulation d’un prompt, générer de nombreuses variantes et en retenir une. Un cinquième des passes par image, c’est tout l’intérêt.
- Choisissez le 2.1 de base quand une seule image doit être juste, ou qu’il faut un outil absent de Turbo : un masque pour ne modifier qu’une zone, l’option de fond transparent, ou une sortie JPEG et WebP. Les retouches multi-références difficiles et le petit lettrage dense sont les autres cas délicats : les versions à peu de pas de ce modèle y ont peiné, et la fiche du turbo de Viggle, par exemple, signale des personnages dupliqués, une dérive d’identité et du petit texte déformé. Qwen n’a publié aucune comparaison de qualité pour le Turbo officiel. Dans nos essais, Turbo a gardé les deux visages reconnaissables dans une composition à partir de deux portraits et a écrit deux courtes lignes d’affiche sans une faute : commencez donc par Turbo et ne passez une image au 2.1 que si elle ne suffit pas.
- Envisagez Pro quand le lettrage et les portraits comptent. Qwen Image 2.1 Pro est le niveau hébergé supérieur d’Alibaba, à CNY 0.25 par image contre CNY 0.10 pour Turbo sur l’API d’Alibaba, et Alibaba lui attribue une typographie, un éclairage de portrait et un détail fin améliorés. Depuis le 14 octobre, il est aussi disponible sur SpicyAPI avec la même requête que Turbo, en texte vers image et en retouche. Alibaba n’a pas publié de comparaison côte à côte de Pro, de Turbo et du modèle de base : lancez donc quelques-uns de vos propres prompts sur les deux avant d’engager un budget.
- Ne comptez pas sur le report d’un seed. Un seed fixe le bruit de départ pour un checkpoint et un calendrier donnés. Le même seed sur Turbo et sur 2.1 donne deux images différentes : gardez donc le fichier qui vous plaît plutôt que le seed.
Le flux pratique : ébaucher avec Turbo, garder le prompt qui a marché, et rendre l’image finale sur 2.1 si la version de Turbo ne suffit pas. Notre guide de Qwen Image 2.1 propose des prompts qui fonctionnent sur le modèle de base, avec des exemples.
Comment écrire des prompts pour Qwen Image 2.1 Turbo
La plupart sont des règles générales pour les modèles d’image à peu de pas et pour Qwen Image 2.1 ; la dernière vient de nos tests de Turbo. Un modèle qui travaille en 8 passes a moins de marge pour deviner ce que vous vouliez dire : dites-le.
- Nommez six éléments, dans cet ordre : qui, ce que la personne porte, une pose, la lumière, l’objectif, la palette. Tout ce que vous omettez reçoit une valeur par défaut banale.
- Une scène par prompt. Deux ambiances ou deux lieux dans une phrase reviennent généralement comme un compromis entre les deux.
- Décrivez la lumière comme des sources. « Une seule lampe de chevet chaude à droite, le reste de la pièce dans l’ombre » fonctionne mieux que « éclairage tamisé ».
- Pour du texte dans l’image, mettez les mots exacts entre guillemets et dites où ils se placent (« un titre d’affiche qui dit ’LATE SHOW’ en haut »).
- Pour les retouches, écrivez d’abord le changement, puis ce qu’il faut garder. « Change sa robe en satin émeraude. Garde son visage, ses cheveux, sa pose, le lit et la lumière de la lampe tels quels. »
- Avec plusieurs images de référence, dites ce qu’apporte chacune : la personne depuis la première image, la veste depuis la deuxième, la pièce depuis la troisième.
- Sur SpicyAPI, décidez de l’expansion du prompt. Sur Turbo, elle est désactivée par défaut : vos mots sont dessinés tels quels. Sur Qwen Image 2.1, elle est activée par défaut. Activez-la pour un prompt court du quotidien que vous voulez étoffer. Laissez-la désactivée quand votre prompt fixe déjà la lumière, l’objectif et la palette, ainsi que pour les prompts pour adultes : la réécriture d’Alibaba les adoucit et, en retouche, peut supprimer purement et simplement l’instruction (voir la section sur le contenu plus bas).
Faible : « une femme en robe dans une chambre ».
Solide :
Photographie d’une femme d’une trentaine d’années en nuisette de soie noire au dos bas, une bretelle tombée de l’épaule, assise au bord d’un lit défait et regardant par-dessus son épaule. Une seule lampe de chevet chaude à droite, le reste de la pièce dans l’ombre. Objectif 85mm, faible profondeur de champ, léger grain argentique, palette sang-de-bœuf, noir et miel.
La version faible laisse au modèle la tenue, la pose, la lumière et l’objectif. La version solide décide de chacun, ce qui est exactement ce qu’on veut quand on itère vite en comparant des brouillons.
Ce que Turbo sait produire : tailles 2K, PNG transparents, retouche et affiches
La vitrine de Qwen pour Turbo couvre le même terrain que le modèle de base. Voici ce que signifie chaque volet sur SpicyAPI, avec ce que nous avons vu dans nos propres essais.
Tailles 2K. Voici les tailles 2K que Turbo a renvoyées sur SpicyAPI. Elles diffèrent légèrement des préréglages des exemples du modèle de base de Qwen :
| Format | Taille en pixels | Pour |
|---|---|---|
| 1:1 | 2048 × 2048 | Photos de profil, vignettes produit, pochettes d’album |
| 4:3 | 2368 × 1760 | Cadres photo classiques, diapositives |
| 3:2 | 2496 × 1664 | Photographie de paysage, en-têtes de blog |
| 2:3 | 1664 × 2496 | Affiches, couvertures de livres et de magazines |
| 16:9 | 2688 × 1536 | Bannières, miniatures, fonds d’écran de bureau |
| 9:16 | 1536 × 2688 | Stories, fonds d’écran de téléphone, publicités verticales |
Turbo accepte un format d’image, quinze au total, plus un palier 1k, 1.5k ou 2k, et tous les paliers coûtent le même prix : 2K est donc le réglage par défaut. Sans format indiqué, une retouche suit la forme de l’image source à environ 2K : nos sources en 1024 × 1536 sont revenues en 1680 × 2512 ou 1664 × 2496.
Images transparentes. Les exemples de Qwen incluent des résultats transparents (RGBA) : un produit ou un personnage sans arrière-plan, prêt à être posé sur une mise en page. Sur SpicyAPI, Turbo n’a pas d’option d’arrière-plan et renvoie toujours des fichiers PNG. Selon Alibaba, un prompt qui demande un fond transparent ou un autocollant renvoie un PNG avec canal alpha ; nous ne l’avons pas vérifié. Quand le détourage doit fonctionner, utilisez Qwen Image 2.1, où régler background sur transparent avec une sortie PNG ou WebP en produit un.
Retouche et plusieurs références. Turbo retouche à partir de consignes simples, de l’ajout d’un accessoire au changement de toute la scène. Sur SpicyAPI, il accepte une à dix images de référence par retouche ; dans le prompt, appelez-les Image 1, Image 2, etc. L’image en tête de cet article vient de deux portraits séparés, un homme sur un toit et une chanteuse en robe de velours, et les deux visages sont restés reconnaissables. Il n’y a pas de masque : décrivez avec des mots la zone à modifier et dites ce qui doit rester.
Affiches, typographie et mises en page. La vitrine comprend typographie, affiches, écrans d’interface et infographies. Qwen ne donne aucun chiffre de précision. Dans notre test d’affiche, les deux lignes entre guillemets sont sorties lettre pour lettre, mais les notes de Viggle sur sa propre version à peu de pas disent que le petit texte se brise plus souvent qu’avec le modèle de base : vérifiez le lettrage en taille réelle avant d’imprimer ou de publier.
API Qwen Image 2.1 Turbo : où l’appeler et ce qu’elle coûte
L’API hébergée d’Alibaba Cloud. Qwen a annoncé les API Turbo et Pro le jour du lancement. La page de prix officielle indique le prix d’origine, hors promotions, par image :
| Modèle | Pékin, États-Unis (Virginie), Francfort, Tokyo, Hong Kong | Singapour | Limite de débit |
|---|---|---|---|
| Qwen Image 2.1 Turbo | CNY 0.10 | CNY 0.113362 | 20 requêtes par minute |
| Qwen Image 2.1 Pro | CNY 0.25 | CNY 0.283404 | 20 requêtes par minute |
Alibaba n’affiche ces prix qu’en yuans. Turbo coûte 40 % du prix de Pro.
SpicyAPI. Turbo est disponible ici depuis le 13 octobre 2026 sous forme de deux endpoints, texte vers image et retouche. Il coûte $0.0144 l’image, le même prix en 1k, 1.5k et 2k, et le même pour une retouche avec une image de référence ou dix. Vous payez chaque image renvoyée : une requête de six images coûte donc six fois ce montant. Une requête accepte un prompt jusqu’à 5 000 caractères, une à six images en sortie, quinze formats d’image, un palier 1k, 1.5k ou 2k, l’expansion du prompt (désactivée par défaut ; une fois activée, un mode réflexion optionnel et, en texte vers image, une réécriture direct ou agent) et une seed ; les retouches ajoutent une à dix images de référence. La sortie est toujours en PNG. Il n’y a ni masque, ni prompt négatif, ni choix du format de sortie.
À titre de comparaison, Qwen Image 2.1 coûte $0.024 par image en 1k et $0.048 en 2k en texte vers image, et ses retouches commencent à $0.036. Passer une intégration de 2.1 à Turbo revient surtout à changer le nom du modèle. Turbo ajoute num_outputs, enable_thinking et, en texte vers image, prompt_optimization_mode ; il n’a pas background ni output_format, et son endpoint de retouche n’a pas mask_url. Les deux modèles rejettent les champs qu’ils ne connaissent pas : retirez-les lors du changement.
Une requête texte vers image minimale :
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "alibaba/qwen-image-2.1-turbo/text-to-image",
    "input": {
      "prompt": "Golden-hour photograph of an adult man in his thirties on a whitewashed balcony on a Greek island, white linen shirt open, leaning on a blue railing with a glass of white wine, 85mm, medium-format film look.",
      "aspect_ratio": "4:5",
      "resolution": "2k",
      "num_outputs": 2
    }
  }'
Exécuter les poids ouverts : Hugging Face, Diffusers et GGUF
Les poids officiels sont Qwen/Qwen-Image-2.1-Turbo sur Hugging Face et ModelScope, publiés le 9 octobre 2026 en BF16. Le checkpoint se charge avec QwenImage21Pipeline. Il faut Diffusers installé depuis les sources (il s’appuie sur des sigmas d’échantillonnage configurés par le pipeline, ajoutés dans la PR #14950), transformers>=5.17.0, accelerate, pillow et une build CUDA de PyTorch.
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1-Turbo", dtype=torch.bfloat16
).to("cuda")

image = pipe(
    prompt="Studio portrait of an adult woman in a charcoal wool coat, one warm key light from the left, 85mm, shallow depth of field",
    width=2048,
    height=2048,
    use_kv_cache=True,
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]
image.save("turbo.png")
Trois points sur lesquels la fiche du modèle est précise :
- Vous ne réglez pas les pas. Le calendrier recommandé de 8 pas est livré avec le checkpoint et se charge automatiquement. Régler
num_inference_stepsseul ne le remplace pas. Passer dessigmasexplicites le fait, mais Qwen précise que les autres calendriers n’ont pas été évalués. - Le CFG vaut 1 par défaut : il n’y a donc pas d’échelle de guidage à régler dans les exemples officiels.
- La retouche utilise le même pipeline : passez l’image source en
image=avec une consigne de retouche et la taille de sortie. L’exemple officiel ouvre l’image d’entrée avec.convert("RGBA").
Pour width et height, les exemples de Qwen utilisent 2048 × 2048 pour un carré et 1696 × 2528 pour un portrait. La fiche n’indique pas de VRAM requise ; les poids représentent 7B de paramètres en BF16.
Les GGUF pour ComfyUI et stable-diffusion.cpp
Qwen ne publie que le checkpoint BF16. Les fichiers GGUF sont des builds communautaires, et plusieurs sont apparus dans la journée suivant la sortie, comme unsloth/Qwen-Image-2.1-Turbo-GGUF et AtomicChat/Qwen-Image-2.1-Turbo-GGUF sur Hugging Face. Unsloth recommande son fichier 4 bits Q4_K_M (4,2 Go) pour la plupart des GPU et Q8_0 (7,6 Go) pour un rendu au plus près du BF16. Trois choses à savoir avant d’en télécharger un :
- Un GGUF ne contient que le modèle d’image. Il vous faut encore l’encodeur de texte Qwen3-VL-8B et le VAE de Qwen Image 2.1, les mêmes que pour le modèle de base.
- Gardez le planning de Turbo : 8 pas, CFG 1 et la liste de sigmas fournie dans le checkpoint. ComfyUI charge ces fichiers avec les nœuds ComfyUI-GGUF ; stable-diffusion.cpp prend les sigmas en ligne de commande.
- La licence suit le fichier. Une fois quantifié, c’est toujours Qwen-Image-2.1-Turbo sous Qwen Research License.
Le téléchargement le plus connu avec « Uncensored » dans son nom est autre chose. Le Qwen-Image-2.1-Turbo-Uncensored-GGUF d’AtomicChat est l’encodeur de texte dont on a retiré le comportement de refus, associé au modèle d’image Turbo inchangé. Sa fiche indique que le pipeline standard à poids ouverts n’a pas de filtre de contenu et que, sur 45 prompts de test sensibles, l’encodeur modifié n’a changé aucun résultat.
Auto-héberger les poids ouverts ou appeler une API ?
| Exécuter vous-même les poids ouverts | Appeler une API hébergée | |
|---|---|---|
| Licence | Qwen Research License ; à lire avant tout usage commercial | Les conditions du fournisseur |
| Matériel | Un GPU CUDA avec de la place pour 7B de paramètres en BF16 (environ 14 Go de poids) plus les activations 2K, ou un GGUF 4 bits d’environ 4 Go plus l’encodeur de texte et le VAE | Aucun |
| Mise en place | Diffusers depuis les sources, transformers>=5.17.0, et suivre les évolutions du pipeline | Une clé d’API |
| Coût | Du temps de GPU, que moins de pas réduit directement | À l’image : prix unique sur SpicyAPI, CNY 0.10 sur l’API d’Alibaba |
| Règles de contenu | Les vôtres ; les poids ouverts n’ont pas de filtre de contenu | Celles du fournisseur ; SpicyAPI n’ajoute aucun filtre propre et laisse l’expansion du prompt de Turbo désactivée par défaut |
| Montée en charge | Autant de GPU que vous en faites tourner | Alibaba indique 20 requêtes par minute |
Exécutez vous-même les poids pour la recherche, pour expérimenter avec des LoRA et des calendriers d’échantillonnage, ou quand les images ne peuvent pas quitter votre machine. Utilisez une API quand vous livrez un produit, que vous ne voulez pas maintenir de GPU ou que vous avez besoin d’images dès aujourd’hui sans mise en place.
Turbo officiel contre le turbo de Viggle
Avant le 9 octobre, « Qwen Image 2.1 turbo » désignait des accélérations communautaires. La plus connue est celle de Viggle, et d’autres circulent sous des noms voisins. Ce n’est pas le même type de fichier :
| Qwen-Image-2.1-Turbo (officiel) | Qwen-Image-2.1-viggle-turbo (communautaire) | |
|---|---|---|
| Auteur | L’équipe Qwen d’Alibaba | Viggle |
| Ce que vous téléchargez | Un checkpoint complet | Un LoRA chargé sur le modèle 2.1 de base (fichiers fusionnés int8, fp8 et GGUF également proposés) |
| Pas | 8 | 6, ou un mode à 9 pas ajouté dans la v0.3 |
| Guidage | CFG 1 par défaut | Pas de classifier-free guidance |
| Images de référence pour la retouche | Non indiqué par Qwen ; 1 à 10 sur SpicyAPI | 1 à 3 |
| Dernière version | 9 octobre 2026 | v0.3, 29 septembre 2026 |
| Licence | Qwen Research License | Qwen Research License (indiquée comme non commerciale) |
Viggle annonce son mode à 6 pas environ cinq fois plus rapide que le modèle de base à 40 pas de bout en bout, et son mode à 9 pas à environ 1,4 à 1,5 fois le temps du mode à 6 pas. Sa fiche énumère aussi les compromis : silhouettes dupliquées ou fantômes et dérive d’identité dans les retouches compliquées, petit texte brouillé plus souvent que sur le modèle de base, et couleurs moins saturées de quelques points. Ces remarques décrivent le LoRA de Viggle, pas le Turbo officiel, qui n’a pas encore de comparaison publiée. Si vous faites tourner la version communautaire dans ComfyUI, vérifiez le nombre de pas utilisé par votre workflow : les réglages recommandés diffèrent selon les versions et les builds quantifiées.
Qwen Image 2.1 Turbo est-il non censuré ?
Sur SpicyAPI, oui, tant que l’expansion du prompt reste désactivée. Le 13 octobre 2026, nous avons envoyé à Turbo 23 requêtes couvrant toute notre échelle, de la lingerie à une scène de contention consentie entre adultes et à une scène de violence cinématographique, et aucune n’a été refusée. Expansion désactivée, tout est revenu tel qu’écrit, sauf une scène intime entre deux adultes sur deux ; expansion activée, le réécrivain de prompts d’Alibaba a adouci trois requêtes et renvoyé deux retouches sans aucun changement.
Les résultats des tests de contenu et les réglages conseillés figurent aussi sur la page du modèle Qwen Image 2.1 Turbo ; ce que changent vraiment les téléchargements « GGUF non censurés » est expliqué dans la section GGUF plus haut. SpicyAPI n’ajoute aucun filtre de contenu propre.
Peut-on utiliser Turbo à titre commercial ?
Les poids ouverts sont publiés sous la Qwen Research License Agreement, la même licence que Qwen Image 2.1 de base. La fiche de Viggle, qui utilise la même licence, la décrit comme un usage non commercial à des fins de recherche ou d’évaluation, l’usage commercial exigeant une licence distincte auprès du concédant. Si vous comptez exécuter les poids sur votre propre GPU dans un produit commercial, lisez d’abord la licence. Une API hébergée relève d’un autre cadre, couvert par les conditions de son fournisseur.
Les questions qu’on pose sur Qwen Image 2.1 Turbo
Quand Qwen Image 2.1 Turbo est-il sorti ?
Le 9 octobre 2026, avec des poids ouverts sur Hugging Face et ModelScope et des API Turbo et Pro hébergées sur Alibaba Cloud le même jour.
Qwen Image 2.1 Turbo est-il gratuit ?
Les poids se téléchargent gratuitement, sous licence de recherche. Les exécuter demande tout de même un GPU capable. L’API hébergée d’Alibaba facture CNY 0.10 par image, et SpicyAPI un prix unique par image, quelle que soit la taille.
Qwen Image 2.1 Turbo est-il open source ?
Ses poids sont ouverts : vous pouvez les télécharger et les exécuter. La licence est la Qwen Research License, pas une licence open source comme Apache 2.0 ; « poids ouverts » est donc le terme exact.
Puis-je utiliser Qwen Image 2.1 Turbo pour un travail commercial ?
Pour les poids auto-hébergés, lisez d’abord la Qwen Research License : c’est une licence de recherche, et Viggle décrit la même licence comme non commerciale. Via une API hébergée, ce sont les conditions de son fournisseur qui s’appliquent.
Combien de pas utilise Qwen Image 2.1 Turbo, et puis-je le changer ?
Huit. Le calendrier se charge avec le checkpoint ; seuls des sigmas explicites le remplacent, et Qwen n’a pas évalué d’autres calendriers.
Existe-t-il une version GGUF de Qwen Image 2.1 Turbo ?
Pas chez Qwen, qui publie des poids BF16. Des GGUF communautaires sont apparus sur Hugging Face en moins d’une journée, par exemple chez Unsloth et AtomicChat. Ils s’utilisent avec l’encodeur de texte Qwen3-VL et le VAE, et avec le planning en 8 pas et CFG 1.
Qwen Image 2.1 Turbo sait-il retoucher des images ?
Oui. Il retouche à partir d’instructions en langage naturel, de l’ajout d’un accessoire au changement de toute la scène. Sur SpicyAPI, une retouche accepte une à dix images de référence, et le résultat garde la forme de la source si vous n’indiquez pas de format.
Qwen Image 2.1 Turbo gère-t-il les fonds transparents ?
La vitrine de Qwen inclut des images transparentes (RGBA), et selon Alibaba un prompt qui demande un fond transparent renvoie un PNG avec canal alpha. Nous ne l’avons pas vérifié sur Turbo, qui n’a pas d’option d’arrière-plan sur SpicyAPI. Pour un détourage garanti, utilisez Qwen Image 2.1 avec background réglé sur transparent.
Quelle résolution Qwen Image 2.1 Turbo génère-t-il ?
La 2K : 2048 × 2048 pour un carré et 2688 × 1536 en 16:9 au palier 2K de SpicyAPI, avec quinze formats et des paliers 1k et 1.5k au même prix.
Qwen Image 2.1 Turbo ou Pro : lequel utiliser ?
Sur l’API d’Alibaba, Turbo coûte CNY 0.10 par image et Pro CNY 0.25. Alibaba n’a pas publié de comparaison : essayez les deux sur vos propres prompts. Les poids de Turbo sont aussi ouverts, vous pouvez donc l’exécuter vous-même.
Qwen Image 2.1 Turbo est-il le même que le turbo de Viggle ?
Non. Le Turbo officiel est un checkpoint complet de Qwen avec un calendrier de 8 pas. Celui de Viggle est un LoRA communautaire posé sur le modèle de base, qui tourne en 6 ou 9 pas.
Qwen Image 2.1 Turbo est-il non censuré ?
Sur SpicyAPI, oui, avec l’expansion du prompt désactivée : aucune de nos 23 requêtes de test n’a été refusée. Avec l’expansion activée, le réécrivain d’Alibaba a adouci les prompts pour adultes. Les détails sont dans la section sur le contenu plus haut.
Peut-on utiliser Qwen Image 2.1 Turbo par API ?
Oui. Alibaba Cloud le propose, et sur SpicyAPI il est disponible depuis le 13 octobre 2026 en texte vers image et en retouche ; le prix en direct s’affiche avant l’envoi.
En résumé
Qwen Image 2.1 Turbo est la version rapide officielle d’un modèle que vous utilisez peut-être déjà : même architecture 7B, même retouche, sortie 2K, en 8 pas. Sur SpicyAPI, il est disponible, coûte moins cher par image que Qwen Image 2.1, renvoie jusqu’à six images par requête et garde l’expansion du prompt désactivée par défaut. Utilisez-le pour les brouillons, le volume et les compositions, passez une image au modèle de base en 40 pas quand il vous faut un masque, un détourage transparent garanti ou des fichiers JPEG et WebP, et vérifiez la licence de recherche avant de bâtir un produit sur les poids ouverts. Commencez par la page texte vers image de Turbo.