Introdução
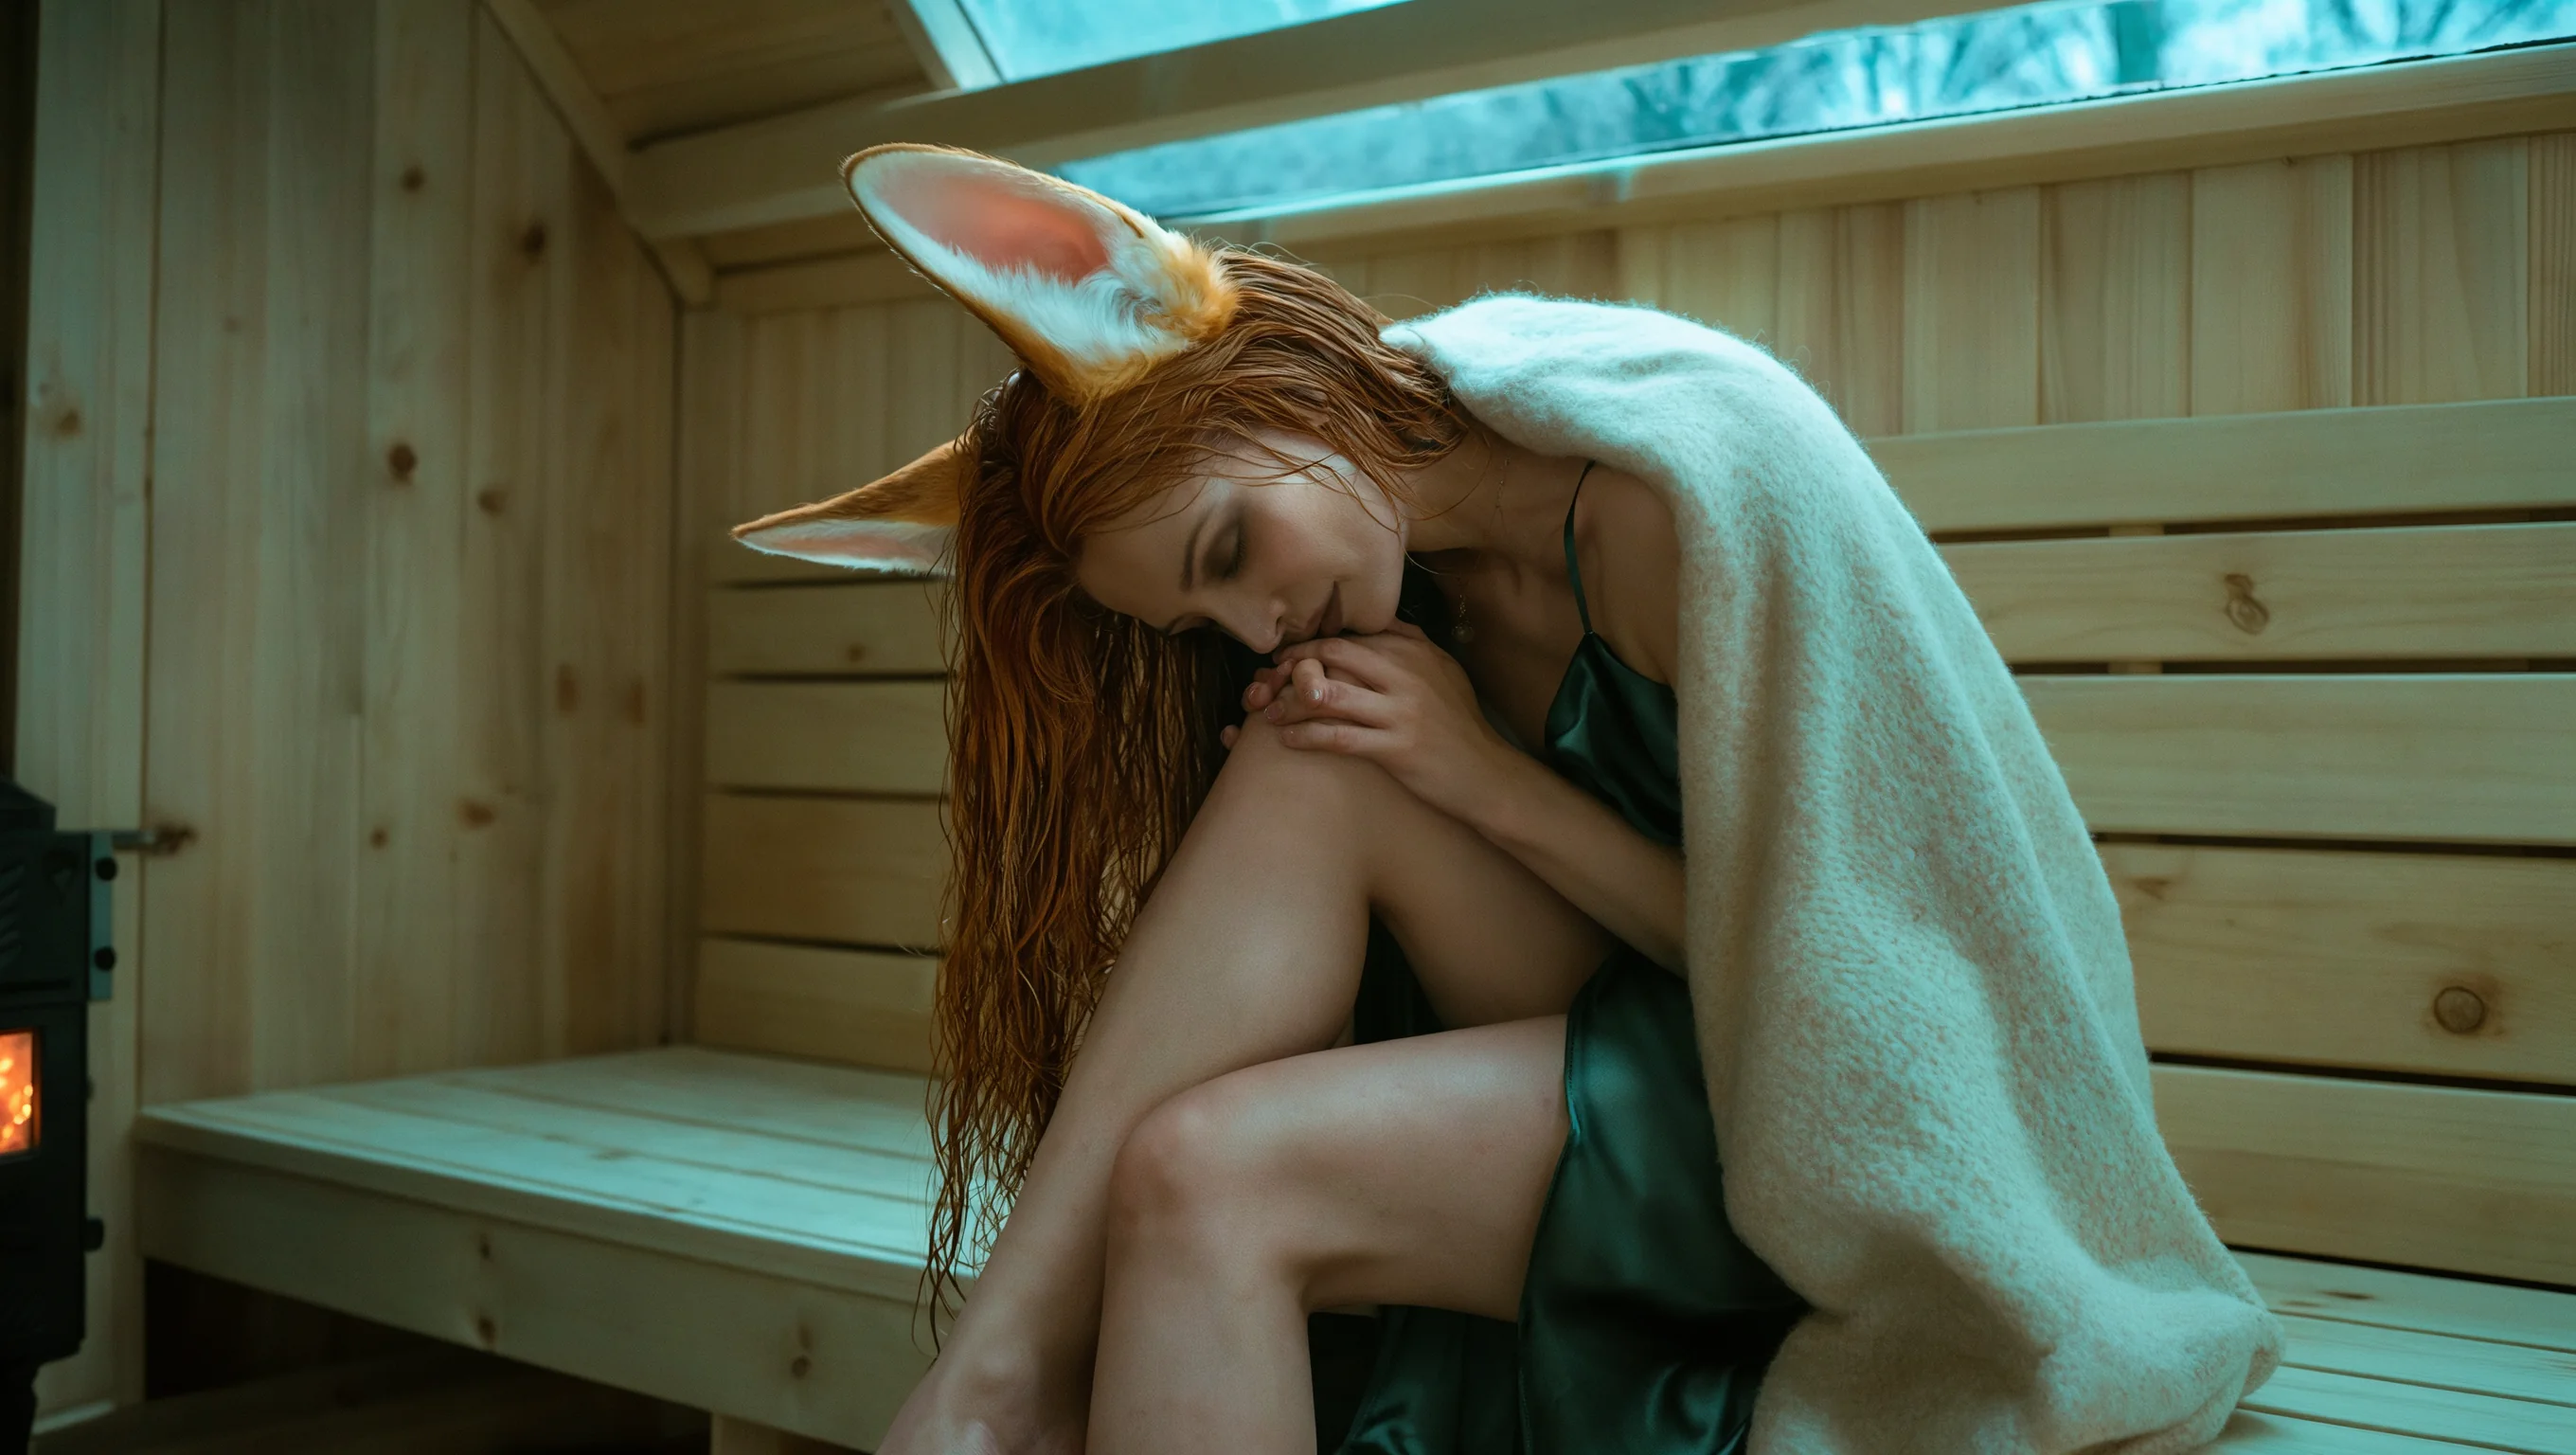
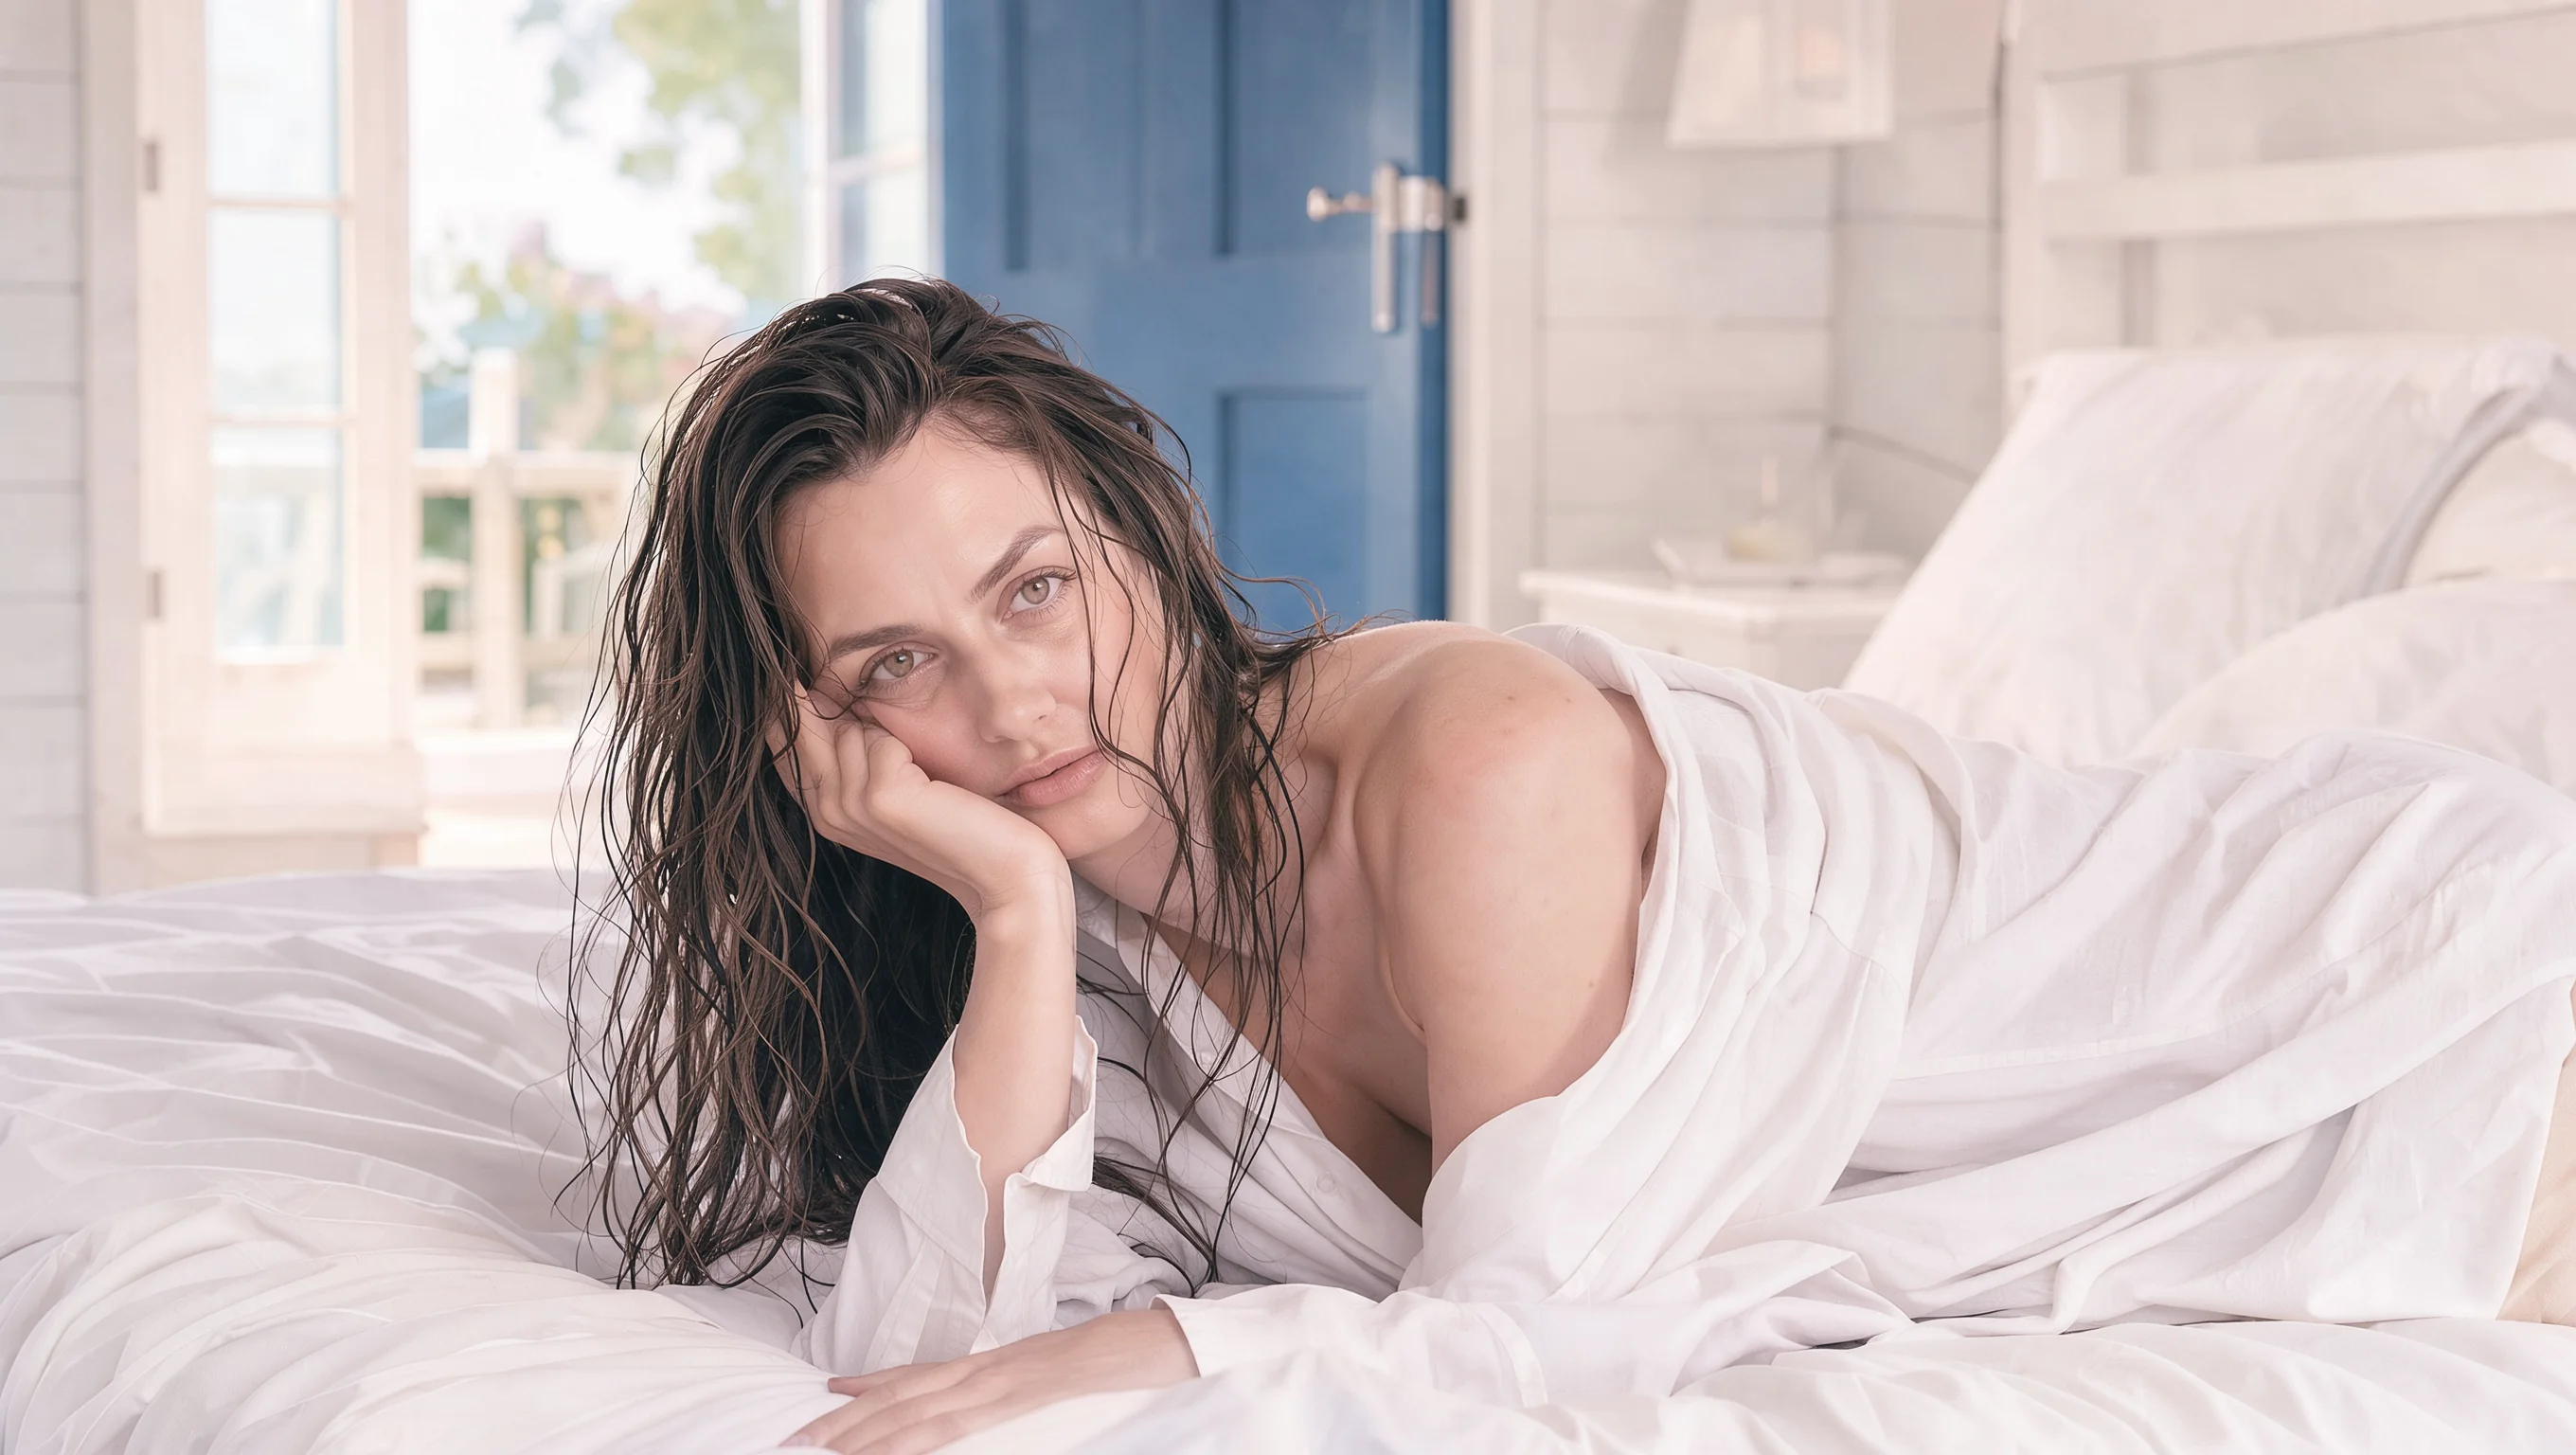
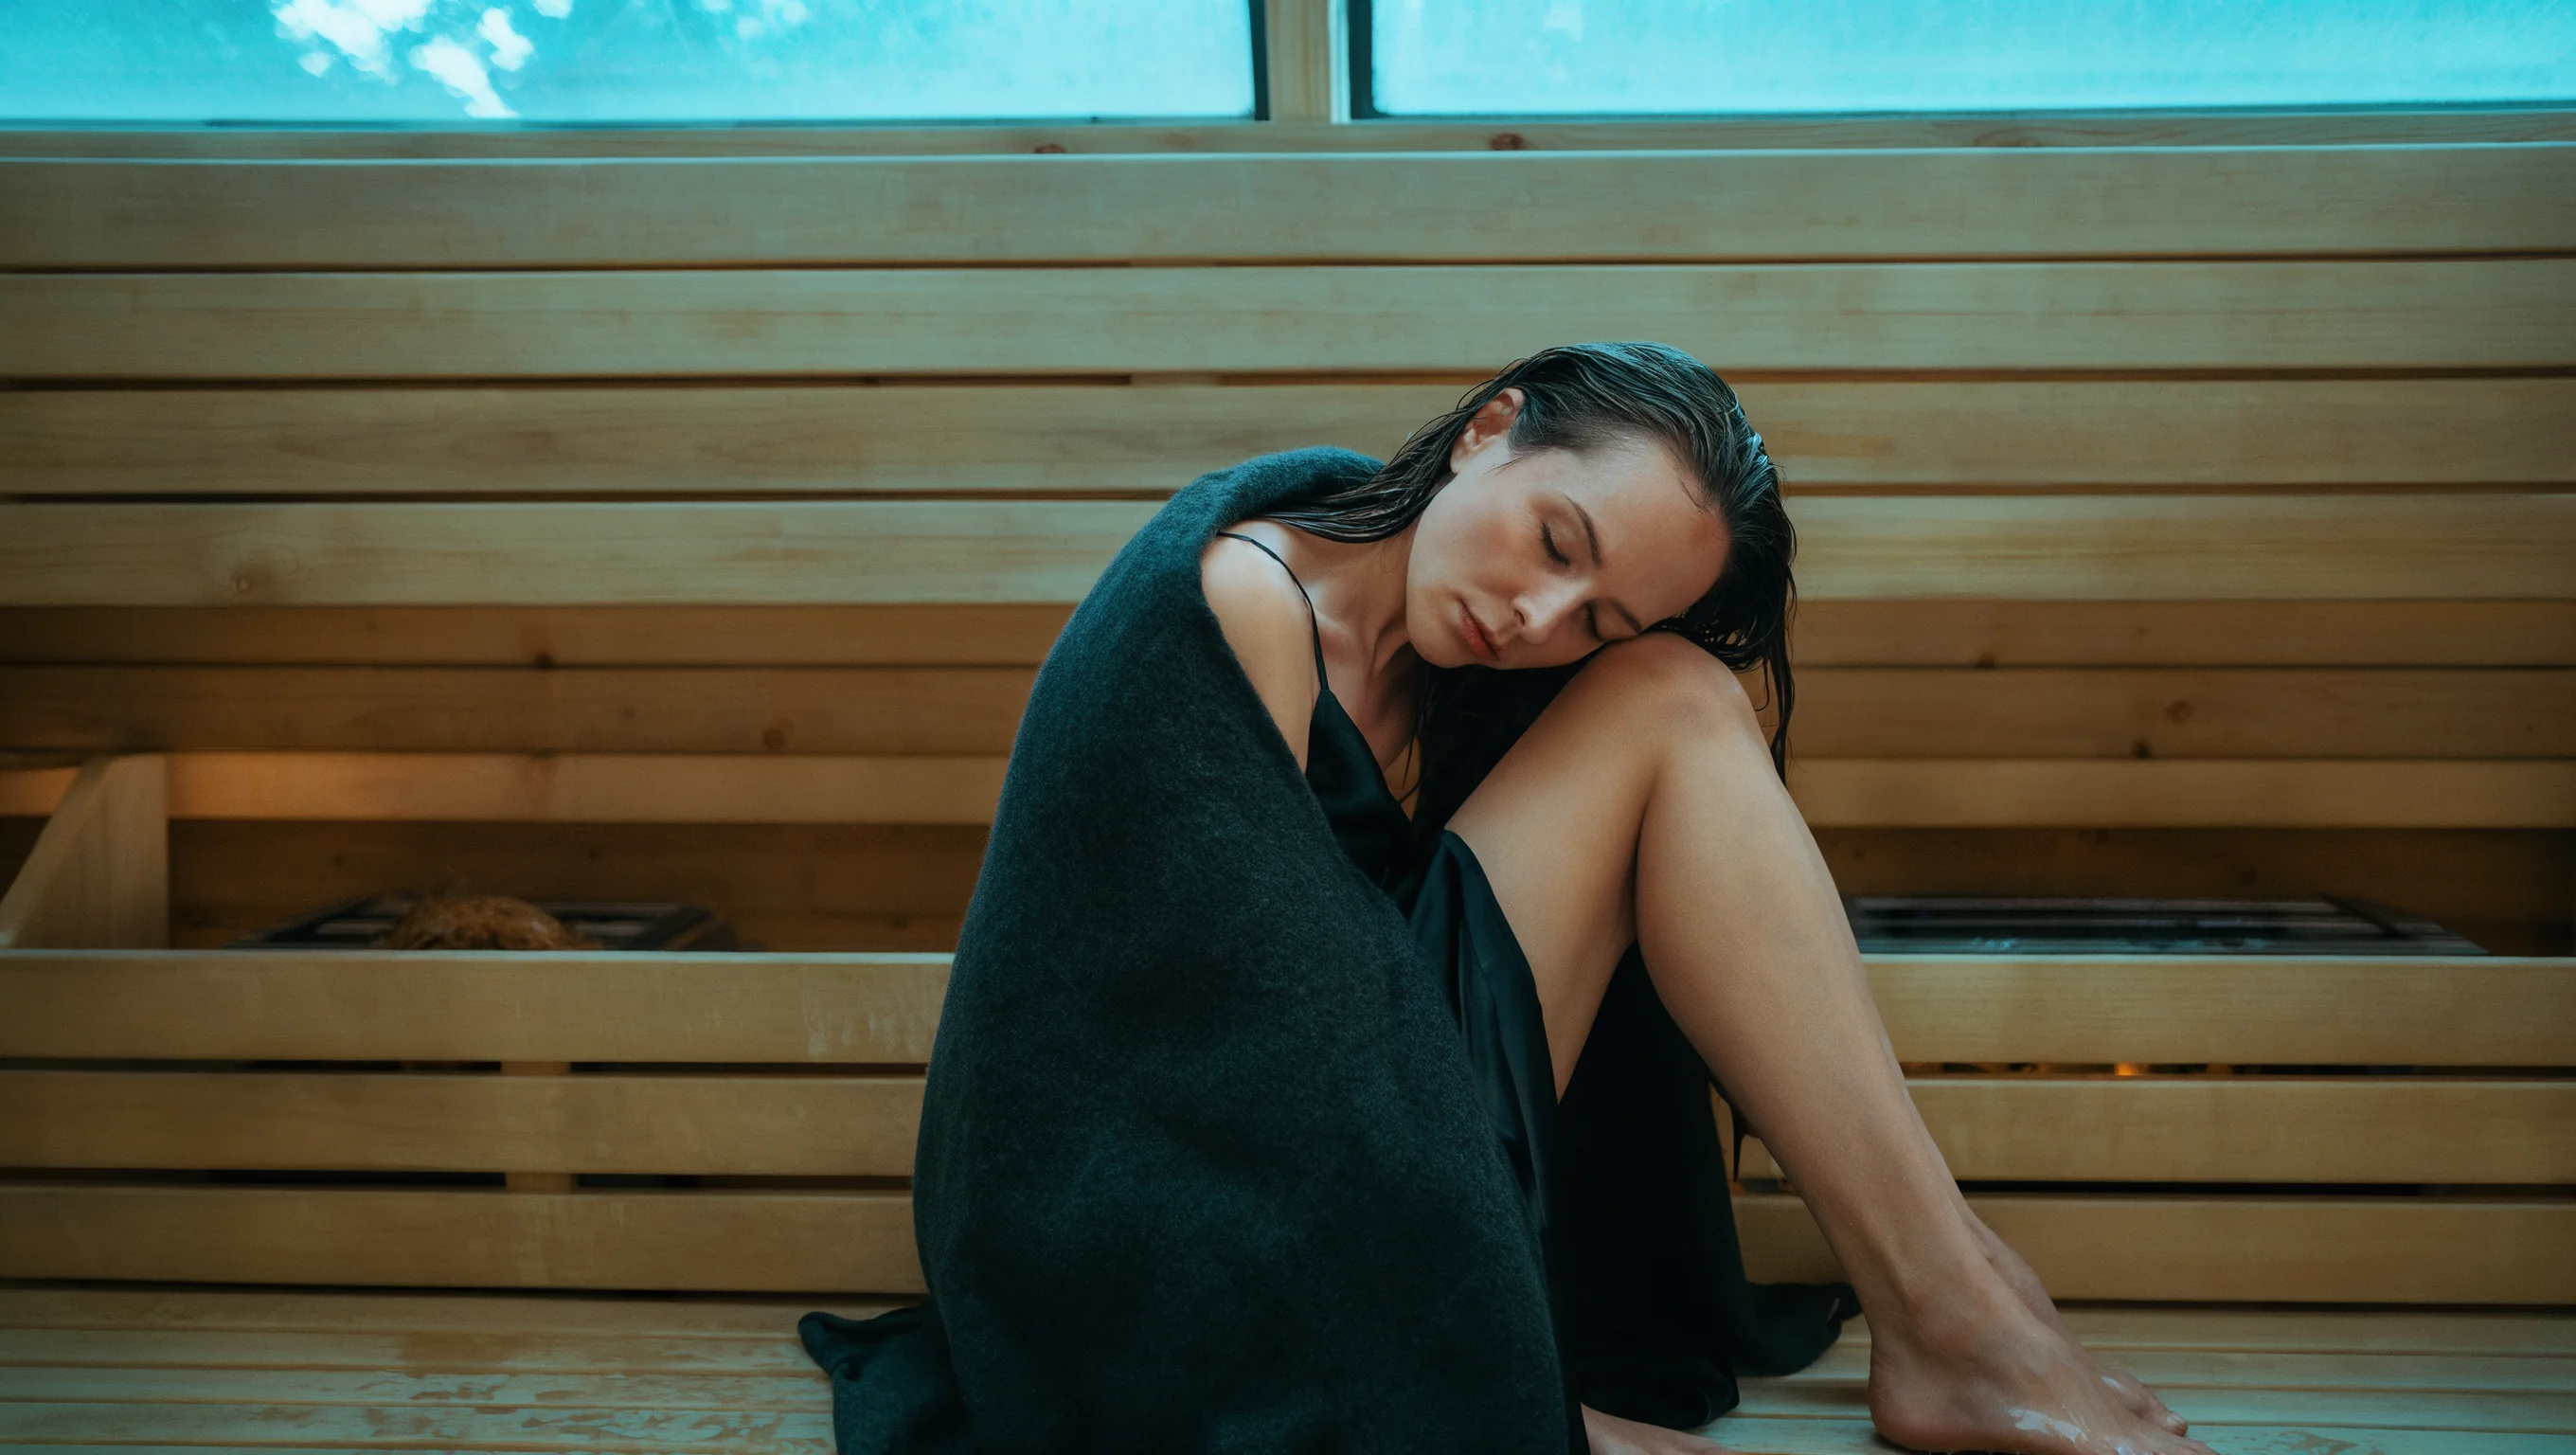
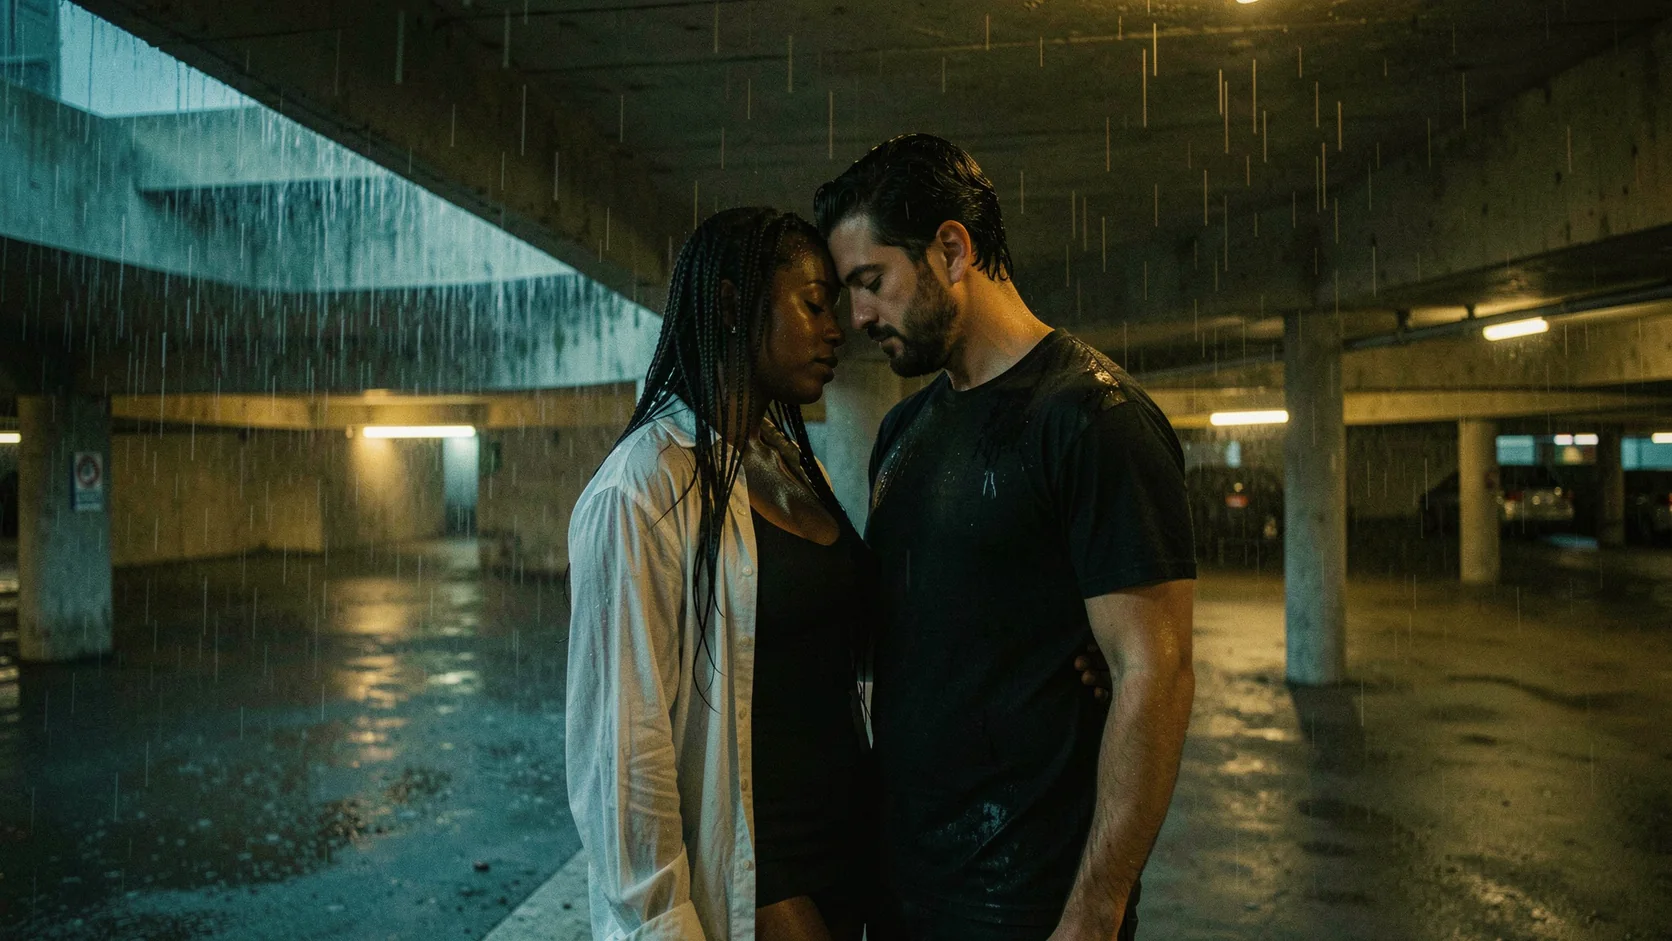
FLUX.1 Dev LoRA Texto para imagem cria uma imagem a partir de um prompt escrito no FLUX.1 [dev] da Black Forest Labs, um rectified flow transformer de 12 bilhões de parâmetros, com até três arquivos LoRA seus carregados. Escolha qualquer uma das nove proporções com cerca de um megapixel, ajuste o guidance e receba JPEG, PNG ou WebP a um preço fixo. A plataforma não acrescenta nenhum filtro de conteúdo ao prompt, aos pesos nem à imagem.
Escolha o modo pelo material de partida
| O que você tem | Modo |
|---|---|
| uma descrição escrita e um LoRA de FLUX | FLUX.1 Dev LoRA Texto para imagem |
| uma imagem para mudar de estilo | FLUX.1 Dev LoRA Edição de imagem |
Recursos e destaques
A maior biblioteca de LoRAs entre os modelos de imagem abertos
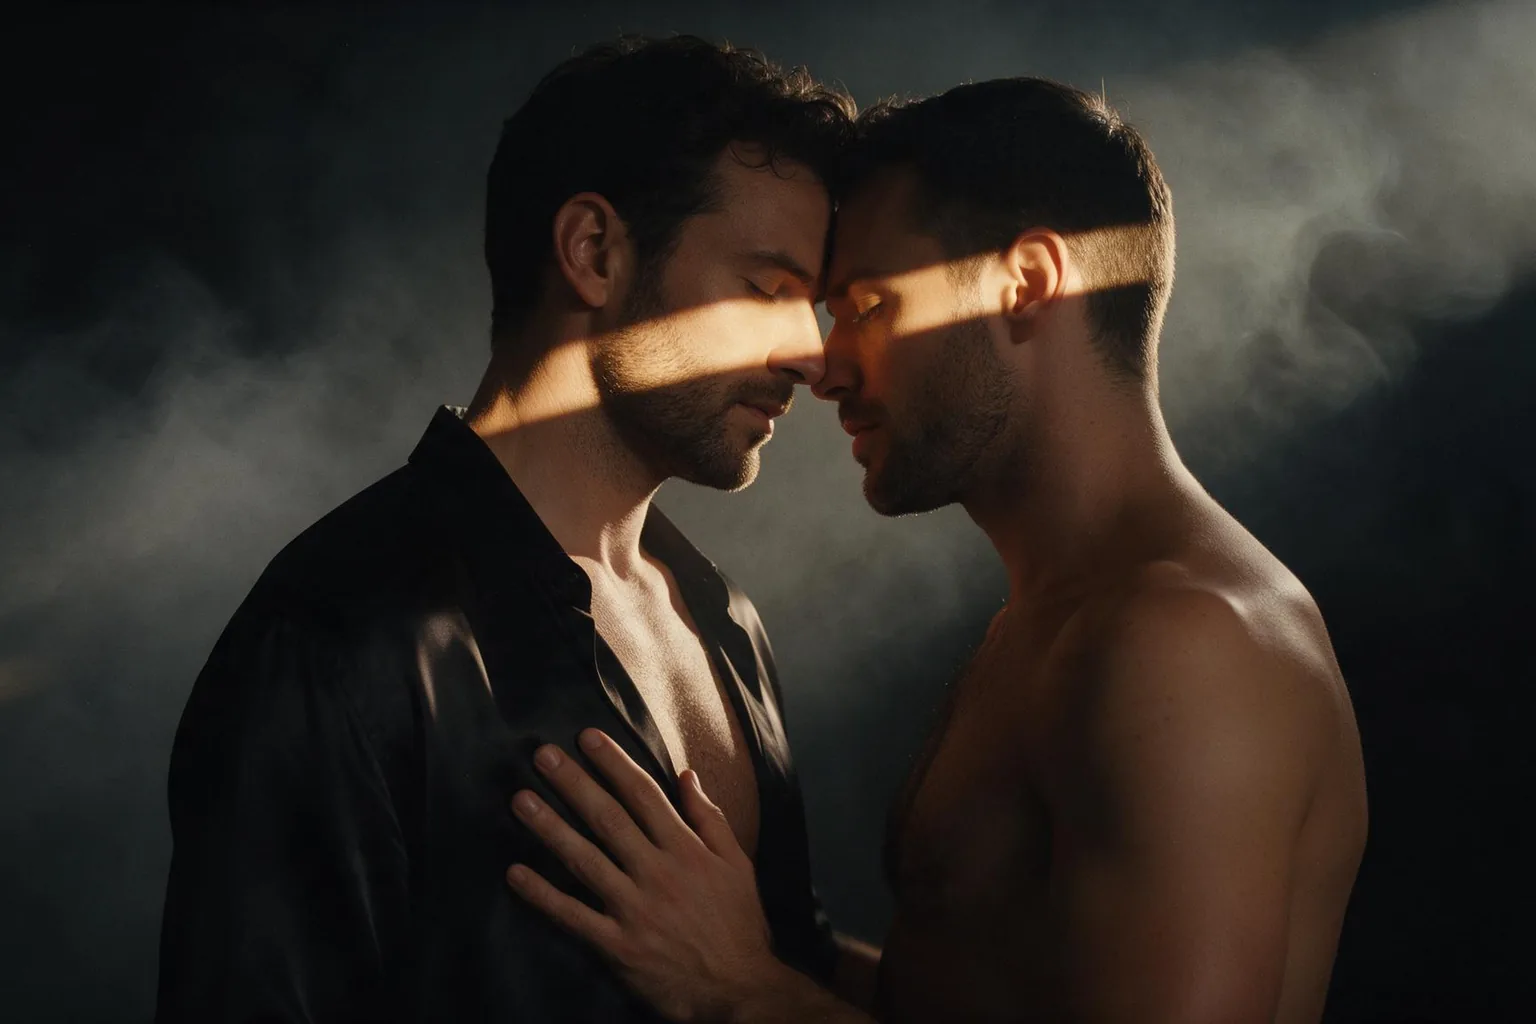
O Hugging Face reúne mais de mil LoRAs baseados em FLUX.1 [dev]: realismo, moda, emulações de filme, cartuns, personagens e estilos sem filtro. Se você encontrou um visual de que gosta, é bem provável que seja um LoRA de FLUX, e aqui ele roda como uma simples chamada de API.
Um guidance que você pode ajustar
O guidance define o quanto a imagem segue o prompt à risca, de 0 a 20. O padrão 3,5 serve para a maioria dos LoRAs, e LoRAs de realismo costumam ficar mais naturais um pouco abaixo.
Sem censura, com pesos personalizados
Os pesos nunca passam por revisão e a saída nunca é filtrada. Em nossos testes, os LoRAs sem filtro foram renderizados, mas no nível mais alto que testamos o modelo segurou parte da cena nas três tentativas.
Parâmetros da requisição
| Parâmetro | Obrigatório | Descrição |
|---|---|---|
prompt | Sim | Comece com a frase-gatilho do LoRA e depois descreva o sujeito, o cenário e a luz em frases completas. O FLUX segue bem prompts longos e específicos. pelo menos 1 caracteres · no máximo 5000 caracteres |
aspect_ratio | Não | Nove opções, de 21:9 a 9:21, todas com cerca de um megapixel e pelo mesmo preço. |
loras | Não | Até três entradas {path, scale} treinadas para o FLUX.1 [dev]; scale de 0 a 4, sendo 1 o neutro. LoRAs de estilo fortes podem precisar de um pouco mais que 1. Valor padrão: |
guidance_scale | Não | O quanto seguir o prompt à risca, de 0 a 20. O padrão 3,5 serve para a maioria dos LoRAs; LoRAs de realismo costumam ficar melhores um pouco abaixo. |
steps | Não | Passos de remoção de ruído, de 1 a 50 (padrão 28). Mais passos levam mais tempo para gerar. |
output_format | Não | JPEG por padrão; PNG ou WebP se você precisar. Não muda o preço. |
seed | Não | Mantém um conjunto de imagens comparável enquanto você ajusta o guidance ou o scale de um LoRA. |
Preços
$0.018 / imagem
Cobrado por imagem, com preço fixo para todas as proporções. Carregar LoRAs não gera cobrança à parte.
Casos de uso
Rode um LoRA que você encontrou
Cole o link de download, defina o scale e acrescente a frase-gatilho ao prompt. Sem treino, sem hospedagem e sem GPU: o LoRA que você viu num hub de modelos vira uma simples chamada de API.
Imagens editoriais e de moda
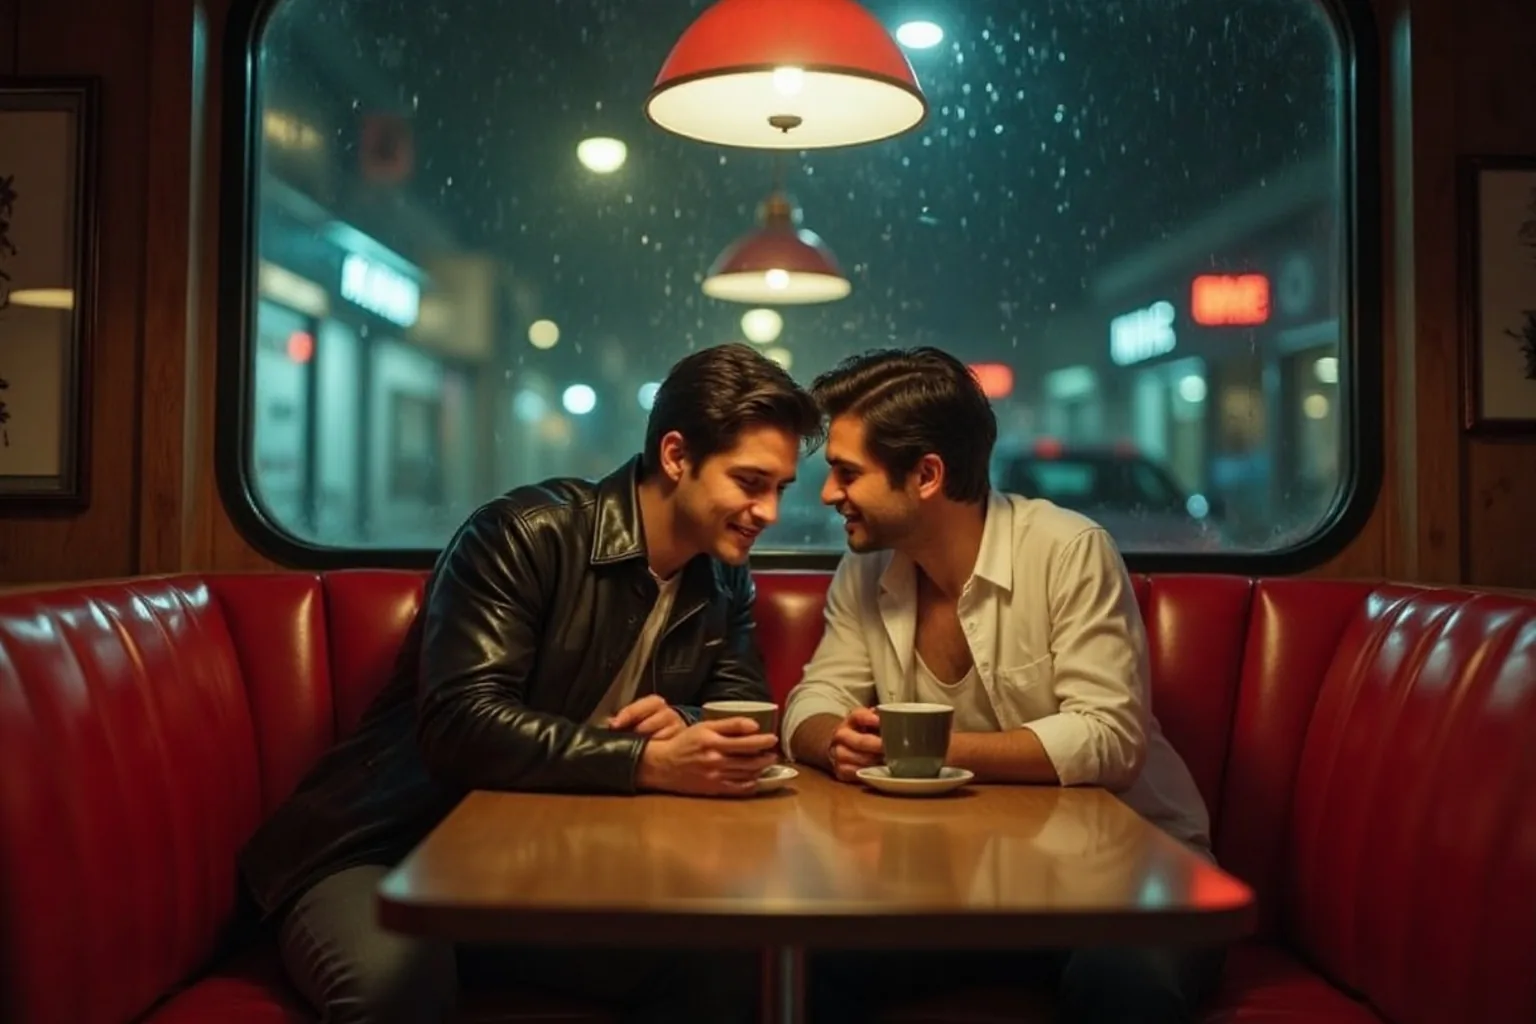
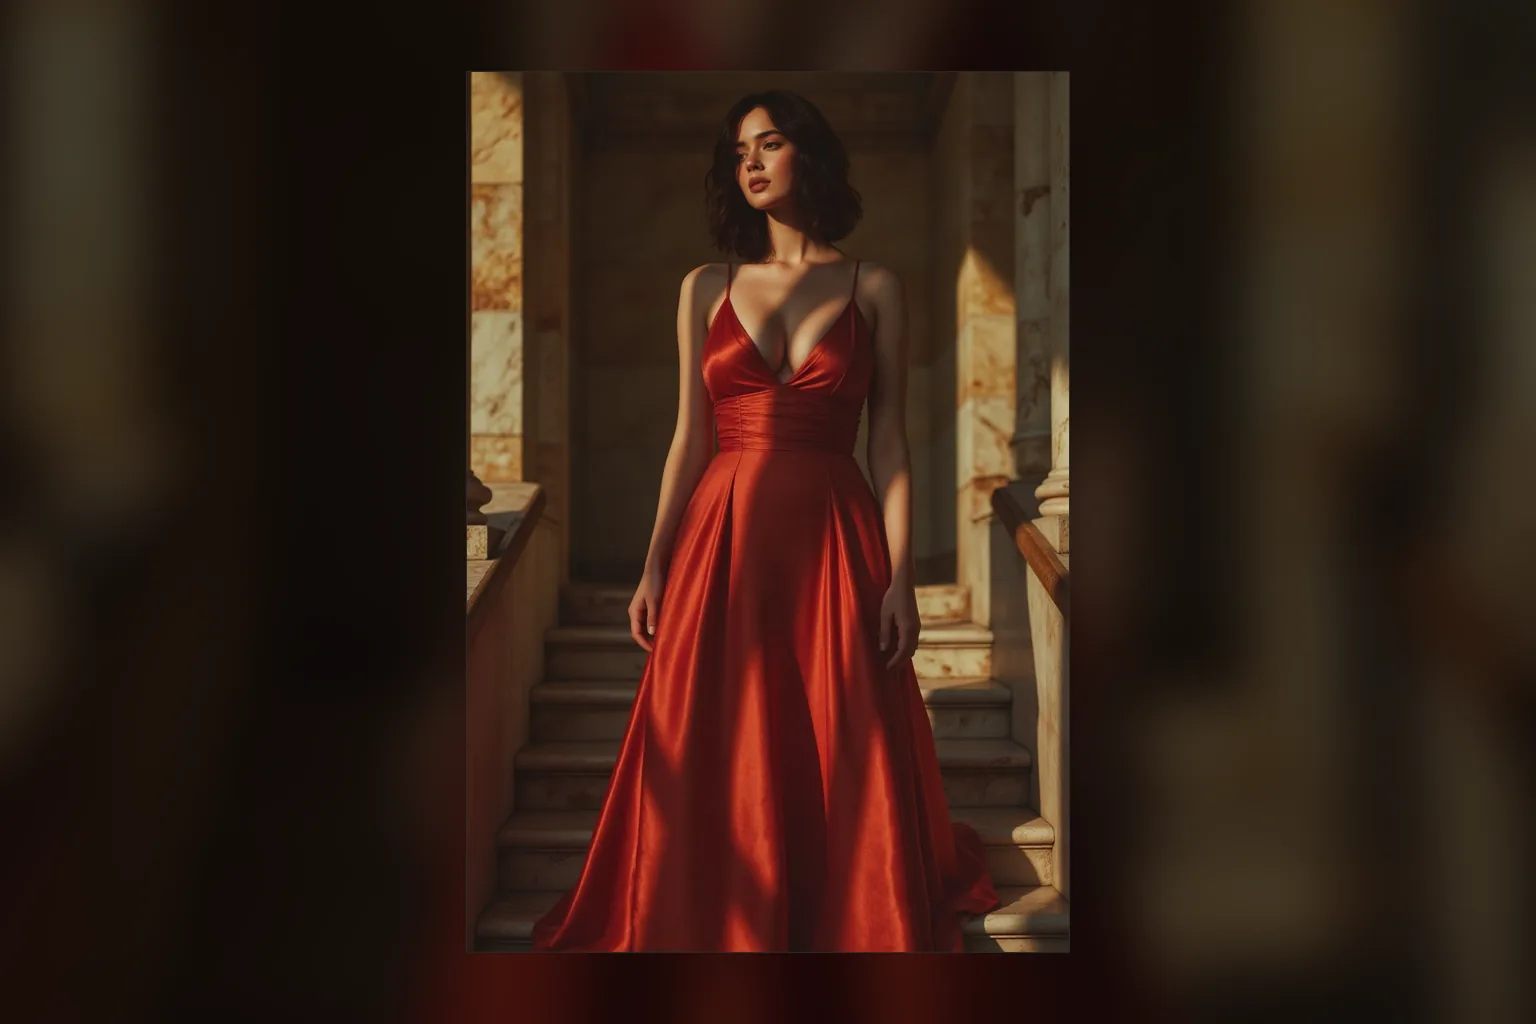
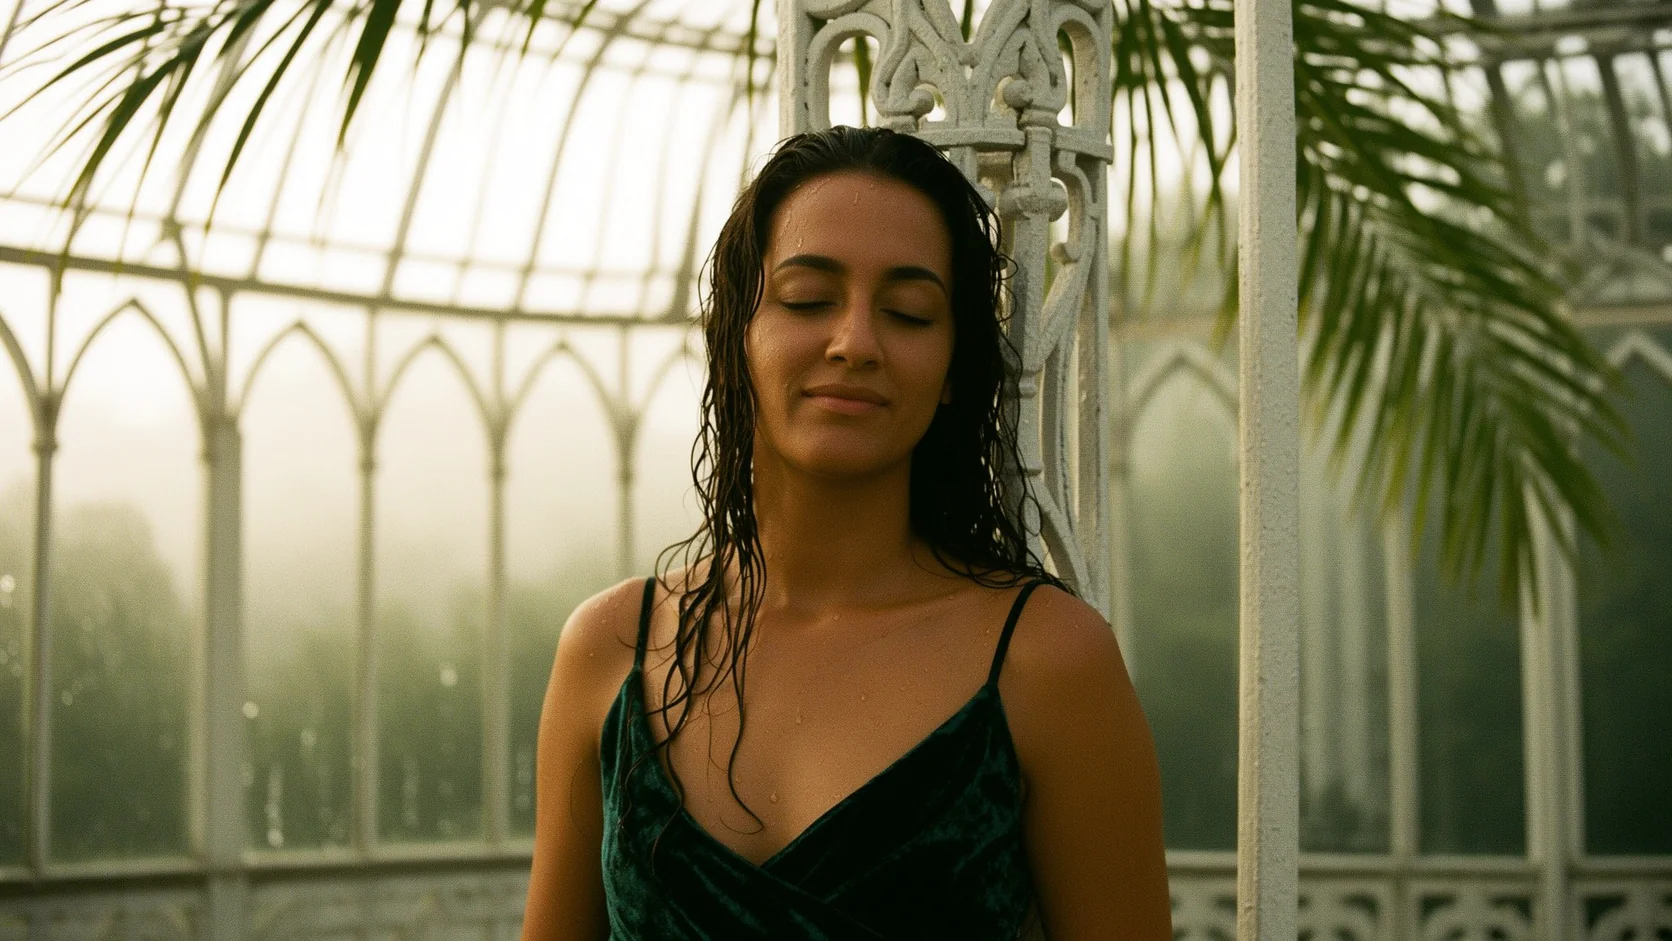
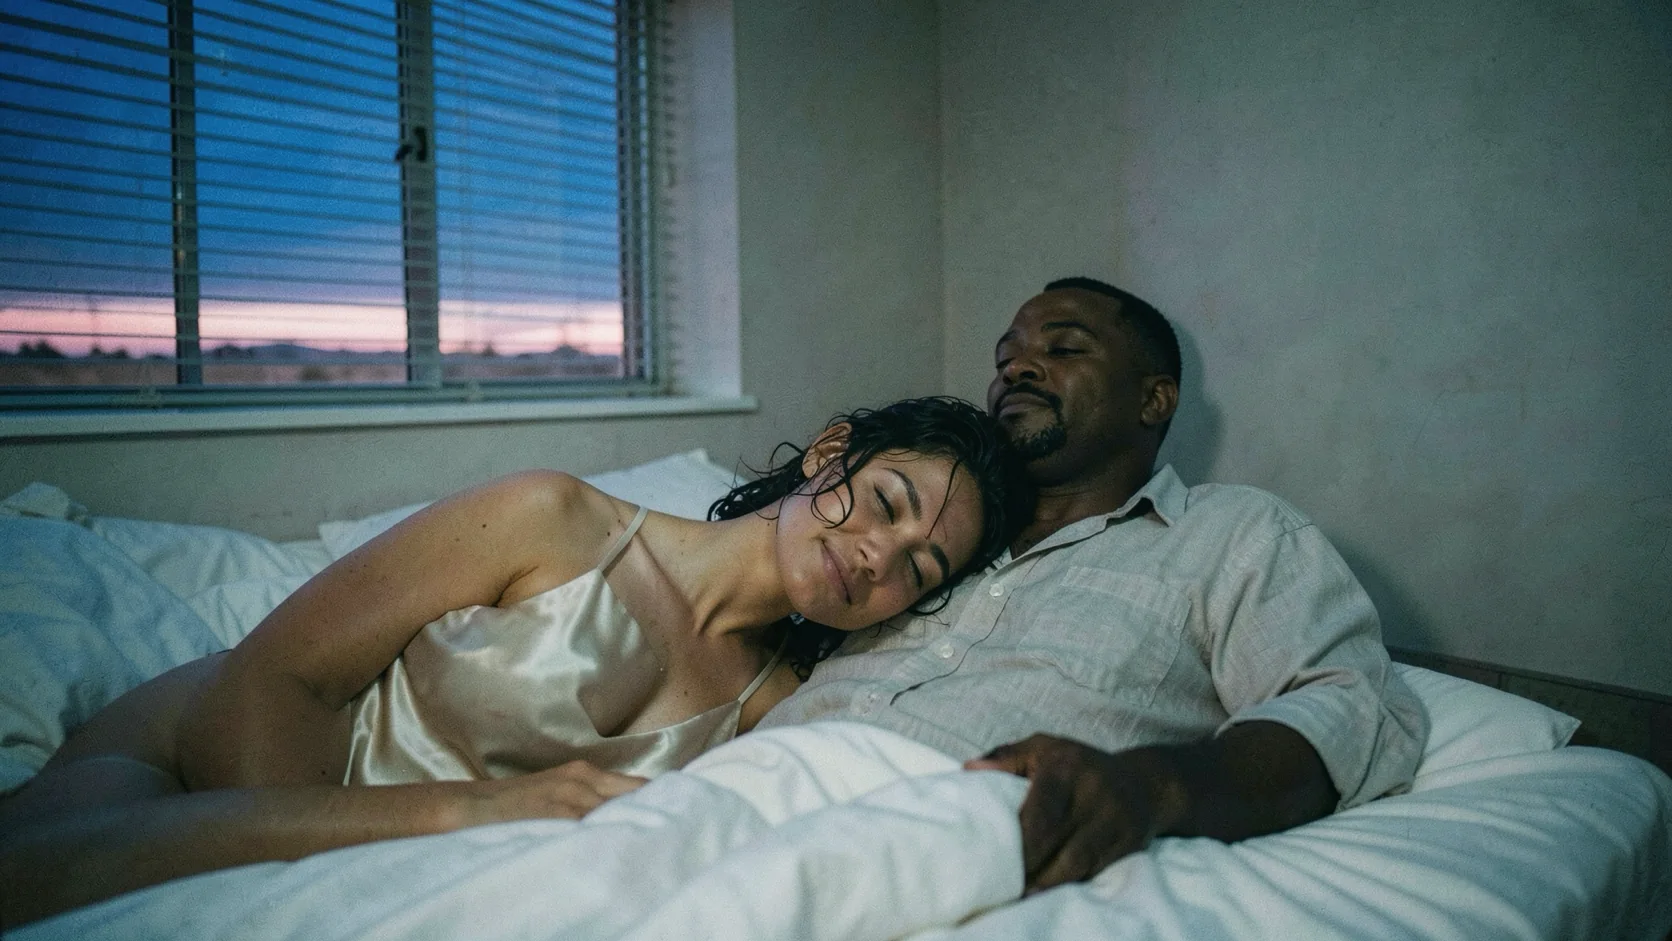
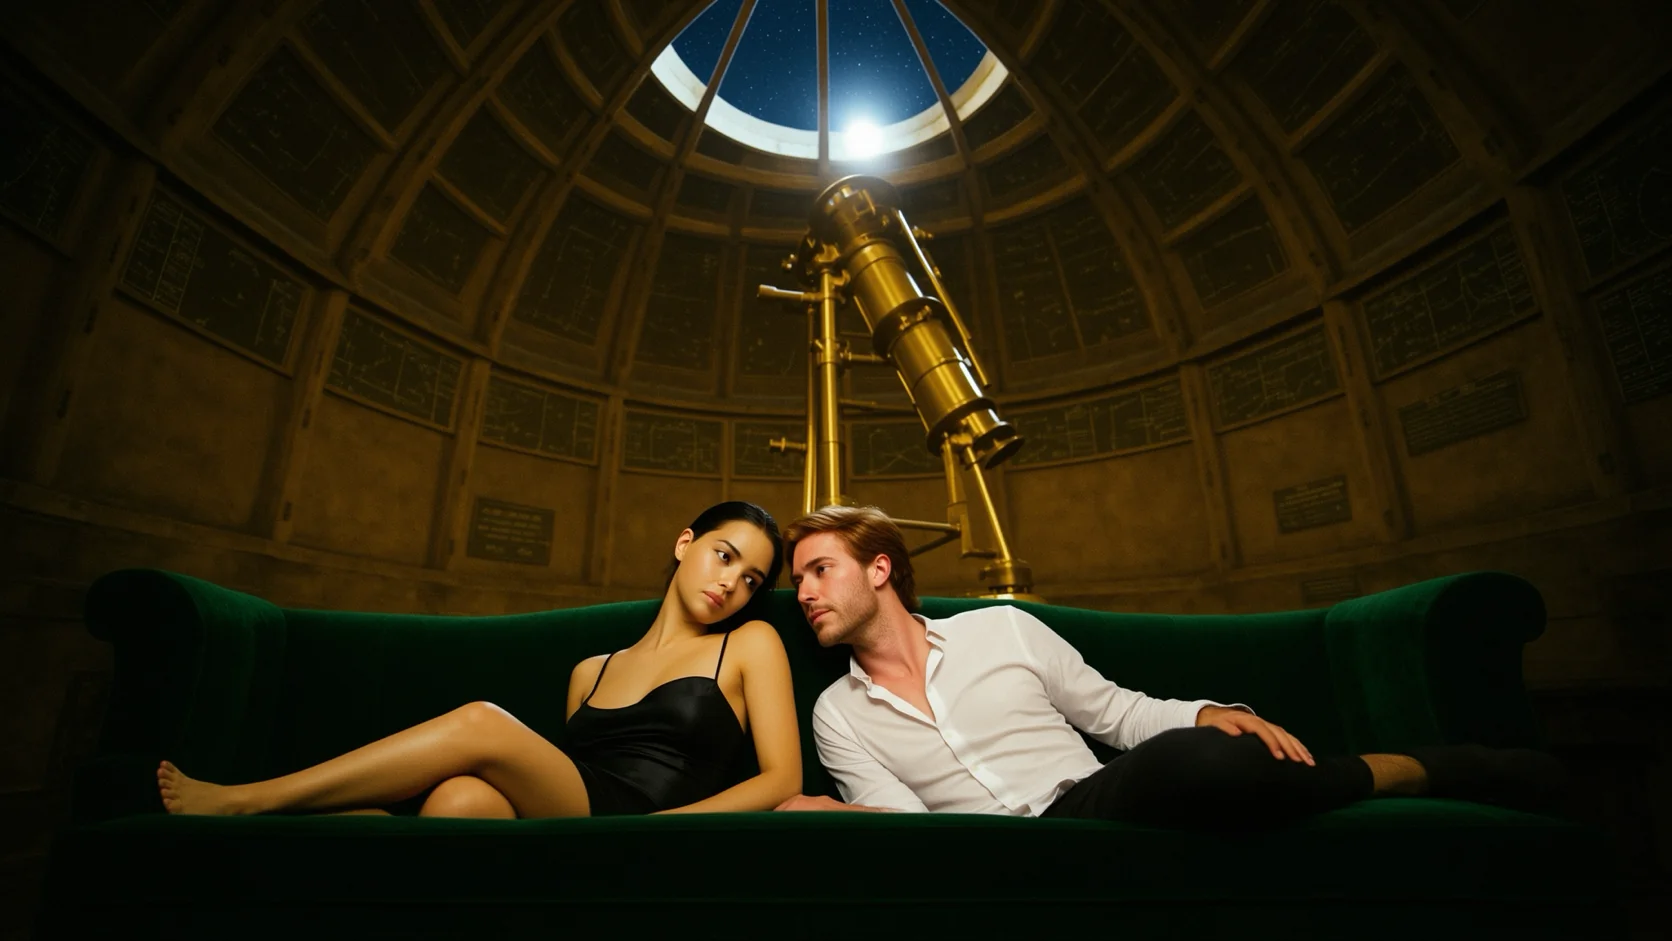
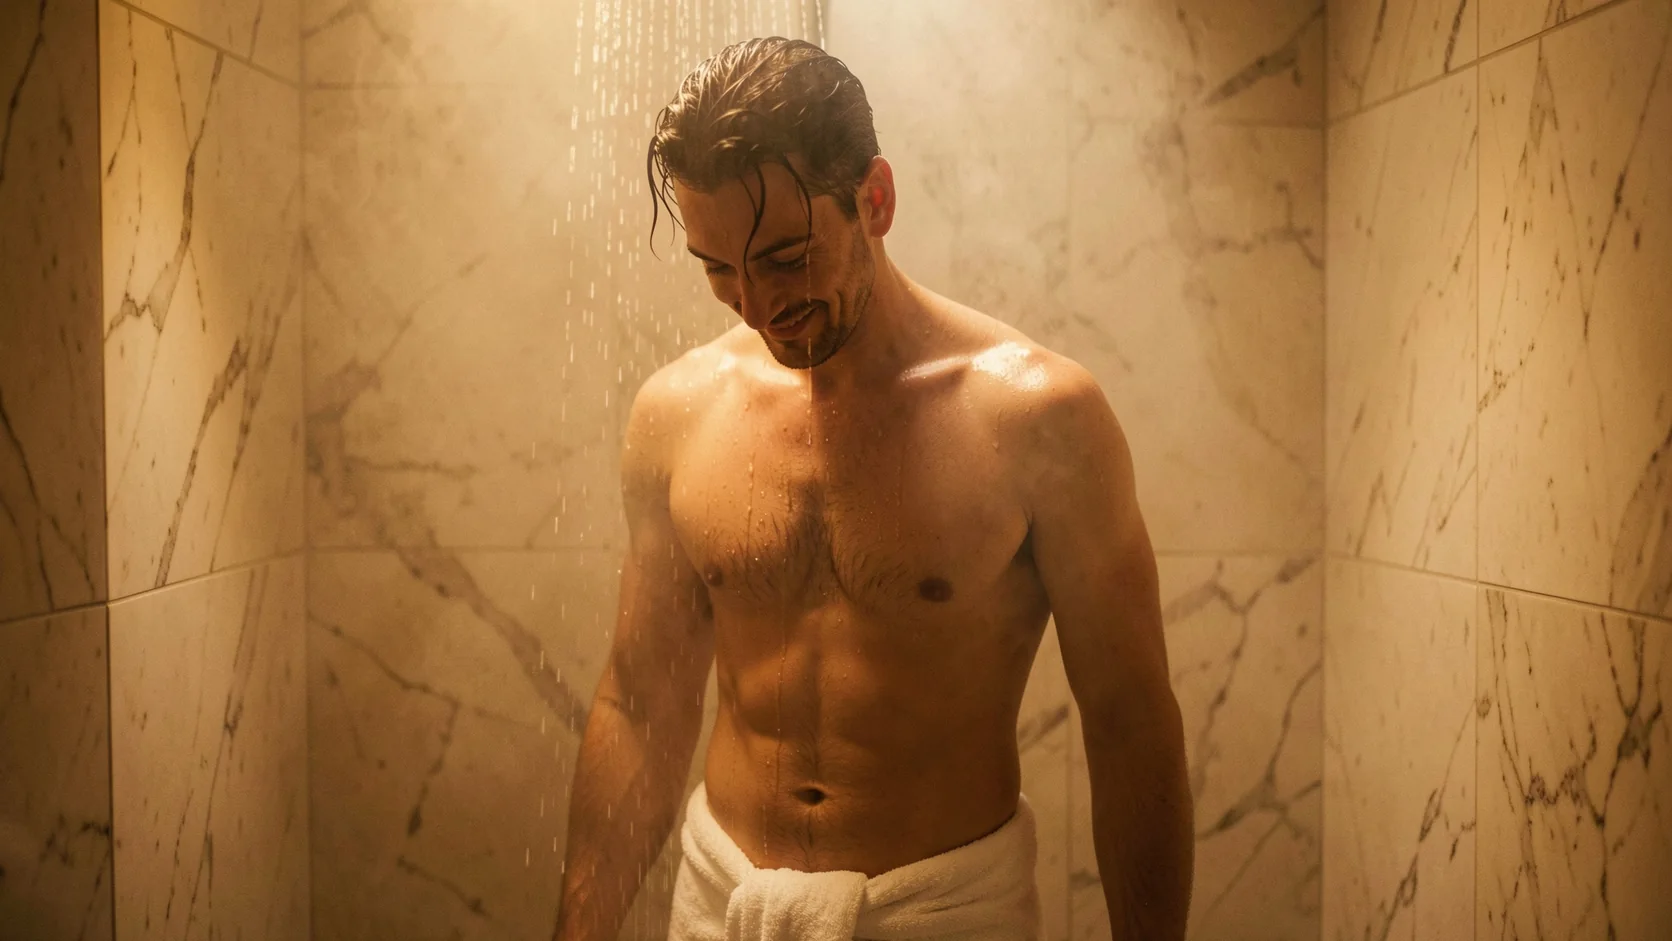
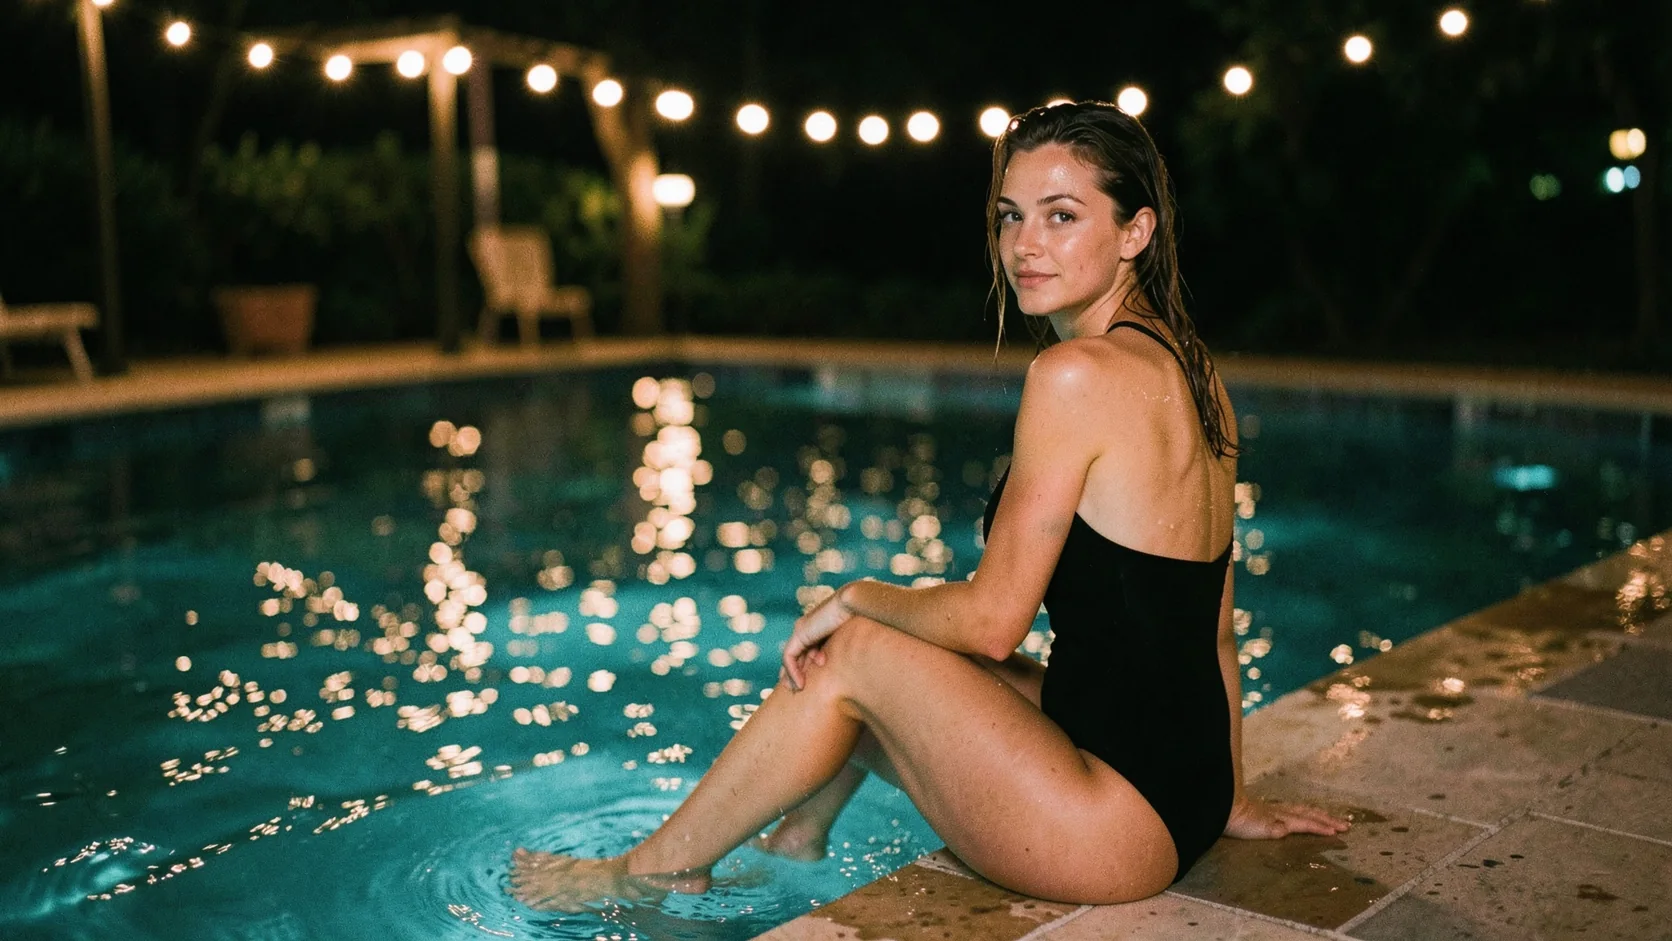
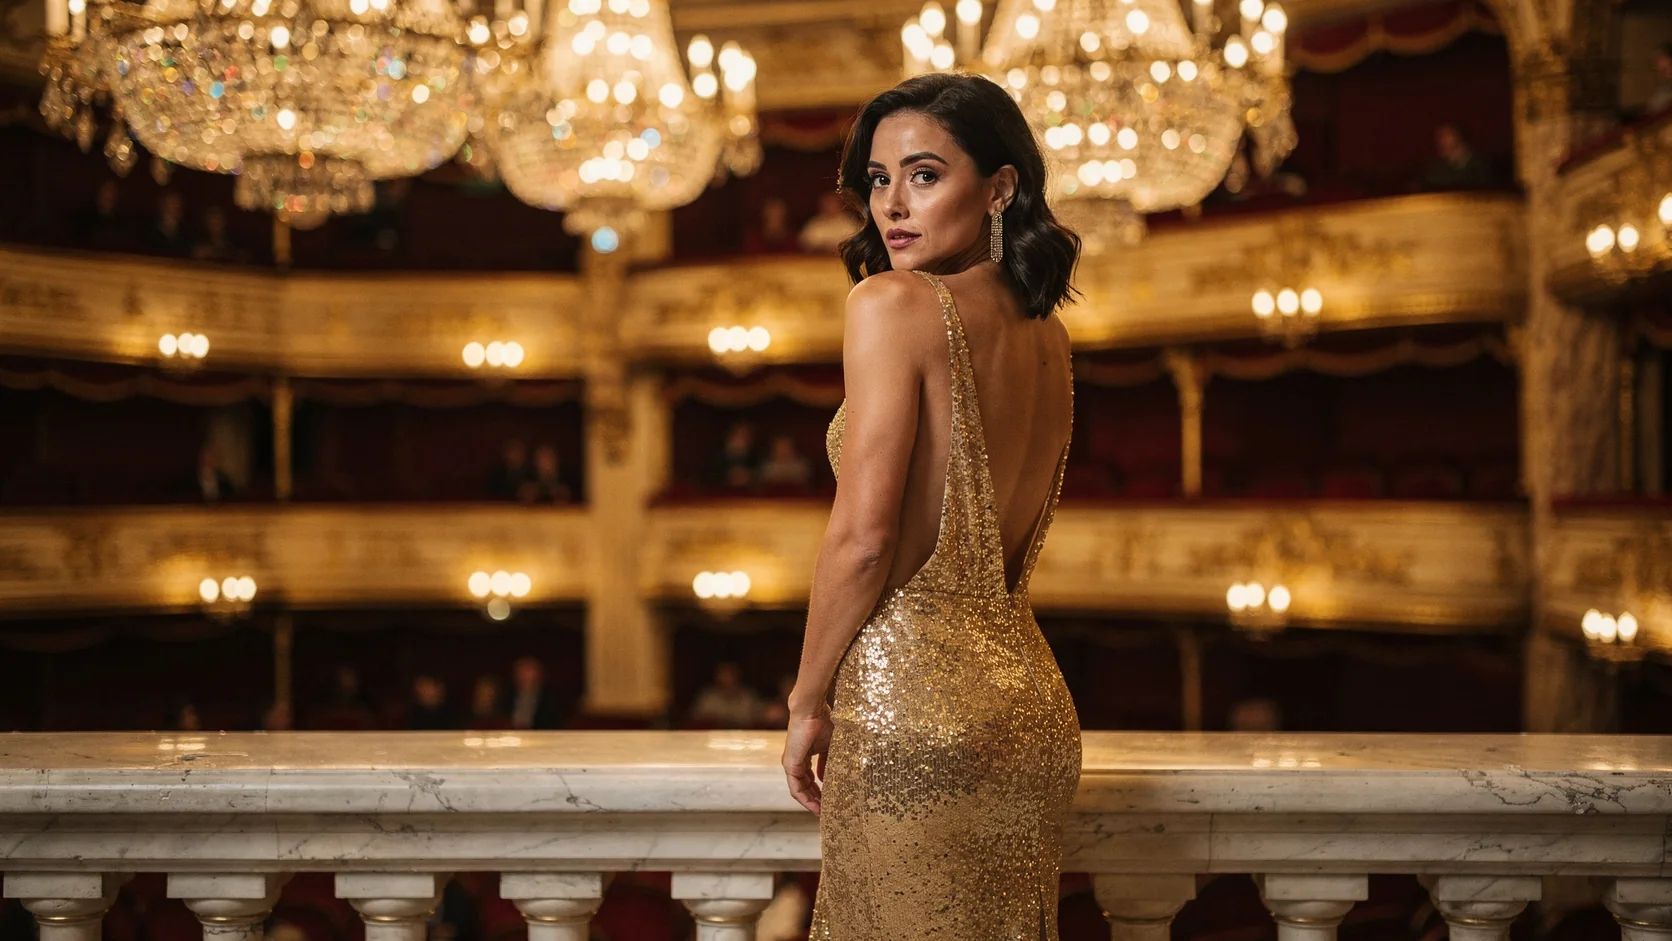
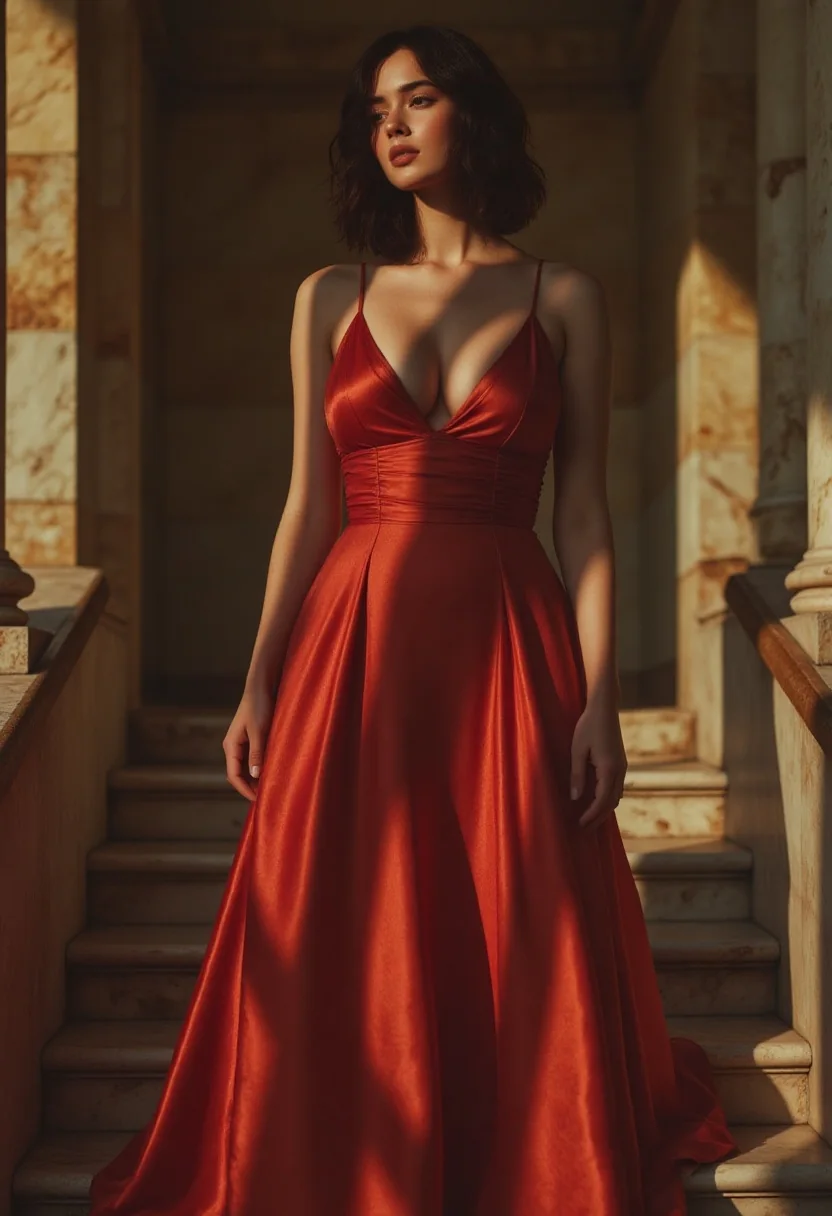
LoRAs de realismo e de revista trazem luz, tecido e pele convincentes para vestidos de gala, retratos e cenas noturnas, prontos para moodboards e rascunhos de campanha.
Séries estilizadas
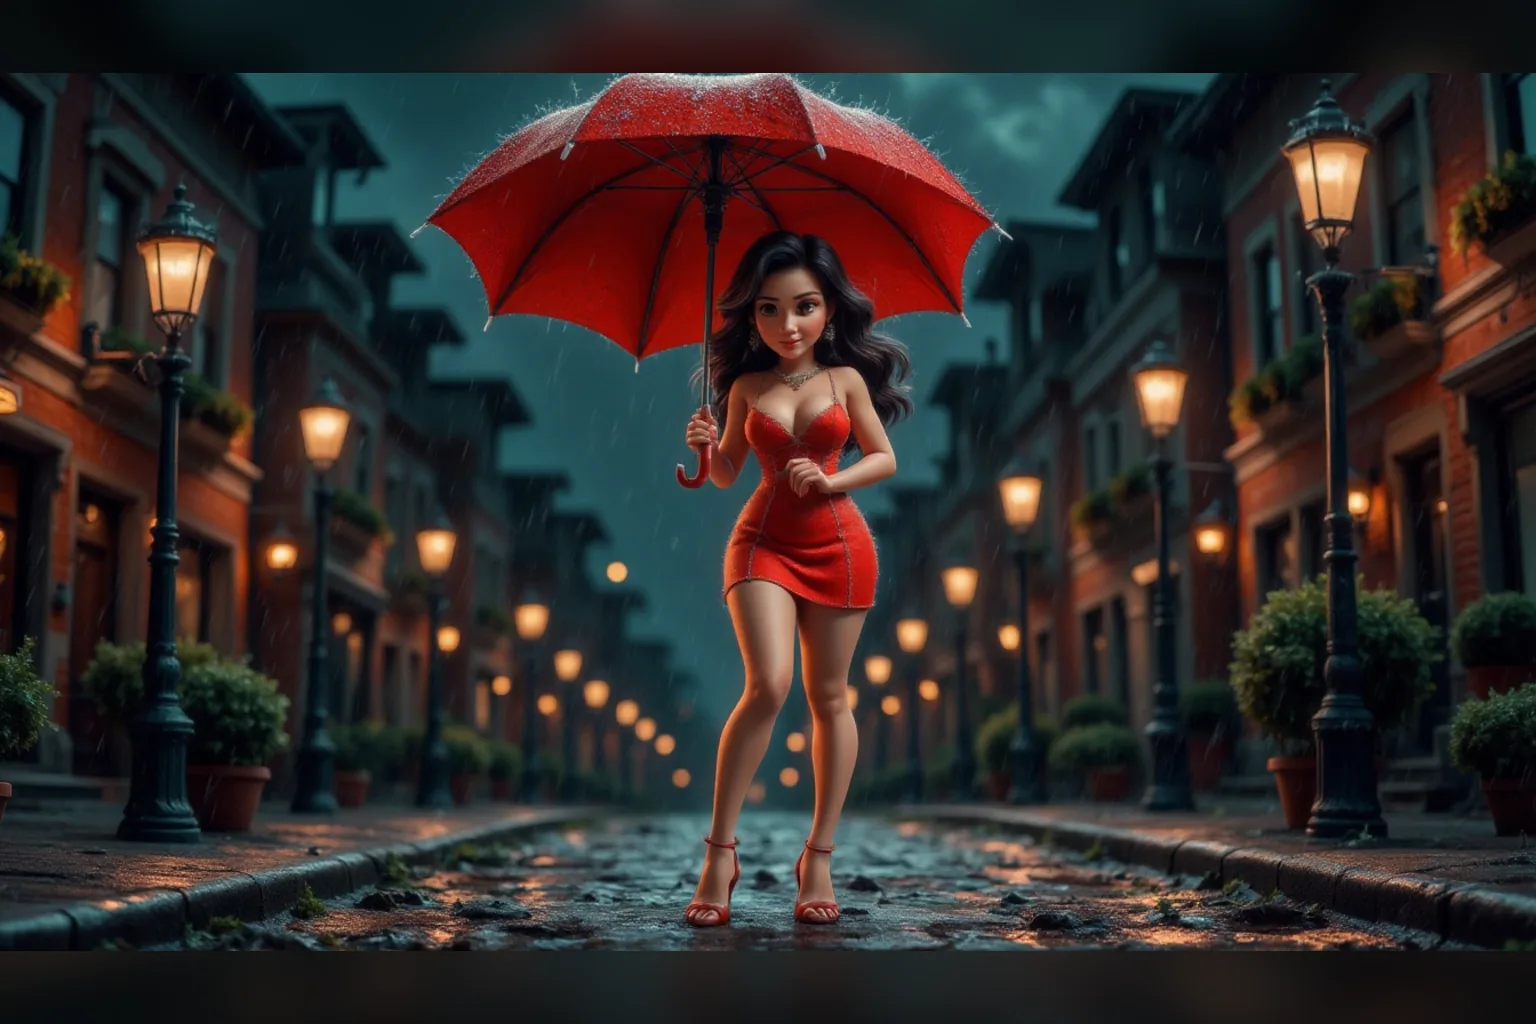
LoRAs de desenho animado e de ilustração mantêm um conjunto inteiro no mesmo visual em nove proporções, de posts quadrados a banners largos.
Guia de prompt e dicas práticas
Primeiro o gatilho, depois frases completas
O FLUX entende bem prompts longos. Comece com a frase-gatilho da página do modelo do LoRA e depois descreva o sujeito, o cenário, a roupa e a luz em frases completas, em vez de uma lista de tags.
Abaixe o guidance para realismo
Se um LoRA de realismo parecer encerado ou com nitidez exagerada, baixe o guidance de 3,5 para perto de 2,5 e compare com o mesmo seed. Um guidance mais alto segue o prompt de forma mais literal, mas custa textura natural.
Suba estilos fracos um passo de cada vez
Quando um estilo mal aparece, suba o scale dele em 0,2. Nosso exemplo de desenho animado precisou de 1,2. Em scales altos, confira de perto rostos e mãos: são as primeiras coisas a se deformar.
Deixe o texto fora das placas
O FLUX tende a escrever palavras em qualquer placa ou tela do quadro, e muitas vezes com erros de grafia. Deixe as placas fora do prompt, a menos que o texto exato importe.
Início rápido da API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "black-forest-labs/flux-1-dev-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulte a referência da API para autenticação, esquema completo, polling e tratamento de erros.