Introdução
OmniHuman 2.0 Avatar falante é o modelo de avatar guiado por áudio da ByteDance. Você envia um retrato (image_url) e um arquivo de áudio com fala ou canto (audio_url), e ele devolve um vídeo em 720p dessa pessoa interpretando o áudio: o rosto, os lábios, a cabeça e a parte superior do corpo se movem junto, em vez de deixar o torso parado. O clipe tem a duração do áudio, de 4 a 300 segundos. Não há campo de duração, resolução ou proporção. Um prompt opcional de até 300 caracteres dirige o clima, os gestos, para onde os olhos vão e, segundo a ByteDance, o movimento de câmera.
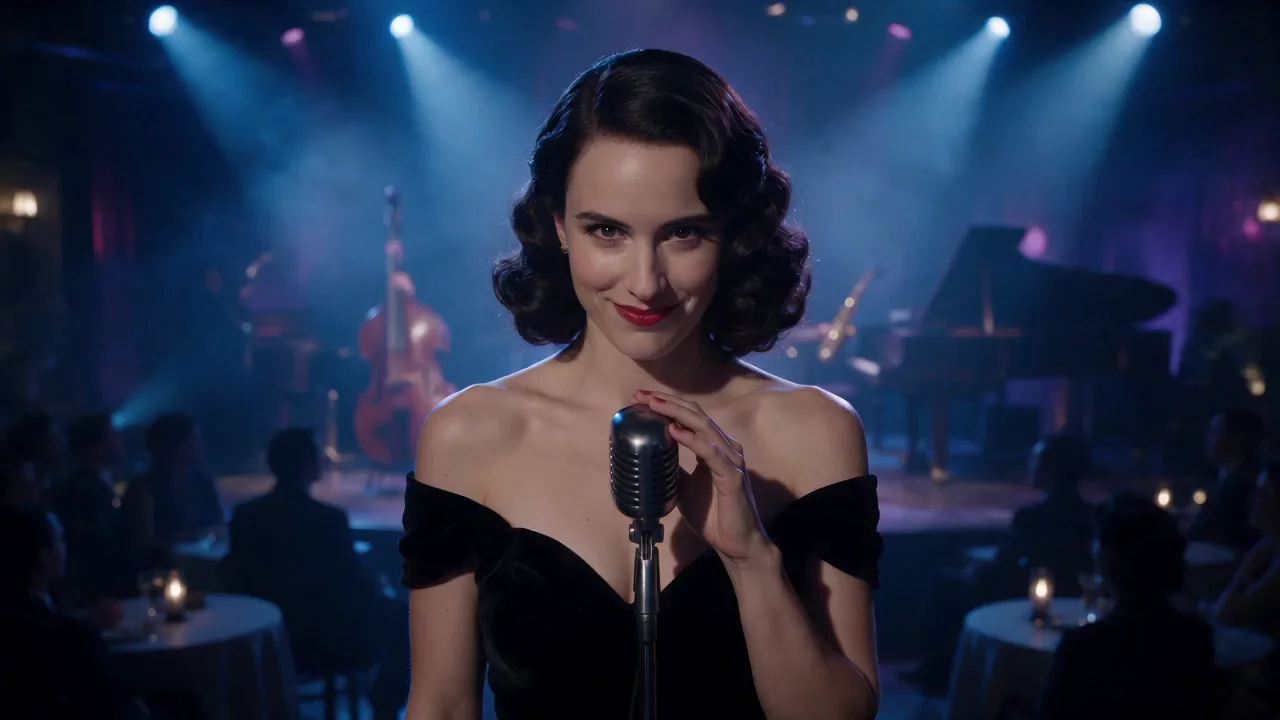
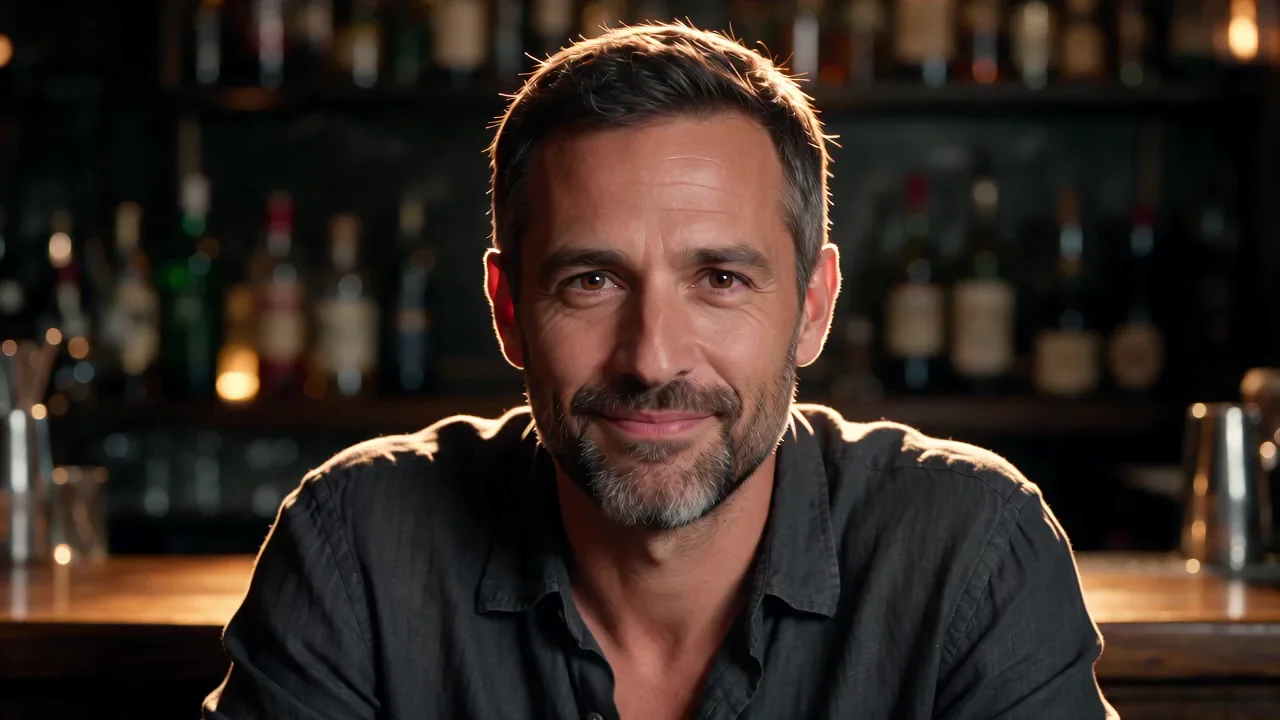
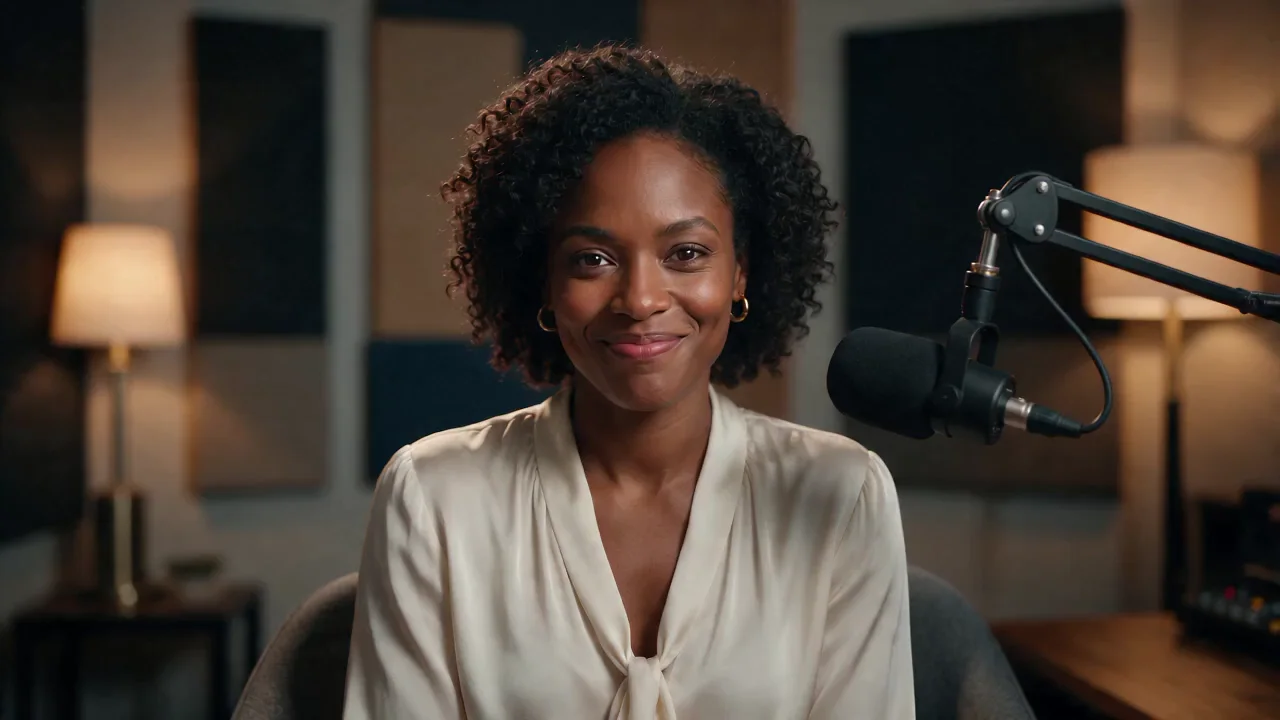
Três dos quatro exemplos desta página (a cantora do clube noturno, o balcão do bar e o programa noturno) usam os mesmos retratos e áudios do Kling Avatar 2.0, cortados para cerca de cinco segundos, para que você possa comparar as duas páginas lado a lado.
Recursos e destaques
O áudio define a duração
Corte o áudio na duração que você quer que o clipe tenha antes de enviá-lo. Áudio com menos de 4 segundos ou com mais de 300 segundos é recusado antes de qualquer cobrança. Em nossos testes, o clipe voltou entre 0,2 e 1 segundo mais longo que o áudio, sempre em um número inteiro de segundos: 4,55 segundos de áudio geraram um clipe de 5 segundos, e 5,2 segundos geraram um de 6 segundos. A cobrança segue a duração do áudio, não a do clipe pronto.
O que medimos
Testamos quatro retratos, cada um com seu próprio áudio de 4,55 a 5,2 segundos e seu próprio prompt de uma linha. Os quatro retratos estavam em 16:9. Todos os clipes voltaram em 1280×720 e 24 fps, com a faixa de áudio incluída, e o processamento levou cerca de dois minutos por clipe: de 110 a 133 segundos entre o envio e o arquivo final. Ao comparar os quadros com o retrato de entrada, o rosto continuou reconhecível como a mesma pessoa nos quatro clipes.
Lábios, expressão e gestos
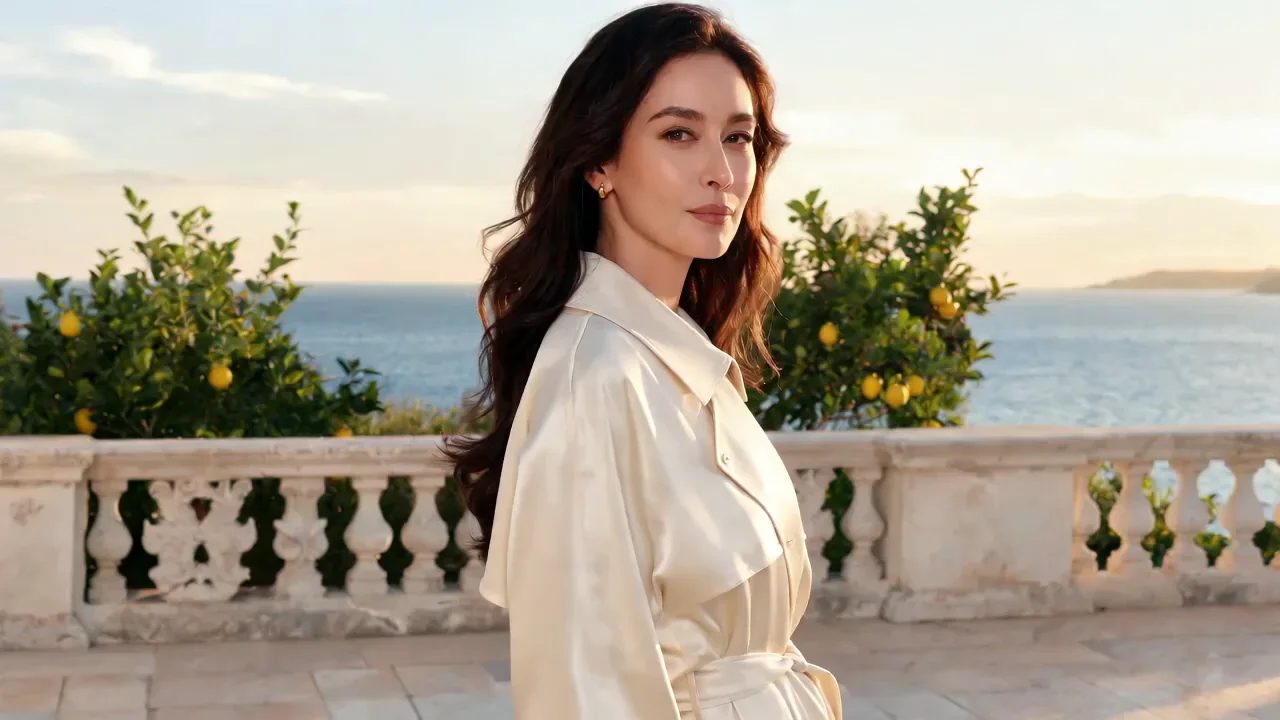
Em todos os quatro clipes, os lábios acompanharam o áudio. Os prompts pediam momentos pequenos e específicos, e a maioria apareceu: um sorriso e uma leve inclinação da cabeça na última palavra, com uma mão que permanece no microfone; um meio sorriso e uma sobrancelha erguida, com as garrafas atrás do bar estáveis; a cabeça virando para o mar no último segundo; e uma risada curta com as sobrancelhas bem erguidas na última palavra. Uma instrução não apareceu de forma visível: a inclinação em direção ao microfone no clipe do programa noturno.
O prompt é opcional
Deixe prompt vazio e o modelo segue o áudio sozinho. A ByteDance lista chinês, inglês, japonês, coreano, espanhol (mexicano) e indonésio como idiomas aceitos no prompt. Nossos quatro prompts estavam em inglês e dirigiam expressão, gestos e para onde os olhos vão; não testamos instruções de movimento de câmera.
O que ainda não testamos
A ByteDance lista cenas com mais de uma pessoa; não testamos esse caso. Nossos clipes tinham todos cerca de cinco segundos de áudio, então não testamos um clipe longo perto do limite de 300 segundos, uma música completa nem retratos que não estejam em 16:9.
Revisão de conteúdo
Retratos que não passam na revisão de conteúdo da ByteDance são recusados, e nada é cobrado. Um dos nossos retratos de teste foi recusado dessa forma: sem clipe, sem cobrança. Considere que toda solicitação passa por essa revisão.
Parâmetros da requisição
| Parâmetro | Obrigatório | Descrição |
|---|---|---|
prompt | Não | Opcional, de até 300 caracteres. Dirige clima, gestos, para onde os olhos vão e o movimento de câmera. no máximo 300 caracteres |
image_url | Sim | Retrato a animar. JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC ou HEIF, com menos de 30 MB, de 300 a 6000 px em cada lado, proporção entre largura e altura de 0,4 a 2,5. |
audio_url | Sim | Fala ou canto, em WAV ou MP3, com menos de 15 MB, de 4 a 300 segundos. O clipe tem a duração deste áudio; áudio fora desse intervalo é recusado antes de qualquer cobrança. |
Preços
$0.108 / segundo
Cobrado por segundo do áudio de entrada, com mínimo de 4 segundos e máximo de 300 segundos; a reserva segue a duração do áudio (ou o máximo de 300 segundos quando ela não puder ser lida), e a diferença é liberada na entrega. Solicitações com falha ou recusadas não são cobradas.
Casos de uso
Dê um rosto a uma fala gravada
Combine uma fala gravada ou gerada com um retrato para obter um clipe dessa pessoa dizendo-a — útil para aberturas narradas, depoimentos ou diálogos de um personagem cujo rosto você já definiu.
Aberturas curtas de apresentador e de programa
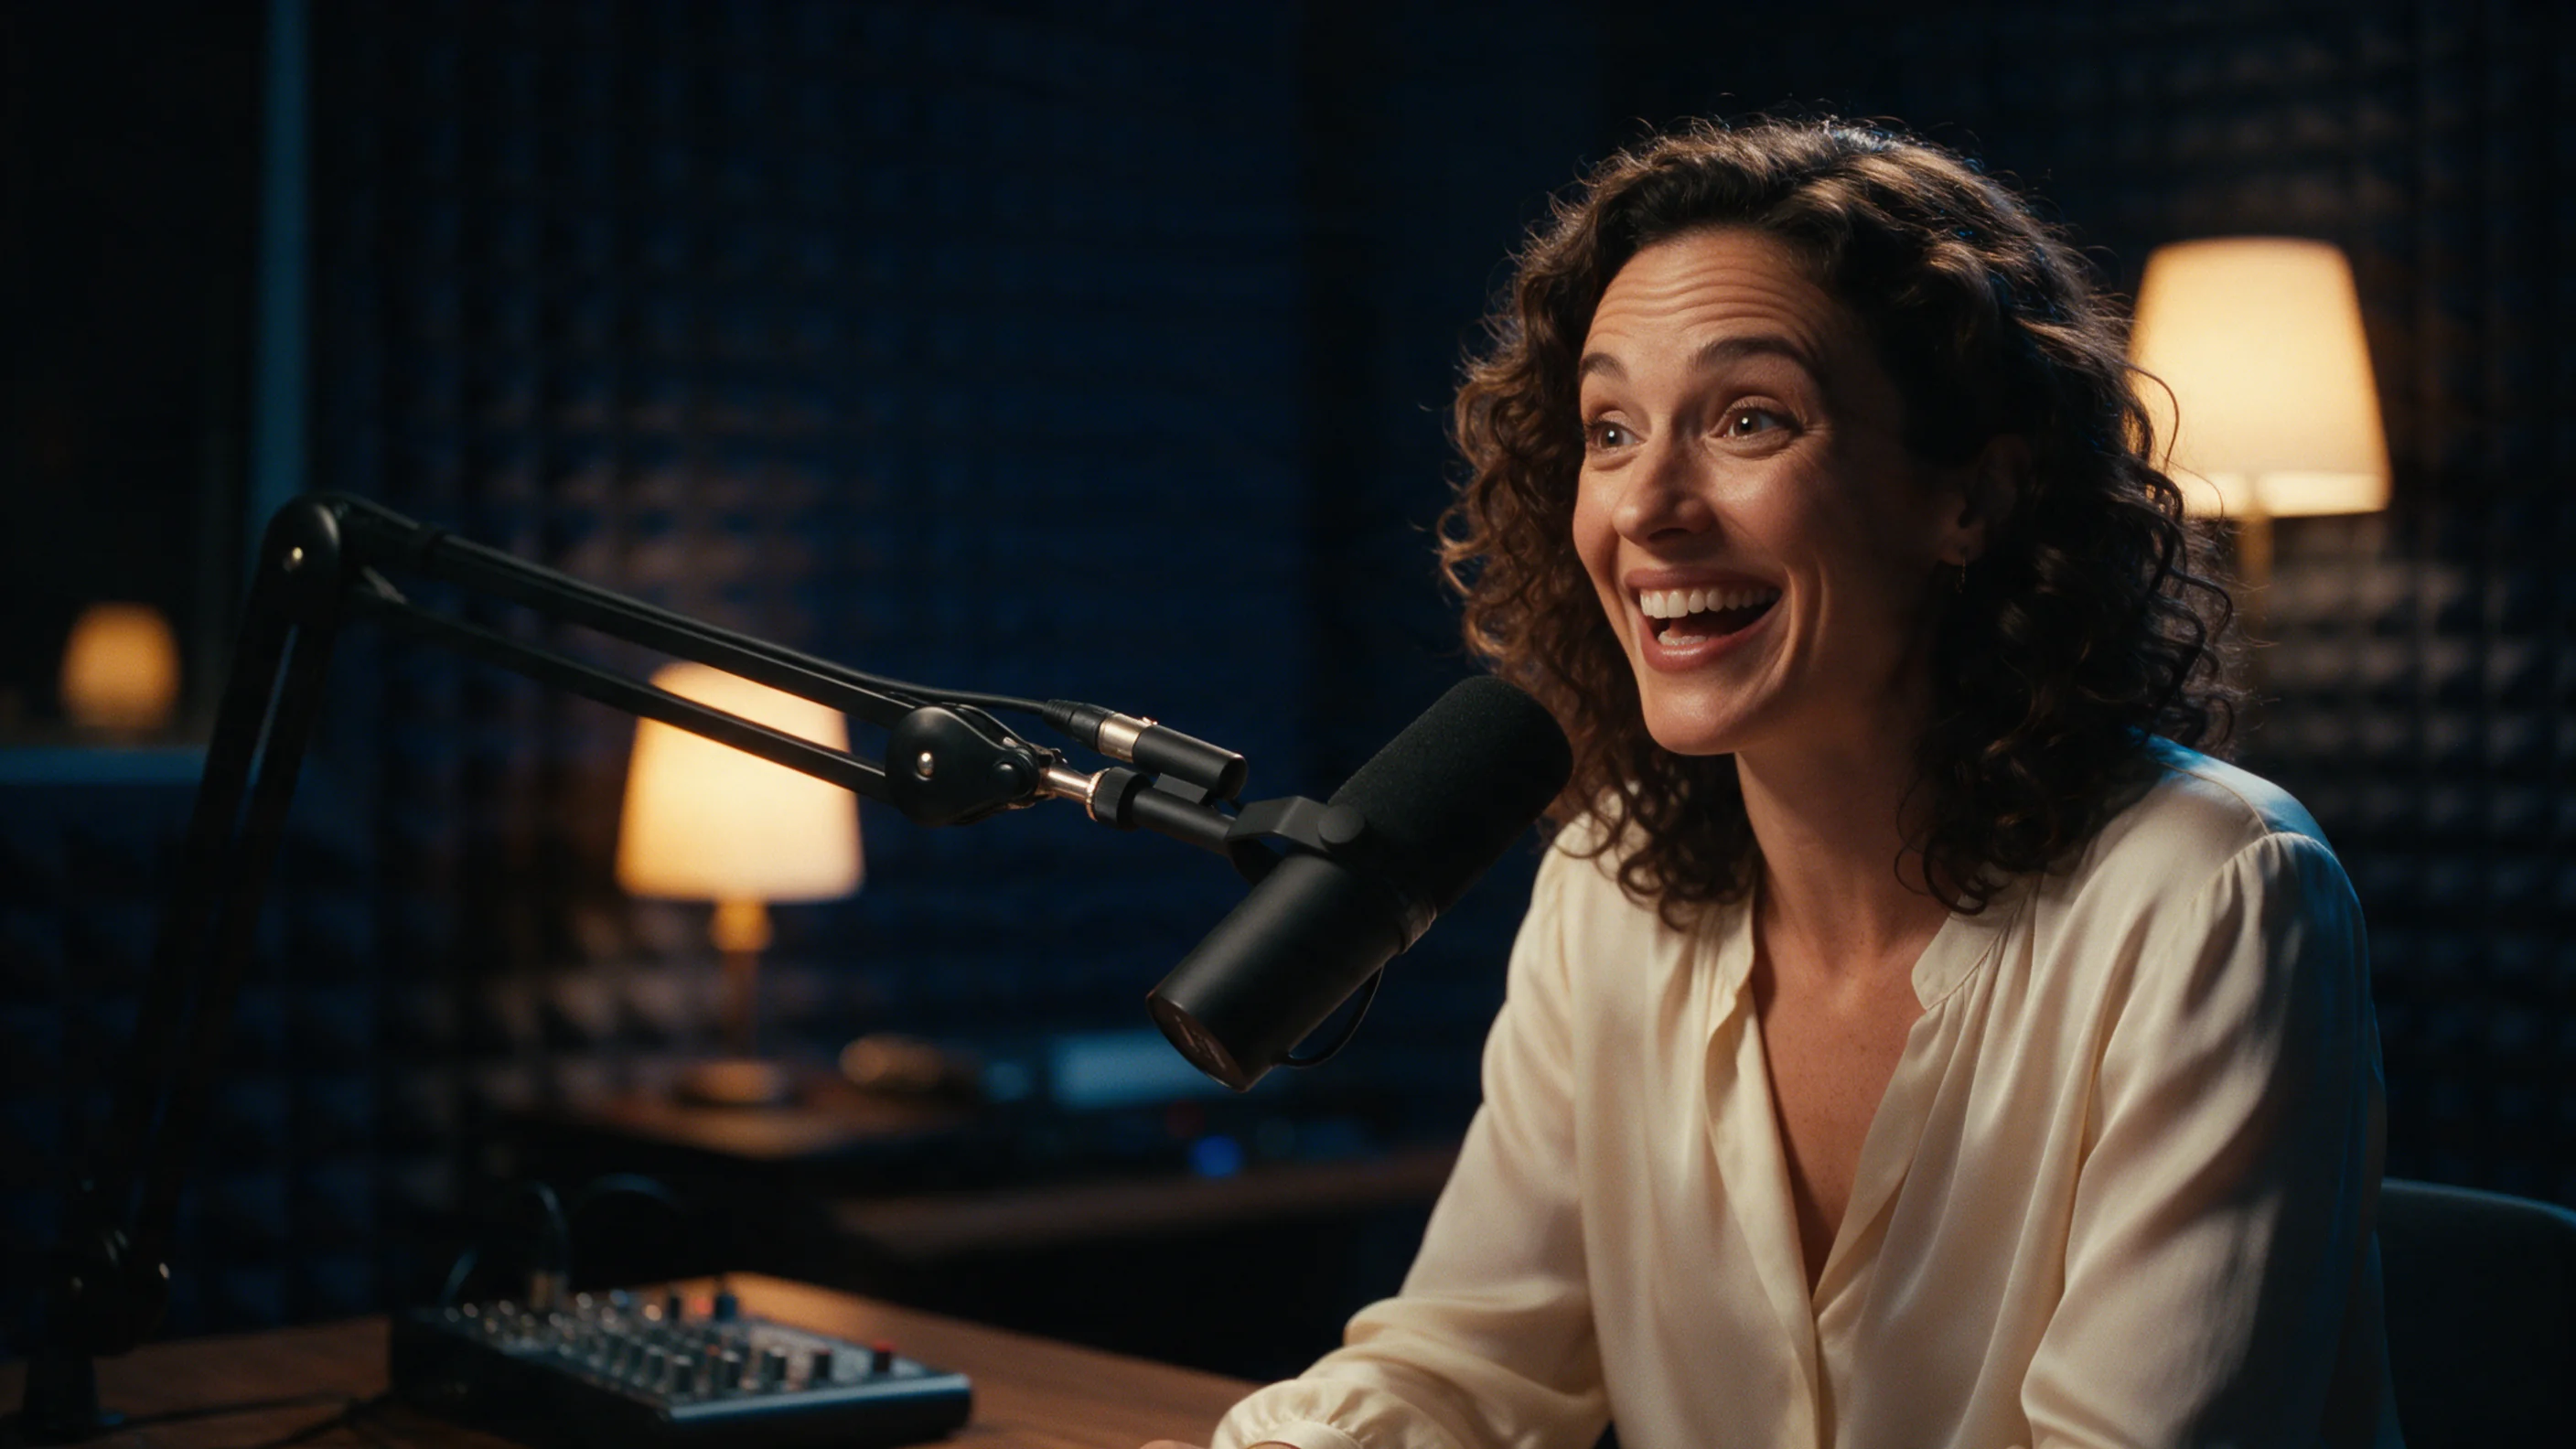
Uma fala de abertura animada e brincalhona, com um prompt que nomeia o clima e um momento na última palavra, nos deu expressões amplas, sobrancelhas vivas e uma risada, como no exemplo do programa noturno desta página.
Uma fala cantada a partir de uma foto parada
A ByteDance lista o canto junto com a fala. Nosso teste foi uma linha lenta, cantada/falada, em um microfone vintage, de cerca de cinco segundos; ainda não tentamos uma música completa.
Fotos de celular do jeito que são
O retrato pode ser JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC ou HEIF, com menos de 30 MB, então uma foto tirada direto do celular pode ser enviada sem conversão prévia.
Guia de prompt e dicas práticas
Amarre uma expressão a um momento da fala
“A lazy smile on the last word” e “glances away at the end” acertaram onde os colocamos: o sorriso e a inclinação da cabeça chegaram ao fim do clipe do clube noturno, e a cabeça virou para o mar no último segundo do clipe do terraço. Nomear em que ponto da fala o momento deve acontecer dá ao modelo algo para cronometrar.
Use poucos momentos
Cada um dos nossos prompts pedia um clima, um ou dois momentos faciais e, às vezes, uma postura. Isso basta para moldar um clipe de cinco segundos. Nos nossos testes, os momentos faciais seguiram o prompt com mais confiança do que os movimentos corporais.
Não conte só com um movimento corporal
“A lean toward the mic”, do prompt do programa noturno, não apareceu de forma visível, enquanto a risada e as sobrancelhas ao lado apareceram. É a observação de um único teste, mas se um movimento corporal for importante para você, gere uma vez e confira antes de construir sobre ele.
Escolha o retrato levando os limites em conta
Largura e altura devem ter, cada uma, de 300 a 6000 pixels, e a proporção entre largura e altura deve estar entre 0,4 e 2,5. Só testamos retratos em 16:9.
Corte o áudio na medida da performance
O clipe dura o mesmo tempo que o áudio, e a cobrança segue a duração do áudio, então corte o arquivo na fala ou no canto que você realmente quer. WAV ou MP3, com menos de 15 MB.
Início rápido da API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "bytedance/omnihuman-2.0/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulte a referência da API para autenticação, esquema completo, polling e tratamento de erros.