Einführung
daVinci-MagiHuman Bild zu Video startet einen Clip von Ihrem Foto und gibt ihm Bewegung und Stimme. daVinci-MagiHuman ist ein offenes Modell mit 15 Milliarden Parametern von Sand.ai und SII-GAIR, das Bild und Tonspur gemeinsam erzeugt. Das Foto ist das Startbild; der Prompt sagt, was danach geschieht und, in Anführungszeichen, was die Person sagt. Dieser Endpunkt liefert 5 bis 10 Sekunden in 256p, 720p oder 1080p, im Format 16:9 oder 9:16, und nimmt Ihre eigene Sprachaufnahme oder Ihr Lied als audio_url an.
Den Modus nach dem Ausgangsmaterial wählen
| Was Sie haben | Modus |
|---|---|
| eine geschriebene Beschreibung | daVinci-MagiHuman Text zu Video |
| ein Foto als Ausgangspunkt, mit oder ohne eigene Audiodatei | daVinci-MagiHuman Bild zu Video |
Wichtige Funktionen und Highlights
Ein Startbild, das sich bewegt und spricht
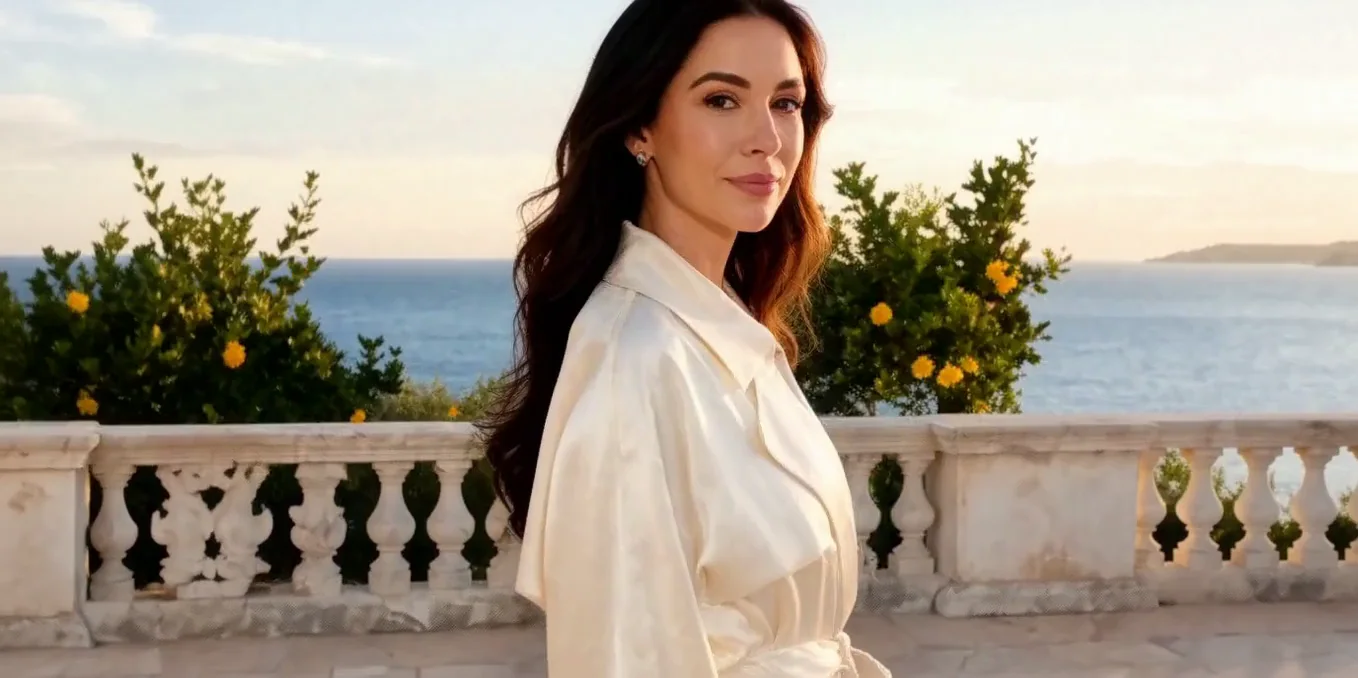
Der Clip beginnt mit Ihrem Bild. In unserem Lauf ohne Audiodatei wandte sie sich vom Meer ab, strich sich das Haar hinters Ohr und sagte die zitierte Zeile; die Transkription der Tonspur stimmte Wort für Wort.
Ihre eigene Stimme
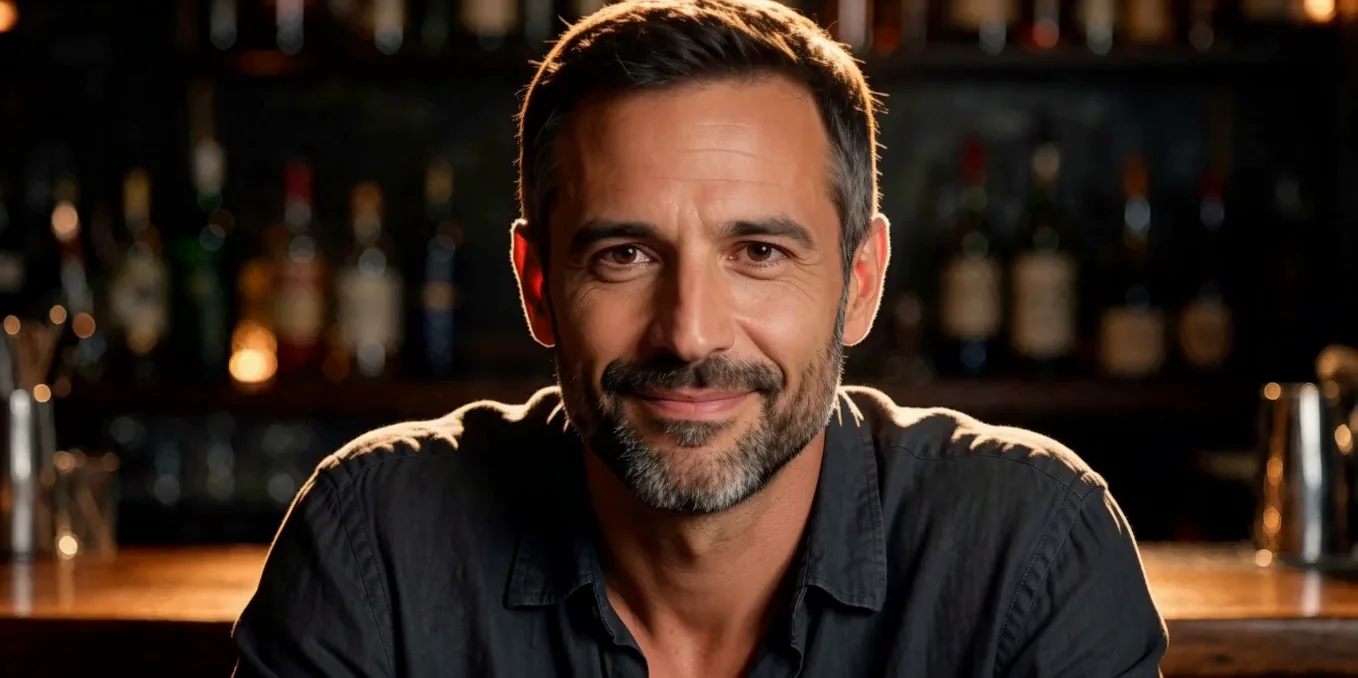
Mit gesetztem audio_url wird das Video synchron zu Ihrer Sprach- oder Gesangsaufnahme erzeugt, statt eine Stimme zu erfinden. In unserem Lauf mit einer 5-Sekunden-Sprachaufnahme folgten die Lippen dem gelieferten Audio, mit einem halben Lächeln und Augenbrauenbewegung, und das Gesicht blieb nah am eingegebenen Porträt.
Was wir gemessen haben
Wir haben zwei Bild-zu-Video-Clips in 720p und 16:9 erzeugt, beide 5,0 Sekunden und beide etwa 1358 x 678 bei 25 fps; 720p ist also nicht exakt 1280 x 720. Der Lauf ohne Audio dauerte etwa 1 Min. 45 Sek., der Lauf mit einer 5-Sekunden-Sprachaufnahme als audio_url etwa 3 Min. 7 Sek. Wir haben diesen Endpunkt nicht in 1080p, nicht im Format 9:16 und nicht mit einer Aufnahme getestet, deren Länge von der des Clips abweicht.
Auflösungen und Formate
resolution ist 256p, 720p (Standard) oder 1080p, und aspect_ratio ist 16:9 (Standard) oder 9:16. Das Modell erzeugt mit einer niedrigen Grundauflösung, und seine eigene Hochskalierungsstufe liefert die höheren Stufen. Höhere Stufen kosten pro Sekunde mehr; Ton und Format ändern den Preis nicht.
Request-Parameter
| Parameter | Pflicht | Beschreibung |
|---|---|---|
prompt | Ja | Beschreiben Sie, was nach dem Foto geschieht: was die Person tut und, in Anführungszeichen, was sie sagt. mindestens 3 Zeichen · höchstens 5000 Zeichen |
image_url | Ja | Das Startbild. Ein öffentlicher, direkt herunterladbarer Link; der Clip beginnt mit diesem Foto. |
audio_url | Nein | Optional. Ein öffentlicher Link zu einer Sprach- oder Gesangsdatei; das Video wird synchron dazu erzeugt, statt eine Stimme zu erfinden. |
aspect_ratio | Nein | 16:9 (Standard) oder 9:16. Unsere Bild-zu-Video-Läufe verwendeten 16:9. |
resolution | Nein | 256p, 720p (Standard) oder 1080p. Höhere Stufen kosten pro Sekunde mehr. |
duration_seconds | Nein | 5 bis 10 Sekunden, Standard 5, abgerechnet pro Sekunde. |
seed | Nein | Optionale ganze Zahl. Derselbe Seed mit denselben Eingaben liefert ähnliche, nicht garantiert identische Ergebnisse. |
Preis
Abgerechnet pro Sekunde der angeforderten Dauer; der Sekundenpreis richtet sich nach der Auflösung, während Ton und Seitenverhältnis ihn nicht ändern. Fehlgeschlagene Anfragen werden nicht berechnet.
| Spezifikation | Preis |
|---|---|
| $0.024 / Sekunde |
| $0.048 / Sekunde |
| $0.072 / Sekunde |
Anwendungsfälle
Ein Porträt, das mit Ihrer Aufnahme spricht
Ein Porträtfoto plus eine Sprachdatei: Die Lippen folgen Ihrem Audio, und das Gesicht bleibt nah am Foto.
Eine Figur, die eine Zeile sagt
Ein Startbild und eine kurze zitierte Zeile, um zu sehen, wie die Figur aussieht und klingt, bevor Sie mehr investieren.
Vertikale Clips aus einem Foto
Wählen Sie 9:16 für Feeds und Stories. Alle unsere Läufe an diesem Endpunkt verwendeten 16:9, prüfen Sie also einen ersten Clip.
Prompt-Leitfaden und Praxistipps
Den nächsten Moment beschreiben
Schreiben Sie, was die Person nach der Aufnahme des Fotos tut: Sie wendet sich der Kamera zu, streicht sich das Haar, spricht. In unserem Lauf geschahen alle drei Handlungen.
Mit eigenem Audio die Worte weglassen
Die Stimme kommt von audio_url, daher kann der Prompt Stimmung, Bewegung und Licht festlegen, zum Beispiel he speaks low and teasing, a slow half smile and a raised eyebrow, warm amber light.
Aufnahme auf die Clip-Länge abstimmen
Unser Lauf nutzte eine 5-Sekunden-Aufnahme für einen 5-Sekunden-Clip. Wir haben keine Aufnahme getestet, die kürzer oder länger als duration_seconds ist; schneiden Sie Ihr Audio also auf die gewählte Länge zu.
Ohne Audio die Zeile in Anführungszeichen setzen
Setzen Sie, was die Person sagt, in Anführungszeichen, dann spricht das Modell es. Wir haben Englisch getestet.
Die Wahl zwischen Modellen
Wenn Sie die Sprachaufnahme und ein Porträt schon haben und einen längeren Clip möchten, bis zu 300 Sekunden, angetrieben von dieser Aufnahme, nutzen Sie OmniHuman 2.0; Kling Avatar 2.0 folgt derselben Idee. Wählen Sie daVinci-MagiHuman, wenn das Modell eine Zeile sprechen soll, die Sie schreiben, oder wenn Sie einen Clip im Format 9:16 brauchen.
API-Schnellstart
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "sand-ai/davinci-magihuman/image-to-video",
  "input": {
    "aspect_ratio": "16:9",
    "duration_seconds": 5,
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "resolution": "720p"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Authentifizierung, vollständiges Schema, Polling und Fehlerbehandlung stehen in der API-Referenz.