Revisar un guion largo exige las escenas que establecen quién sabe o posee qué. Enviar más parte del guion puede ayudar a descubrir una conexión que falta, pero también cambia la factura, sobre todo en el límite de 200.000 tokens.
Grok 4.3 es la opción de contexto largo de la gama de chat de Grok actual: acepta hasta 1.000.000 de tokens de entrada y ofrece reasoning_effort: "none", algo que los contratos actuales de 4.5, 4.6 y 4.7 no ofrecen. Vigile el límite de facturación: con 200.000 tokens de entrada en total ya se aplica el nivel superior, y ese nivel rige para toda la solicitud.
Precios y límites exactos
El contrato actual de SpicyAPI para xai/grok-4.3/chat admite partes de texto e imagen, hasta 256 mensajes y 128 definiciones de herramientas. No acepta partes de archivo/PDF ni de audio.
| Entrada total | Entrada sin caché / 1M | Entrada en caché / 1M | Salida / 1M |
|---|---|---|---|
| Menos de 200.000 tokens | $1.25 | $0.20 | $2.50 |
| 200.000 tokens o más | $2.50 | $0.40 | $5.00 |
El techo de entrada es de 1.000.000 de tokens. max_tokens es 4.096 por defecto y admite hasta 900.000, el techo de la respuesta visible. Los tokens de razonamiento se facturan por separado dentro del uso de salida y no están limitados por este tope. Los niveles de esfuerzo disponibles son none, low, medium, high y xhigh; el predeterminado es low.
Para una extracción exacta sencilla, empiece con none. Para una pregunta de continuidad difícil que abarca muchas escenas separadas, pruebe low o superior si la primera respuesta pasa por alto una conexión concreta. El razonamiento también consume salida facturada, así que la longitud de la respuesta visible por sí sola no permite reconstruir la factura.
Qué ocurre con 199.999 frente a 200.000 tokens
Con 4.000 tokens de salida facturados y sin caché:
| Entrada | Cálculo | Coste estimado |
|---|---|---|
| 199.999 | 199.999 × $1.25 / 1M + 4.000 × $2.50 / 1M | $0.25999875 |
| 200.000 | 200.000 × $2.50 / 1M + 4.000 × $5.00 / 1M | $0.52 |
La diferencia es un cambio de nivel, no el coste de un token más a la tarifa anterior. La entrada en caché también cuenta para el umbral. Con 50.000 tokens sin caché más 149.000 en caché y 4.000 de salida, la estimación es de $0.1023. Si la parte en caché sube a 150.000, la entrada total pasa a 200.000 y la estimación sube a $0.205.
No cuente de nuevo la parte en caché como entrada sin caché. La fórmula de la solicitud es:
cost = uncached_input × input_rate / 1,000,000
     + cached_input × cached_rate / 1,000,000
     + billed_output × output_rate / 1,000,000
Antes de enviar, cargue los mensajes y ajustes completos en el Playground de Grok 4.3 y revise la estimación de precio y el nivel. Incluya las instrucciones del sistema, las definiciones de herramientas, las imágenes y el historial reenviado: un recuento de caracteres no es un recuento exacto de tokens. Después, revise usage.prompt_tokens, que ya incluye la entrada en caché. No vuelva a sumar usage.prompt_tokens_details.cached_tokens. Compare la entrada total con 200.000 y use después el cargo liquidado para la factura final.
Ponga primero el guion reutilizable y la biblia de personajes, y al final la pregunta que cambia. Un prefijo estable puede permitir la reutilización, pero aplique la tarifa de caché solo a los tokens que se notifiquen como aciertos de caché.
El nivel se elige según la entrada total, incluido el historial enviado con esta llamada. Una retención inicial de saldo no refleja necesariamente el ahorro final por caché. Use el uso devuelto y el cargo liquidado para evaluar una solicitud real; todos los totales de aquí son aritmética ilustrativa.
La ventana de un millón de tokens es un límite para una sola solicitud de API. Es independiente de la cuota semanal de mensajes de una suscripción a la app de Grok. Con este endpoint de chat, en cada llamada envía el historial y el texto fuente que el modelo necesita; no adquiere sus conversaciones anteriores de la app solo porque el nombre del modelo le resulte familiar.
Pruébelo primero en el Playground
- Abra Grok 4.3 y cambie al Playground.
- Ponga en el System prompt la instrucción del ejemplo de abajo. En el cuadro de mensaje pegue las dos escenas (SCENE12 y SCENE18) y pida los traspasos de utilería que faltan. Elija la opción de razonamiento none y pulse Run model.
- Compruebe que la respuesta nombre tanto el termo como el maletín rojo y revise después la estimación de precio antes de enviar un guion completo.
Un caso práctico con un guion largo
Un guion romántico ficticio para adultos usa un maletín de cuero rojo y un termo de cobre con una banda azul. El problema de continuidad es la posesión: ¿quién llevaba cada objeto antes y después de una escena? Envíe el guion como texto con etiquetas de escena y pida los traspasos explícitos o ausentes, en lugar de pedirle al modelo que «revise todo».
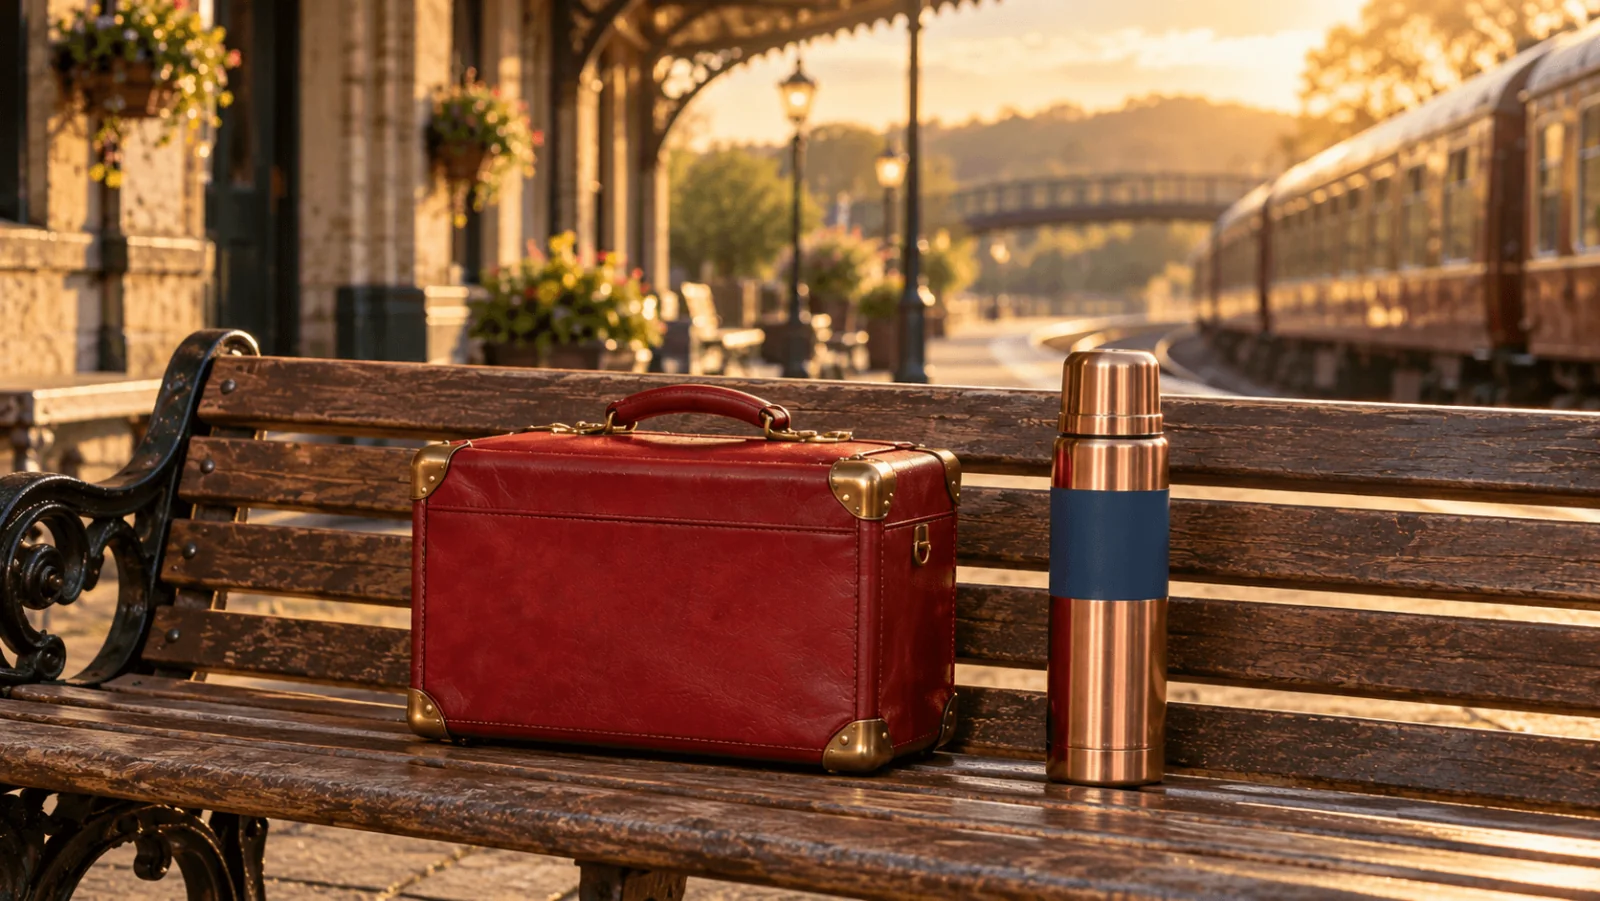
Ilustración de los objetos ficticios. No es una salida de Grok ni prueba de precisión visual; la llamada de abajo recibe sus descripciones escritas.
curl --fail-with-body https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Idempotency-Key: $(uuidgen)" \
  -d '{
    "model": "xai/grok-4.3/chat",
    "reasoning_effort": "none",
    "max_tokens": 2000,
    "response_format": {"type": "json_object"},
    "messages": [
      {"role": "system", "content": "Return JSON with missing_handoffs: a list of objects containing prop, missing_step and evidence_scene_ids (a nonempty list of supplied scene labels). Do not invent a handoff."},
      {"role": "user", "content": "Fictional adults: Mara, 32, Jon, 35. SCENE_12: Mara leaves her copper thermos with a blue band on the bench. Jon carries a closed red leather case. SCENE_18: Jon gives Mara the thermos; Mara opens the red case. Find ownership changes without an explicit handoff."}
    ]
  }' > response.json

python3 - <<'PY'
import json
from pathlib import Path

resp = json.loads(Path("response.json").read_text())
print(json.dumps({"usage": resp.get("usage")}, indent=2))
choices = resp.get("choices") or []
if resp.get("error") or not choices or choices[0].get("finish_reason") != "stop":
    raise RuntimeError("no complete continuity report")
text = choices[0].get("message", {}).get("content")
if not isinstance(text, str) or not text.strip():
    raise RuntimeError("empty report")
report = json.loads(text)
if not isinstance(report, dict) or not isinstance(report.get("missing_handoffs"), list):
    raise RuntimeError("missing_handoffs must be a list")
for item in report["missing_handoffs"]:
    if not isinstance(item, dict):
        raise RuntimeError("each finding must be an object")
    for key in ("prop", "missing_step"):
        if not isinstance(item.get(key), str) or not item[key].strip():
            raise RuntimeError(f"missing {key}")
    ids = item.get("evidence_scene_ids")
    if not isinstance(ids, list) or not ids or any(
        not isinstance(i, str) or i not in {"SCENE_12", "SCENE_18"} for i in ids
    ):
        raise RuntimeError("unsupported scene reference")
print(json.dumps(report, indent=2))
PY
Se esperan dos huecos: Jon debe recoger el termo del banco y el maletín rojo debe pasar de Jon a Mara. Ninguna de las dos acciones es imposible; ninguno de los dos traspasos figura en las escenas proporcionadas. Una respuesta correcta identifica ambos huecos con SCENE_12 y SCENE_18, en lugar de inventar una escena que los resuelva.
Para una comprobación programática, dé al modelo una forma de salida concreta: missing_handoffs es una lista de objetos con prop, missing_step y evidence_scene_ids. El único ejemplo comprueba esa forma antes de imprimir el informe.
El verificador valida la estructura del informe y las referencias de escena. Compare los dos hallazgos con el texto de las escenas antes de aceptar la edición; un JSON válido por sí solo no demuestra que el análisis de continuidad sea correcto.
Para un guion completo, sustituya el mensaje del usuario por el texto exportado de su borrador actual, conservando las mismas etiquetas de escena.
Para un guion largo, use la interfaz de streaming. Exporte primero el texto del PDF y conserve las etiquetas de escena que usan sus hallazgos.
Dé al guion largo una pregunta útil, no una invitación a resumir
Para la continuidad de utilería, mantenga una secuencia compacta con etiquetas de escena y acciones visibles: quién trajo el objeto, dónde se dejó y quién lo usa después. Una biblia de personajes establece el propietario habitual; no impide que otro personaje tome prestado el objeto. Pida los cambios que carecen de un traspaso indicado, no todas las apariciones que difieran de la tabla de propietarios.
En el ejemplo, que Jon le entregue el termo a Mara implica que lo recogió o lo recibió después de la escena 12. Que Mara abra el maletín rojo implica que tiene acceso al objeto de Jon. Son huecos que conviene revisar. Una corrección escrita por una persona podría hacer que Jon recoja el termo al salir del andén y ofrezca el maletín para que Mara lo abra. Otra corrección legítima mantiene la distancia entre los personajes y hace que cada uno manipule solo su propio objeto. Elija según el momento de la relación en la escena; el informe de continuidad no puede tomar por usted esa decisión creativa.
En una aplicación de compañía para adultos, el paquete equivalente contiene hechos estables de personajes ficticios, un breve relato de la relación actual y la conversación necesaria para la siguiente respuesta. Mantenga la distinción entre un hecho establecido y la afirmación de un participante. Si un personaje dice «nos conocimos el verano pasado» pero el historial aprobado indica que se conocieron ayer, el asistente no debe reescribir en silencio el registro del personaje. La afirmación puede ser una broma o una ficción deliberada dentro de la escena.
Por qué cincuenta respuestas cortas pueden costar más que una revisión larga
Cada llamada puede reenviar el contexto. Con 100.000 tokens de entrada en frío y 2.000 tokens de salida facturados, el cálculo de Grok 4.3 en el nivel inferior es de $0.13 por respuesta, o $6.50 por cincuenta respuestas con el mismo uso. Un paquete enfocado de 10.000 tokens de entrada con la misma salida cuesta $0.0175, o $0.875 por cincuenta. Estos casos aritméticos no suponen aciertos de caché ni una calidad equivalente.
Una entrada diez veces menor solo es útil si conserva la información que necesita la siguiente respuesta. Conserve el guion completo para una pregunta sobre todo el guion; lleve un historial aprobado y conciso para un intercambio local. Cuando un resumen omite el hecho de que una promesa sigue sin cumplirse, el prompt más barato puede producir una continuación peor. Compruebe los datos importantes de relación y continuidad antes de sustituir un paquete fuente por su resumen.
La opción none, admitida, es un punto de partida razonable para la extracción literal. No hace igual de fácil toda inferencia narrativa difícil. Si el traspaso que falta abarca varias escenas, asegúrese primero de haber proporcionado esas escenas y pruebe después más esfuerzo en esa pregunta definida. Aumentar el esfuerzo antes de aportar las pruebas solo permite una conjetura más elaborada.
Añada una imagen de referencia con la forma de mensaje correcta
Los tokens de imagen cuentan para el mismo techo de entrada y el mismo umbral de precio. Añada la imagen solo cuando la pregunta dependa del aspecto de los objetos.
Para una pregunta visual, sustituya el contenido de cadena del mensaje del usuario por partes tipadas (la documentación de la API de chat indica qué partes acepta cada modelo):
{
  "role": "user",
  "content": [
    {"type": "text", "text": "Describe the visible case and thermos. Do not infer an unseen handoff."},
    {"type": "image_url", "image_url": {"url": "https://cdn.spicyapi.ai/blog/authored/seo-next-twenty-2026-10-01/grok-4-3-context-budget-guide/body-1-gpt-image-66b06646fd526c4c.webp"}}
  ]
}
La imagen muestra el aspecto de los objetos; los cambios de propiedad siguen requiriendo el texto de la escena correspondiente. Proporcione ambos cuando una pregunta de continuidad dependa de un detalle visual.
Deje que un Agent prepare la llamada
Para comprobaciones de continuidad repetidas, pida a su Agent de programación que use el Skill de SpicyAPI: "Read xai/grok-4.3/chat, then adapt the example to my input; show the request before running it." La consulta con la CLI es spicyapi models get xai/grok-4.3/chat --json; la consulta con el MCP es spicyapi_model_get con model: "xai/grok-4.3/chat". Las llamadas de chat usan un cliente compatible o la API de chat; los comandos de tareas multimedia no generan respuestas de chat.
Observaciones sobre contenido para adultos y elección de modelo
La reseña de Grok 4.3 informa de que 8 de 9 solicitudes de escenas para adultos de mayor intensidad se completaron en las pruebas de septiembre de 2026, con una respuesta suavizada. Para un guion para adultos, indique en el mensaje del sistema el encargo de edición de ficción y aporte los pasajes que deben conservarse.
Para un creador de contenido para adultos que necesita una biblia de personajes extensa más el guion, los atractivos prácticos son su techo de entrada, la tarifa de salida más baja y una opción de esfuerzo none genuina. Grok 4.5 y 4.6 y Grok 4.7 comparten un techo menor de 500.000 tokens y cuestan $2.00 por millón de entrada sin caché y $6.00 por millón de salida por debajo de 200K de entrada, frente a $1.25 y $2.50 en Grok 4.3. La entrada en caché cuesta $0.30 en 4.5 y $0.50 en 4.6 y 4.7, frente a $0.20 en Grok 4.3.
Soluciones para sorpresas habituales
| Síntoma | Solución directa |
|---|---|
| Más caro que la estimación del nivel inferior | Incluir la entrada en caché y el historial de la conversación en el umbral de 200.000 tokens |
| La salida facturada supera lo que sugiere el texto visible | Tener en cuenta el razonamiento; usar none en una tarea acotada adecuada |
| Parte PDF o de audio rechazada | Extraer el texto o usar una vía de transcripción específica |
| El modelo rellena un traspaso ausente con una escena nueva | Exigir solo las etiquetas proporcionadas y rechazar las referencias de escena sin respaldo |
| Un paquete grande provoca un tiempo de espera agotado de la pasarela | Transmitir la respuesta en streaming; aumentar el tiempo de espera del cliente no amplía el límite de unos 100 segundos del edge para solicitudes sin streaming |
| La salida de una herramienta no permite continuar la conversación | Conservar en el historial el mensaje de llamada a herramienta del asistente y los ID de llamada correspondientes |
| El JSON se corta | Aumentar max_tokens o pedir menos hallazgos de continuidad |
Con qué configuración empezar
Use Grok 4.3 con none para un informe de continuidad acotado cuando importen el coste y un paquete fuente grande. Empiece por la evidencia de escenas en lugar de reescribir todo el guion. Mantenga el paquete por debajo de 200.000 tokens cuando la tarea lo permita; cuando la conexión que falta dependa de escenas distantes, pague el contexto necesario en lugar de descartar la escena que prueba la respuesta.
FAQ
¿La ventana de un millón de tokens de la API es lo mismo que la memoria de la app de Grok?
No. Todo lo que el modelo deba saber tiene que estar en la solicitud: pegue las escenas anteriores o un resumen de ellas. El historial de su app de Grok y su cuota de mensajes no se trasladan a las llamadas de API.
¿La entrada en caché cuenta para el umbral de 200.000 tokens?
Sí. Los tokens en caché y el historial reenviado cuentan todos, así que un chat largo puede cruzar la línea aunque la mayor parte esté en caché. Las tarifas más altas se aplican entonces a toda la solicitud; por eso, recorte los turnos antiguos antes de la llamada final si está cerca.
¿none garantiza la respuesta más barata?
Elimina el modo de razonamiento expuesto, lo que lo convierte en un buen punto de partida para una extracción pequeña. La factura sigue dependiendo de la entrada, las categorías de caché, la salida visible y el nivel seleccionado; una respuesta más larga o un paquete mayor cuesta más.
¿Puede el modelo encontrar todos los errores de continuidad en un guion de un millón de tokens?
La ventana es capacidad, no una garantía de recuerdo perfecto. Etiquete las escenas, haga una pregunta de continuidad concreta y verifique los pasajes citados. Tras encontrar el traspaso que falta, pida una reparación local en lugar de regenerar todo el guion.





