긴 대본을 검토하려면 누가 무엇을 알고 있는지, 무엇을 갖고 있는지를 정해 주는 장면이 필요해요. 대본을 더 많이 보내면 빠진 연결을 드러내는 데 도움이 될 수 있지만, 청구 금액도 달라져요. 특히 200,000토큰 경계에서 그래요.
Grok 4.3은 현재 Grok 채팅 라인업에서 긴 컨텍스트를 다룰 수 있는 선택지예요. 입력을 최대 1,000,000토큰까지 받고, 현재 4.5·4.6·4.7 계약에는 없는 reasoning_effort: "none"을 쓸 수 있어요. 과금 경계를 눈여겨보세요. 입력 총합이 200,000토큰이 되면 이미 더 높은 요금 구간이 적용되고, 그 구간은 요청 전체에 적용돼요.
정확한 가격과 한도
xai/grok-4.3/chat에 대한 현재 SpicyAPI 계약은 텍스트와 이미지 파트, 최대 256개 메시지, 128개 도구 정의를 지원해요. 파일/PDF와 오디오 파트는 받지 않아요.
| 입력 총합 | 캐시 없는 입력 / 1M | 캐시된 입력 / 1M | 출력 / 1M |
|---|---|---|---|
| 200,000토큰 미만 | $1.25 | $0.20 | $2.50 |
| 200,000토큰 이상 | $2.50 | $0.40 | $5.00 |
입력 상한은 1,000,000토큰이에요. max_tokens 기본값은 4,096이고 최대 900,000까지 받는데, 이는 눈에 보이는 답변의 상한이에요. 추론 토큰은 출력 사용량 안에서 따로 과금되며 이 상한의 제한을 받지 않아요. 사용할 수 있는 effort는 none, low, medium, high, xhigh이고 기본값은 low예요.
단순하고 정확한 추출이라면 none으로 시작하세요. 멀리 떨어진 여러 장면에 걸친 어려운 연속성 질문이라면, 첫 답변이 특정 연결을 놓칠 때 low 이상을 시도해 보세요. 추론도 과금되는 출력을 소비하므로, 눈에 보이는 답변 길이만으로는 청구 금액을 계산할 수 없어요.
199,999토큰과 200,000토큰의 차이
과금되는 출력이 4,000토큰이고 캐시가 없을 때예요.
| 입력 수 | 계산 | 예상 비용 |
|---|---|---|
| 199,999 | 199,999 × $1.25 / 1M + 4,000 × $2.50 / 1M | $0.25999875 |
| 200,000 | 200,000 × $2.50 / 1M + 4,000 × $5.00 / 1M | $0.52 |
이 차이는 요금 구간이 바뀐 결과이지, 이전 요율로 토큰 하나가 늘어난 비용이 아니에요. 캐시된 입력도 경계에 포함돼요. 캐시 없는 입력 50,000토큰에 캐시된 입력 149,000토큰, 출력 4,000토큰이면 예상 비용은 $0.1023이에요. 캐시된 부분을 150,000토큰으로 늘리면 입력 총합이 200,000토큰이 되어 예상 비용이 $0.205로 올라가요.
캐시된 부분을 캐시 없는 입력으로 다시 세지 마세요. 요청 계산식은 이래요.
cost = uncached_input × input_rate / 1,000,000
     + cached_input × cached_rate / 1,000,000
     + billed_output × output_rate / 1,000,000
보내기 전에 전체 메시지와 설정을 Grok 4.3 Playground에 불러와 가격 예상치와 요금 구간을 확인하세요. 시스템 지침, 도구 정의, 이미지, 다시 보내는 기록도 포함하세요. 글자 수는 정확한 토큰 수가 아니에요. 보낸 뒤에는 캐시된 입력을 이미 포함하는 usage.prompt_tokens를 확인하세요. usage.prompt_tokens_details.cached_tokens를 다시 더하지 마세요. 입력 총합을 200,000과 비교한 다음, 최종 청구에는 확정된 과금액을 쓰세요.
재사용하는 대본과 등장인물 설정집을 앞에 두고, 바뀌는 질문을 맨 뒤에 두세요. 안정적인 접두부는 재사용을 가능하게 하지만, 캐시 요율은 캐시 히트로 보고된 토큰에만 적용하세요.
요금 구간은 이번 호출과 함께 보내는 기록을 포함한 입력 총합으로 정해져요. 처음에 잡히는 잔액 보류 금액이 최종 캐시 절감을 반드시 반영하는 것은 아니에요. 실제 요청을 평가할 때는 반환된 사용량과 확정된 과금액을 쓰세요. 여기 나오는 합계는 모두 예시용 계산이에요.
100만 토큰 창은 API 요청 한 번에 대한 한도예요. Grok 앱 구독의 주간 메시지 허용량과는 별개예요. 이 채팅 엔드포인트에서는 모델에 필요한 기록과 원문 텍스트를 호출마다 보내야 해요. 모델 이름이 익숙하다고 해서 앱에서 나눴던 이전 대화를 알게 되지는 않아요.
먼저 Playground에서 해 보기
- Grok 4.3을 열고 Playground로 전환하세요.
- System prompt에 아래 예시의 지침을 입력하세요. 메시지 입력란에 두 장면(SCENE12와 SCENE18)을 붙여 넣고 빠진 소품 전달을 물어보세요. 추론 옵션은 none을 고르고 Run model을 누르세요.
- 답변에 보온병과 빨간 케이스가 모두 언급되는지 확인한 뒤, 전체 대본을 보내기 전에 가격 예상치를 확인하세요.
긴 대본을 쓰는 실전 사례
가상의 성인 로맨스 대본에 빨간 가죽 케이스와 파란 띠가 있는 구리색 보온병이 나와요. 연속성 문제는 소유예요. 장면 전후에 각 소품을 누가 들고 있었을까요? 모델에게 "전부 검토해 줘"라고 하지 말고, 장면 라벨이 붙은 텍스트로 대본을 보내서 명시된 전달이나 빠진 전달을 물어보세요.
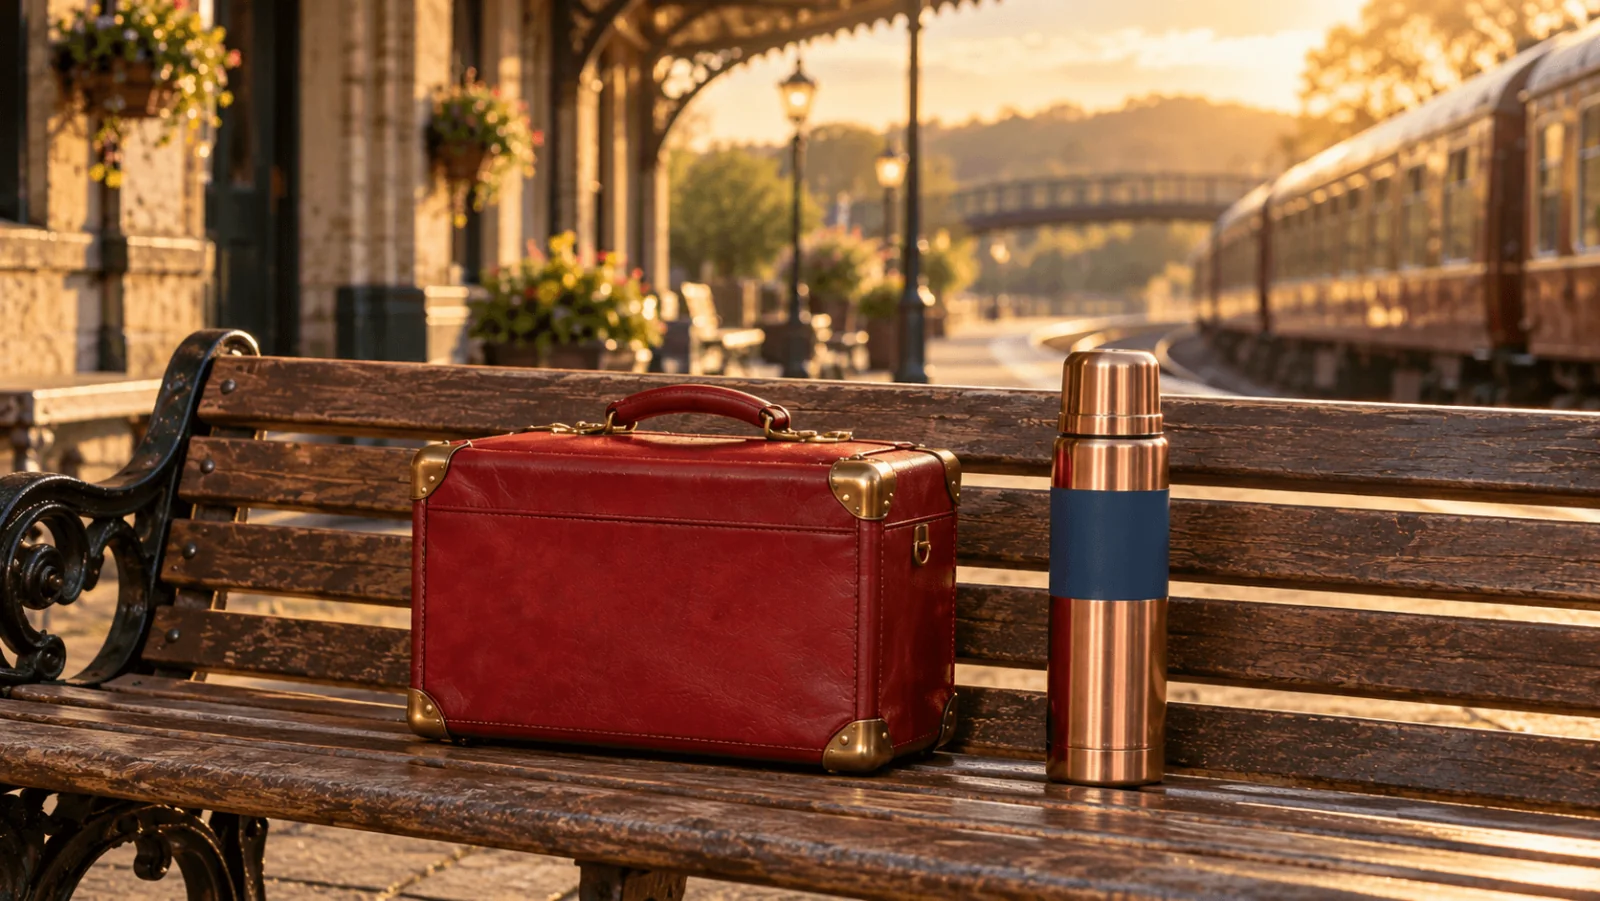
가상의 소품을 그린 일러스트예요. Grok의 출력이 아니며 시각적 정확성의 증거도 아니에요. 아래 호출이 받는 것은 소품에 대한 글 설명이에요.
curl --fail-with-body https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Idempotency-Key: $(uuidgen)" \
  -d '{
    "model": "xai/grok-4.3/chat",
    "reasoning_effort": "none",
    "max_tokens": 2000,
    "response_format": {"type": "json_object"},
    "messages": [
      {"role": "system", "content": "Return JSON with missing_handoffs: a list of objects containing prop, missing_step and evidence_scene_ids (a nonempty list of supplied scene labels). Do not invent a handoff."},
      {"role": "user", "content": "Fictional adults: Mara, 32, Jon, 35. SCENE_12: Mara leaves her copper thermos with a blue band on the bench. Jon carries a closed red leather case. SCENE_18: Jon gives Mara the thermos; Mara opens the red case. Find ownership changes without an explicit handoff."}
    ]
  }' > response.json

python3 - <<'PY'
import json
from pathlib import Path

resp = json.loads(Path("response.json").read_text())
print(json.dumps({"usage": resp.get("usage")}, indent=2))
choices = resp.get("choices") or []
if resp.get("error") or not choices or choices[0].get("finish_reason") != "stop":
    raise RuntimeError("no complete continuity report")
text = choices[0].get("message", {}).get("content")
if not isinstance(text, str) or not text.strip():
    raise RuntimeError("empty report")
report = json.loads(text)
if not isinstance(report, dict) or not isinstance(report.get("missing_handoffs"), list):
    raise RuntimeError("missing_handoffs must be a list")
for item in report["missing_handoffs"]:
    if not isinstance(item, dict):
        raise RuntimeError("each finding must be an object")
    for key in ("prop", "missing_step"):
        if not isinstance(item.get(key), str) or not item[key].strip():
            raise RuntimeError(f"missing {key}")
    ids = item.get("evidence_scene_ids")
    if not isinstance(ids, list) or not ids or any(
        not isinstance(i, str) or i not in {"SCENE_12", "SCENE_18"} for i in ids
    ):
        raise RuntimeError("unsupported scene reference")
print(json.dumps(report, indent=2))
PY
예상되는 빈틈은 두 가지예요. Jon이 벤치에서 보온병을 되찾아야 하고, 빨간 케이스가 Jon에게서 Mara에게 넘어가야 해요. 두 행동 모두 불가능하지는 않지만, 제공된 장면 어디에도 두 전달이 적혀 있지 않아요. 올바른 답변은 이를 메우는 장면을 지어내지 않고 SCENE_12와 SCENE_18을 근거로 두 빈틈을 모두 짚어 내요.
프로그램으로 확인하려면 모델에 구체적인 출력 형태를 알려 주세요. missing_handoffs는 prop, missing_step, evidence_scene_ids를 가진 객체의 목록이에요. 이 예시 하나는 보고서를 출력하기 전에 이 형태를 검증해요.
검증기는 보고서의 구조와 장면 참조를 확인해요. 수정을 받아들이기 전에 두 결과를 장면 텍스트와 비교하세요. JSON이 올바르다는 사실만으로는 연속성 분석이 옳다고 할 수 없어요.
전체 대본이라면 사용자 메시지를 현재 초고에서 내보낸 텍스트로 바꾸고 같은 장면 라벨을 유지하세요.
긴 대본에는 스트리밍 인터페이스를 쓰세요. 먼저 PDF 텍스트를 내보내고, 결과에서 사용하는 장면 라벨을 그대로 유지하세요.
긴 대본에는 요약 요청이 아니라 쓸모 있는 질문을
소품 연속성을 보려면 장면 라벨과 눈에 보이는 행동을 담은 간결한 순서를 유지하세요. 누가 물건을 가져왔는지, 어디에 두었는지, 다음에 누가 쓰는지예요. 등장인물 설정집은 평소의 주인을 정할 뿐, 다른 인물이 그 물건을 빌리는 것을 막지는 않아요. 소유자 표와 다른 모든 등장을 묻지 말고, 전달이 명시되지 않은 변화를 물어보세요.
이 예시에서 Jon이 Mara에게 보온병을 건네면 그가 장면 12 이후에 그것을 되찾았거나 받았다는 뜻이에요. Mara가 빨간 케이스를 열면 그녀가 Jon의 물건에 접근할 수 있다는 뜻이고요. 이런 빈틈은 살펴봐야 해요. 사람이 쓰는 수정안은 플랫폼을 떠나면서 Jon이 보온병을 챙기고 Mara가 열 수 있게 케이스를 내미는 식일 수 있어요. 또 다른 타당한 수정안은 두 인물의 거리를 유지하고 각자 자기 물건만 다루게 하는 거예요. 장면의 관계 비트에 맞춰 고르세요. 연속성 보고서가 이 창작상의 결정을 대신 내려 줄 수는 없어요.
성인용 컴패니언 애플리케이션이라면, 같은 역할의 패키지에 가상 인물에 대한 안정적인 사실, 현재 관계에 대한 짧은 설명, 다음 답장에 필요한 대화를 담아요. 확립된 사실과 참여자의 주장을 구분하세요. 인물이 "우린 작년 여름에 만났어"라고 말하는데 승인된 기록에는 어제 만났다고 되어 있다면, 어시스턴트가 인물 기록을 조용히 고쳐 쓰면 안 돼요. 그 말은 농담이거나 장면 안의 의도적인 꾸밈일 수 있어요.
짧은 답장 50번이 긴 검토 한 번보다 비쌀 수 있는 이유
호출마다 컨텍스트를 다시 보낼 수 있어요. 캐시 없는 입력 100,000토큰과 과금 출력 2,000토큰이면 Grok 4.3의 낮은 요금 구간 계산은 답장당 $0.13이고, 같은 사용량으로 50번이면 $6.50이에요. 같은 출력에 입력을 10,000토큰으로 좁힌 패키지는 $0.0175, 50번이면 $0.875예요. 이 계산 사례는 캐시 히트나 동일한 품질을 가정하지 않아요.
입력이 10분의 1로 줄어드는 것은 다음 답장에 필요한 정보가 남아 있을 때만 쓸모가 있어요. 대본 전체에 대한 질문에는 전체 대본을 쓰고, 국소적인 주고받기에는 승인된 간결한 기록을 가지고 가세요. 약속이 아직 지켜지지 않았다는 사실이 요약에서 빠지면, 더 싼 프롬프트가 더 나쁜 이어 쓰기를 만들 수 있어요. 원본 패키지를 요약으로 바꾸기 전에 중요한 관계와 연속성 사실을 확인하세요.
지원되는 none 옵션은 문자 그대로의 추출에서 출발하기에 합리적이에요. 하지만 어려운 서사적 추론까지 똑같이 쉬워지지는 않아요. 빠진 전달이 여러 장면에 걸쳐 있다면 먼저 그 장면들을 제공했는지 확인하고, 그 정해 둔 질문에 더 높은 effort를 시도하세요. 근거를 제공하기 전에 effort를 올려 봐야 더 정교한 추측이 가능해질 뿐이에요.
올바른 메시지 형태로 참고 이미지 추가하기
이미지 토큰도 같은 입력 상한과 가격 경계에 포함돼요. 질문이 소품의 생김새에 달려 있을 때만 이미지를 추가하세요.
시각적인 질문이라면 사용자 메시지의 문자열 content를 타입이 지정된 파트로 바꾸세요. 모델별로 받는 파트는 채팅 API 문서에 나와 있어요.
{
  "role": "user",
  "content": [
    {"type": "text", "text": "Describe the visible case and thermos. Do not infer an unseen handoff."},
    {"type": "image_url", "image_url": {"url": "https://cdn.spicyapi.ai/blog/authored/seo-next-twenty-2026-10-01/grok-4-3-context-budget-guide/body-1-gpt-image-66b06646fd526c4c.webp"}}
  ]
}
이미지는 소품의 생김새를 보여 줘요. 소유 변화에는 여전히 해당 장면의 텍스트가 필요해요. 연속성 질문이 시각적 디테일에 달려 있다면 둘 다 제공하세요.
Agent에게 호출 준비를 맡기기
연속성 점검을 반복한다면 코딩용 Agent에게 SpicyAPI Skill을 쓰도록 요청하세요. "Read xai/grok-4.3/chat, then adapt the example to my input; show the request before running it." CLI로 조회하는 명령은 spicyapi models get xai/grok-4.3/chat --json이고, MCP로 조회하려면 model: "xai/grok-4.3/chat"을 지정한 spicyapi_model_get을 쓰세요. 채팅 호출에는 호환 클라이언트나 채팅 API를 써요. 미디어 태스크 명령으로는 채팅 답장이 생성되지 않아요.
성인 콘텐츠 관찰 결과와 모델 선택
Grok 4.3 리뷰는 2026년 9월 테스트에서 강도가 더 높은 성인 장면 요청 9건 중 8건이 완료됐고 한 건은 표현이 누그러졌다고 보고해요. 성인용 대본이라면 시스템 메시지에 허구의 편집 업무임을 밝히고 보존할 구절을 제공하세요.
큰 등장인물 설정집과 대본을 함께 다뤄야 하는 성인 콘텐츠 제작자에게 실용적인 매력은 입력 상한, 낮은 출력 요율, 진짜 none effort 옵션이에요. Grok 4.5와 4.6 및 Grok 4.7은 더 작은 500,000토큰 상한을 공유하고, 입력이 200K 미만일 때 캐시 없는 입력이 100만 토큰당 $2.00, 출력이 100만 토큰당 $6.00이에요. Grok 4.3은 $1.25와 $2.50이에요. 캐시된 입력은 4.5에서 $0.30, 4.6과 4.7에서 $0.50이지만 Grok 4.3에서는 $0.20이에요.
흔한 예상 밖 상황의 해결
| 증상 | 바로 할 수 있는 해결 |
|---|---|
| 낮은 요금 구간 예상치보다 비싸요 | 캐시된 입력과 대화 기록을 200,000토큰 경계에 포함하세요 |
| 과금 출력이 눈에 보이는 텍스트로 예상한 양을 넘어요 | 추론을 고려하세요. 범위가 정해진 적합한 작업에는 none을 쓰세요 |
| PDF나 오디오 파트가 거부돼요 | 텍스트를 추출하거나 전용 전사 경로를 쓰세요 |
| 모델이 빠진 전달을 새 장면으로 채워요 | 제공한 라벨만 요구하고, 근거 없는 장면 참조는 거부하세요 |
| 큰 패키지에서 게이트웨이 타임아웃이 나요 | 응답을 스트리밍하세요. 클라이언트 타임아웃을 늘려도 비스트리밍에 대한 엣지의 약 100초 제한은 늘어나지 않아요 |
| 도구 출력으로 대화를 이어 갈 수 없어요 | 어시스턴트의 도구 호출 메시지와 일치하는 호출 ID를 기록에 남기세요 |
| JSON이 잘려요 | max_tokens를 늘리거나 연속성 지적 수를 줄여 요청하세요 |
어떤 구성으로 시작할까
비용과 큰 원본 패키지가 중요하고 범위가 정해진 연속성 보고서가 필요하다면 Grok 4.3을 none으로 쓰세요. 대본 전체를 다시 쓰기보다 장면 근거에서 시작하세요. 작업이 허락한다면 패키지를 200,000토큰 아래로 유지하세요. 빠진 연결이 멀리 떨어진 장면에 달려 있다면, 답을 증명하는 장면을 빼지 말고 필요한 컨텍스트 값을 치르세요.
FAQ
API의 100만 토큰 창은 Grok 앱의 기억과 같은가요?
아니요. 모델이 알아야 하는 모든 내용은 요청 안에 있어야 해요. 이전 장면이나 그 요약을 붙여 넣으세요. Grok 앱 기록과 메시지 허용량은 API 호출로 이어지지 않아요.
캐시된 입력도 200,000토큰 경계에 포함되나요?
네. 캐시된 토큰과 다시 보내는 기록이 모두 포함되므로, 대부분이 캐시여도 긴 대화는 경계를 넘을 수 있어요. 그러면 더 높은 요율이 요청 전체에 적용되니, 경계에 가깝다면 마지막 호출 전에 오래된 대화를 줄이세요.
none이면 항상 가장 싼 답변인가요?
공개된 추론 모드를 없애 주므로 작은 추출의 출발점으로 쓸모가 있어요. 다만 청구 금액은 여전히 입력, 캐시 구분, 눈에 보이는 출력, 선택된 요금 구간에 따라 달라져요. 답변이 더 길거나 패키지가 더 크면 비용이 더 들어요.
100만 토큰짜리 대본의 연속성 오류를 모델이 전부 찾을 수 있나요?
창은 용량일 뿐, 완벽한 회상을 보장하지는 않아요. 장면에 라벨을 붙이고, 구체적인 연속성 질문을 하고, 인용된 구절을 확인하세요. 빠진 전달을 찾은 뒤에는 대본 전체를 다시 생성하지 말고 그 부분만 고쳐 달라고 요청하세요.





