長いシナリオを見直すには、誰が何を知っているか、何を持っているかを決める場面が必要です。シナリオをより多く送れば、欠けているつながりを見つけやすくなりますが、請求額も変わります。特に 200,000 トークンの境界では注意が必要です。
Grok 4.3 は、現在の Grok チャットのラインナップで長いコンテキストを扱える選択肢です。入力は最大 1,000,000 トークンまで受け付け、現行の 4.5、4.6、4.7 の契約にはない reasoning_effort: "none" を使えます。課金の境界に注意してください。入力の合計が 200,000 トークンに達した時点で上位の料金帯が適用され、その料金帯はリクエスト全体に及びます。
正確な価格と上限
xai/grok-4.3/chat に対する現在の SpicyAPI の契約では、テキストと画像のパート、最大 256 件のメッセージ、128 件のツール定義に対応しています。ファイル/PDF やオーディオのパートは受け付けません。
| 入力の合計 | キャッシュなしの入力 / 1M | キャッシュありの入力 / 1M | 出力 / 1M |
|---|---|---|---|
| 200,000 トークン未満 | $1.25 | $0.20 | $2.50 |
| 200,000 トークン以上 | $2.50 | $0.40 | $5.00 |
入力の上限は 1,000,000 トークンです。max_tokens の既定値は 4,096 で、最大 900,000 まで指定できます。これは目に見える返信の上限です。推論トークンは出力の使用量の中で別に課金され、この上限では制限されません。使える effort は none、low、medium、high、xhigh で、既定は low です。
単純で正確な抽出なら、まず none から始めます。離れた多数の場面にまたがる難しい整合性の質問では、最初の回答が特定のつながりを見落とした場合に low 以上を試してください。推論も課金対象の出力を消費するため、見えている回答の長さだけでは請求額を再現できません。
199,999 トークンと 200,000 トークンの違い
課金対象の出力が 4,000 トークンで、キャッシュがない場合:
| 入力数 | 計算 | 見積もり費用 |
|---|---|---|
| 199,999 | 199,999 × $1.25 / 1M + 4,000 × $2.50 / 1M | $0.25999875 |
| 200,000 | 200,000 × $2.50 / 1M + 4,000 × $5.00 / 1M | $0.52 |
この差は料金帯の切り替えによるもので、旧料金で 1 トークン増えた分の費用ではありません。キャッシュありの入力も境界に含まれます。キャッシュなし 50,000 トークンにキャッシュあり 149,000 トークン、出力 4,000 トークンの場合、見積もりは $0.1023 です。キャッシュ分を 150,000 に増やすと入力の合計が 200,000 になり、見積もりは $0.205 に上がります。
キャッシュ分をキャッシュなしとして二重に数えないでください。リクエストの計算式は次のとおりです。
cost = uncached_input × input_rate / 1,000,000
     + cached_input × cached_rate / 1,000,000
     + billed_output × output_rate / 1,000,000
送信前に、完全なメッセージと設定を Grok 4.3 の Playground に読み込み、価格の見積もりと料金帯を確認します。システム指示、ツール定義、画像、再送する履歴も含めてください。文字数は正確なトークン数ではありません。送信後は、キャッシュありの入力をすでに含む usage.prompt_tokens を確認します。usage.prompt_tokens_details.cached_tokens をさらに加算しないでください。入力の合計を 200,000 と比べ、最終的な請求額には確定した課金額を使います。
再利用するシナリオと登場人物設定集を先頭に置き、変わる質問を最後に置きます。安定したプレフィックスは再利用を可能にしますが、キャッシュ料金を適用するのはキャッシュヒットとして報告されたトークンだけです。
料金帯は、この呼び出しで送る履歴を含む入力の合計で決まります。最初の残高の確保額が、最終的なキャッシュによる節約を反映しているとは限りません。実際のリクエストを評価するには、返された使用量と確定した課金額を使ってください。ここに示した合計はすべて説明用の計算です。
100 万トークンのウィンドウは、1 回の API リクエストに対する上限です。Grok アプリのサブスクリプションにある週ごとのメッセージ上限とは別のものです。このチャットのエンドポイントでは、モデルが必要とする履歴と元のテキストを呼び出しのたびに送ります。モデル名に見覚えがあるからといって、アプリでの過去の会話をモデルが知っているわけではありません。
まず Playground で試す
- Grok 4.3 を開き、Playground に切り替えます。
- System prompt に、下の例の指示を設定します。メッセージ欄に 2 つの場面(SCENE12 と SCENE18)を貼り付け、小道具の受け渡しの抜けを尋ねます。推論のオプションは none を選び、Run model を押します。
- 回答に魔法瓶と赤いケースの両方が挙がっていることを確かめ、シナリオ全体を送る前に価格の見積もりを確認します。
長いシナリオでの実用例
架空の成人向けロマンスのシナリオに、赤い革のケースと青い帯のついた銅色の魔法瓶が登場します。整合性の問題は持ち主です。場面の前後で、それぞれの小道具を誰が持っていたでしょうか。モデルに「全部見直して」と頼むのではなく、場面ラベル付きのテキストとしてシナリオを送り、明示された受け渡し、または抜けている受け渡しを尋ねます。
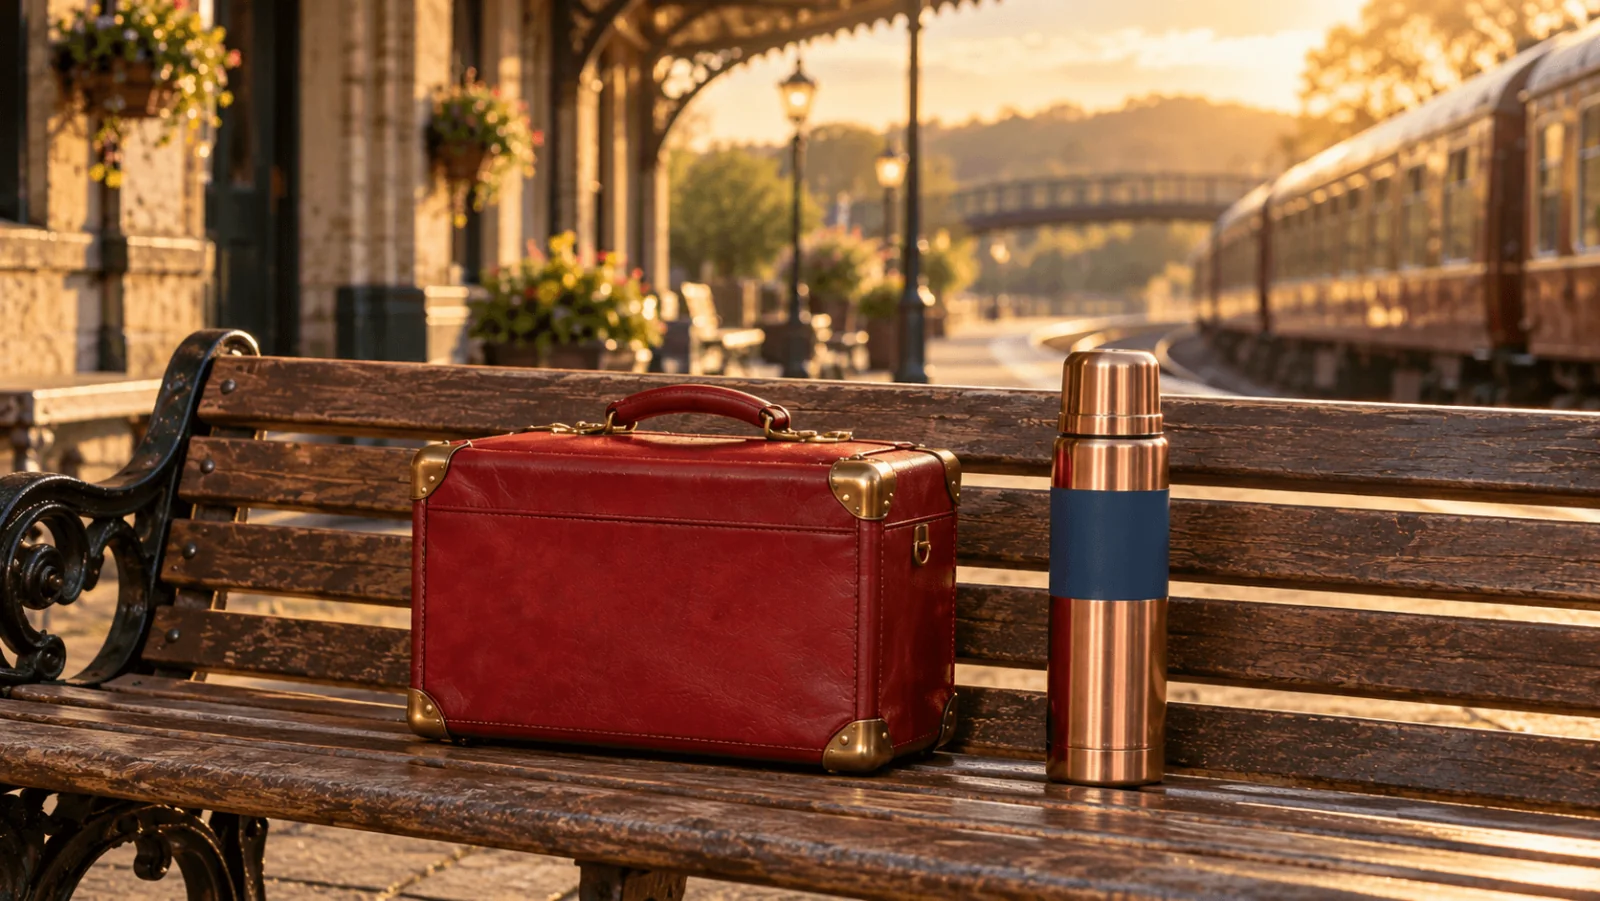
架空の小道具のイラストです。Grok の出力ではなく、見た目の正確さを示す証拠でもありません。下の呼び出しが受け取るのは、その文章による説明です。
curl --fail-with-body https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Idempotency-Key: $(uuidgen)" \
  -d '{
    "model": "xai/grok-4.3/chat",
    "reasoning_effort": "none",
    "max_tokens": 2000,
    "response_format": {"type": "json_object"},
    "messages": [
      {"role": "system", "content": "Return JSON with missing_handoffs: a list of objects containing prop, missing_step and evidence_scene_ids (a nonempty list of supplied scene labels). Do not invent a handoff."},
      {"role": "user", "content": "Fictional adults: Mara, 32, Jon, 35. SCENE_12: Mara leaves her copper thermos with a blue band on the bench. Jon carries a closed red leather case. SCENE_18: Jon gives Mara the thermos; Mara opens the red case. Find ownership changes without an explicit handoff."}
    ]
  }' > response.json

python3 - <<'PY'
import json
from pathlib import Path

resp = json.loads(Path("response.json").read_text())
print(json.dumps({"usage": resp.get("usage")}, indent=2))
choices = resp.get("choices") or []
if resp.get("error") or not choices or choices[0].get("finish_reason") != "stop":
    raise RuntimeError("no complete continuity report")
text = choices[0].get("message", {}).get("content")
if not isinstance(text, str) or not text.strip():
    raise RuntimeError("empty report")
report = json.loads(text)
if not isinstance(report, dict) or not isinstance(report.get("missing_handoffs"), list):
    raise RuntimeError("missing_handoffs must be a list")
for item in report["missing_handoffs"]:
    if not isinstance(item, dict):
        raise RuntimeError("each finding must be an object")
    for key in ("prop", "missing_step"):
        if not isinstance(item.get(key), str) or not item[key].strip():
            raise RuntimeError(f"missing {key}")
    ids = item.get("evidence_scene_ids")
    if not isinstance(ids, list) or not ids or any(
        not isinstance(i, str) or i not in {"SCENE_12", "SCENE_18"} for i in ids
    ):
        raise RuntimeError("unsupported scene reference")
print(json.dumps(report, indent=2))
PY
想定される抜けは 2 つあります。Jon がベンチから魔法瓶を取り戻す必要があること、そして赤いケースが Jon から Mara に渡る必要があることです。どちらの行動も不可能ではありませんが、渡された場面のどちらにも受け渡しは書かれていません。正しい回答は、それを解決する場面を作り出すのではなく、SCENE_12 と SCENE_18 を使って 2 つの抜けを指摘します。
プログラムでチェックするには、モデルに具体的な出力の形を示します。missing_handoffs は、prop、missing_step、evidence_scene_ids を持つオブジェクトのリストです。この 1 つの例では、レポートを出力する前にこの形を検証します。
チェッカーが検証するのはレポートの構造と場面の参照です。修正を受け入れる前に、2 つの指摘を場面のテキストと突き合わせてください。JSON が正しいというだけでは、整合性の分析が正しいとは言えません。
シナリオ全体の場合は、ユーザーメッセージを現在の稿から書き出したテキストに置き換え、同じ場面ラベルを保ちます。
長いシナリオでは、ストリーミングのインターフェースを使います。先に PDF のテキストを書き出し、指摘で使う場面ラベルを残しておきます。
長いシナリオには、要約の依頼ではなく役立つ質問を
小道具の整合性では、場面ラベルと目に見える動作を並べた簡潔な流れを用意します。誰がそのアイテムを持ってきたか、どこに置かれたか、次に誰が使うかです。登場人物設定集が決めるのは通常の持ち主であり、別の人物がそれを借りることを禁じるものではありません。持ち主の表と違う登場をすべて挙げるのではなく、受け渡しが明記されていない変化を尋ねてください。
この例では、Jon が Mara に魔法瓶を渡すということは、場面 12 のあとに彼が取り戻したか受け取ったことを意味します。Mara が赤いケースを開けるということは、彼女が Jon の持ち物に触れられることを意味します。どちらも調べるべき抜けです。人が書く修正案としては、ホームを離れるときに Jon が魔法瓶を拾い、Mara が開けられるようにケースを差し出す、というものが考えられます。別の妥当な修正は、二人の距離を保ち、それぞれが自分の持ち物だけを扱うというものです。場面での二人の関係の見せ場に合わせて選んでください。この創作上の判断を整合性レポートが代わりに下すことはできません。
成人向けのコンパニオンアプリでは、同様のパッケージに、架空の登場人物についての安定した事実、現在の関係の短い説明、次の返信に必要な会話を入れます。確立された事実と、参加者の主張とを区別してください。登場人物が「去年の夏に会ったよね」と言っても、承認済みの履歴では昨日会ったことになっている場合、アシスタントは登場人物の記録を黙って書き換えてはいけません。その発言は冗談かもしれず、場面の中での意図的な作り話かもしれません。
短い返信 50 回が 1 回の長いレビューより高くつく理由
呼び出しのたびにコンテキストを再送することがあります。キャッシュなしの入力 100,000 トークン、課金対象の出力 2,000 トークンの場合、Grok 4.3 の低い料金帯での計算は 1 回の返信あたり $0.13、同じ使い方で 50 回なら $6.50 です。同じ出力で入力を絞った 10,000 トークンのパッケージなら $0.0175、50 回で $0.875 です。これらの計算例は、キャッシュヒットや同等の品質を前提にしていません。
入力が 10 分の 1 になることが役に立つのは、次の返信に必要な情報が残る場合だけです。シナリオ全体についての質問には完全なシナリオを使い、局所的なやり取りには承認済みの簡潔な履歴を持ち回ります。要約から約束がまだ果たされていないという事実が抜けると、安いプロンプトのほうが質の低い続きを生むことがあります。元のパッケージを要約に置き換える前に、重要な関係や整合性の事実を確認してください。
サポートされている none は、文字どおりの抽出の出発点として妥当です。ただし、難しい物語上の推論までもが等しく簡単になるわけではありません。抜けている受け渡しが複数の場面にまたがる場合は、まずそれらの場面を渡したか確認し、その定めた質問に対して effort を上げて試してください。証拠を渡す前に effort を上げても、より手の込んだ推測ができるだけです。
正しいメッセージの形で参考画像を追加する
画像のトークンも、同じ入力の上限と価格の境界に含まれます。質問が小道具の見た目に左右される場合にだけ、画像を追加してください。
視覚的な質問では、ユーザーメッセージの文字列の content を、型付きのパートに置き換えます(各モデルが受け付けるパートはチャット API のドキュメントに一覧があります)。
{
  "role": "user",
  "content": [
    {"type": "text", "text": "Describe the visible case and thermos. Do not infer an unseen handoff."},
    {"type": "image_url", "image_url": {"url": "https://cdn.spicyapi.ai/blog/authored/seo-next-twenty-2026-10-01/grok-4-3-context-budget-guide/body-1-gpt-image-66b06646fd526c4c.webp"}}
  ]
}
画像が示すのは小道具の見た目です。持ち主の変化には、引き続き該当する場面のテキストが必要です。整合性の質問が視覚的な細部に左右される場合は、両方を渡してください。
Agent に呼び出しを準備させる
整合性チェックを繰り返す場合は、コーディング用の Agent に SpicyAPI Skill を使うよう頼みます。「Read xai/grok-4.3/chat, then adapt the example to my input; show the request before running it.」CLI での参照は spicyapi models get xai/grok-4.3/chat --json、MCP での参照は model: "xai/grok-4.3/chat" を指定した spicyapi_model_get です。チャットの呼び出しには、互換クライアントかチャット APIを使います。メディアタスクのコマンドではチャットの返信は生成されません。
成人向けコンテンツの検証結果とモデルの選び方
Grok 4.3 のレビューでは、2026 年 9 月のテストで、強度の高い成人向けシーンのリクエスト 9 件中 8 件が完了し、1 件は表現が和らげられたと報告しています。成人向けのシナリオでは、システムメッセージに架空の編集作業であることを明記し、残したい箇所を渡してください。
大きな登場人物設定集とシナリオを一緒に扱いたい成人向けクリエイターにとって、実用上の魅力は入力の上限、低い出力料金、そして本物の none effort のオプションです。Grok 4.5 と 4.6 および Grok 4.7 は、より小さい 500,000 トークンの上限を共有し、入力が 200K 未満の場合、キャッシュなしの入力が 100 万トークンあたり $2.00、出力が 100 万トークンあたり $6.00 です。Grok 4.3 は $1.25 と $2.50 です。キャッシュありの入力は 4.5 で $0.30、4.6 と 4.7 で $0.50 ですが、Grok 4.3 は $0.20 です。
よくある想定外への対処
| 症状 | すぐできる対処 |
|---|---|
| 低い料金帯の見積もりより高い | キャッシュありの入力と会話履歴を 200,000 トークンの境界に含める |
| 課金対象の出力が、見えているテキストから予想した量を超える | 推論を考慮する。範囲の限られた適切なタスクでは none を使う |
| PDF やオーディオのパートが拒否される | テキストを抽出するか、専用の文字起こしの経路を使う |
| モデルが抜けている受け渡しを新しい場面で埋める | 渡した場面ラベルだけを要求し、裏づけのない場面の参照は却下する |
| 大きなパッケージでゲートウェイのタイムアウトが起きる | レスポンスをストリーミングする。クライアントのタイムアウトを延ばしても、非ストリーミングでのエッジの約 100 秒の制限は延びない |
| ツールの出力で会話を続けられない | アシスタントのツール呼び出しメッセージと、対応する呼び出し ID を履歴に残す |
| JSON が途中で切れる | max_tokens を増やすか、整合性の指摘の件数を減らして依頼する |
どの構成から始めるか
コストと大きな元資料が重要で、範囲を絞った整合性レポートを出したい場合は、Grok 4.3 を none で使ってください。シナリオ全体の書き直しではなく、場面の証拠から始めます。タスクが許すなら、パッケージを 200,000 トークン未満に収めます。欠けているつながりが離れた場面に左右されるなら、答えを裏づける場面を外すのではなく、必要なコンテキストの分を支払ってください。
FAQ
API の 100 万トークンのウィンドウは、Grok アプリの記憶と同じですか。
いいえ。モデルに知らせたいことはすべてリクエストに含める必要があります。以前の場面か、その要約を貼り付けてください。Grok アプリの履歴やメッセージ上限は、API の呼び出しには引き継がれません。
キャッシュありの入力も 200,000 トークンの境界に含まれますか。
はい。キャッシュされたトークンも再送する履歴もすべて数えられるため、大半がキャッシュでも、長いチャットは境界を越えることがあります。その場合は高い料金がリクエスト全体に適用されるので、境界が近いときは最後の呼び出しの前に古いやり取りを削ってください。
none なら必ず最安の回答になりますか。
公開されている推論モードを外すので、小さな抽出の出発点として便利です。ただし請求額は、入力、キャッシュの区分、見える出力、選ばれた料金帯に左右されます。長い回答や大きなパッケージにはそれだけ費用がかかります。
100 万トークンのシナリオにある整合性のミスを、モデルはすべて見つけられますか。
ウィンドウは容量であり、完全に思い出せる保証ではありません。場面にラベルを付け、具体的な整合性の質問をし、引用された箇所を確認してください。抜けている受け渡しが見つかったら、シナリオ全体を再生成するのではなく、その部分だけの修正を依頼します。





