Rivedere un copione lungo richiede le scene che stabiliscono chi sa o possiede cosa. Inviare più parti del copione può aiutare a far emergere un collegamento mancante, ma cambia anche il conto, soprattutto alla soglia dei 200.000 token.
Grok 4.3 è l'opzione a lungo contesto dell'attuale gamma chat di Grok: accetta fino a 1.000.000 di token in input e offre reasoning_effort: "none", che i contratti attuali di 4.5, 4.6 e 4.7 non prevedono. Tieni d'occhio la soglia di fatturazione: 200.000 token di input totali selezionano già la fascia più alta, e quella fascia si applica all'intera richiesta.
Prezzi e limiti esatti
L'attuale contratto SpicyAPI per xai/grok-4.3/chat supporta parti di testo e immagine, fino a 256 messaggi e 128 definizioni di strumenti. Non accetta parti file/PDF né audio.
| Input totale | Input non in cache / 1M | Input in cache / 1M | Output / 1M |
|---|---|---|---|
| Sotto i 200.000 token | $1.25 | $0.20 | $2.50 |
| 200.000 token o più | $2.50 | $0.40 | $5.00 |
Il tetto dell'input è di 1.000.000 di token. max_tokens è 4.096 per impostazione predefinita e accetta fino a 900.000, il tetto della risposta visibile. I token di ragionamento sono fatturati a parte, all'interno dell'utilizzo in output, e non sono limitati da questo tetto. I livelli di effort disponibili sono none, low, medium, high e xhigh; quello predefinito è low.
Per una semplice estrazione esatta, parti da none. Per una domanda di continuità difficile che coinvolge molte scene distanti, prova low o un livello più alto se la prima risposta non coglie un collegamento specifico. Anche il ragionamento consuma output fatturato, quindi la sola lunghezza della risposta visibile non basta a ricostruire il conto.
Cosa succede con 199.999 contro 200.000 token
Con 4.000 token di output fatturati e senza cache:
| Input | Calcolo | Costo stimato |
|---|---|---|
| 199.999 | 199.999 × $1.25 / 1M + 4.000 × $2.50 / 1M | $0.25999875 |
| 200.000 | 200.000 × $2.50 / 1M + 4.000 × $5.00 / 1M | $0.52 |
La differenza è un cambio di fascia, non il costo di un token in più alla vecchia tariffa. Anche l'input in cache concorre alla soglia. Con 50.000 token non in cache più 149.000 in cache e 4.000 di output, la stima è $0.1023. Portando la parte in cache a 150.000, l'input totale arriva a 200.000 e la stima sale a $0.205.
Non contare di nuovo la parte in cache come non in cache. La formula della richiesta è:
cost = uncached_input × input_rate / 1,000,000
     + cached_input × cached_rate / 1,000,000
     + billed_output × output_rate / 1,000,000
Prima dell'invio, carica messaggi e impostazioni completi nel Playground di Grok 4.3 e controlla la stima del prezzo e la fascia. Includi istruzioni di sistema, definizioni degli strumenti, immagini e cronologia rinviata: un conteggio dei caratteri non è un conteggio esatto dei token. Dopo l'invio, controlla usage.prompt_tokens, che include già l'input in cache. Non sommare di nuovo usage.prompt_tokens_details.cached_tokens. Confronta l'input totale con 200.000, poi usa l'addebito definitivo per il conto finale.
Metti per primi il copione riutilizzabile e la scheda dei personaggi, e per ultima la domanda che cambia. Un prefisso stabile può rendere possibile il riutilizzo, ma applica la tariffa della cache solo ai token segnalati come cache hit.
La fascia viene scelta in base all'input totale, compresa la cronologia inviata con questa chiamata. Un blocco iniziale sul saldo non riflette necessariamente il risparmio finale dovuto alla cache. Usa l'utilizzo restituito e l'addebito definitivo per valutare una richiesta reale; tutti i totali qui riportati sono aritmetica a scopo illustrativo.
La finestra da un milione di token è un limite per una singola richiesta API. È separata dalla quota settimanale di messaggi di un abbonamento all'app Grok. Con questo endpoint chat, a ogni chiamata invii la cronologia e il testo sorgente di cui il modello ha bisogno: non acquisisce le tue conversazioni precedenti nell'app solo perché il nome del modello ti è familiare.
Prova prima nel Playground
- Apri Grok 4.3 e passa al Playground.
- Imposta il System prompt con l'istruzione dell'esempio qui sotto. Nel campo del messaggio incolla le due scene (SCENE12 e SCENE18) e chiedi i passaggi di mano mancanti degli oggetti di scena. Scegli l'opzione di ragionamento none e premi Run model.
- Verifica che la risposta nomini sia il thermos sia la valigetta rossa, poi controlla la stima del prezzo prima di inviare un copione completo.
Un caso pratico con un copione lungo
Un copione romantico immaginario per adulti usa una valigetta di pelle rossa e un thermos di rame con una fascia blu. Il problema di continuità è il possesso: chi portava ciascun oggetto prima e dopo una scena? Invia il copione come testo con le etichette delle scene e chiedi i passaggi di mano espliciti o mancanti, invece di chiedere al modello di «rivedere tutto».
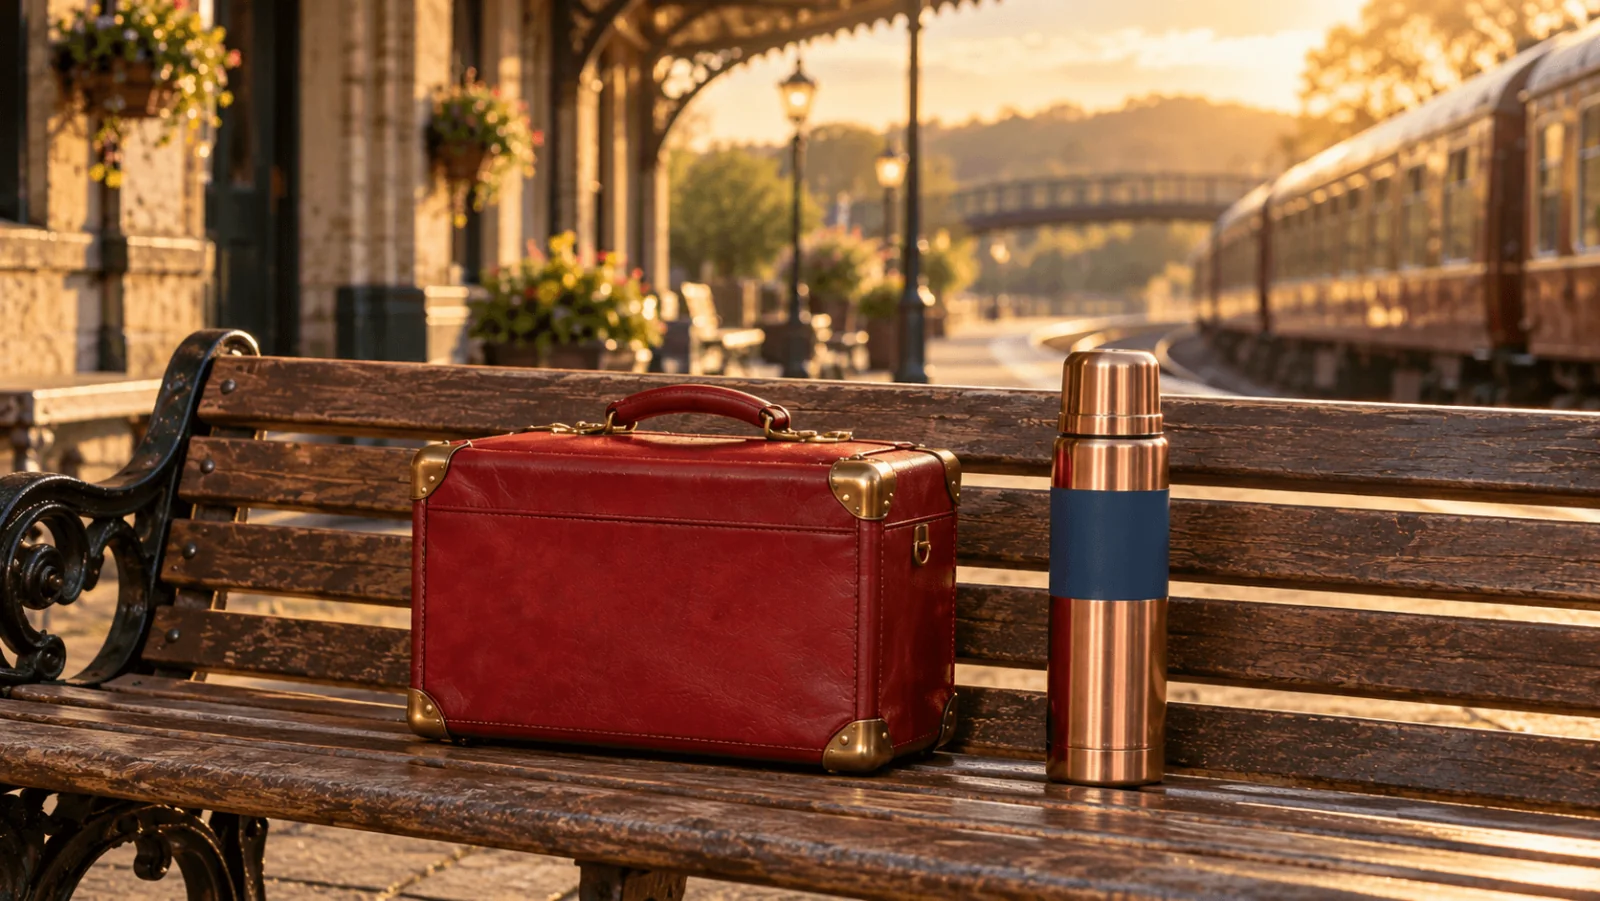
Illustrazione degli oggetti di scena immaginari. Non è un output di Grok né una prova dell'accuratezza visiva: la chiamata qui sotto riceve le loro descrizioni scritte.
curl --fail-with-body https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Idempotency-Key: $(uuidgen)" \
  -d '{
    "model": "xai/grok-4.3/chat",
    "reasoning_effort": "none",
    "max_tokens": 2000,
    "response_format": {"type": "json_object"},
    "messages": [
      {"role": "system", "content": "Return JSON with missing_handoffs: a list of objects containing prop, missing_step and evidence_scene_ids (a nonempty list of supplied scene labels). Do not invent a handoff."},
      {"role": "user", "content": "Fictional adults: Mara, 32, Jon, 35. SCENE_12: Mara leaves her copper thermos with a blue band on the bench. Jon carries a closed red leather case. SCENE_18: Jon gives Mara the thermos; Mara opens the red case. Find ownership changes without an explicit handoff."}
    ]
  }' > response.json

python3 - <<'PY'
import json
from pathlib import Path

resp = json.loads(Path("response.json").read_text())
print(json.dumps({"usage": resp.get("usage")}, indent=2))
choices = resp.get("choices") or []
if resp.get("error") or not choices or choices[0].get("finish_reason") != "stop":
    raise RuntimeError("no complete continuity report")
text = choices[0].get("message", {}).get("content")
if not isinstance(text, str) or not text.strip():
    raise RuntimeError("empty report")
report = json.loads(text)
if not isinstance(report, dict) or not isinstance(report.get("missing_handoffs"), list):
    raise RuntimeError("missing_handoffs must be a list")
for item in report["missing_handoffs"]:
    if not isinstance(item, dict):
        raise RuntimeError("each finding must be an object")
    for key in ("prop", "missing_step"):
        if not isinstance(item.get(key), str) or not item[key].strip():
            raise RuntimeError(f"missing {key}")
    ids = item.get("evidence_scene_ids")
    if not isinstance(ids, list) or not ids or any(
        not isinstance(i, str) or i not in {"SCENE_12", "SCENE_18"} for i in ids
    ):
        raise RuntimeError("unsupported scene reference")
print(json.dumps(report, indent=2))
PY
Le lacune attese sono due: Jon deve riprendere il thermos dalla panchina, e la valigetta rossa deve passare da Jon a Mara. Nessuna delle due azioni è impossibile, ma nessuno dei due passaggi è dichiarato nelle scene fornite. Una risposta corretta individua entrambe le lacune citando SCENE_12 e SCENE_18, senza inventare una scena che le risolva.
Per un controllo programmatico, dai al modello una forma di output concreta: missing_handoffs è un elenco di oggetti con prop, missing_step e evidence_scene_ids. L'unico esempio controlla questa forma prima di stampare il report.
Il controllo verifica la struttura del report e i riferimenti alle scene. Confronta i due risultati con il testo delle scene prima di accettare la modifica: un JSON valido da solo non dimostra che l'analisi di continuità sia corretta.
Per un copione completo, sostituisci il messaggio dell'utente con il testo esportato dalla tua bozza attuale, mantenendo le stesse etichette di scena.
Per un copione lungo, usa l'interfaccia in streaming. Esporta prima il testo dal PDF e conserva le etichette di scena usate nei tuoi risultati.
Dai al copione lungo una domanda utile, non l'invito a riassumere
Per la continuità degli oggetti, tieni una sequenza compatta con etichette di scena e azioni visibili: chi ha portato l'oggetto, dove è stato lasciato e chi lo usa dopo. La scheda dei personaggi stabilisce il proprietario abituale; non vieta a un altro personaggio di prendere l'oggetto in prestito. Chiedi i cambi privi di un passaggio dichiarato, non ogni apparizione che differisce dalla tabella dei proprietari.
Nell'esempio, Jon che porge il thermos a Mara implica che lo abbia ripreso o ricevuto dopo la scena 12. Mara che apre la valigetta rossa implica che abbia accesso all'oggetto di Jon. Sono lacune da controllare. Una correzione scritta da una persona potrebbe far raccogliere a Jon il thermos mentre lasciano la banchina e fargli offrire la valigetta perché Mara la apra. Un'altra correzione legittima mantiene la distanza tra i personaggi e fa maneggiare a ciascuno solo il proprio oggetto. Scegli in base al momento relazionale della scena: il report di continuità non può prendere questa decisione creativa al posto tuo.
Per un'applicazione di compagnia per adulti, il pacchetto equivalente contiene fatti stabili sui personaggi immaginari, un breve resoconto della relazione attuale e la conversazione necessaria per la risposta successiva. Mantieni la distinzione tra un fatto stabilito e l'affermazione di un partecipante. Se un personaggio dice «ci siamo conosciuti l'estate scorsa» ma la cronologia approvata dice che si sono conosciuti ieri, l'assistente non dovrebbe riscrivere in silenzio la scheda del personaggio. L'affermazione può essere una battuta o una finzione deliberata all'interno della scena.
Perché cinquanta risposte brevi possono costare più di una lunga revisione
Ogni chiamata può rinviare il contesto. Con 100.000 token di input a freddo e 2.000 token di output fatturati, il calcolo di Grok 4.3 nella fascia bassa è $0.13 a risposta, ovvero $6.50 per cinquanta risposte con lo stesso utilizzo. Un pacchetto mirato da 10.000 token di input con lo stesso output costa $0.0175, ovvero $0.875 per cinquanta. Questi casi aritmetici non presuppongono cache hit né una qualità equivalente.
Un input dieci volte più piccolo è utile solo se conserva le informazioni di cui ha bisogno la risposta successiva. Tieni il copione completo per una domanda sull'intero copione; porta con te una cronologia approvata e concisa per uno scambio locale. Quando un riassunto omette il fatto che una promessa non è ancora stata mantenuta, il prompt più economico può produrre una continuazione peggiore. Controlla i fatti importanti su relazioni e continuità prima di sostituire un pacchetto sorgente con il suo riassunto.
L'opzione none, supportata, è un buon punto di partenza per l'estrazione letterale. Non rende ugualmente facile ogni inferenza narrativa difficile. Se il passaggio mancante si estende su più scene, assicurati prima che quelle scene siano state fornite, poi prova un effort più alto su quella domanda definita. Aumentare l'effort prima di fornire le prove rende solo possibile un'ipotesi più elaborata.
Aggiungi un'immagine di riferimento con la forma di messaggio corretta
I token delle immagini contano per lo stesso tetto di input e per la stessa soglia di prezzo. Aggiungi l'immagine solo quando la domanda dipende dall'aspetto degli oggetti.
Per una domanda visiva, sostituisci il contenuto stringa del messaggio dell'utente con parti tipizzate (la documentazione dell'API chat elenca quali parti accetta ciascun modello):
{
  "role": "user",
  "content": [
    {"type": "text", "text": "Describe the visible case and thermos. Do not infer an unseen handoff."},
    {"type": "image_url", "image_url": {"url": "https://cdn.spicyapi.ai/blog/authored/seo-next-twenty-2026-10-01/grok-4-3-context-budget-guide/body-1-gpt-image-66b06646fd526c4c.webp"}}
  ]
}
L'immagine mostra l'aspetto degli oggetti; i cambi di possesso richiedono comunque il testo della scena pertinente. Fornisci entrambi quando una domanda di continuità dipende da un dettaglio visivo.
Fai preparare la chiamata a un Agent
Per controlli di continuità ripetuti, chiedi al tuo Agent di programmazione di usare la Skill di SpicyAPI: "Read xai/grok-4.3/chat, then adapt the example to my input; show the request before running it." La ricerca con la CLI è spicyapi models get xai/grok-4.3/chat --json; quella con l'MCP è spicyapi_model_get con model: "xai/grok-4.3/chat". Le chiamate chat usano un client compatibile o l'API chat; i comandi dei task multimediali non generano risposte chat.
Osservazioni sui contenuti per adulti e scelta del modello
La recensione di Grok 4.3 riporta che 8 richieste su 9 di scene per adulti a intensità più alta sono state completate nei test di settembre 2026, con una risposta attenuata. Per un copione per adulti, indica nel messaggio di sistema l'incarico di editing di finzione e fornisci i passaggi da preservare.
Per chi crea contenuti per adulti e ha bisogno di una grande scheda dei personaggi più il copione, i vantaggi pratici sono il tetto di input, la tariffa di output più bassa e una vera opzione di effort none. Grok 4.5 e 4.6 e Grok 4.7 condividono un tetto più basso di 500.000 token e costano $2.00 per milione di input non in cache e $6.00 per milione di output sotto i 200K di input, contro $1.25 e $2.50 di Grok 4.3. L'input in cache costa $0.30 su 4.5 e $0.50 su 4.6 e 4.7, contro $0.20 su Grok 4.3.
Rimedi per le sorprese più comuni
| Sintomo | Rimedio diretto |
|---|---|
| Costo superiore alla stima della fascia bassa | Includi l'input in cache e la cronologia della conversazione nella soglia dei 200.000 token |
| L'output fatturato supera quello atteso dal testo visibile | Tieni conto del ragionamento; usa none per un compito circoscritto adatto |
| Parte PDF o audio rifiutata | Estrai il testo o usa un percorso di trascrizione dedicato |
| Il modello riempie un passaggio mancante con una scena nuova | Richiedi solo le etichette fornite e rifiuta i riferimenti a scene non supportati |
| Un pacchetto grande va in timeout del gateway | Usa lo streaming; aumentare il timeout del client non estende il limite di circa 100 secondi dell'edge per le richieste non in streaming |
| L'output di uno strumento non può proseguire la conversazione | Conserva nella cronologia il messaggio di tool-call dell'assistente e gli ID di chiamata corrispondenti |
| Il JSON è troncato | Aumenta max_tokens o richiedi meno rilievi di continuità |
Da quale configurazione partire
Usa Grok 4.3 con none per un report di continuità circoscritto quando contano il costo e un grande pacchetto sorgente. Parti dalle prove delle scene, non dalla riscrittura dell'intero copione. Tieni il pacchetto sotto i 200.000 token quando il compito lo permette; quando il passaggio mancante dipende da scene lontane, paga per il contesto necessario invece di scartare la scena che dimostra la risposta.
FAQ
La finestra API da un milione di token coincide con la memoria dell'app Grok?
No. Tutto ciò che il modello deve sapere deve stare nella richiesta: incolla le scene precedenti o un loro riassunto. La cronologia dell'app Grok e la tua quota di messaggi non si trasferiscono alle chiamate API.
L'input in cache conta ai fini della soglia di 200.000 token?
Sì. I token in cache e la cronologia rinviata contano tutti, quindi una chat lunga può superare la soglia anche se la maggior parte è in cache. Le tariffe più alte si applicano allora all'intera richiesta, quindi riduci i turni vecchi prima della chiamata finale se sei vicino al limite.
none garantisce la risposta più economica?
Elimina la modalità di ragionamento esposta, il che lo rende un buon punto di partenza per una piccola estrazione. Il conto dipende comunque dall'input, dalle categorie di cache, dall'output visibile e dalla fascia selezionata: una risposta più lunga o un pacchetto più grande costa di più.
Il modello può trovare ogni errore di continuità in un copione da un milione di token?
La finestra è capacità, non una garanzia di richiamo perfetto. Etichetta le scene, fai una domanda di continuità specifica e verifica i passaggi citati. Dopo aver trovato il passaggio mancante, chiedi una correzione locale invece di rigenerare l'intero copione.





