La relecture d'un long scénario exige les scènes qui établissent qui sait quoi ou possède quoi. Envoyer davantage du scénario peut aider à révéler un lien manquant, mais cela modifie aussi la facture, surtout à la limite des 200 000 tokens.
Grok 4.3 est l'option à long contexte de la gamme de chat Grok actuelle : il accepte jusqu'à 1 000 000 de tokens en entrée et propose reasoning_effort: "none", ce que les contrats actuels de 4.5, 4.6 et 4.7 n'offrent pas. Surveillez le seuil de facturation : 200 000 tokens d'entrée au total sélectionnent déjà le palier supérieur, et ce palier s'applique à toute la requête.
Prix et limites exacts
Le contrat SpicyAPI actuel pour xai/grok-4.3/chat prend en charge les parties texte et image, jusqu'à 256 messages et 128 définitions d'outils. Il n'accepte ni parties fichier/PDF ni parties audio.
| Entrée totale | Entrée hors cache / 1M | Entrée en cache / 1M | Sortie / 1M |
|---|---|---|---|
| Moins de 200 000 tokens | $1.25 | $0.20 | $2.50 |
| 200 000 tokens ou plus | $2.50 | $0.40 | $5.00 |
Le plafond d'entrée est de 1 000 000 de tokens. max_tokens vaut 4 096 par défaut et accepte jusqu'à 900 000, le plafond de la réponse visible. Les tokens de raisonnement sont facturés séparément au sein de la consommation en sortie et ne sont pas limités par ce plafond. Les niveaux d'effort disponibles sont none, low, medium, high et xhigh ; le niveau par défaut est low.
Pour une extraction exacte simple, commencez par none. Pour une question de continuité difficile portant sur de nombreuses scènes éloignées, essayez low ou plus si la première réponse manque un lien précis. Le raisonnement consomme aussi de la sortie facturée : la seule longueur de la réponse visible ne permet donc pas de reconstituer la facture.
Ce qui se passe à 199 999 contre 200 000 tokens
Avec 4 000 tokens de sortie facturés et sans cache :
| Entrée | Calcul | Coût estimé |
|---|---|---|
| 199 999 | 199 999 × $1.25 / 1M + 4 000 × $2.50 / 1M | $0.25999875 |
| 200 000 | 200 000 × $2.50 / 1M + 4 000 × $5.00 / 1M | $0.52 |
La différence est un changement de palier, et non le coût d'un token supplémentaire à l'ancien tarif. L'entrée en cache compte aussi pour le seuil. Avec 50 000 tokens hors cache plus 149 000 en cache et 4 000 en sortie, l'estimation est de $0.1023. En portant la part en cache à 150 000, l'entrée totale atteint 200 000 et l'estimation passe à $0.205.
Ne recomptez pas la part en cache comme hors cache. La formule de la requête est :
cost = uncached_input × input_rate / 1,000,000
     + cached_input × cached_rate / 1,000,000
     + billed_output × output_rate / 1,000,000
Avant l'envoi, chargez les messages et réglages complets dans le Playground de Grok 4.3 et consultez l'estimation du prix et le palier. Incluez les instructions système, les définitions d'outils, les images et l'historique renvoyé : un nombre de caractères n'est pas un nombre exact de tokens. Après l'envoi, vérifiez usage.prompt_tokens, qui inclut déjà l'entrée en cache. N'ajoutez pas de nouveau usage.prompt_tokens_details.cached_tokens. Comparez l'entrée totale à 200 000, puis utilisez le montant définitivement débité pour la facture finale.
Placez en premier le scénario réutilisable et la bible des personnages, et en dernier la question qui change. Un préfixe stable peut permettre la réutilisation, mais n'appliquez le tarif du cache qu'aux tokens signalés comme des cache hits.
Le palier est choisi d'après l'entrée totale, y compris l'historique envoyé avec cet appel. Une retenue initiale sur le solde ne reflète pas forcément l'économie finale liée au cache. Servez-vous de l'utilisation renvoyée et du montant définitivement débité pour évaluer une vraie requête ; tous les totaux présentés ici sont de l'arithmétique à titre d'illustration.
La fenêtre d'un million de tokens est une limite pour une seule requête d'API. Elle est distincte du quota hebdomadaire de messages d'un abonnement à l'application Grok. Avec ce point de terminaison de chat, vous envoyez à chaque appel l'historique et le texte source dont le modèle a besoin : il n'acquiert pas vos conversations antérieures de l'application simplement parce que le nom du modèle vous est familier.
Essayez d'abord dans le Playground
- Ouvrez Grok 4.3 et passez au Playground.
- Réglez le System prompt sur l'instruction de l'exemple ci-dessous. Dans le champ de message, collez les deux scènes (SCENE12 et SCENE18) et demandez les transmissions d'accessoires manquantes. Choisissez l'option de raisonnement none et cliquez sur Run model.
- Vérifiez que la réponse nomme à la fois le thermos et la mallette rouge, puis consultez l'estimation du prix avant d'envoyer un scénario complet.
Un cas pratique avec un long scénario
Un scénario romantique fictif pour adultes utilise une mallette en cuir rouge et un thermos en cuivre à bande bleue. Le problème de continuité est la possession : qui portait chaque accessoire avant et après une scène ? Envoyez le scénario sous forme de texte avec des étiquettes de scène et demandez les transmissions explicites ou manquantes, plutôt que de demander au modèle de « tout relire ».
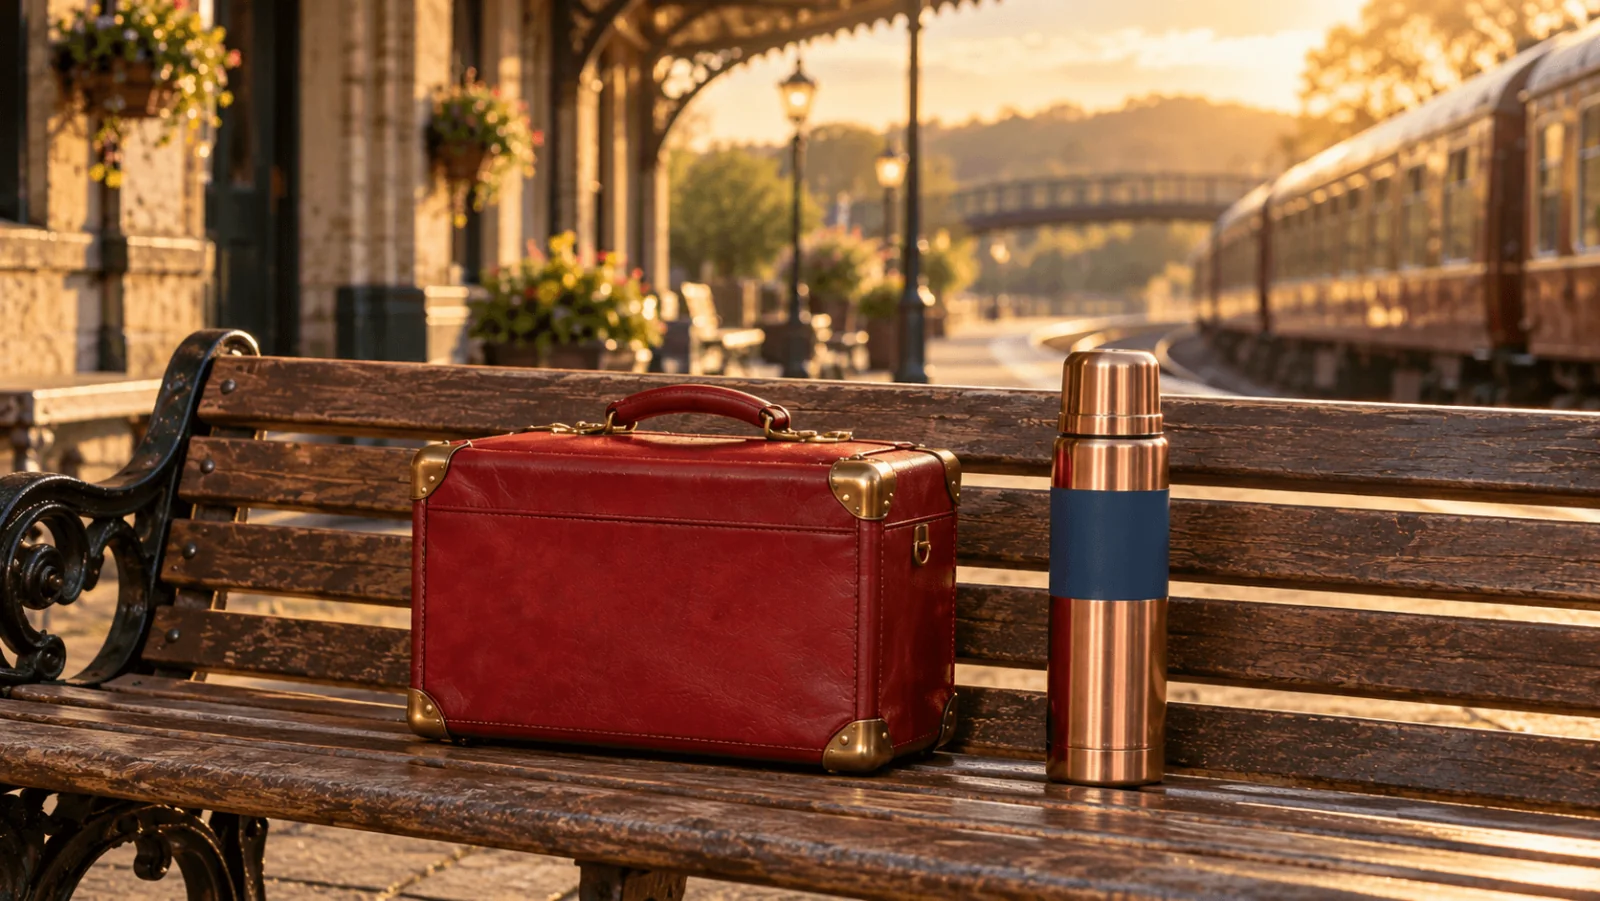
Illustration des accessoires fictifs. Ce n'est pas une sortie de Grok ni une preuve d'exactitude visuelle : l'appel ci-dessous reçoit leurs descriptions écrites.
curl --fail-with-body https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Idempotency-Key: $(uuidgen)" \
  -d '{
    "model": "xai/grok-4.3/chat",
    "reasoning_effort": "none",
    "max_tokens": 2000,
    "response_format": {"type": "json_object"},
    "messages": [
      {"role": "system", "content": "Return JSON with missing_handoffs: a list of objects containing prop, missing_step and evidence_scene_ids (a nonempty list of supplied scene labels). Do not invent a handoff."},
      {"role": "user", "content": "Fictional adults: Mara, 32, Jon, 35. SCENE_12: Mara leaves her copper thermos with a blue band on the bench. Jon carries a closed red leather case. SCENE_18: Jon gives Mara the thermos; Mara opens the red case. Find ownership changes without an explicit handoff."}
    ]
  }' > response.json

python3 - <<'PY'
import json
from pathlib import Path

resp = json.loads(Path("response.json").read_text())
print(json.dumps({"usage": resp.get("usage")}, indent=2))
choices = resp.get("choices") or []
if resp.get("error") or not choices or choices[0].get("finish_reason") != "stop":
    raise RuntimeError("no complete continuity report")
text = choices[0].get("message", {}).get("content")
if not isinstance(text, str) or not text.strip():
    raise RuntimeError("empty report")
report = json.loads(text)
if not isinstance(report, dict) or not isinstance(report.get("missing_handoffs"), list):
    raise RuntimeError("missing_handoffs must be a list")
for item in report["missing_handoffs"]:
    if not isinstance(item, dict):
        raise RuntimeError("each finding must be an object")
    for key in ("prop", "missing_step"):
        if not isinstance(item.get(key), str) or not item[key].strip():
            raise RuntimeError(f"missing {key}")
    ids = item.get("evidence_scene_ids")
    if not isinstance(ids, list) or not ids or any(
        not isinstance(i, str) or i not in {"SCENE_12", "SCENE_18"} for i in ids
    ):
        raise RuntimeError("unsupported scene reference")
print(json.dumps(report, indent=2))
PY
Deux lacunes sont attendues : Jon doit récupérer le thermos sur le banc, et la mallette rouge doit passer de Jon à Mara. Aucune de ces actions n'est impossible ; aucune des deux transmissions n'est indiquée dans les scènes fournies. Une bonne réponse identifie les deux lacunes en citant SCENE_12 et SCENE_18, plutôt que d'inventer une scène qui les résout.
Pour une vérification par programme, donnez au modèle une forme de sortie concrète : missing_handoffs est une liste d'objets avec prop, missing_step et evidence_scene_ids. L'unique exemple vérifie cette forme avant d'afficher le rapport.
Le vérificateur contrôle la structure du rapport et les références de scène. Comparez les deux constats avec le texte des scènes avant d'accepter la modification : un JSON valide ne suffit pas à établir que l'analyse de continuité est juste.
Pour un scénario complet, remplacez le message de l'utilisateur par le texte exporté de votre version actuelle, en conservant les mêmes étiquettes de scène.
Pour un long scénario, utilisez l'interface de streaming. Exportez d'abord le texte du PDF et conservez les étiquettes de scène utilisées dans vos constats.
Donnez au long scénario une question utile, pas une invitation à résumer
Pour la continuité des accessoires, conservez une séquence compacte avec des étiquettes de scène et des actions visibles : qui a apporté l'objet, où il a été laissé et qui l'utilise ensuite. Une bible des personnages établit le propriétaire habituel ; elle n'interdit pas à un autre personnage d'emprunter l'objet. Demandez les changements sans transmission indiquée, plutôt que chaque apparition qui diffère du tableau des propriétaires.
Dans l'exemple, le fait que Jon tende le thermos à Mara implique qu'il l'a récupéré ou reçu après la scène 12. Le fait que Mara ouvre la mallette rouge implique qu'elle a accès à l'objet de Jon. Ce sont des lacunes à examiner. Une correction écrite par un humain pourrait faire récupérer le thermos par Jon en quittant le quai et lui faire proposer la mallette pour que Mara l'ouvre. Une autre correction légitime maintient la distance entre les personnages et fait manipuler à chacun uniquement son propre objet. Choisissez selon le moment relationnel de la scène ; le rapport de continuité ne peut pas prendre cette décision créative à votre place.
Pour une application de compagnon pour adultes, le paquet équivalent contient des faits stables sur les personnages fictifs, un bref récit de la relation actuelle et la conversation nécessaire à la réponse suivante. Maintenez la distinction entre un fait établi et l'affirmation d'un participant. Si un personnage dit « on s'est rencontrés l'été dernier » alors que l'historique approuvé indique qu'ils se sont rencontrés hier, l'assistant ne doit pas réécrire silencieusement la fiche du personnage. L'affirmation peut être une plaisanterie ou une fiction délibérée dans la scène.
Pourquoi cinquante réponses courtes peuvent coûter plus qu'une longue relecture
Chaque appel peut renvoyer le contexte. Avec 100 000 tokens d'entrée à froid et 2 000 tokens de sortie facturés, le calcul de Grok 4.3 au palier inférieur est de $0.13 par réponse, soit $6.50 pour cinquante réponses à utilisation égale. Un paquet ciblé de 10 000 tokens d'entrée avec la même sortie coûte $0.0175, soit $0.875 pour cinquante. Ces cas arithmétiques ne supposent ni cache hits ni qualité équivalente.
Une entrée dix fois plus petite n'est utile que si elle préserve les informations dont la réponse suivante a besoin. Gardez le scénario complet pour une question portant sur tout le scénario ; transportez un historique approuvé et concis pour un échange local. Quand un résumé omet le fait qu'une promesse reste à tenir, le prompt moins cher peut produire une suite de moindre qualité. Vérifiez les faits importants de relation et de continuité avant de remplacer un paquet source par son résumé.
L'option none, prise en charge, est un point de départ raisonnable pour l'extraction littérale. Elle ne rend pas toute inférence narrative difficile également facile. Si la transmission manquante s'étend sur plusieurs scènes, assurez-vous d'abord que ces scènes ont été fournies, puis essayez davantage d'effort sur cette question bien définie. Augmenter l'effort avant de fournir les preuves ne permet que de produire une supposition plus élaborée.
Ajouter une image de référence avec la bonne forme de message
Les tokens d'image comptent pour le même plafond d'entrée et le même seuil de prix. N'ajoutez l'image que lorsque la question dépend de l'aspect des accessoires.
Pour une question visuelle, remplacez le contenu en chaîne du message de l'utilisateur par des parties typées (la documentation de l'API de chat indique les parties acceptées par chaque modèle) :
{
  "role": "user",
  "content": [
    {"type": "text", "text": "Describe the visible case and thermos. Do not infer an unseen handoff."},
    {"type": "image_url", "image_url": {"url": "https://cdn.spicyapi.ai/blog/authored/seo-next-twenty-2026-10-01/grok-4-3-context-budget-guide/body-1-gpt-image-66b06646fd526c4c.webp"}}
  ]
}
L'image montre l'aspect des accessoires ; les changements de possession exigent toujours le texte de la scène concernée. Fournissez les deux lorsqu'une question de continuité dépend d'un détail visuel.
Laisser un Agent préparer l'appel
Pour des vérifications de continuité répétées, demandez à votre Agent de programmation d'utiliser le Skill SpicyAPI : « Read xai/grok-4.3/chat, then adapt the example to my input; show the request before running it. » La recherche avec la CLI est spicyapi models get xai/grok-4.3/chat --json ; celle avec le MCP est spicyapi_model_get avec model: "xai/grok-4.3/chat". Les appels de chat passent par un client compatible ou l'API de chat ; les commandes de tâches média ne génèrent pas de réponses de chat.
Observations sur le contenu pour adultes et choix du modèle
La revue de Grok 4.3 indique que 8 requêtes sur 9 de scènes pour adultes de plus forte intensité ont abouti lors des tests de septembre 2026, avec une réponse adoucie. Pour un scénario pour adultes, indiquez dans le message système la mission d'édition de fiction et fournissez les passages à préserver.
Pour un créateur de contenu pour adultes qui a besoin d'une grande bible des personnages plus le scénario, les attraits pratiques sont le plafond d'entrée, le tarif de sortie plus bas et une véritable option d'effort none. Grok 4.5 et 4.6 et Grok 4.7 partagent un plafond plus petit de 500 000 tokens et coûtent $2.00 par million d'entrée hors cache et $6.00 par million de sortie sous 200K d'entrée, contre $1.25 et $2.50 pour Grok 4.3. L'entrée en cache coûte $0.30 sur 4.5 et $0.50 sur 4.6 et 4.7, contre $0.20 sur Grok 4.3.
Remèdes aux surprises courantes
| Symptôme | Remède direct |
|---|---|
| Plus cher que l'estimation du palier inférieur | Inclure l'entrée en cache et l'historique de conversation dans le seuil de 200 000 tokens |
| La sortie facturée dépasse ce que laisse attendre le texte visible | Tenir compte du raisonnement ; utiliser none pour une tâche bornée qui s'y prête |
| Partie PDF ou audio rejetée | Extraire le texte ou passer par une voie de transcription dédiée |
| Le modèle comble une transmission manquante par une nouvelle scène | N'exiger que les étiquettes fournies et rejeter les références de scène non étayées |
| Un gros paquet provoque un délai d'attente de la passerelle | Diffuser la réponse en streaming ; augmenter le délai d'attente du client ne prolonge pas la limite d'environ 100 secondes de l'edge pour les requêtes sans streaming |
| La sortie d'un outil ne permet pas de poursuivre la conversation | Conserver dans l'historique le message d'appel d'outil de l'assistant et les ID d'appel correspondants |
| Le JSON est tronqué | Augmenter max_tokens ou demander moins de constats de continuité |
Par quelle configuration commencer
Utilisez Grok 4.3 avec none pour un rapport de continuité borné lorsque le coût et un gros paquet source comptent. Commencez par les preuves de scène plutôt que par une réécriture de tout le scénario. Gardez le paquet sous 200 000 tokens quand la tâche le permet ; lorsque le lien manquant dépend de scènes éloignées, payez le contexte nécessaire plutôt que de retirer la scène qui prouve la réponse.
FAQ
La fenêtre d'un million de tokens de l'API est-elle la même que la mémoire de l'application Grok ?
Non. Tout ce que le modèle doit savoir doit figurer dans la requête : collez les scènes précédentes ou un résumé de celles-ci. L'historique de votre application Grok et votre quota de messages ne se transmettent pas aux appels d'API.
L'entrée en cache compte-t-elle pour le seuil de 200 000 tokens ?
Oui. Les tokens en cache et l'historique renvoyé comptent tous, si bien qu'une longue conversation peut franchir la limite même si l'essentiel est en cache. Les tarifs supérieurs s'appliquent alors à toute la requête : réduisez donc les anciens tours avant l'appel final si vous êtes proche.
none garantit-il la réponse la moins chère ?
Il supprime le mode de raisonnement exposé, ce qui en fait un bon point de départ pour une petite extraction. La facture dépend toujours de l'entrée, des catégories de cache, de la sortie visible et du palier choisi ; une réponse plus longue ou un paquet plus gros coûte plus cher.
Le modèle peut-il trouver toutes les erreurs de continuité dans un scénario d'un million de tokens ?
La fenêtre est une capacité, pas une garantie de rappel parfait. Étiquetez les scènes, posez une question de continuité précise et vérifiez les passages cités. Après avoir trouvé la transmission manquante, demandez une correction locale plutôt que de régénérer tout le scénario.





