Sprawdzenie długiego scenariusza wymaga scen, które ustalają, kto co wie lub posiada. Wysłanie większej części scenariusza może pomóc wychwycić brakujące powiązanie, ale zmienia też rachunek, zwłaszcza na progu 200 000 tokenów.
Grok 4.3 to opcja z długim kontekstem w obecnej linii czatu Grok: przyjmuje do 1 000 000 tokenów wejściowych i oferuje reasoning_effort: "none", czego obecne kontrakty 4.5, 4.6 i 4.7 nie mają. Pilnuj progu rozliczeniowego: już 200 000 tokenów wejściowych łącznie uruchamia wyższy poziom cenowy, a ten poziom obejmuje całe żądanie.
Dokładne ceny i limity
Obecny kontrakt SpicyAPI dla xai/grok-4.3/chat obsługuje części tekstowe i obrazowe, do 256 wiadomości i 128 definicji narzędzi. Nie przyjmuje części plikowych/PDF ani audio.
| Dane wejściowe łącznie | Wejście bez cache / 1M | Wejście z cache / 1M | Wyjście / 1M |
|---|---|---|---|
| Poniżej 200 000 tokenów | $1.25 | $0.20 | $2.50 |
| 200 000 tokenów lub więcej | $2.50 | $0.40 | $5.00 |
Limit wejścia wynosi 1 000 000 tokenów. max_tokens domyślnie ma wartość 4096 i przyjmuje do 900 000, czyli limit widocznej odpowiedzi. Tokeny rozumowania są rozliczane osobno w ramach zużycia wyjścia i ten limit ich nie ogranicza. Dostępne poziomy wysiłku to none, low, medium, high i xhigh; domyślny to low.
Przy prostej, dokładnej ekstrakcji zacznij od none. Przy trudnym pytaniu o ciągłość, obejmującym wiele odległych scen, spróbuj low lub wyżej, jeśli pierwsza odpowiedź pomija konkretne powiązanie. Rozumowanie też zużywa rozliczane wyjście, więc samej długości widocznej odpowiedzi nie da się użyć do odtworzenia rachunku.
Co się dzieje przy 199 999, a co przy 200 000 tokenów
Przy 4000 rozliczanych tokenach wyjścia i bez cache:
| Wejście | Obliczenie | Szacowany koszt |
|---|---|---|
| 199 999 | 199 999 × $1.25 / 1M + 4000 × $2.50 / 1M | $0.25999875 |
| 200 000 | 200 000 × $2.50 / 1M + 4000 × $5.00 / 1M | $0.52 |
Różnica to zmiana poziomu cenowego, a nie koszt jednego dodatkowego tokena po dawnej stawce. Wejście z cache również wlicza się do progu. Przy 50 000 tokenów bez cache plus 149 000 z cache i 4000 na wyjściu szacunek wynosi $0.1023. Po zwiększeniu części z cache do 150 000 łączne wejście osiąga 200 000, a szacunek rośnie do $0.205.
Nie licz części z cache drugi raz jako wejścia bez cache. Wzór dla żądania wygląda tak:
cost = uncached_input × input_rate / 1,000,000
     + cached_input × cached_rate / 1,000,000
     + billed_output × output_rate / 1,000,000
Przed wysłaniem wczytaj kompletne wiadomości i ustawienia w Playground Grok 4.3 i sprawdź szacunek ceny oraz poziom cenowy. Uwzględnij instrukcje systemowe, definicje narzędzi, obrazy i ponownie wysyłaną historię; liczba znaków nie jest dokładną liczbą tokenów. Po wysłaniu sprawdź usage.prompt_tokens, które już obejmuje wejście z cache. Nie dodawaj ponownie usage.prompt_tokens_details.cached_tokens. Porównaj łączne wejście z 200 000, a do ostatecznego rachunku użyj rozliczonej opłaty.
Umieść na początku scenariusz wielokrotnego użytku i bibliię postaci, a na końcu pytanie, które się zmienia. Stały prefiks może umożliwić ponowne wykorzystanie, ale stawkę cache stosuj tylko do tokenów zgłoszonych jako trafienia w cache.
Poziom cenowy jest wybierany na podstawie łącznego wejścia, wraz z historią wysłaną w tym wywołaniu. Początkowa blokada środków nie musi odzwierciedlać ostatecznej oszczędności z cache. Do oceny prawdziwego żądania użyj zwróconego zużycia i rozliczonej opłaty; wszystkie sumy tutaj to arytmetyka poglądowa.
Okno miliona tokenów to limit dla pojedynczego żądania API. Jest oddzielne od tygodniowego limitu wiadomości w subskrypcji aplikacji Grok. Przy tym endpoincie czatu w każdym wywołaniu wysyłasz historię i tekst źródłowy, których potrzebuje model; nie pozna on Twoich wcześniejszych rozmów z aplikacji tylko dlatego, że nazwa modelu brzmi znajomo.
Najpierw wypróbuj w Playground
- Otwórz Grok 4.3 i przełącz się na Playground.
- Ustaw System prompt na instrukcję z przykładu poniżej. W polu wiadomości wklej dwie sceny (SCENE12 i SCENE18) i poproś o brakujące przekazania rekwizytów. Wybierz opcję rozumowania none i kliknij Run model.
- Sprawdź, czy odpowiedź wymienia zarówno termos, jak i czerwoną walizkę, a potem sprawdź szacunek ceny, zanim wyślesz pełny scenariusz.
Praktyczny przypadek z długim scenariuszem
Fikcyjny romantyczny scenariusz dla dorosłych używa czerwonej skórzanej walizki i miedzianego termosu z niebieskim paskiem. Problem z ciągłością to posiadanie: kto niósł każdy rekwizyt przed sceną i po niej? Wyślij scenariusz jako tekst z etykietami scen i poproś o jawne lub brakujące przekazania, zamiast prosić model, żeby „sprawdził wszystko”.
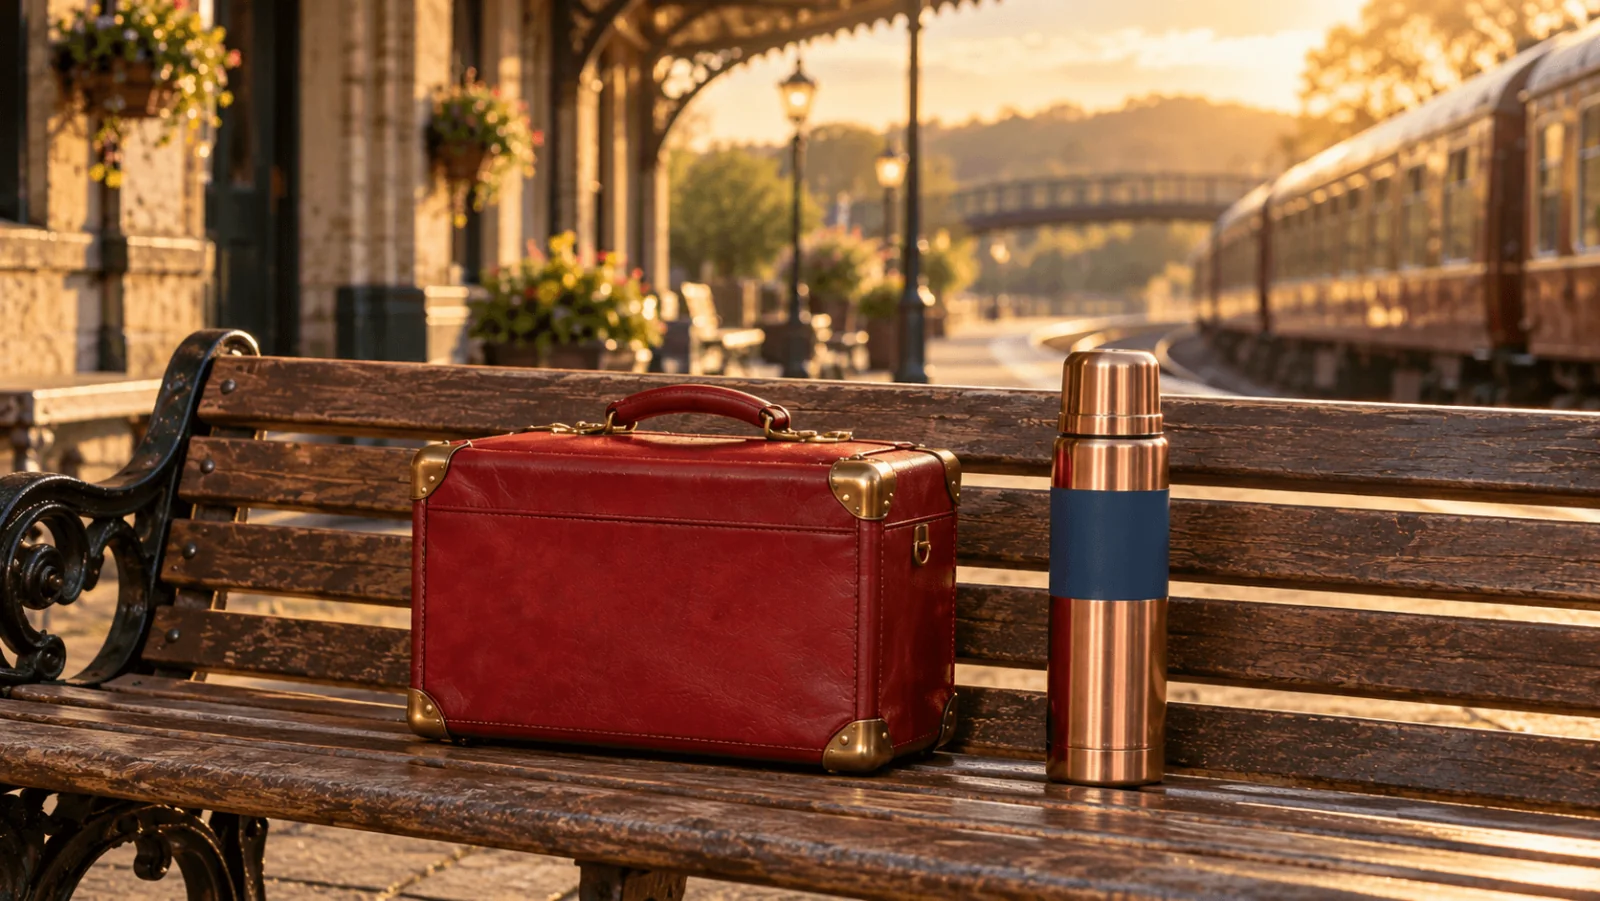
Ilustracja fikcyjnych rekwizytów. Nie jest to wynik Grok ani dowód trafności wizualnej; poniższe wywołanie otrzymuje ich opisy tekstowe.
curl --fail-with-body https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Idempotency-Key: $(uuidgen)" \
  -d '{
    "model": "xai/grok-4.3/chat",
    "reasoning_effort": "none",
    "max_tokens": 2000,
    "response_format": {"type": "json_object"},
    "messages": [
      {"role": "system", "content": "Return JSON with missing_handoffs: a list of objects containing prop, missing_step and evidence_scene_ids (a nonempty list of supplied scene labels). Do not invent a handoff."},
      {"role": "user", "content": "Fictional adults: Mara, 32, Jon, 35. SCENE_12: Mara leaves her copper thermos with a blue band on the bench. Jon carries a closed red leather case. SCENE_18: Jon gives Mara the thermos; Mara opens the red case. Find ownership changes without an explicit handoff."}
    ]
  }' > response.json

python3 - <<'PY'
import json
from pathlib import Path

resp = json.loads(Path("response.json").read_text())
print(json.dumps({"usage": resp.get("usage")}, indent=2))
choices = resp.get("choices") or []
if resp.get("error") or not choices or choices[0].get("finish_reason") != "stop":
    raise RuntimeError("no complete continuity report")
text = choices[0].get("message", {}).get("content")
if not isinstance(text, str) or not text.strip():
    raise RuntimeError("empty report")
report = json.loads(text)
if not isinstance(report, dict) or not isinstance(report.get("missing_handoffs"), list):
    raise RuntimeError("missing_handoffs must be a list")
for item in report["missing_handoffs"]:
    if not isinstance(item, dict):
        raise RuntimeError("each finding must be an object")
    for key in ("prop", "missing_step"):
        if not isinstance(item.get(key), str) or not item[key].strip():
            raise RuntimeError(f"missing {key}")
    ids = item.get("evidence_scene_ids")
    if not isinstance(ids, list) or not ids or any(
        not isinstance(i, str) or i not in {"SCENE_12", "SCENE_18"} for i in ids
    ):
        raise RuntimeError("unsupported scene reference")
print(json.dumps(report, indent=2))
PY
Oczekiwane są dwie luki: Jon musi odebrać termos z ławki, a czerwona walizka musi przejść od Jona do Mary. Żadna z tych czynności nie jest niemożliwa; żadne z tych przekazań nie jest wskazane w dostarczonych scenach. Poprawna odpowiedź wskazuje obie luki, powołując się na SCENE_12 i SCENE_18, zamiast wymyślać scenę, która je rozwiązuje.
Do kontroli programowej podaj modelowi konkretny kształt wyniku: missing_handoffs to lista obiektów z polami prop, missing_step i evidence_scene_ids. Jedyny przykład sprawdza ten kształt przed wypisaniem raportu.
Skrypt sprawdzający waliduje strukturę raportu i odwołania do scen. Zanim zaakceptujesz poprawkę, porównaj oba ustalenia z tekstem scen; samo poprawne JSON nie dowodzi, że analiza ciągłości jest właściwa.
Dla pełnego scenariusza zastąp wiadomość użytkownika tekstem wyeksportowanym z bieżącej wersji roboczej, zachowując te same etykiety scen.
Przy długim scenariuszu użyj interfejsu strumieniowania. Najpierw wyeksportuj tekst z PDF i zachowaj etykiety scen używane w ustaleniach.
Daj długiemu scenariuszowi użyteczne pytanie, a nie zaproszenie do streszczenia
Przy ciągłości rekwizytów trzymaj zwartą sekwencję z etykietami scen i widocznymi działaniami: kto przyniósł przedmiot, gdzie go zostawiono i kto użyje go następnie. Biblia postaci ustala zwykłego właściciela; nie zabrania innej postaci pożyczyć przedmiot. Pytaj o zmiany bez wskazanego przekazania, a nie o każde pojawienie się, które różni się od tabeli właścicieli.
W przykładzie to, że Jon podaje Marze termos, oznacza, że odebrał go lub otrzymał po scenie 12. To, że Mara otwiera czerwoną walizkę, oznacza, że ma dostęp do przedmiotu Jona. To luki do sprawdzenia. Poprawka napisana przez człowieka mogłaby sprawić, że Jon zabiera termos przy opuszczaniu peronu i podaje walizkę, by Mara ją otworzyła. Inna zasadna poprawka utrzymuje dystans między postaciami i każe każdej obsługiwać tylko własny przedmiot. Wybierz zgodnie z relacyjnym punktem zwrotnym sceny; raport ciągłości nie podejmie za Ciebie tej decyzji twórczej.
W aplikacji towarzyskiej dla dorosłych odpowiedni pakiet zawiera stałe fakty o fikcyjnych postaciach, krótki opis obecnej relacji i rozmowę potrzebną do następnej odpowiedzi. Zachowaj rozróżnienie między ustalonym faktem a twierdzeniem uczestnika. Jeśli postać mówi „poznaliśmy się zeszłego lata”, ale zatwierdzona historia mówi, że poznali się wczoraj, asystent nie powinien po cichu przepisywać karty postaci. Ta wypowiedź może być żartem albo celową fikcją w obrębie sceny.
Dlaczego pięćdziesiąt krótkich odpowiedzi może kosztować więcej niż jedna długa recenzja
Każde wywołanie może ponownie wysyłać kontekst. Przy 100 000 tokenów wejścia na zimno i 2000 rozliczanych tokenów wyjścia rachunek Grok 4.3 na niższym poziomie wynosi $0.13 za odpowiedź, czyli $6.50 za pięćdziesiąt odpowiedzi przy tym samym zużyciu. Skupiony pakiet 10 000 tokenów wejścia z tym samym wyjściem kosztuje $0.0175, czyli $0.875 za pięćdziesiąt. Te przypadki arytmetyczne nie zakładają trafień w cache ani równej jakości.
Dziesięciokrotnie mniejsze wejście jest przydatne tylko wtedy, gdy zachowuje informacje potrzebne następnej odpowiedzi. Zachowaj pełny scenariusz przy pytaniu o cały scenariusz; przy lokalnej wymianie nośnikiem niech będzie zwięzła, zatwierdzona historia. Gdy streszczenie pomija fakt, że obietnica wciąż nie została spełniona, tańszy prompt może dać gorszą kontynuację. Sprawdź ważne fakty dotyczące relacji i ciągłości, zanim zastąpisz pakiet źródłowy jego streszczeniem.
Obsługiwana opcja none to rozsądny punkt wyjścia dla dosłownej ekstrakcji. Nie sprawia, że każdy trudny wniosek narracyjny staje się równie łatwy. Jeśli brakujące przekazanie obejmuje kilka scen, najpierw upewnij się, że te sceny zostały dostarczone, a potem wypróbuj większy wysiłek przy tym zdefiniowanym pytaniu. Zwiększanie wysiłku przed dostarczeniem dowodów umożliwia tylko bardziej wyszukane zgadywanie.
Dodaj obraz referencyjny w poprawnym kształcie wiadomości
Tokeny obrazu liczą się do tego samego limitu wejścia i progu cenowego. Dodaj obraz tylko wtedy, gdy pytanie zależy od wyglądu rekwizytów.
Przy pytaniu wizualnym zastąp tekstową zawartość wiadomości użytkownika częściami z typami (w dokumentacji API czatu znajdziesz, jakie części akceptuje każdy model):
{
  "role": "user",
  "content": [
    {"type": "text", "text": "Describe the visible case and thermos. Do not infer an unseen handoff."},
    {"type": "image_url", "image_url": {"url": "https://cdn.spicyapi.ai/blog/authored/seo-next-twenty-2026-10-01/grok-4-3-context-budget-guide/body-1-gpt-image-66b06646fd526c4c.webp"}}
  ]
}
Obraz pokazuje wygląd rekwizytów; zmiany własności nadal wymagają tekstu odpowiedniej sceny. Dostarcz oba, gdy pytanie o ciągłość zależy od szczegółu wizualnego.
Pozwól Agentowi przygotować wywołanie
Przy powtarzanych kontrolach ciągłości poproś swojego Agenta programistycznego o użycie Skilla SpicyAPI: „Read xai/grok-4.3/chat, then adapt the example to my input; show the request before running it.” Wyszukanie przez CLI to spicyapi models get xai/grok-4.3/chat --json; przez MCP to spicyapi_model_get z model: "xai/grok-4.3/chat". Wywołania czatu korzystają z kompatybilnego klienta lub API czatu; polecenia zadań multimedialnych nie generują odpowiedzi czatu.
Obserwacje dotyczące treści dla dorosłych i wybór modelu
Recenzja Grok 4.3 podaje, że 8 z 9 próśb o sceny dla dorosłych o wyższej intensywności zostało zrealizowanych w testach z września 2026, a jedna odpowiedź była złagodzona. Przy scenariuszu dla dorosłych podaj w wiadomości systemowej fikcyjne zadanie redakcyjne i dostarcz fragmenty do zachowania.
Dla twórcy treści dla dorosłych, który potrzebuje dużej biblii postaci oraz scenariusza, praktyczne atuty to limit wejścia, niższa stawka za wyjście i prawdziwa opcja wysiłku none. Grok 4.5 i 4.6 oraz Grok 4.7 mają mniejszy limit 500 000 tokenów i kosztują $2.00 za milion tokenów wejścia bez cache i $6.00 za milion tokenów wyjścia poniżej 200K wejścia, wobec $1.25 i $2.50 w Grok 4.3. Wejście z cache kosztuje $0.30 w 4.5 i $0.50 w 4.6 i 4.7, wobec $0.20 w Grok 4.3.
Naprawa typowych niespodzianek
| Objaw | Bezpośrednie rozwiązanie |
|---|---|
| Drożej niż w szacunku dla niższego poziomu | Wlicz wejście z cache i historię rozmowy do progu 200 000 tokenów |
| Rozliczane wyjście przekracza oczekiwania wynikające z widocznego tekstu | Uwzględnij rozumowanie; przy odpowiednim, ograniczonym zadaniu użyj none |
| Część PDF lub audio została odrzucona | Wyodrębnij tekst albo użyj dedykowanej ścieżki transkrypcji |
| Model wypełnia brakujące przekazanie nową sceną | Wymagaj wyłącznie dostarczonych etykiet i odrzucaj niepoparte odwołania do scen |
| Duży pakiet kończy się przekroczeniem czasu bramki | Przesyłaj odpowiedź strumieniowo; wydłużenie limitu czasu klienta nie przedłuża trwającego około 100 sekund limitu edge dla żądań bez strumieniowania |
| Wynik narzędzia nie pozwala kontynuować rozmowy | Zachowaj w historii wiadomość asystenta z wywołaniem narzędzia i pasujące identyfikatory wywołań |
| JSON jest ucięty | Zwiększ max_tokens albo poproś o mniej ustaleń dotyczących ciągłości |
Od jakiej konfiguracji zacząć
Użyj Grok 4.3 z none do ograniczonego raportu ciągłości, gdy liczą się koszt i duży pakiet źródłowy. Zacznij od dowodów ze scen, a nie od przepisywania całego scenariusza. Trzymaj pakiet poniżej 200 000 tokenów, gdy zadanie na to pozwala; gdy brakujące powiązanie zależy od odległych scen, zapłać za potrzebny kontekst zamiast pomijać scenę, która dowodzi odpowiedzi.
FAQ
Czy milionowe okno API to to samo co pamięć aplikacji Grok?
Nie. Wszystko, co model ma wiedzieć, musi znaleźć się w żądaniu: wklej wcześniejsze sceny albo ich streszczenie. Historia Twojej aplikacji Grok i limit wiadomości nie przenoszą się na wywołania API.
Czy wejście z cache wlicza się do progu 200 000 tokenów?
Tak. Tokeny z cache i ponownie wysyłana historia wliczają się wszystkie, więc długi czat może przekroczyć próg, nawet gdy większość jest z cache. Wyższe stawki obejmują wtedy całe żądanie, więc jeśli jesteś blisko progu, przed ostatnim wywołaniem skróć stare tury.
Czy none gwarantuje najtańszą odpowiedź?
Usuwa udostępniany tryb rozumowania, co czyni go dobrym punktem wyjścia dla małej ekstrakcji. Rachunek nadal zależy od wejścia, kategorii cache, widocznego wyjścia i wybranego poziomu cenowego; dłuższa odpowiedź lub większy pakiet kosztuje więcej.
Czy model znajdzie każdy błąd ciągłości w scenariuszu liczącym milion tokenów?
Okno to pojemność, a nie gwarancja idealnego odtwarzania. Oznacz sceny etykietami, zadaj konkretne pytanie o ciągłość i zweryfikuj cytowane fragmenty. Gdy znajdziesz brakujące przekazanie, poproś o lokalną poprawkę zamiast generować cały scenariusz od nowa.





