Für die Prüfung eines langen Drehbuchs braucht es die Szenen, die festlegen, wer was weiß oder besitzt. Mehr vom Drehbuch zu senden kann helfen, eine fehlende Verbindung aufzudecken, verändert aber auch die Rechnung, besonders an der Grenze von 200.000 Tokens.
Grok 4.3 ist die Long-Context-Option im aktuellen Grok-Chat-Angebot: Es nimmt bis zu 1.000.000 Eingabe-Tokens an und bietet reasoning_effort: "none", was die aktuellen Verträge von 4.5, 4.6 und 4.7 nicht vorsehen. Achten Sie auf die Abrechnungsgrenze: Bei 200.000 Eingabe-Tokens insgesamt gilt bereits die höhere Stufe, und diese Stufe gilt für die gesamte Anfrage.
Genaue Preise und Limits
Der aktuelle SpicyAPI-Vertrag für xai/grok-4.3/chat unterstützt Text- und Bildteile, bis zu 256 Nachrichten und 128 Tool-Definitionen. Datei-/PDF- und Audioteile werden nicht akzeptiert.
| Eingabe gesamt | Nicht gecachte Eingabe / 1M | Gecachte Eingabe / 1M | Ausgabe / 1M |
|---|---|---|---|
| Unter 200.000 Tokens | $1.25 | $0.20 | $2.50 |
| 200.000 Tokens oder mehr | $2.50 | $0.40 | $5.00 |
Die Eingabeobergrenze liegt bei 1.000.000 Tokens. max_tokens ist standardmäßig 4.096 und akzeptiert bis zu 900.000, die Obergrenze für die sichtbare Antwort. Reasoning-Tokens werden separat innerhalb der Ausgabenutzung abgerechnet und von dieser Obergrenze nicht begrenzt. Verfügbare Stufen sind none, low, medium, high und xhigh; Standard ist low.
Beginnen Sie bei einer einfachen exakten Extraktion mit none. Probieren Sie bei einer schwierigen Kontinuitätsfrage über viele verstreute Szenen low oder höher, wenn die erste Antwort eine bestimmte Verbindung übersieht. Reasoning verbraucht ebenfalls abgerechnete Ausgabe, daher lässt sich die Rechnung allein aus der Länge der sichtbaren Antwort nicht rekonstruieren.
Was bei 199.999 gegenüber 200.000 Tokens passiert
Bei 4.000 abgerechneten Ausgabe-Tokens und ohne Cache:
| Eingabe | Berechnung | Geschätzte Kosten |
|---|---|---|
| 199.999 | 199.999 × $1.25 / 1M + 4.000 × $2.50 / 1M | $0.25999875 |
| 200.000 | 200.000 × $2.50 / 1M + 4.000 × $5.00 / 1M | $0.52 |
Der Unterschied ist ein Stufenwechsel, nicht der Preis eines zusätzlichen Tokens zum alten Satz. Auch gecachte Eingabe zählt zur Grenze. Bei 50.000 nicht gecachten plus 149.000 gecachten Eingabe-Tokens und 4.000 Ausgabe-Tokens ergibt die Schätzung $0.1023. Erhöht man den gecachten Anteil auf 150.000, beträgt die Gesamteingabe 200.000 und die Schätzung steigt auf $0.205.
Zählen Sie den gecachten Teil nicht noch einmal als nicht gecacht. Die Formel für die Anfrage lautet:
cost = uncached_input × input_rate / 1,000,000
     + cached_input × cached_rate / 1,000,000
     + billed_output × output_rate / 1,000,000
Laden Sie vor dem Senden die vollständigen Nachrichten und Einstellungen im Grok 4.3 Playground und prüfen Sie Preisschätzung und Stufe. Berücksichtigen Sie Systemanweisungen, Tool-Definitionen, Bilder und erneut gesendeten Verlauf; eine Zeichenzahl ist keine exakte Token-Zahl. Prüfen Sie danach usage.prompt_tokens, das gecachte Eingabe bereits enthält. Addieren Sie usage.prompt_tokens_details.cached_tokens nicht noch einmal. Vergleichen Sie die Gesamteingabe mit 200.000 und nehmen Sie dann den abgerechneten Betrag für die endgültige Rechnung.
Stellen Sie das wiederverwendbare Drehbuch und die Figurenbibel an den Anfang und die wechselnde Frage ans Ende. Ein stabiles Präfix kann eine Wiederverwendung ermöglichen, aber wenden Sie den Cache-Satz nur auf Tokens an, die als Cache-Treffer gemeldet werden.
Die Stufe richtet sich nach der Gesamteingabe, einschließlich des mit diesem Aufruf gesendeten Verlaufs. Eine anfängliche Guthabenreservierung spiegelt die endgültige Cache-Ersparnis nicht unbedingt wider. Beurteilen Sie eine echte Anfrage anhand der zurückgegebenen Nutzung und des abgerechneten Betrags; alle Summen hier sind illustrative Rechenbeispiele.
Das Millionen-Token-Fenster ist ein Limit für eine einzelne API-Anfrage. Es ist getrennt vom wöchentlichen Nachrichtenkontingent eines Grok-App-Abos. Bei diesem Chat-Endpunkt senden Sie bei jedem Aufruf den Verlauf und den Quelltext mit, den das Modell braucht; es erhält Ihre früheren App-Unterhaltungen nicht schon deshalb, weil der Modellname vertraut klingt.
Zuerst im Playground ausprobieren
- Öffnen Sie Grok 4.3 und wechseln Sie zum Playground.
- Setzen Sie den System prompt auf die Anweisung aus dem Beispiel unten. Fügen Sie im Nachrichtenfeld die beiden Szenen (SCENE12 und SCENE18) ein und fragen Sie nach fehlenden Requisitenübergaben. Wählen Sie die Reasoning-Option none und klicken Sie auf Run model.
- Prüfen Sie, dass die Antwort sowohl die Thermoskanne als auch den roten Koffer nennt, und kontrollieren Sie dann die Preisschätzung, bevor Sie ein vollständiges Drehbuch senden.
Ein praktischer Anwendungsfall mit langem Drehbuch
Ein fiktives Liebesdrehbuch für Erwachsene verwendet einen roten Lederkoffer und eine kupferne Thermoskanne mit blauem Band. Das Kontinuitätsproblem ist der Besitz: Wer trug jedes Requisit vor und nach einer Szene? Senden Sie das Drehbuch als Text mit Szenenbezeichnungen und fragen Sie nach ausdrücklichen oder fehlenden Übergaben, statt das Modell „alles prüfen“ zu lassen.
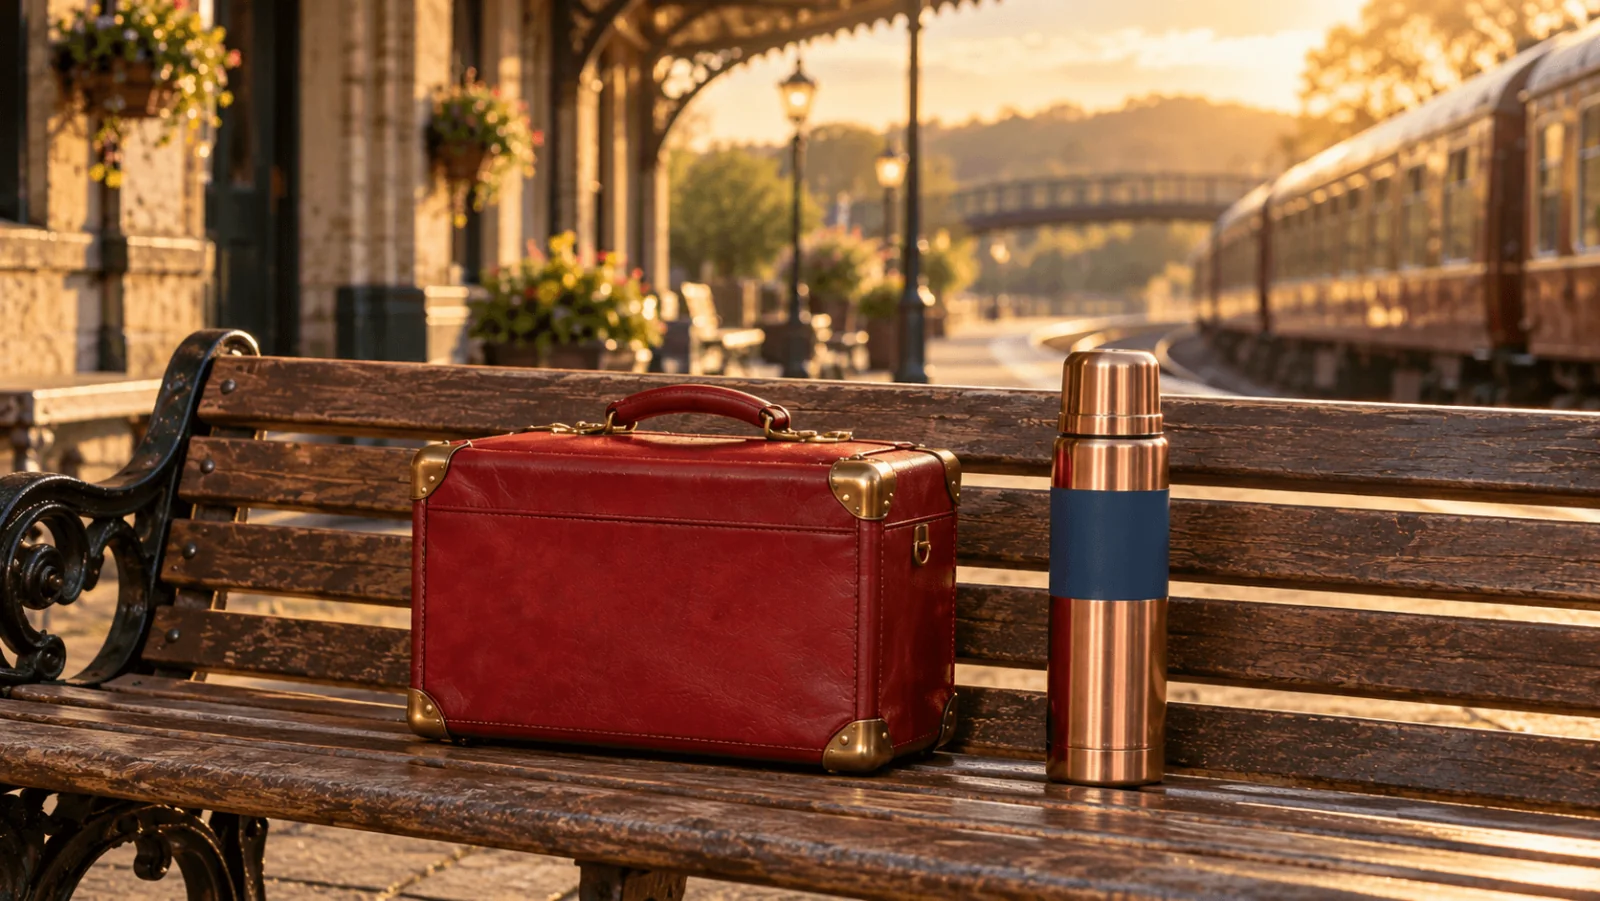
Illustration der fiktiven Requisiten. Sie ist keine Ausgabe von Grok und kein Beleg für visuelle Genauigkeit; der Aufruf unten erhält deren schriftliche Beschreibungen.
curl --fail-with-body https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Idempotency-Key: $(uuidgen)" \
  -d '{
    "model": "xai/grok-4.3/chat",
    "reasoning_effort": "none",
    "max_tokens": 2000,
    "response_format": {"type": "json_object"},
    "messages": [
      {"role": "system", "content": "Return JSON with missing_handoffs: a list of objects containing prop, missing_step and evidence_scene_ids (a nonempty list of supplied scene labels). Do not invent a handoff."},
      {"role": "user", "content": "Fictional adults: Mara, 32, Jon, 35. SCENE_12: Mara leaves her copper thermos with a blue band on the bench. Jon carries a closed red leather case. SCENE_18: Jon gives Mara the thermos; Mara opens the red case. Find ownership changes without an explicit handoff."}
    ]
  }' > response.json

python3 - <<'PY'
import json
from pathlib import Path

resp = json.loads(Path("response.json").read_text())
print(json.dumps({"usage": resp.get("usage")}, indent=2))
choices = resp.get("choices") or []
if resp.get("error") or not choices or choices[0].get("finish_reason") != "stop":
    raise RuntimeError("no complete continuity report")
text = choices[0].get("message", {}).get("content")
if not isinstance(text, str) or not text.strip():
    raise RuntimeError("empty report")
report = json.loads(text)
if not isinstance(report, dict) or not isinstance(report.get("missing_handoffs"), list):
    raise RuntimeError("missing_handoffs must be a list")
for item in report["missing_handoffs"]:
    if not isinstance(item, dict):
        raise RuntimeError("each finding must be an object")
    for key in ("prop", "missing_step"):
        if not isinstance(item.get(key), str) or not item[key].strip():
            raise RuntimeError(f"missing {key}")
    ids = item.get("evidence_scene_ids")
    if not isinstance(ids, list) or not ids or any(
        not isinstance(i, str) or i not in {"SCENE_12", "SCENE_18"} for i in ids
    ):
        raise RuntimeError("unsupported scene reference")
print(json.dumps(report, indent=2))
PY
Es gibt zwei erwartete Lücken: Jon muss die Thermoskanne von der Bank holen, und der rote Koffer muss von Jon zu Mara wechseln. Keine der beiden Handlungen ist unmöglich; keine der beiden Übergaben steht in den gelieferten Szenen. Eine korrekte Antwort benennt beide Lücken mit SCENE_12 und SCENE_18, statt eine Szene zu erfinden, die sie auflöst.
Für eine programmatische Prüfung geben Sie dem Modell eine konkrete Ausgabeform vor: missing_handoffs ist eine Liste von Objekten mit prop, missing_step und evidence_scene_ids. Das einzelne Beispiel prüft diese Form, bevor es den Bericht ausgibt.
Der Checker validiert die Berichtsstruktur und die Szenenverweise. Vergleichen Sie die beiden Befunde mit dem Szenentext, bevor Sie die Änderung übernehmen; gültiges JSON allein belegt nicht, dass die Kontinuitätsanalyse stimmt.
Ersetzen Sie bei einem vollständigen Drehbuch die Nutzernachricht durch den aus Ihrem aktuellen Entwurf exportierten Text und behalten Sie dieselben Szenenbezeichnungen bei.
Nutzen Sie bei einem langen Drehbuch die Streaming-Schnittstelle. Exportieren Sie zuerst den PDF-Text und behalten Sie die Szenenbezeichnungen bei, die in Ihren Befunden vorkommen.
Geben Sie dem langen Drehbuch eine brauchbare Frage, nicht die Aufforderung zum Zusammenfassen
Halten Sie für die Requisitenkontinuität eine kompakte Abfolge mit Szenenbezeichnungen und sichtbaren Handlungen bereit: Wer hat den Gegenstand mitgebracht, wo wurde er zurückgelassen und wer benutzt ihn als Nächstes. Eine Figurenbibel legt den gewöhnlichen Besitzer fest; sie verbietet einer anderen Figur nicht, sich den Gegenstand zu leihen. Fragen Sie nach Wechseln ohne angegebene Übergabe, nicht nach jedem Auftreten, das von der Besitzertabelle abweicht.
Im Beispiel impliziert Jons Übergabe der Thermoskanne an Mara, dass er sie nach Szene 12 geholt oder erhalten hat. Dass Mara den roten Koffer öffnet, impliziert, dass sie Zugriff auf Jons Gegenstand hat. Das sind Lücken, die zu prüfen sind. Eine von Menschen geschriebene Lösung könnte Jon die Thermoskanne beim Verlassen des Bahnsteigs einsammeln und Mara den Koffer zum Öffnen anbieten lassen. Eine andere legitime Lösung hält die Distanz zwischen den Figuren und lässt jede nur ihren eigenen Gegenstand anfassen. Entscheiden Sie nach dem Beziehungsmoment der Szene; der Kontinuitätsbericht kann diese kreative Entscheidung nicht für Sie treffen.
Bei einer Companion-Anwendung für Erwachsene enthält das entsprechende Paket stabile Fakten zu fiktiven Figuren, eine kurze Darstellung der aktuellen Beziehung und die Unterhaltung, die für die nächste Antwort nötig ist. Halten Sie den Unterschied zwischen einem festgelegten Fakt und der Behauptung eines Beteiligten aufrecht. Sagt eine Figur „wir haben uns letzten Sommer kennengelernt“, der freigegebene Verlauf besagt aber, dass sie sich gestern kennengelernt haben, sollte der Assistent den Figureneintrag nicht stillschweigend umschreiben. Die Aussage kann ein Scherz oder eine bewusste Fiktion innerhalb der Szene sein.
Warum fünfzig kurze Antworten mehr kosten können als eine lange Prüfung
Jeder Aufruf kann den Kontext erneut senden. Bei 100.000 kalten Eingabe-Tokens und 2.000 abgerechneten Ausgabe-Tokens beträgt die Rechnung von Grok 4.3 in der niedrigen Stufe $0.13 pro Antwort, also $6.50 für fünfzig Antworten bei gleicher Nutzung. Ein gezieltes Paket mit 10.000 Eingabe-Tokens und gleicher Ausgabe kostet $0.0175, also $0.875 für fünfzig. Diese Rechenfälle setzen weder Cache-Treffer noch gleiche Qualität voraus.
Die zehnmal kleinere Eingabe ist nur dann nützlich, wenn sie die Informationen bewahrt, die die nächste Antwort braucht. Behalten Sie das vollständige Drehbuch für eine Frage zum ganzen Drehbuch; führen Sie für einen lokalen Austausch einen knappen freigegebenen Verlauf mit. Wenn eine Zusammenfassung die Tatsache auslässt, dass ein Versprechen noch nicht eingelöst ist, kann der günstigere Prompt eine schlechtere Fortsetzung liefern. Prüfen Sie die wichtigen Beziehungs- und Kontinuitätsfakten, bevor Sie ein Quellpaket durch seine Zusammenfassung ersetzen.
Die unterstützte Option none ist ein vernünftiger Ausgangspunkt für wörtliche Extraktion. Sie macht nicht jede schwierige narrative Schlussfolgerung gleich leicht. Erstreckt sich die fehlende Übergabe über mehrere Szenen, stellen Sie zuerst sicher, dass diese Szenen geliefert wurden, und probieren Sie dann bei dieser klar definierten Frage mehr Effort. Den Effort zu erhöhen, bevor die Belege geliefert sind, ermöglicht nur eine aufwendigere Vermutung.
Ein Referenzbild in der richtigen Nachrichtenform hinzufügen
Bild-Tokens zählen zur selben Eingabeobergrenze und Preisgrenze. Fügen Sie das Bild nur hinzu, wenn die Frage vom Aussehen der Requisiten abhängt.
Ersetzen Sie bei einer visuellen Frage den String-Inhalt der Nutzernachricht durch typisierte Teile (die Chat-API-Dokumentation listet auf, welche Teile jedes Modell akzeptiert):
{
  "role": "user",
  "content": [
    {"type": "text", "text": "Describe the visible case and thermos. Do not infer an unseen handoff."},
    {"type": "image_url", "image_url": {"url": "https://cdn.spicyapi.ai/blog/authored/seo-next-twenty-2026-10-01/grok-4-3-context-budget-guide/body-1-gpt-image-66b06646fd526c4c.webp"}}
  ]
}
Das Bild zeigt das Aussehen der Requisiten; Besitzwechsel erfordern weiterhin den entsprechenden Szenentext. Liefern Sie beides, wenn eine Kontinuitätsfrage von einem visuellen Detail abhängt.
Einen Agent den Aufruf vorbereiten lassen
Bitten Sie bei wiederholten Kontinuitätsprüfungen Ihren Coding-Agent, den SpicyAPI Skill zu verwenden: „Read xai/grok-4.3/chat, then adapt the example to my input; show the request before running it.“ Die Abfrage per CLI lautet spicyapi models get xai/grok-4.3/chat --json; die per MCP ist spicyapi_model_get mit model: "xai/grok-4.3/chat". Chat-Aufrufe nutzen einen kompatiblen Client oder die Chat-API; die Befehle für Medien-Tasks erzeugen keine Chat-Antworten.
Beobachtungen zu Erwachseneninhalten und Modellwahl
Die Grok-4.3-Bewertung berichtet, dass in den Tests vom September 2026 8 von 9 Anfragen zu Erwachsenenszenen höherer Intensität abgeschlossen wurden, eine Antwort fiel abgeschwächt aus. Nennen Sie bei einem Drehbuch für Erwachsene den fiktiven Redaktionsauftrag in der Systemnachricht und liefern Sie die Passagen, die erhalten bleiben sollen.
Für Ersteller von Erwachseneninhalten, die eine große Figurenbibel plus Drehbuch brauchen, sind die praktischen Vorteile die Eingabeobergrenze, der niedrigere Ausgabesatz und eine echte Effort-Option none. Grok 4.5 und 4.6 sowie Grok 4.7 teilen sich eine kleinere Obergrenze von 500.000 Tokens und kosten $2.00 pro Million nicht gecachter Eingabe und $6.00 pro Million Ausgabe unterhalb von 200K Eingabe, gegenüber $1.25 und $2.50 bei Grok 4.3. Gecachte Eingabe kostet $0.30 bei 4.5 und $0.50 bei 4.6 und 4.7, gegenüber $0.20 bei Grok 4.3.
Abhilfe bei häufigen Überraschungen
| Symptom | Direkte Abhilfe |
|---|---|
| Teurer als die Schätzung der niedrigen Stufe | Gecachte Eingabe und Gesprächsverlauf in die Grenze von 200.000 Tokens einrechnen |
| Abgerechnete Ausgabe übersteigt die Erwartung nach dem sichtbaren Text | Reasoning berücksichtigen; bei einer geeigneten, begrenzten Aufgabe none verwenden |
| PDF- oder Audioteil abgelehnt | Text extrahieren oder einen eigenen Transkriptionsweg nutzen |
| Das Modell füllt eine fehlende Übergabe mit einer neuen Szene | Nur gelieferte Bezeichnungen verlangen und nicht belegte Szenenverweise ablehnen |
| Großes Paket läuft in ein Gateway-Timeout | Die Antwort streamen; ein höherer Client-Timeout verlängert das Limit von etwa 100 Sekunden für Anfragen ohne Streaming am Edge nicht |
| Tool-Ausgabe kann die Unterhaltung nicht fortsetzen | Die Tool-Call-Nachricht des Assistenten und die passenden Call-IDs im Verlauf behalten |
| JSON ist abgeschnitten | max_tokens erhöhen oder weniger Kontinuitätsbefunde anfordern |
Mit welchem Setup beginnen
Verwenden Sie Grok 4.3 mit none für einen begrenzten Kontinuitätsbericht, wenn Kosten und ein großes Quellpaket wichtig sind. Beginnen Sie mit Szenenbelegen statt mit einer Neufassung des ganzen Drehbuchs. Halten Sie das Paket unter 200.000 Tokens, wenn die Aufgabe es erlaubt; hängt die fehlende Verbindung von weit entfernten Szenen ab, zahlen Sie für den nötigen Kontext, statt die Szene wegzulassen, die die Antwort belegt.
FAQ
Ist das Millionen-Token-Fenster der API dasselbe wie das Gedächtnis der Grok-App?
Nein. Alles, was das Modell wissen soll, muss in der Anfrage stehen: Fügen Sie die früheren Szenen oder eine Zusammenfassung davon ein. Ihr Grok-App-Verlauf und Ihr Nachrichtenkontingent werden nicht auf API-Aufrufe übertragen.
Zählt gecachte Eingabe zur Grenze von 200.000 Tokens?
Ja. Gecachte Tokens und erneut gesendeter Verlauf zählen alle mit, sodass ein langer Chat die Grenze überschreiten kann, auch wenn der größte Teil gecacht ist. Die höheren Sätze gelten dann für die gesamte Anfrage; kürzen Sie also vor dem letzten Aufruf alte Beiträge, wenn Sie nahe an der Grenze liegen.
Garantiert none die günstigste Antwort?
Es entfernt den offengelegten Reasoning-Modus und ist damit ein guter Ausgangspunkt für eine kleine Extraktion. Die Rechnung hängt weiterhin von Eingabe, Cache-Kategorien, sichtbarer Ausgabe und der gewählten Stufe ab; eine längere Antwort oder ein größeres Paket kostet mehr.
Kann das Modell jeden Kontinuitätsfehler in einem Drehbuch mit einer Million Tokens finden?
Das Fenster ist Kapazität, keine Garantie für perfektes Erinnern. Beschriften Sie Szenen, stellen Sie eine konkrete Kontinuitätsfrage und prüfen Sie die zitierten Passagen. Fordern Sie nach dem Fund der fehlenden Übergabe eine lokale Korrektur an, statt das gesamte Drehbuch neu zu erzeugen.





