Revisar um roteiro longo exige as cenas que estabelecem quem sabe ou possui o quê. Enviar mais partes do roteiro pode ajudar a expor uma ligação que falta, mas também muda a conta, especialmente no limite de 200.000 tokens.
O Grok 4.3 é a opção de contexto longo na linha atual de chat do Grok: aceita até 1.000.000 de tokens de entrada e oferece reasoning_effort: "none", o que os contratos atuais do 4.5, 4.6 e 4.7 não oferecem. Fique de olho no limite de cobrança: 200.000 tokens de entrada no total já selecionam a faixa mais alta, e essa faixa vale para a requisição inteira.
Preços e limites exatos
O contrato atual da SpicyAPI para xai/grok-4.3/chat aceita partes de texto e imagem, até 256 mensagens e 128 definições de ferramentas. Não aceita partes de arquivo/PDF nem de áudio.
| Entrada total | Entrada sem cache / 1M | Entrada em cache / 1M | Saída / 1M |
|---|---|---|---|
| Abaixo de 200.000 tokens | $1.25 | $0.20 | $2.50 |
| 200.000 tokens ou mais | $2.50 | $0.40 | $5.00 |
O teto de entrada é de 1.000.000 de tokens. max_tokens é 4.096 por padrão e aceita até 900.000, o teto da resposta visível. Os tokens de raciocínio são cobrados separadamente dentro do uso de saída e não são limitados por esse teto. Os níveis de esforço disponíveis são none, low, medium, high e xhigh; o padrão é low.
Para uma extração exata simples, comece com none. Para uma pergunta de continuidade difícil que envolva muitas cenas separadas, tente low ou mais se a primeira resposta deixar escapar uma ligação específica. O raciocínio também consome saída cobrada, então o tamanho da resposta visível sozinho não permite reconstruir a conta.
O que acontece com 199.999 versus 200.000 tokens
Com 4.000 tokens de saída cobrados e sem cache:
| Entrada | Cálculo | Custo estimado |
|---|---|---|
| 199.999 | 199.999 × $1.25 / 1M + 4.000 × $2.50 / 1M | $0.25999875 |
| 200.000 | 200.000 × $2.50 / 1M + 4.000 × $5.00 / 1M | $0.52 |
A diferença é uma mudança de faixa, não o custo de um token a mais na tarifa antiga. A entrada em cache também conta para o limite. Com 50.000 tokens sem cache mais 149.000 em cache e 4.000 de saída, a estimativa é de $0.1023. Elevando a parte em cache para 150.000, a entrada total passa a 200.000 e a estimativa sobe para $0.205.
Não conte a parte em cache de novo como sem cache. A fórmula da requisição é:
cost = uncached_input × input_rate / 1,000,000
     + cached_input × cached_rate / 1,000,000
     + billed_output × output_rate / 1,000,000
Antes de enviar, carregue as mensagens e configurações completas no Playground do Grok 4.3 e confira a estimativa de preço e a faixa. Inclua instruções de sistema, definições de ferramentas, imagens e histórico reenviado: uma contagem de caracteres não é uma contagem exata de tokens. Depois do envio, confira usage.prompt_tokens, que já inclui a entrada em cache. Não some de novo usage.prompt_tokens_details.cached_tokens. Compare a entrada total com 200.000 e use então o valor liquidado como a cobrança final.
Coloque primeiro o roteiro reutilizável e a bíblia de personagens, e por último a pergunta que muda. Um prefixo estável pode permitir o reaproveitamento, mas aplique a tarifa de cache apenas aos tokens informados como cache hits.
A faixa é escolhida pela entrada total, incluindo o histórico enviado nesta chamada. Uma retenção inicial de saldo não reflete necessariamente a economia final do cache. Use o uso retornado e o valor liquidado para avaliar uma requisição real; todos os totais aqui são aritmética ilustrativa.
A janela de um milhão de tokens é um limite para uma única requisição de API. É separada da cota semanal de mensagens de uma assinatura do app Grok. Com este endpoint de chat, você envia a cada chamada o histórico e o texto-fonte de que o modelo precisa: ele não adquire suas conversas anteriores no app só porque o nome do modelo lhe é familiar.
Experimente primeiro no Playground
- Abra o Grok 4.3 e mude para o Playground.
- Defina o System prompt com a instrução do exemplo abaixo. No campo de mensagem, cole as duas cenas (SCENE12 e SCENE18) e peça as passagens de objetos de cena que faltam. Escolha a opção de raciocínio none e clique em Run model.
- Confira se a resposta cita tanto a garrafa térmica quanto a maleta vermelha e depois verifique a estimativa de preço antes de enviar um roteiro completo.
Um caso prático com roteiro longo
Um roteiro romântico fictício para adultos usa uma maleta de couro vermelha e uma garrafa térmica de cobre com uma faixa azul. O problema de continuidade é a posse: quem carregava cada objeto antes e depois de uma cena? Envie o roteiro como texto com rótulos de cena e peça as passagens explícitas ou ausentes, em vez de pedir ao modelo que «revise tudo».
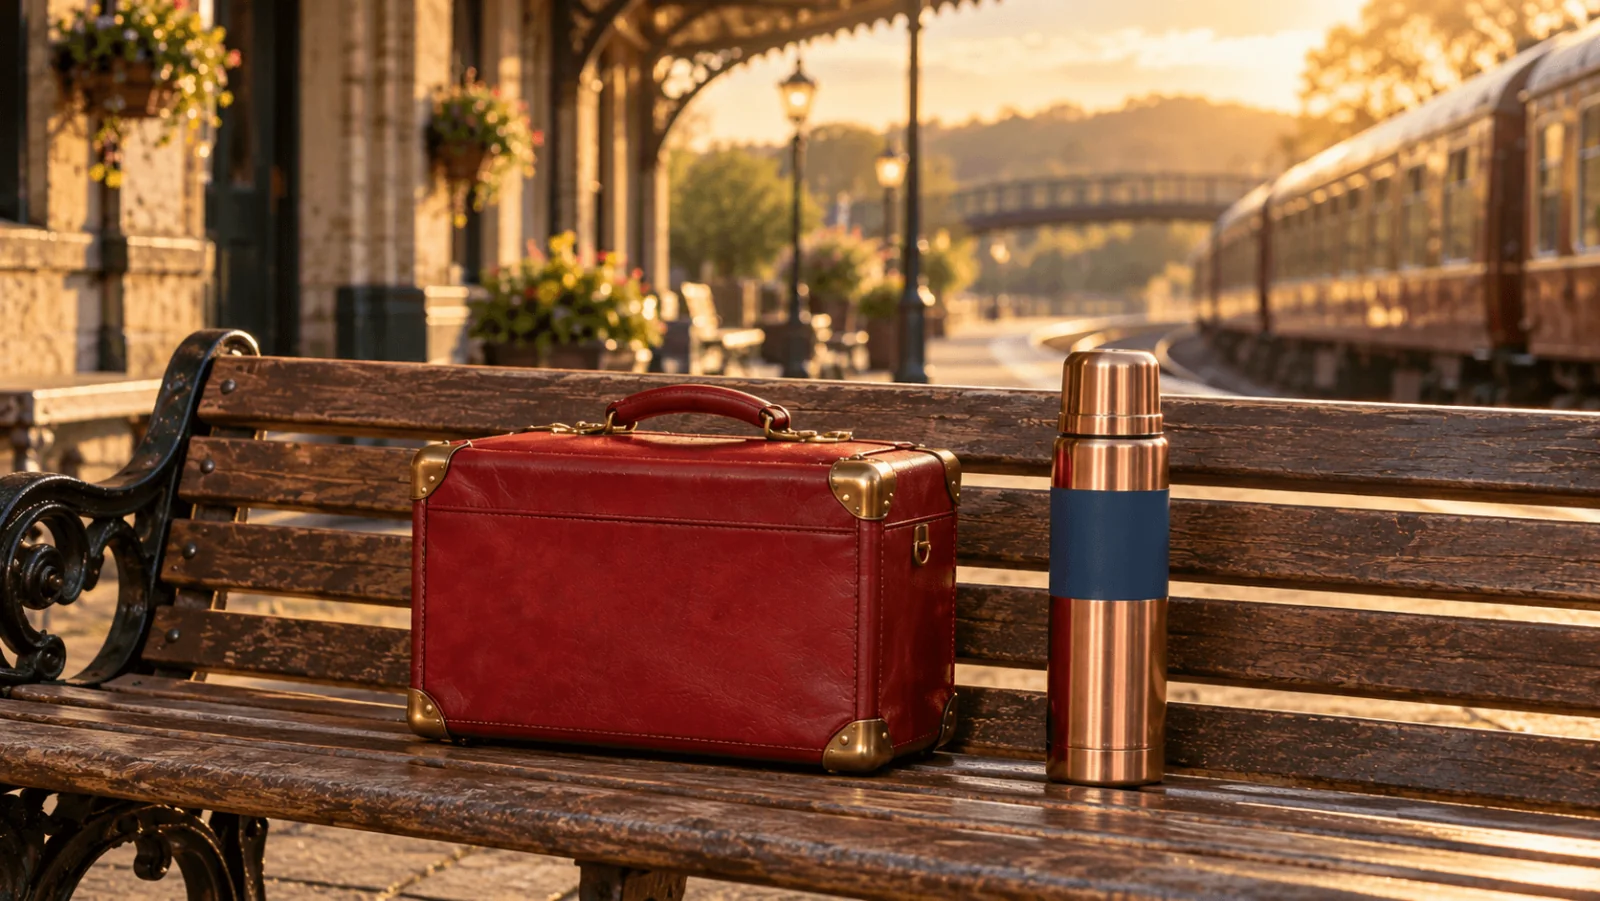
Ilustração dos objetos fictícios. Não é uma saída do Grok nem prova de precisão visual; a chamada abaixo recebe as descrições escritas deles.
curl --fail-with-body https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Idempotency-Key: $(uuidgen)" \
  -d '{
    "model": "xai/grok-4.3/chat",
    "reasoning_effort": "none",
    "max_tokens": 2000,
    "response_format": {"type": "json_object"},
    "messages": [
      {"role": "system", "content": "Return JSON with missing_handoffs: a list of objects containing prop, missing_step and evidence_scene_ids (a nonempty list of supplied scene labels). Do not invent a handoff."},
      {"role": "user", "content": "Fictional adults: Mara, 32, Jon, 35. SCENE_12: Mara leaves her copper thermos with a blue band on the bench. Jon carries a closed red leather case. SCENE_18: Jon gives Mara the thermos; Mara opens the red case. Find ownership changes without an explicit handoff."}
    ]
  }' > response.json

python3 - <<'PY'
import json
from pathlib import Path

resp = json.loads(Path("response.json").read_text())
print(json.dumps({"usage": resp.get("usage")}, indent=2))
choices = resp.get("choices") or []
if resp.get("error") or not choices or choices[0].get("finish_reason") != "stop":
    raise RuntimeError("no complete continuity report")
text = choices[0].get("message", {}).get("content")
if not isinstance(text, str) or not text.strip():
    raise RuntimeError("empty report")
report = json.loads(text)
if not isinstance(report, dict) or not isinstance(report.get("missing_handoffs"), list):
    raise RuntimeError("missing_handoffs must be a list")
for item in report["missing_handoffs"]:
    if not isinstance(item, dict):
        raise RuntimeError("each finding must be an object")
    for key in ("prop", "missing_step"):
        if not isinstance(item.get(key), str) or not item[key].strip():
            raise RuntimeError(f"missing {key}")
    ids = item.get("evidence_scene_ids")
    if not isinstance(ids, list) or not ids or any(
        not isinstance(i, str) or i not in {"SCENE_12", "SCENE_18"} for i in ids
    ):
        raise RuntimeError("unsupported scene reference")
print(json.dumps(report, indent=2))
PY
Há duas lacunas esperadas: Jon precisa pegar a garrafa térmica do banco, e a maleta vermelha precisa passar de Jon para Mara. Nenhuma das duas ações é impossível; nenhuma das duas passagens está declarada nas cenas fornecidas. Uma resposta correta identifica as duas lacunas com SCENE_12 e SCENE_18, em vez de inventar uma cena que as resolva.
Para uma verificação programática, dê ao modelo um formato de saída concreto: missing_handoffs é uma lista de objetos com prop, missing_step e evidence_scene_ids. O único exemplo verifica esse formato antes de imprimir o relatório.
O verificador valida a estrutura do relatório e as referências de cena. Compare os dois achados com o texto das cenas antes de aceitar a edição; um JSON válido, por si só, não prova que a análise de continuidade esteja certa.
Para um roteiro completo, substitua a mensagem do usuário pelo texto exportado do seu rascunho atual, mantendo os mesmos rótulos de cena.
Para um roteiro longo, use a interface de streaming. Exporte primeiro o texto do PDF e mantenha os rótulos de cena usados nos seus achados.
Dê ao roteiro longo uma pergunta útil, não um convite a resumir
Para a continuidade de objetos de cena, mantenha uma sequência compacta com rótulos de cena e ações visíveis: quem trouxe o item, onde foi deixado e quem o usa em seguida. Uma bíblia de personagens estabelece o dono habitual; ela não proíbe outro personagem de pegar o item emprestado. Peça as mudanças sem passagem declarada, não toda aparição que difere da tabela de donos.
No exemplo, Jon entregar a garrafa térmica a Mara implica que ele a pegou ou recebeu depois da cena 12. Mara abrir a maleta vermelha implica que ela tem acesso ao item de Jon. São lacunas a examinar. Uma correção escrita por uma pessoa poderia fazer Jon pegar a garrafa térmica ao deixarem a plataforma e oferecer a maleta para Mara abrir. Outra correção legítima mantém a distância entre os personagens e faz cada um manusear apenas o seu próprio item. Escolha conforme o momento da relação na cena; o relatório de continuidade não pode tomar essa decisão criativa por você.
Para um aplicativo de companhia para adultos, o pacote equivalente contém fatos estáveis dos personagens fictícios, um breve relato da relação atual e a conversa necessária para a próxima resposta. Mantenha a distinção entre um fato estabelecido e a afirmação de um participante. Se um personagem diz «nos conhecemos no verão passado», mas o histórico aprovado diz que se conheceram ontem, o assistente não deve reescrever em silêncio o registro do personagem. A afirmação pode ser uma piada ou uma ficção deliberada dentro da cena.
Por que cinquenta respostas curtas podem custar mais que uma revisão longa
Cada chamada pode reenviar o contexto. Com 100.000 tokens de entrada a frio e 2.000 tokens de saída cobrados, o cálculo do Grok 4.3 na faixa inferior é de $0.13 por resposta, ou $6.50 por cinquenta respostas com o mesmo uso. Um pacote focado de 10.000 tokens de entrada com a mesma saída custa $0.0175, ou $0.875 por cinquenta. Esses casos aritméticos não pressupõem cache hits nem qualidade equivalente.
A entrada dez vezes menor só é útil se preservar as informações de que a próxima resposta precisa. Mantenha o roteiro completo para uma pergunta sobre o roteiro inteiro; leve um histórico aprovado e conciso para uma troca local. Quando um resumo omite o fato de que uma promessa continua pendente, o prompt mais barato pode produzir uma continuação pior. Confira os fatos importantes de relação e continuidade antes de substituir um pacote-fonte pelo seu resumo.
A opção none, suportada, é um ponto de partida razoável para a extração literal. Ela não torna igualmente fácil toda inferência narrativa difícil. Se a passagem ausente se estende por várias cenas, primeiro garanta que essas cenas foram fornecidas e depois tente mais esforço nessa pergunta definida. Aumentar o esforço antes de fornecer as evidências só permite um palpite mais elaborado.
Adicione uma imagem de referência com o formato de mensagem correto
Os tokens de imagem contam para o mesmo teto de entrada e o mesmo limite de preço. Adicione a imagem apenas quando a pergunta depender da aparência dos objetos.
Para uma pergunta visual, substitua o conteúdo em string da mensagem do usuário por partes tipadas (a documentação da API de chat lista quais partes cada modelo aceita):
{
  "role": "user",
  "content": [
    {"type": "text", "text": "Describe the visible case and thermos. Do not infer an unseen handoff."},
    {"type": "image_url", "image_url": {"url": "https://cdn.spicyapi.ai/blog/authored/seo-next-twenty-2026-10-01/grok-4-3-context-budget-guide/body-1-gpt-image-66b06646fd526c4c.webp"}}
  ]
}
A imagem mostra a aparência dos objetos; mudanças de posse ainda exigem o texto da cena relevante. Forneça ambos quando uma pergunta de continuidade depender de um detalhe visual.
Deixe um Agent preparar a chamada
Para verificações de continuidade repetidas, peça ao seu Agent de programação que use o Skill da SpicyAPI: "Read xai/grok-4.3/chat, then adapt the example to my input; show the request before running it." A consulta pela CLI é spicyapi models get xai/grok-4.3/chat --json; a consulta pelo MCP é spicyapi_model_get com model: "xai/grok-4.3/chat". As chamadas de chat usam um cliente compatível ou a API de chat; os comandos de tarefas de mídia não geram respostas de chat.
Observações sobre conteúdo adulto e escolha do modelo
A análise do Grok 4.3 relata que 8 de 9 pedidos de cenas adultas de maior intensidade foram concluídos nos testes de setembro de 2026, com uma resposta suavizada. Para um roteiro adulto, informe na mensagem de sistema a tarefa de edição ficcional e forneça as passagens a preservar.
Para quem cria conteúdo adulto e precisa de uma grande bíblia de personagens mais o roteiro, os atrativos práticos são o teto de entrada, a tarifa de saída mais baixa e uma opção de esforço none genuína. O Grok 4.5 e 4.6 e o Grok 4.7 compartilham um teto menor de 500.000 tokens e custam $2.00 por milhão de entrada sem cache e $6.00 por milhão de saída abaixo de 200K de entrada, contra $1.25 e $2.50 no Grok 4.3. A entrada em cache custa $0.30 no 4.5 e $0.50 no 4.6 e 4.7, contra $0.20 no Grok 4.3.
Correções para surpresas comuns
| Sintoma | Correção direta |
|---|---|
| Mais caro que a estimativa da faixa inferior | Incluir a entrada em cache e o histórico da conversa no limite de 200.000 tokens |
| A saída cobrada excede o esperado pelo texto visível | Considerar o raciocínio; usar none em uma tarefa delimitada adequada |
| Parte PDF ou de áudio rejeitada | Extrair o texto ou usar uma rota de transcrição dedicada |
| O modelo preenche uma passagem ausente com uma cena nova | Exigir apenas os rótulos fornecidos e rejeitar referências de cena sem respaldo |
| Um pacote grande atinge o tempo limite do gateway | Transmitir a resposta em streaming; aumentar o tempo limite do cliente não amplia o limite de cerca de 100 segundos do edge para requisições sem streaming |
| A saída de uma ferramenta não consegue continuar a conversa | Manter no histórico a mensagem de chamada de ferramenta do assistente e os IDs de chamada correspondentes |
| O JSON é cortado | Aumentar max_tokens ou pedir menos achados de continuidade |
Com qual configuração começar
Use o Grok 4.3 com none para um relatório de continuidade delimitado quando o custo e um grande pacote-fonte importarem. Comece pelas evidências de cena, não por uma reescrita do roteiro inteiro. Mantenha o pacote abaixo de 200.000 tokens quando a tarefa permitir; quando a ligação ausente depender de cenas distantes, pague pelo contexto necessário em vez de descartar a cena que prova a resposta.
FAQ
A janela de um milhão de tokens da API é a mesma coisa que a memória do app Grok?
Não. Tudo o que o modelo deve saber precisa estar na requisição: cole as cenas anteriores ou um resumo delas. O histórico do seu app Grok e a sua cota de mensagens não passam para as chamadas de API.
A entrada em cache conta para o limite de 200.000 tokens?
Sim. Os tokens em cache e o histórico reenviado contam todos, então um chat longo pode ultrapassar a linha mesmo que a maior parte esteja em cache. As tarifas mais altas passam então a valer para a requisição inteira; por isso, reduza os turnos antigos antes da chamada final se estiver perto do limite.
O none garante a resposta mais barata?
Ele remove o modo de raciocínio exposto, o que o torna um bom ponto de partida para uma extração pequena. A conta ainda depende da entrada, das categorias de cache, da saída visível e da faixa selecionada; uma resposta mais longa ou um pacote maior custa mais.
O modelo consegue encontrar todos os erros de continuidade em um roteiro de um milhão de tokens?
A janela é capacidade, não garantia de recordação perfeita. Rotule as cenas, faça uma pergunta de continuidade específica e verifique as passagens citadas. Depois de achar a passagem ausente, peça um reparo local em vez de regenerar o roteiro inteiro.





