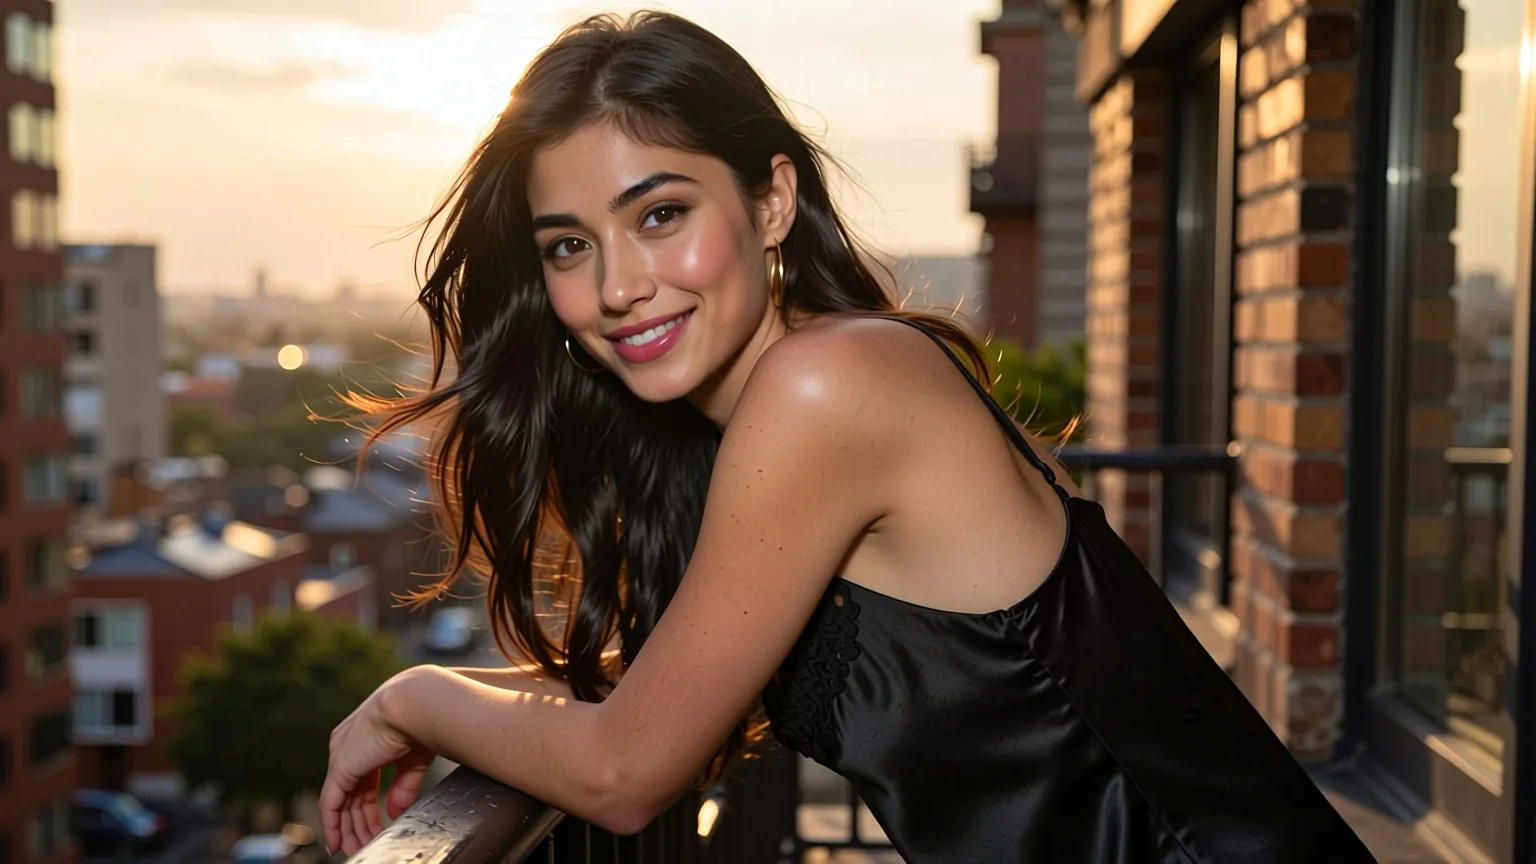
Jib Mix Qwen es un modelo rápido de retratos fotorrealistas: en nuestras pruebas una imagen tardó una mediana de 5.8 segundos, y los LoRA de foto y de cámara cambiaron su aspecto mientras que los LoRA de estilo casi no lo hicieron. Tiene dos puntos débiles que queremos que conozcas antes de construir sobre él. Seis solicitudes de una mujer japonesa, coreana o de Asia oriental volvieron todas con aspecto europeo o ambiguo, y las escenas íntimas de dos personas se dibujaron sin rechazo pero con una anatomía confusa.
Probamos tanto Jib Mix Qwen como su versión con LoRA el 5 de octubre de 2026. Jib Mix es una serie de checkpoints de la comunidad del creador J1B, y este es una mezcla de ajustes finos y LoRA de Qwen-Image construida sobre el Qwen-Image de Alibaba, de 20 mil millones de parámetros. Todos los prompts que se muestran abajo son escenas cotidianas con adultos vestidos.
De un vistazo
| Jib Mix Qwen y Jib Mix Qwen LoRA (probados el 5 de octubre de 2026) | |
|---|---|
| Creador y base | J1B; una mezcla de ajustes finos y LoRA de Qwen-Image sobre Qwen-Image (20B, codificador de texto Qwen2.5-VL) |
| Nombres del modelo en la API | j1b/jib-mix-qwen-image/text-to-image y j1b/jib-mix-qwen-image-lora/text-to-image |
| Campos públicos | prompt (hasta 5,000 caracteres), aspect_ratio, output_format, seed; la versión con LoRA agrega loras |
| Relaciones de aspecto | 9, hasta 1536 píxeles en el lado largo: 1328 x 1328 en 1:1, 1536 x 864 en 16:9 |
| Salida | Una imagen por solicitud en JPEG (por defecto), PNG o WebP |
| Velocidad en nuestras pruebas | Base: de 3.7 a 48 segundos en 30 ejecuciones, mediana de 5.8, 21 de 30 por debajo de 10. Versión con LoRA: de 3.2 a 36 segundos en 38 ejecuciones, mediana de 5.6 |
| Política de contenido | Sin censura, sin filtro de contenido; el contenido de un solo sujeto volvió como se pidió, las escenas de dos personas se dibujaron sin rechazo pero con menos precisión |
| No puede | Prompts negativos, pasos, guidance, imagen de entrada, edición, más de una imagen por solicitud |
Qué es y qué versión
Las notas del creador sobre la primera versión dicen que mezcla modelos Qwen con LoRA favoritos a pesos precisos. La página de Civitai enumera seis versiones entre septiembre de 2025 y marzo de 2026. La nota de la v4.0, del 15 de octubre de 2025, dice "much more natural pretty faces (much better at Asian faces)". La nota de la v6.0, de marzo de 2026, dice "more European faces and fewer Asian by default" y "not quite as good at NSFW as V5".
La ruta alojada no dice qué versión ejecuta. Su descripción repite la nota de la v4.0, pero nuestras salidas se inclinan hacia lo europeo, lo que coincide con la v6, y la ruta se actualizó hace poco, así que no podemos descartar un cambio. Lo señalamos como no verificado en lugar de adivinar. Lo que sí podemos informar es lo que hace la ruta, y eso es el resto de este artículo.
Cómo escribir prompts para retratos
Al modelo le gusta un encargo de fotógrafo en frases completas. El retrato de la ventana de abajo usó edad, pelo, pecas, ropa, pose y luz, con una breve apertura fotográfica:
Photorealistic photo, natural skin texture. A 32-year-old woman with a short black bob, light freckles and minimal makeup sits on a windowsill in a cream silk camisole, knees drawn up, holding a mug of coffee. Soft morning light, sheer curtains, shallow depth of field.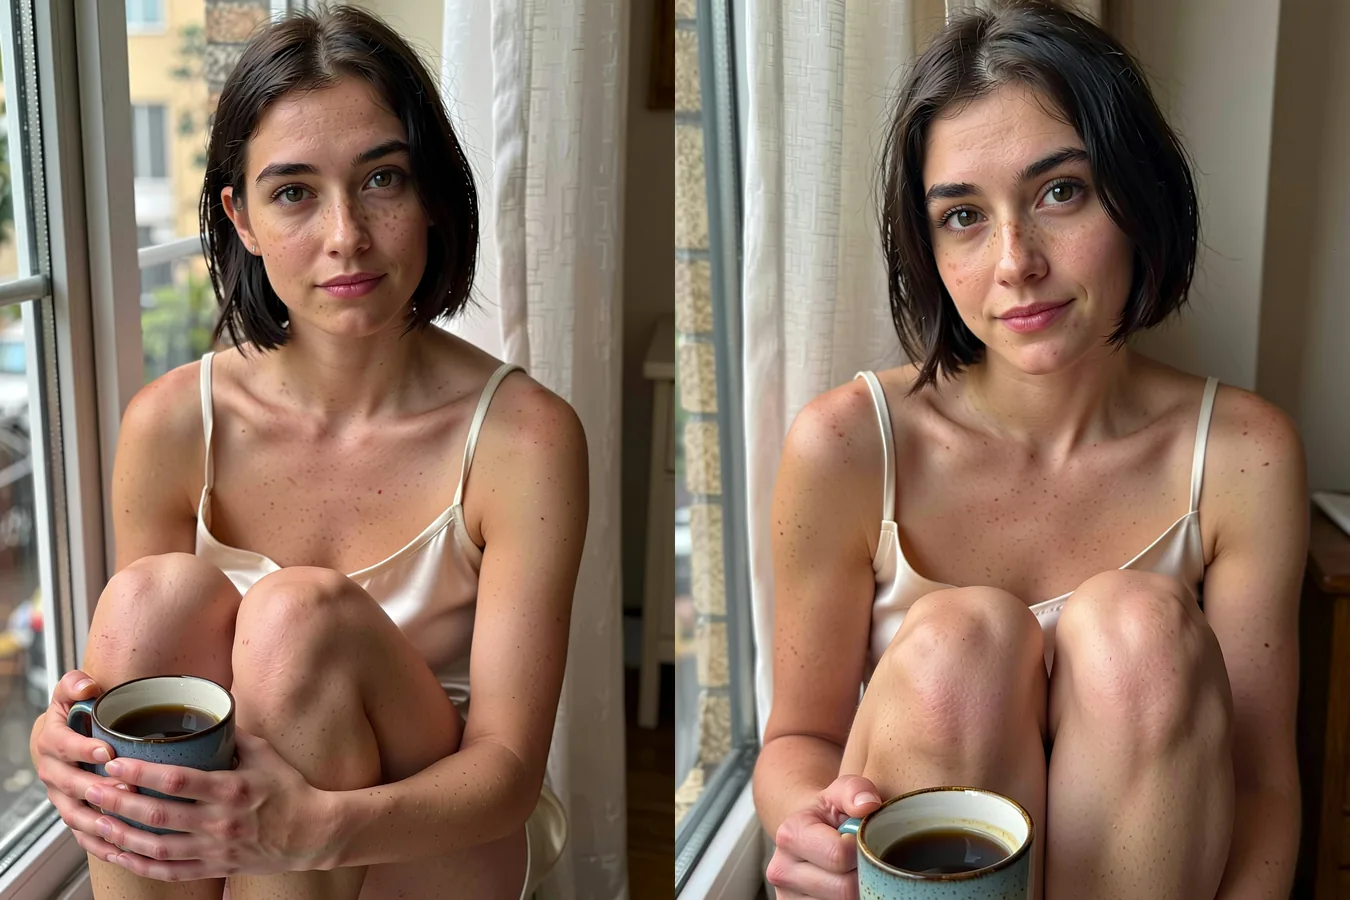
Seeds 1 y 2 de una versión de este prompt que pedía una mujer japonesa. Mira la sección de rostros más abajo. 3:4, texto a imagen.
Hábitos que ayudaron en nuestras ejecuciones:
- Abre con una pista fotográfica. "Photorealistic photo, natural skin texture", "35mm film look" o "phone photo with flash" orientan el aspecto.
- Describe a la persona, no una nacionalidad. La edad, el largo y color del pelo, las pecas, una barba y la expresión cambiaron los rostros de forma fiable. Una nacionalidad no.
- Cita palabras cortas. Nuestro prompt de la pizarra pedía un cartel que dijera "OPEN LATE" en letras de tiza blanca. La pizarra volvió con esas palabras en ambos seeds. Mantén una frase corta y revisa las letras.
- Fija el seed y cambia una sola cosa. La luz, la ropa o la sensación del lente, de una en una. Los seeds hacen que las ejecuciones sean comparables, pero no prometen píxeles idénticos.
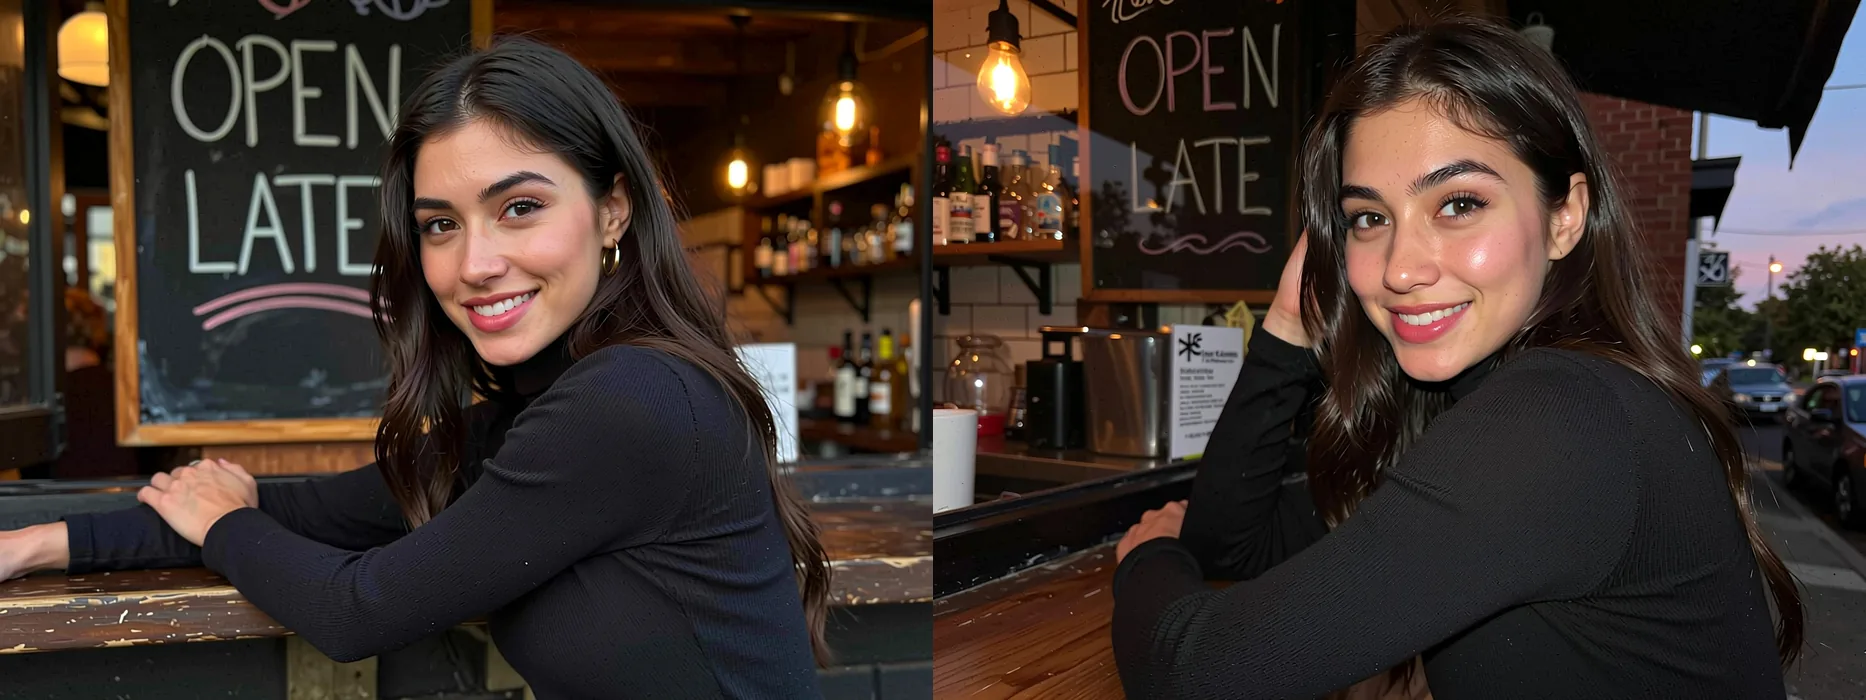
Seeds 1 y 2 del prompt de la pizarra (aquí pidiendo una mujer coreana), 4:3. El cartel dice "OPEN LATE" en ambos.
Relaciones de aspecto y tamaños
No hay un campo de tamaño. Eliges una de nueve relaciones de aspecto, cada una asignada a un tamaño fijo. Corrimos cada relación una vez en ambos endpoints, y todas las salidas volvieron exactamente con los píxeles pedidos. El lado largo se detiene en 1536.
| Relación | Tamaño | Relación | Tamaño |
|---|---|---|---|
| 1:1 | 1328 x 1328 | 21:9 | 1536 x 656 |
| 4:3 | 1472 x 1104 | 9:21 | 656 x 1536 |
| 3:4 | 1104 x 1472 | 16:9 | 1536 x 864 |
| 3:2 | 1536 x 1024 | 9:16 | 864 x 1536 |
| 2:3 | 1024 x 1536 |
Elige según el trabajo. 3:4 y 2:3 van bien para retratos; 16:9 y 21:9, para fotogramas de película y banners. Un retrato cercano en 2:3 se ve así:
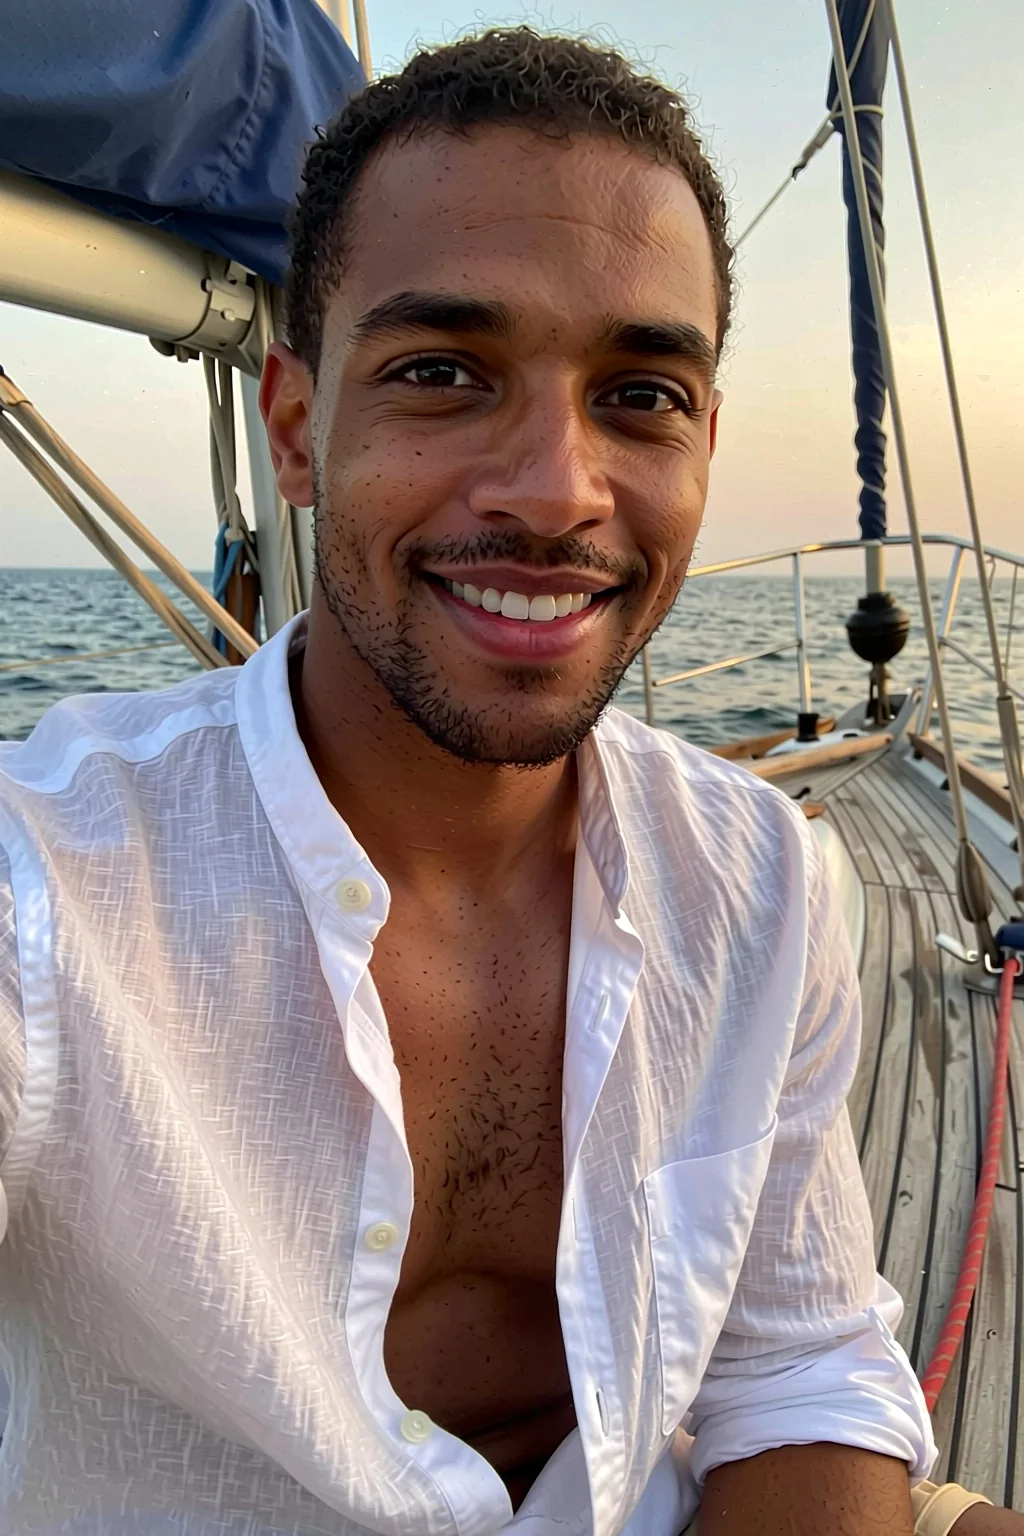
Ejemplo publicado: un hombre de 35 años en un velero a la hora dorada, 2:3, seed 1.
Photorealistic photo, natural skin texture. A 35-year-old Black man with a trimmed beard and a warm smile, open white linen shirt, sits on the deck of a sailboat at golden hour. Sea spray, wind in his shirt, shallow depth of field.Velocidad
El tiempo del modelo del endpoint base fue de 3.7 a 48 segundos en 30 ejecuciones, con una mediana de 5.8 segundos y 21 de 30 por debajo de diez. La versión con LoRA fue casi igual: de 3.2 a 36 segundos en 38 ejecuciones, mediana de 5.6, y una solicitud que cargaba un archivo LoRA por primera vez tardó de 10 a 25 segundos. Es lo bastante rápido para iterar sobre un retrato.
Dos personas en un cuadro
Las escenas con dos personas vestidas funcionaron. Este prompt de fotograma de película dibujó a una pareja riendo bajo un mismo paraguas en ambos seeds, cada persona con su propio abrigo y su lugar en el cuadro:
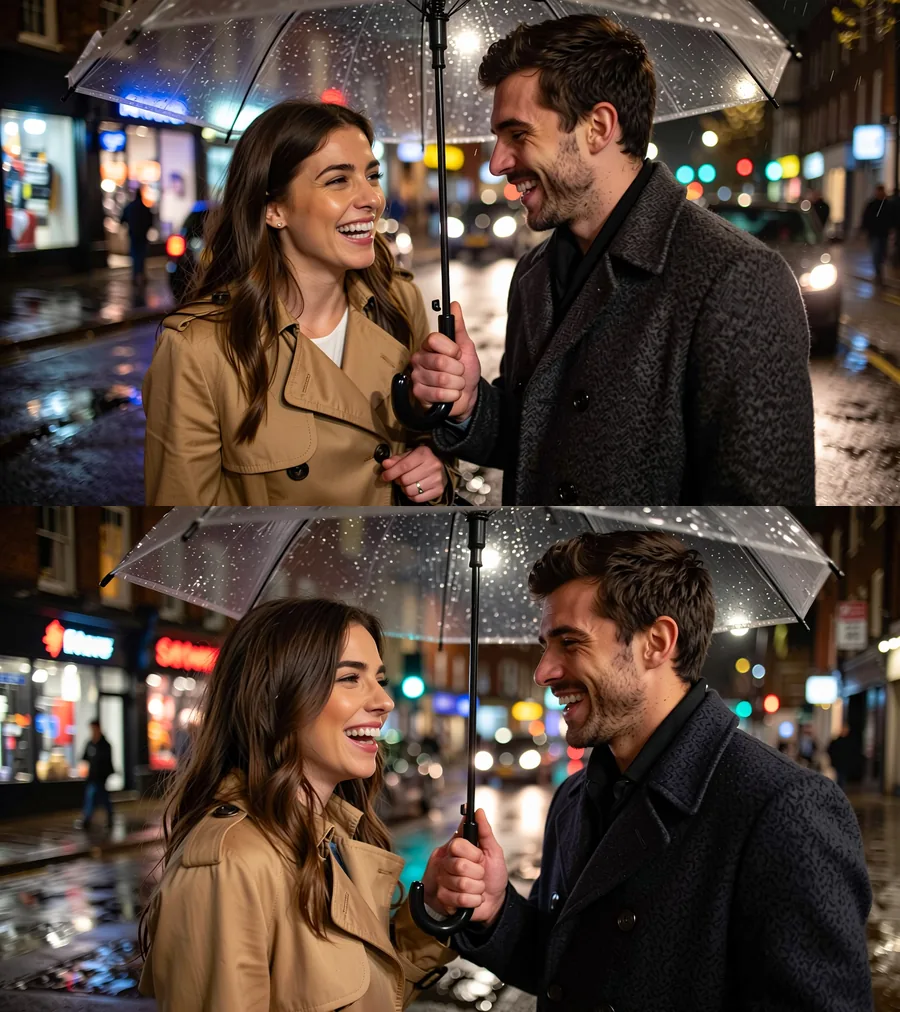
Seeds 1 y 2 del prompt del paraguas, 16:9, apilados. El modelo dio a cada persona un abrigo distinto y conservó el bokeh.
Photorealistic film still. A woman and a man in their early thirties laugh together under one clear umbrella on a rainy city street at night, she in a camel trench coat, he in a dark wool coat. Shop lights blur into colorful bokeh and reflect on the wet asphalt.Dale a cada persona un lugar claro en el cuadro y un atuendo para cada una. Cuando las manos o las extremidades se fusionan, vuelve a generar con otro seed.
Hasta dónde llega
La plataforma no agrega ningún filtro de contenido. Corrimos un prompt por peldaño de nuestra escala de cinco niveles en 3:4, seed 1, con los personajes indicados como adultos, y revisamos todas las imágenes.
| Nivel | Resultado en el endpoint base |
|---|---|
| L1 Sugerente (lencería, un tirante que se desliza) | Entregado |
| L2 Temas maduros | Entregado, y en las nueve relaciones (9 de 9) en ambos endpoints |
| L3 Fuerte, femenina y masculina | Entregado |
| L4 Intenso (una escena íntima entre dos adultos) | Suavizado: tres seeds dibujaron a dos adultos, pero la anatomía estaba confusa y solo uno de los tres se leía como la escena que pedimos |
| L5 Extremo (ataduras consentidas entre adultos; gore cinematográfico) | Ambos entregados |
No hubo ningún rechazo en ninguna parte. L4 es el hallazgo honesto: el modelo no lo rechaza, simplemente no puede dibujarlo con limpieza. Agregar un LoRA de Qwen-Image para adultos cambió la composición a una pareja posando y aun así no produjo la escena. Así que el límite práctico es este: el contenido de un solo sujeto volvió como se pidió, y las escenas de dos personas se dibujaron sin rechazo pero con una anatomía menos precisa. Si tu trabajo depende de L4, prueba primero la ruta exacta y compárala con Qwen Image 2512 LoRA, más abajo.
El problema de los rostros
Pedimos dos veces una "32-year-old Japanese woman", dos veces una "woman with East Asian features" y dos veces una "30-year-old Korean woman". Los seis rostros salieron europeos o ambiguos.
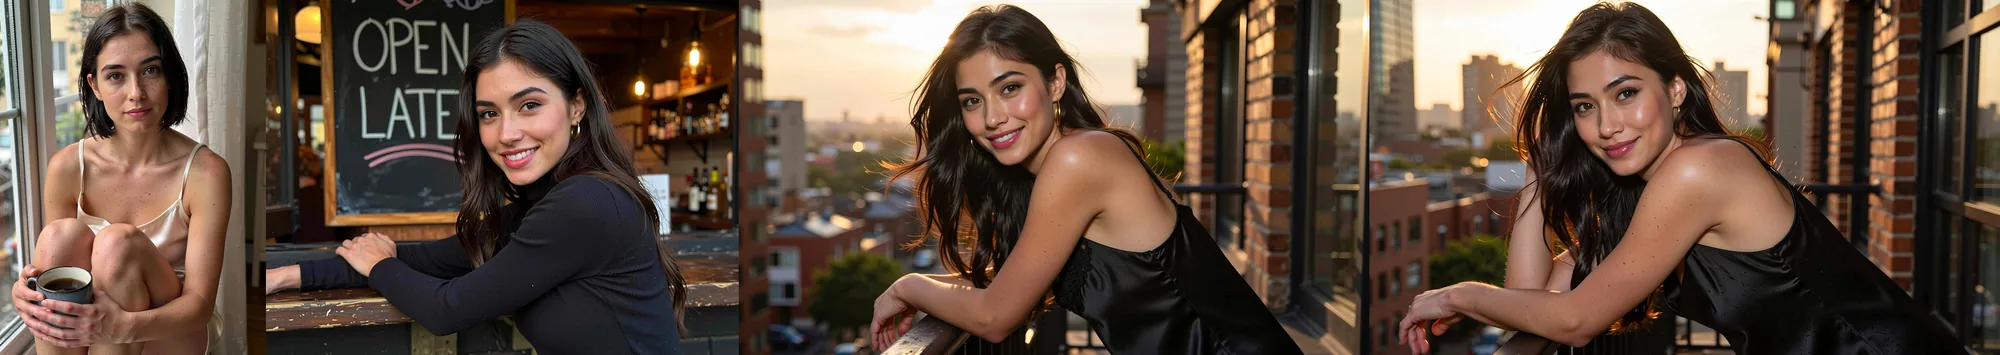
De izquierda a derecha: "Japanese woman" seed 1 (3:4), "Korean woman" seed 1 (4:3), "East Asian features" seeds 1 y 2 (16:9).
Muchos seeds también se asientan en un mismo rostro de pelo oscuro, el hábito de la "misma cara" que los usuarios de Civitai reportan en las primeras versiones. No elijas este modelo si necesitas rostros de Asia oriental marcados. Si te quedas con él, varía explícitamente la edad, el pelo, las pecas, una barba y la expresión, y no dependas de una palabra de nacionalidad. Los ejemplos publicados en la página del modelo se escribieron sin nacionalidad.
Qué LoRA lo cambian
La versión con LoRA admite hasta tres LoRA por solicitud, cada uno un enlace directo a un archivo .safetensors con un scale de 0 a 4. Sin ningún LoRA cargado dio una salida idéntica píxel por píxel a la del endpoint base con el mismo seed en nuestras comprobaciones, así que usa el endpoint base a menos que planees cargar uno. Un enlace a la página web de un repositorio falla con un mensaje que pide el enlace de descarga directa, y un repositorio restringido falla con un error HTTP 401.
Los LoRA de Qwen-Image se cargan, desde Hugging Face o desde un enlace directo de Civitai, y los LoRA de Qwen-Image-2512 también. Lo que le hacen a la imagen depende del tipo.
Los LoRA de foto y de cámara se notan. Con un mismo prompt y seed, cuatro LoRA fotográficos cambiaron cada uno el rostro y la luz de forma visible pero no drástica.
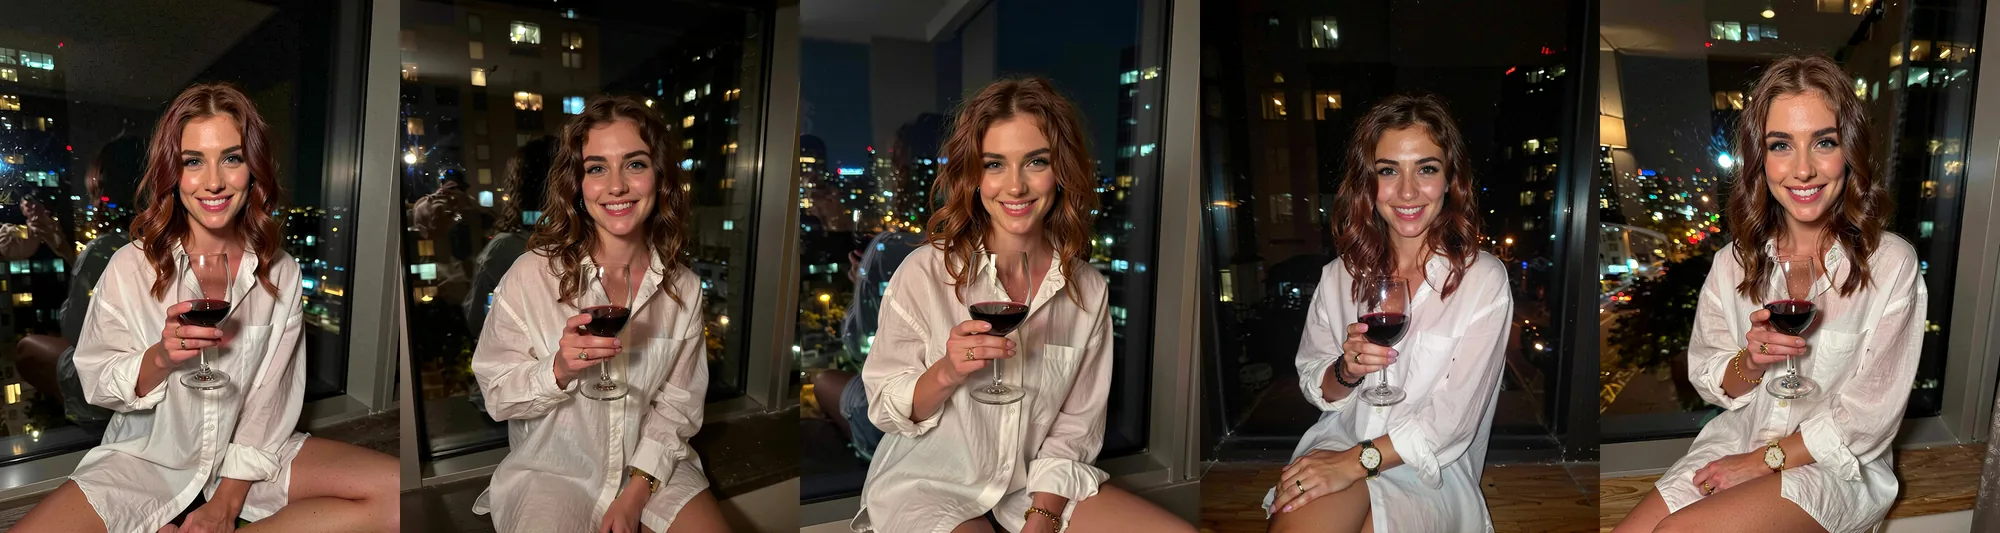
De izquierda a derecha: sin LoRA; un LoRA de cámara de teléfono (Samsung UltraReal); un LoRA de retoque de retrato (AWPortrait-QW); un LoRA de foto con flash (Lenovo); un LoRA de realismo (flymy-ai). Mismo prompt, seed 21, 3:4, todos a escala 1.
| Tipo de LoRA | Qué vimos | Veredicto |
|---|---|---|
| Cámara de teléfono (Samsung UltraReal) | Pelo más rizado, luz más dura, aire de instantánea | Visible |
| Retoque de retrato (AWPortrait-QW) | Un aspecto de retrato más retocado | Visible, sutil |
| Foto con flash (Lenovo) | Cuadro más oscuro, iluminado con flash | Visible |
| Realismo (flymy-ai) | Cambiaron el rostro y la luz | Visible, sutil |
| Dos combinados (Samsung 0.8 más AWPortrait 0.6) | Funcionó | Dos LoRA en una solicitud |
Dos ejemplos publicados muestran los LoRA de cámara y de retoque en acción:
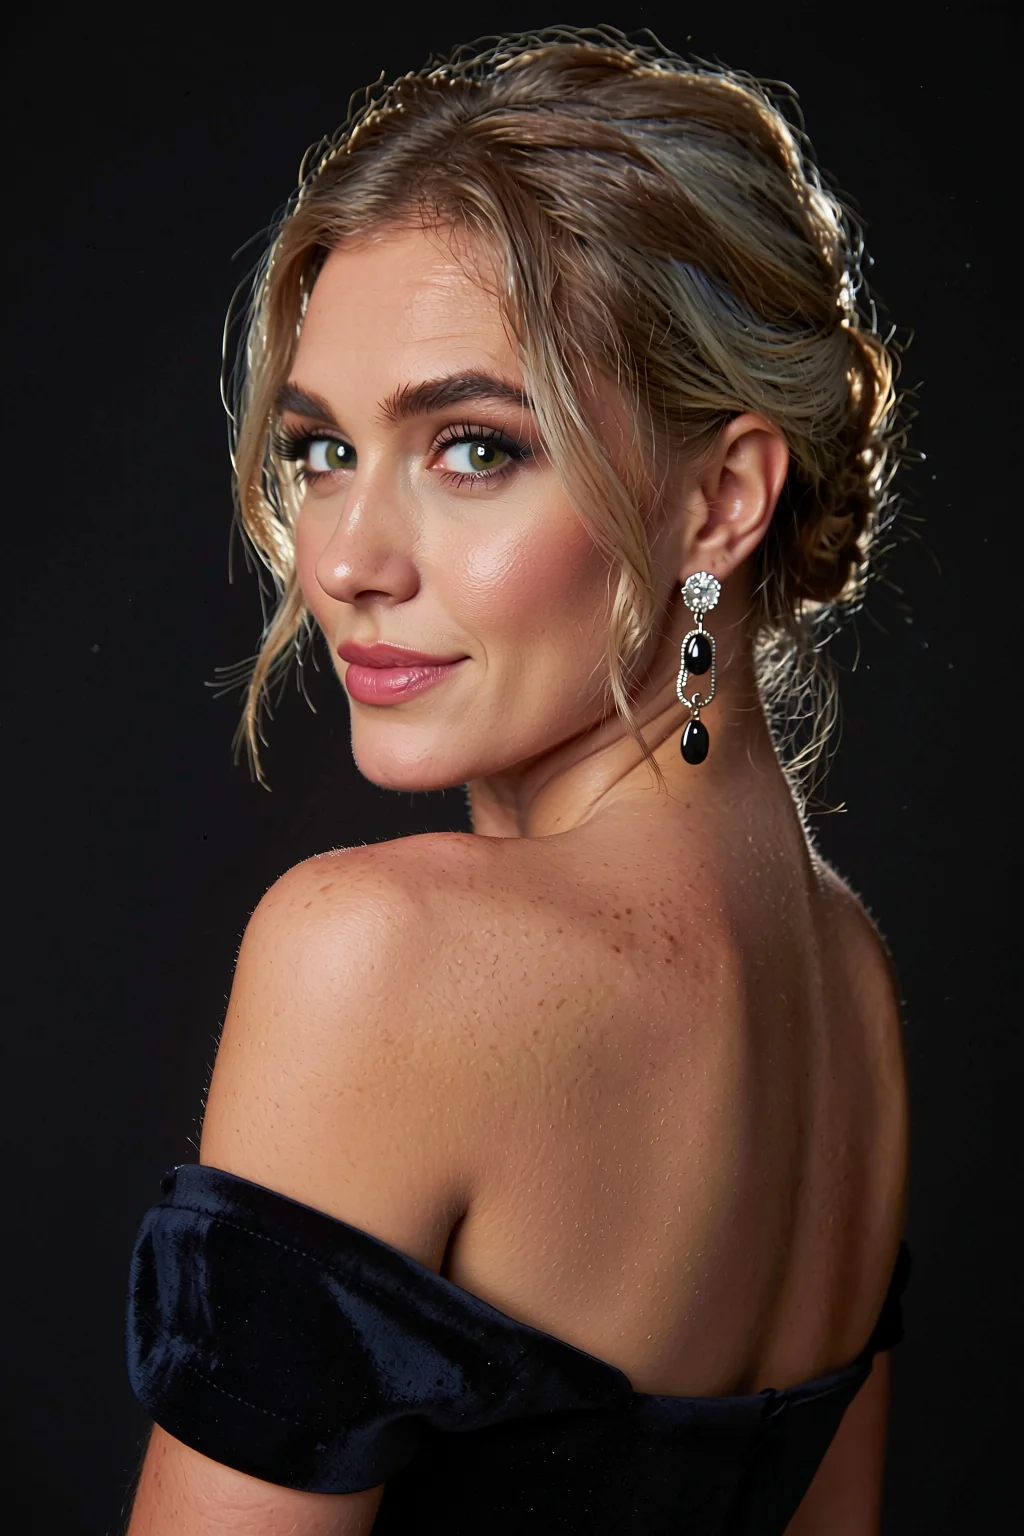
LoRA de retoque de retrato a escala 1, 2:3, seed 1.
Studio portrait photo. A 36-year-old woman with silver-blonde hair pinned up wears an off-shoulder black velvet gown and long earrings, looking over her bare shoulder at the camera. Soft key light, dark backdrop, rim light on her hair.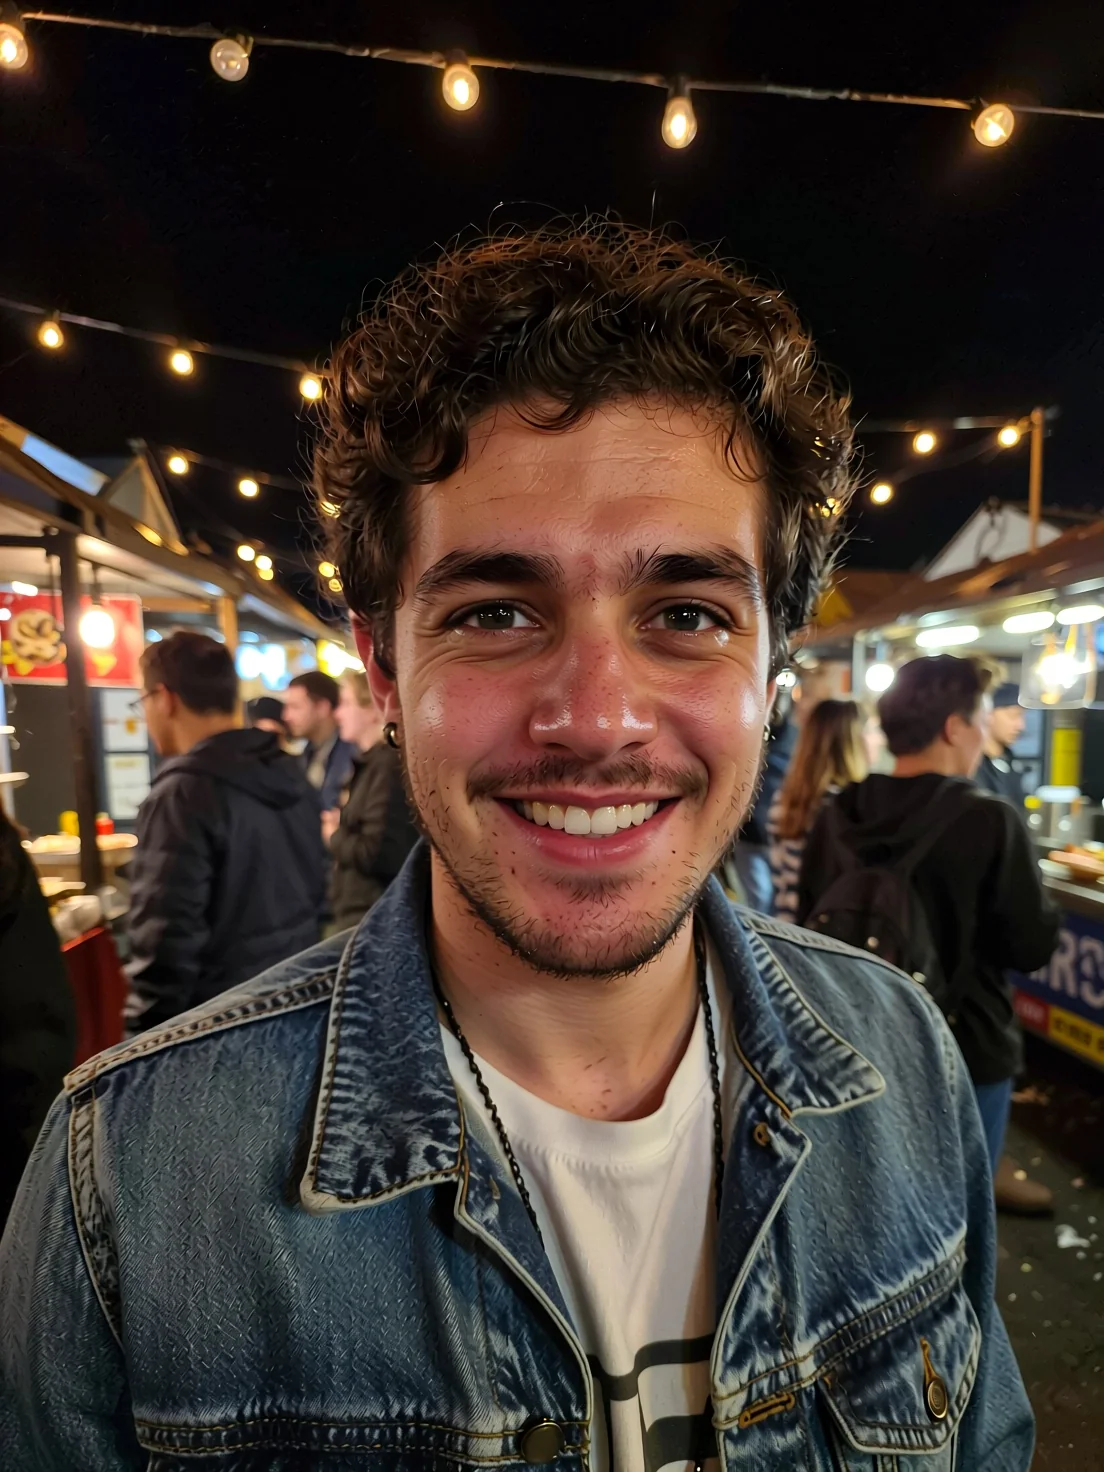
LoRA de cámara de teléfono a escala 1, 3:4, seed 1. Prompt: "Amateur phone photo with on-camera flash. A 31-year-old man with curly dark hair and a short beard in a denim jacket over a white T-shirt grins at the camera at a crowded night market, string lights and food stalls behind him."
Los LoRA de estilo apenas lo mueven. Pedimos un retrato en estilo "Japanese modern anime style". El checkpoint base ignoró la frase, y también lo hizo un LoRA de anime de Qwen-Image a escala 0.5, 1 y 2: los píxeles cambiaron, pero la imagen siguió siendo una fotografía. A escala 4 la imagen se rompió en un primer plano distorsionado con ojos desproporcionados. Un LoRA de pixel art de Qwen-Image-2512 cambió píxeles y no produjo ningún aspecto de pixel art.
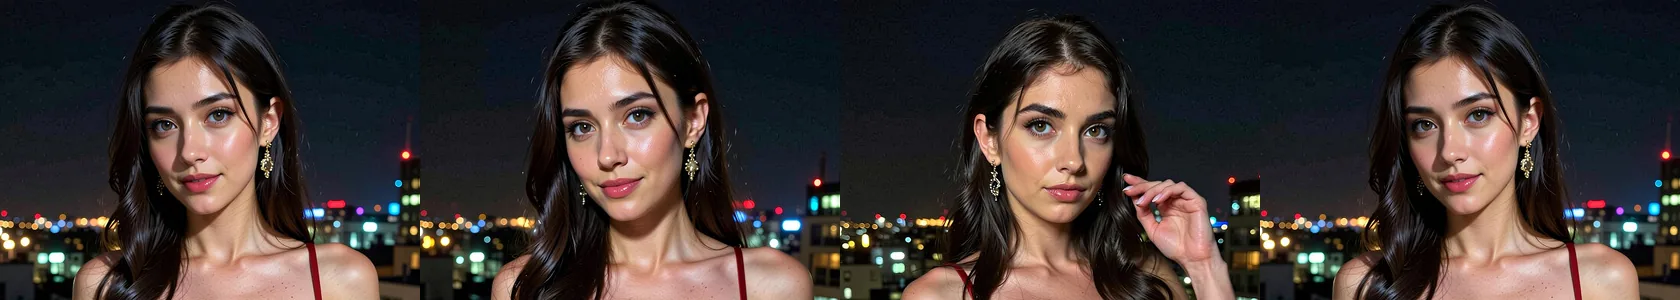
Recortes de rostro, de izquierda a derecha: sin LoRA; un LoRA de anime a 0.5; el mismo a 1; un LoRA de FLUX a 1. Mismo prompt, seed 11, 3:4. Las cuatro siguen siendo fotografías.
Un LoRA de otra base no hace nada. Un LoRA de FLUX se cargó sin error y dio una salida idéntica píxel por píxel a no usar ningún LoRA. Una respuesta exitosa no significa que el archivo correspondiera al modelo.
El rango útil de escala fue de alrededor de 0.5 a 1.5. Dos LoRA combinados funcionaron bien:
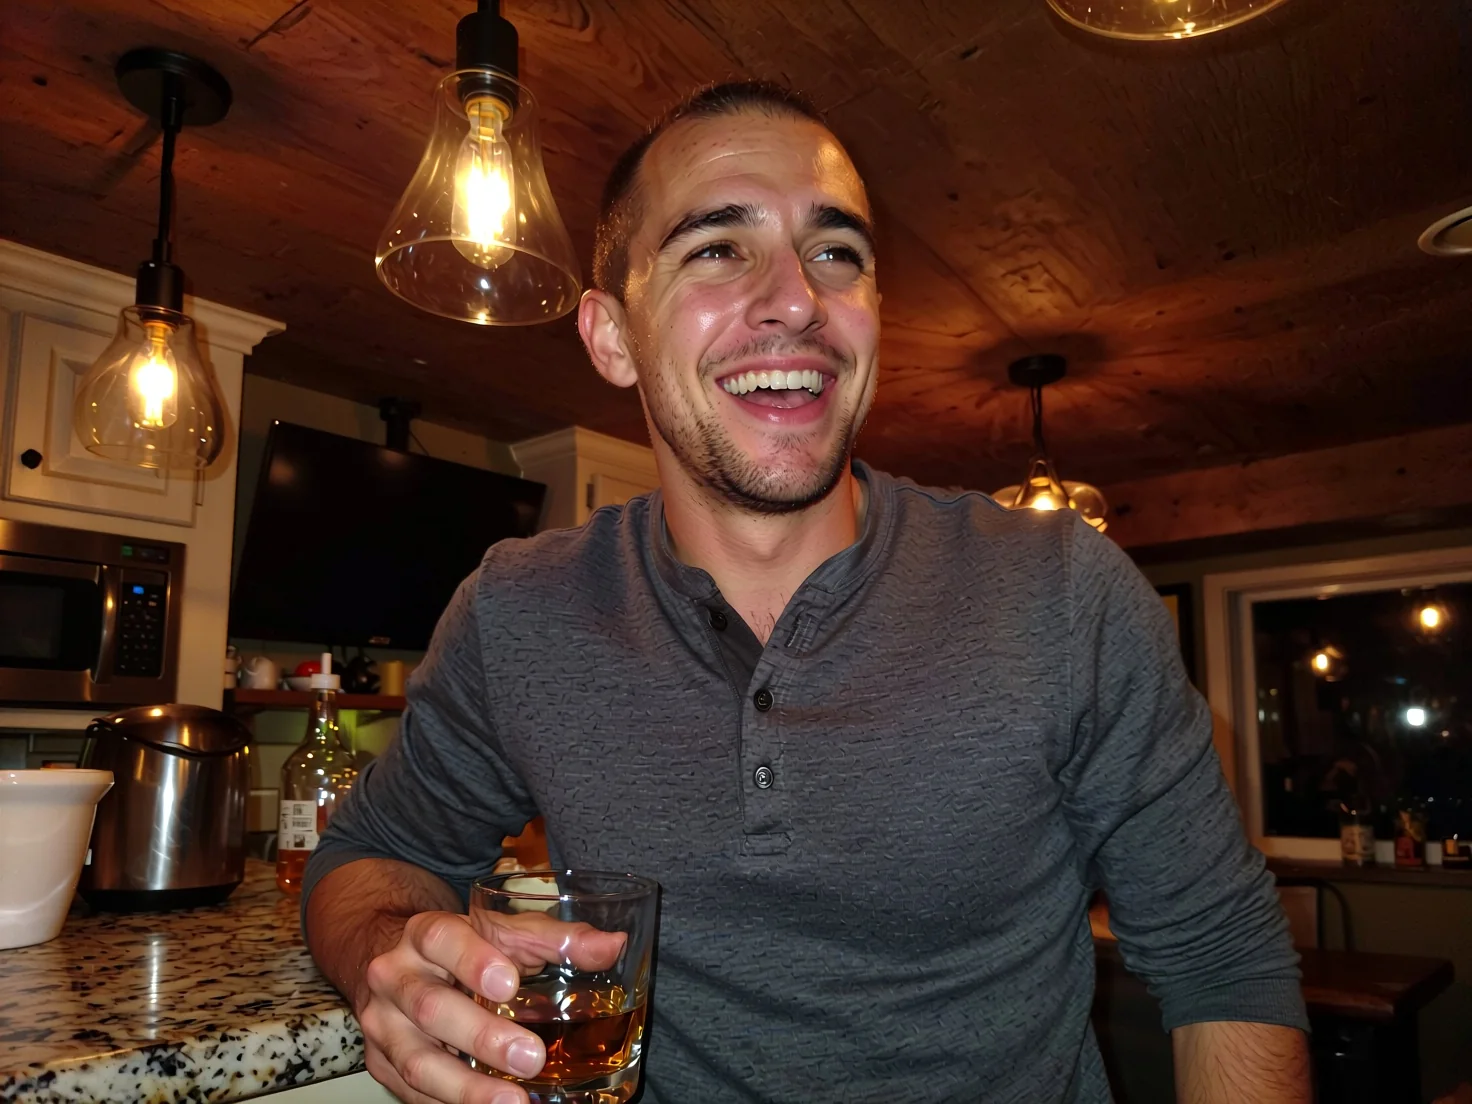
LoRA de cámara Samsung a 0.8 más AWPortrait a 0.6, 4:3, seed 1.
Jib Mix Qwen o Qwen Image 2512 LoRA
Ambos son modelos de la familia Qwen-Image con hasta tres LoRA en la ruta de LoRA. Son buenos en trabajos distintos.
| Jib Mix Qwen (y versión con LoRA) | Qwen Image 2512 LoRA | |
|---|---|---|
| Base | Mezcla de la comunidad sobre Qwen-Image | Qwen-Image-2512 para generar, Qwen-Image-Edit-2511 para editar |
| Tareas | Solo texto a imagen | Texto a imagen y edición con 1 a 3 imágenes de origen |
| LoRA | Solo en la versión con LoRA, hasta 3 | Hasta 3 en ambas tareas |
| Aspecto de fábrica | Retratos fotográficos, piel natural | Uso general; los adaptadores definen el estilo |
| Velocidad en nuestras pruebas | Mediana de 5.8 s (base) | No se midió en esta ronda |
| Relaciones de aspecto | 9, hasta 1536 px | 9 para generar, hasta 1536 px; la edición sigue la primera imagen de origen |
| Contenido en nuestras pruebas | La escala se entregó salvo L4, suavizado | Una ejecución de la escala del 27 de septiembre entregó 15 de 18 encargos en cada ruta; los tres fallos fueron de la misma clase de escena íntima, que un LoRA externo para adultos cumplió en cada tarea el 26 de septiembre |
Nuestra regla práctica: elige Jib Mix Qwen cuando quieras un retrato fotográfico listo sin buscar LoRA y aceptes el límite de los rostros. Elige Qwen Image 2512 LoRA cuando necesites edición, cuando ya tengas un LoRA para la base 2512 o cuando quieras que la base tome su aspecto de tu adaptador. Nuestra guía para hacer coincidir los pesos con la tarea explica la división entre 2512 y Edit 2511, y el resumen de LoRA alojados compara el panorama más amplio.
Límites
- Rostros. Las solicitudes de rostros de Asia oriental volvieron europeas o ambiguas en los seis intentos, y muchos seeds convergen en un rostro parecido.
- Rango de estilos. Los prompts y LoRA de anime y de pixel art dejaron fotografías. Usa un modelo de ilustración para un aspecto dibujado.
- Escenas íntimas de dos personas. Se dibujan sin rechazo, con una anatomía menos precisa.
- Sin prompt negativo, pasos ni guidance, sin imagen de entrada, sin edición.
- Una imagen por solicitud.
- Versión desconocida. La ruta alojada no dice qué versión de Jib Mix Qwen ejecuta.
Preguntas frecuentes
¿Jib Mix Qwen no tiene censura?
Sí. La plataforma no agrega ningún filtro de contenido. El contenido de un solo sujeto volvió como se pidió en nuestra escala, y las escenas de dos personas se dibujaron sin rechazo pero con una anatomía menos precisa.
¿Puede hacer rostros de Asia oriental?
No de forma fiable. Seis solicitudes de mujeres japonesas, coreanas o de Asia oriental volvieron todas con aspecto europeo o ambiguo. Varía la edad, el pelo y los rasgos en lugar de usar una nacionalidad.
¿Funcionan los LoRA de estilo?
Apenas. Un LoRA de anime a 0.5, 1 y 2 dejó la imagen como una fotografía, y a 4 la imagen se rompió. Los LoRA de foto, de cámara y de retrato son los que se notan.
¿Qué escala debo usar para un LoRA?
Empieza en 1 y mantente entre 0.5 y 1.5 aproximadamente. La escala 4, el máximo, rompió la imagen en nuestra prueba.
¿Funciona un LoRA de otro modelo base?
No. Un LoRA de FLUX se cargó sin error y no cambió nada. Usa LoRA entrenados para Qwen-Image o Qwen-Image-2512.
¿Debo usar el endpoint base o el de LoRA?
El endpoint base si no vas a cargar un LoRA. Sin LoRA, la versión con LoRA dio una salida idéntica píxel por píxel a la base con el mismo seed en nuestras comprobaciones.
¿Puede generar texto dentro de la imagen?
Palabras cortas, sí. Nuestro "OPEN LATE" de la pizarra se leyó correctamente en ambos seeds. Mantén la frase corta y revisa las letras antes de publicar.
¿Puedo editar una foto existente con él?
No. Ambos endpoints son de texto a imagen. Para editar con imágenes de origen, usa Qwen Image 2512 LoRA.