Jib Mix Qwen ist ein schnelles fotorealistisches Porträtmodell: In unseren Tests brauchte ein Bild im Median 5,8 Sekunden, und Foto- und Kamera-LoRAs veränderten seinen Look, während Stil-LoRAs kaum etwas bewirkten. Es hat zwei Schwachstellen, die Sie kennen sollten, bevor Sie darauf aufbauen. Sechs Anfragen nach einer japanischen, koreanischen oder ostasiatischen Frau kamen alle europäisch oder uneindeutig zurück, und intime Szenen mit zwei Personen wurden ohne Ablehnung gezeichnet, aber mit verworrener Anatomie.
Wir haben am 5. Oktober 2026 sowohl Jib Mix Qwen als auch seinen LoRA-Build getestet. Jib Mix ist eine Community-Checkpoint-Reihe des Creators J1B, und dieser hier ist ein Merge aus Qwen-Image-Fine-Tunes und LoRAs auf Basis von Alibabas Qwen-Image mit 20 Milliarden Parametern. Jeder unten abgedruckte Prompt ist eine Alltagsszene mit bekleideten Erwachsenen.
Auf einen Blick
| Jib Mix Qwen und Jib Mix Qwen LoRA (getestet am 5. Oktober 2026) | |
|---|---|
| Creator und Basis | J1B; ein Merge aus Qwen-Image-Fine-Tunes und LoRAs auf Qwen-Image (20B, Qwen2.5-VL-Textencoder) |
| API-Modellnamen | j1b/jib-mix-qwen-image/text-to-image und j1b/jib-mix-qwen-image-lora/text-to-image |
| Öffentliche Felder | prompt (bis 5.000 Zeichen), aspect_ratio, output_format, seed; der LoRA-Build ergänzt loras |
| Seitenverhältnisse | 9, bis 1536 Pixel auf der langen Seite: 1328 x 1328 bei 1:1, 1536 x 864 bei 16:9 |
| Ausgabe | Ein Bild pro Anfrage als JPEG (Standard), PNG oder WebP |
| Tempo in unseren Tests | Basis: 3,7 bis 48 Sekunden über 30 Läufe, Median 5,8, 21 von 30 unter 10. LoRA-Build: 3,2 bis 36 Sekunden über 38 Läufe, Median 5,6 |
| Inhaltsrichtlinie | Unzensiert, kein Content-Filter; Inhalte mit einer einzelnen Person kamen wie verlangt zurück, Zweierszenen wurden ohne Ablehnung, aber weniger präzise gezeichnet |
| Kann nicht | Negative Prompts, Schritte, Guidance, Bildeingabe, Bearbeiten, mehr als ein Bild pro Anfrage |
Was es ist, und welche Version
Die Notizen des Creators zur ersten Version besagen, dass es Qwen-Modelle mit Lieblings-LoRAs in präzisen Gewichtungen zusammenführt. Die Seite auf Civitai listet sechs Versionen zwischen September 2025 und März 2026. Die Notiz zu v4.0 vom 15. Oktober 2025 sagt "much more natural pretty faces (much better at Asian faces)". Die Notiz zu v6.0 vom März 2026 sagt "more European faces and fewer Asian by default" und "not quite as good at NSFW as V5".
Die gehostete Route nennt nicht, welche Version sie betreibt. Ihre Beschreibung greift die Notiz zu v4.0 auf, aber unsere Ausgaben tendieren zu europäischen Gesichtern, was zu v6 passt, und die Route wurde kürzlich aktualisiert, sodass wir einen Wechsel nicht ausschließen können. Wir kennzeichnen das als nicht verifiziert, statt zu raten. Was wir berichten können, ist, was die Route tut, und das ist der Rest dieses Artikels.
Prompts für Porträts
Das Modell mag ein Briefing eines Fotografen in vollständigen Sätzen. Das Fensterporträt unten nutzte Alter, Haar, Sommersprossen, Kleidung, Pose und Licht, mit einer kurzen fotografischen Einleitung:
Photorealistic photo, natural skin texture. A 32-year-old woman with a short black bob, light freckles and minimal makeup sits on a windowsill in a cream silk camisole, knees drawn up, holding a mug of coffee. Soft morning light, sheer curtains, shallow depth of field.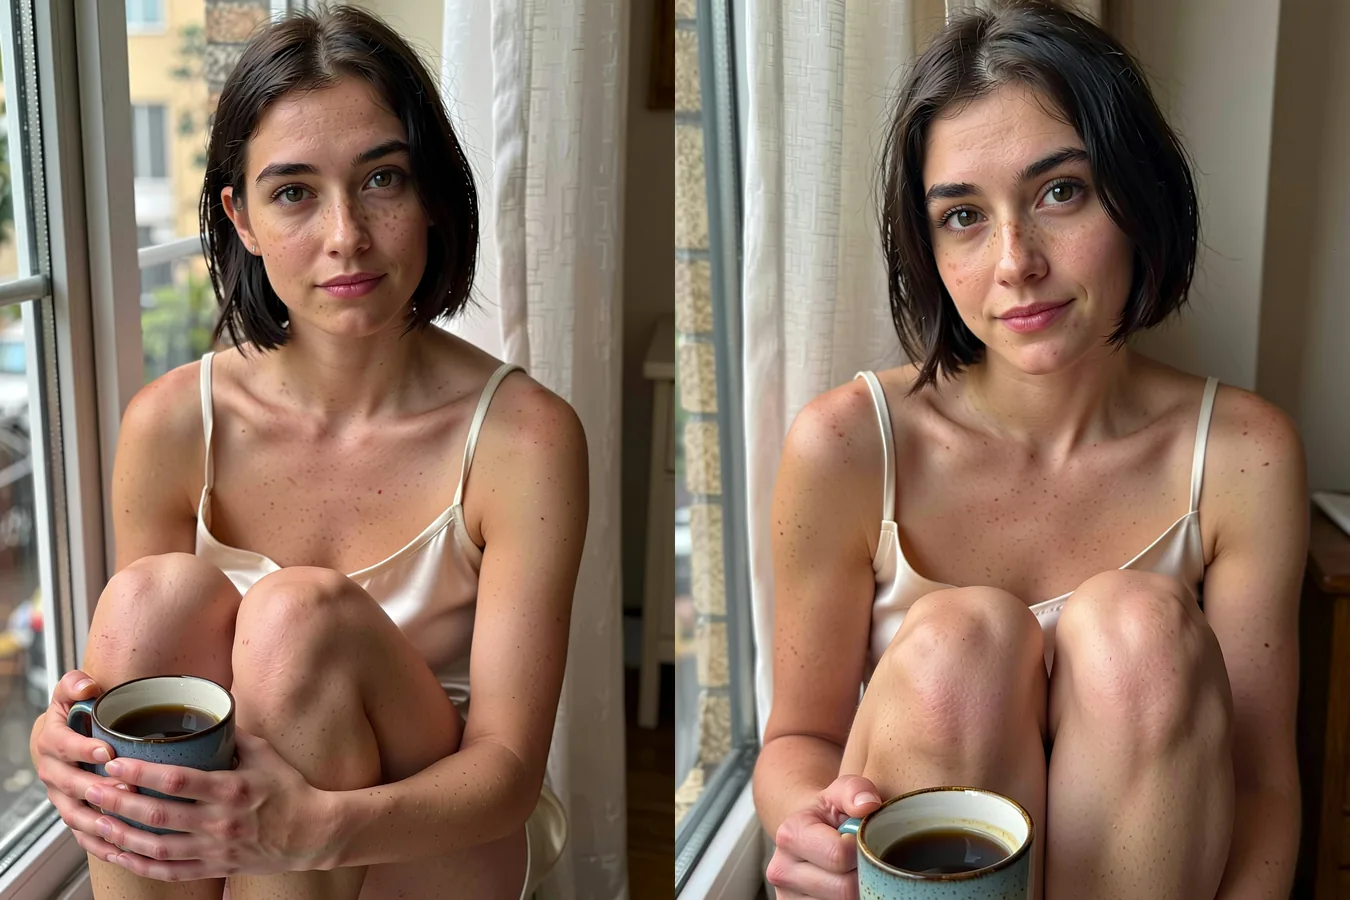
Seeds 1 und 2 einer Variante dieses Prompts, die nach einer Japanerin fragte. Siehe den Abschnitt zu Gesichtern unten. 3:4, Text-zu-Bild.
Gewohnheiten, die in unseren Läufen halfen:
- Beginnen Sie mit einem fotografischen Hinweis. "Photorealistic photo, natural skin texture" oder "35mm film look" oder "phone photo with flash" steuert den Look.
- Beschreiben Sie die Person, nicht eine Nationalität. Alter, Haarlänge und -farbe, Sommersprossen, ein Bart und der Ausdruck veränderten Gesichter zuverlässig. Eine Nationalität nicht.
- Setzen Sie kurze Wörter in Anführungszeichen. Unser Kreidetafel-Prompt verlangte ein Schild mit "OPEN LATE" in weißen Kreidebuchstaben. Die Tafel kam in beiden Seeds mit diesen Worten zurück. Beschränken Sie sich auf eine kurze Wendung und prüfen Sie die Beschriftung.
- Fixieren Sie den Seed und ändern Sie eine Sache. Licht, Kleidung oder Objektivgefühl, jeweils eines. Seeds machen Läufe vergleichbar, sind aber kein Versprechen identischer Pixel.
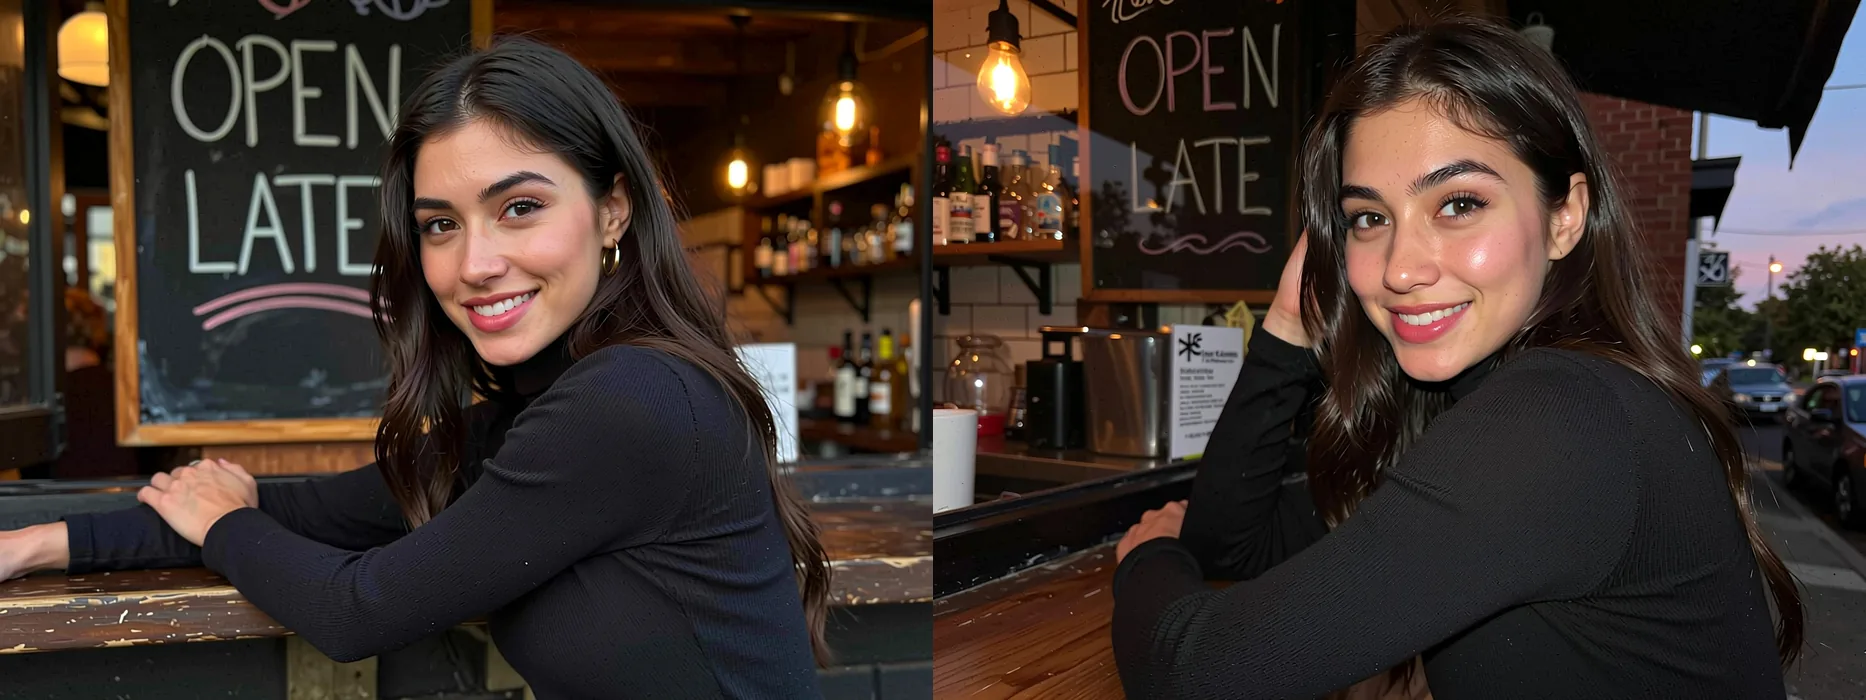
Seeds 1 und 2 des Kreidetafel-Prompts (hier mit der Bitte um eine Koreanerin), 4:3. Das Schild zeigt in beiden "OPEN LATE".
Seitenverhältnisse und Größen
Es gibt kein Größenfeld. Sie wählen eines von neun Seitenverhältnissen, jedes einer festen Größe zugeordnet. Wir haben jedes Verhältnis einmal auf beiden Endpunkten gefahren, und jede Ausgabe kam in exakt den angeforderten Pixeln zurück. Die lange Seite endet bei 1536.
| Verhältnis | Größe | Verhältnis | Größe |
|---|---|---|---|
| 1:1 | 1328 x 1328 | 21:9 | 1536 x 656 |
| 4:3 | 1472 x 1104 | 9:21 | 656 x 1536 |
| 3:4 | 1104 x 1472 | 16:9 | 1536 x 864 |
| 3:2 | 1536 x 1024 | 9:16 | 864 x 1536 |
| 2:3 | 1024 x 1536 |
Wählen Sie nach der Aufgabe. 3:4 und 2:3 eignen sich für Porträts, 16:9 und 21:9 für Filmstills und Banner. Ein enges Porträt in 2:3 sieht so aus:
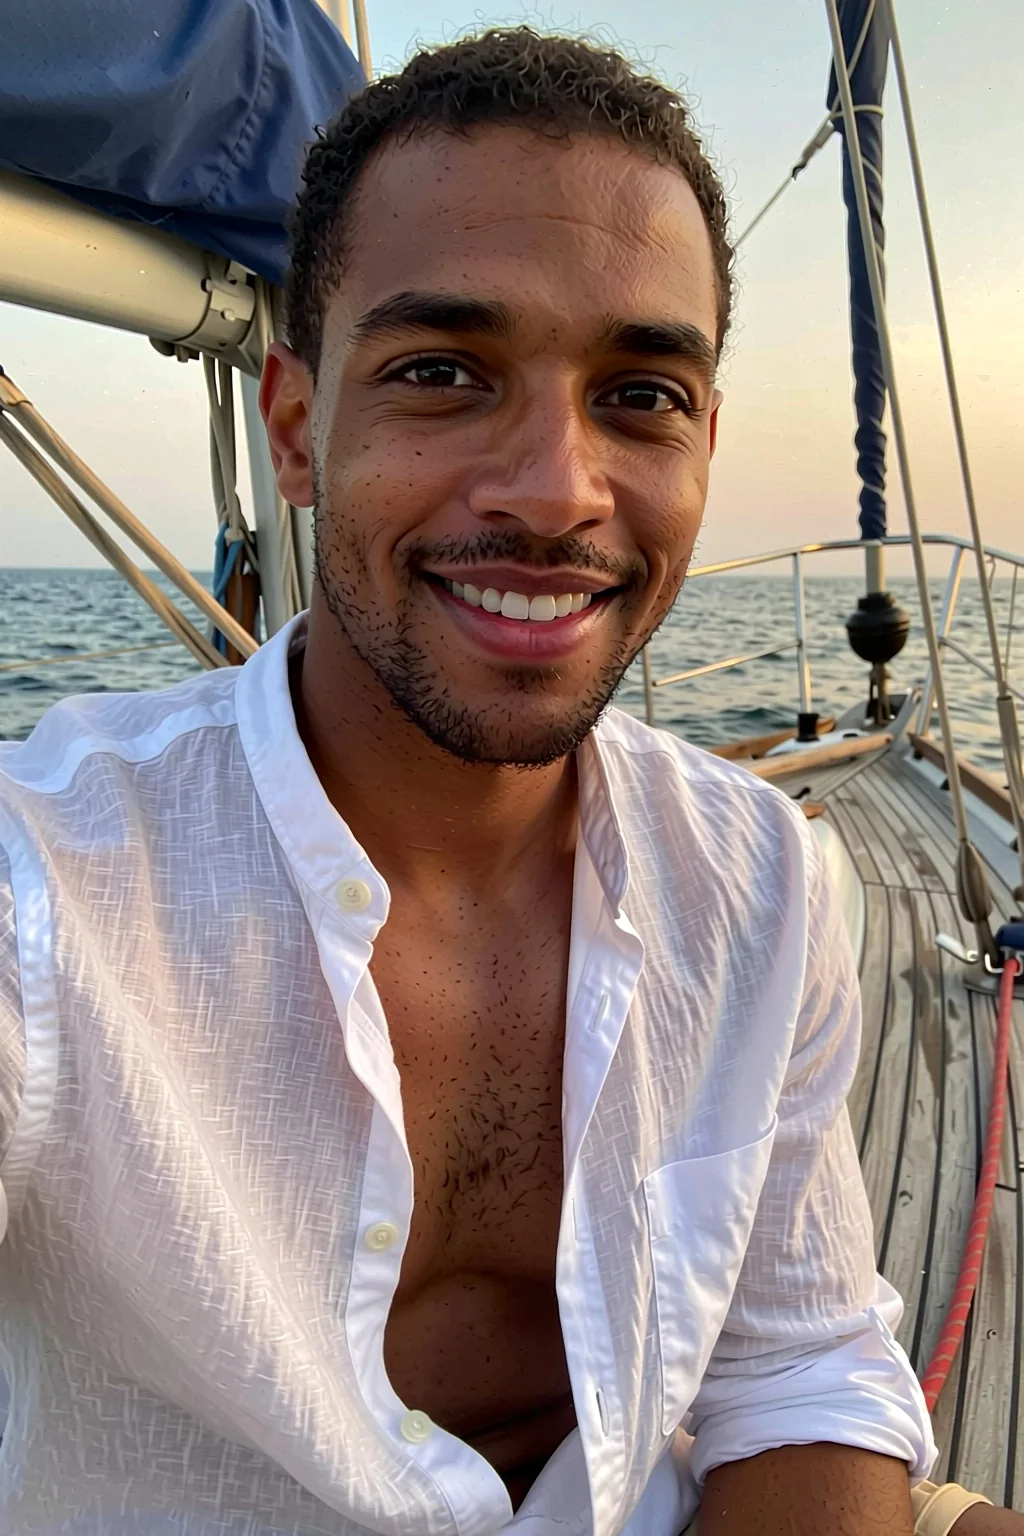
Veröffentlichtes Beispiel: ein 35-jähriger Mann auf einem Segelboot zur goldenen Stunde, 2:3, Seed 1.
Photorealistic photo, natural skin texture. A 35-year-old Black man with a trimmed beard and a warm smile, open white linen shirt, sits on the deck of a sailboat at golden hour. Sea spray, wind in his shirt, shallow depth of field.Tempo
Die Modellzeit des Basis-Endpunkts reichte über 30 Läufe von 3,7 bis 48 Sekunden, bei einem Median von 5,8 Sekunden und 21 von 30 unter zehn. Der LoRA-Build war fast gleich: 3,2 bis 36 Sekunden über 38 Läufe, Median 5,6, und eine Anfrage, die eine LoRA-Datei zum ersten Mal lud, brauchte 10 bis 25 Sekunden. Das ist schnell genug, um an einem Porträt zu iterieren.
Zwei Personen in einem Bild
Szenen mit zwei bekleideten Personen funktionierten. Dieser Filmstill-Prompt zeichnete in beiden Seeds ein lachendes Paar unter einem Regenschirm, jede Person mit eigenem Mantel und eigenem Platz im Bild:
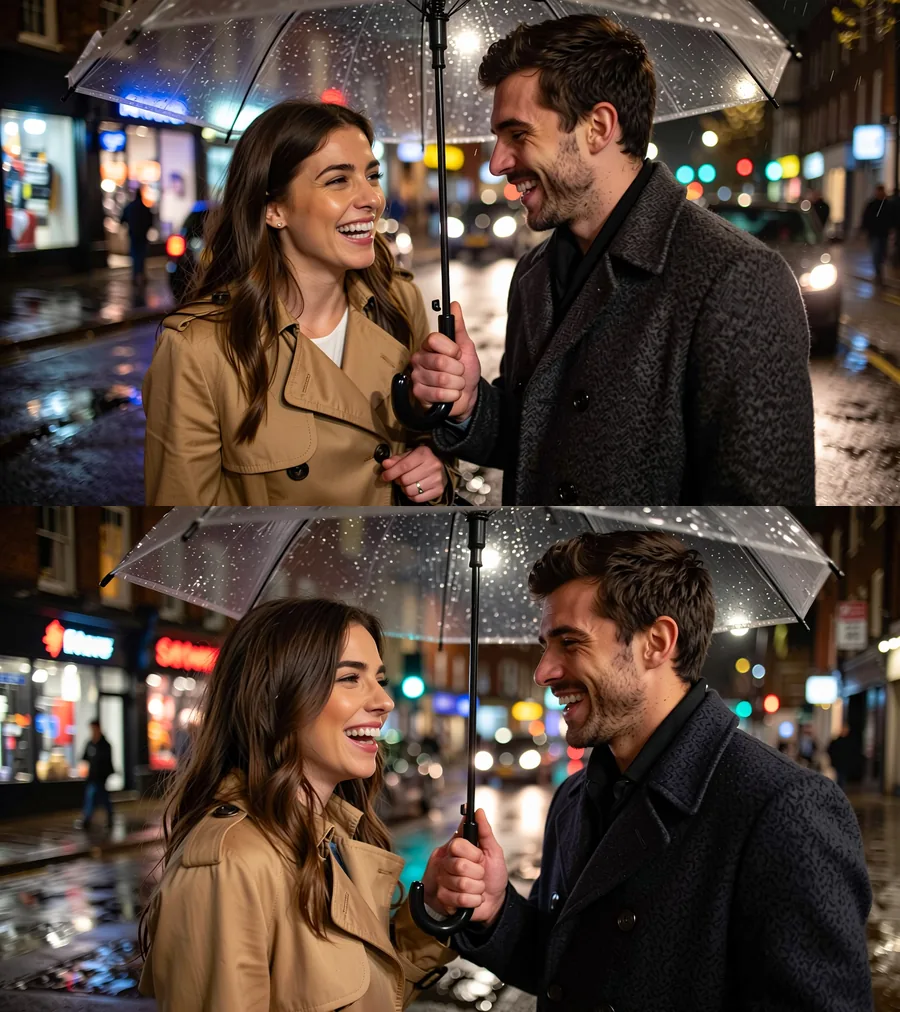
Seeds 1 und 2 des Regenschirm-Prompts, 16:9, übereinander. Das Modell gab jeder Person einen eigenen Mantel und behielt das Bokeh.
Photorealistic film still. A woman and a man in their early thirties laugh together under one clear umbrella on a rainy city street at night, she in a camel trench coat, he in a dark wool coat. Shop lights blur into colorful bokeh and reflect on the wet asphalt.Geben Sie jeder Person einen klaren Platz im Bild und je ein Outfit. Wenn Hände oder Gliedmaßen verschmelzen, würfeln Sie den Seed neu.
Wie weit es geht
Die Plattform fügt keinen Content-Filter hinzu. Wir haben pro Stufe unserer fünfstufigen Leiter einen Prompt bei 3:4, Seed 1, gefahren, wobei die Figuren als Erwachsene angegeben waren, und uns jedes Bild angesehen.
| Stufe | Ergebnis auf dem Basis-Endpunkt |
|---|---|
| L1 Andeutung (Dessous, ein rutschender Träger) | Geliefert |
| L2 Reife Themen | Geliefert, und bei allen neun Verhältnissen (9 von 9) auf beiden Endpunkten |
| L3 Stark, weiblich und männlich | Geliefert |
| L4 Intensiv (eine intime Szene zwischen zwei Erwachsenen) | Abgeschwächt: Drei Seeds zeichneten alle zwei Erwachsene, aber die Anatomie war verworren, und nur eines der drei las sich als die verlangte Szene |
| L5 Extrem (einvernehmliche Fesselung unter Erwachsenen; filmisches Gore) | Beides geliefert |
Nirgends gab es eine Ablehnung. L4 ist der ehrliche Befund: Das Modell lehnt es nicht ab, es kann es nur nicht sauber zeichnen. Eine Adult-Qwen-Image-LoRA zu ergänzen, änderte die Komposition zu einem posierten Paar und lieferte die Szene trotzdem nicht. Die praktische Grenze lautet also: Inhalte mit einer einzelnen Person kamen wie verlangt zurück, und Zweierszenen wurden ohne Ablehnung, aber mit weniger präziser Anatomie gezeichnet. Wenn Ihre Arbeit von L4 abhängt, testen Sie zuerst genau diese Route und vergleichen Sie sie mit Qwen Image 2512 LoRA weiter unten.
Das Gesichterproblem
Wir haben zweimal nach einer "32-year-old Japanese woman", zweimal nach einer "woman with East Asian features" und zweimal nach einer "30-year-old Korean woman" gefragt. Alle sechs Gesichter kamen europäisch oder uneindeutig heraus.
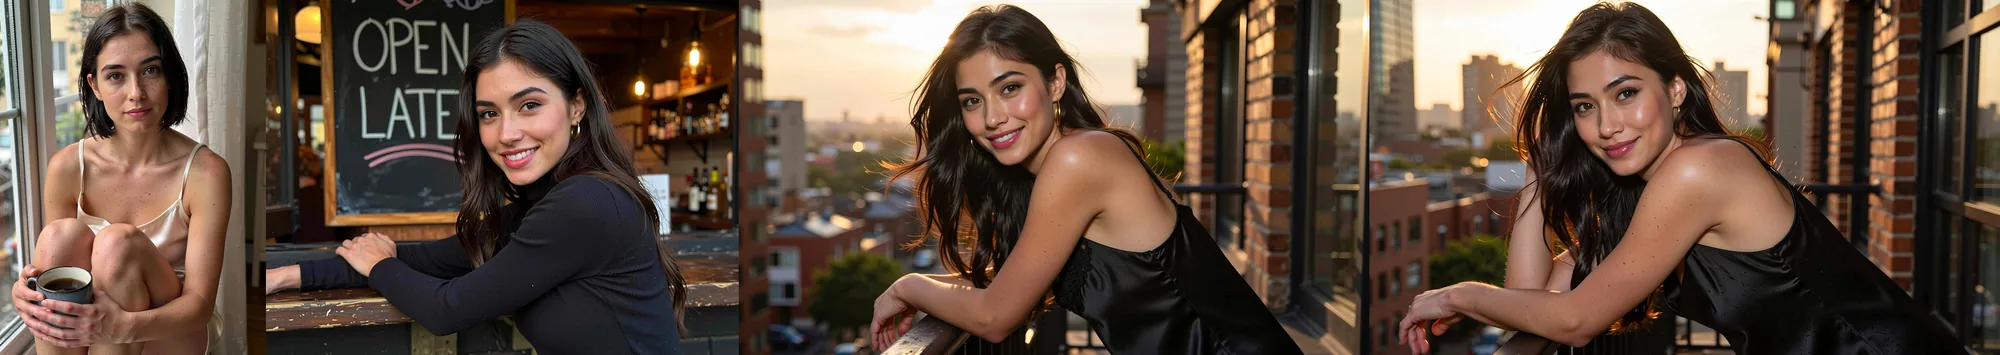
Von links nach rechts: "Japanese woman" Seed 1 (3:4), "Korean woman" Seed 1 (4:3), "East Asian features" Seeds 1 und 2 (16:9).
Viele Seeds landen außerdem bei einem ähnlichen dunkelhaarigen Gesicht, der "Same-Face"-Gewohnheit, die Civitai-Nutzer für frühe Versionen melden. Wählen Sie dieses Modell nicht, wenn Sie ausgeprägte ostasiatische Gesichter brauchen. Wenn Sie dabeibleiben, variieren Sie Alter, Haar, Sommersprossen, einen Bart und den Ausdruck ausdrücklich und verlassen Sie sich nicht auf ein Nationalitätswort. Die veröffentlichten Beispiele auf der Modellseite wurden ohne Nationalität geschrieben.
Welche LoRAs es verändern
Der LoRA-Build nimmt bis zu drei LoRAs pro Anfrage, jeweils ein Direktlink zu einer .safetensors-Datei mit einer scale von 0 bis 4. Ohne geladene LoRA lieferte er in unseren Prüfungen bei gleichem Seed pixelgleiche Ausgabe wie der Basis-Endpunkt; nutzen Sie also den Basis-Endpunkt, sofern Sie keine laden wollen. Ein Link auf die Webseite eines Repositorys scheitert mit einer Meldung, die nach dem Direkt-Download-Link fragt, und ein gesperrtes Repository scheitert mit einem HTTP-401-Fehler.
Qwen-Image-LoRAs laden, von Hugging Face oder über einen Civitai-Direktlink, ebenso Qwen-Image-2512-LoRAs. Was sie mit dem Bild machen, hängt vom Typ ab.
Foto- und Kamera-LoRAs zeigen Wirkung. Bei einem Prompt und einem Seed veränderten vier fotografische LoRAs jeweils Gesicht und Licht sichtbar, aber nicht drastisch.
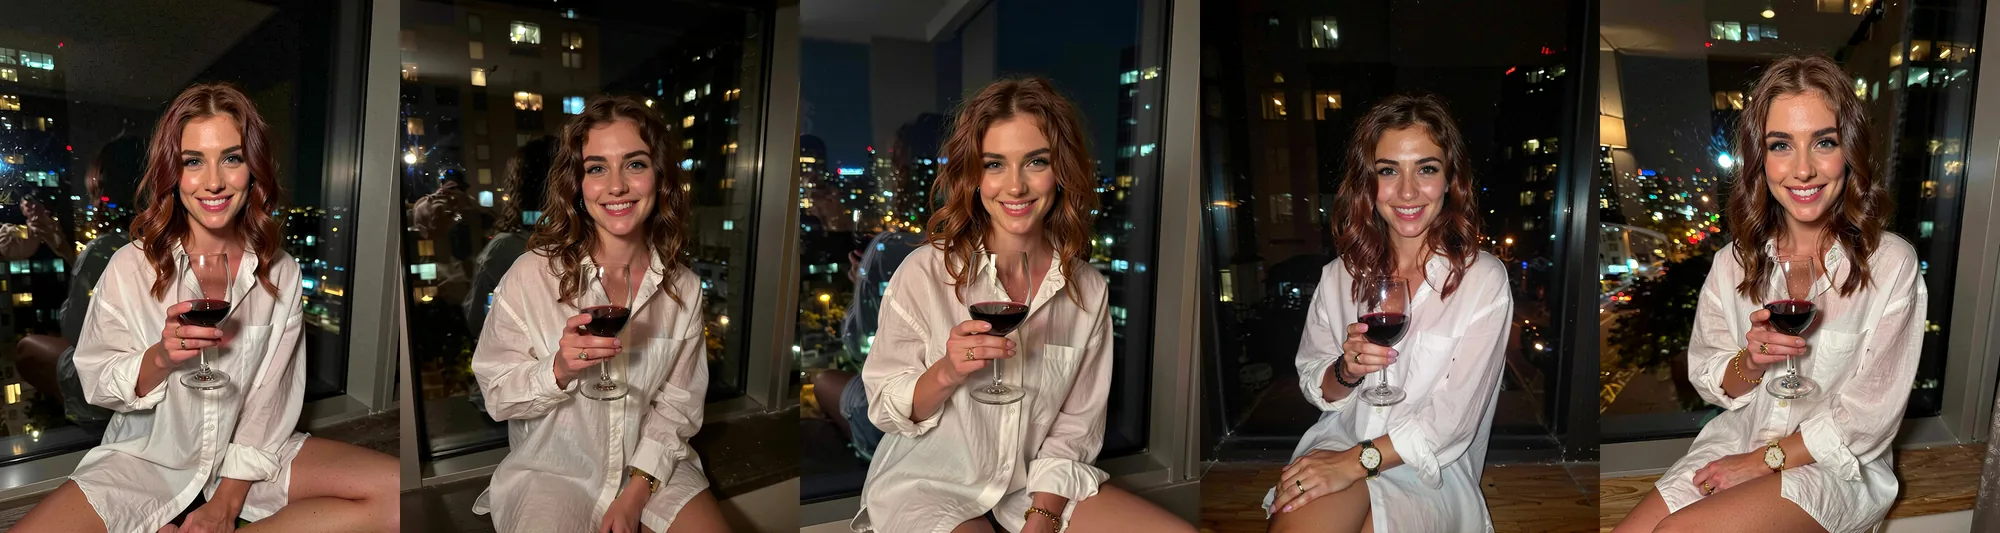
Von links nach rechts: keine LoRA; eine Handykamera-LoRA (Samsung UltraReal); eine Porträt-Retusche-LoRA (AWPortrait-QW); eine Blitzfoto-LoRA (Lenovo); eine Realismus-LoRA (flymy-ai). Gleicher Prompt, Seed 21, 3:4, alle mit Stärke 1.
| LoRA-Typ | Was wir sahen | Urteil |
|---|---|---|
| Handykamera (Samsung UltraReal) | Lockigeres Haar, härteres Licht, Schnappschuss-Gefühl | Sichtbar |
| Porträt-Retusche (AWPortrait-QW) | Ein stärker retuschierter Porträtlook | Sichtbar, dezent |
| Blitzfoto (Lenovo) | Dunkleres Bild, blitzbeleuchtet | Sichtbar |
| Realismus (flymy-ai) | Gesicht und Licht änderten sich | Sichtbar, dezent |
| Zwei gestapelt (Samsung 0,8 plus AWPortrait 0,6) | Funktionierte | Zwei LoRAs in einer Anfrage |
Zwei veröffentlichte Beispiele zeigen die Kamera- und die Retusche-LoRA bei der Arbeit:
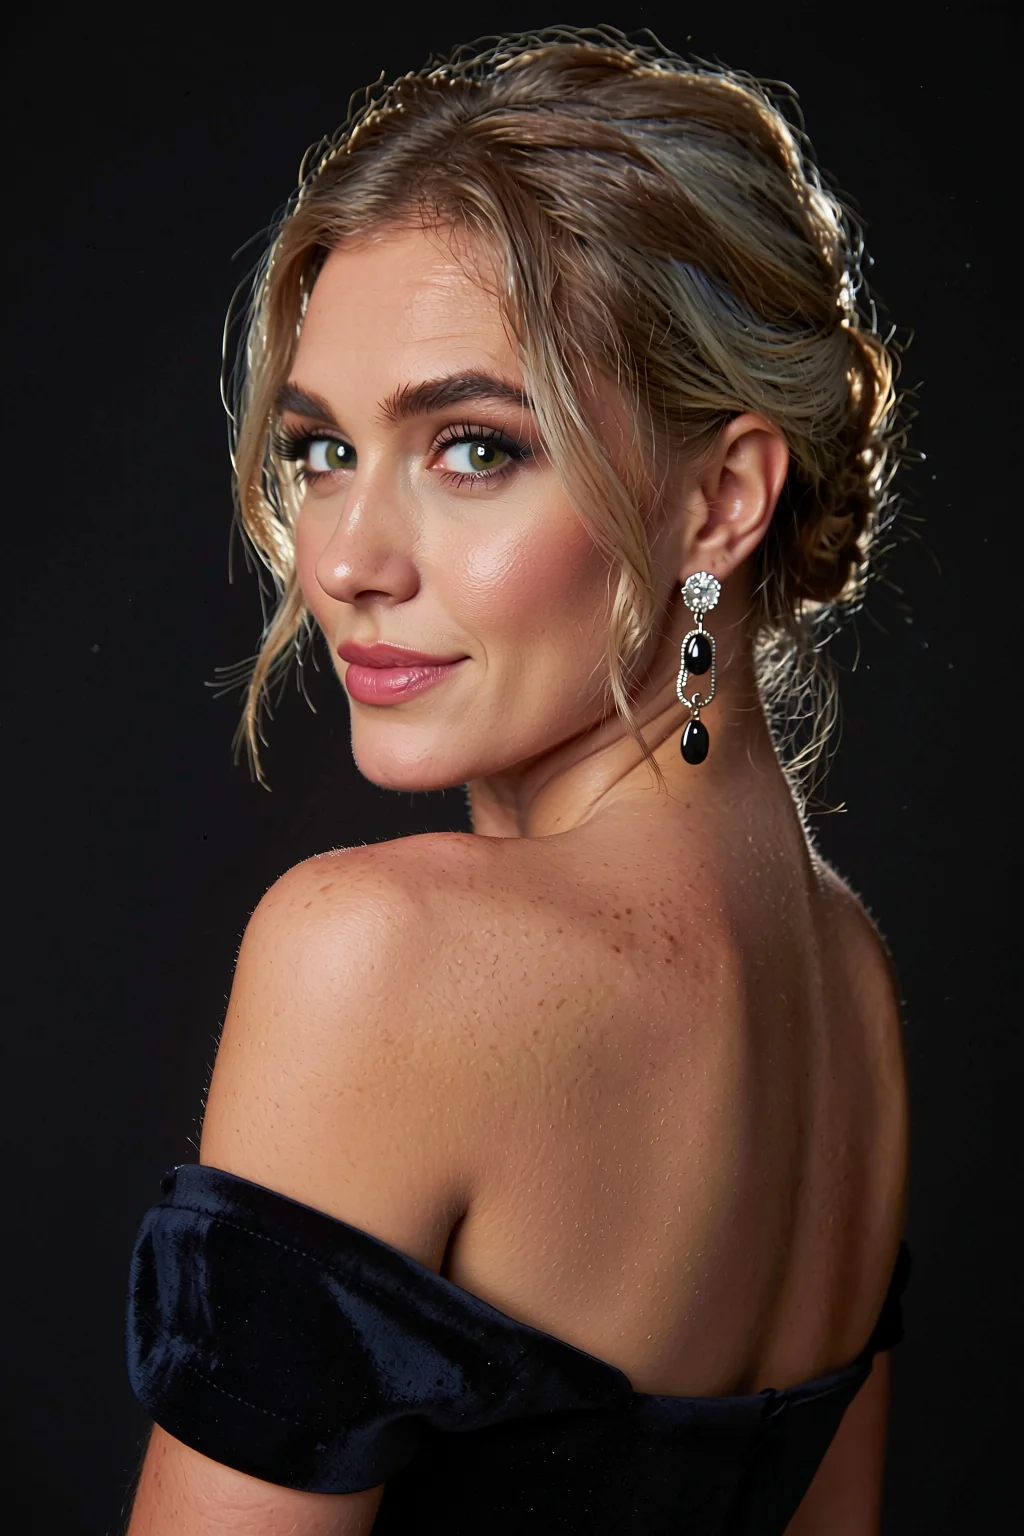
Porträt-Retusche-LoRA mit Stärke 1, 2:3, Seed 1.
Studio portrait photo. A 36-year-old woman with silver-blonde hair pinned up wears an off-shoulder black velvet gown and long earrings, looking over her bare shoulder at the camera. Soft key light, dark backdrop, rim light on her hair.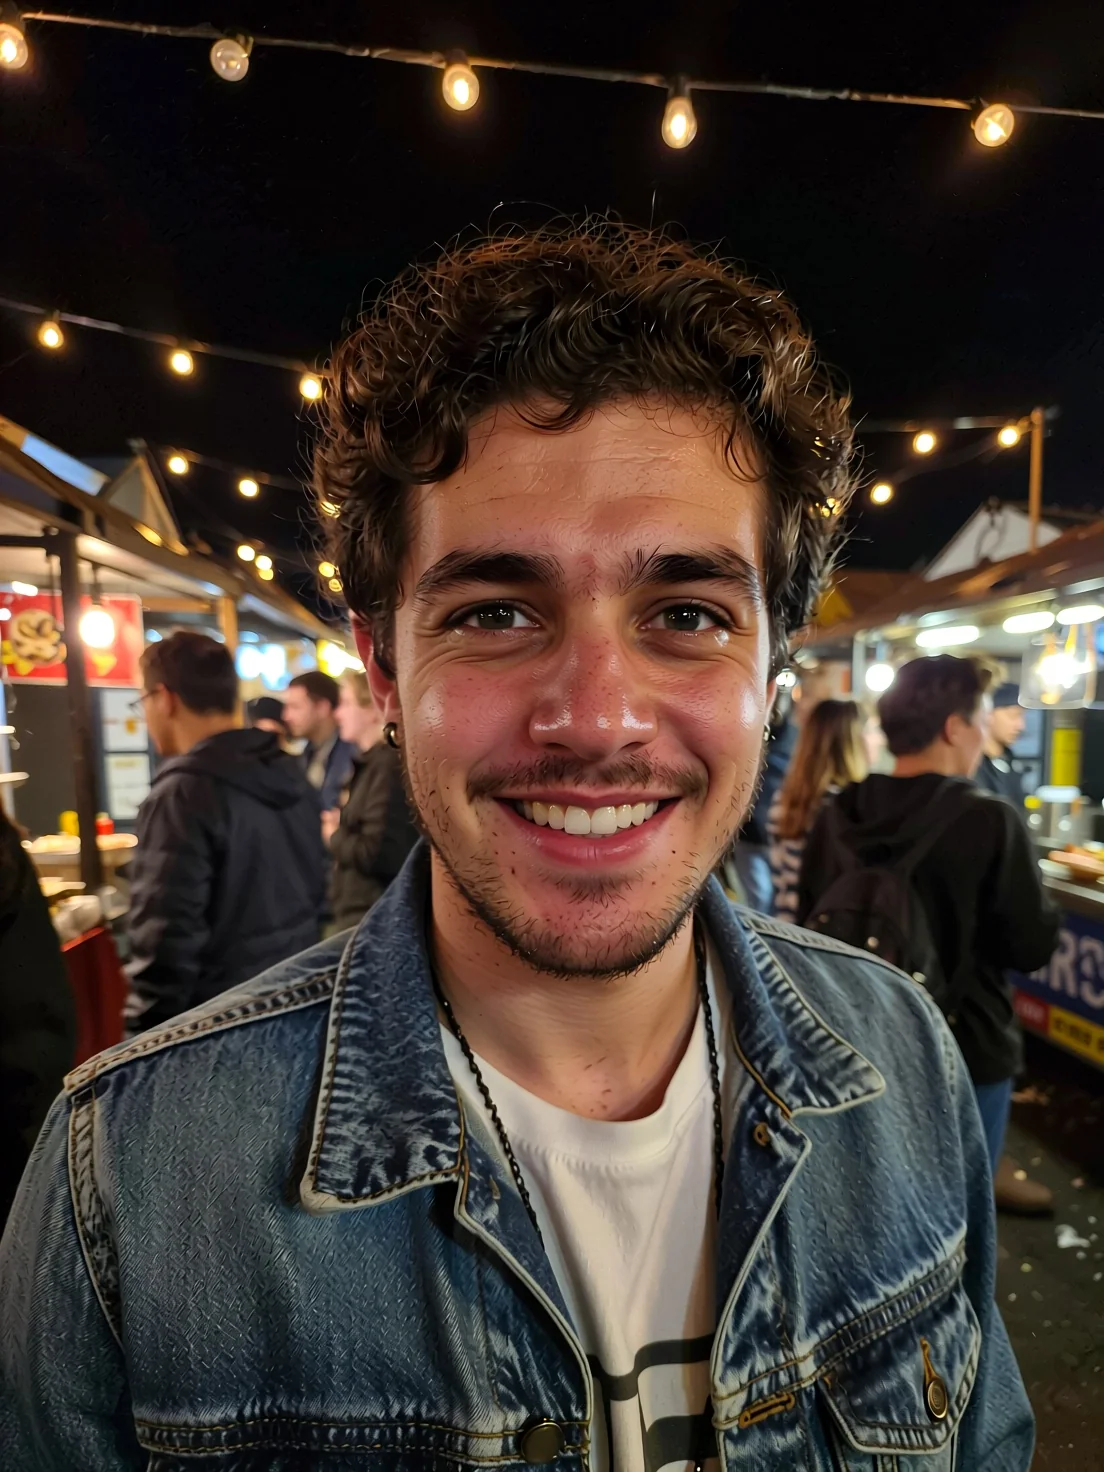
Handykamera-LoRA mit Stärke 1, 3:4, Seed 1. Prompt: "Amateur phone photo with on-camera flash. A 31-year-old man with curly dark hair and a short beard in a denim jacket over a white T-shirt grins at the camera at a crowded night market, string lights and food stalls behind him."
Stil-LoRAs bewegen es kaum. Wir haben nach einem Porträt im "Japanese modern anime style" gefragt. Der Basis-Checkpoint ignorierte die Wendung, und eine Qwen-Image-Anime-LoRA bei Stärke 0,5, 1 und 2 ebenfalls: Die Pixel änderten sich, aber das Bild blieb ein Foto. Bei Stärke 4 zerfiel das Bild zu einer verzerrten Nahaufnahme mit übergroßen Augen. Eine Qwen-Image-2512-Pixel-Art-LoRA veränderte Pixel und erzeugte keinen Pixel-Art-Look.
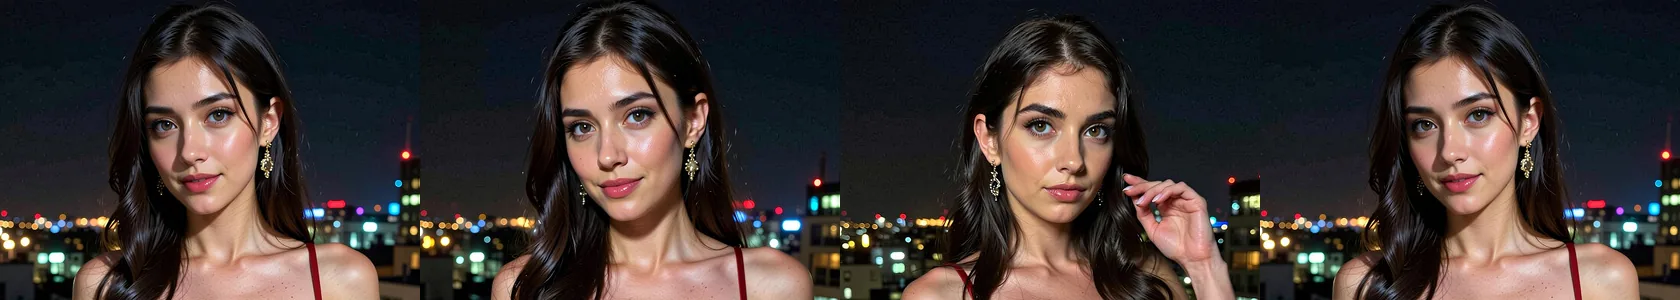
Gesichtsausschnitte, von links nach rechts: keine LoRA; eine Anime-LoRA mit 0,5; dieselbe mit 1; eine FLUX-LoRA mit 1. Gleicher Prompt, Seed 11, 3:4. Alle vier bleiben Fotografien.
Eine LoRA für ein anderes Basismodell bewirkt nichts. Eine FLUX-LoRA lud ohne Fehler und lieferte pixelgleiche Ausgabe wie ohne LoRA. Eine erfolgreiche Antwort heißt nicht, dass die Datei zum Modell passte.
Der nützliche Stärkebereich lag bei etwa 0,5 bis 1,5. Zwei gestapelte LoRAs funktionierten gut:
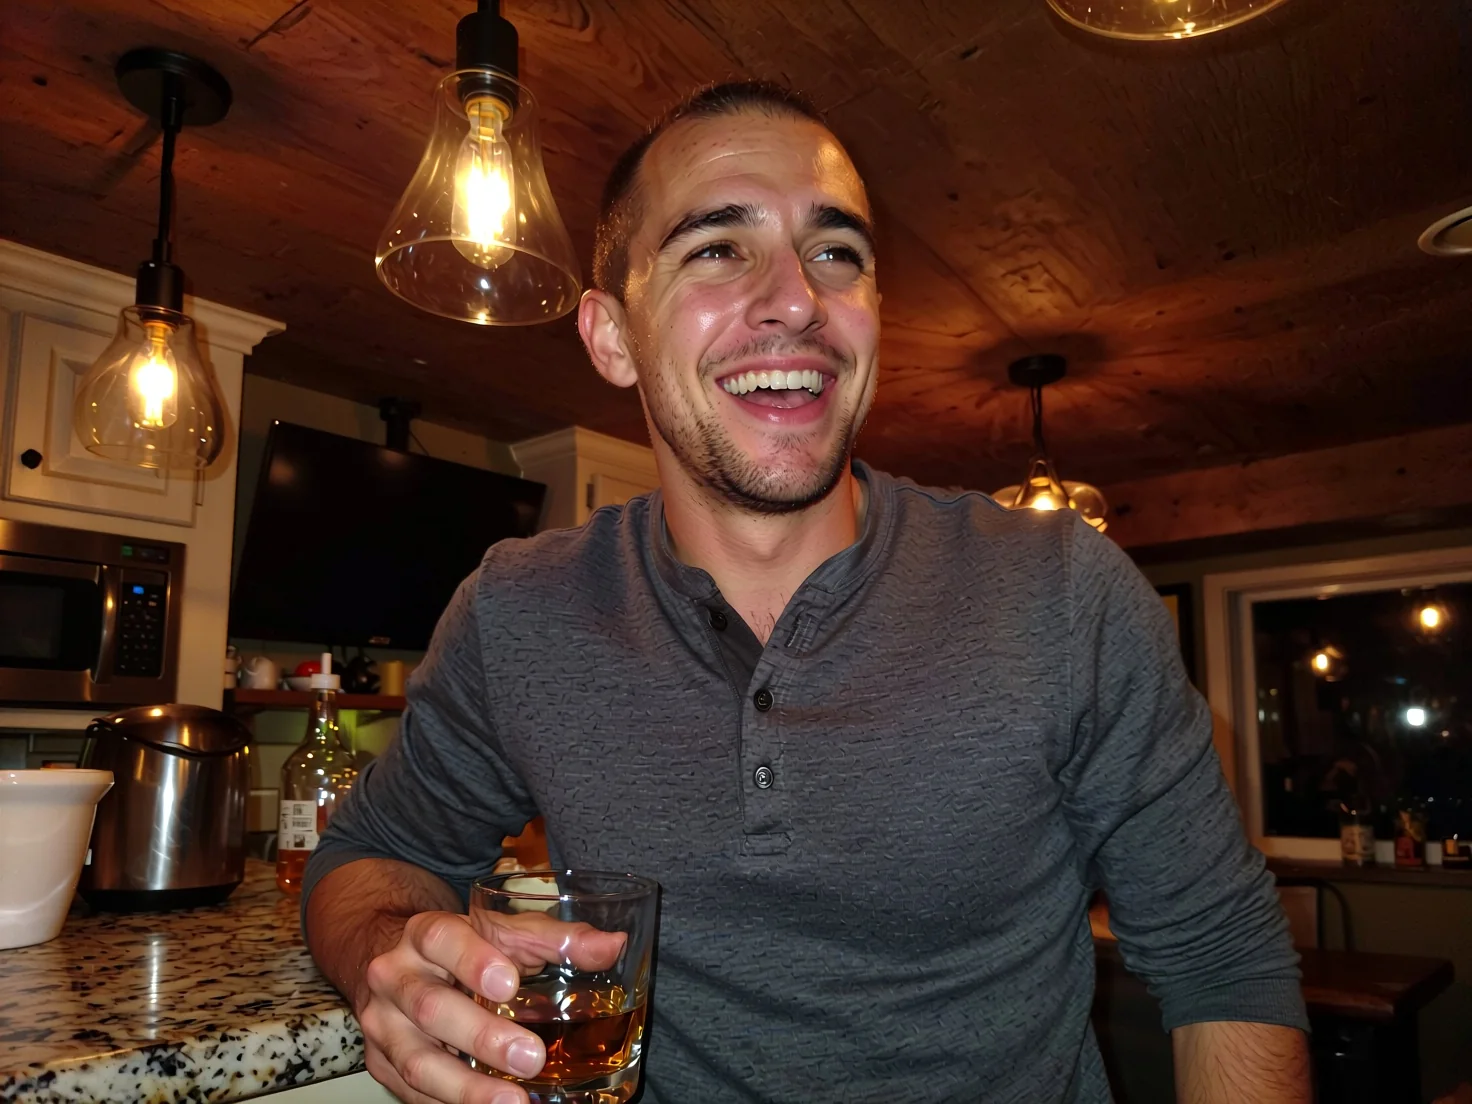
Samsung-Kamera-LoRA mit 0,8 plus AWPortrait mit 0,6, 4:3, Seed 1.
Jib Mix Qwen oder Qwen Image 2512 LoRA
Beides sind Modelle der Qwen-Image-Familie mit bis zu drei LoRAs auf der LoRA-Route. Sie eignen sich für unterschiedliche Aufgaben.
| Jib Mix Qwen (und LoRA-Build) | Qwen Image 2512 LoRA | |
|---|---|---|
| Basis | Community-Merge auf Qwen-Image | Qwen-Image-2512 zum Generieren, Qwen-Image-Edit-2511 zum Bearbeiten |
| Aufgaben | Nur Text-zu-Bild | Text-zu-Bild und Bearbeiten mit 1 bis 3 Quellbildern |
| LoRAs | Nur im LoRA-Build, bis zu 3 | Bis zu 3 bei beiden Aufgaben |
| Look ab Werk | Fotografische Porträts, natürliche Haut | Allzweck; Adapter bestimmen den Stil |
| Tempo in unseren Tests | Median 5,8 s (Basis) | In dieser Runde nicht gemessen |
| Seitenverhältnisse | 9, bis 1536 px | 9 beim Generieren, bis 1536 px; beim Bearbeiten nach der ersten Quelle |
| Inhalte in unseren Tests | Leiter geliefert außer L4, abgeschwächt | Ein Lauf der Leiter am 27. September lieferte auf jeder Route 15 von 18 Briefings; die drei Fehlschläge waren dieselbe Klasse intimer Szenen, die am 26. September eine externe Adult-LoRA bei jeder Aufgabe erfüllte |
Unsere Faustregel: Wählen Sie Jib Mix Qwen, wenn Sie ein fertiges fotografisches Porträt wollen, ohne nach LoRAs zu suchen, und die Gesichtergrenze akzeptieren. Wählen Sie Qwen Image 2512 LoRA, wenn Sie Bearbeiten brauchen, wenn Sie bereits eine LoRA für die 2512-Basis besitzen oder wenn die Basis ihren Look von Ihrem Adapter beziehen soll. Unser Leitfaden zum Abstimmen der Gewichte auf die Aufgabe erklärt die Aufteilung zwischen 2512 und Edit 2511, und die Übersicht zu gehosteten LoRA-Modellen vergleicht das weitere Feld.
Grenzen
- Gesichter. Anfragen nach ostasiatischen Gesichtern kamen in allen sechs Versuchen europäisch oder uneindeutig zurück, und viele Seeds konvergieren auf ein ähnliches Gesicht.
- Stilspektrum. Anime- und Pixel-Art-Prompts und -LoRAs ließen Fotografien zurück. Nutzen Sie für einen gezeichneten Look ein Illustrationsmodell.
- Intime Szenen mit zwei Personen. Ohne Ablehnung gezeichnet, mit weniger präziser Anatomie.
- Kein negativer Prompt, keine Schritte oder Guidance, keine Bildeingabe, kein Bearbeiten.
- Ein Bild pro Anfrage.
- Unbekannte Version. Die gehostete Route nennt nicht, welche Version von Jib Mix Qwen sie betreibt.
FAQ
Ist Jib Mix Qwen unzensiert?
Ja. Die Plattform fügt keinen Content-Filter hinzu. Inhalte mit einer einzelnen Person kamen in unserer Leiter wie verlangt zurück, und Zweierszenen wurden ohne Ablehnung, aber mit weniger präziser Anatomie gezeichnet.
Kann es ostasiatische Gesichter erzeugen?
Nicht zuverlässig. Sechs Anfragen nach japanischen, koreanischen oder ostasiatischen Frauen kamen alle europäisch oder uneindeutig zurück. Variieren Sie stattdessen Alter, Haar und Gesichtszüge, statt eine Nationalität zu nennen.
Funktionieren Stil-LoRAs darauf?
Kaum. Eine Anime-LoRA bei 0,5, 1 und 2 ließ das Bild ein Foto, und bei 4 zerfiel das Bild. Foto-, Kamera- und Porträt-LoRAs sind die, die Wirkung zeigen.
Welche Stärke soll ich für eine LoRA verwenden?
Beginnen Sie bei 1 und bleiben Sie zwischen etwa 0,5 und 1,5. Stärke 4, das Maximum, zerstörte in unserem Test das Bild.
Funktioniert eine LoRA für ein anderes Basismodell?
Nein. Eine FLUX-LoRA lud ohne Fehler und änderte nichts. Verwenden Sie LoRAs, die für Qwen-Image oder Qwen-Image-2512 trainiert wurden.
Soll ich den Basis-Endpunkt oder den LoRA-Endpunkt nutzen?
Den Basis-Endpunkt, wenn Sie keine LoRA laden. Ohne LoRA lieferte der LoRA-Build in unseren Prüfungen bei gleichem Seed pixelgleiche Ausgabe wie die Basis.
Kann es Text im Bild darstellen?
Kurze Wörter, ja. Unser Kreidetafel-"OPEN LATE" las sich in beiden Seeds korrekt. Halten Sie die Wendung kurz und prüfen Sie die Beschriftung vor der Veröffentlichung.
Kann ich damit ein vorhandenes Foto bearbeiten?
Nein. Beide Endpunkte sind Text-zu-Bild. Zum Bearbeiten mit Quellbildern nutzen Sie Qwen Image 2512 LoRA.