Jib Mix Qwen est un modèle rapide de portraits photoréalistes : dans nos tests, une image a pris une médiane de 5,8 secondes, et les LoRA de photo et d’appareil ont changé son rendu alors que les LoRA de style l’ont à peine modifié. Il a deux points faibles que vous devez connaître avant de construire dessus. Six requêtes pour une femme japonaise, coréenne ou d’Asie de l’Est sont toutes revenues européennes ou ambiguës, et les scènes intimes à deux personnes ont été dessinées sans refus, mais avec une anatomie confuse.
Nous avons testé Jib Mix Qwen et sa version LoRA le 5 octobre 2026. Jib Mix est une série de checkpoints communautaires du créateur J1B, et celui-ci est un mélange de fine-tunes et de LoRA de Qwen-Image construit sur le Qwen-Image d’Alibaba de 20 milliards de paramètres. Chaque prompt reproduit ci-dessous est une scène du quotidien avec des adultes habillés.
En un coup d’œil
| Jib Mix Qwen et Jib Mix Qwen LoRA (testés le 5 octobre 2026) | |
|---|---|
| Créateur et base | J1B ; un mélange de fine-tunes et de LoRA de Qwen-Image sur Qwen-Image (20B, encodeur de texte Qwen2.5-VL) |
| Noms de modèle dans l’API | j1b/jib-mix-qwen-image/text-to-image et j1b/jib-mix-qwen-image-lora/text-to-image |
| Champs publics | prompt (jusqu’à 5 000 caractères), aspect_ratio, output_format, seed ; la version LoRA ajoute loras |
| Rapports d’aspect | 9, jusqu’à 1536 pixels sur le grand côté : 1328 x 1328 en 1:1, 1536 x 864 en 16:9 |
| Sortie | Une image par requête en JPEG (par défaut), PNG ou WebP |
| Vitesse dans nos tests | Base : de 3,7 à 48 secondes sur 30 exécutions, médiane 5,8, 21 sur 30 sous 10. Version LoRA : de 3,2 à 36 secondes sur 38 exécutions, médiane 5,6 |
| Politique de contenu | Sans censure, aucun filtre de contenu ; le contenu à un seul sujet est revenu comme demandé, les scènes à deux personnes ont été dessinées sans refus mais avec moins de précision |
| Ne sait pas faire | Prompt négatif, étapes, guidance, image en entrée, retouche, plus d’une image par requête |
Ce que c’est, et quelle version
Les notes du créateur pour la première version disent qu’elle fusionne des modèles Qwen avec des LoRA favorites à des poids précis. La page Civitai répertorie six versions entre septembre 2025 et mars 2026. La note de la v4.0, du 15 octobre 2025, dit « much more natural pretty faces (much better at Asian faces) ». La note de la v6.0, de mars 2026, dit « more European faces and fewer Asian by default » et « not quite as good at NSFW as V5 ».
La route hébergée n’indique pas quelle version elle fait tourner. Sa description reprend la note de la v4.0, mais nos sorties penchent vers l’européen, ce qui correspond à la v6, et la route a été mise à jour récemment : nous ne pouvons donc pas exclure un remplacement. Nous le signalons comme non vérifié plutôt que de deviner. Ce que nous pouvons rapporter, c’est ce que fait la route, et c’est le reste de cet article.
Écrire des prompts pour les portraits
Le modèle aime un brief de photographe en phrases complètes. Le portrait à la fenêtre ci-dessous utilisait l’âge, les cheveux, les taches de rousseur, les vêtements, la pose et la lumière, avec une courte amorce photographique :
Photorealistic photo, natural skin texture. A 32-year-old woman with a short black bob, light freckles and minimal makeup sits on a windowsill in a cream silk camisole, knees drawn up, holding a mug of coffee. Soft morning light, sheer curtains, shallow depth of field.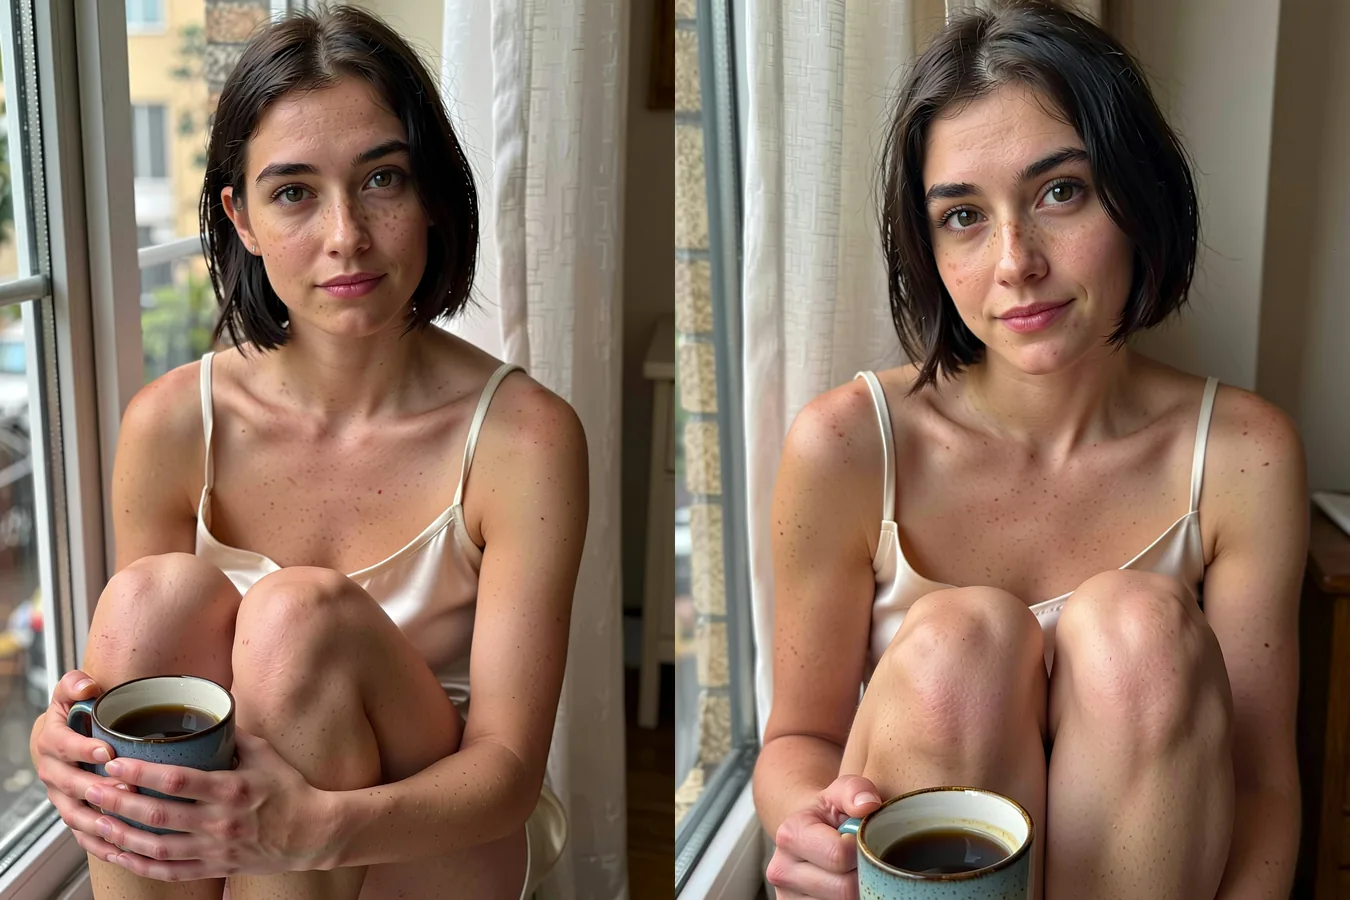
Seeds 1 et 2 d’une version de ce prompt qui demandait une femme japonaise. Voir la section sur les visages plus bas. 3:4, texte vers image.
Les habitudes qui ont aidé dans nos exécutions :
- Ouvrez avec un repère photographique. « Photorealistic photo, natural skin texture » ou « 35mm film look » ou « phone photo with flash » oriente le rendu.
- Décrivez la personne, pas une nationalité. L’âge, la longueur et la couleur des cheveux, les taches de rousseur, une barbe et l’expression ont changé les visages de façon fiable. Une nationalité, non.
- Citez des mots courts. Notre prompt d’ardoise demandait une enseigne portant « OPEN LATE » en lettres de craie blanche. L’ardoise est revenue avec ces mots sur les deux seeds. Restez sur une expression courte et vérifiez les lettres.
- Fixez la seed et changez une seule chose. La lumière, les vêtements ou l’effet d’objectif, un à la fois. Les seeds rendent les exécutions comparables mais ne promettent pas des pixels identiques.
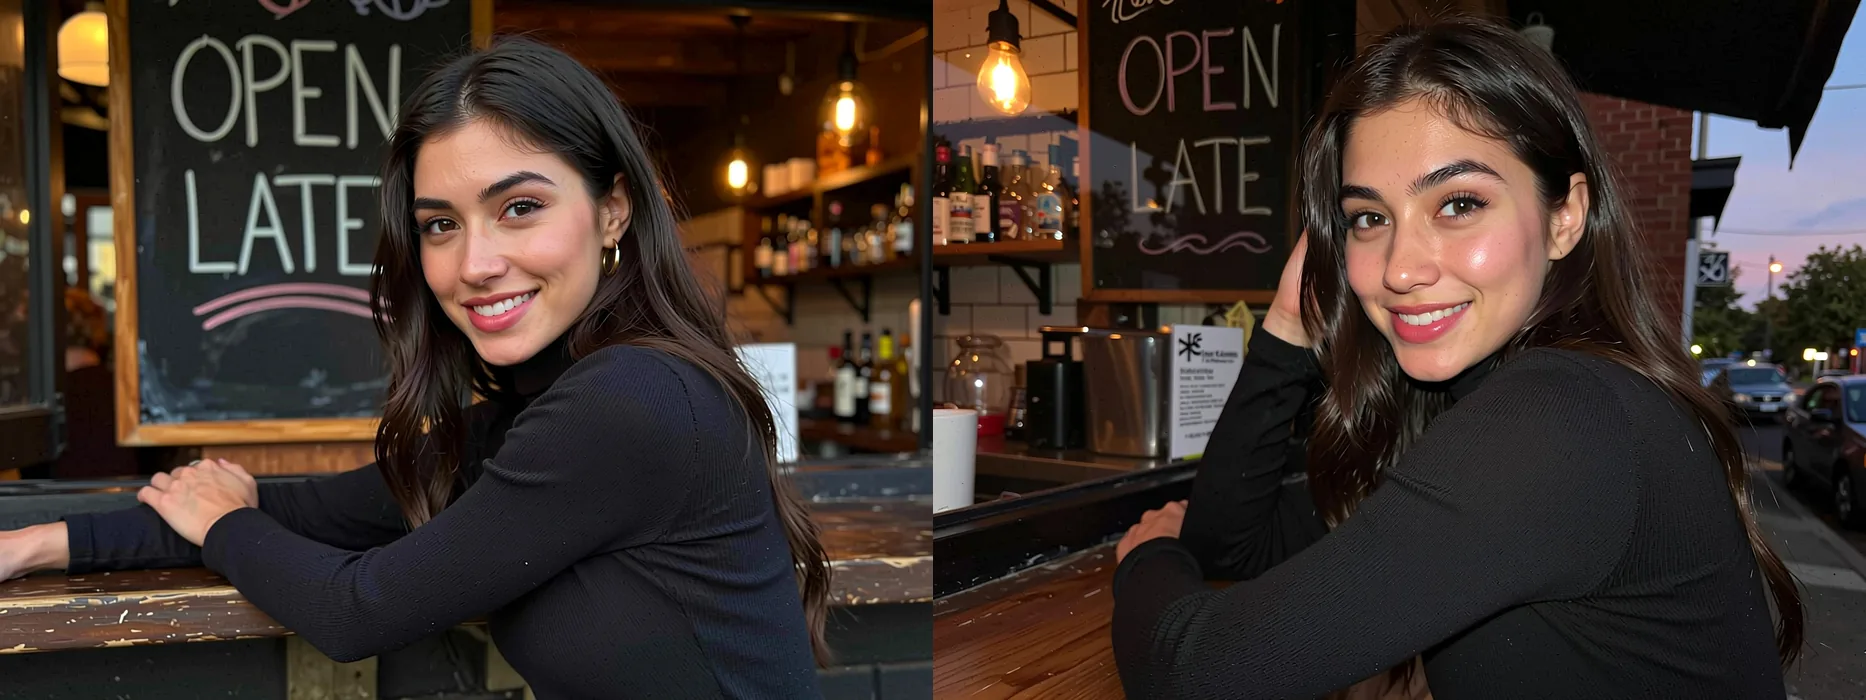
Seeds 1 et 2 du prompt d’ardoise (ici pour une femme coréenne), 4:3. L’enseigne indique « OPEN LATE » dans les deux.
Rapports d’aspect et tailles
Il n’y a pas de champ de taille. Vous choisissez l’un des neuf rapports d’aspect, chacun associé à une taille fixe. Nous avons lancé chaque rapport une fois sur les deux points d’accès, et chaque sortie est revenue exactement aux pixels demandés. Le grand côté s’arrête à 1536.
| Rapport | Taille | Rapport | Taille |
|---|---|---|---|
| 1:1 | 1328 x 1328 | 21:9 | 1536 x 656 |
| 4:3 | 1472 x 1104 | 9:21 | 656 x 1536 |
| 3:4 | 1104 x 1472 | 16:9 | 1536 x 864 |
| 3:2 | 1536 x 1024 | 9:16 | 864 x 1536 |
| 2:3 | 1024 x 1536 |
Choisissez selon le travail. 3:4 et 2:3 conviennent aux portraits, 16:9 et 21:9 aux arrêts sur image de film et aux bannières. Un portrait serré en 2:3 ressemble à ceci :
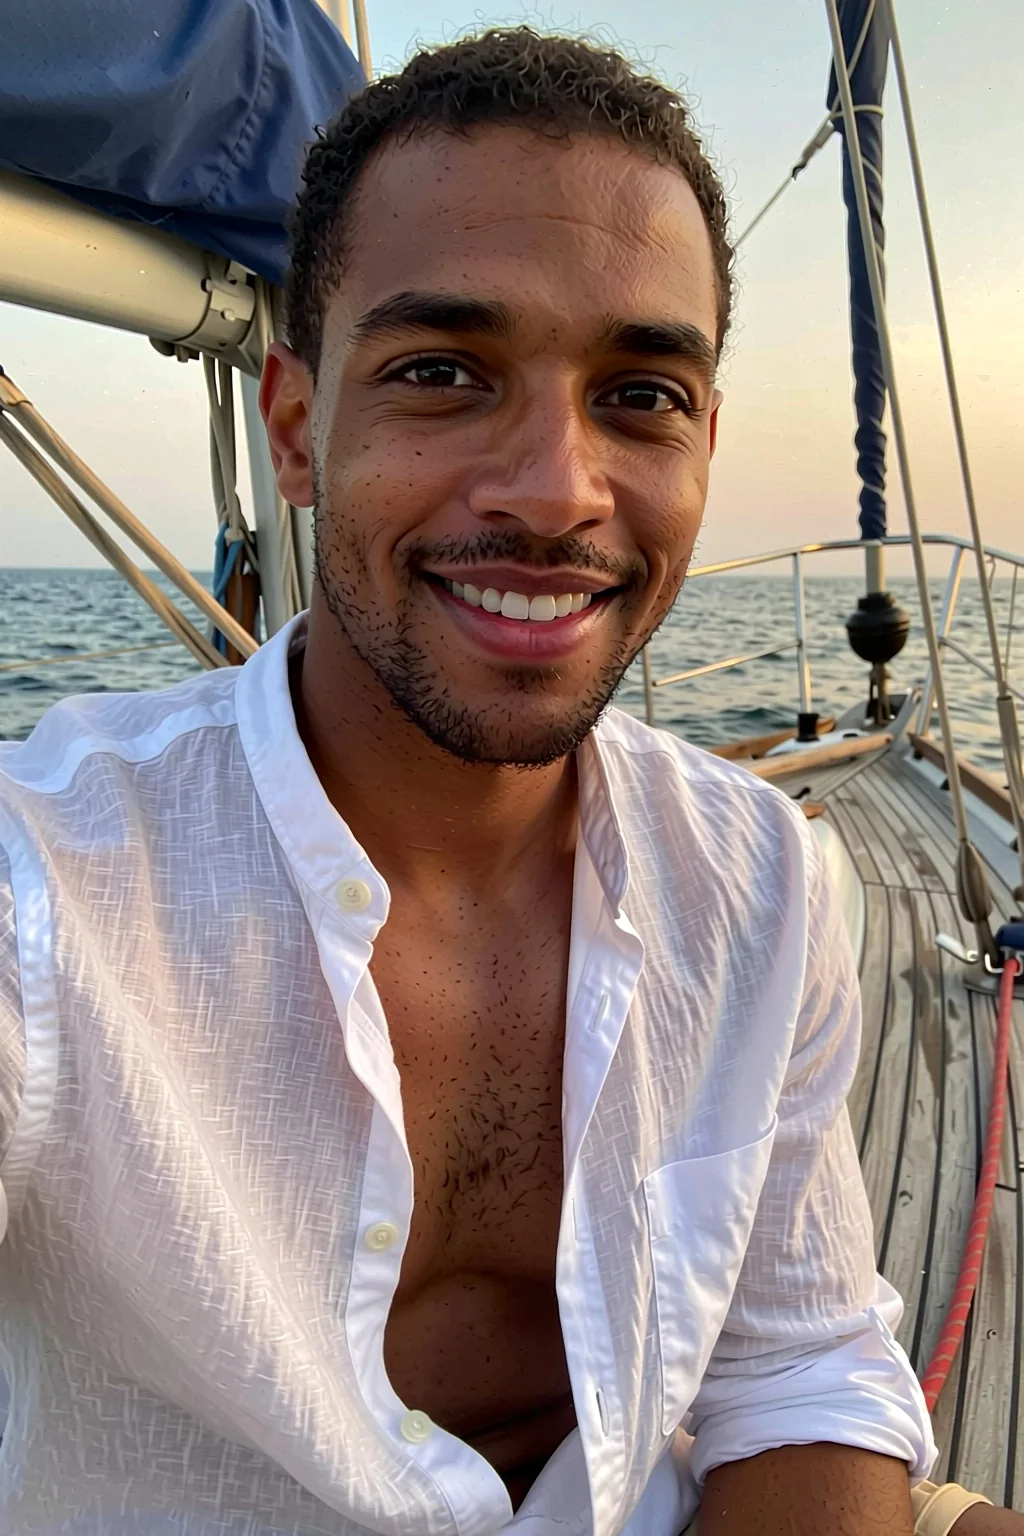
Exemple publié : un homme de 35 ans sur un voilier à l’heure dorée, 2:3, seed 1.
Photorealistic photo, natural skin texture. A 35-year-old Black man with a trimmed beard and a warm smile, open white linen shirt, sits on the deck of a sailboat at golden hour. Sea spray, wind in his shirt, shallow depth of field.Vitesse
Le temps de modèle du point d’accès de base allait de 3,7 à 48 secondes sur 30 exécutions, avec une médiane de 5,8 secondes et 21 sur 30 sous dix. La version LoRA était presque identique : de 3,2 à 36 secondes sur 38 exécutions, médiane 5,6, et une requête qui chargeait un fichier LoRA pour la première fois a pris de 10 à 25 secondes. C’est assez rapide pour itérer sur un portrait.
Deux personnes dans un même cadre
Les scènes avec deux personnes habillées ont fonctionné. Ce prompt d’arrêt sur image a dessiné un couple riant sous un même parapluie sur les deux seeds, chaque personne avec son propre manteau et sa place dans le cadre :
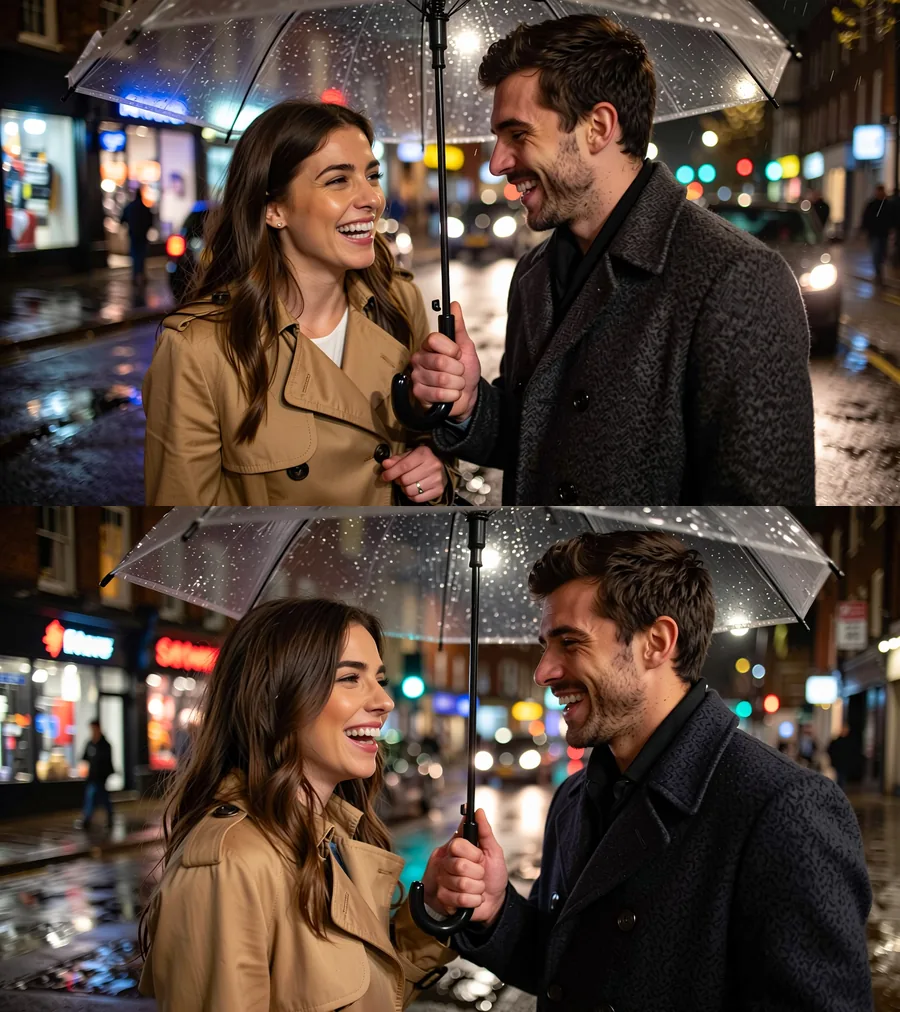
Seeds 1 et 2 du prompt du parapluie, 16:9, empilées. Le modèle a donné à chaque personne un manteau distinct et a gardé le bokeh.
Photorealistic film still. A woman and a man in their early thirties laugh together under one clear umbrella on a rainy city street at night, she in a camel trench coat, he in a dark wool coat. Shop lights blur into colorful bokeh and reflect on the wet asphalt.Donnez à chaque personne une place claire dans le cadre et une tenue chacune. Quand des mains ou des membres fusionnent, relancez la seed.
Jusqu’où ça va
La plateforme n’ajoute aucun filtre de contenu. Nous avons lancé un prompt par échelon de notre échelle en cinq paliers, en 3:4, seed 1, avec des personnages précisés comme adultes, et regardé chaque image.
| Palier | Résultat sur le point d’accès de base |
|---|---|
| L1 Suggestif (lingerie, une bretelle qui glisse) | Rendu |
| L2 Thèmes matures | Rendu, et sur les neuf rapports (9 sur 9) sur les deux points d’accès |
| L3 Fort, féminin et masculin | Rendu |
| L4 Intense (une scène intime entre deux adultes) | Atténué : les trois seeds ont dessiné deux adultes, mais l’anatomie était confuse et une seule des trois ressemblait à la scène demandée |
| L5 Extrême (contrainte consentie entre adultes ; gore cinématographique) | Les deux rendus |
Il n’y a eu de refus nulle part. L4 est le constat honnête : le modèle ne le décline pas, il ne sait simplement pas le dessiner proprement. L’ajout d’une LoRA Qwen-Image pour adultes a changé la composition en un couple posé et n’a toujours pas produit la scène. La limite pratique est donc la suivante : le contenu à un seul sujet est revenu comme demandé, et les scènes à deux personnes ont été dessinées sans refus mais avec une anatomie moins précise. Si votre travail dépend de L4, testez d’abord la route exacte, et comparez-la avec Qwen Image 2512 LoRA ci-dessous.
Le problème des visages
Nous avons demandé deux fois une « 32-year-old Japanese woman », deux fois une « woman with East Asian features » et deux fois une « 30-year-old Korean woman ». Les six visages sont sortis européens ou ambigus.
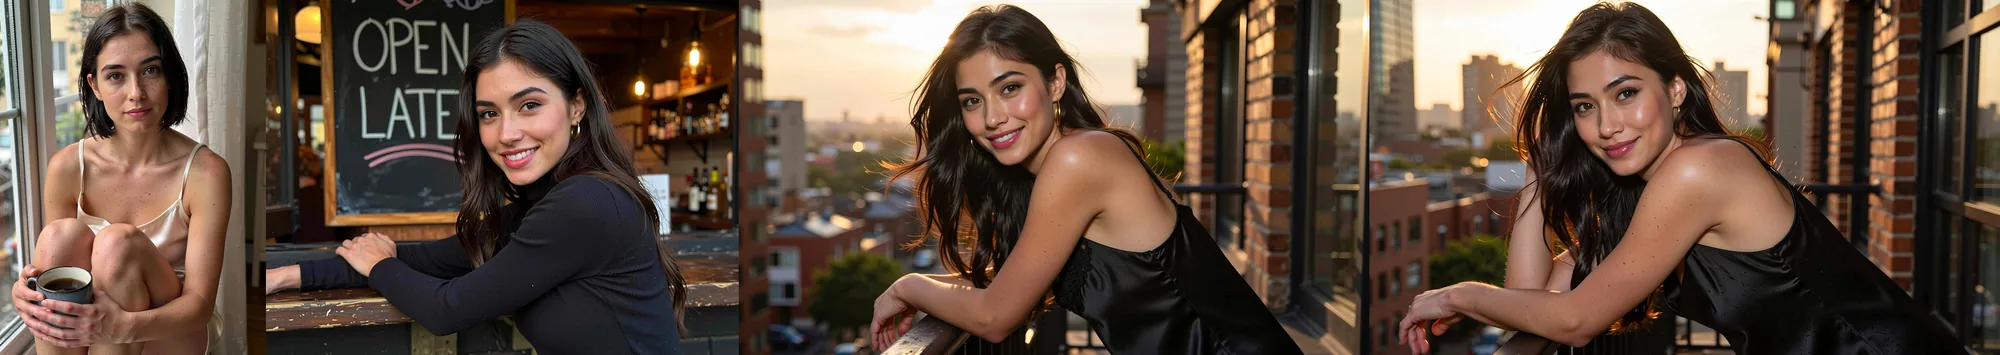
De gauche à droite : « Japanese woman » seed 1 (3:4), « Korean woman » seed 1 (4:3), « East Asian features » seeds 1 et 2 (16:9).
De nombreuses seeds se fixent aussi sur un même visage aux cheveux sombres, l’habitude du « même visage » que signalent les utilisateurs de Civitai pour les premières versions. Ne choisissez pas ce modèle si vous avez besoin de visages d’Asie de l’Est marqués. Si vous le gardez, faites varier explicitement l’âge, les cheveux, les taches de rousseur, la barbe et l’expression, et ne comptez pas sur un mot de nationalité. Les exemples publiés sur la page du modèle ont été écrits sans nationalité.
Quelles LoRA le changent
La version LoRA accepte jusqu’à trois LoRA par requête, chacune étant un lien direct vers un fichier .safetensors avec un scale de 0 à 4. Sans LoRA chargée, elle a donné une sortie identique au pixel près à celle du point d’accès de base sur la même seed dans nos vérifications : utilisez donc le point d’accès de base à moins de prévoir d’en charger une. Un lien vers la page web d’un dépôt échoue avec un message demandant le lien de téléchargement direct, et un dépôt verrouillé échoue avec une erreur HTTP 401.
Les LoRA Qwen-Image se chargent, depuis Hugging Face ou depuis un lien direct Civitai, et les LoRA Qwen-Image-2512 aussi. Leur effet sur l’image dépend du type.
Les LoRA de photo et d’appareil se voient. Sur un prompt et une seed, quatre LoRA photographiques ont chacune changé le visage et la lumière de façon visible mais pas radicale.
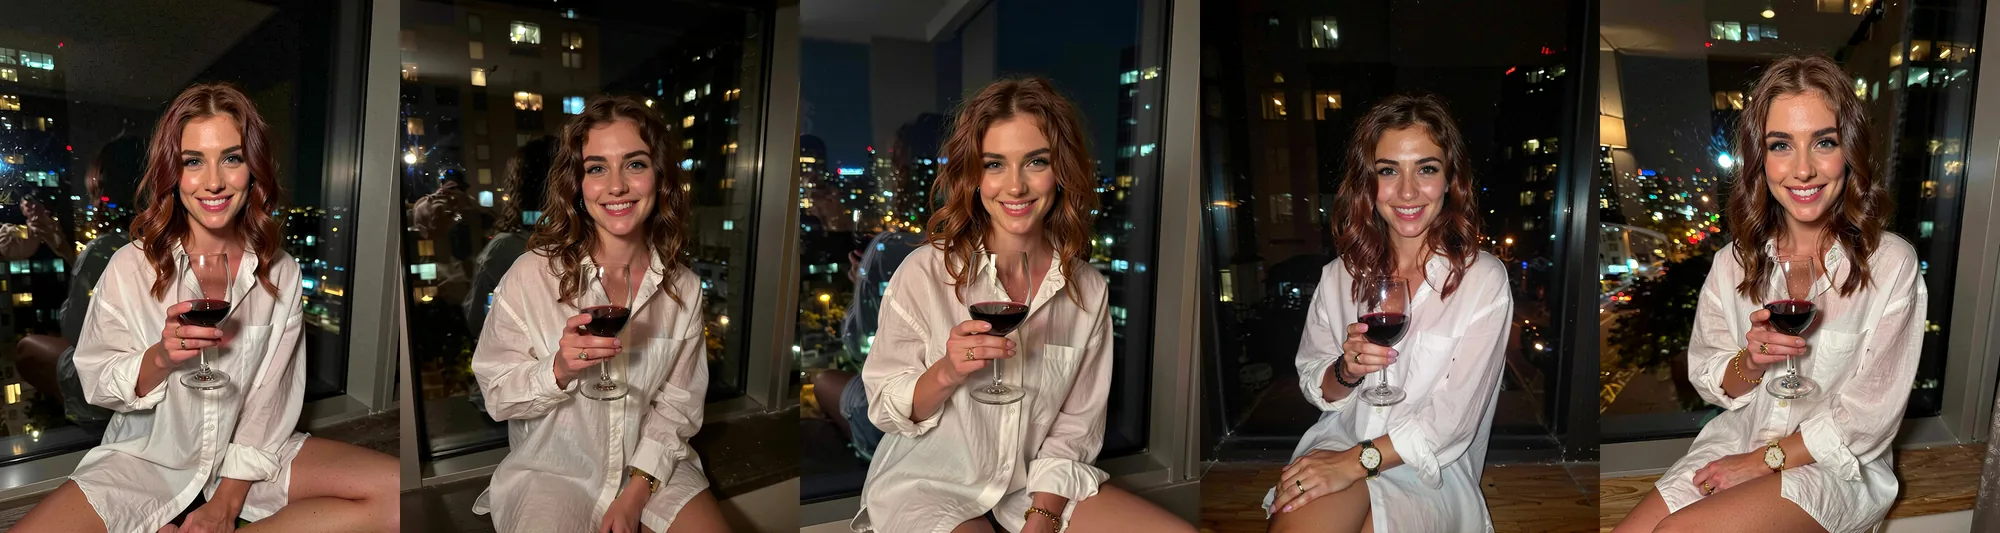
De gauche à droite : sans LoRA ; une LoRA d’appareil de téléphone (Samsung UltraReal) ; une LoRA de retouche de portrait (AWPortrait-QW) ; une LoRA de photo au flash (Lenovo) ; une LoRA de réalisme (flymy-ai). Même prompt, seed 21, 3:4, toutes à l’échelle 1.
| Type de LoRA | Ce que nous avons vu | Verdict |
|---|---|---|
| Appareil de téléphone (Samsung UltraReal) | Cheveux plus bouclés, lumière plus dure, un effet instantané | Visible |
| Retouche de portrait (AWPortrait-QW) | Un rendu de portrait plus retouché | Visible, subtil |
| Photo au flash (Lenovo) | Cadre plus sombre, éclairé au flash | Visible |
| Réalisme (flymy-ai) | Visage et lumière changés | Visible, subtil |
| Deux empilées (Samsung 0,8 plus AWPortrait 0,6) | A fonctionné | Deux LoRA dans une requête |
Deux exemples publiés montrent les LoRA d’appareil et de retouche à l’œuvre :
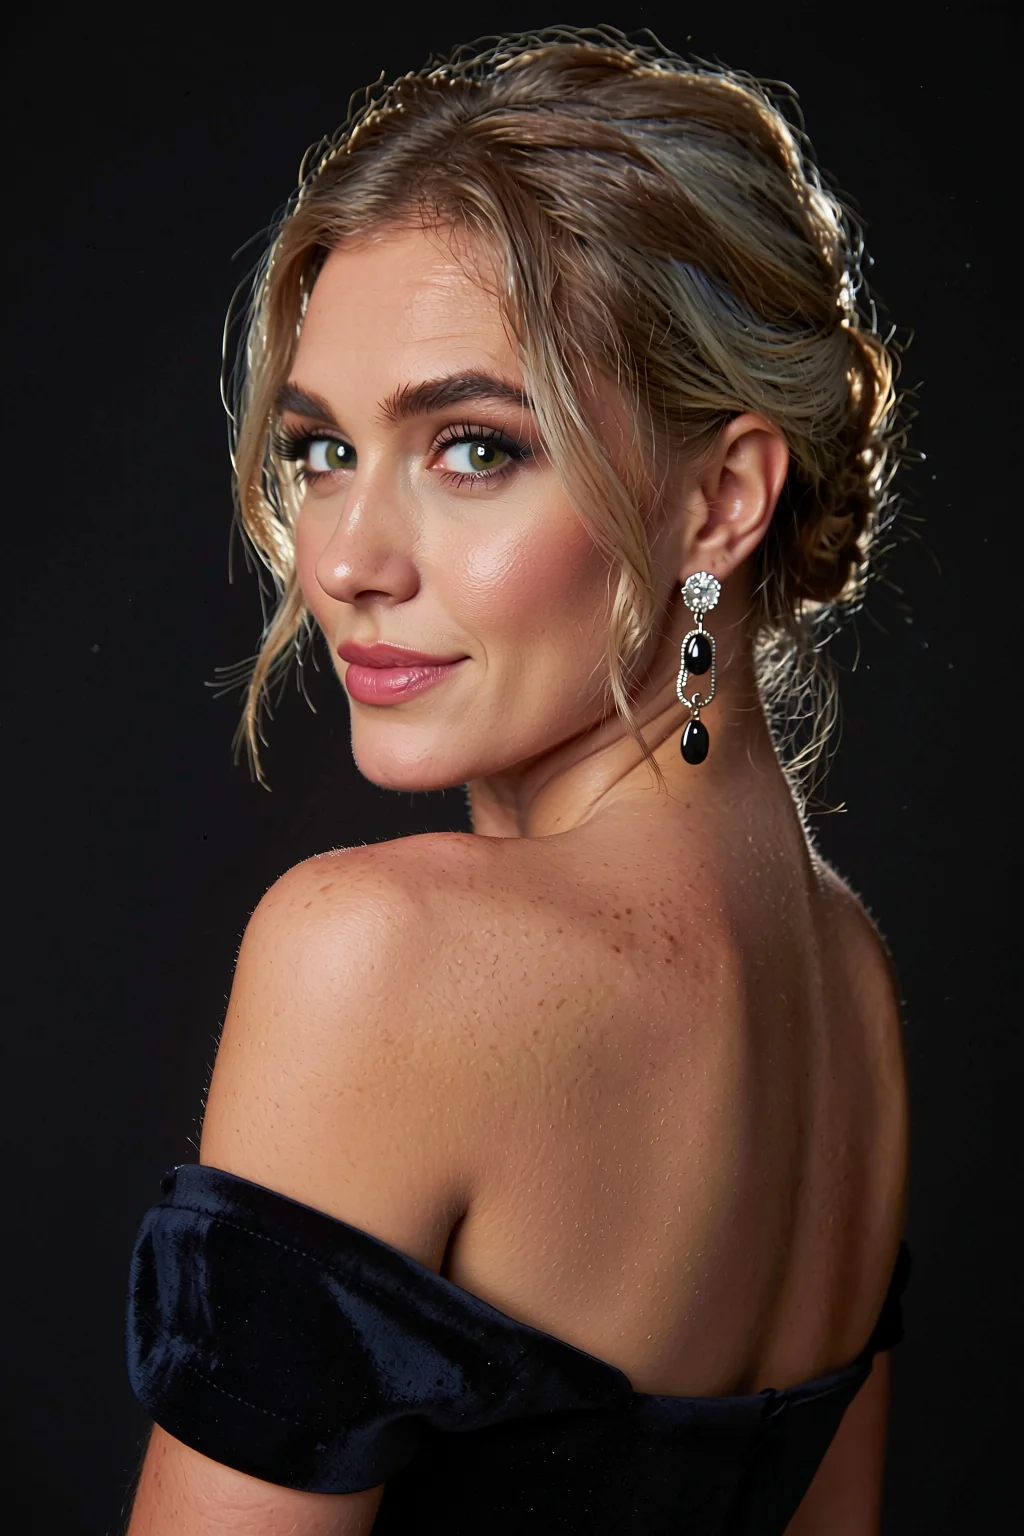
LoRA de retouche de portrait à l’échelle 1, 2:3, seed 1.
Studio portrait photo. A 36-year-old woman with silver-blonde hair pinned up wears an off-shoulder black velvet gown and long earrings, looking over her bare shoulder at the camera. Soft key light, dark backdrop, rim light on her hair.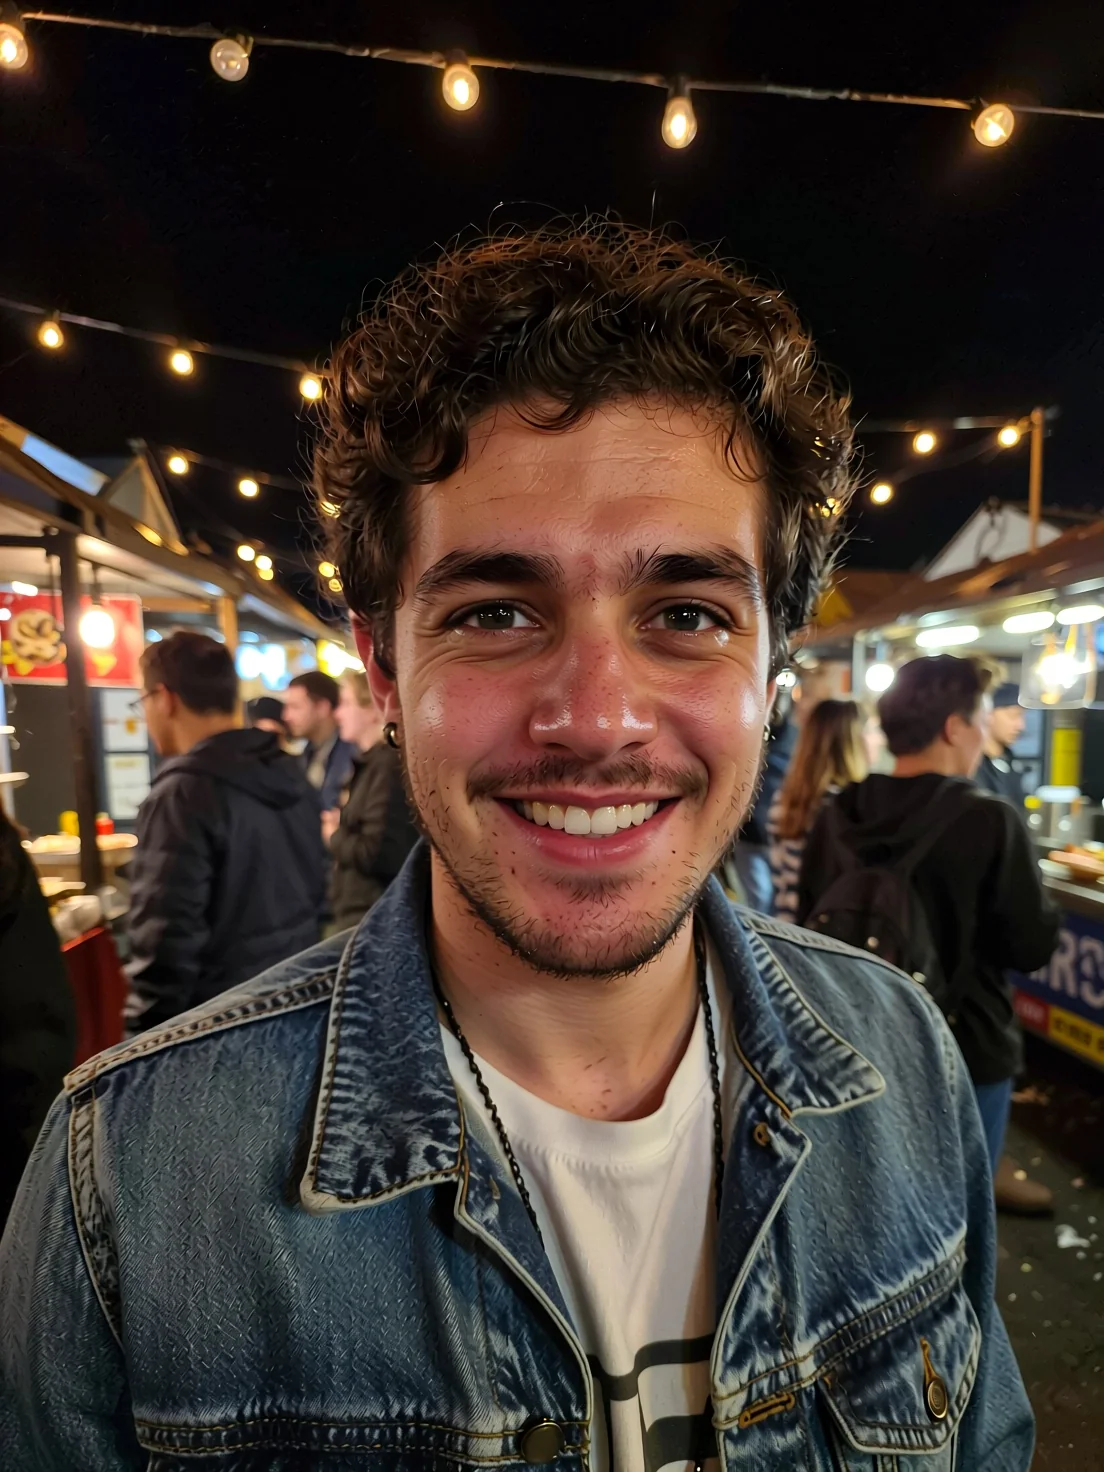
LoRA d’appareil de téléphone à l’échelle 1, 3:4, seed 1. Prompt : "Amateur phone photo with on-camera flash. A 31-year-old man with curly dark hair and a short beard in a denim jacket over a white T-shirt grins at the camera at a crowded night market, string lights and food stalls behind him."
Les LoRA de style le déplacent à peine. Nous avons demandé un portrait « Japanese modern anime style ». Le checkpoint de base a ignoré la phrase, tout comme une LoRA d’anime pour Qwen-Image aux échelles 0,5, 1 et 2 : les pixels ont changé mais l’image est restée une photographie. À l’échelle 4, l’image s’est brisée en un gros plan déformé aux yeux démesurés. Une LoRA de pixel art pour Qwen-Image-2512 a changé des pixels sans produire d’aspect pixel art.
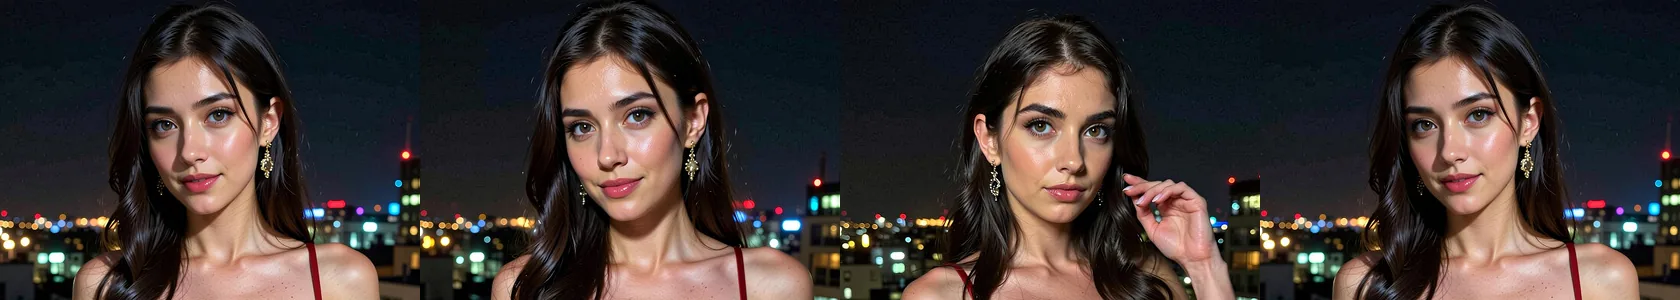
Recadrages de visage, de gauche à droite : sans LoRA ; une LoRA d’anime à 0,5 ; la même à 1 ; une LoRA FLUX à 1. Même prompt, seed 11, 3:4. Les quatre restent des photographies.
Une LoRA d’un autre modèle de base ne fait rien. Une LoRA FLUX s’est chargée sans erreur et a donné une sortie identique au pixel près à l’absence de LoRA. Une réponse réussie ne signifie pas que le fichier correspondait au modèle.
La plage de scale utile allait d’environ 0,5 à 1,5. Deux LoRA empilées ont bien fonctionné :
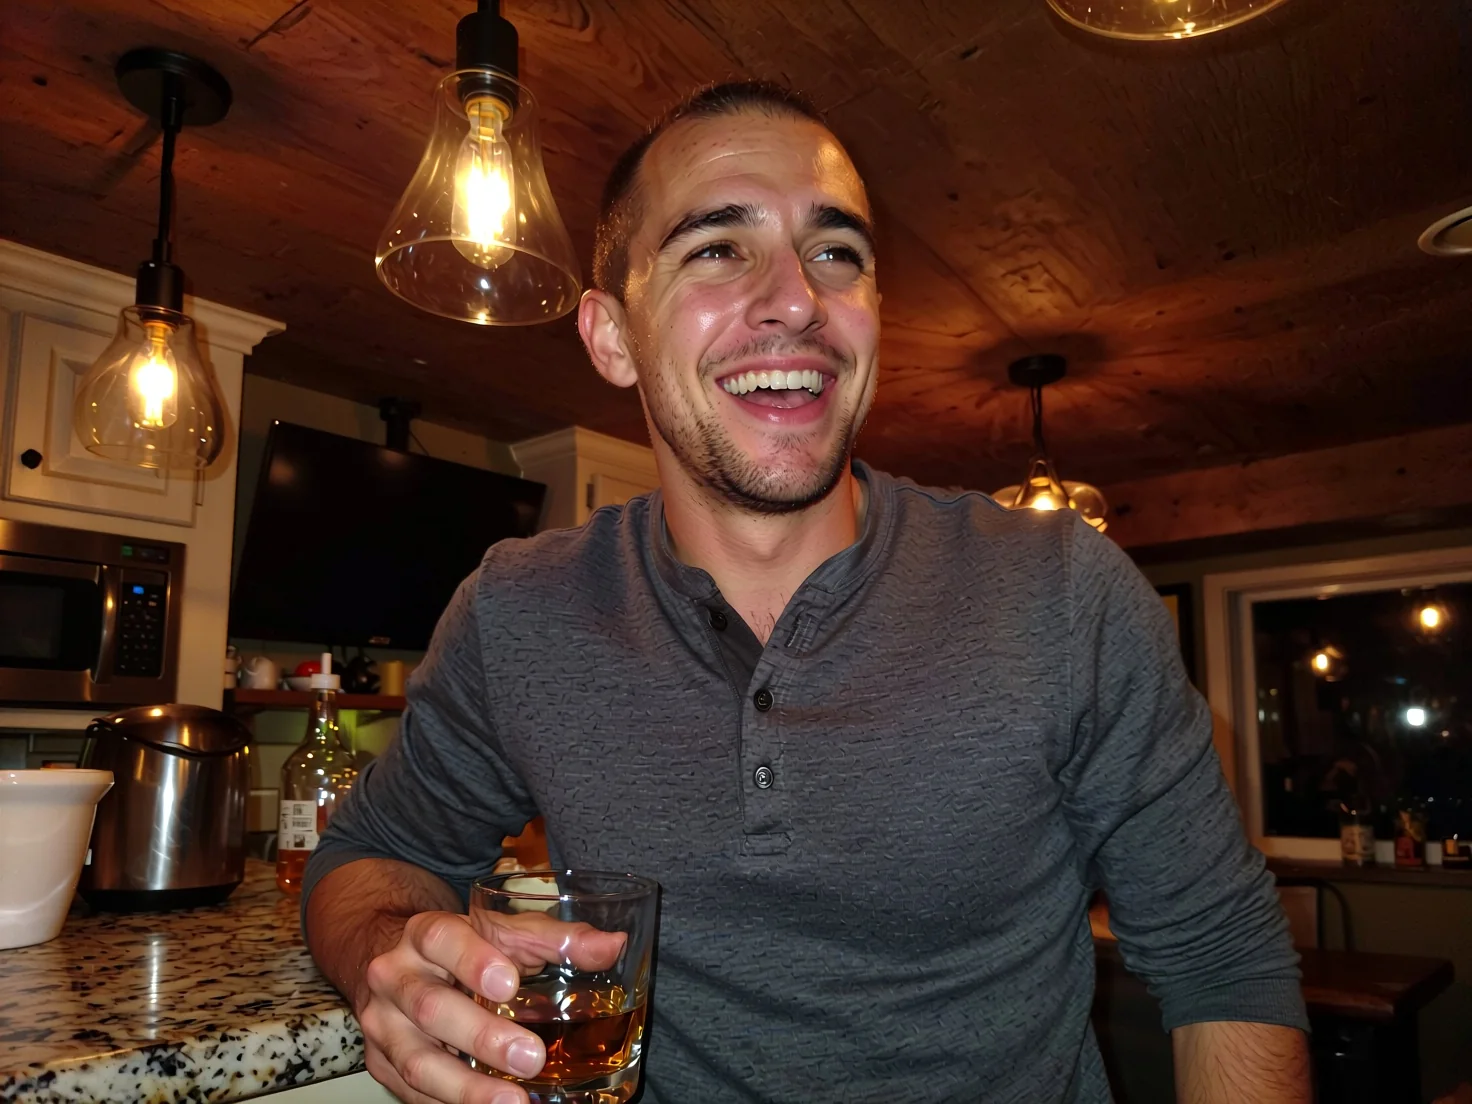
LoRA d’appareil Samsung à 0,8 plus AWPortrait à 0,6, 4:3, seed 1.
Jib Mix Qwen ou Qwen Image 2512 LoRA
Les deux sont des modèles de la famille Qwen-Image avec jusqu’à trois LoRA sur la route LoRA. Ils sont bons pour des tâches différentes.
| Jib Mix Qwen (et version LoRA) | Qwen Image 2512 LoRA | |
|---|---|---|
| Base | Mélange communautaire sur Qwen-Image | Qwen-Image-2512 pour la génération, Qwen-Image-Edit-2511 pour la retouche |
| Tâches | Texte vers image uniquement | Texte vers image et retouche avec 1 à 3 images sources |
| LoRA | Seulement sur la version LoRA, jusqu’à 3 | Jusqu’à 3 sur les deux tâches |
| Rendu de départ | Portraits photographiques, peau naturelle | Usage général ; les adaptateurs fixent le style |
| Vitesse dans nos tests | Médiane 5,8 s (base) | Non mesurée dans cette série |
| Rapports d’aspect | 9, jusqu’à 1536 px | 9 en génération, jusqu’à 1536 px ; la retouche suit la première source |
| Contenu dans nos tests | Échelle rendue sauf L4, atténué | Une exécution de l’échelle du 27 septembre a rendu 15 briefs sur 18 sur chaque route ; les trois ratés étaient de la même classe de scène intime, qu’une LoRA adulte externe a réussie sur chaque tâche le 26 septembre |
Notre règle empirique : choisissez Jib Mix Qwen quand vous voulez un portrait photographique prêt à l’emploi sans chercher de LoRA et que vous acceptez la limite des visages. Choisissez Qwen Image 2512 LoRA quand vous avez besoin de retouche, quand vous possédez déjà une LoRA pour la base 2512, ou quand vous voulez que la base tire son rendu de votre adaptateur. Notre guide sur l’association des poids à la tâche explique la séparation entre 2512 et Edit 2511, et le panorama des LoRA hébergées compare le champ plus large.
Limites
- Visages. Les demandes de visages d’Asie de l’Est sont revenues européennes ou ambiguës sur nos six essais, et de nombreuses seeds convergent vers un visage similaire.
- Gamme de styles. Les prompts et LoRA d’anime et de pixel art ont laissé des photographies. Utilisez un modèle d’illustration pour un rendu dessiné.
- Scènes intimes à deux personnes. Dessinées sans refus, avec une anatomie moins précise.
- Pas de prompt négatif, d’étapes ni de guidance, pas d’image en entrée, pas de retouche.
- Une image par requête.
- Version inconnue. La route hébergée n’indique pas quelle version de Jib Mix Qwen elle fait tourner.
FAQ
Jib Mix Qwen est-il sans censure ?
Oui. La plateforme n’ajoute aucun filtre de contenu. Le contenu à un seul sujet est revenu comme demandé dans notre échelle, et les scènes à deux personnes ont été dessinées sans refus mais avec une anatomie moins précise.
Peut-il produire des visages d’Asie de l’Est ?
Pas de façon fiable. Six requêtes pour des femmes japonaises, coréennes ou d’Asie de l’Est sont toutes revenues européennes ou ambiguës. Faites plutôt varier l’âge, les cheveux et les traits au lieu d’utiliser une nationalité.
Les LoRA de style fonctionnent-elles dessus ?
À peine. Une LoRA d’anime à 0,5, 1 et 2 a laissé l’image en photographie, et à 4 l’image s’est brisée. Les LoRA de photo, d’appareil et de portrait sont celles qui se voient.
Quel scale utiliser pour une LoRA ?
Commencez à 1 et restez entre environ 0,5 et 1,5. Le scale 4, le maximum, a brisé l’image dans notre test.
Une LoRA d’un autre modèle de base fonctionne-t-elle ?
Non. Une LoRA FLUX s’est chargée sans erreur et n’a rien changé. Utilisez des LoRA entraînées pour Qwen-Image ou Qwen-Image-2512.
Dois-je utiliser le point d’accès de base ou le point d’accès LoRA ?
Le point d’accès de base si vous ne chargez pas de LoRA. Sans LoRA, la version LoRA a donné une sortie identique au pixel près à celle de la base sur la même seed dans nos vérifications.
Peut-il rendre du texte dans l’image ?
Des mots courts, oui. Notre « OPEN LATE » sur l’ardoise s’est lu correctement sur les deux seeds. Gardez l’expression courte et vérifiez les lettres avant de publier.
Puis-je retoucher une photo existante avec lui ?
Non. Les deux points d’accès sont uniquement texte vers image. Pour retoucher avec des images sources, utilisez Qwen Image 2512 LoRA.