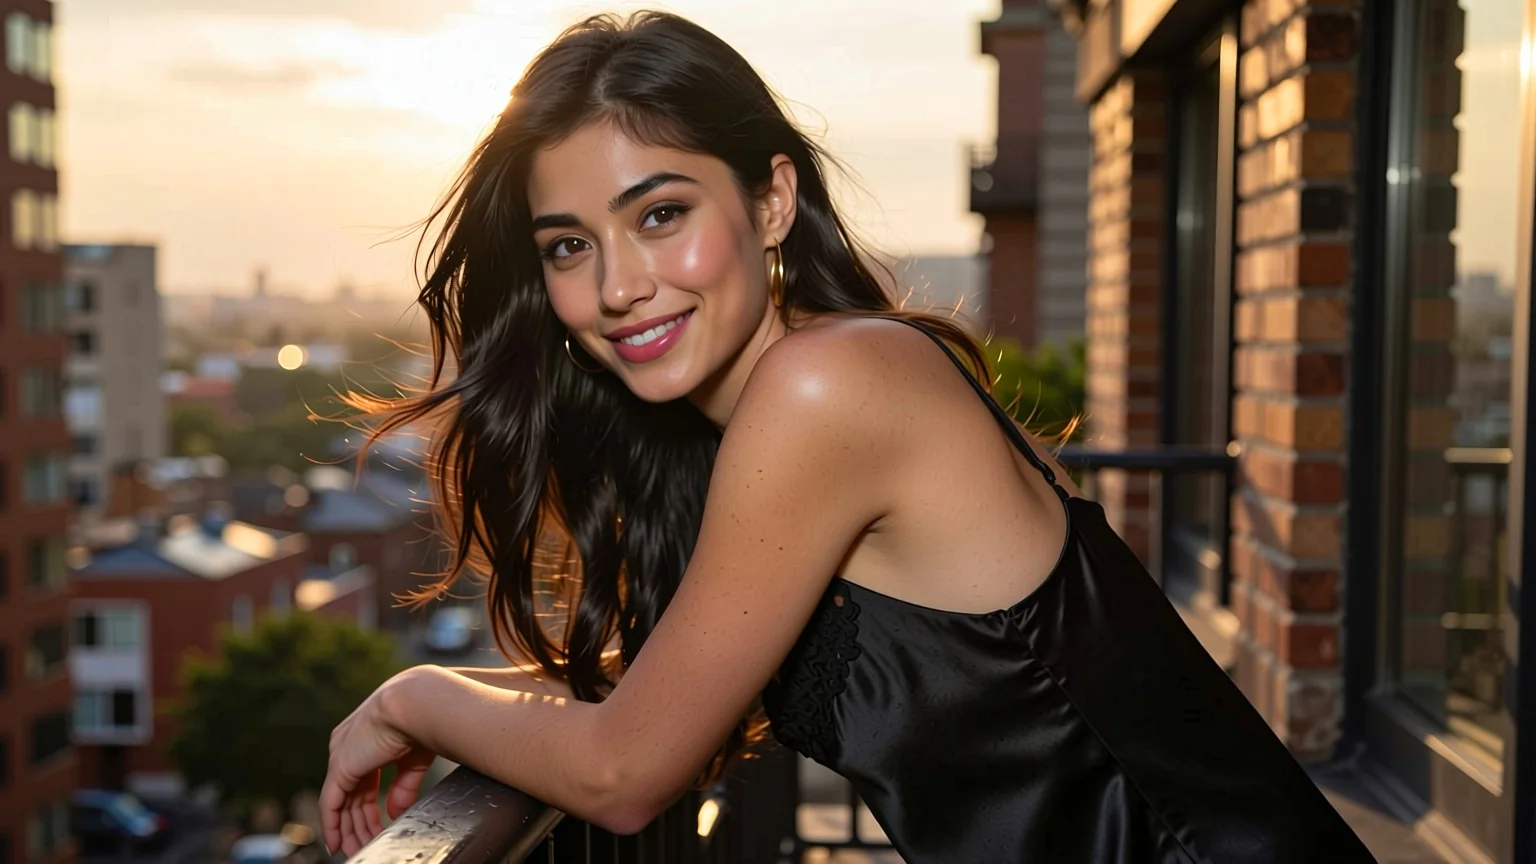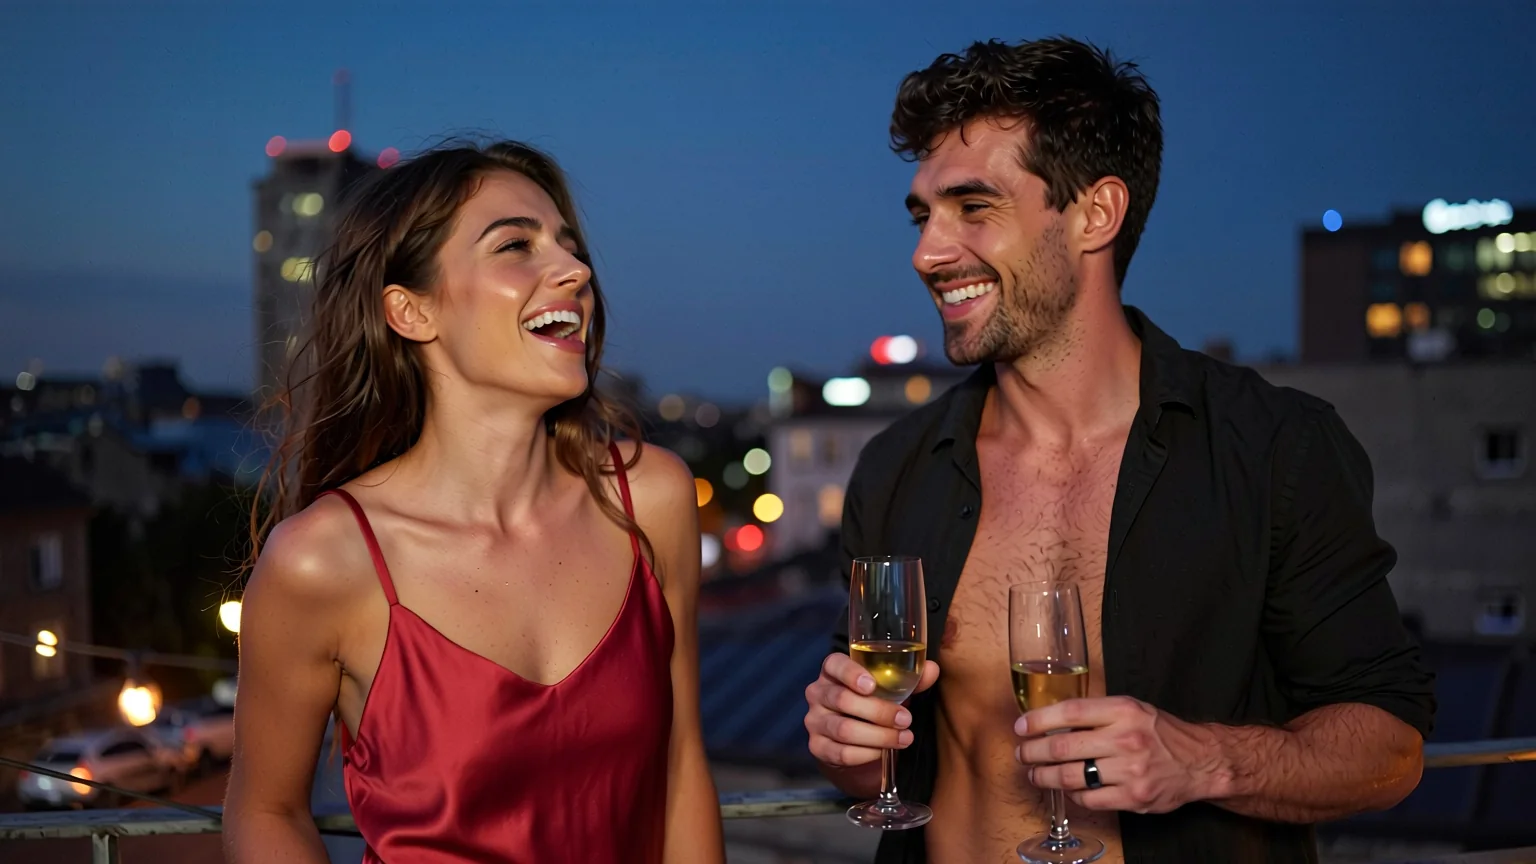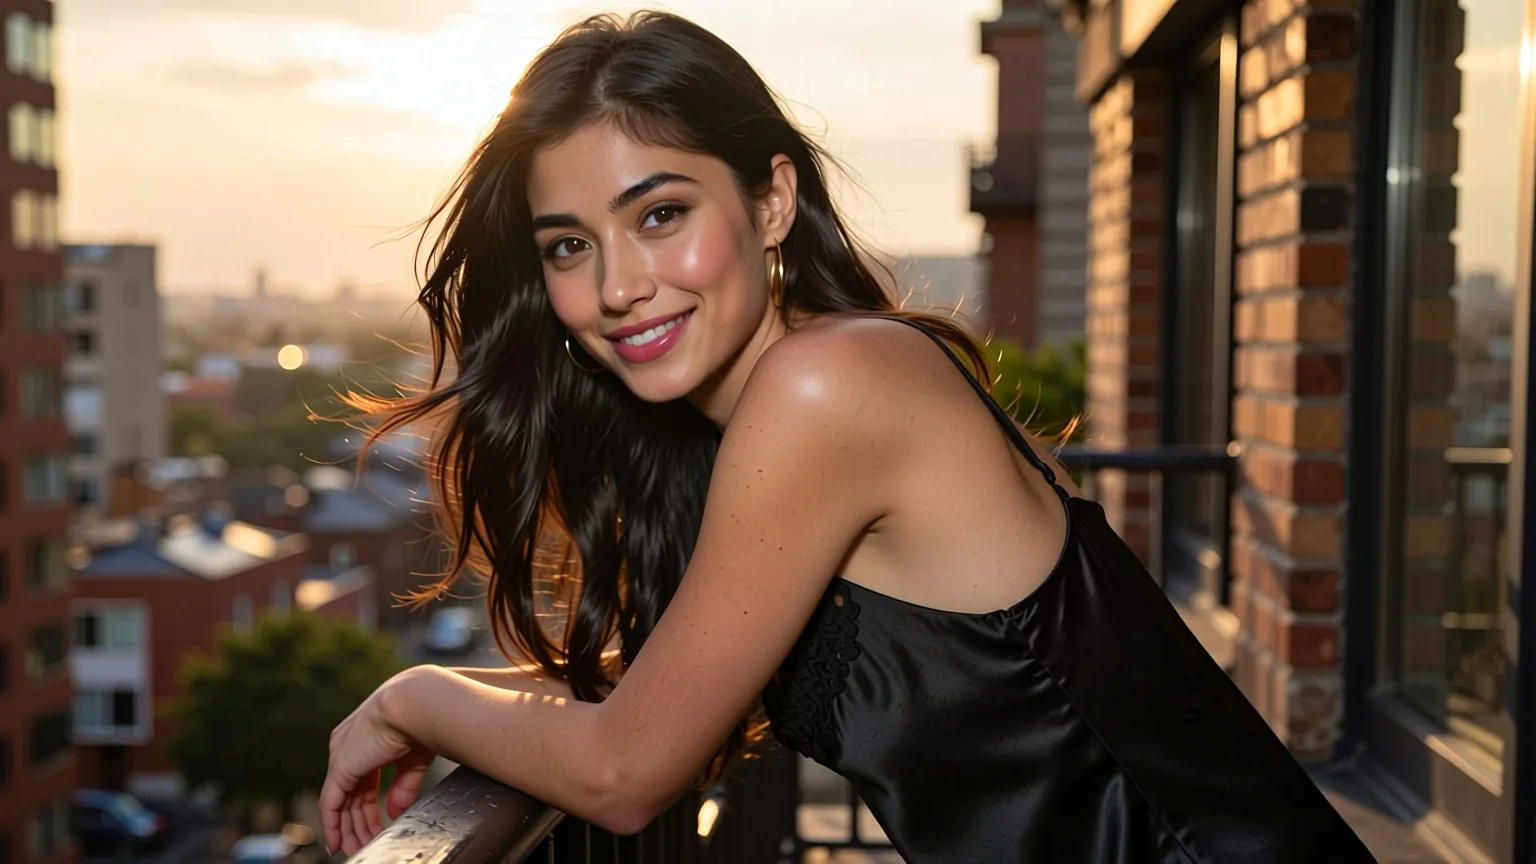
O Jib Mix Qwen é um modelo rápido de retratos fotorrealistas: nos nossos testes, uma imagem levou uma mediana de 5,8 segundos, e LoRAs de foto e de câmera mudaram o visual, enquanto LoRAs de estilo mal o alteraram. Ele tem dois pontos fracos que queremos que você conheça antes de construir algo sobre ele. Seis requisições de uma mulher japonesa, coreana ou do leste asiático voltaram todas europeias ou ambíguas, e cenas íntimas a dois foram desenhadas sem recusa, mas com anatomia confusa.
Testamos o Jib Mix Qwen e a sua versão com LoRA em 5 de outubro de 2026. O Jib Mix é uma série de checkpoints da comunidade, do criador J1B, e este é uma mistura de ajustes finos e LoRAs de Qwen-Image construída sobre o Qwen-Image de 20 bilhões de parâmetros da Alibaba. Todos os prompts impressos abaixo são cenas do dia a dia com adultos vestidos.
Visão geral
| Jib Mix Qwen e Jib Mix Qwen LoRA (testados em 5 de outubro de 2026) | |
|---|---|
| Criador e base | J1B; mistura de ajustes finos e LoRAs de Qwen-Image sobre o Qwen-Image (20B, codificador de texto Qwen2.5-VL) |
| Nomes de modelo na API | j1b/jib-mix-qwen-image/text-to-image e j1b/jib-mix-qwen-image-lora/text-to-image |
| Campos públicos | prompt (até 5.000 caracteres), aspect_ratio, output_format, seed; a versão com LoRA acrescenta loras |
| Proporções | 9, até 1536 pixels no lado maior: 1328 x 1328 em 1:1, 1536 x 864 em 16:9 |
| Saída | Uma imagem por requisição em JPEG (padrão), PNG ou WebP |
| Velocidade nos nossos testes | Base: de 3,7 a 48 segundos em 30 execuções, mediana de 5,8, 21 de 30 abaixo de 10. Versão com LoRA: de 3,2 a 36 segundos em 38 execuções, mediana de 5,6 |
| Política de conteúdo | Sem censura, sem filtro de conteúdo; conteúdo de um só sujeito voltou como pedido, cenas a dois foram desenhadas sem recusa, porém com menos precisão |
| Não faz | Prompts negativos, passos, guidance, entrada de imagem, edição, mais de uma imagem por requisição |
O que é e qual é a versão
As notas do criador para a primeira versão dizem que ele mistura modelos Qwen com LoRAs favoritas em pesos precisos. A página no Civitai lista seis versões entre setembro de 2025 e março de 2026. A nota da v4.0, de 15 de outubro de 2025, diz "much more natural pretty faces (much better at Asian faces)". A nota da v6.0, de março de 2026, diz "more European faces and fewer Asian by default" e "not quite as good at NSFW as V5".
A rota hospedada não diz qual versão roda. A descrição dela ecoa a nota da v4.0, mas as nossas saídas pendem para o europeu, o que combina com a v6, e a rota foi atualizada recentemente, então não podemos descartar uma troca. Sinalizamos isso como não verificado em vez de adivinhar. O que podemos relatar é o que a rota faz, e é isso o resto deste artigo.
Prompts para retratos
O modelo gosta de um briefing de fotógrafo em frases completas. O retrato na janela abaixo usou idade, cabelo, sardas, roupa, pose e luz, com uma abertura fotográfica curta:
Photorealistic photo, natural skin texture. A 32-year-old woman with a short black bob, light freckles and minimal makeup sits on a windowsill in a cream silk camisole, knees drawn up, holding a mug of coffee. Soft morning light, sheer curtains, shallow depth of field.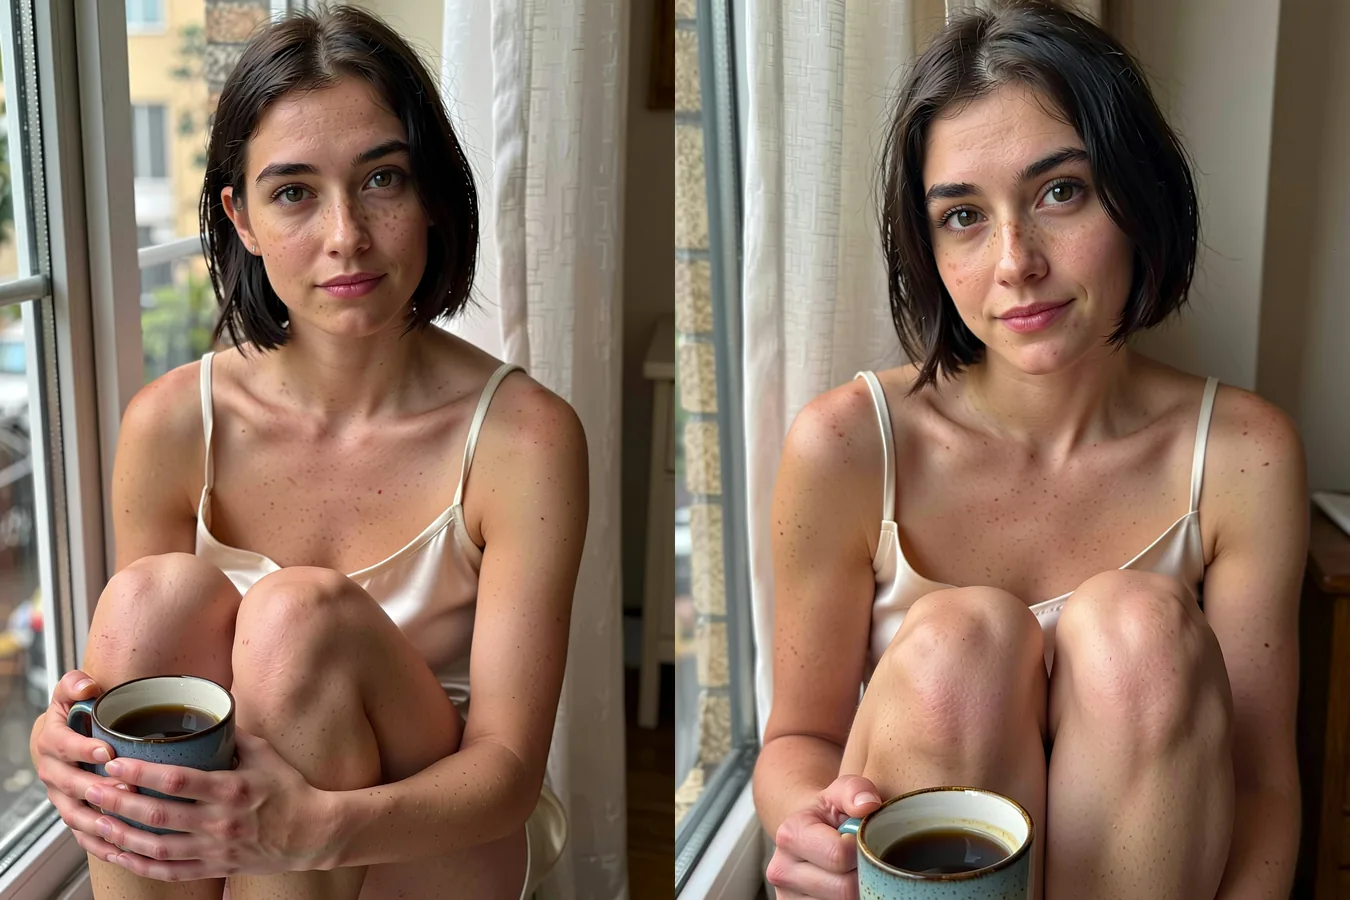
Seeds 1 e 2 de uma versão deste prompt que pedia uma mulher japonesa. Veja a seção de rostos abaixo. 3:4, texto para imagem.
Hábitos que ajudaram nas nossas execuções:
- Abra com uma deixa fotográfica. "Photorealistic photo, natural skin texture" ou "35mm film look" ou "phone photo with flash" orienta o visual.
- Descreva a pessoa, não uma nacionalidade. Idade, comprimento e cor do cabelo, sardas, barba e a expressão mudaram os rostos de forma confiável. Uma nacionalidade, não.
- Cite palavras curtas. O nosso prompt do quadro-negro pedia uma placa com "OPEN LATE" em letras de giz brancas. O quadro voltou com essas palavras nos dois seeds. Fique em uma frase curta e confira as letras.
- Fixe o seed e mude uma coisa só. Luz, roupa ou sensação de lente, uma de cada vez. Os seeds tornam as execuções comparáveis, mas não prometem pixels idênticos.
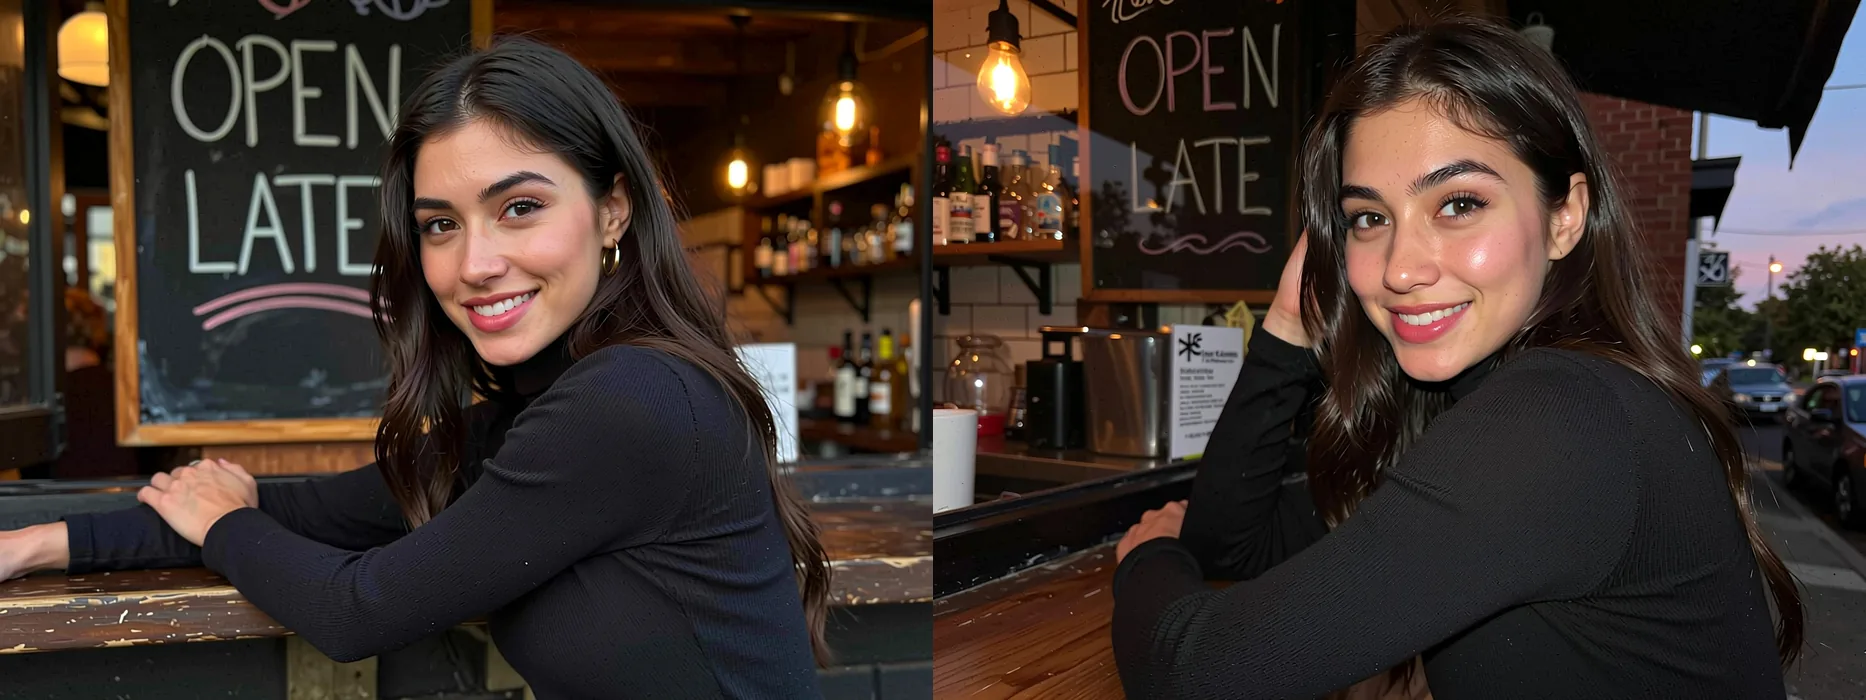
Seeds 1 e 2 do prompt do quadro-negro (aqui pedindo uma mulher coreana), 4:3. A placa diz "OPEN LATE" nos dois.
Proporções e tamanhos
Não há campo de tamanho. Você escolhe uma de nove proporções, cada uma associada a um tamanho fixo. Rodamos cada proporção uma vez nos dois endpoints, e todas as saídas voltaram exatamente nos pixels pedidos. O lado maior para em 1536.
| Proporção | Tamanho | Proporção | Tamanho |
|---|---|---|---|
| 1:1 | 1328 x 1328 | 21:9 | 1536 x 656 |
| 4:3 | 1472 x 1104 | 9:21 | 656 x 1536 |
| 3:4 | 1104 x 1472 | 16:9 | 1536 x 864 |
| 3:2 | 1536 x 1024 | 9:16 | 864 x 1536 |
| 2:3 | 1024 x 1536 |
Escolha conforme o trabalho. 3:4 e 2:3 servem para retratos, 16:9 e 21:9 servem para fotogramas de cinema e banners. Um retrato fechado em 2:3 fica assim:
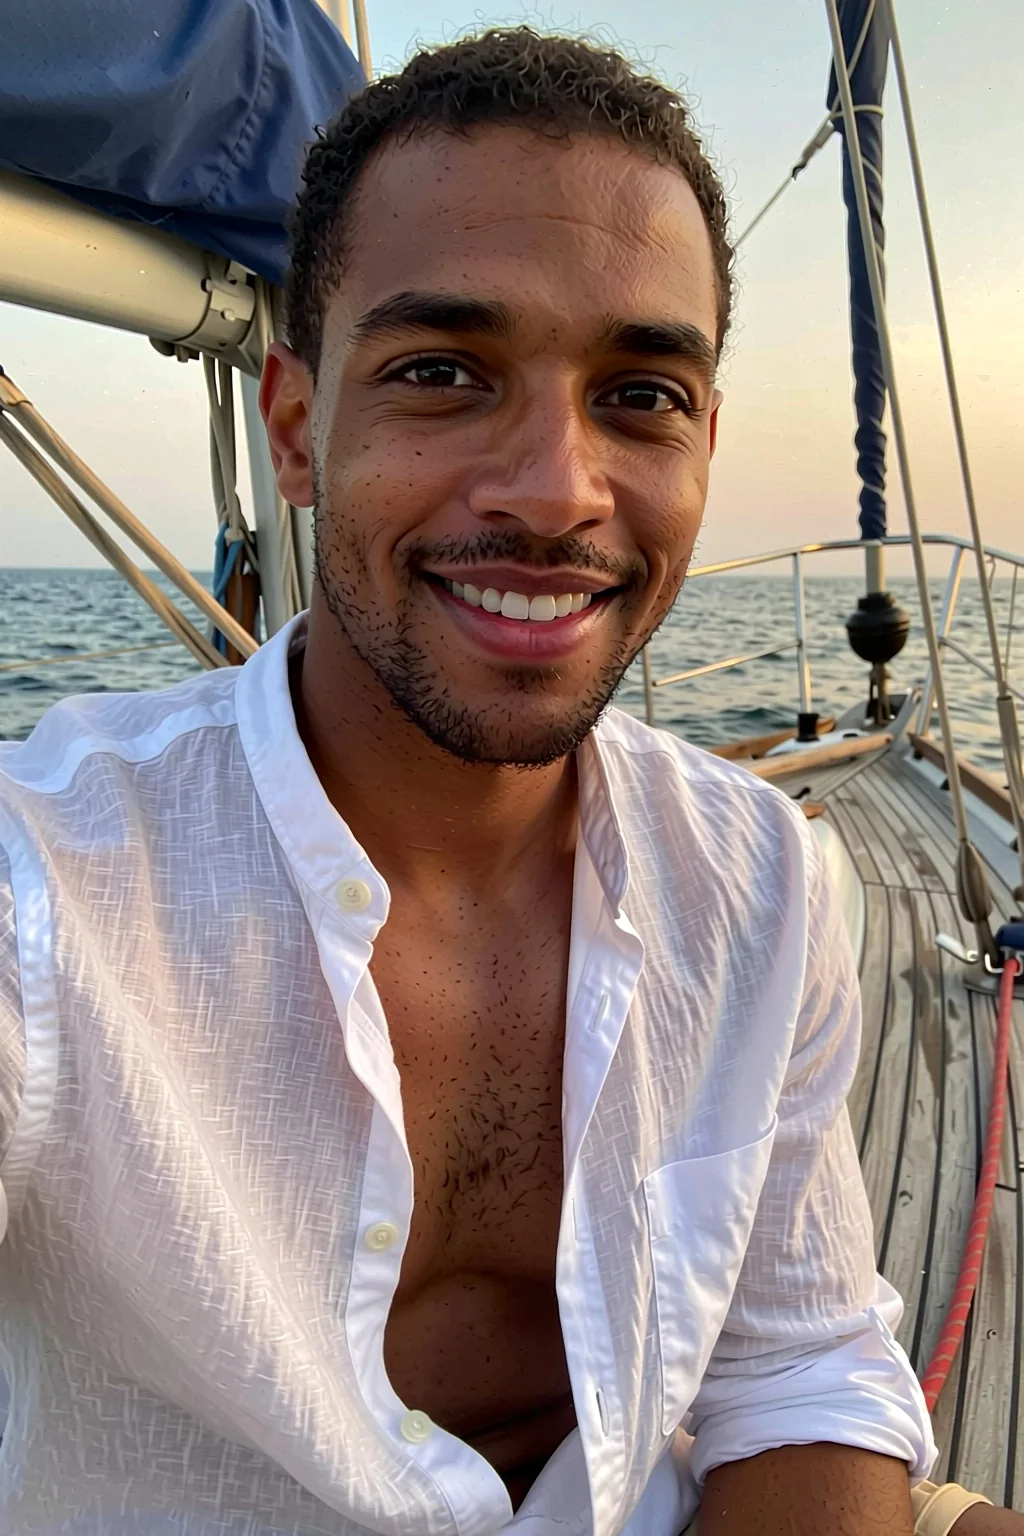
Exemplo publicado: um homem de 35 anos em um veleiro na hora dourada, 2:3, seed 1.
Photorealistic photo, natural skin texture. A 35-year-old Black man with a trimmed beard and a warm smile, open white linen shirt, sits on the deck of a sailboat at golden hour. Sea spray, wind in his shirt, shallow depth of field.Velocidade
O tempo de modelo do endpoint base variou de 3,7 a 48 segundos em 30 execuções, com mediana de 5,8 segundos e 21 de 30 abaixo de dez. A versão com LoRA foi quase igual: de 3,2 a 36 segundos em 38 execuções, mediana de 5,6, e uma requisição que carregava um arquivo de LoRA pela primeira vez levou de 10 a 25 segundos. É rápido o bastante para iterar em um retrato.
Duas pessoas no mesmo quadro
Cenas com duas pessoas vestidas funcionaram. Este prompt de fotograma desenhou um casal rindo sob um guarda-chuva nos dois seeds, cada pessoa com o seu casaco e o seu lugar no quadro:
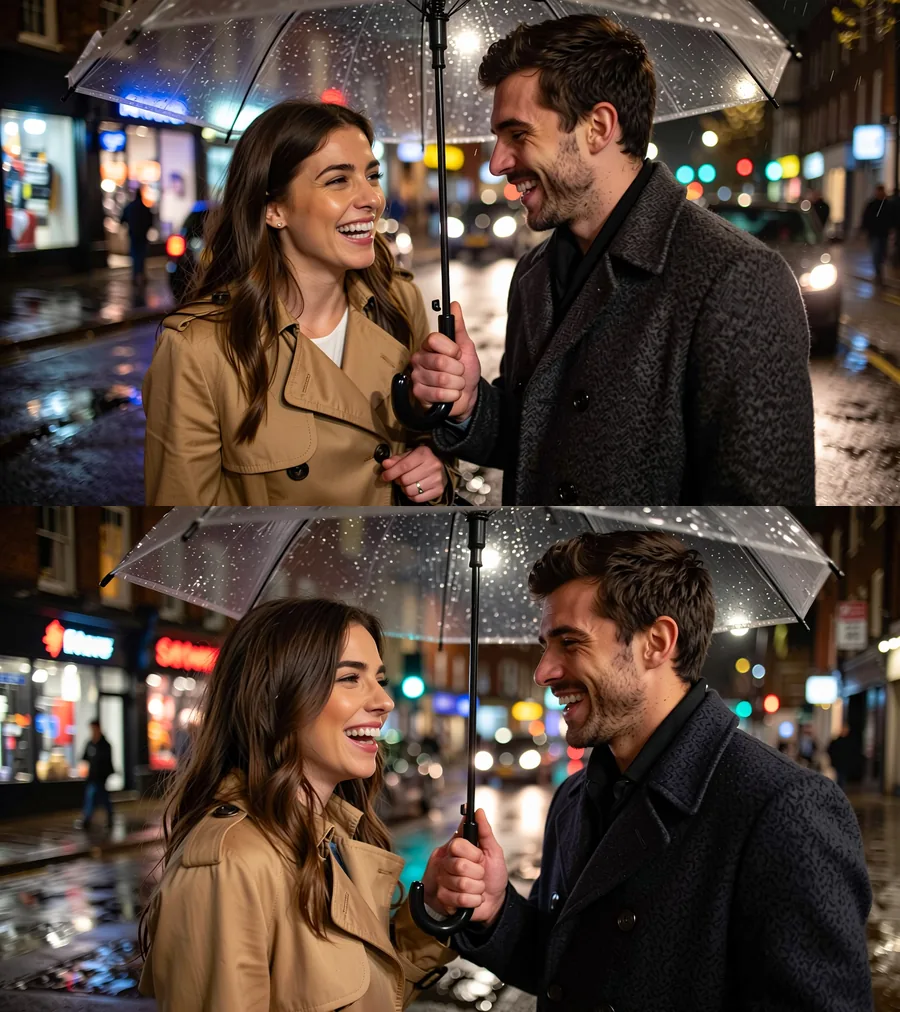
Seeds 1 e 2 do prompt do guarda-chuva, 16:9, empilhados. O modelo deu a cada pessoa um casaco distinto e manteve o bokeh.
Photorealistic film still. A woman and a man in their early thirties laugh together under one clear umbrella on a rainy city street at night, she in a camel trench coat, he in a dark wool coat. Shop lights blur into colorful bokeh and reflect on the wet asphalt.Dê a cada pessoa um lugar claro no quadro e uma roupa só. Quando mãos ou membros se fundirem, rode um novo seed.
Até onde ele vai
A plataforma não adiciona nenhum filtro de conteúdo. Rodamos um prompt por degrau da nossa escada de cinco níveis em 3:4, seed 1, com os personagens declarados como adultos, e olhamos todas as imagens.
| Nível | Resultado no endpoint base |
|---|---|
| L1 Sugestivo (lingerie, uma alcinha escorregando) | Entregue |
| L2 Temas maduros | Entregue, e nas nove proporções (9 de 9) nos dois endpoints |
| L3 Forte, feminina e masculina | Entregue |
| L4 Intenso (uma cena íntima entre dois adultos) | Suavizado: os três seeds desenharam dois adultos, mas a anatomia ficou confusa e só um dos três lembrava a cena que pedimos |
| L5 Extremo (contenção consensual entre adultos; gore cinematográfico) | Os dois entregues |
Não houve recusa em lugar nenhum. O L4 é a constatação honesta: o modelo não recusa, simplesmente não consegue desenhá-lo com limpeza. Acrescentar uma LoRA adulta de Qwen-Image mudou a composição para um casal posado e ainda assim não produziu a cena. Então o limite prático é este: conteúdo de um só sujeito voltou como pedido, e cenas a dois foram desenhadas sem recusa, mas com anatomia menos precisa. Se o seu trabalho depende do L4, teste primeiro a rota exata e compare com o Qwen Image 2512 LoRA mais abaixo.
O problema dos rostos
Pedimos duas vezes uma "mulher japonesa de 32 anos", duas vezes uma "mulher com traços do leste asiático" e duas vezes uma "mulher coreana de 30 anos". Os seis rostos saíram europeus ou ambíguos.
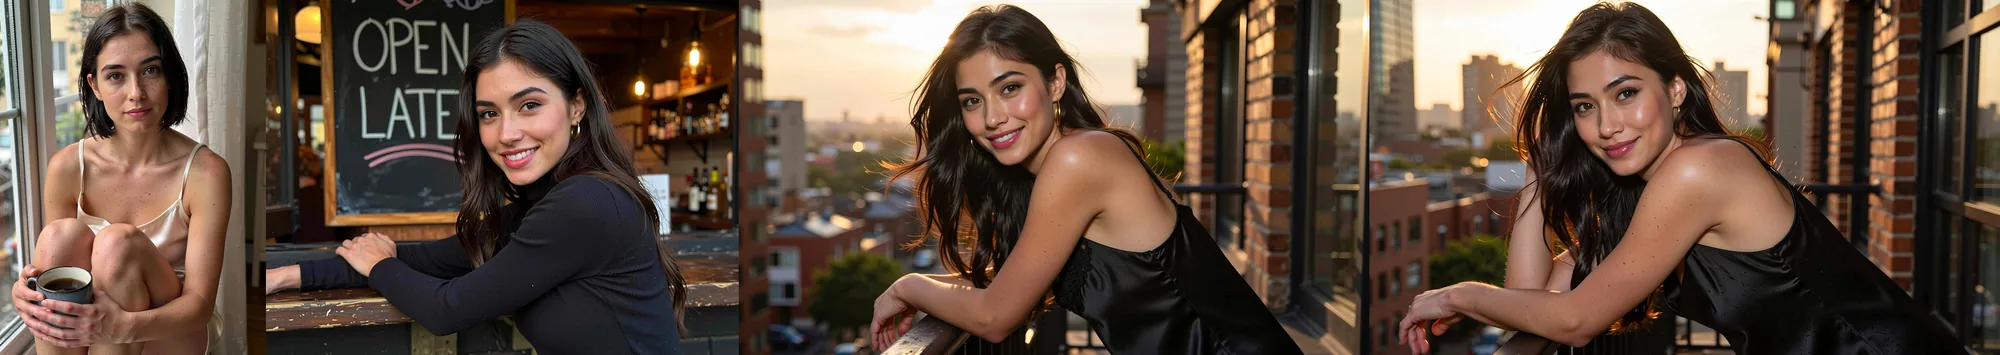
Da esquerda para a direita: "mulher japonesa" seed 1 (3:4), "mulher coreana" seed 1 (4:3), "traços do leste asiático" seeds 1 e 2 (16:9).
Muitos seeds também se fixam em um rosto parecido de cabelo escuro, o hábito do "mesmo rosto" que usuários do Civitai relatam nas primeiras versões. Não escolha este modelo se você precisa de rostos do leste asiático marcados. Se continuar com ele, varie idade, cabelo, sardas, barba e a expressão de forma explícita e não dependa de uma palavra de nacionalidade. Os exemplos publicados na página do modelo foram escritos sem nacionalidade.
Quais LoRAs o mudam
A versão com LoRA aceita até três LoRAs por requisição, cada uma um link direto para um arquivo .safetensors com um scale de 0 a 4. Sem nenhuma LoRA carregada, ela deu saída idêntica pixel a pixel à do endpoint base com o mesmo seed nas nossas verificações; portanto, use o endpoint base a menos que pretenda carregar uma. Um link para a página web de um repositório falha com uma mensagem pedindo o link direto de download, e um repositório restrito falha com um erro HTTP 401.
LoRAs de Qwen-Image carregam, do Hugging Face ou de um link direto do Civitai, e as LoRAs de Qwen-Image-2512 também. O que elas fazem com a imagem depende do tipo.
LoRAs de foto e de câmera aparecem. Com um prompt e um seed, quatro LoRAs fotográficas mudaram o rosto e a luz de forma visível, mas não drástica.
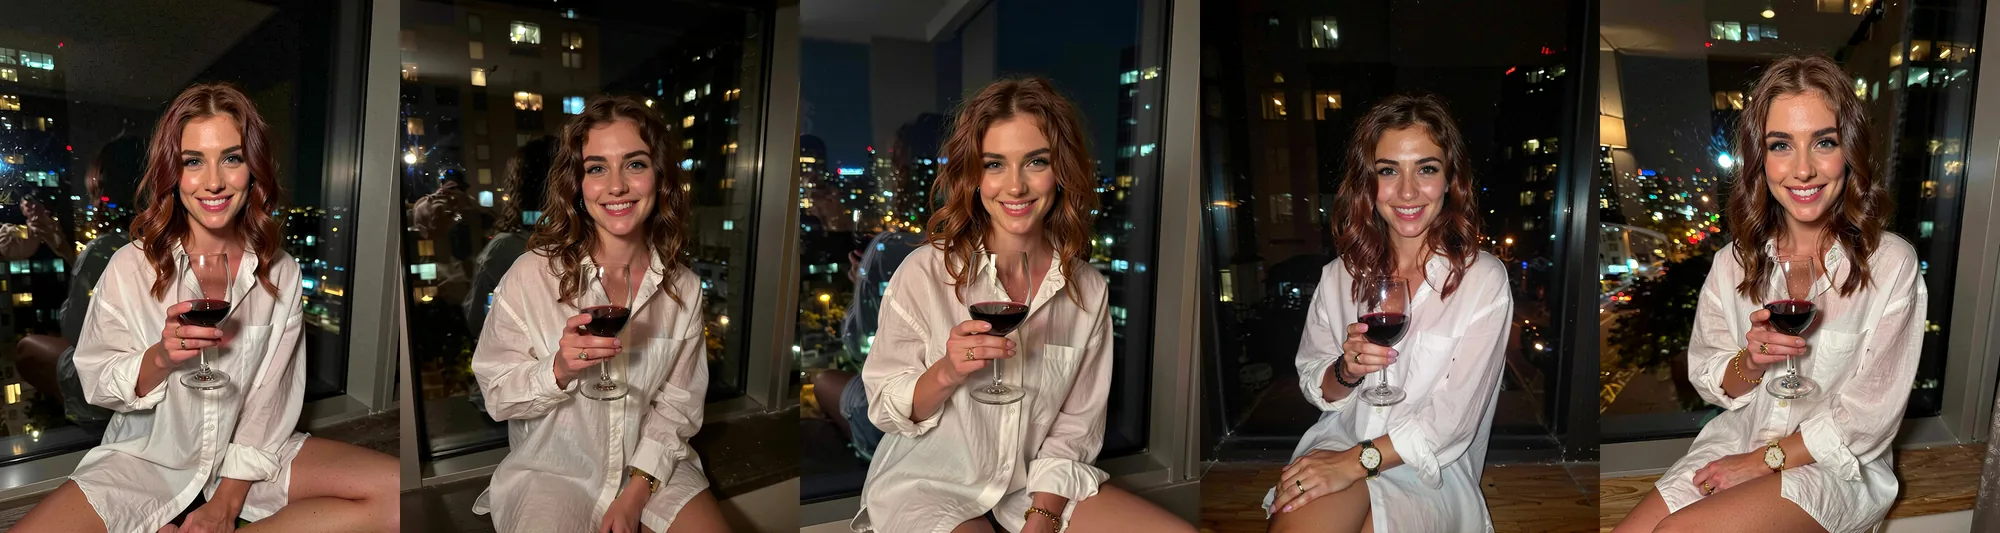
Da esquerda para a direita: sem LoRA; uma LoRA de câmera de celular (Samsung UltraReal); uma LoRA de retoque de retrato (AWPortrait-QW); uma LoRA de foto com flash (Lenovo); uma LoRA de realismo (flymy-ai). Mesmo prompt, seed 21, 3:4, todas com scale 1.
| Tipo de LoRA | O que vimos | Veredito |
|---|---|---|
| Câmera de celular (Samsung UltraReal) | Cabelo mais cacheado, luz mais dura, clima de foto espontânea | Visível |
| Retoque de retrato (AWPortrait-QW) | Um visual de retrato mais retocado | Visível, sutil |
| Foto com flash (Lenovo) | Quadro mais escuro, iluminado por flash | Visível |
| Realismo (flymy-ai) | Rosto e luz mudaram | Visível, sutil |
| Duas combinadas (Samsung 0.8 mais AWPortrait 0.6) | Funcionou | Duas LoRAs em uma requisição |
Dois exemplos publicados mostram as LoRAs de câmera e de retoque em ação:
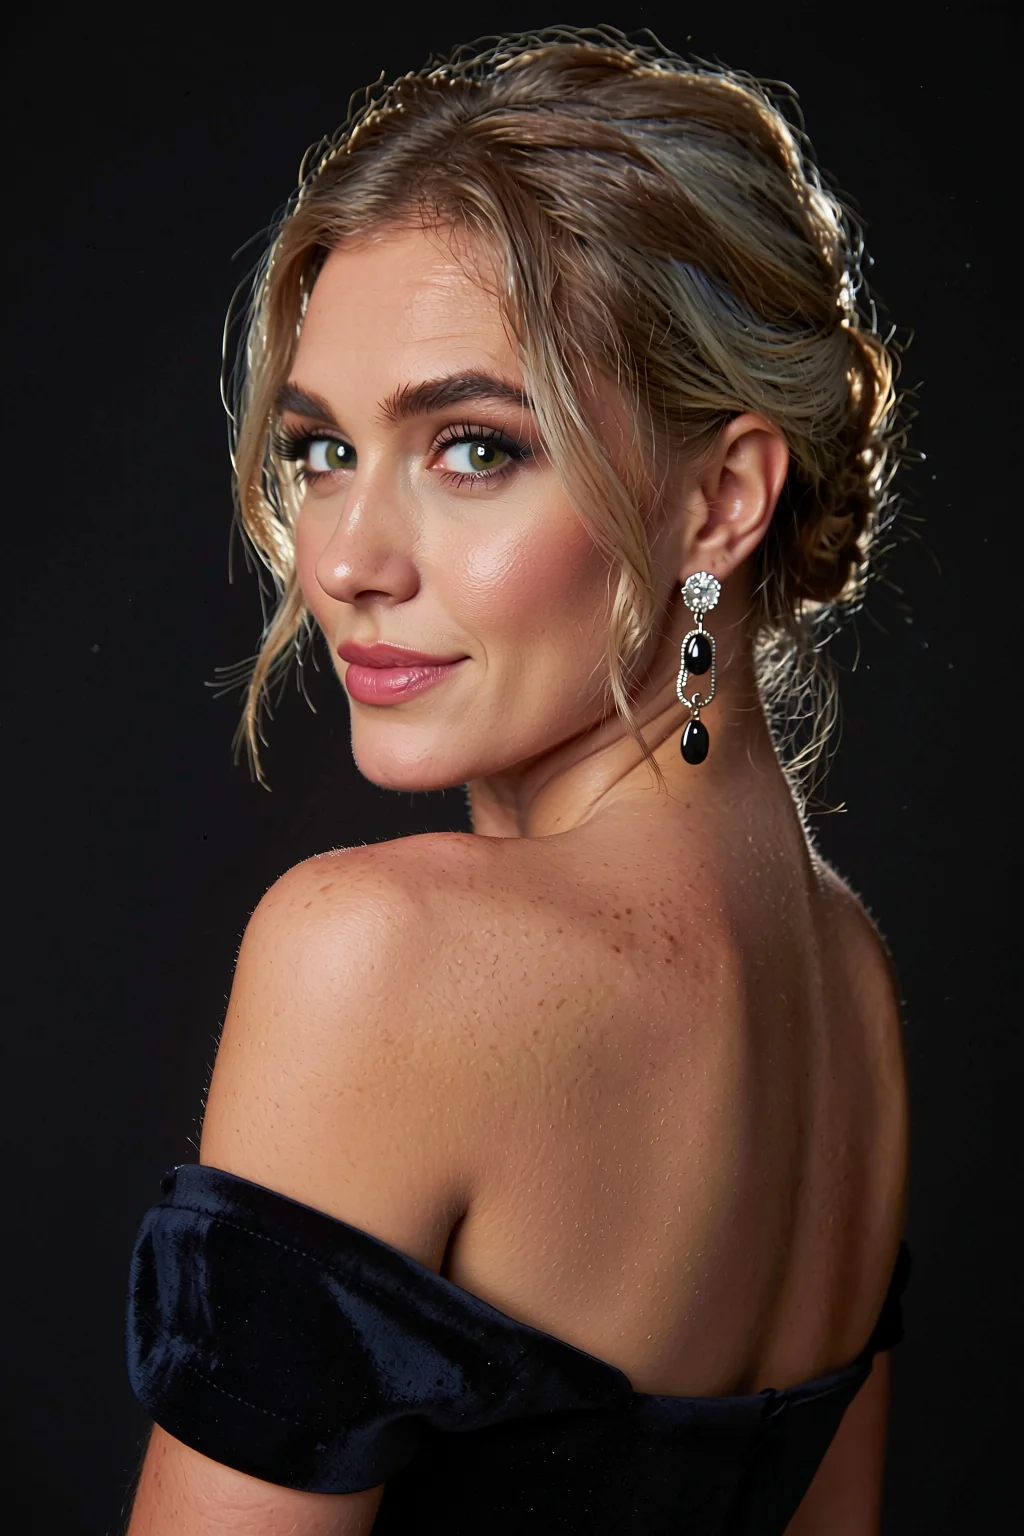
LoRA de retoque de retrato com scale 1, 2:3, seed 1.
Studio portrait photo. A 36-year-old woman with silver-blonde hair pinned up wears an off-shoulder black velvet gown and long earrings, looking over her bare shoulder at the camera. Soft key light, dark backdrop, rim light on her hair.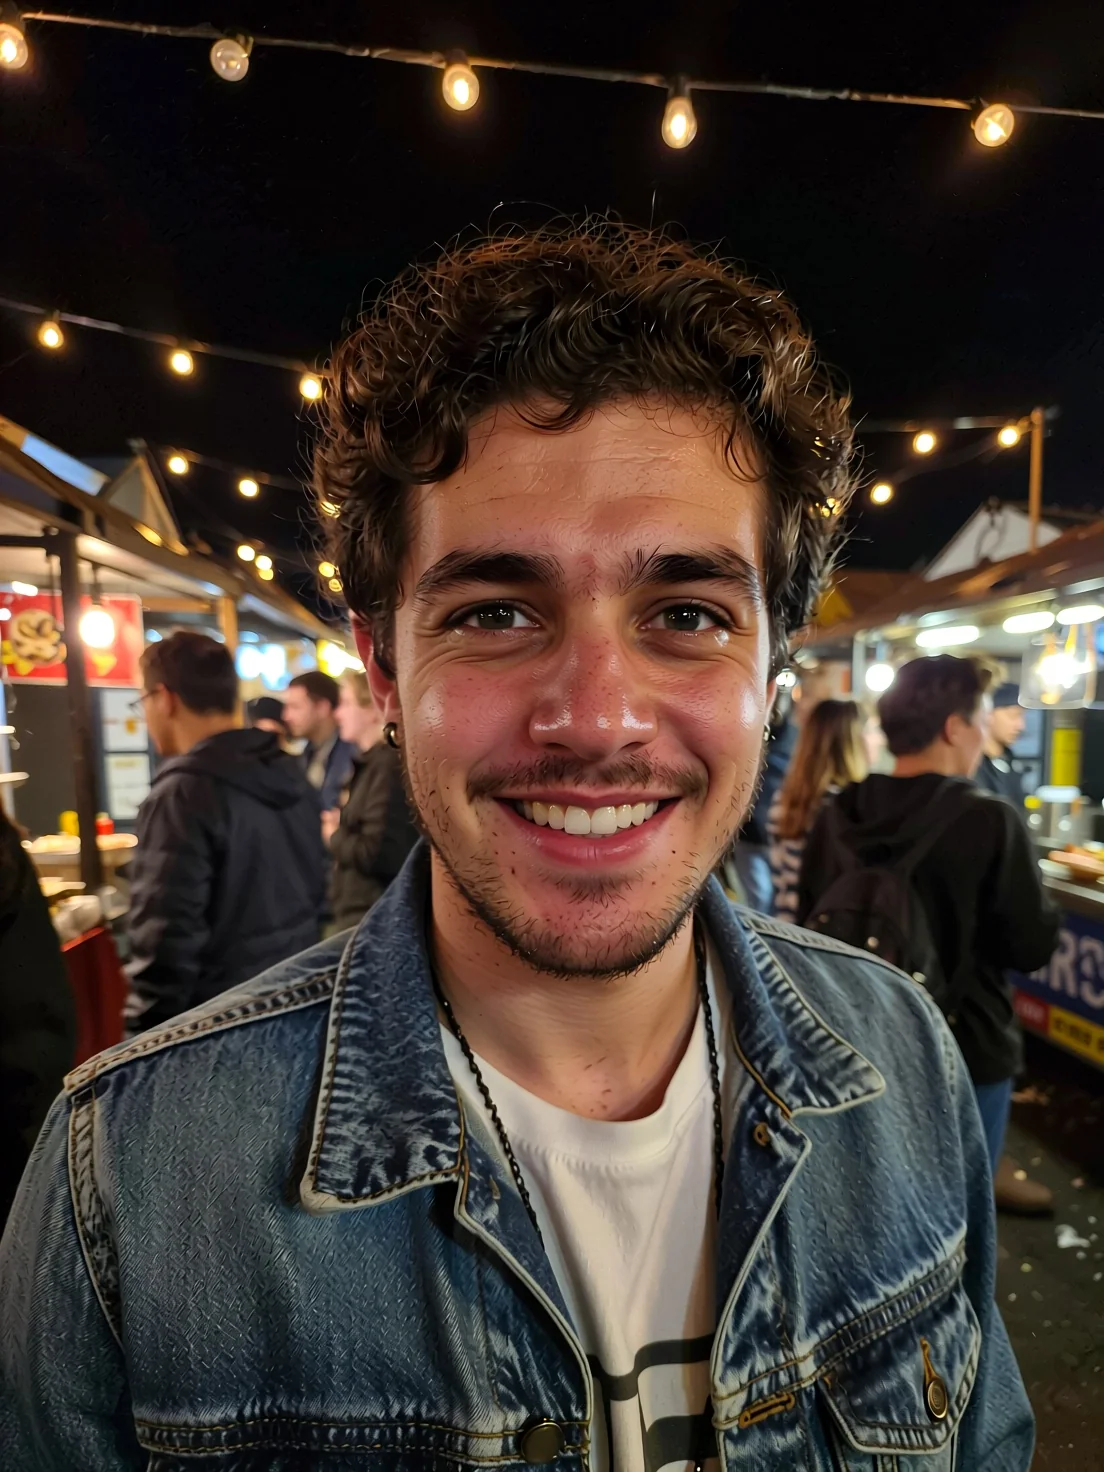
LoRA de câmera de celular com scale 1, 3:4, seed 1. Prompt: "Amateur phone photo with on-camera flash. A 31-year-old man with curly dark hair and a short beard in a denim jacket over a white T-shirt grins at the camera at a crowded night market, string lights and food stalls behind him."
LoRAs de estilo mal o movem. Pedimos um retrato em "Japanese modern anime style". O checkpoint base ignorou a frase, e uma LoRA de anime para Qwen-Image também, com scale 0.5, 1 e 2: os pixels mudaram, mas a imagem continuou sendo uma fotografia. Com scale 4 a imagem se desfez em um close distorcido com olhos exagerados. Uma LoRA de pixel art de Qwen-Image-2512 mudou pixels e não produziu nenhum visual de pixel art.
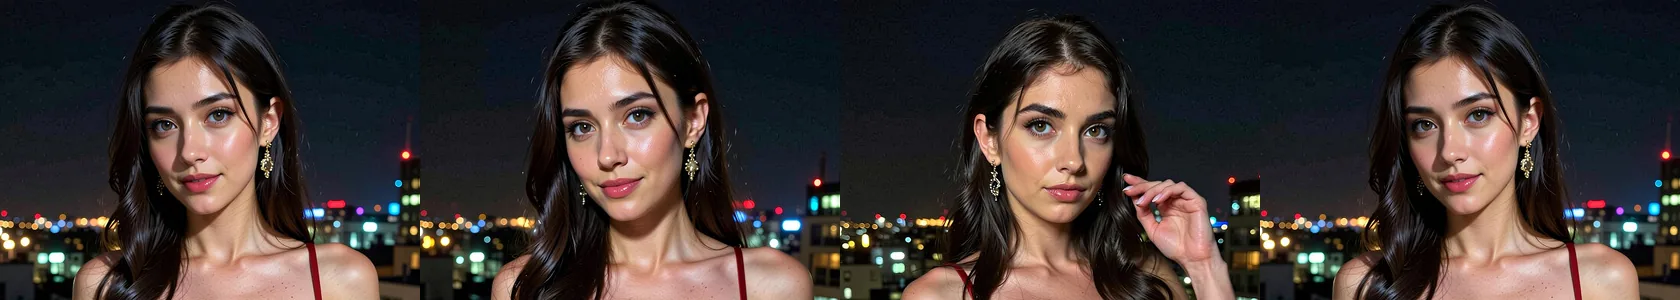
Recortes de rosto, da esquerda para a direita: sem LoRA; uma LoRA de anime com 0.5; a mesma com 1; uma LoRA de FLUX com 1. Mesmo prompt, seed 11, 3:4. As quatro continuam fotografias.
Uma LoRA de outro modelo base não faz nada. Uma LoRA de FLUX carregou sem erro e deu saída idêntica pixel a pixel à de nenhuma LoRA. Uma resposta bem-sucedida não significa que o arquivo combinava com o modelo.
A faixa útil de scale foi de cerca de 0.5 a 1.5. Duas LoRAs combinadas funcionaram bem:
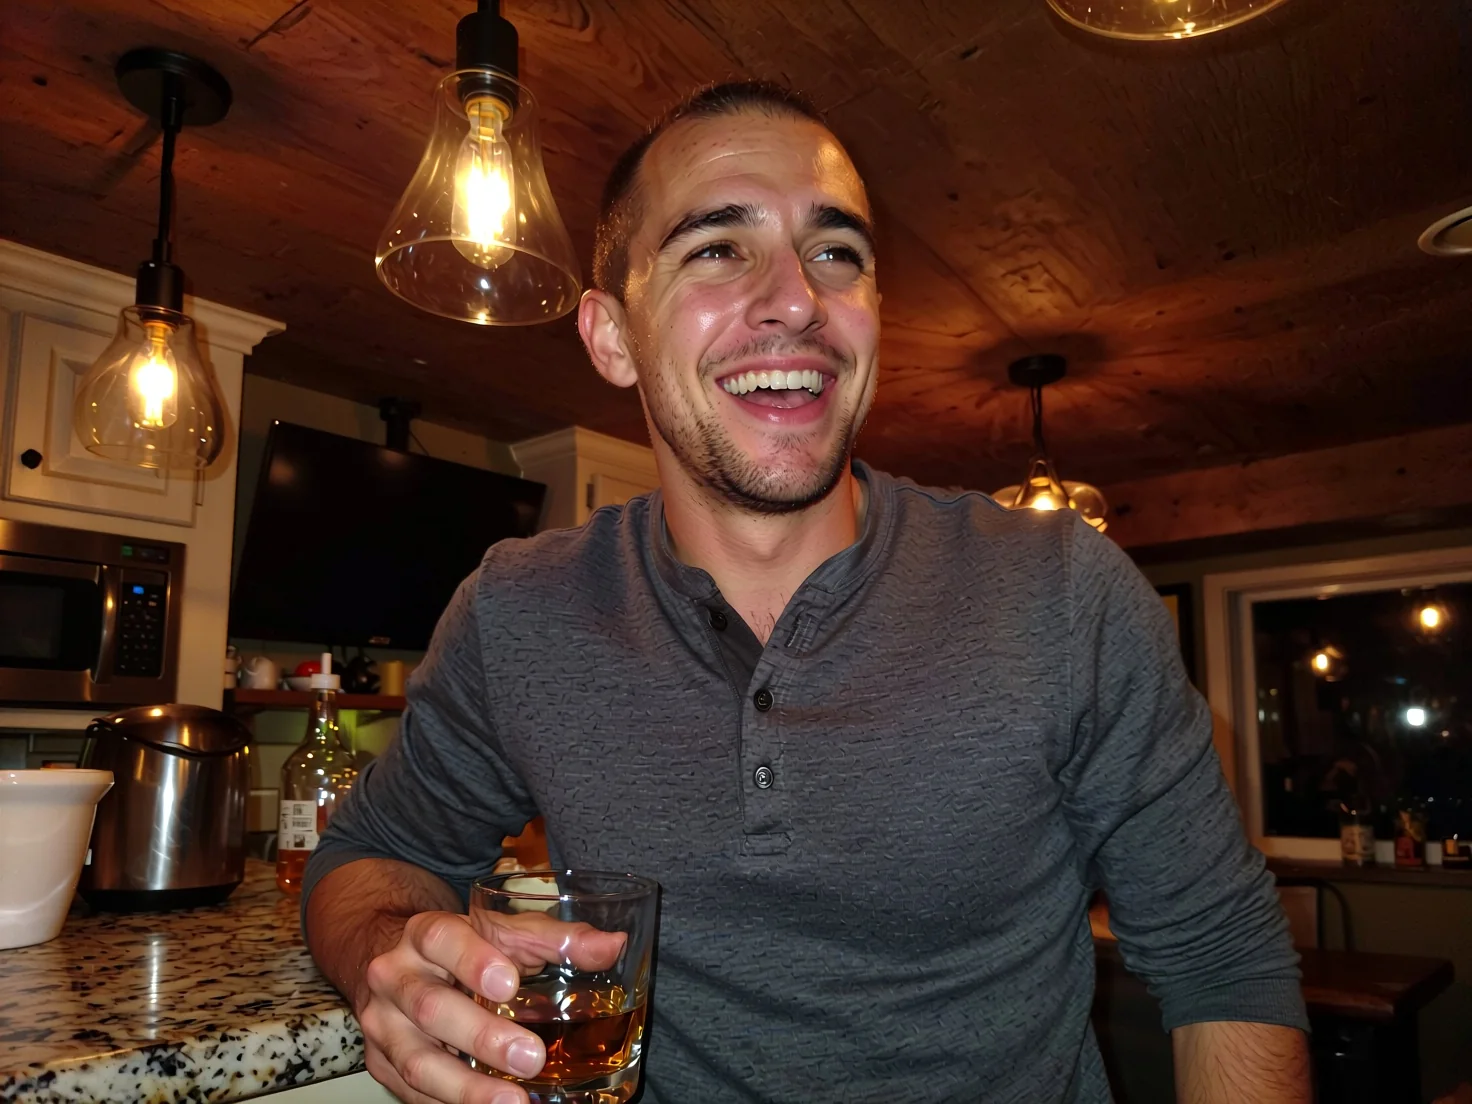
LoRA de câmera Samsung com 0.8 mais AWPortrait com 0.6, 4:3, seed 1.
Jib Mix Qwen ou Qwen Image 2512 LoRA
Os dois são modelos da família Qwen-Image com até três LoRAs na rota com LoRA. Eles são bons em trabalhos diferentes.
| Jib Mix Qwen (e versão com LoRA) | Qwen Image 2512 LoRA | |
|---|---|---|
| Base | Mistura da comunidade sobre o Qwen-Image | Qwen-Image-2512 para geração, Qwen-Image-Edit-2511 para edição |
| Tarefas | Somente texto para imagem | Texto para imagem e edição com 1 a 3 imagens de origem |
| LoRAs | Só na versão com LoRA, até 3 | Até 3 nas duas tarefas |
| Visual de fábrica | Retratos fotográficos, pele natural | Uso geral; os adaptadores definem o estilo |
| Velocidade nos nossos testes | Mediana de 5,8 s (base) | Não medida nesta rodada |
| Proporções | 9, até 1536 px | 9 para geração, até 1536 px; a edição segue a primeira origem |
| Conteúdo nos nossos testes | A escada foi entregue, exceto o L4, suavizado | Uma rodada da escada em 27 de setembro entregou 15 de 18 pedidos em cada rota; as três falhas foram da mesma classe de cena íntima, que uma LoRA adulta externa atendeu em cada tarefa em 26 de setembro |
Nossa regra prática: escolha o Jib Mix Qwen quando quiser um retrato fotográfico pronto, sem caçar LoRAs, e aceitar o limite dos rostos. Escolha o Qwen Image 2512 LoRA quando precisar de edição, quando já tiver uma LoRA para a base 2512 ou quando quiser que a base tire o visual do seu adaptador. Nosso guia sobre combinar pesos com a tarefa explica a divisão entre 2512 e Edit 2511, e o panorama de modelos de imagem com LoRA hospedados compara o cenário mais amplo.
Limites
- Rostos. Pedidos de rostos do leste asiático voltaram europeus ou ambíguos em todas as nossas seis tentativas, e muitos seeds convergem para um rosto parecido.
- Faixa de estilo. Prompts e LoRAs de anime e de pixel art deixaram fotografias. Use um modelo de ilustração para um visual desenhado.
- Cenas íntimas a dois. Desenhadas sem recusa, com anatomia menos precisa.
- Sem prompt negativo, passos nem guidance, sem entrada de imagem, sem edição.
- Uma imagem por requisição.
- Versão desconhecida. A rota hospedada não diz qual versão do Jib Mix Qwen ela roda.
FAQ
O Jib Mix Qwen é sem censura?
Sim. A plataforma não adiciona nenhum filtro de conteúdo. Conteúdo de um só sujeito voltou como pedido na nossa escada, e cenas a dois foram desenhadas sem recusa, mas com anatomia menos precisa.
Ele consegue fazer rostos do leste asiático?
Não de forma confiável. Seis requisições de mulheres japonesas, coreanas ou do leste asiático voltaram todas europeias ou ambíguas. Varie idade, cabelo e traços em vez de usar uma nacionalidade.
LoRAs de estilo funcionam nele?
Mal. Uma LoRA de anime com 0.5, 1 e 2 deixou a imagem como fotografia, e com 4 a imagem se desfez. LoRAs de foto, de câmera e de retrato são as que aparecem.
Que scale devo usar em uma LoRA?
Comece em 1 e fique entre cerca de 0.5 e 1.5. O scale 4, o máximo, quebrou a imagem no nosso teste.
Uma LoRA de outro modelo base funciona?
Não. Uma LoRA de FLUX carregou sem erro e não mudou nada. Use LoRAs treinadas para Qwen-Image ou Qwen-Image-2512.
Devo usar o endpoint base ou o endpoint com LoRA?
O endpoint base, se você não vai carregar uma LoRA. Sem LoRA, a versão com LoRA deu saída idêntica pixel a pixel à do base com o mesmo seed nas nossas verificações.
Ele consegue renderizar texto dentro da imagem?
Palavras curtas, sim. O nosso "OPEN LATE" no quadro-negro saiu correto nos dois seeds. Mantenha a frase curta e confira as letras antes de publicar.
Posso editar uma foto existente com ele?
Não. Os dois endpoints são de texto para imagem. Para edição com imagens de origem, use o Qwen Image 2512 LoRA.