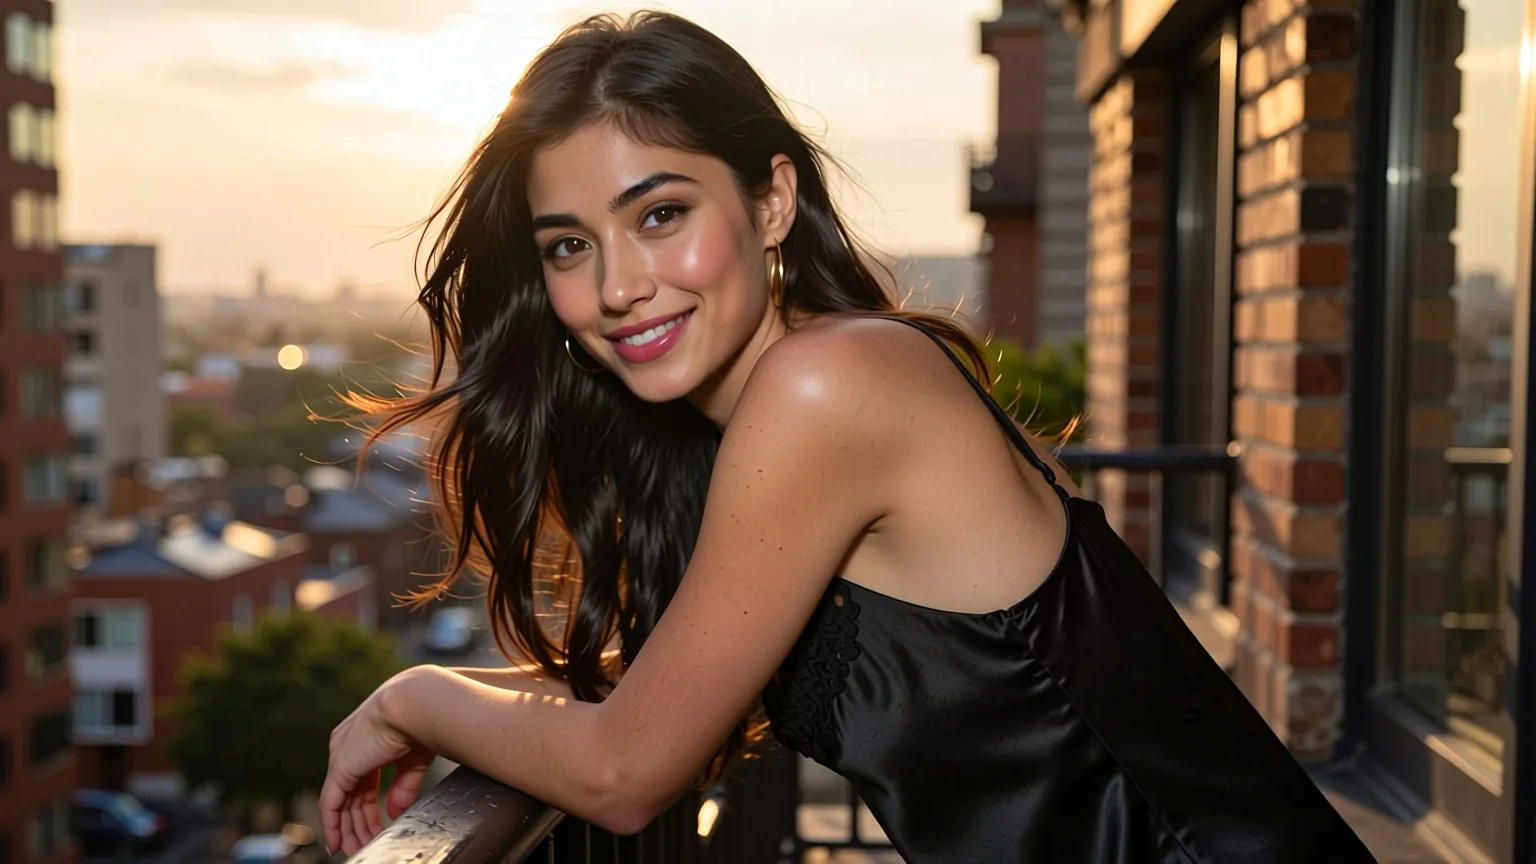
Jib Mix Qwen è un modello veloce per ritratti fotorealistici: nei nostri test un'immagine ha richiesto una mediana di 5,8 secondi, e le LoRA fotografiche e di camera ne hanno cambiato il look mentre le LoRA di stile quasi per niente. Ha due punti deboli che vogliamo farti conoscere prima di costruirci sopra. Sei richieste per una donna giapponese, coreana o dell'Asia orientale sono tornate tutte europee o ambigue, e le scene intime a due persone sono state disegnate senza rifiuto ma con un'anatomia confusa.
Abbiamo provato sia Jib Mix Qwen sia la sua build LoRA il 5 ottobre 2026. Jib Mix è una serie di checkpoint della community del creatore J1B, e questo è un merge di fine-tune e LoRA di Qwen-Image costruito su Qwen-Image di Alibaba da 20 miliardi di parametri. Ogni prompt riportato qui sotto è una scena quotidiana con adulti vestiti.
In breve
| Jib Mix Qwen e Jib Mix Qwen LoRA (testati il 5 ottobre 2026) | |
|---|---|
| Creatore e base | J1B; un merge di fine-tune e LoRA di Qwen-Image su Qwen-Image (20B, text encoder Qwen2.5-VL) |
| Nomi dei modelli API | j1b/jib-mix-qwen-image/text-to-image e j1b/jib-mix-qwen-image-lora/text-to-image |
| Campi pubblici | prompt (fino a 5.000 caratteri), aspect_ratio, output_format, seed; la build LoRA aggiunge loras |
| Proporzioni | 9, fino a 1536 pixel sul lato lungo: 1328 x 1328 a 1:1, 1536 x 864 a 16:9 |
| Output | Un'immagine per richiesta in JPEG (predefinito), PNG o WebP |
| Velocità nei nostri test | Base: da 3,7 a 48 secondi su 30 esecuzioni, mediana 5,8, 21 su 30 sotto i 10. Build LoRA: da 3,2 a 36 secondi su 38 esecuzioni, mediana 5,6 |
| Politica sui contenuti | Senza censura, nessun filtro sui contenuti; i contenuti con un solo soggetto sono tornati come richiesto, le scene a due persone sono state disegnate senza rifiuto ma con meno precisione |
| Non può fare | Prompt negativi, passi, guidance, immagine in ingresso, modifica, più di un'immagine per richiesta |
Che cos'è, e quale versione
Le note del creatore per la prima release dicono che fonde modelli Qwen con LoRA preferite a pesi precisi. La pagina su Civitai elenca sei versioni tra settembre 2025 e marzo 2026. La nota della v4.0, del 15 ottobre 2025, dice "much more natural pretty faces (much better at Asian faces)". La nota della v6.0, di marzo 2026, dice "more European faces and fewer Asian by default" e "not quite as good at NSFW as V5".
La route ospitata non dice quale versione usi. La sua descrizione riecheggia la nota della v4.0, ma i nostri output tendono all'europeo, il che corrisponde alla v6, e la route è stata aggiornata di recente, quindi non possiamo escludere uno scambio. Lo segnaliamo come non verificato invece di tirare a indovinare. Ciò che possiamo riferire è ciò che fa la route, e questo è il resto dell'articolo.
Come scrivere i prompt per i ritratti
Il modello gradisce un briefing da fotografo in frasi complete. Il ritratto alla finestra qui sotto usava età, capelli, lentiggini, abbigliamento, posa e luce, con una breve apertura fotografica:
Photorealistic photo, natural skin texture. A 32-year-old woman with a short black bob, light freckles and minimal makeup sits on a windowsill in a cream silk camisole, knees drawn up, holding a mug of coffee. Soft morning light, sheer curtains, shallow depth of field.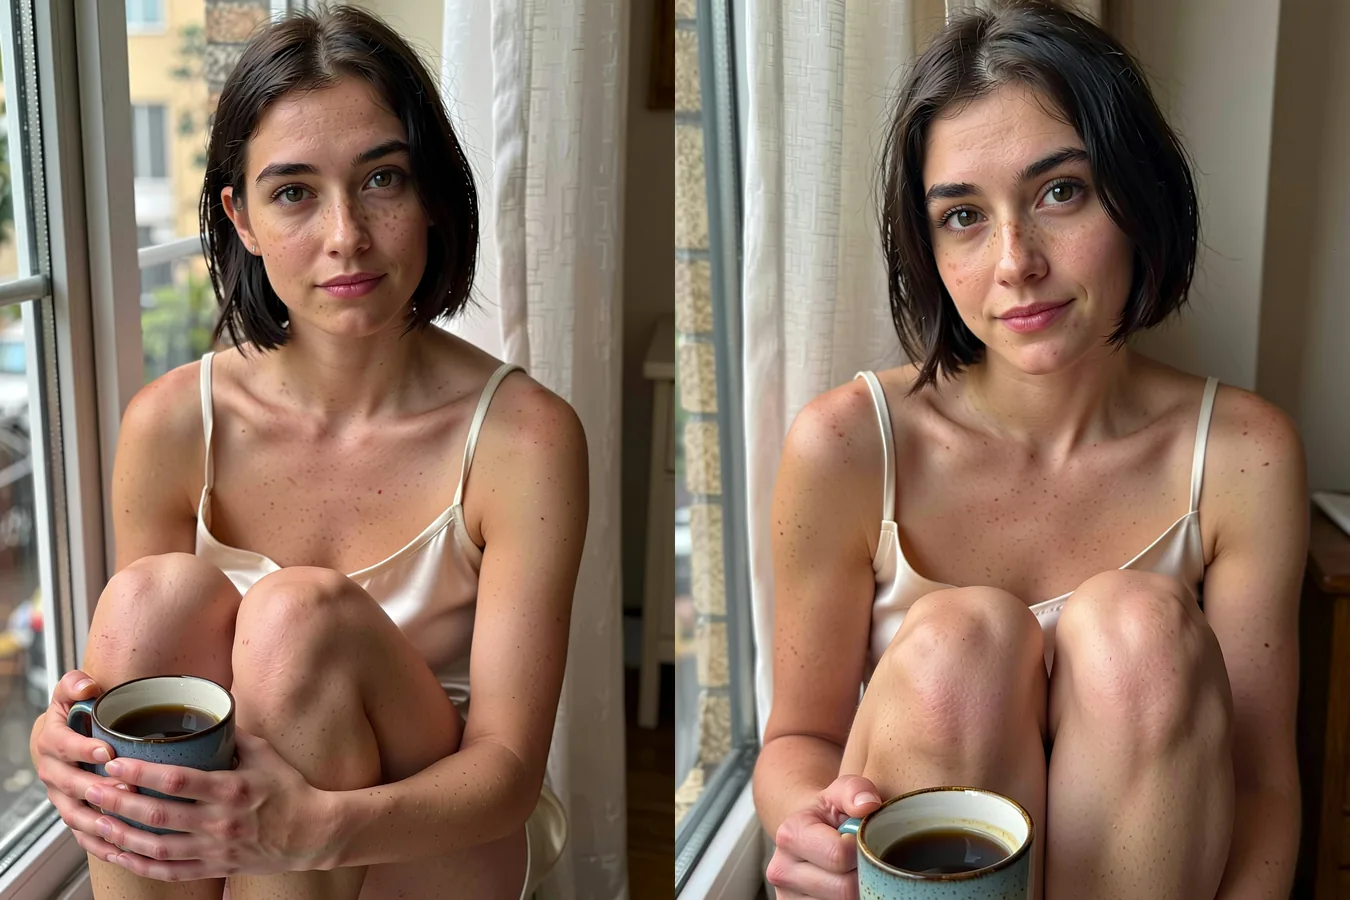
Seed 1 e 2 di una versione di questo prompt che chiedeva una donna giapponese. Vedi la sezione sui volti qui sotto. 3:4, testo in immagine.
Abitudini che hanno aiutato nelle nostre esecuzioni:
- Apri con un'indicazione fotografica. "Photorealistic photo, natural skin texture" o "35mm film look" o "phone photo with flash" orienta il look.
- Descrivi la persona, non una nazionalità. Età, lunghezza e colore dei capelli, lentiggini, una barba e l'espressione hanno cambiato i volti in modo affidabile. Una nazionalità no.
- Cita parole brevi. Il nostro prompt della lavagna chiedeva un'insegna con la scritta "OPEN LATE" in lettere di gesso bianco. La lavagna è tornata con quelle parole in entrambi i seed. Limitati a una frase breve e controlla le lettere.
- Fissa il seed e cambia una cosa sola. Luce, abbigliamento o resa dell'obiettivo, uno alla volta. I seed rendono le esecuzioni confrontabili ma non promettono pixel identici.
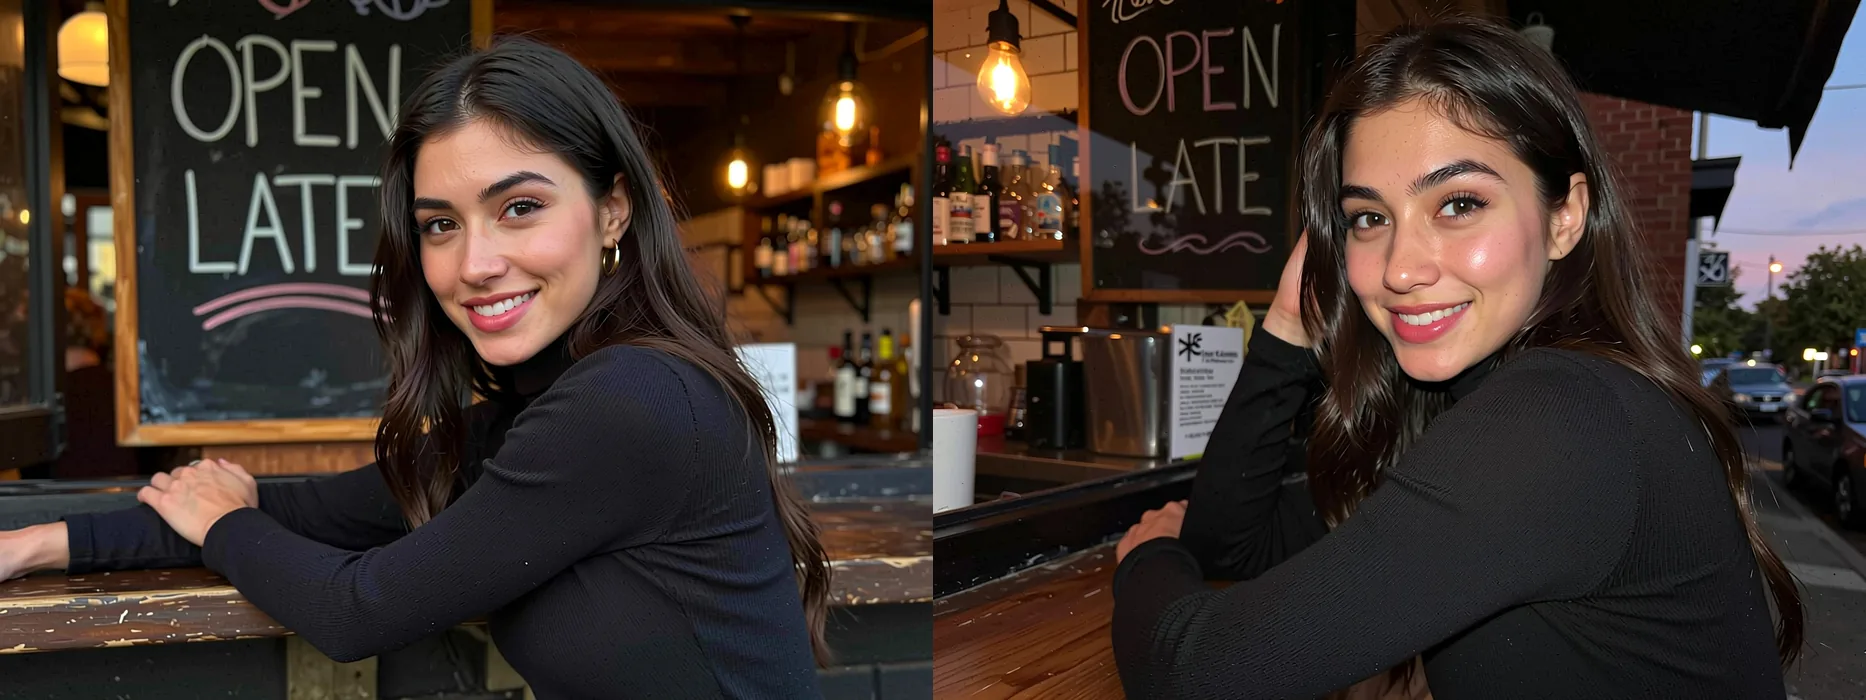
Seed 1 e 2 del prompt della lavagna (qui con una donna coreana), 4:3. L'insegna dice "OPEN LATE" in entrambi.
Proporzioni e dimensioni
Non c'è un campo per la dimensione. Scegli una delle nove proporzioni, ciascuna associata a una dimensione fissa. Abbiamo eseguito ogni proporzione una volta su entrambi gli endpoint, e ogni output è tornato esattamente ai pixel richiesti. Il lato lungo si ferma a 1536.
| Proporzione | Dimensione | Proporzione | Dimensione |
|---|---|---|---|
| 1:1 | 1328 x 1328 | 21:9 | 1536 x 656 |
| 4:3 | 1472 x 1104 | 9:21 | 656 x 1536 |
| 3:4 | 1104 x 1472 | 16:9 | 1536 x 864 |
| 3:2 | 1536 x 1024 | 9:16 | 864 x 1536 |
| 2:3 | 1024 x 1536 |
Scegli in base al lavoro. 3:4 e 2:3 vanno bene per i ritratti, 16:9 e 21:9 per fotogrammi di film e banner. Un ritratto ravvicinato a 2:3 si presenta così:
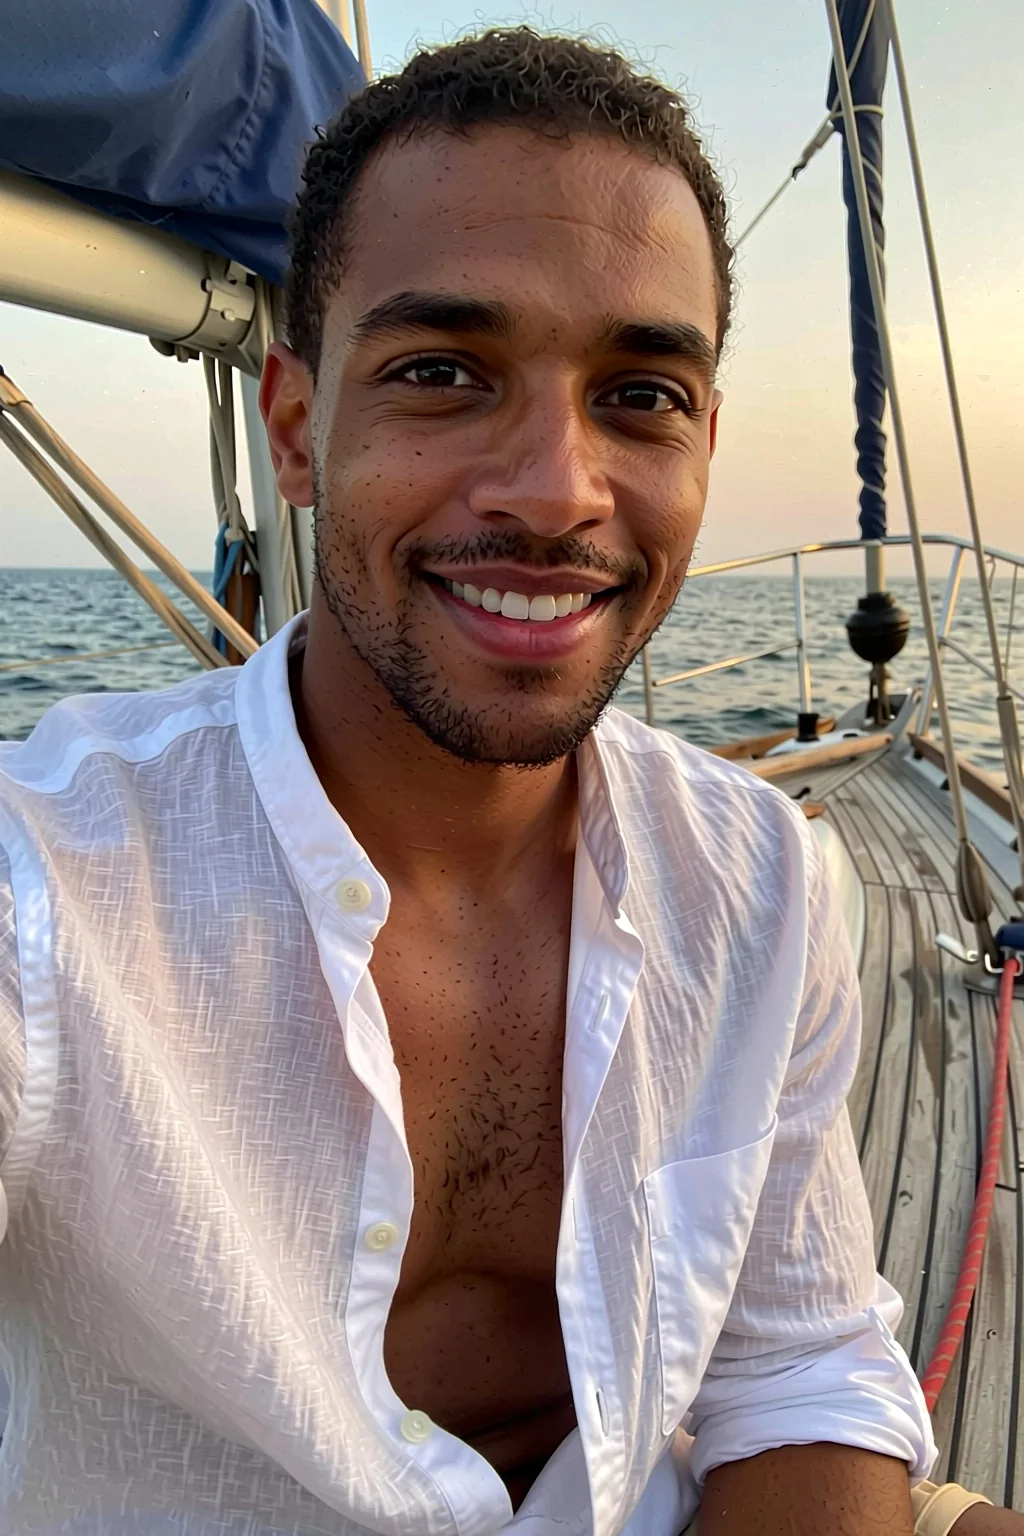
Esempio pubblicato: un uomo di 35 anni su una barca a vela all'ora dorata, 2:3, seed 1.
Photorealistic photo, natural skin texture. A 35-year-old Black man with a trimmed beard and a warm smile, open white linen shirt, sits on the deck of a sailboat at golden hour. Sea spray, wind in his shirt, shallow depth of field.Velocità
Il tempo del modello dell'endpoint base è andato da 3,7 a 48 secondi su 30 esecuzioni, con una mediana di 5,8 secondi e 21 su 30 sotto i dieci. La build LoRA è stata quasi uguale: da 3,2 a 36 secondi su 38 esecuzioni, mediana 5,6, e una richiesta che caricava un file LoRA per la prima volta ha richiesto da 10 a 25 secondi. È abbastanza veloce per iterare su un ritratto.
Due persone nella stessa inquadratura
Le scene con due persone vestite hanno funzionato. Questo prompt da fotogramma di film ha disegnato in entrambi i seed una coppia che ride sotto un solo ombrello, ognuno con il proprio cappotto e il proprio posto nell'inquadratura:
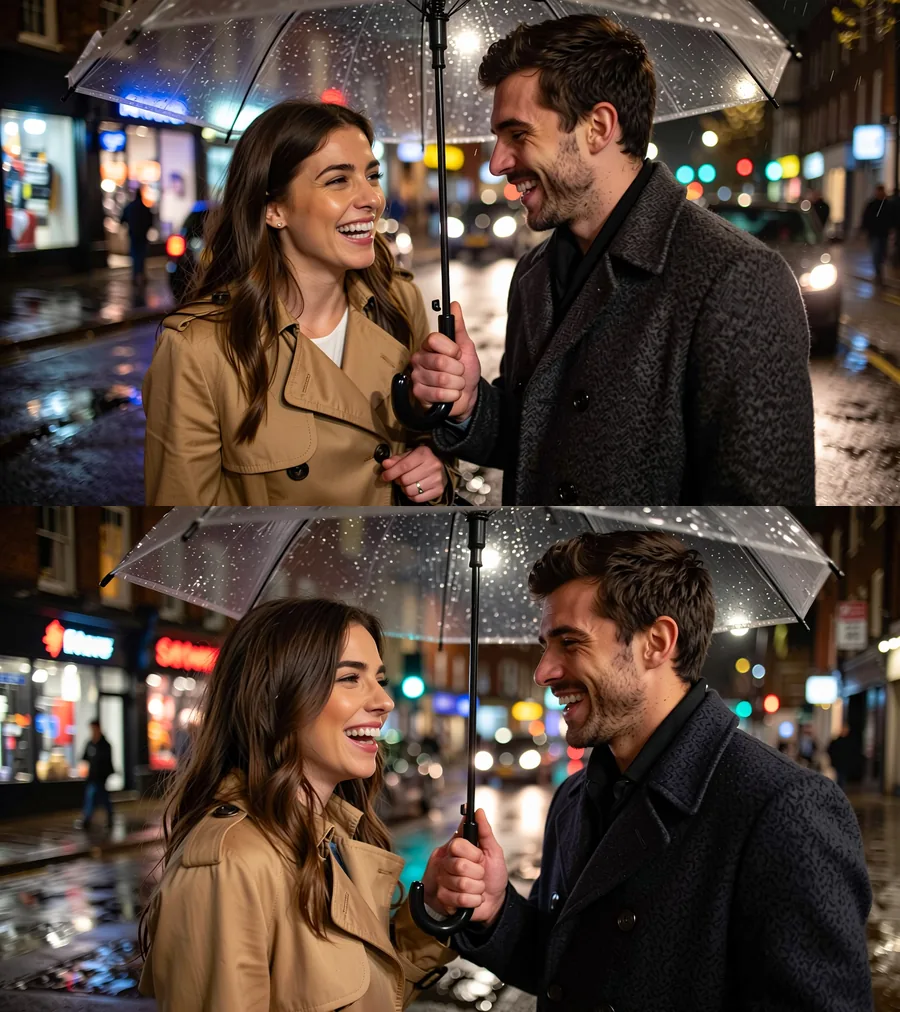
Seed 1 e 2 del prompt dell'ombrello, 16:9, impilati. Il modello ha dato a ciascuna persona un cappotto distinto e ha mantenuto il bokeh.
Photorealistic film still. A woman and a man in their early thirties laugh together under one clear umbrella on a rainy city street at night, she in a camel trench coat, he in a dark wool coat. Shop lights blur into colorful bokeh and reflect on the wet asphalt.Dai a ogni persona un posto chiaro nell'inquadratura e un solo abito ciascuna. Quando mani o arti si fondono, rilancia il seed.
Fin dove arriva
La piattaforma non aggiunge alcun filtro sui contenuti. Abbiamo eseguito un prompt per ogni gradino della nostra scala a cinque livelli a 3:4, seed 1, con i personaggi dichiarati adulti, e abbiamo guardato ogni immagine.
| Livello | Risultato sull'endpoint base |
|---|---|
| L1 Allusivo (lingerie, uno spallino che scivola) | Reso |
| L2 Temi maturi | Reso, e in tutte e nove le proporzioni (9 su 9) su entrambi gli endpoint |
| L3 Forte, femminile e maschile | Reso |
| L4 Intenso (una scena intima tra due adulti) | Attenuato: tre seed hanno disegnato tutti due adulti, ma l'anatomia era confusa e solo uno dei tre si leggeva come la scena richiesta |
| L5 Estremo (bondage consensuale tra adulti; gore cinematografico) | Resi entrambi |
Nessun rifiuto da nessuna parte. L4 è il dato onesto: il modello non lo rifiuta, semplicemente non riesce a disegnarlo in modo pulito. Aggiungere una LoRA Qwen-Image per adulti ha cambiato la composizione in una coppia in posa e non ha comunque prodotto la scena. Il limite pratico è quindi questo: i contenuti con un solo soggetto sono tornati come richiesto, e le scene a due persone sono state disegnate senza rifiuto ma con un'anatomia meno precisa. Se il tuo lavoro dipende da L4, testa prima la route esatta e confrontala con Qwen Image 2512 LoRA qui sotto.
Il problema dei volti
Abbiamo chiesto due volte una "32-year-old Japanese woman", due volte una "woman with East Asian features" e due volte una "30-year-old Korean woman". Tutti e sei i volti sono usciti europei o ambigui.
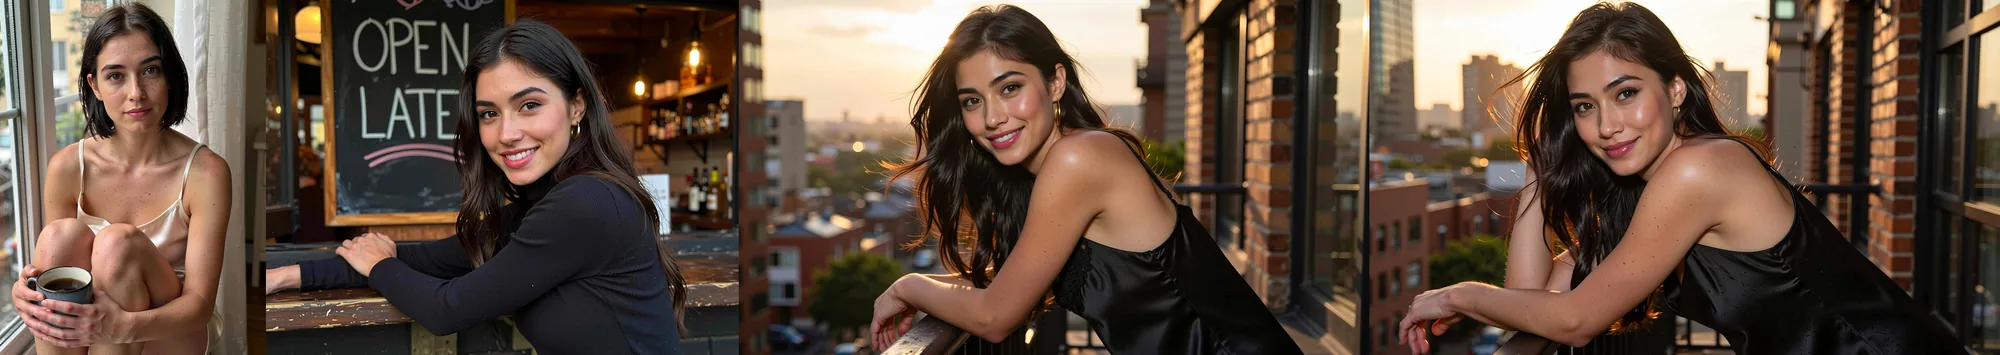
Da sinistra a destra: "Japanese woman" seed 1 (3:4), "Korean woman" seed 1 (4:3), "East Asian features" seed 1 e 2 (16:9).
Molti seed finiscono inoltre su un volto simile dai capelli scuri, l'abitudine del «stesso volto» che gli utenti di Civitai segnalano per le prime versioni. Non scegliere questo modello se ti servono volti dell'Asia orientale marcati. Se lo tieni, varia esplicitamente età, capelli, lentiggini, barba ed espressione e non affidarti a una parola di nazionalità. Gli esempi pubblicati sulla pagina del modello sono stati scritti senza una nazionalità.
Quali LoRA lo cambiano
La build LoRA accetta fino a tre LoRA per richiesta, ciascuna un link diretto a un file .safetensors con uno scale da 0 a 4. Senza alcuna LoRA caricata ha dato un output identico al pixel a quello dell'endpoint base con lo stesso seed nei nostri controlli, quindi usa l'endpoint base a meno che tu non intenda caricarne una. Un link alla pagina web del repository fallisce con un messaggio che chiede il link di download diretto, e un repository protetto fallisce con un errore HTTP 401.
Le LoRA Qwen-Image si caricano, da Hugging Face o da un link diretto di Civitai, e così le LoRA Qwen-Image-2512. Ciò che fanno all'immagine dipende dal tipo.
Le LoRA fotografiche e di camera si vedono. Con un solo prompt e un solo seed, quattro LoRA fotografiche hanno cambiato ciascuna il volto e la luce in modo visibile ma non drastico.
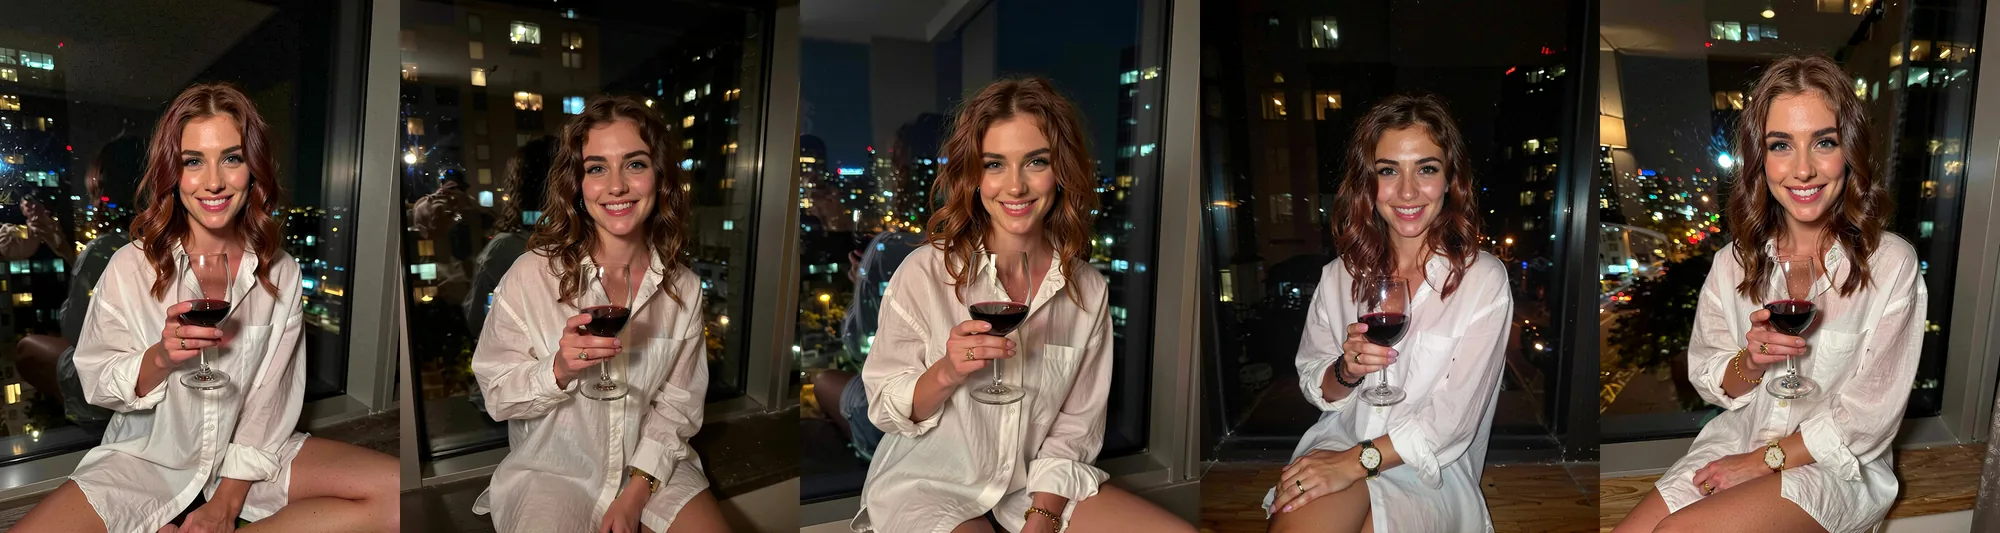
Da sinistra a destra: nessuna LoRA; una LoRA da fotocamera di telefono (Samsung UltraReal); una LoRA di ritocco ritratto (AWPortrait-QW); una LoRA da foto con flash (Lenovo); una LoRA di realismo (flymy-ai). Stesso prompt, seed 21, 3:4, tutte con scale 1.
| Tipo di LoRA | Che cosa abbiamo visto | Verdetto |
|---|---|---|
| Fotocamera di telefono (Samsung UltraReal) | Capelli più ricci, luce più dura, un'aria da istantanea | Visibile |
| Ritocco ritratto (AWPortrait-QW) | Un look da ritratto più ritoccato | Visibile, sottile |
| Foto con flash (Lenovo) | Inquadratura più scura, illuminata dal flash | Visibile |
| Realismo (flymy-ai) | Volto e luce cambiati | Visibile, sottile |
| Due insieme (Samsung 0.8 più AWPortrait 0.6) | Ha funzionato | Due LoRA in una sola richiesta |
Due esempi pubblicati mostrano all'opera le LoRA di camera e di ritocco:
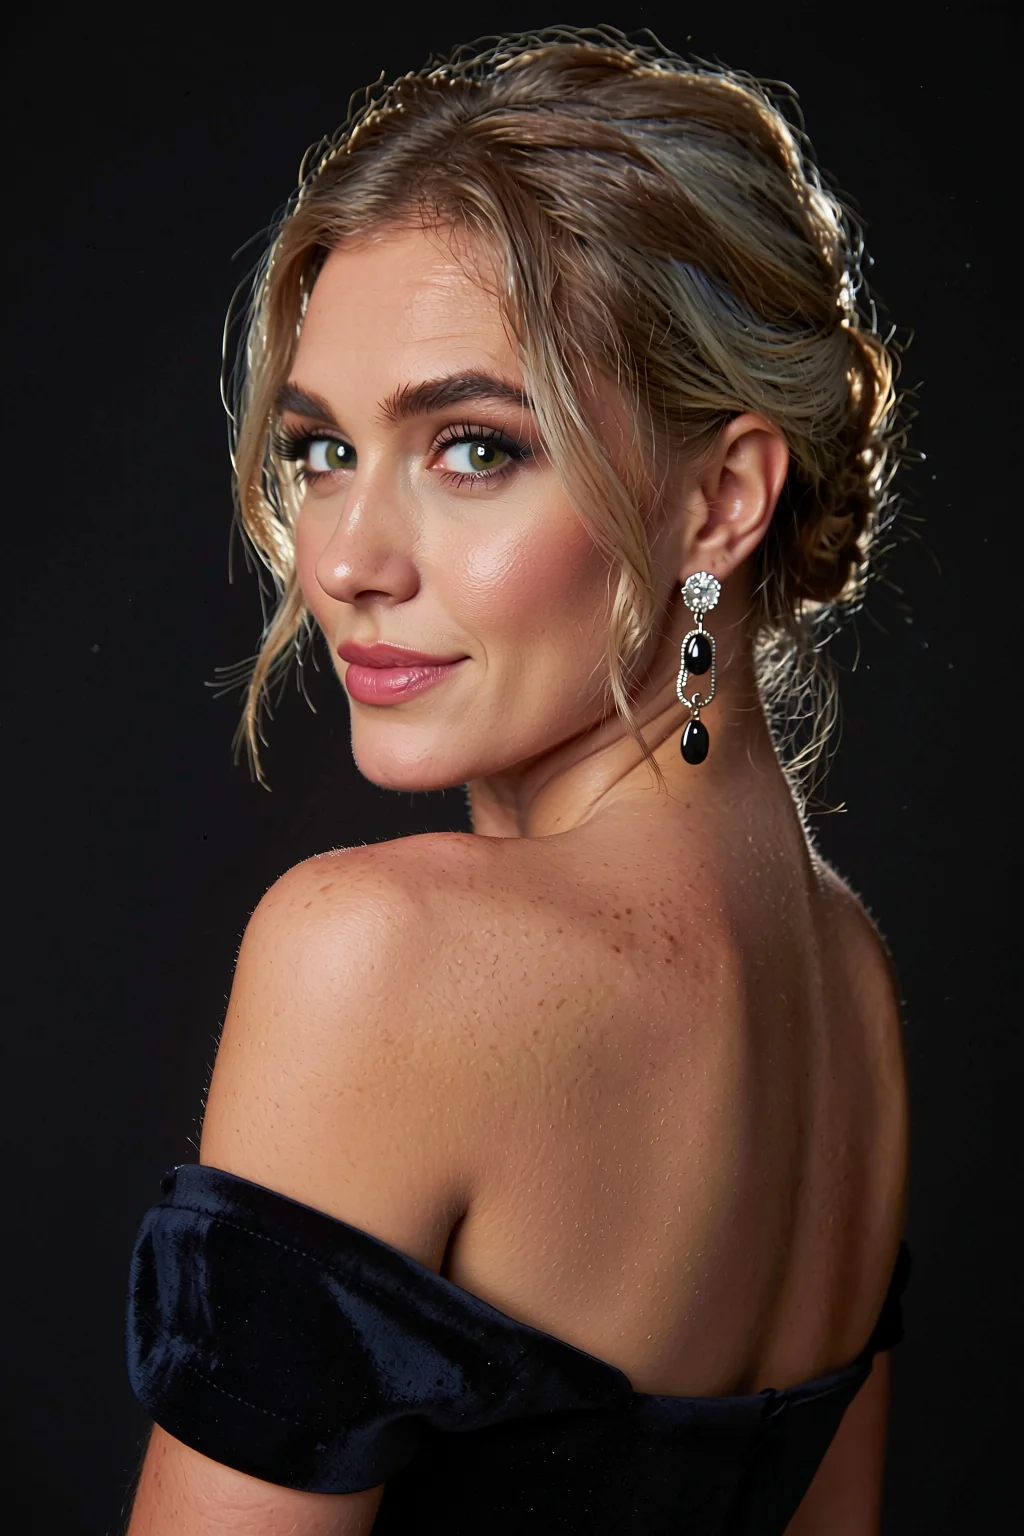
LoRA di ritocco ritratto con scale 1, 2:3, seed 1.
Studio portrait photo. A 36-year-old woman with silver-blonde hair pinned up wears an off-shoulder black velvet gown and long earrings, looking over her bare shoulder at the camera. Soft key light, dark backdrop, rim light on her hair.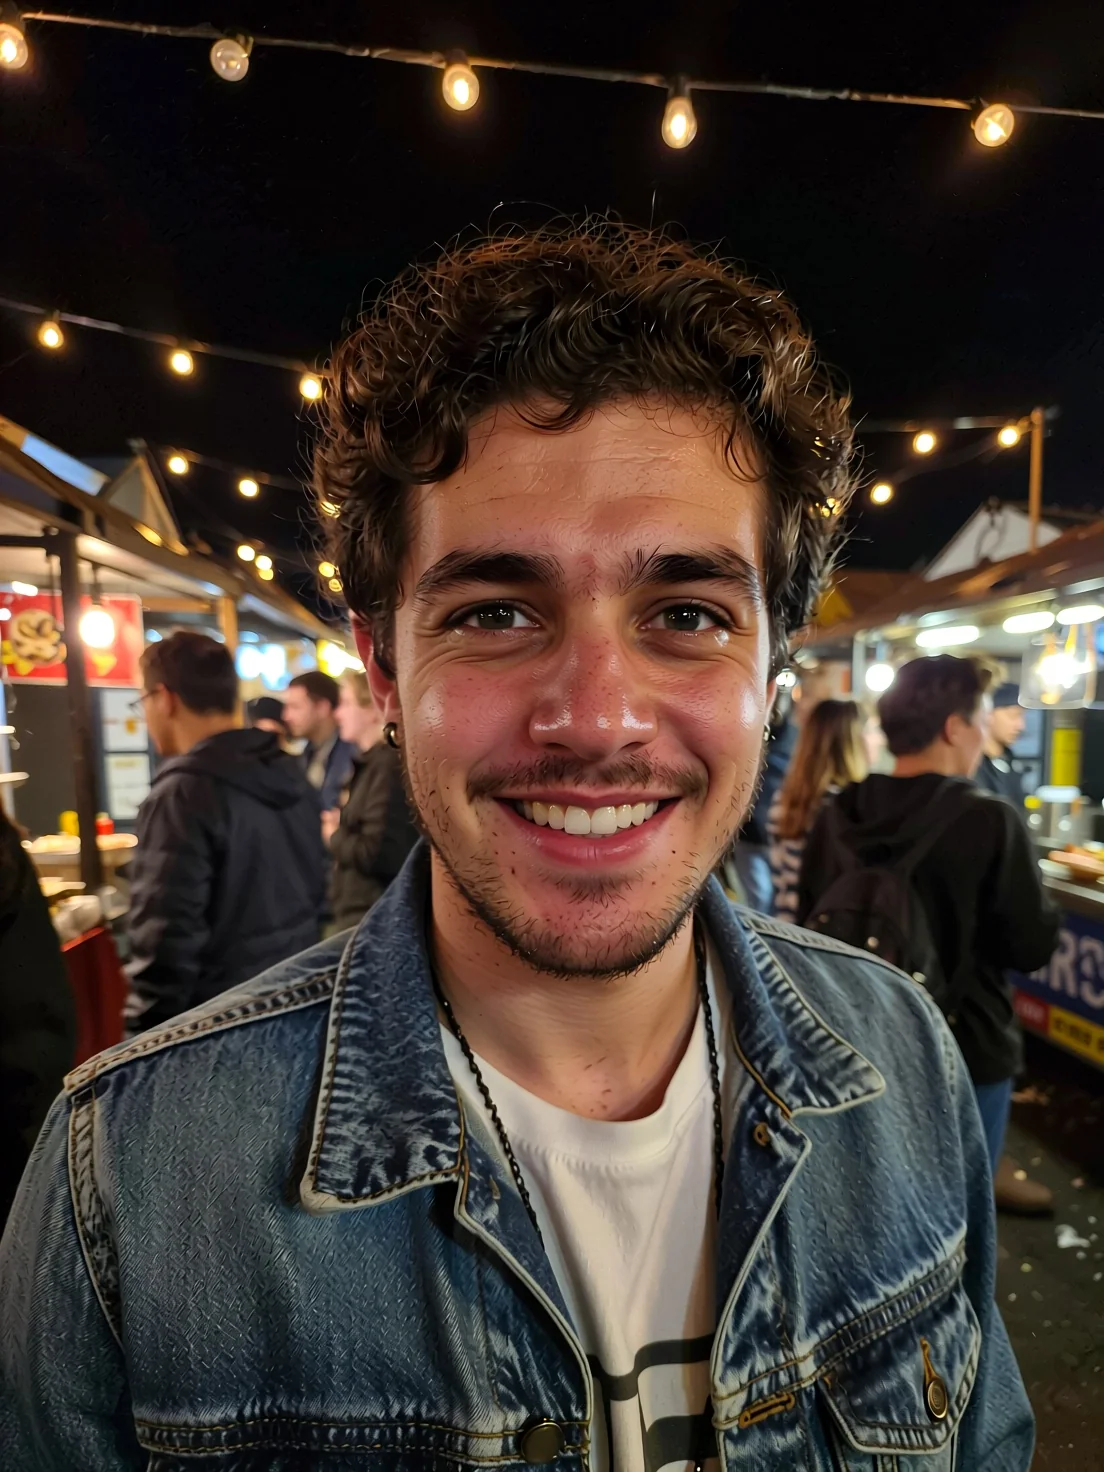
LoRA da fotocamera di telefono con scale 1, 3:4, seed 1. Prompt: "Amateur phone photo with on-camera flash. A 31-year-old man with curly dark hair and a short beard in a denim jacket over a white T-shirt grins at the camera at a crowded night market, string lights and food stalls behind him."
Le LoRA di stile lo smuovono appena. Abbiamo chiesto un ritratto in "Japanese modern anime style". Il checkpoint base ha ignorato la frase, e lo stesso ha fatto una LoRA anime di Qwen-Image con scale 0.5, 1 e 2: i pixel sono cambiati ma l'immagine è rimasta una fotografia. Con scale 4 l'immagine si è rotta in un primo piano deformato con occhi sproporzionati. Una LoRA pixel art di Qwen-Image-2512 ha cambiato i pixel e non ha prodotto alcun look pixel art.
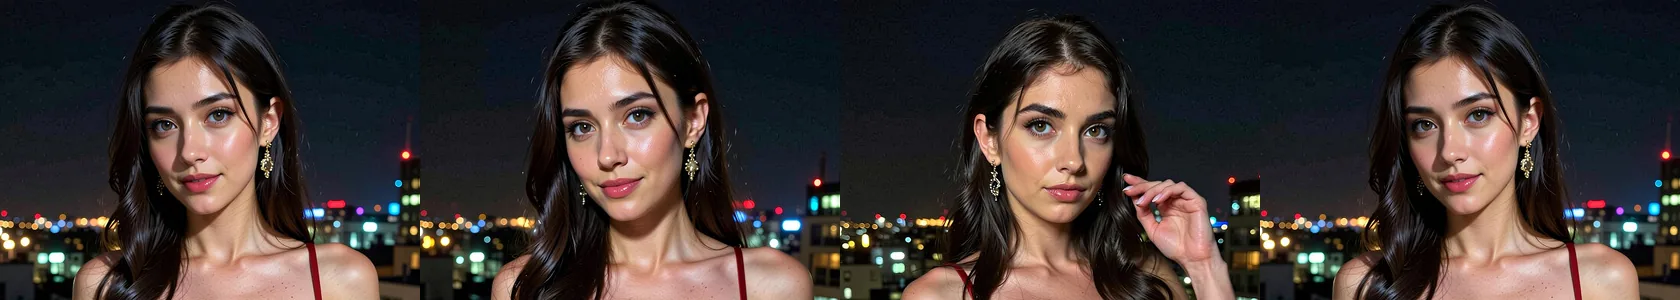
Ritagli di volto, da sinistra a destra: nessuna LoRA; una LoRA anime a 0.5; la stessa a 1; una LoRA FLUX a 1. Stesso prompt, seed 11, 3:4. Tutte e quattro restano fotografie.
Una LoRA per un altro modello base non fa nulla. Una LoRA FLUX si è caricata senza errori e ha dato un output identico al pixel a quello senza LoRA. Una risposta riuscita non significa che il file corrispondesse al modello.
L'intervallo di scale utile è stato da circa 0.5 a 1.5. Due LoRA insieme hanno funzionato bene:
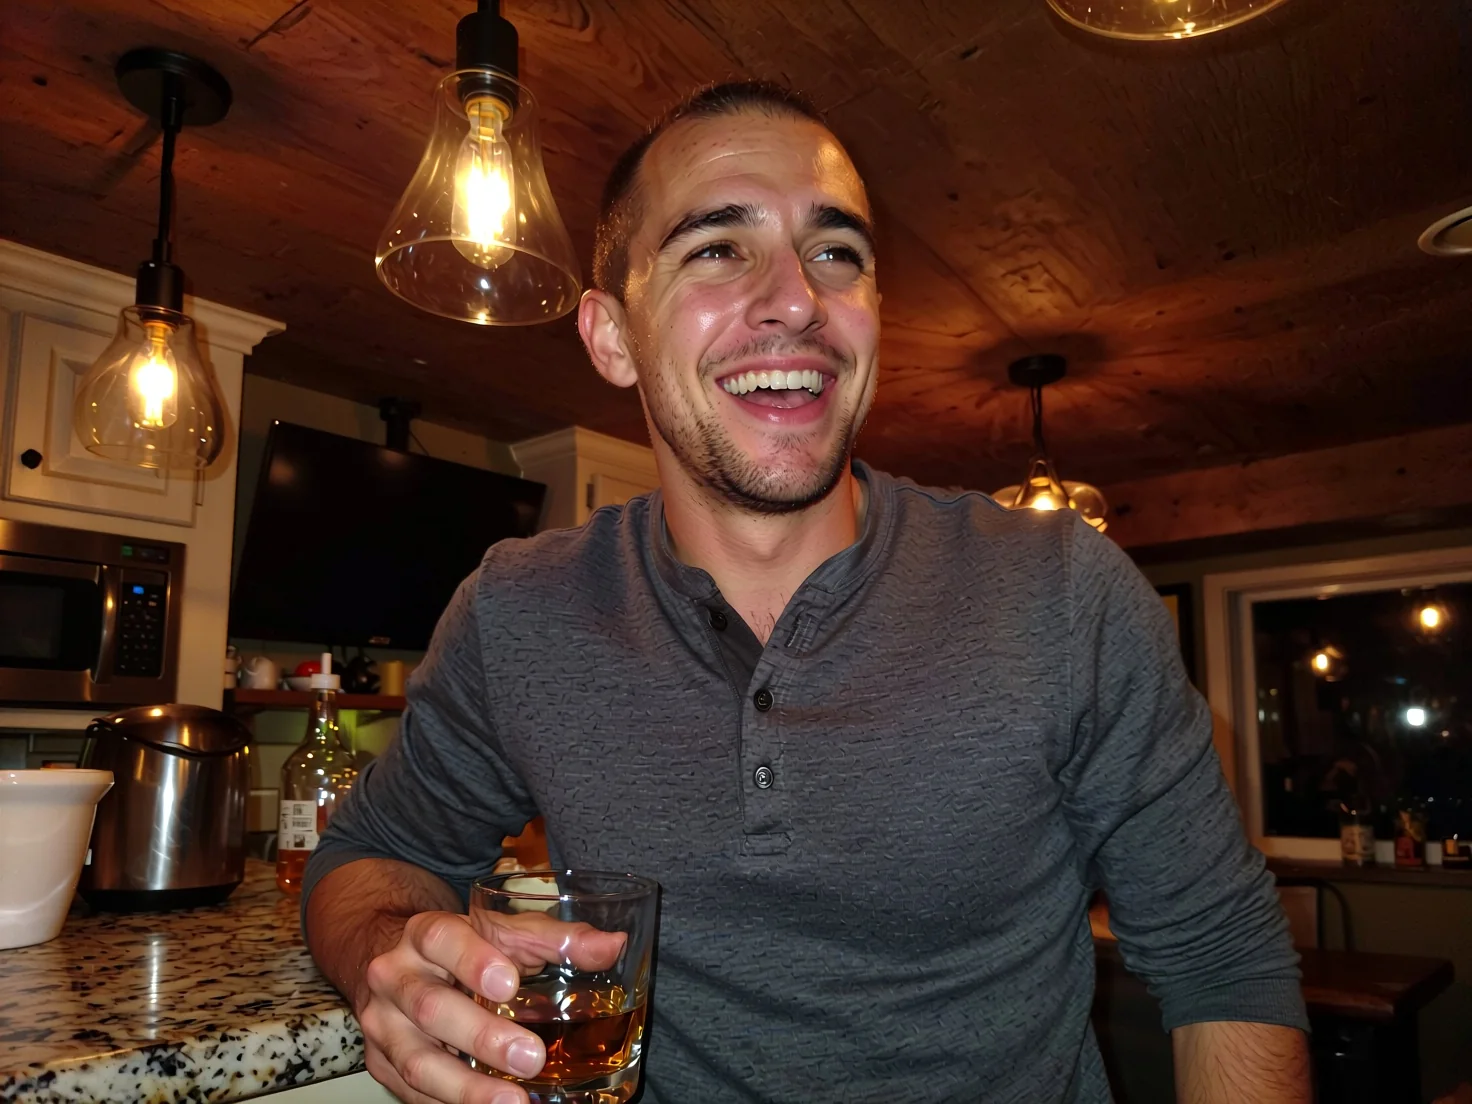
LoRA di camera Samsung a 0.8 più AWPortrait a 0.6, 4:3, seed 1.
Jib Mix Qwen o Qwen Image 2512 LoRA
Entrambi sono modelli della famiglia Qwen-Image con fino a tre LoRA sulla route LoRA. Sono bravi in lavori diversi.
| Jib Mix Qwen (e build LoRA) | Qwen Image 2512 LoRA | |
|---|---|---|
| Base | Merge della community su Qwen-Image | Qwen-Image-2512 per la generazione, Qwen-Image-Edit-2511 per la modifica |
| Attività | Solo testo in immagine | Testo in immagine e modifica con da 1 a 3 immagini sorgente |
| LoRA | Solo sulla build LoRA, fino a 3 | Fino a 3 in entrambe le attività |
| Look di serie | Ritratti fotografici, pelle naturale | Uso generale; sono gli adattatori a impostare lo stile |
| Velocità nei nostri test | Mediana 5,8 s (base) | Non misurata in questo giro |
| Proporzioni | 9, fino a 1536 px | 9 per la generazione, fino a 1536 px; la modifica segue la prima sorgente |
| Contenuti nei nostri test | Scala resa tranne L4, attenuato | Un'esecuzione della scala del 27 settembre ha reso 15 brief su 18 su ciascuna route; le tre mancanze erano della stessa classe di scena intima, che una LoRA esterna per adulti ha reso su ciascuna attività il 26 settembre |
La nostra regola pratica: scegli Jib Mix Qwen quando vuoi un ritratto fotografico già pronto senza dover cercare LoRA e accetti il limite dei volti. Scegli Qwen Image 2512 LoRA quando ti serve la modifica, quando hai già una LoRA per la base 2512, o quando vuoi che la base prenda il suo look dal tuo adattatore. La nostra guida su come abbinare i pesi all'attività spiega la divisione tra 2512 ed Edit 2511, e la rassegna delle LoRA ospitate confronta il campo più ampio.
Limiti
- Volti. Le richieste di volti dell'Asia orientale sono tornate europee o ambigue in tutti e sei i nostri tentativi, e molti seed convergono su un volto simile.
- Gamma di stili. I prompt e le LoRA anime e pixel art hanno lasciato fotografie. Usa un modello per illustrazioni per un look disegnato.
- Scene intime a due persone. Disegnate senza rifiuto, con un'anatomia meno precisa.
- Nessun prompt negativo, passi o guidance, nessuna immagine in ingresso, nessuna modifica.
- Un'immagine per richiesta.
- Versione sconosciuta. La route ospitata non dice quale versione di Jib Mix Qwen usi.
FAQ
Jib Mix Qwen è senza censura?
Sì. La piattaforma non aggiunge alcun filtro sui contenuti. I contenuti con un solo soggetto sono tornati come richiesto nella nostra scala, e le scene a due persone sono state disegnate senza rifiuto ma con un'anatomia meno precisa.
Può fare volti dell'Asia orientale?
Non in modo affidabile. Sei richieste per donne giapponesi, coreane o dell'Asia orientale sono tornate tutte europee o ambigue. Varia età, capelli e tratti invece di usare una nazionalità.
Le LoRA di stile funzionano?
Appena. Una LoRA anime a 0.5, 1 e 2 ha lasciato l'immagine una fotografia, e a 4 l'immagine si è rotta. Le LoRA fotografiche, di camera e da ritratto sono quelle che si vedono.
Che scale devo usare per una LoRA?
Parti da 1 e resta tra circa 0.5 e 1.5. Scale 4, il massimo, ha rotto l'immagine nel nostro test.
Funziona una LoRA per un altro modello base?
No. Una LoRA FLUX si è caricata senza errori e non ha cambiato nulla. Usa LoRA addestrate per Qwen-Image o Qwen-Image-2512.
Devo usare l'endpoint base o quello LoRA?
L'endpoint base se non caricherai una LoRA. Senza LoRA, la build LoRA ha dato un output identico al pixel a quello della base con lo stesso seed nei nostri controlli.
Può rendere testo dentro l'immagine?
Parole brevi, sì. La nostra lavagna "OPEN LATE" si leggeva correttamente in entrambi i seed. Tieni la frase breve e controlla le lettere prima di pubblicare.
Posso modificare una foto esistente con questo modello?
No. Entrambi gli endpoint sono testo in immagine. Per la modifica con immagini sorgente, usa Qwen Image 2512 LoRA.