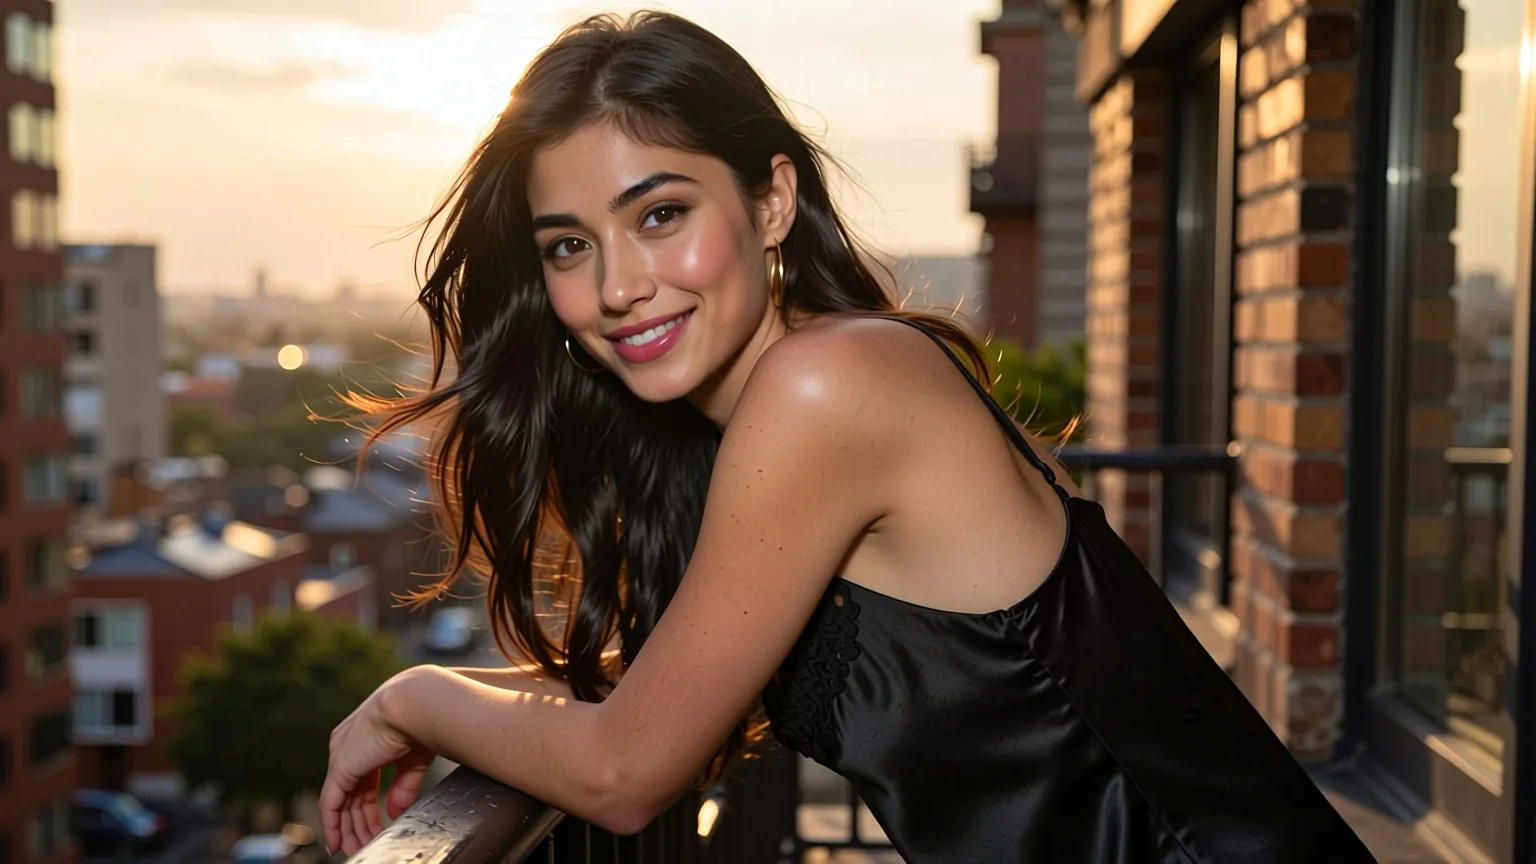
Jib Mix Qwen to szybki, fotorealistyczny model portretów: w naszych testach obraz powstawał ze średnim (medianowym) czasem 5,8 sekundy, a LoRA fotograficzne i aparatowe zmieniały jego wygląd, podczas gdy LoRA stylu ledwo. Ma dwie słabe strony, o których chcemy, żebyś wiedział, zanim coś na nim zbudujesz. Sześć żądań o japońską, koreańską albo wschodnioazjatycką kobietę wróciło za każdym razem z twarzą europejską lub niejednoznaczną, a intymne sceny z dwiema osobami zostały narysowane bez odmowy, ale z poplątaną anatomią.
5 października 2026 przetestowaliśmy zarówno Jib Mix Qwen, jak i jego wersję z LoRA. Jib Mix to seria społecznościowych checkpointów twórcy J1B, a ten jest połączeniem fine-tune'ów i LoRA Qwen-Image zbudowanym na 20-miliardowym Qwen-Image od Alibaby. Każdy wydrukowany niżej prompt to codzienna scena z ubranymi dorosłymi.
W skrócie
| Jib Mix Qwen i Jib Mix Qwen LoRA (test z 5 października 2026) | |
|---|---|
| Twórca i baza | J1B; połączenie fine-tune'ów i LoRA Qwen-Image na Qwen-Image (20B, enkoder tekstu Qwen2.5-VL) |
| Nazwy modeli w API | j1b/jib-mix-qwen-image/text-to-image i j1b/jib-mix-qwen-image-lora/text-to-image |
| Pola publiczne | prompt (do 5 000 znaków), aspect_ratio, output_format, seed; wersja z LoRA dodaje loras |
| Proporcje obrazu | 9, do 1536 pikseli na dłuższym boku: 1328 x 1328 przy 1:1, 1536 x 864 przy 16:9 |
| Wynik | Jeden obraz na żądanie jako JPEG (domyślnie), PNG lub WebP |
| Szybkość w naszych testach | Bazowy: 3,7 do 48 sekund w 30 przebiegach, mediana 5,8, 21 z 30 poniżej 10. Wersja z LoRA: 3,2 do 36 sekund w 38 przebiegach, mediana 5,6 |
| Polityka treści | Bez cenzury, bez filtra treści; treści z jednym podmiotem wracały zgodnie z prośbą, sceny z dwiema osobami były rysowane bez odmowy, ale mniej precyzyjnie |
| Nie potrafi | Promptów negatywnych, kroków, guidance, obrazu wejściowego, edycji, więcej niż jednego obrazu na żądanie |
Czym jest i która to wersja
Notatki twórcy do pierwszego wydania mówią, że łączy modele Qwen z ulubionymi LoRA przy precyzyjnie dobranych wagach. Strona na Civitai wymienia sześć wersji między wrześniem 2025 a marcem 2026. Notatka do v4.0 z 15 października 2025 mówi „much more natural pretty faces (much better at Asian faces)”. Notatka do v6.0 z marca 2026 mówi „more European faces and fewer Asian by default” oraz „not quite as good at NSFW as V5”.
Trasa hostowana nie podaje, którą wersję uruchamia. Jej opis powtarza notatkę do v4.0, ale nasze wyniki skłaniają się ku twarzom europejskim, co pasuje do v6, a trasa była niedawno aktualizowana, więc nie możemy wykluczyć podmiany. Oznaczamy to jako niezweryfikowane, zamiast zgadywać. Możemy zrelacjonować, co trasa robi, i to jest reszta tego artykułu.
Prompty do portretów
Model lubi brief fotografa w pełnych zdaniach. Portret przy oknie poniżej wykorzystał wiek, włosy, piegi, ubranie, pozę i światło, z krótkim fotograficznym otwarciem:
Photorealistic photo, natural skin texture. A 32-year-old woman with a short black bob, light freckles and minimal makeup sits on a windowsill in a cream silk camisole, knees drawn up, holding a mug of coffee. Soft morning light, sheer curtains, shallow depth of field.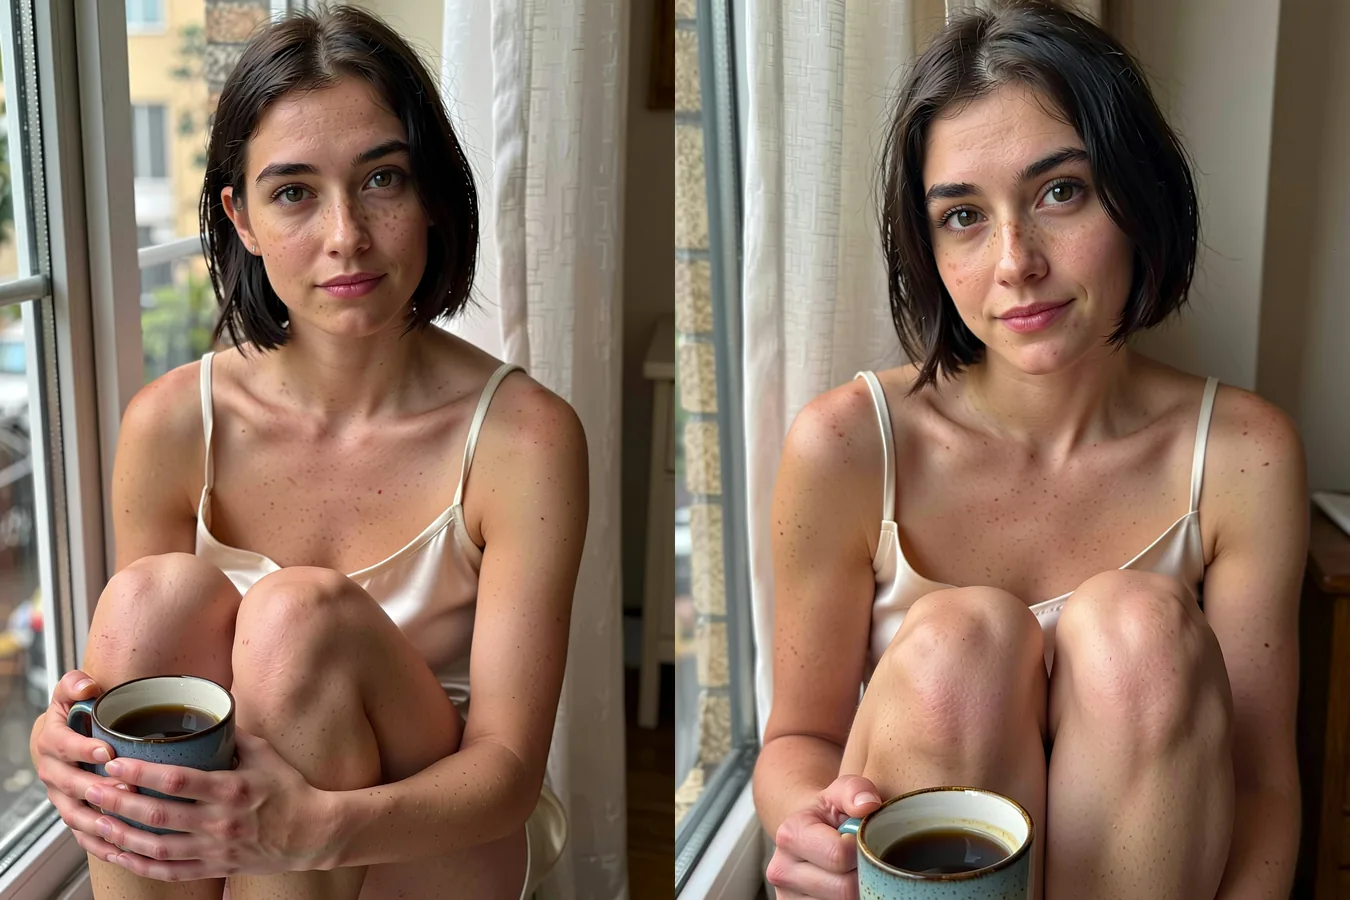
Seedy 1 i 2 wersji tego promptu, która prosiła o Japonkę. Zobacz sekcję o twarzach niżej. 3:4, tekst na obraz.
Nawyki, które pomogły w naszych przebiegach:
- Zacznij od fotograficznej wskazówki. „Photorealistic photo, natural skin texture”, „35mm film look” albo „phone photo with flash” steruje wyglądem.
- Opisuj osobę, nie narodowość. Wiek, długość i kolor włosów, piegi, broda i mimika zmieniały twarze niezawodnie. Narodowość nie.
- Cytuj krótkie słowa. Nasz prompt z tablicą kredową prosił o szyld z napisem „OPEN LATE” białą kredą. Tablica wróciła z tym napisem w obu seedach. Trzymaj się krótkiej frazy i sprawdź literowanie.
- Ustaw seed i zmieniaj jedną rzecz. Światło, ubranie albo wrażenie obiektywu, po jednym. Seedy czynią przebiegi porównywalnymi, ale nie obiecują identycznych pikseli.
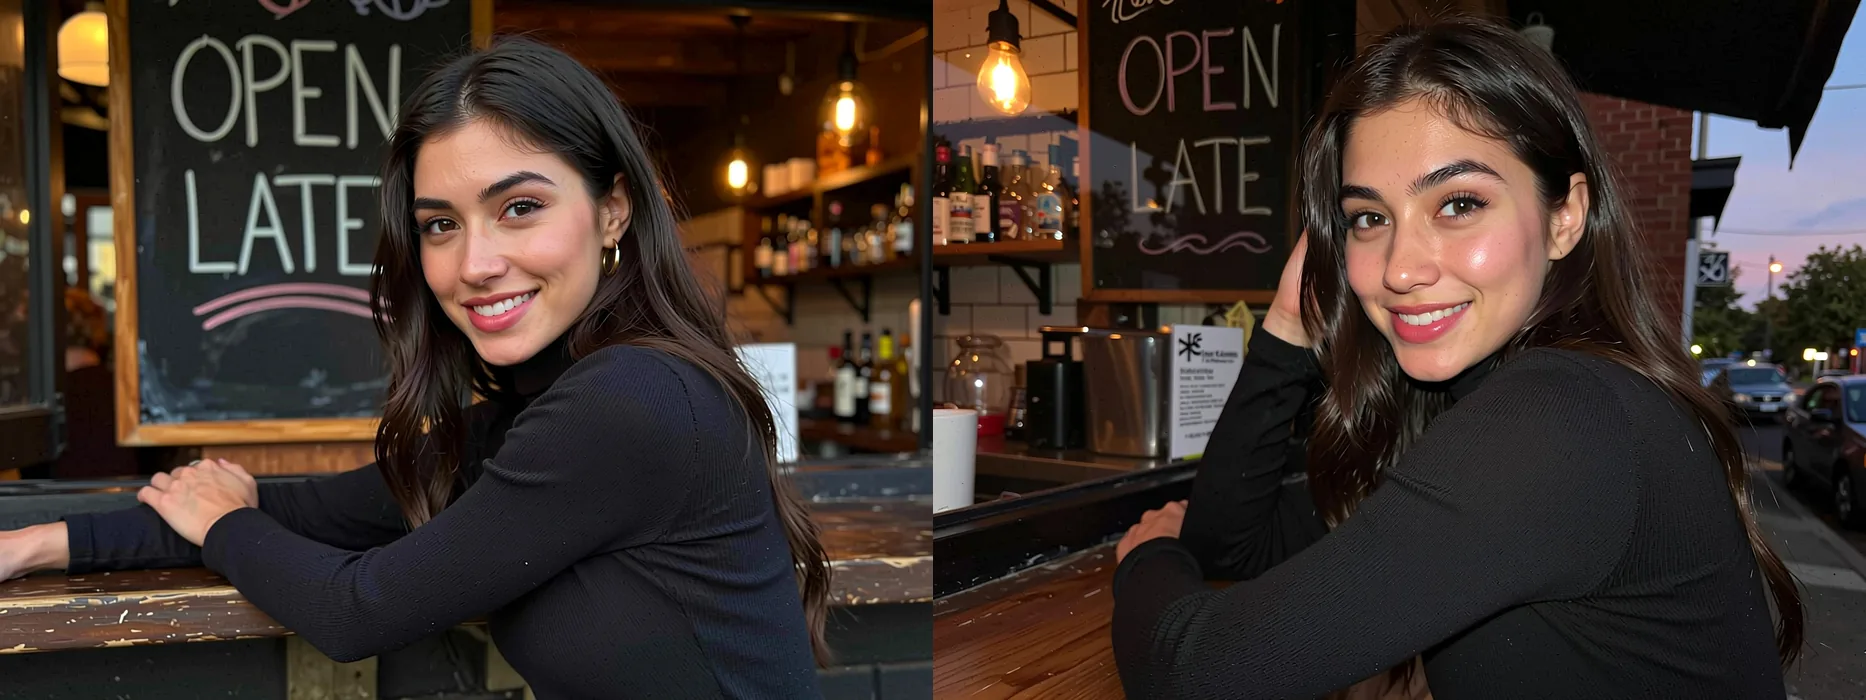
Seedy 1 i 2 promptu z tablicą (tu z prośbą o Koreankę), 4:3. Szyld w obu czyta się „OPEN LATE”.
Proporcje obrazu i rozmiary
Nie ma pola rozmiaru. Wybierasz jedną z dziewięciu proporcji obrazu, każda odpowiada stałemu rozmiarowi. Uruchomiliśmy każdą proporcję raz na obu endpointach i każdy wynik wrócił dokładnie w zażądanych pikselach. Dłuższy bok kończy się na 1536.
| Proporcje | Rozmiar | Proporcje | Rozmiar |
|---|---|---|---|
| 1:1 | 1328 x 1328 | 21:9 | 1536 x 656 |
| 4:3 | 1472 x 1104 | 9:21 | 656 x 1536 |
| 3:4 | 1104 x 1472 | 16:9 | 1536 x 864 |
| 3:2 | 1536 x 1024 | 9:16 | 864 x 1536 |
| 2:3 | 1024 x 1536 |
Wybieraj według zadania. 3:4 i 2:3 pasują do portretów, 16:9 i 21:9 do kadrów filmowych i banerów. Zbliżony portret w 2:3 wygląda tak:
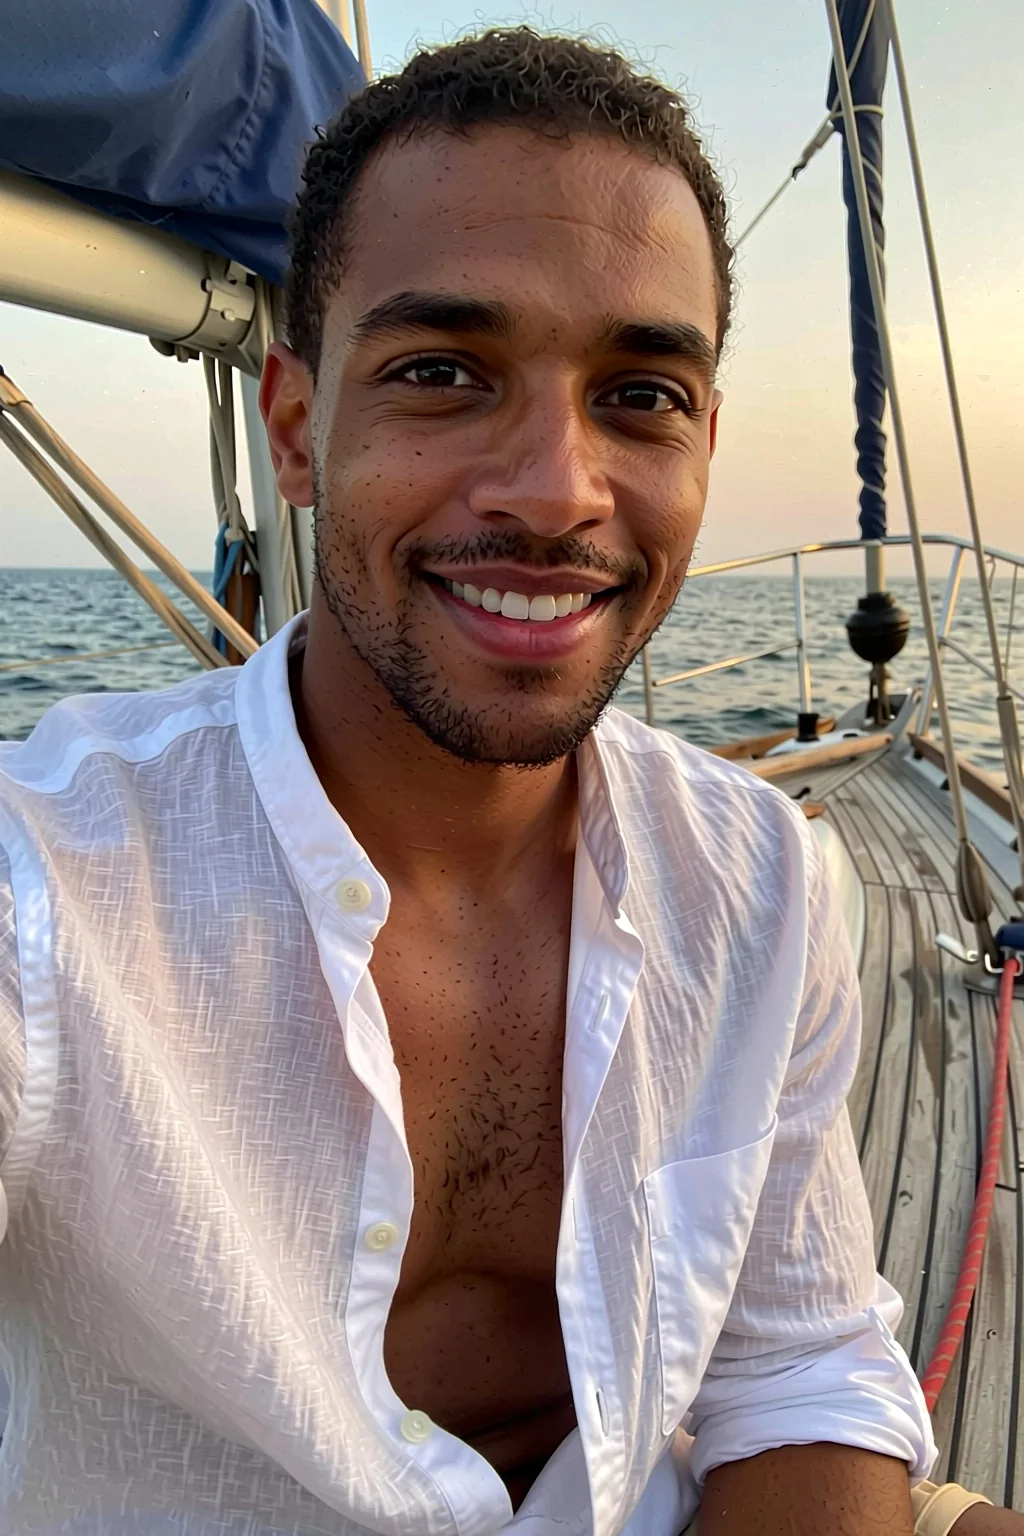
Opublikowany przykład: 35-letni mężczyzna na żaglówce o złotej godzinie, 2:3, seed 1.
Photorealistic photo, natural skin texture. A 35-year-old Black man with a trimmed beard and a warm smile, open white linen shirt, sits on the deck of a sailboat at golden hour. Sea spray, wind in his shirt, shallow depth of field.Szybkość
Czas modelu endpointu bazowego wahał się od 3,7 do 48 sekund w 30 przebiegach, z medianą 5,8 sekundy, a 21 z 30 zmieściło się poniżej dziesięciu. Wersja z LoRA była prawie taka sama: 3,2 do 36 sekund w 38 przebiegach, mediana 5,6, a żądanie wczytujące plik LoRA po raz pierwszy trwało od 10 do 25 sekund. To dość szybko, by iterować nad portretem.
Dwie osoby w jednym kadrze
Sceny z dwiema ubranymi osobami zadziałały. Ten prompt w stylu kadru filmowego narysował w obu seedach śmiejącą się parę pod jednym parasolem, każda osoba z własnym płaszczem i miejscem w kadrze:
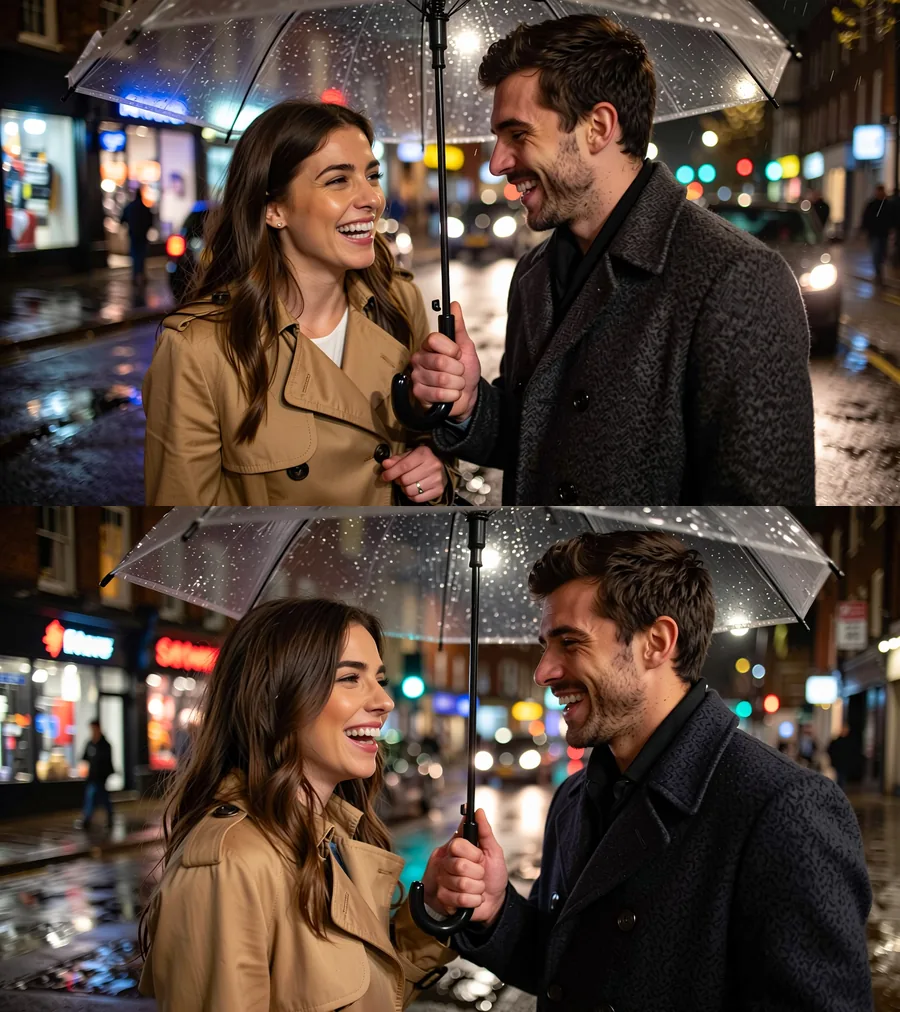
Seedy 1 i 2 promptu z parasolem, 16:9, jeden nad drugim. Model dał każdej osobie odrębny płaszcz i zachował bokeh.
Photorealistic film still. A woman and a man in their early thirties laugh together under one clear umbrella on a rainy city street at night, she in a camel trench coat, he in a dark wool coat. Shop lights blur into colorful bokeh and reflect on the wet asphalt.Daj każdej osobie wyraźne miejsce w kadrze i jeden strój. Gdy dłonie lub kończyny się zlewają, losuj seed ponownie.
Jak daleko to sięga
Platforma nie dodaje filtra treści. Uruchomiliśmy po jednym prompcie na szczebel naszej pięciostopniowej drabiny w 3:4, seed 1, z postaciami określonymi jako dorosłe, i obejrzeliśmy każdy obraz.
| Poziom | Wynik na endpoincie bazowym |
|---|---|
| L1 Sugestywny (bielizna, zsuwające się ramiączko) | Dostarczone |
| L2 Dojrzałe motywy (odsłonięty biust) | Dostarczone, także we wszystkich dziewięciu proporcjach (9 z 9) na obu endpointach |
| L3 Mocny, kobieca i męska | Dostarczone |
| L4 Intensywny (intymna scena między dwojgiem dorosłych) | Złagodzone: trzy seedy narysowały dwoje dorosłych, ale anatomia była poplątana i tylko jeden z trzech wyglądał jak żądana scena |
| L5 Ekstremalny (dobrowolne skrępowanie między dorosłymi; filmowy gore) | Oba dostarczone |
Nigdzie nie było odmowy. L4 to uczciwe ustalenie: model nie odmawia, po prostu nie potrafi tego czysto narysować. Dodanie dorosłej LoRA do Qwen-Image zmieniło kompozycję na pozującą parę i nadal nie dało tej sceny. Praktyczne ograniczenie jest więc takie: treści z jednym podmiotem wracały zgodnie z prośbą, a sceny z dwiema osobami były rysowane bez odmowy, ale z mniej precyzyjną anatomią. Jeśli twoja praca zależy od L4, najpierw przetestuj dokładnie tę trasę i porównaj ją z Qwen Image 2512 LoRA niżej.
Problem z twarzami
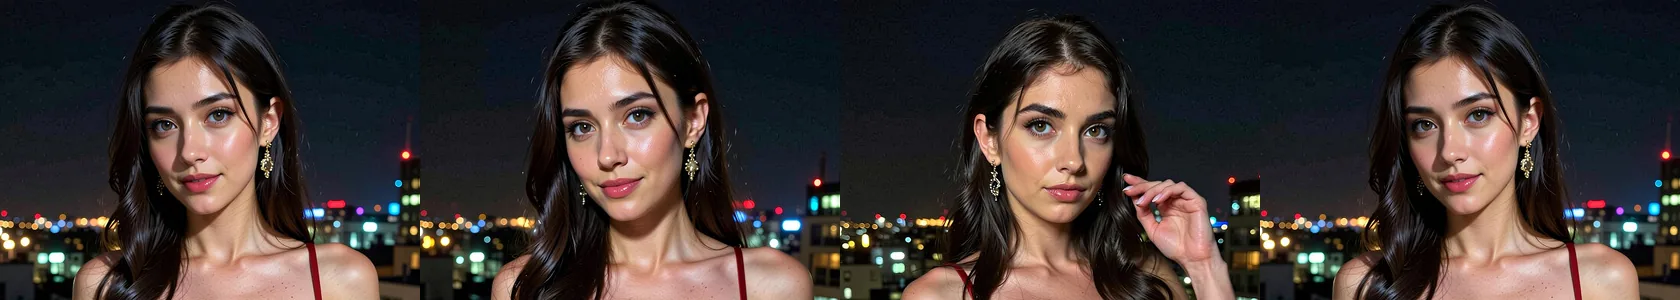
Dwukrotnie poprosiliśmy o „32-year-old Japanese woman”, dwukrotnie o „woman with East Asian features” i dwukrotnie o „30-year-old Korean woman”. Wszystkie sześć twarzy wyszło europejskich lub niejednoznacznych.
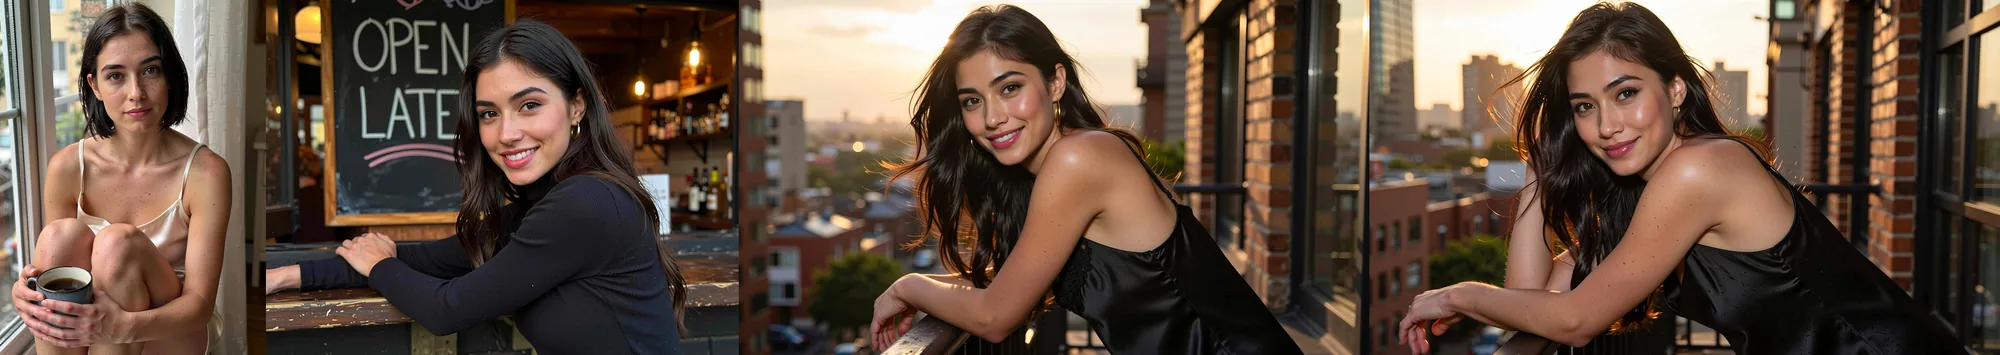
Od lewej do prawej: „Japanese woman” seed 1 (3:4), „Korean woman” seed 1 (4:3), „East Asian features” seedy 1 i 2 (16:9).
Wiele seedów też osiada na podobnej twarzy o ciemnych włosach, czyli nawyku „tej samej twarzy”, o którym użytkownicy Civitai piszą przy wczesnych wersjach. Nie wybieraj tego modelu, jeśli potrzebujesz wyraźnie wschodnioazjatyckich twarzy. Jeśli zostajesz przy nim, jawnie zmieniaj wiek, włosy, piegi, brodę i mimikę, a nie polegaj na słowie o narodowości. Opublikowane przykłady na stronie modelu napisano bez narodowości.
Które LoRA zmieniają wygląd
Wersja z LoRA przyjmuje do trzech LoRA na żądanie, każda to bezpośredni link do pliku .safetensors ze scale od 0 do 4. Bez wczytanej LoRA dawała w naszych sprawdzeniach wynik identyczny co do piksela z endpointem bazowym na tym samym seedzie, więc używaj endpointu bazowego, chyba że planujesz wczytać LoRA. Link do strony repozytorium kończy się komunikatem z prośbą o bezpośredni link do pobrania, a zablokowane repozytorium błędem HTTP 401.
LoRA do Qwen-Image wczytują się, z Hugging Face lub z bezpośredniego linku Civitai, tak samo jak LoRA do Qwen-Image-2512. To, co robią z obrazem, zależy od typu.
LoRA fotograficzne i aparatowe są widoczne. Na jednym prompcie i jednym seedzie cztery LoRA fotograficzne każda zmieniła twarz i światło w sposób widoczny, ale nie drastyczny.
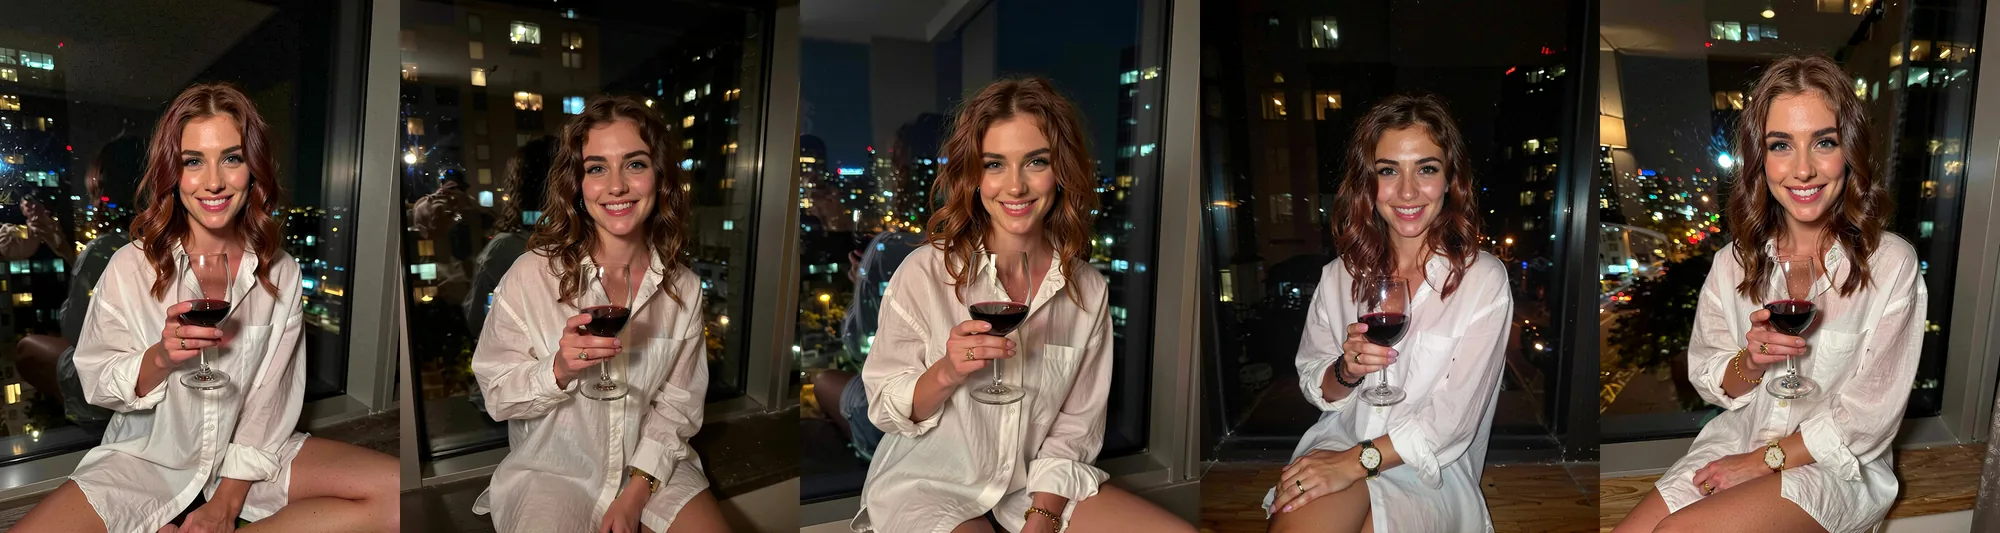
Od lewej do prawej: bez LoRA; LoRA aparatu telefonu (Samsung UltraReal); LoRA retuszu portretowego (AWPortrait-QW); LoRA zdjęcia z fleszem (Lenovo); LoRA realizmu (flymy-ai). Ten sam prompt, seed 21, 3:4, wszystkie przy scale 1.
| Typ LoRA | Co zobaczyliśmy | Wniosek |
|---|---|---|
| Aparat telefonu (Samsung UltraReal) | Bardziej kręcone włosy, twardsze światło, wrażenie zdjęcia z ręki | Widoczna |
| Retusz portretowy (AWPortrait-QW) | Bardziej wyretuszowany wygląd portretu | Widoczna, subtelna |
| Zdjęcie z fleszem (Lenovo) | Ciemniejszy kadr, oświetlony fleszem | Widoczna |
| Realizm (flymy-ai) | Zmieniła się twarz i światło | Widoczna, subtelna |
| Dwie połączone (Samsung 0.8 plus AWPortrait 0.6) | Zadziałało | Dwie LoRA w jednym żądaniu |
Dwa opublikowane przykłady pokazują LoRA aparatową i retuszu w akcji:
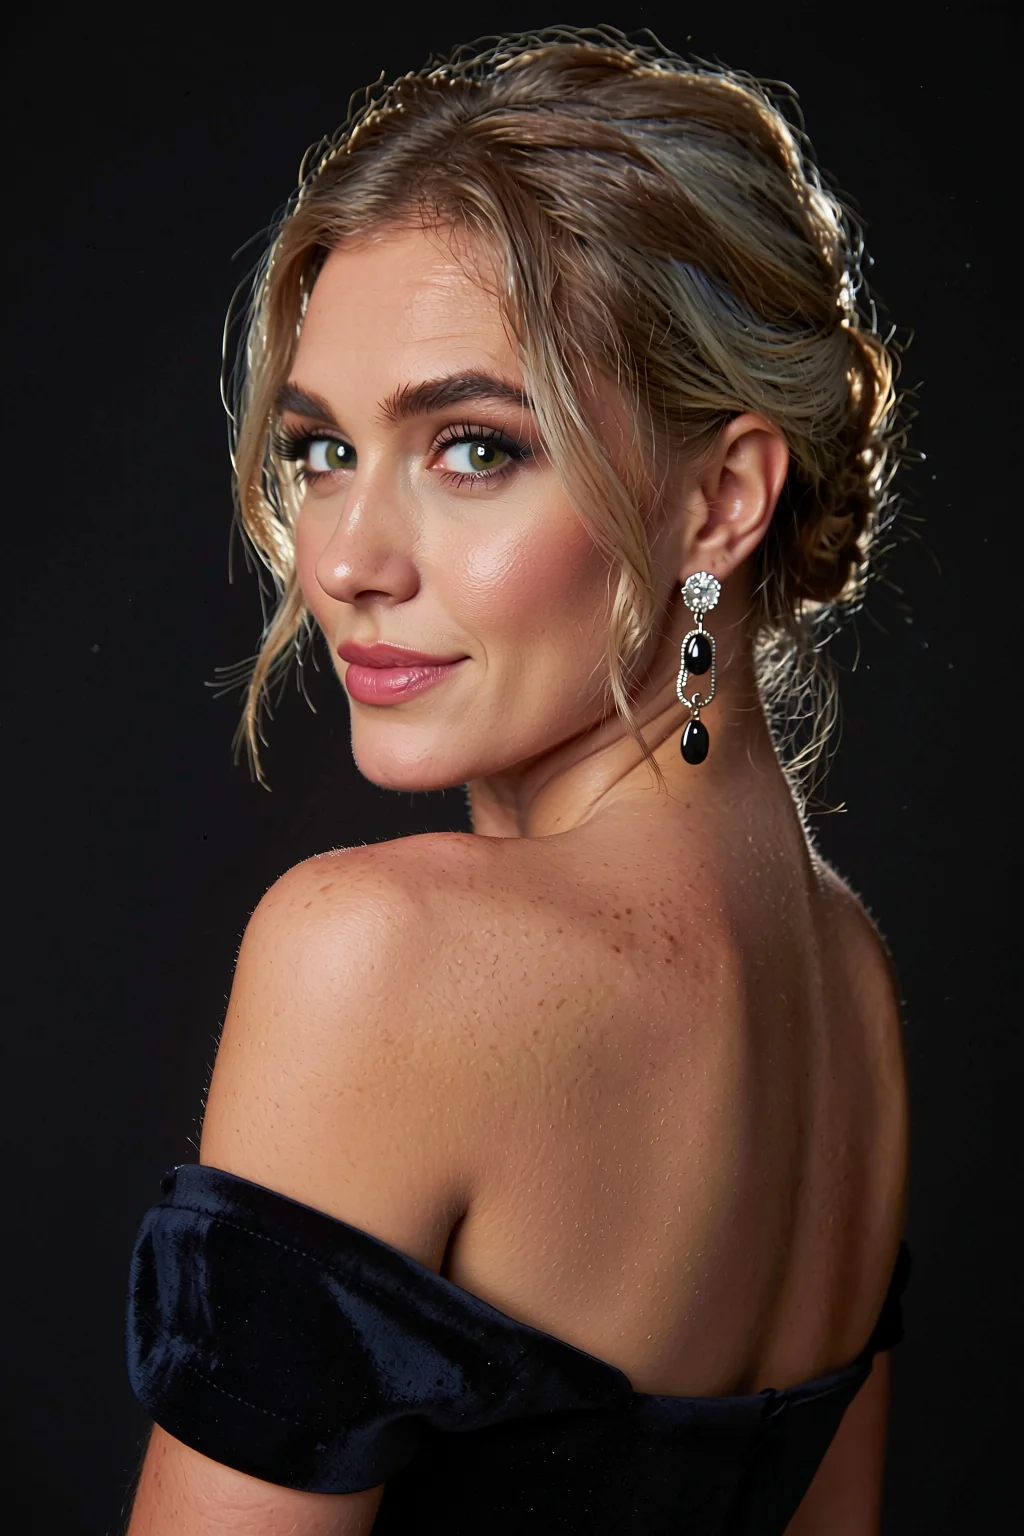
LoRA retuszu portretowego przy scale 1, 2:3, seed 1.
Studio portrait photo. A 36-year-old woman with silver-blonde hair pinned up wears an off-shoulder black velvet gown and long earrings, looking over her bare shoulder at the camera. Soft key light, dark backdrop, rim light on her hair.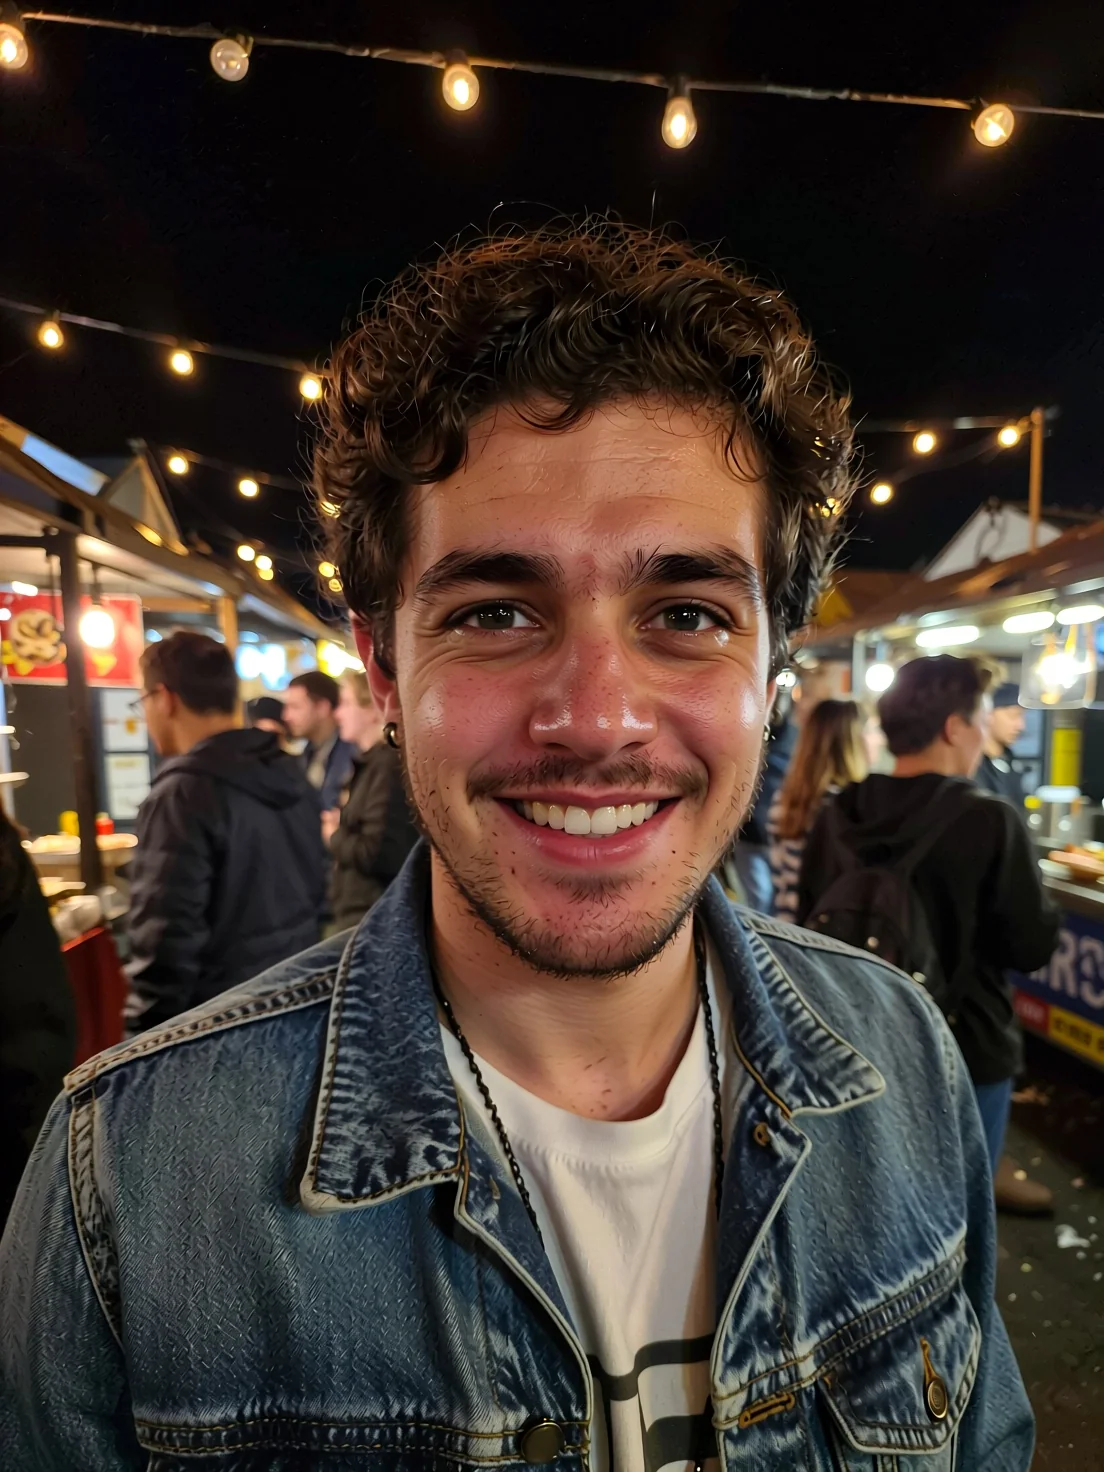
LoRA aparatu telefonu przy scale 1, 3:4, seed 1. Prompt: „Amateur phone photo with on-camera flash. A 31-year-old man with curly dark hair and a short beard in a denim jacket over a white T-shirt grins at the camera at a crowded night market, string lights and food stalls behind him.”
LoRA stylu ledwo go ruszają. Poprosiliśmy o portret w stylu „Japanese modern anime style”. Checkpoint bazowy zignorował frazę, podobnie jak LoRA anime do Qwen-Image przy scale 0.5, 1 i 2: piksele się zmieniły, ale obraz pozostał fotografią. Przy scale 4 obraz rozpadł się na zniekształcony zbliżony kadr z przerośniętymi oczami. LoRA pixel art do Qwen-Image-2512 zmieniła piksele i nie dała wyglądu pixel artu.
Wycinki twarzy, od lewej do prawej: bez LoRA; LoRA anime przy 0.5; ta sama przy 1; LoRA do FLUX przy 1. Ten sam prompt, seed 11, 3:4. Wszystkie cztery pozostają fotografiami.
LoRA do innego modelu bazowego nic nie robi. LoRA do FLUX wczytała się bez błędu i dała wynik identyczny co do piksela z użyciem bez LoRA. Udana odpowiedź nie oznacza, że plik pasował do modelu.
Użyteczny zakres scale wynosił około 0.5 do 1.5. Dwie połączone LoRA działały dobrze:
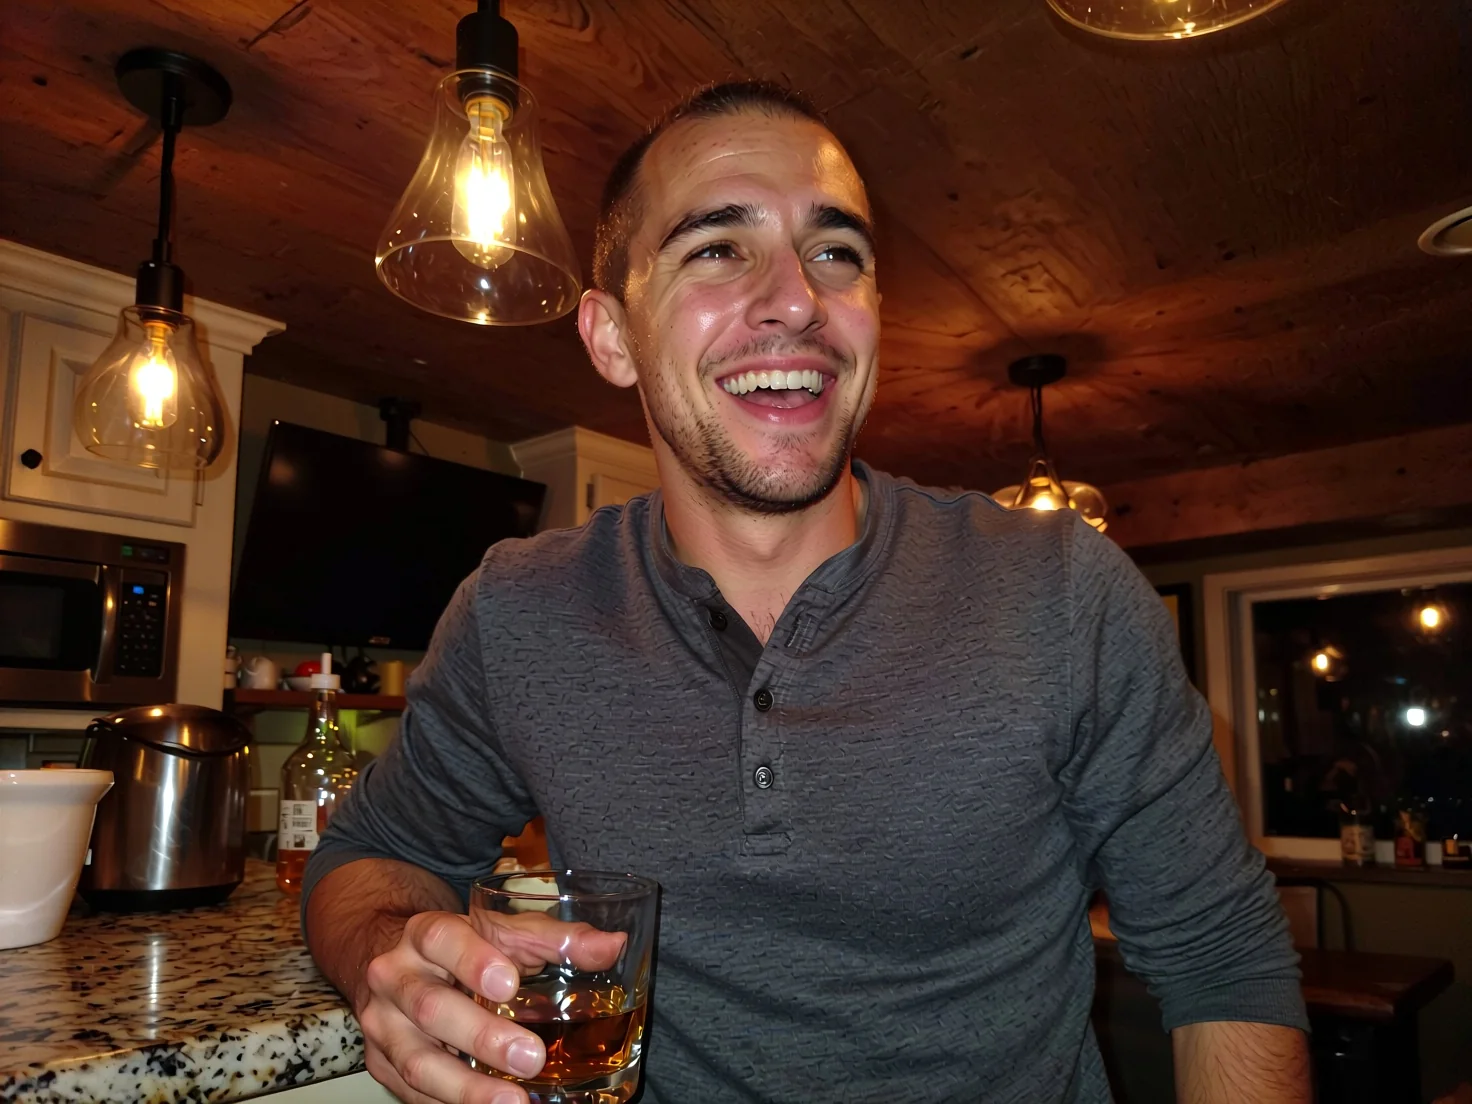
LoRA aparatu Samsung przy 0.8 plus AWPortrait przy 0.6, 4:3, seed 1.
Jib Mix Qwen czy Qwen Image 2512 LoRA
Oba to modele z rodziny Qwen-Image z maksymalnie trzema LoRA na trasie LoRA. Dobrze radzą sobie z różnymi zadaniami.
| Jib Mix Qwen (i wersja z LoRA) | Qwen Image 2512 LoRA | |
|---|---|---|
| Baza | Społecznościowy merge na Qwen-Image | Qwen-Image-2512 do generowania, Qwen-Image-Edit-2511 do edycji |
| Zadania | Tylko tekst na obraz | Tekst na obraz i edycja z 1 do 3 obrazów źródłowych |
| LoRA | Tylko w wersji z LoRA, do 3 | Do 3 w obu zadaniach |
| Wygląd z pudełka | Fotograficzne portrety, naturalna skóra | Ogólnego przeznaczenia; adaptery ustalają styl |
| Szybkość w naszych testach | Mediana 5,8 s (bazowy) | Niemierzona w tej rundzie |
| Proporcje obrazu | 9, do 1536 px | 9 dla generowania, do 1536 px; edycja podąża za pierwszym źródłem |
| Treści w naszych testach | Drabina dostarczona poza L4, złagodzonym | Przebieg drabiny z 27 września dostarczył 15 z 18 briefów na każdej trasie; trzy pudła były tą samą klasą intymnej sceny, którą jedna zewnętrzna LoRA dla dorosłych spełniła w każdym zadaniu 26 września |
Nasza reguła kciuka: wybierz Jib Mix Qwen, gdy chcesz gotowego fotograficznego portretu bez szukania LoRA i akceptujesz ograniczenie z twarzami. Wybierz Qwen Image 2512 LoRA, gdy potrzebujesz edycji, gdy masz już LoRA do bazy 2512 albo gdy chcesz, by baza czerpała wygląd z twojego adaptera. Nasz poradnik o dopasowaniu wag do zadania wyjaśnia podział 2512 i Edit 2511, a zestawienie hostowanych LoRA porównuje szersze pole.
Ograniczenia
- Twarze. Prośby o wschodnioazjatyckie twarze wróciły europejskie lub niejednoznaczne we wszystkich sześciu naszych próbach, a wiele seedów zbiega do podobnej twarzy.
- Rozpiętość stylów. Prompty i LoRA anime oraz pixel art zostawiły fotografie. Do rysowanego wyglądu użyj modelu ilustracji.
- Intymne sceny z dwiema osobami. Rysowane bez odmowy, z mniej precyzyjną anatomią.
- Brak promptu negatywnego, kroków i guidance, brak obrazu wejściowego, brak edycji.
- Jeden obraz na żądanie.
- Nieznana wersja. Trasa hostowana nie podaje, którą wersję Jib Mix Qwen uruchamia.
FAQ
Czy Jib Mix Qwen jest bez cenzury?
Tak. Platforma nie dodaje filtra treści. Treści z jednym podmiotem wracały w naszej drabinie zgodnie z prośbą, a sceny z dwiema osobami były rysowane bez odmowy, ale z mniej precyzyjną anatomią.
Czy potrafi robić wschodnioazjatyckie twarze?
Niezawodnie nie. Sześć próśb o Japonki, Koreanki lub wschodnioazjatyckie kobiety wróciło europejskie lub niejednoznaczne. Zmieniaj wiek, włosy i rysy zamiast używać narodowości.
Czy LoRA stylu na nim działają?
Ledwo. LoRA anime przy 0.5, 1 i 2 zostawiła obraz fotografią, a przy 4 obraz się rozpadł. Widoczne są LoRA fotograficzne, aparatowe i portretowe.
Jakiego scale użyć dla LoRA?
Zacznij od 1 i trzymaj się między około 0.5 a 1.5. Scale 4, czyli maksimum, rozbił obraz w naszym teście.
Czy LoRA do innego modelu bazowego działa?
Nie. LoRA do FLUX wczytała się bez błędu i niczego nie zmieniła. Używaj LoRA wytrenowanych pod Qwen-Image lub Qwen-Image-2512.
Użyć endpointu bazowego czy z LoRA?
Bazowego, jeśli nie będziesz wczytywać LoRA. Bez LoRA wersja z LoRA dawała w naszych sprawdzeniach wynik identyczny co do piksela z bazową na tym samym seedzie.
Czy może renderować tekst w obrazie?
Krótkie słowa tak. Nasze „OPEN LATE” na tablicy odczytało się poprawnie w obu seedach. Trzymaj frazę krótką i sprawdź literowanie przed publikacją.
Czy mogę nim edytować istniejące zdjęcie?
Nie. Oba endpointy to tekst na obraz. Do edycji z obrazami źródłowymi użyj Qwen Image 2512 LoRA.