Introduction
Z-Image Base LoRA Texte vers image dessine une image à partir d’un prompt écrit, avec jusqu’à trois de vos propres fichiers LoRA chargés. Il fait tourner Z-Image, le modèle de base de 6 milliards de paramètres de l’équipe Tongyi-MAI d’Alibaba : la version non distillée que ses auteurs présentent comme point de départ du fine-tuning et de l’entraînement de LoRA. Choisissez l’un des neuf ratios d’image. La plateforme n’ajoute aucun filtre de contenu au prompt, aux poids ni à l’image.
Choisir un mode selon le matériau de départ
| Matériau de départ | Mode |
|---|---|
| une description écrite | Z-Image Base LoRA Texte vers image |
| une image à restyliser | Z-Image Base LoRA Image vers image |
Fonctionnalités et points forts
La version sur laquelle les LoRA sont entraînés
Z-Image existe en une version Turbo distillée et rapide, et en cette version Base complète. L’éditeur recommande Base pour le fine-tuning ; un LoRA entraîné dessus, chargé ici, a changé tout le rendu lors de nos tests.
Trois à la fois
Jusqu’à trois LoRA par requête, chacun avec son propre scale de 0 à 4. Rien n’est à téléverser chez nous à l’avance et les fichiers ne sont pas vérifiés.
Des photographies par défaut
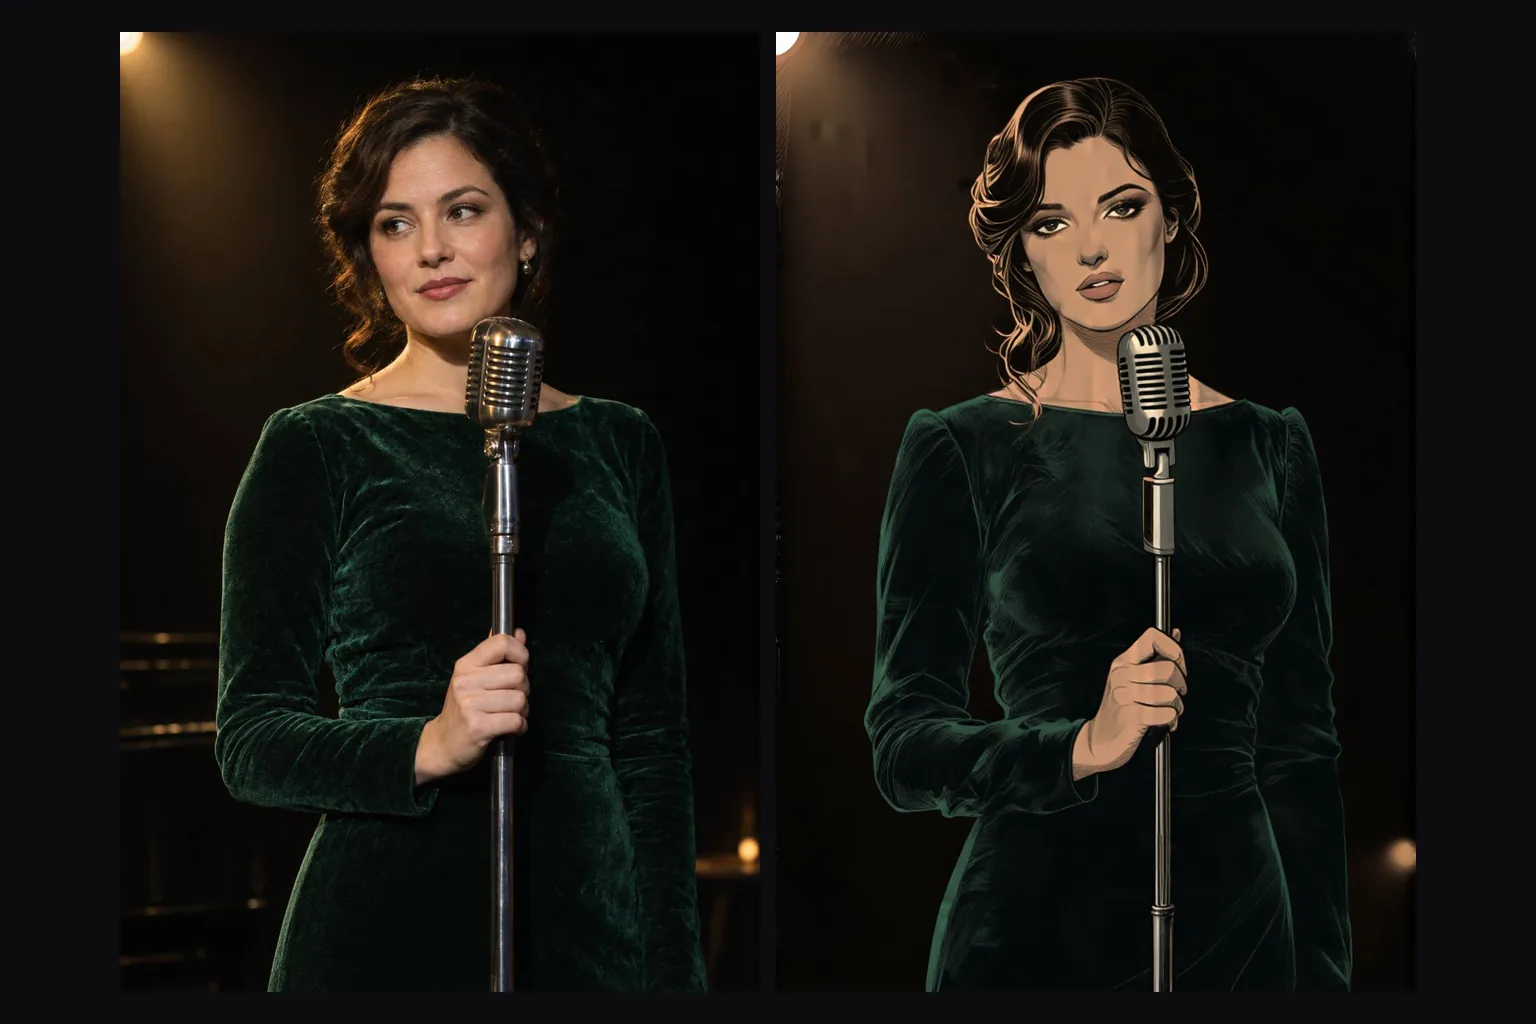
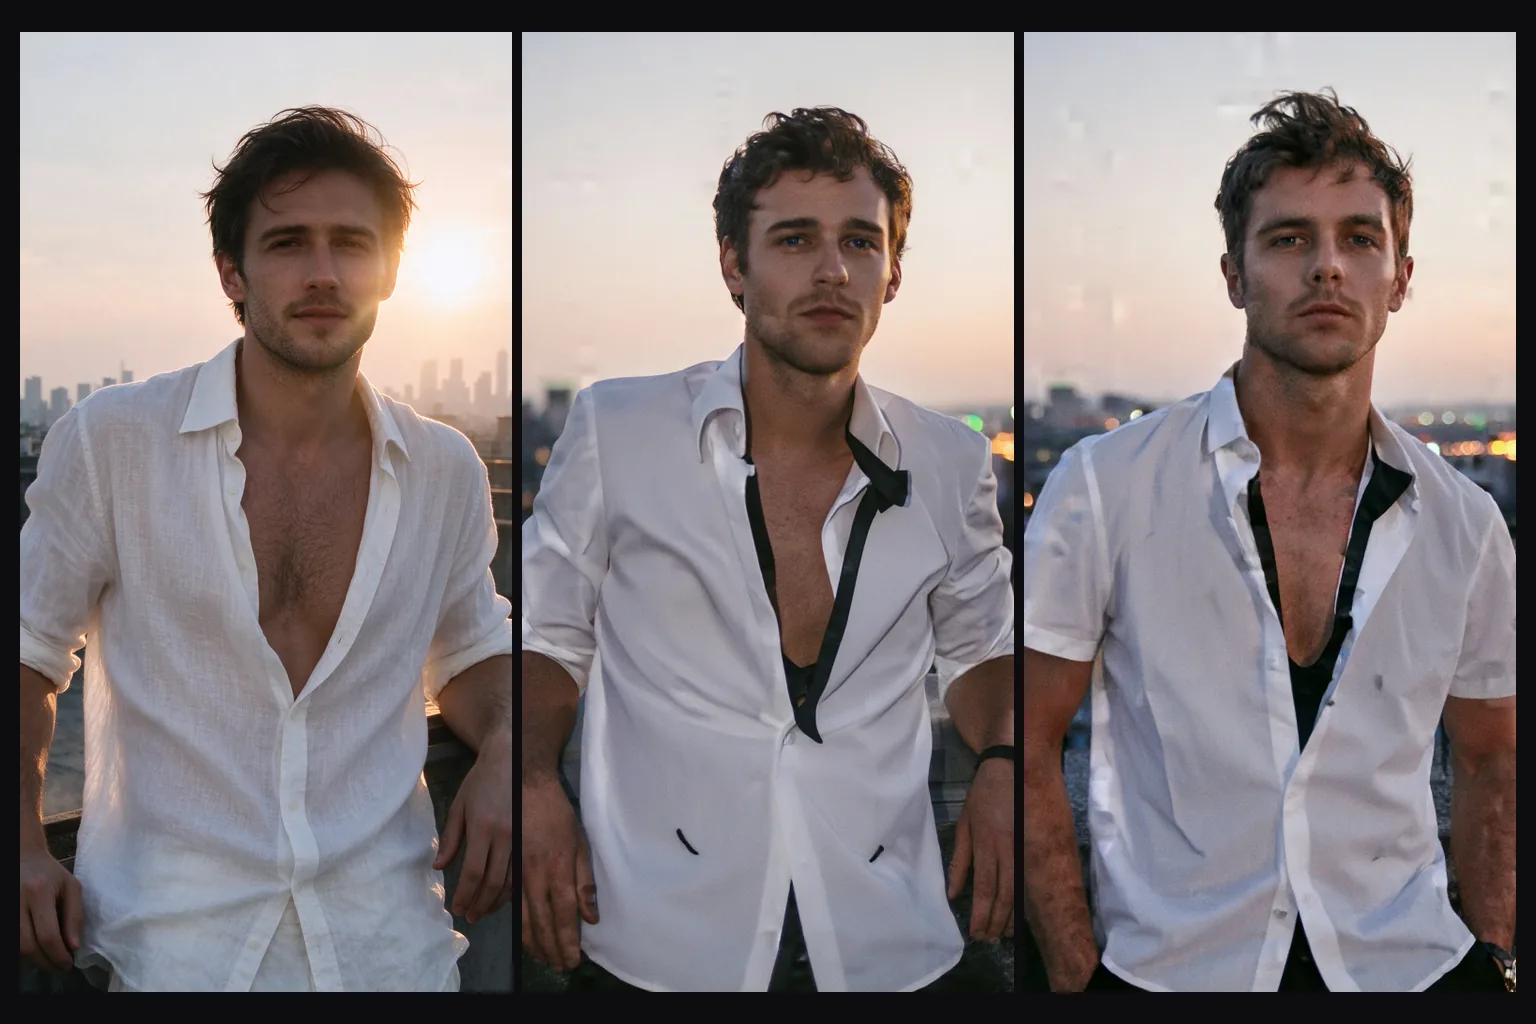
Sans LoRA, le modèle dessine des images photographiques avec une peau, une lumière et un grain naturels, et il suit de près les longs prompts descriptifs.
Aucun filtre de contenu
Il n'y a aucun filtre sur les prompts, les poids ni les résultats. Le modèle de base a rendu chaque niveau, de Léger à Maximum, sans hésiter, sauf Très fort : celui-ci est sorti flou plutôt que bloqué ; c'est précisément à cela que servent les LoRA non filtrés.
Paramètres de requête
| Paramètre | Obligatoire | Description |
|---|---|---|
prompt | Oui | Les phrases complètes donnent les meilleurs résultats : sujet, tenue, lieu, lumière et objectif. Placez d’abord la phrase déclencheur d’un LoRA. 1 caractères minimum · 5000 caractères maximum |
aspect_ratio | Non | Neuf formats d’environ un mégapixel, du 21:9 (1536 x 640) au 9:21 ; 1:1 par défaut. Le ratio change la forme, pas le prix. |
loras | Non | Jusqu’à trois entrées {path, scale} entraînées sur Z-Image Base ; scale de 0 à 4, 1 est neutre. Les LoRA Turbo ne sont pas compatibles. Valeur par défaut: |
output_format | Non | JPEG par défaut, ou PNG ou WebP. Le format ne change pas le prix. |
seed | Non | Garde une série d’images comparable pendant que vous changez un seul LoRA ou une seule phrase à la fois. Il ne garantit pas les mêmes pixels à chaque exécution. |
Tarification
$0.014 / image
Facturé à l’image. Le ratio d’image, le format de sortie et le chargement de LoRA ne changent pas le prix.
Cas d’utilisation
Un style maison pour toute une série
Chargez un LoRA de style, gardez sa phrase déclencheur en tête et enchaînez une liste de prompts. Toutes les images de la série partagent le même rendu.
Vos propres LoRA entraînés
Si vous entraînez sur Z-Image Base, testez le résultat ici à pleine qualité, sans faire tourner votre propre GPU.
Des images photographiques
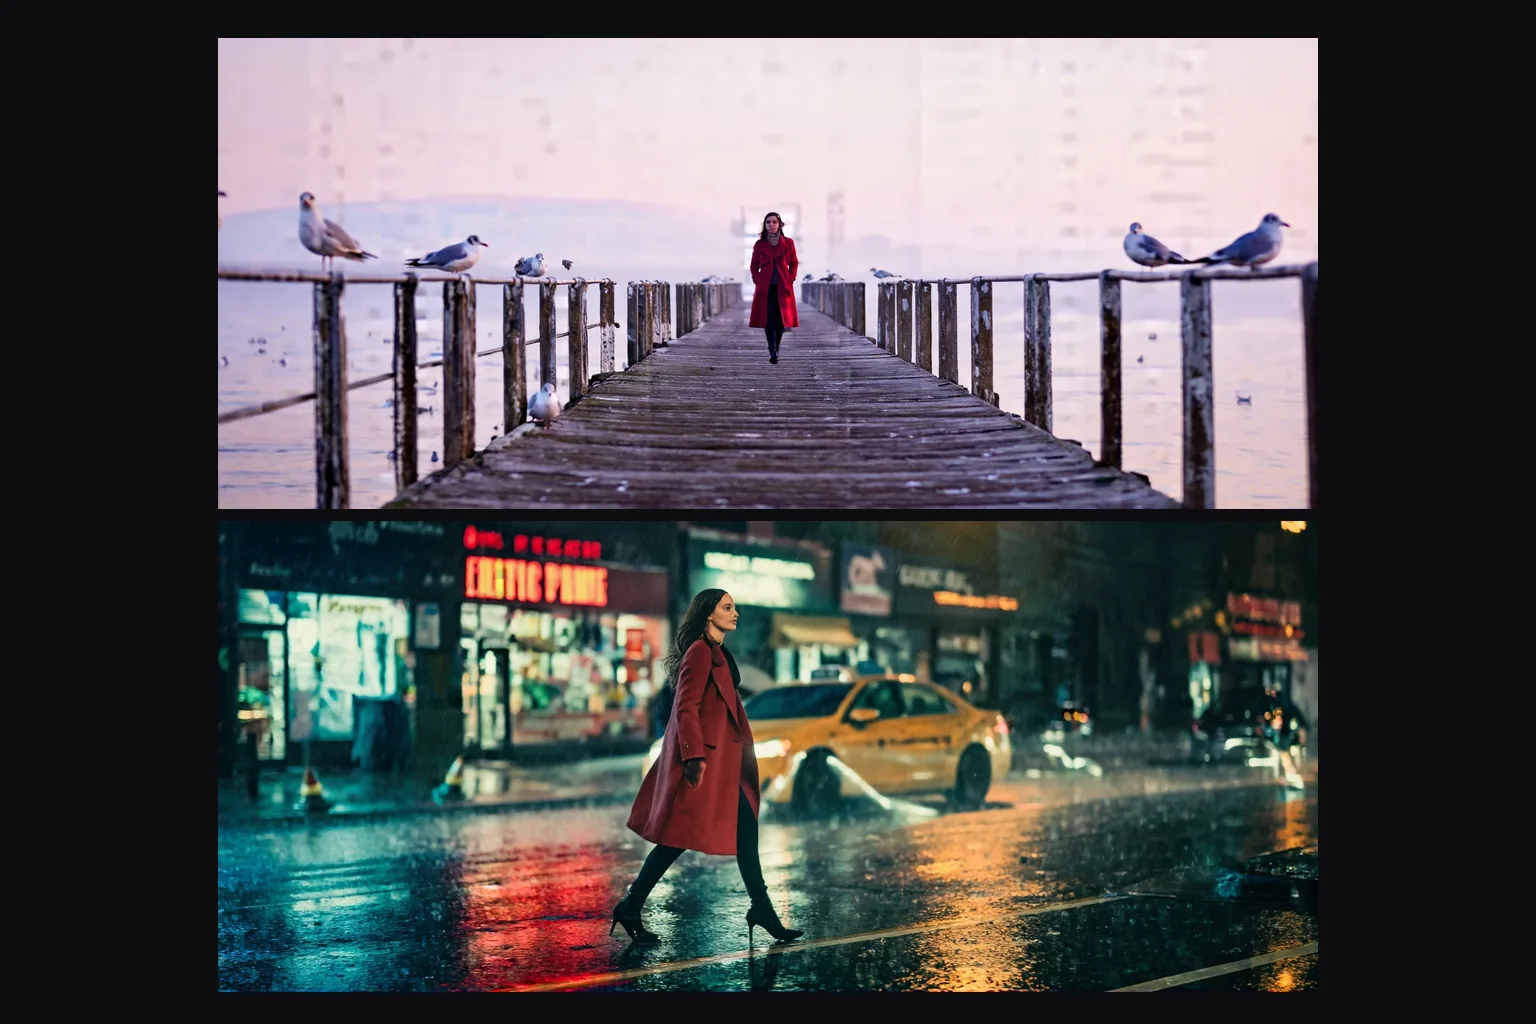
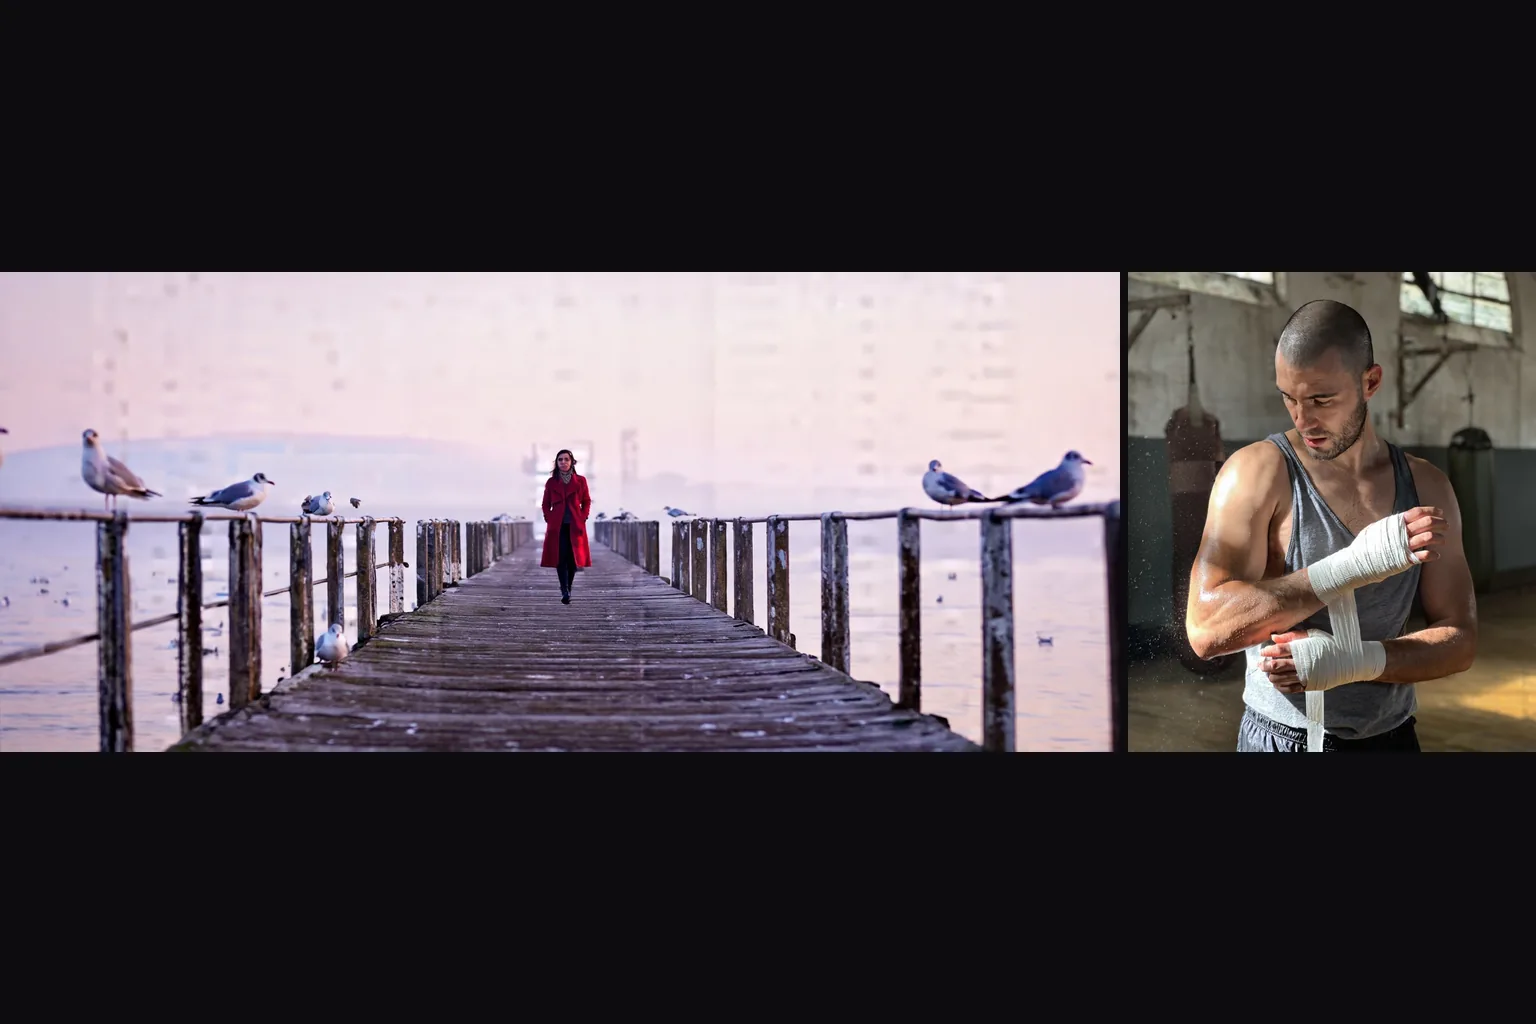
Portraits, images éditoriales et plans de cinéma à partir de phrases, en neuf formats du 21:9 au 9:21.
Guide de prompt et conseils pratiques
Écrivez des phrases
Décrivez le sujet, la tenue, le lieu, la lumière et l’objectif en phrases complètes. Lors de nos tests, le modèle a suivi des détails comme une tasse de café tenue à deux mains ou des mouettes sur une jetée.
Attention à la phrase déclencheur
Le respect du prompt est assez fort pour que la phrase déclencheur d’un LoRA suffise à elle seule à changer le style. Comparez les résultats avec et sans le fichier LoRA, pas seulement avec et sans la phrase.
Des LoRA Base, pas des LoRA Turbo
Un LoRA entraîné sur Z-Image Turbo a mis l’image en pièces sur cette version lors de notre test, sans erreur. Cherchez des LoRA entraînés sur Z-Image Base.
Prévoyez du temps
Base exécute bien plus d’étapes d’échantillonnage que Turbo : lors de nos tests, une requête texte vers image a pris de 10 à 57 secondes de temps de modèle, en général autour d’une demi-minute.
Démarrage rapide de l’API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "alibaba/z-image-base-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
La référence API détaille l’authentification, le schéma complet, le polling et la gestion des erreurs.