Vai al contenuto principale

Il text-to-image MiniMax H3 Image LoRA crea una singola immagine con MiniMax H3 a pesi aperti e fino a tre tue LoRA. Output di circa 1 o 4 megapixel in quindici proporzioni, in JPEG, PNG o WebP, senza filtri sul prompt.

Da $0.042/immagine

Playground

Input

Da testo a immagine
166/5000
Descrivi soggetto, ambientazione e luce come se stessi illuminando un’inquadratura di un film. Se un LoRA ha una parola trigger, mettila per prima. almeno 1 caratteri · al massimo 5000 caratteri
Quindici opzioni da 3:1 a 1:3. Tutti i formati costano uguale.
incide sul prezzo
1k è circa un megapixel e costa meno; 2k circa quattro. Itera a 1k.
LoRA di stile1/3

Vh5tape Vhs

Fino a tre voci {path, scale} addestrate per MiniMax H3; scale da 0 a 4, 1 è neutro. Anche i tuoi LoRA video H3 funzionano qui. al massimo 3 elementi
Formato di output
JPEGPNGWebP
JPEG di default, PNG o WebP se ti servono. Non cambia il prezzo.
Seed
Tiene vicina una serie di immagini mentre confronti le intensità dei LoRA. non meno di 0 · non più di 2147483647
Controllo di sicurezzaDisattivato

SpicyAPI non applica nessun controllo di sicurezza a questo modello. Il tuo prompt e i tuoi media arrivano al modello così come li hai scritti, ed è il modello stesso a decidere che cosa torna indietro.

Controllo del tuo account prima di abilitare invio e prezzi.

Output

Pronto per una nuova esecuzione
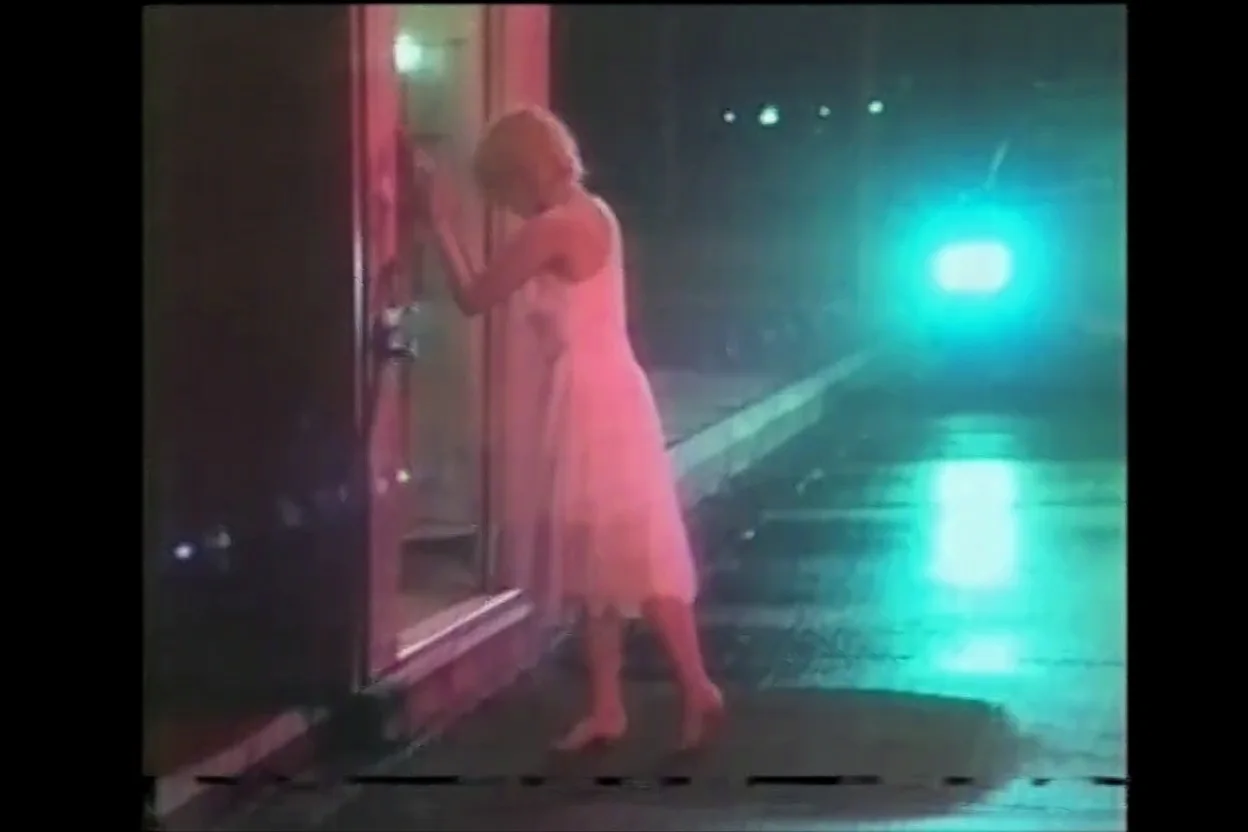
vhs-still-doorwayRisultato di esempio

Modelli correlati e attività successive

Manca il modello che ti serve?

Dicci cosa aggiungere e dove lo useresti. Le richieste arrivano a chi decide quali modelli integrare per primi.

Definisci il look sulle immagini prima di pagare i secondi di video

MiniMax H3 Image LoRA chiede al modello video H3 un singolo fotogramma, con fino a tre delle tue LoRA per H3 caricate e nessun filtro della piattaforma su prompt, pesi o immagine. Le immagini reggono anche da sole, ma rendono di più come prima fase, economica, di una pipeline video: ogni scelta di personaggio e di stile che fai qui passa dritta alle famiglie video H3, perché i pesi sono gli stessi file. Questa pagina spiega come usarlo in questo modo, e quelle poche cose che un'immagine fissa non può dirti.

Apri il Playground
Definisci il look sulle immagini prima di pagare i secondi di video
Usalo per
Scegliere e regolare le LoRA di personaggio e di stile prima di generare qualsiasi video
Cosa non può dirti
Come si comporta una LoRA di movimento o di camera: in un singolo fotogramma non c'è movimento
Fotogrammi destinati a diventare clip
Restano nei sette formati video: 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 o 9:21
Risoluzione dei fotogrammi iniziali
1k corrisponde più o meno a un fotogramma video a 768p; 2k per clip a 1080p o per immagini che restano immagini
Pesi
Gli stessi link LoRA per H3 che usi per il video, invariati
Filtro dei contenuti
Nessuno da parte della piattaforma; diritti e consenso restano a carico tuo
Il test più economico
Un look deciso in secondi, non in minutiUn'immagine torna in pochi secondi e si paga a immagine, mentre una clip si paga per secondo di video. Prova qui a gradini la forza di una nuova LoRA, confronta gli stack, fissa il seed e arriva al video con l'array loras già definito.
Set di riferimenti
L'endpoint edit prepara il tuo foglio di riferimentoReference-to-video tiene meglio un personaggio quando ogni input ha un solo compito. Usa l'editing per ricavare quegli input da un solo ritratto: un primo piano del volto, l'outfit a figura intera, la stanza da sola. Stessa persona, stessa LoRA, tre riferimenti puliti.
Limiti
Cosa un'immagine non mostraLe LoRA di movimento e di camera, la colonna sonora e la tenuta di un look per quindici secondi si rivelano solo in video. Verificali con una breve clip a 480p su MiniMax H3 LoRA quando l'immagine è a posto.

MiniMax H3 Image LoRA come prima fase di un video

Regola le forze qui, poi portale nel video

Regola le forze qui, poi portale nel video

Qui è il modello video H3 a restituire un fotogramma, quindi una LoRA di personaggio o di stile a 0.8 su un'immagine di solito dà un risultato vicino alla stessa LoRA a 0.8 in una clip. Trova la forza sulle immagini con un seed fisso, poi incolla lo stesso array loras nella richiesta video.

Crea un foglio personaggio per reference-to-video

Crea un foglio personaggio per reference-to-video

Invia un buon ritratto come Picture 1 e chiedi tre varianti, ognuna dedicata a un solo elemento: il volto in primo piano, l'outfit a figura intera contro un muro neutro, il luogo senza nessuno. Quelle tre immagini, con la stessa LoRA di personaggio, danno a reference-to-video un compito chiaro per ogni input.

  • Adatta il fotogramma alla clip che hai in mente

    Image-to-video mantiene la forma del suo fotogramma iniziale, e le modalità da testo e da riferimenti offrono sette formati. Crea i fotogrammi destinati a diventare clip in uno di quei sette, così ogni inquadratura della sequenza combacia. I formati in più disponibili qui, dai banner 3:1 ai ritratti 4:5, servono per le immagini che restano immagini.

  • Usa il 2k dove la clip lo sfrutterà

    Un'immagine 1k porta all'incirca tanti pixel quanto un fotogramma video a 768p, abbastanza per le bozze e per le consegne a 768p. Passa al 2k quando la clip verrà finalizzata a 1080p, o quando è l'immagine stessa il prodotto da consegnare.

  • Nessuna revisione della piattaforma: integra i tuoi controlli

    Da parte nostra nulla controlla i pesi o le immagini, ed è questo che permette alle LoRA senza censura di girare qui così come sono. I controlli di cui ha bisogno la tua attività, per esempio che ogni persona mostrata sia maggiorenne e che tu detenga i diritti su ogni somiglianza presente nei riferimenti, vanno nella tua pipeline, prima della richiesta e dopo il risultato.

Chi usa MiniMax H3 Image LoRA

  • Tavole disegnate già nel look finale

    Team di storyboard e pitch

    Tavole disegnate già nel look finale

    Crea ogni tavola dello storyboard come immagine con la LoRA di stile della campagna, fai approvare i fotogrammi e poi anima solo quelli approvati. Il look approvato dal cliente è quello che le clip ereditano, perché i pesi non cambiano mai tra le due fasi.

  • Lo stesso personaggio in tutto il catalogo

    Personaggi e volti di brand

    Lo stesso personaggio in tutto il catalogo

    Abbina una LoRA di personaggio all'endpoint edit per portare la stessa persona in nuovi outfit, luoghi e luci senza descriverne di nuovo il volto. Un link LoRA fissato e un seed fisso per ogni tipo di inquadratura evitano che un catalogo lungo vada alla deriva.

  • Identità e stile verificati in pochi secondi per checkpoint

    Chi addestra LoRA per H3

    Identità e stile verificati in pochi secondi per checkpoint

    Un'immagine risponde a gran parte di ciò che vuoi sapere su un checkpoint di personaggio o di stile: il volto regge, il look arriva, il prompt viene sovrastato? Esegui qui una batteria fissa per ogni checkpoint e tieni i test video per le domande sul movimento.

  • Prima l'immagine, la clip su richiesta

    App con un pulsante «anima»

    Prima l'immagine, la clip su richiesta

    Lascia che gli utenti generino e perfezionino un'immagine, poi offri un pulsante che la manda a image-to-video con lo stesso array loras. La clip parte dall'immagine che è già piaciuta, e il render più lungo e più costoso parte solo quando lo chiedono.

Dall'immagine alla clip con MiniMax H3 Image LoRA

  1. Carica le LoRA con cui pensi di animare

    Usa esattamente i link e le forze che intendi mandare al video, fissati a un commit. Un'immagine è un'anteprima fedele solo quando i pesi sono identici.

  2. Prova la forza a gradini a 1k

    Tieni fermi prompt e seed e prova tre forze per ogni LoRA. Le immagini tornano in pochi secondi, quindi una scala completa per uno stack di due LoRA si chiude in poco tempo.

  3. Crea il fotogramma nel formato della clip

    Scegli il formato video che userà la clip e descrivi il fotogramma come il primo istante dell'inquadratura, lasciando spazio nell'immagine al movimento che verrà.

  4. Se l'inquadratura li richiede, costruisci i riferimenti con l'editing

    Per reference-to-video, trasforma un ritratto in un primo piano del volto, un'inquadratura dell'outfit e un luogo vuoto, ciascuno richiamato come Picture a sé nel prompt video.

  5. Passa il testimone con lo stesso array loras

    Manda il fotogramma a image-to-video di MiniMax H3 LoRA o di Singularity, oppure il set di riferimenti a reference-to-video, con l'array invariato. Verifica lì le LoRA di movimento, a 480p e tre secondi.

Prompt per MiniMax H3 Image LoRA da copiare

  • Una scala di forza su una sola immagine

    Tre esecuzioni a 0.5, 0.8 e 1.1 sullo stesso seed mostrano il punto in cui una LoRA di stile inizia a prendere il sopravvento sul volto, e ti indicano la forza da portare nel video.

    Medium shot of a jazz singer in a green velvet dress at a vintage microphone, three spotlights behind her, haze in the air, warm key light from the left, shallow depth of field
  • Un foglio di riferimento da un solo ritratto

    Da eseguire sull'endpoint edit con un solo ritratto come Picture 1. Il volto arriva dal riferimento, quindi il prompt stabilisce solo inquadratura e sfondo.

    Picture 1 is the woman. Show her full-length, standing against a plain light-grey studio wall in the same camel coat, soft even light, arms relaxed at her sides
  • Un fotogramma iniziale pensato per la clip

    Scritto come il primo istante di un'inquadratura d'azione in un formato video, con spazio libero sul lato verso cui il soggetto sta per muoversi.

    Wide 16:9 frame of a rain-wet rooftop at night, a woman in a black jacket crouched at the left edge, about to sprint to the right, city lights blurred behind her, one hard rim light from the right

Altre domande su MiniMax H3 Image LoRA

Usa le immagini come prima bozza del tuo video

Carica esattamente i link LoRA con cui animerai, prova la loro forza a gradini sulle immagini con un seed fisso e crea ogni fotogramma nel formato e nella risoluzione che userà la sua clip. Quando un'inquadratura lo richiede, costruisci i set di riferimenti con l'endpoint edit. Poi passa il fotogramma e l'array loras invariato alle famiglie video, e giudica lì le LoRA di movimento, dove c'è davvero un movimento da giudicare.

Tutti i modelli MiniMax11

Modelli di immagine1

  • MiniMax H3 Image LoRAAttualeDa testo a immagine · Editing di immaginiDa $0.042per immagine