Pular para o conteúdo principal

daVinci-MagiHuman API

sand-ai/davinci-magihuman/image-to-video

O image-to-video do daVinci-MagiHuman anima a sua foto em um clipe de 5 a 10 segundos com movimento e voz: coloque a fala entre aspas no prompt ou anexe o seu próprio áudio. 256p, 720p ou 1080p, 16:9 ou 9:16.

A partir de $0.024/s

Playground

Entrada

Imagem para vídeo
211/5000
Descreva o que acontece depois da foto: o que a pessoa faz e, entre aspas, o que diz. Com audio_url, deixe as palavras de fora e descreva o clima, o movimento e a luz. pelo menos 3 caracteres · no máximo 5000 caracteres
1/1

Arraste arquivos ou links de mídia, cole ou selecione · 1 arquivo · Máx. 10 MB · JPG · PNG · WEBP

  • 1
1 / 1 arquivos
O quadro inicial. Um link público que possa ser baixado diretamente; o clipe parte dessa foto.
0/1

Solte um arquivo de áudio aqui ou procure no computador · 1 arquivo · Máx. 90 MB · MP3 · WAV

0 / 1 arquivos
Opcional. Um link público para um arquivo de fala ou de música; o vídeo é gerado em sincronia com ele, em vez de inventar uma voz. Nossa execução usou um trecho de 5 segundos para um clipe de 5 segundos.
16:9 (o padrão) ou 9:16. Nossas execuções de imagem para vídeo usaram 16:9. O formato não altera o preço.
afeta o preço
256p, 720p (o padrão) ou 1080p. Faixas mais altas custam mais por segundo. O modelo renderiza pequeno e a própria etapa de super-resolução gera as faixas mais altas; nossas execuções em 720p saíram com cerca de 1358 x 678.
Duraçãoafeta o preço
De 5 a 10 segundos, padrão 5, cobrados por segundo. não menor que 5 · não maior que 10
Seed
Inteiro opcional. A mesma seed com as mesmas entradas gera resultados parecidos, não garantidamente idênticos. não menor que 0 · não maior que 2147483647
Filtro de segurançaDesligado

A SpicyAPI não executa filtro de segurança neste modelo. Seu prompt e suas mídias chegam ao modelo exatamente como você os enviou, e o próprio modelo decide o resultado.

Verificando sua conta antes de liberar o envio e a estimativa de preço.

Saída

Pronto para uma nova execução
Resultado de exemplo

Não encontrou o modelo que precisa?

Conte qual modelo adicionar e para que você vai usá-lo. Os pedidos vão direto para quem decide os próximos modelos.

API DE VÍDEO FALADO

A API daVinci-MagiHuman em resumo

Um único modelo de 15 bilhões de parâmetros que gera a imagem e a voz juntas: uma pessoa falando para a câmera, a partir de texto ou de uma foto, em 5 a 10 segundos e com até 1080p.

Parâmetros
15B
Um só modelo gera a imagem e a trilha sonora juntos. Os pesos são abertos sob Apache 2.0.
Duração do clipe
5 a 10 s
Escolha de 5 a 10 segundos; o padrão é 5. Nossos clipes saíram a 25 fps.
Resolução máxima
1080p
256p, 720p (padrão) ou 1080p. O modelo renderiza em tamanho pequeno e uma etapa própria de super-resolução gera as faixas mais altas; os tamanhos saem próximos do nominal, como cerca de 1904 x 1088 em 1080p.
Formatos
2
Horizontal 16:9 (padrão) ou vertical 9:16, nos dois endpoints. Som e formato não mudam o preço.
Áudio próprio
Opcional
Envie um arquivo de fala ou de música como audio_url e o vídeo é gerado em sincronia com ele, em vez de inventar uma voz.
Idiomas de fala
6
Chinês (mandarim e cantonês), inglês, japonês, coreano, alemão e francês, conforme a lista do publicador. Testamos inglês.

Resultados

O que você pode criar com daVinci-MagiHuman

  • Texto para vídeo

    Uma fala, dita na varanda

    Um prompt com uma fala entre aspas gerou um clipe em 1080p de uma mulher de cabelo platinado curto em uma varanda noturna, com as luzes da cidade desfocadas atrás dela. Saiu com cerca de 1904 x 1088 a 25 fps, 5,0 segundos, com som, e a nossa transcrição da trilha bateu com a fala palavra por palavra. O processamento levou cerca de 3 min 53 s.

    Texto para vídeo, 1080p, 16:9, cinco segundos, com a fala entre aspas dita na trilha sonora.

  • Retrato

    Um clipe vertical com uma risada e uma fala

    Com o formato em 9:16, um homem de sardas e cabelo ruivo, em uma rua molhada de neon, ri e diz a fala. Em 720p saiu com cerca de 726 x 1270, 5,0 segundos, e a transcrição bateu palavra por palavra. O processamento levou cerca de um minuto. Escrevemos "looks straight into the camera" em vez de pedir uma selfie.

    Texto para vídeo em retrato, 9:16 em 720p, cinco segundos, com a fala entre aspas dita na trilha sonora.

  • Imagem para vídeo

    Uma foto que se vira e fala

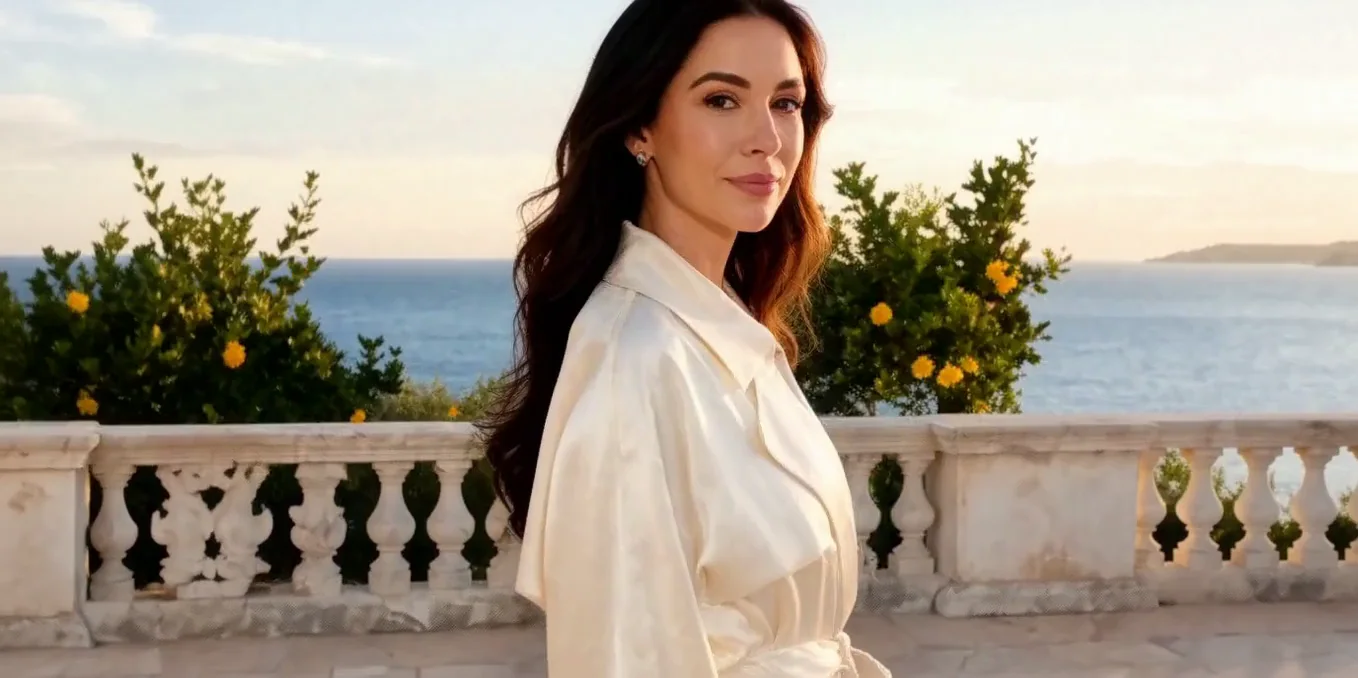
    A partir de uma imagem de quadro inicial e um prompt, sem arquivo de áudio, ela se afasta do mar, ajeita o cabelo atrás da orelha e diz a fala. A transcrição bateu palavra por palavra. Em 720p saiu com cerca de 1358 x 678, 5,0 segundos, após cerca de 1 min 45 s.

    Imagem para vídeo sem arquivo de áudio, 16:9 em 720p, cinco segundos, com a fala entre aspas dita na trilha sonora.

  • Áudio próprio

    Um retrato que segue a sua gravação

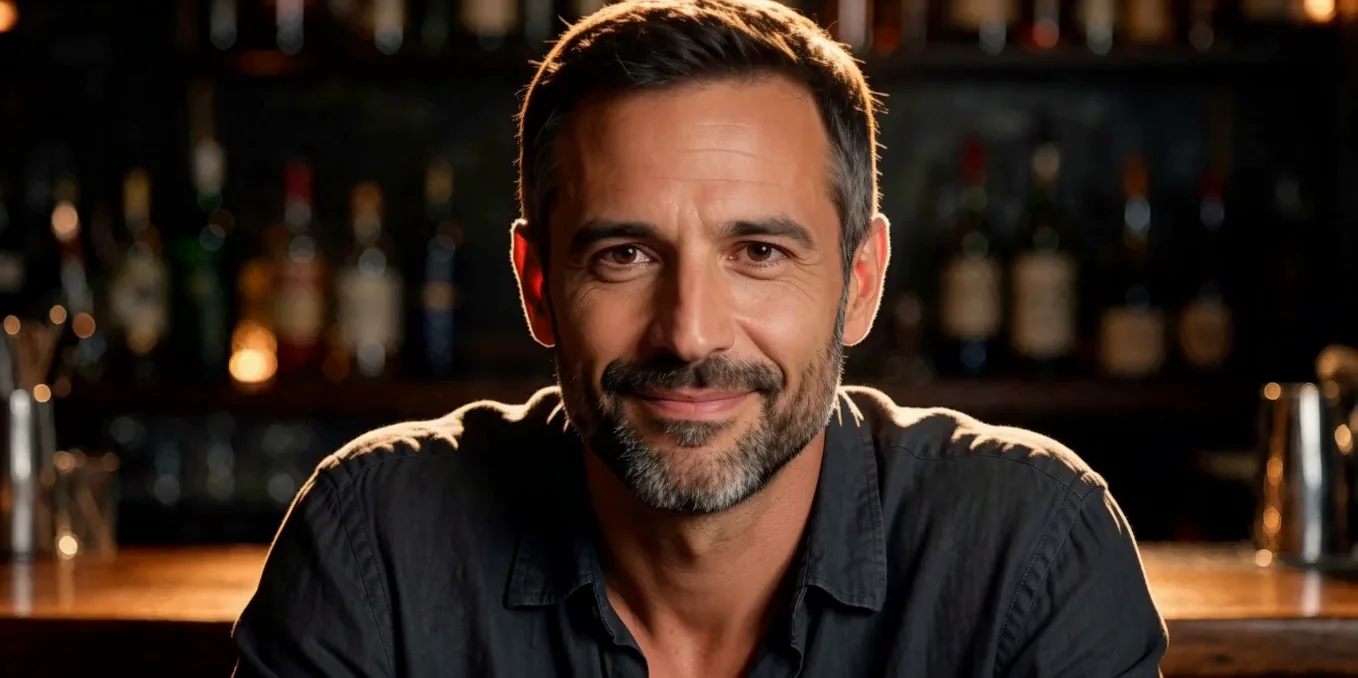
    Com um clipe falado de 5 segundos como audio_url, a boca acompanhou o áudio enviado, com um meio sorriso e movimento de sobrancelha, e o rosto continuou fiel ao retrato de entrada. Em 720p saiu com cerca de 1358 x 678, 5,0 segundos, após cerca de 3 min 7 s.

    Imagem para vídeo com um clipe falado de 5 segundos como audio_url, 16:9 em 720p, cinco segundos.

Antes de rodar

O que saber antes de usar o daVinci-MagiHuman

Todos os modos
Os clipes têm de 5 a 10 segundos, em 256p, 720p ou 1080p, na horizontal 16:9 ou na vertical 9:16. Os tamanhos saem próximos dos nominais, não exatos: 720p em 16:9 deu cerca de 1358 x 678 e 1080p deu cerca de 1904 x 1088. Testamos fala em inglês e não testamos canto. O que um clipe pode mostrar depende do seu prompt e da nossa política de uso.
Texto para vídeo
A pessoa e a cena vêm das suas palavras, então descreva o enquadramento; um pedido de selfie com celular colocou um celular no quadro em uma execução extra. Não rodamos audio_url neste endpoint.
Imagem para vídeo
É obrigatória uma imagem de quadro inicial, e o clipe parte dela. Todas as nossas execuções de imagem para vídeo usaram 16:9. Com audio_url, testamos um trecho de 5 segundos em um clipe de 5 segundos, e não testamos uma gravação mais curta ou mais longa que o clipe.

Casos de uso

O que construir com a API daVinci-MagiHuman

  • Clipes curtos com fala

    Uma pessoa diz uma frase para a câmera em 5 a 10 segundos: uma abertura, um teaser, uma saudação, com a voz gerada para você.

  • Clipes verticais para o celular

    Defina o formato como 9:16 para feeds e stories. Nossa execução vertical em 720p saiu com cerca de 726 x 1270.

  • Um retrato que fala com a sua gravação

    Parta de uma foto e adicione um arquivo de fala em audio_url; a boca acompanha o seu áudio e o rosto continua fiel à foto.

  • Testes de personagem e diálogo

    Teste como um personagem aparece e soa em uma foto de quadro inicial, com uma fala curta entre aspas, antes de montar uma peça mais longa. Testamos em inglês; o publicador lista mais cinco idiomas.

Prompts

Exemplos de prompts do daVinci-MagiHuman para copiar

Cole um deles no Playground sem alterações e depois mude uma coisa de cada vez.

  • Texto para vídeo

    Quem, onde, a fala entre aspas e depois a luz

    Resultado deste prompt

    Close-up at night on a hotel balcony, city lights blurred behind. A woman in her thirties with a short platinum bob and a black slip dress leans on the rail, looks into the camera with a sly smile and says softly: "You really thought I'd leave without saying goodbye?" Warm practical light, shallow depth of field.

    Por que funciona. A pessoa e o lugar vêm primeiro, a fala fica entre aspas com o jeito de dizer, e a luz fecha o prompt. A nossa transcrição bateu com a fala palavra por palavra.

    Testar este prompt
  • Texto para vídeo

    Diga para onde vão os olhos

    Resultado deste prompt

    Vertical medium close-up on a rainy neon-lit street at night. A man in his late twenties with freckles, short ginger hair and a wet denim jacket looks straight into the camera, laughs and says: "Okay, I'm lost, but honestly? Best night of the trip." Rain drips from his hair, pink and blue sign reflections on the wet pavement behind him. Handheld, eye level.

    Por que funciona. "Looks straight into the camera" definiu o enquadramento. Em uma execução extra, pedir uma selfie com celular colocou um celular no quadro.

    Testar este prompt
  • Imagem para vídeo

    Dê um momento seguinte à foto

    Resultado deste prompt

    On a sunlit stone terrace above the sea, she turns from the view to the camera, tucks her hair behind her ear and says warmly: "Stay for one more sunset. The boat can wait." Gentle sea breeze, soft golden light.

    Por que funciona. O prompt diz o que ela faz depois da foto: vira-se para a câmera, ajeita o cabelo e fala. As três coisas aconteceram, e a transcrição bateu.

    Este modo começa pela sua própria imagem: adicione-a no Playground antes de executar.

    Testar este prompt
  • Imagem para vídeo

    Com a sua voz, dirija o visual

    Resultado deste prompt

    Leaning on the bar, he speaks low and teasing, a slow half smile and a raised eyebrow, warm amber light.

    Por que funciona. As palavras vêm da gravação que você envia, então o prompt só define o clima, o movimento e a luz. A boca acompanhou o áudio, com um meio sorriso e movimento de sobrancelha.

    Este modo começa pela sua própria imagem: adicione-a no Playground antes de executar.

    Testar este prompt

Comparar

daVinci-MagiHuman x modelos parecidos: qual escolher

ModeloModosA partir deConteúdoEscolha se
OmniHuman 2.0Avatar falante$0.108 / segundo de saídaCom filtro — Este modelo recusa de forma clara os pedidos que passam dos seus próprios limites. É um resultado medido, não presumido; modelos que você não vê rotulados ainda não foram medidos.Você já tem a gravação de voz e um retrato, e quer um clipe mais longo, de até 300 segundos, guiado por esse áudio. Escolha o daVinci-MagiHuman quando quiser que o modelo fale uma fala que você escreve entre aspas, ou precisar de um clipe em 9:16.
Kling Avatar 2.0Avatar falante$0.051 / segundo de saídaCom filtro — Este modelo recusa de forma clara os pedidos que passam dos seus próprios limites. É um resultado medido, não presumido; modelos que você não vê rotulados ainda não foram medidos.Você tem um retrato e o seu próprio áudio e quer um clipe guiado por esse áudio, a mesma ideia do OmniHuman 2.0. Escolha o daVinci-MagiHuman quando quiser que o modelo fale uma fala que você escreve entre aspas.

Preços

Preços da API daVinci-MagiHuman

Um clipe de 5 segundos custa a partir de $0.12 em 256p e de $0.36 em 1080p.

O Playground mostra o preço exato das suas configurações antes de rodar. Tarefas com falha ou tempo esgotado normalmente não são cobradas. Alguns modelos cobram recusas de conteúdo conforme indicado na página do modelo; confira essas condições antes de enviar.

Ver todas as faixas de preço

Primeiros passos

Como usar a API daVinci-MagiHuman em três passos

  1. Passo 1

    Coloque a fala entre aspas

    O modelo fala o que está entre aspas. Diga quem fala e como (suavemente, com carinho, rindo) e só depois a fala em si. Nossas três falas entre aspas tinham de 8 a 10 palavras para um clipe de 5 segundos, e cada uma saiu palavra por palavra.

  2. Passo 2

    Descreva o enquadramento, não um aparelho

    Em uma execução extra em 9:16, pedir uma selfie com celular colocou um celular no quadro, virado para a câmera por trás. Escreva "looks straight into the camera" e o tamanho do plano ("vertical medium close-up") no lugar.

  3. Passo 3

    Traga a sua própria voz com audio_url

    Com um arquivo de fala ou de música anexado, o prompt já não precisa das palavras. Descreva o clima, o movimento e a luz, e a boca acompanha a gravação. Em nossa execução, uma gravação de 5 segundos combinou com um clipe de 5 segundos.

A referência de parâmetros e os exemplos de código estão nas abas API e Readme, no topo desta página.

Por que SpicyAPI

Por que usar o daVinci-MagiHuman na SpicyAPI

  • Nenhum filtro nosso

    Não adicionamos nenhum filtro de conteúdo próprio. O que o modelo gera é o que você recebe.

  • Testado na prática

    Os níveis de conteúdo vêm de gerações reais que rodamos e conferimos, com a data do teste na página.

  • Pague por resultado, em dólares

    Sem assinatura e sem créditos. Tarefas com falha ou tempo esgotado normalmente não são cobradas. Alguns modelos cobram recusas de conteúdo conforme indicado na página do modelo; confira essas condições antes de enviar.

  • Uma chave para todos os modelos

    Uma única chave de API e um único saldo atendem modelos de imagem, vídeo, áudio e chat, para você explorar mais modelos na mesma conta.

FAQ

Perguntas frequentes da API daVinci-MagiHuman

Sobre o daVinci-MagiHuman

daVinci-MagiHuman reúne em uma só API o modelo aberto de 15 bilhões de parâmetros da Sand.ai e da SII-GAIR: texto para vídeo e imagem para vídeo, com imagem e voz geradas juntas, de 5 a 10 segundos em 256p, 720p ou 1080p, na horizontal 16:9 ou na vertical 9:16, e com a opção de trazer o seu próprio áudio. A cobrança é por segundo da duração solicitada, e requisições com falha não são cobradas.

Modelos relacionados e próximas tarefas