Introdução
O Kling 2.6 Imagem para vídeo pega uma imagem inicial e um prompt descrevendo o que acontece depois, e retorna um clipe fixo em 1080p de 5 ou 10 segundos. Também não há campo aspect_ratio — a saída assume o formato da sua imagem de origem. generate_audio é opcional: ative para diálogo ou som ambiente renderizado com o movimento.
Escolha um modo do Kling 2.6 pelo material de partida
| O que você tem no início | Modo |
|---|---|
| uma cena escrita | Kling 2.6 Texto para vídeo |
| uma imagem inicial aprovada | Kling 2.6 Imagem para vídeo |
| um vídeo de referência e uma foto de personagem | Kling 2.6 Motion Control |
Recursos e destaques
A imagem inicial fixa o clipe inteiro
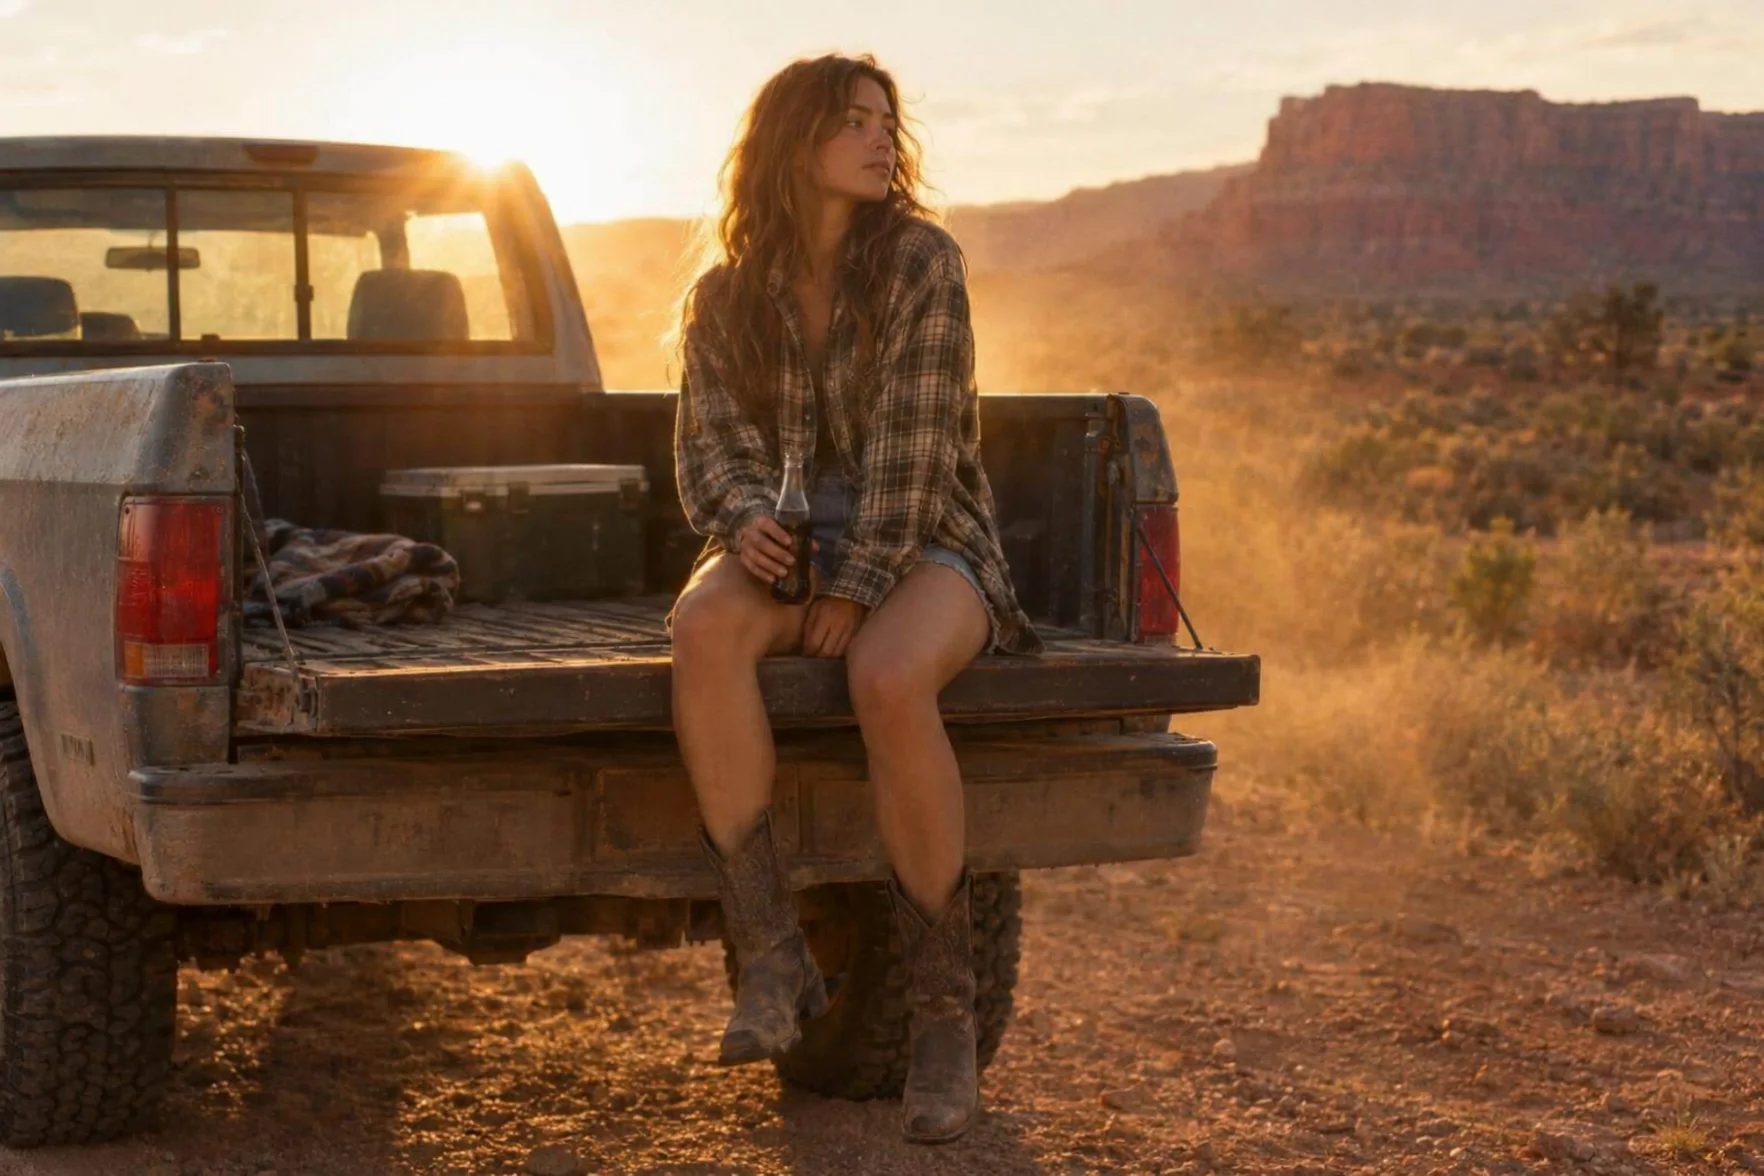
No nosso teste, a camisa xadrez de uma mulher, a picape e o cenário do deserto da imagem inicial se mantiveram por todo o clipe; o prompt só forneceu o gesto, a virada para o sol e a fala. No nosso teste na caçamba, uma única foto de camisa xadrez virou um clipe ao pôr do sol com uma fala, vento do deserto e um caminhão passando, tudo sem precisar redescrever o figurino ou o cenário que a foto já tinha fixado.
O som, quando você pede, acompanha a ação
Com generate_audio ativado, nosso teste retornou vento do deserto, grilos e um caminhão passando sincronizados com o momento em que ela fala — embora a mixagem tenha ficado mais baixa do que a imagem, vale a pena rodar de novo se você precisar do áudio mais presente.
Parâmetros da requisição
| Parâmetro | Obrigatório | Descrição |
|---|---|---|
prompt | Sim | Descreva só o que acontece depois da imagem: a ação, o movimento de câmera e, se você for ativar o som, o diálogo ou som ambiente. pelo menos 1 caracteres · no máximo 2500 caracteres |
image_url | Sim | Imagem inicial. A pessoa, a roupa e o cenário nesta imagem se mantêm ao longo do clipe. |
negative_prompt | Não | O que não pode aparecer: uma segunda pessoa, legendas, um objeto que o modelo insiste em trazer de volta. Escreva uma lista simples em vez de frases negativas. no máximo 2500 caracteres |
generate_audio | Não | Desligado por padrão. Ative para uma trilha sonora gerada, renderizada com a imagem; custa mais por segundo. Valor padrão: |
duration_seconds | Não | 5 ou 10 segundos — nenhum outro valor é aceito. Influencia o preço. |
guidance_scale | Não | O quanto o clipe segue o prompt à risca, de 0 a 1 em passos de 0,01; padrão 0,5. |
Preços
Cobrado por segundo de saída; ativar o som custa mais por segundo.
| Especificação | Preço |
|---|---|
| $0.069 / segundo |
| $0.138 / segundo |
Casos de uso
Transformar uma imagem aprovada em um momento sonorizado
Anime um personagem, produto ou local que você já fixou em uma foto, e acrescente uma fala curta ou som ambiente, em vez de descrever uma cena inteira do zero.
Clipes sociais de formato fixo
1080p, 5 ou 10 segundos, é um formato previsível e pronto para postar, quando você não precisa ajustar resolução ou duração por clipe. Esse formato fixo também torna este endpoint uma forma rápida de transformar um lote de fotos aprovadas de produto ou personagem em uma leva de clipes no mesmo formato para um feed.
Reencenando a mesma imagem com falas diferentes
Como a imagem inicial fixa o visual, você pode passar uma mesma imagem aprovada por vários prompts - uma fala diferente, um gesto diferente - mantendo a pessoa, o figurino e o cenário idênticos em cada versão.
Guia de prompt e dicas práticas
Descreva o próximo momento, não a cena inteira
Como a imagem já define o visual, o prompt só precisa do movimento, da câmera e — se generate_audio estiver ativado — do diálogo ou som ambiente que você quer. Redescrever o figurino ou o cenário que a foto já mostra só desperdiça palavras que o modelo poderia usar na ação.
Apenas JPEG ou PNG
O campo de imagem deste endpoint não aceita outros formatos. Converta sua imagem de origem para JPEG ou PNG antes de enviá-la. uma origem em WEBP ou HEIC falha antes mesmo de o job começar.
Se a mixagem de som sair baixa, diga isso no prompt
Nosso teste no deserto trouxe o vento, os grilos e o caminhão sincronizados com o momento em que ela fala, mas mixados mais baixo que a imagem. Se o som ambiente precisa soar tão alto quanto o diálogo, diga isso explicitamente no prompt em vez de presumir uma mixagem equilibrada por padrão.
Início rápido da API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "kling/2.6/image-to-video",
  "input": {
    "duration_seconds": 5,
    "generate_audio": false,
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Consulte a referência da API para autenticação, esquema completo, polling e tratamento de erros.