
alibaba/z-image-base-lora/text-to-imageTexto para imagem no Z-Image Base, o modelo Z-Image não destilado de 6 bilhões de parâmetros da equipe Tongyi-MAI da Alibaba, com até três LoRAs seus por requisição. Prompts em frases, nove proporções, JPEG, PNG ou WebP e nenhum filtro em prompts, pesos ou resultados.
Playground
Estes exemplos foram escritos para este endpoint. Substitua o prompt e as URLs de mídia de exemplo por suas próprias entradas acessíveis. Antes de enviar, confira a estimativa atual e a disponibilidade do modelo.
 Saída
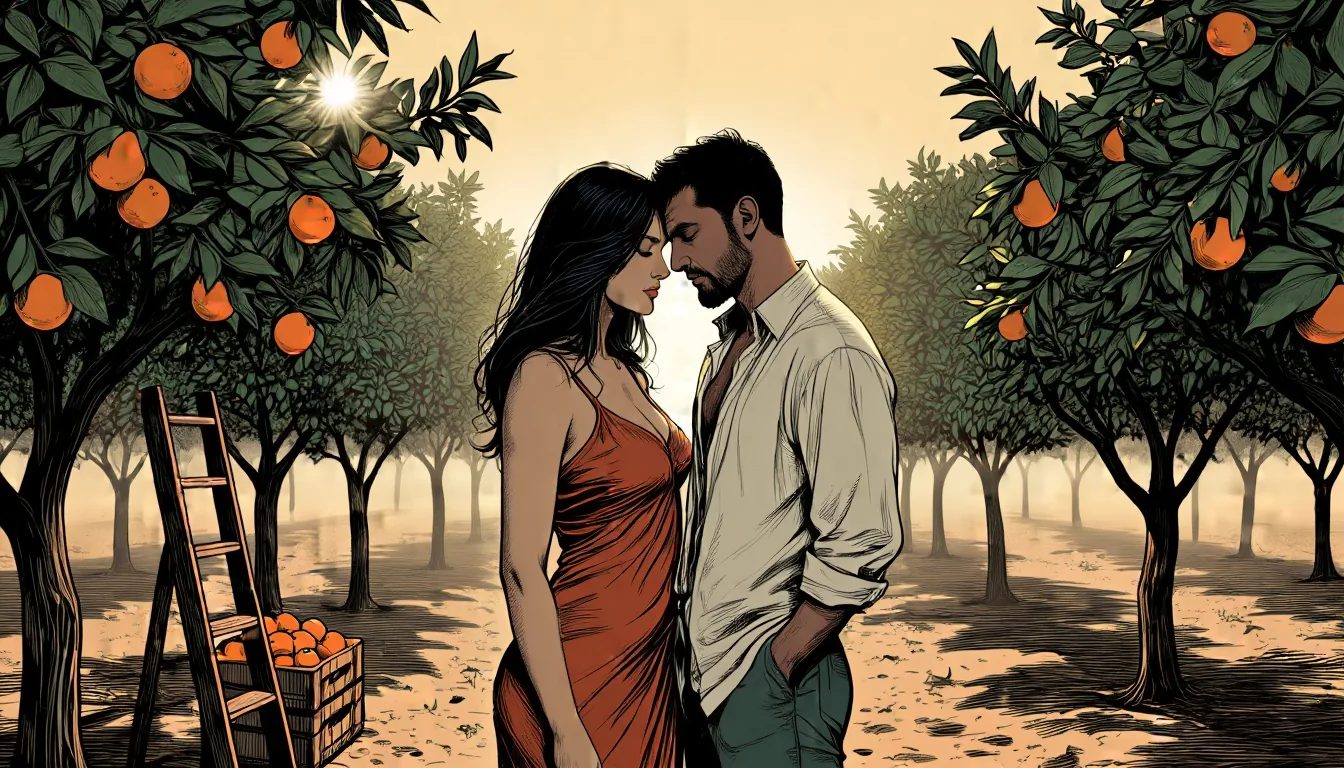
orange-grove-sunrise Um LoRA de ilustração treinado no Z-Image Base em 1, com a frase de gatilho "mature illustration with muted color and complex linework" no começo.
- 321
- 16:9
 Saída
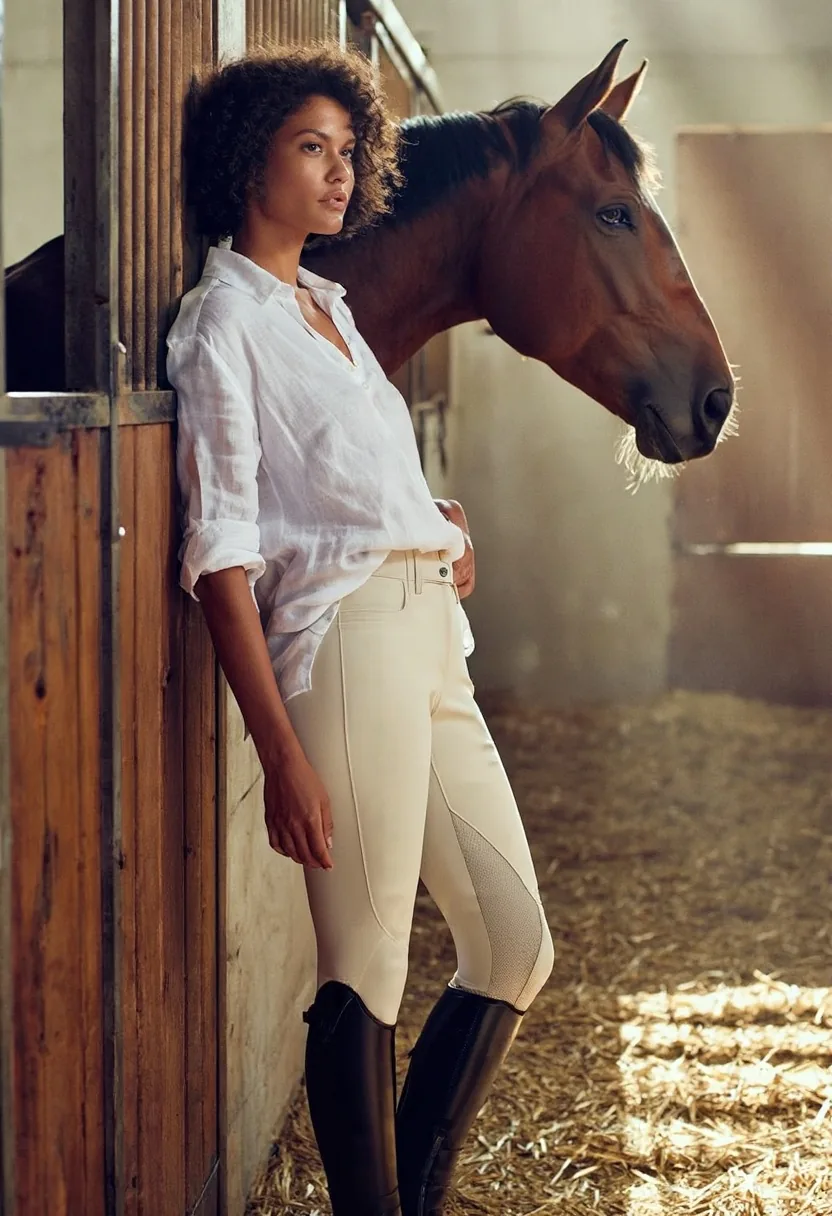
stable-first-light Sem LoRA: uma frase longa com pessoa, roupa, lugar e luz, e depois a lente. O modelo base resolve o visual fotográfico sozinho.
- 302
- 2:3
 Saída
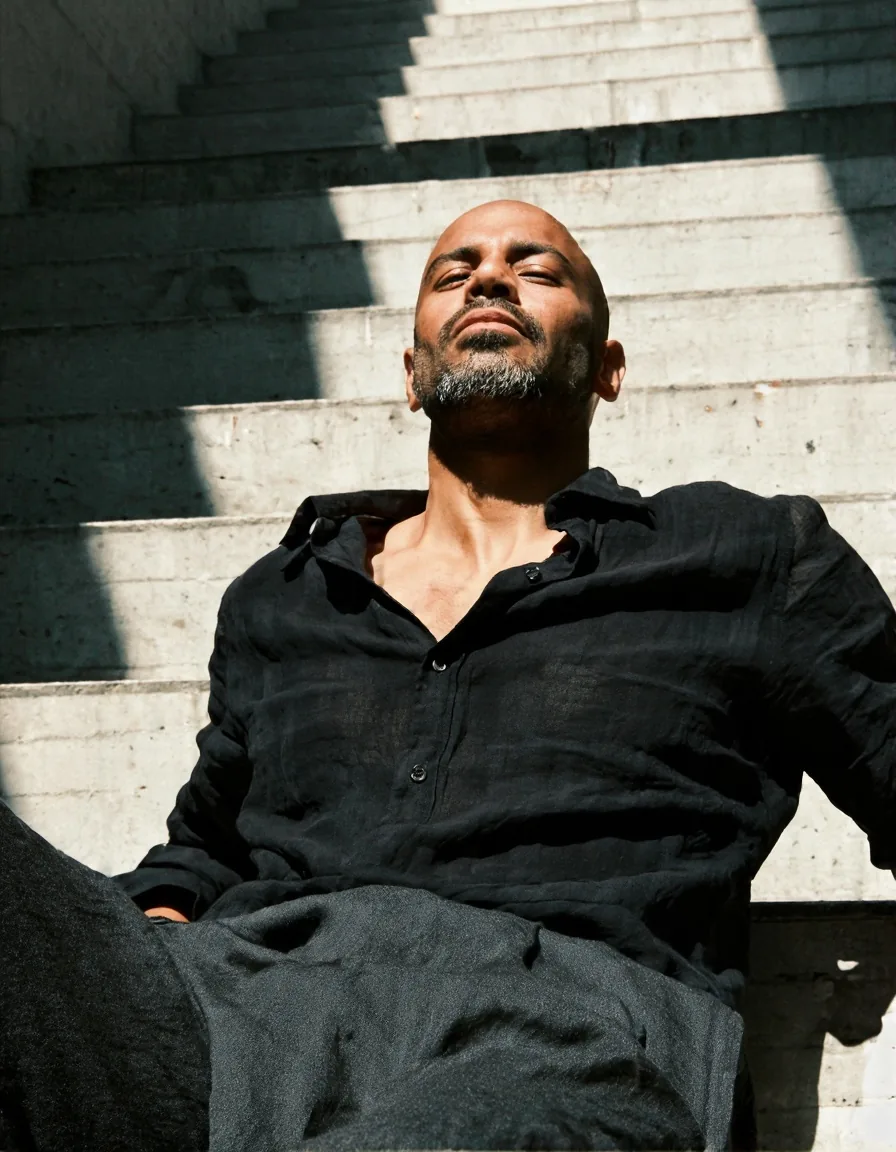
brutalist-stair-noon Sem LoRA, 3:4. A luz dura e as faixas diagonais de sombra escritas no prompt é que formam o quadro.
- 311
- 3:4
 Saída
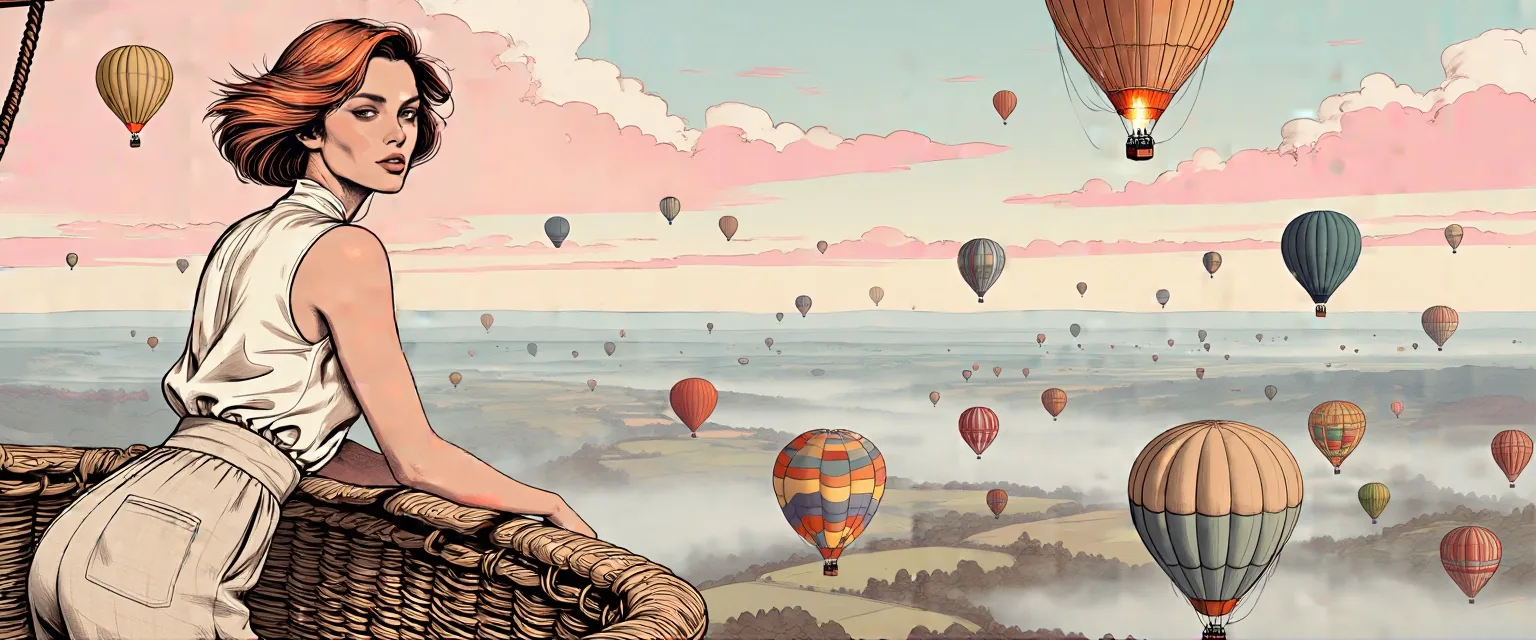
balloon-dawn-21x9 O mesmo LoRA em 0,8 no formato mais largo, 21:9 (1536 x 640): uma panorâmica com uma figura em primeiro plano.
- 337
- 21:9
Este exemplo começa em $0.014 por imagem. O Playground recalcula a estimativa sempre que você muda as configurações.