Pular para o conteúdo principal

Texto para imagem no Z-Image Base, o modelo Z-Image não destilado de 6 bilhões de parâmetros da equipe Tongyi-MAI da Alibaba, com até três LoRAs seus por requisição. Prompts em frases, nove proporções, JPEG, PNG ou WebP e nenhum filtro em prompts, pesos ou resultados.

A partir de $0.014/imagem

Playground

Entrada

Texto para imagem
406/5000
Frases completas funcionam melhor: sujeito, roupa, lugar, luz e lente. Coloque primeiro a frase-gatilho do LoRA. Até 5.000 caracteres; não há prompt negativo. pelo menos 1 caracteres · no máximo 5000 caracteres
Nove formatos de cerca de um megapixel, de 21:9 (1536 x 640) a 9:21; 1:1 por padrão. A proporção muda o formato, não o preço.
LoRAs de estilo1/3

Mikkoani

Até três entradas {path, scale} treinadas no Z-Image Base; scale de 0 a 4, sendo 1 o neutro. LoRAs do Turbo não são compatíveis. Use um link público e direto para o arquivo .safetensors. no máximo 3 itens
Formato de saída
JPEGPNGWebP
JPEG por padrão, ou PNG ou WebP. O formato não muda o preço.
Seed
Mantém um conjunto de imagens comparável enquanto você muda um LoRA ou uma frase de cada vez. Não garante os mesmos pixels a cada execução. não menor que 0 · não maior que 2147483647
Filtro de segurançaDesligado

A SpicyAPI não executa filtro de segurança neste modelo. Seu prompt e suas mídias chegam ao modelo exatamente como você os enviou, e o próprio modelo decide o resultado.

Verificando sua conta antes de liberar o envio e a estimativa de preço.

Saída

Pronto para uma nova execução
orange-grove-sunriseResultado de exemplo

Modelos relacionados e próximas tarefas

Não encontrou o modelo que precisa?

Conte qual modelo adicionar e para que você vai usá-lo. Os pedidos vão direto para quem decide os próximos modelos.

Rode LoRAs feitas para o Z-Image Base e refaça o estilo de fotos com um controle de strength

O Z-Image Base LoRA roda o Z-Image Base, o modelo de fundação de 6 bilhões de parâmetros da Tongyi-MAI, na Alibaba, com até três LoRAs em texto para imagem e em imagem para imagem. O Base é o modelo não destilado sobre o qual a comunidade treina, por isso é mais lento que o Turbo: texto para imagem levou de 9,8 a 56,7 segundos, com mediana de 32,8, e as edições de 4,9 a 41,7, com mediana de 16,8. Nada filtra o prompt nem a imagem, embora o modelo base sozinho desenhe mal o nível Muito forte do nosso teste de conteúdo, e é para isso que existem LoRAs.

Abrir o Playground
Rode LoRAs feitas para o Z-Image Base e refaça o estilo de fotos com um controle de strength
LoRAs por requisição
Até 3, cada uma {path, scale}; o arquivo precisa ser treinado no Z-Image Base, não no Turbo
Strength da edição
De 0 a 1, padrão 0.7; perto de 0.6 refez o estilo com uma LoRA, 0.75 remontou a cena
Tamanhos
9 proporções com até 1536 de lado; edições aceitam 1k ou 1.5k no lado maior e mantêm a proporção da origem
Velocidade
Texto para imagem: mediana de 32,8 segundos em 36 execuções; edição: mediana de 16,8 segundos em 28
Preço
Cobrado por imagem, com um valor único; tamanho, imagem de origem e número de LoRAs não o alteram
Não disponível
Passos, guidance e prompt negativo; o endpoint não tem esses campos
Modelo base certo
Uma LoRA do modelo errado falha sem dar erroUma LoRA treinada no Z-Image Turbo, carregada no Base, desfez a imagem em ruído e pseudotexto. Uma LoRA Pony e um arquivo rotulado como Z-Image, salvo em outro formato de chaves, carregaram e não mudaram nada. Use arquivos treinados no Base e rode antes um par com e sem o arquivo.
Limites da edição
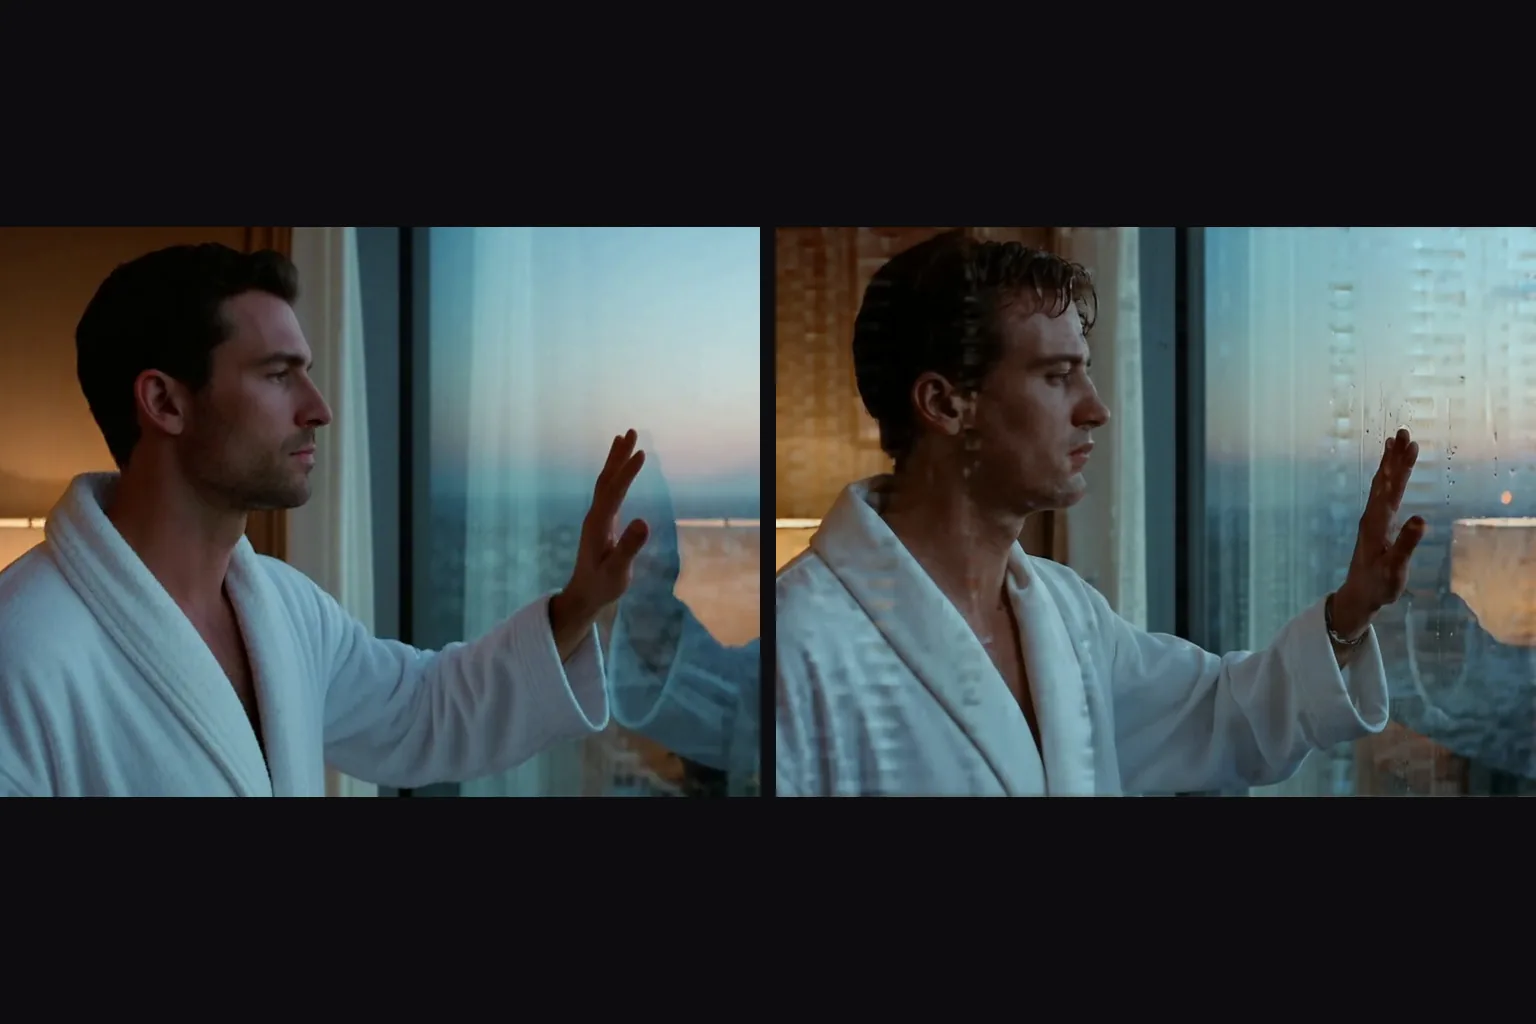
A edição redesenha o quadro e não segue instruçõesSem LoRA, pedir preto e branco com strength 0.65 e 0.8 continuou colorido, e pedir um smoking com 0.7 e 0.8 mudou pouco. Descreva a imagem inteira que você quer e traga uma LoRA de estilo quando quiser que o visual mude.
Limite honesto
Um único nível de conteúdo sai suavizadoNenhum filtro de conteúdo fica na frente do modelo, e nos dois endpoints, nosso teste de conteúdo em cinco níveis renderizou todos os níveis exceto Muito forte, inclusive Máximo. Muito forte voltou suavizado em três tentativas: o modelo base não o desenha de forma convincente por conta própria, e é para isso que servem as LoRAs treinadas para ele.

Como trabalhar com Z-Image Base LoRA

Escreva prompts de foto como frases simples

Escreva prompts de foto como frases simples

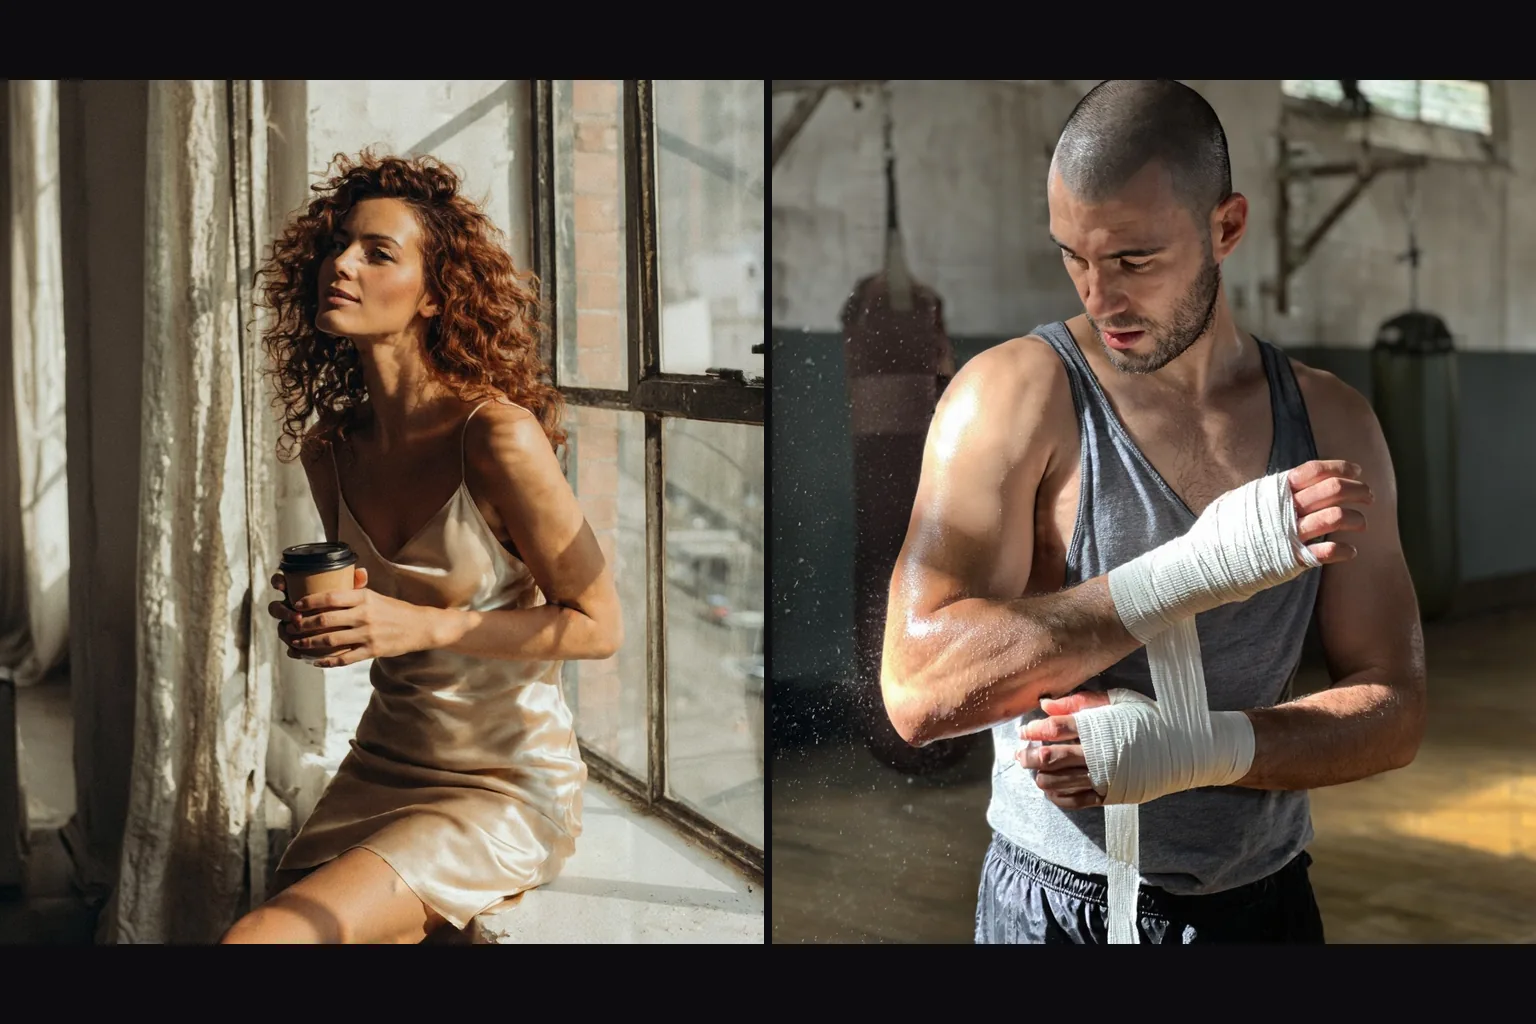
A aderência ao prompt é forte, então descreva a fotografia como você faria o briefing para um fotógrafo: personagem, roupa, lugar, luz, grão. Nossos retratos do loft e da academia saíram de uma frase cada. O mesmo formato de frase, trocando só o personagem, sustenta uma série inteira.

Use LoRAs treinadas no Base

Use LoRAs treinadas no Base

Uma LoRA treinada no Z-Image Base funcionou com 0.5 e com 1. A LoRA de ilustração mikkoani se ativa com a frase “mature illustration with muted color and complex linework” no início do prompt, e só a frase, sem o arquivo, já empurrou um prompt de foto para o lado da ilustração.

  • Escolha a strength antes de reescrever o prompt

    Na edição, a strength decide quanto da origem sobrevive. Na nossa escada, 0.3 e 0.5 deixaram a imagem quase igual e 0.6 a mudou um pouco. Com 0.7 o conteúdo começou a mudar com a composição mantida, 0.75 reposicionou e remontou a cena mantendo a luz e a paleta, e 0.85 deu uma imagem nova. Com uma LoRA de estilo, 0.6 refez o estilo do quadro todo e manteve a composição exatamente.

  • Espere reestilização, não instruções

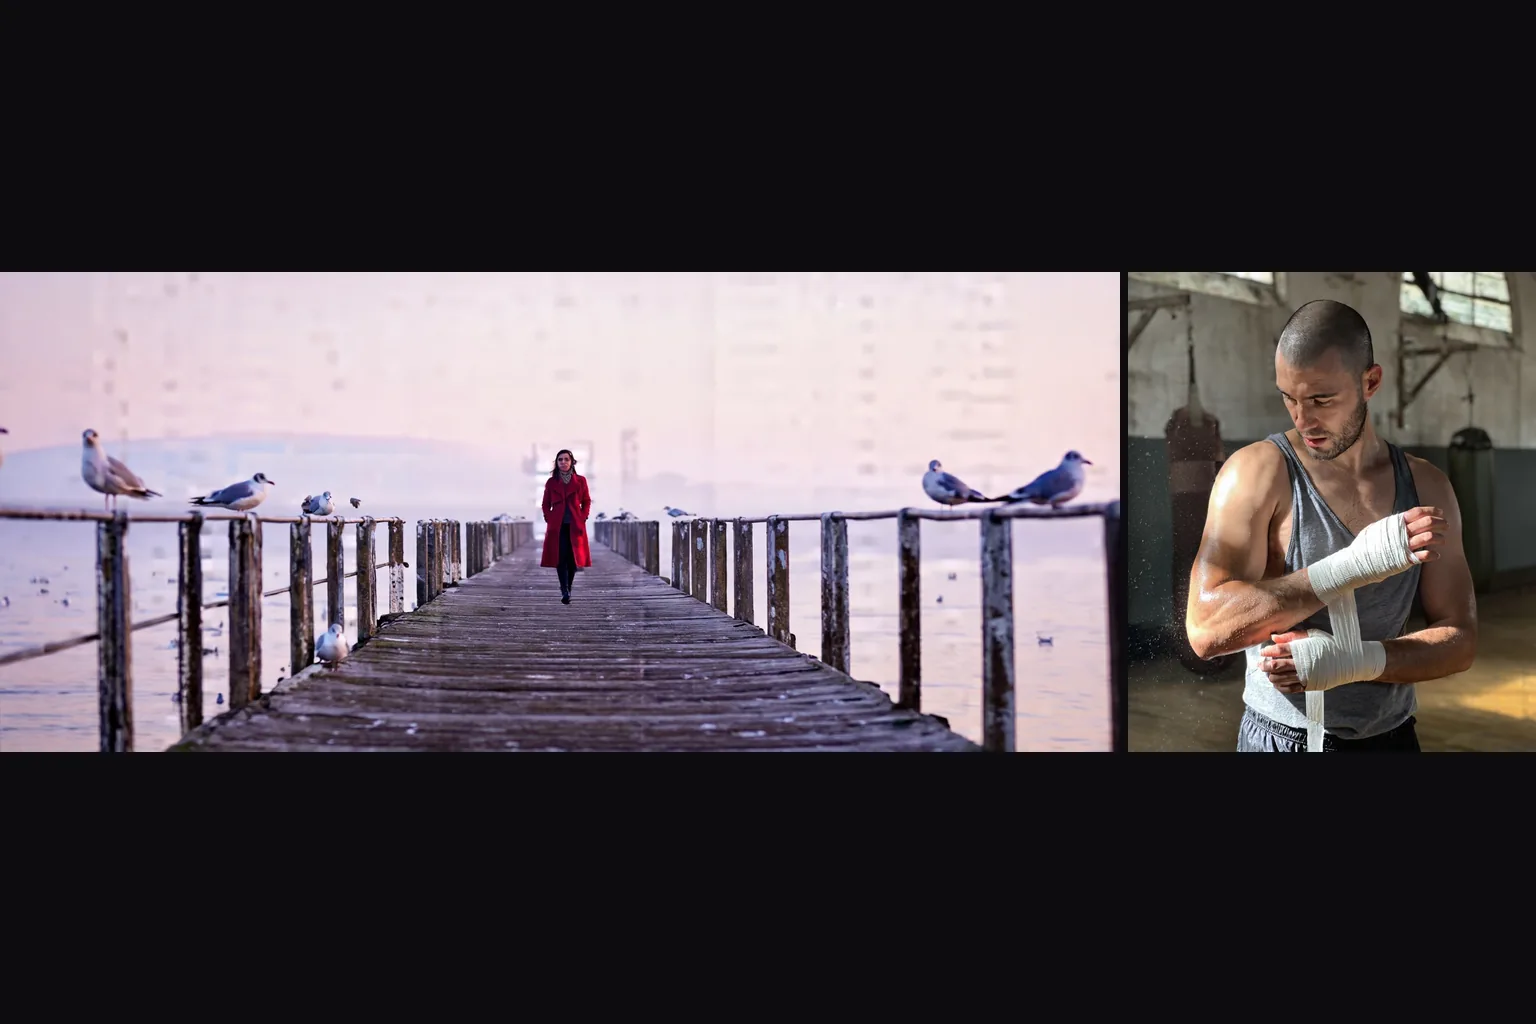
    O modelo de edição redesenha o quadro a partir da sua descrição. “Make it black and white” continuou colorido com 0.65 e 0.8 no nosso teste, como mostra a imagem da direita. Para trocar o meio artístico, use uma LoRA de estilo; para uma cena diferente, descreva-a por inteiro.

  • Atenção aos tamanhos

    Texto para imagem oferece nove proporções, de 1024×1024 em 1:1 a 1536×640 em 21:9, e cada uma voltou exatamente no tamanho pedido. Na edição, 1k e 1.5k definem o lado maior e a proporção da origem é mantida: uma foto 2:3 em 1k voltou em 680×1024, e uma foto 16:9 em 1.5k voltou em 1536×856.

Quem usa Z-Image Base LoRA

  • Ilustração de cores suaves e traço complexo a partir de texto

    Ilustradores e concept artists

    Ilustração de cores suaves e traço complexo a partir de texto

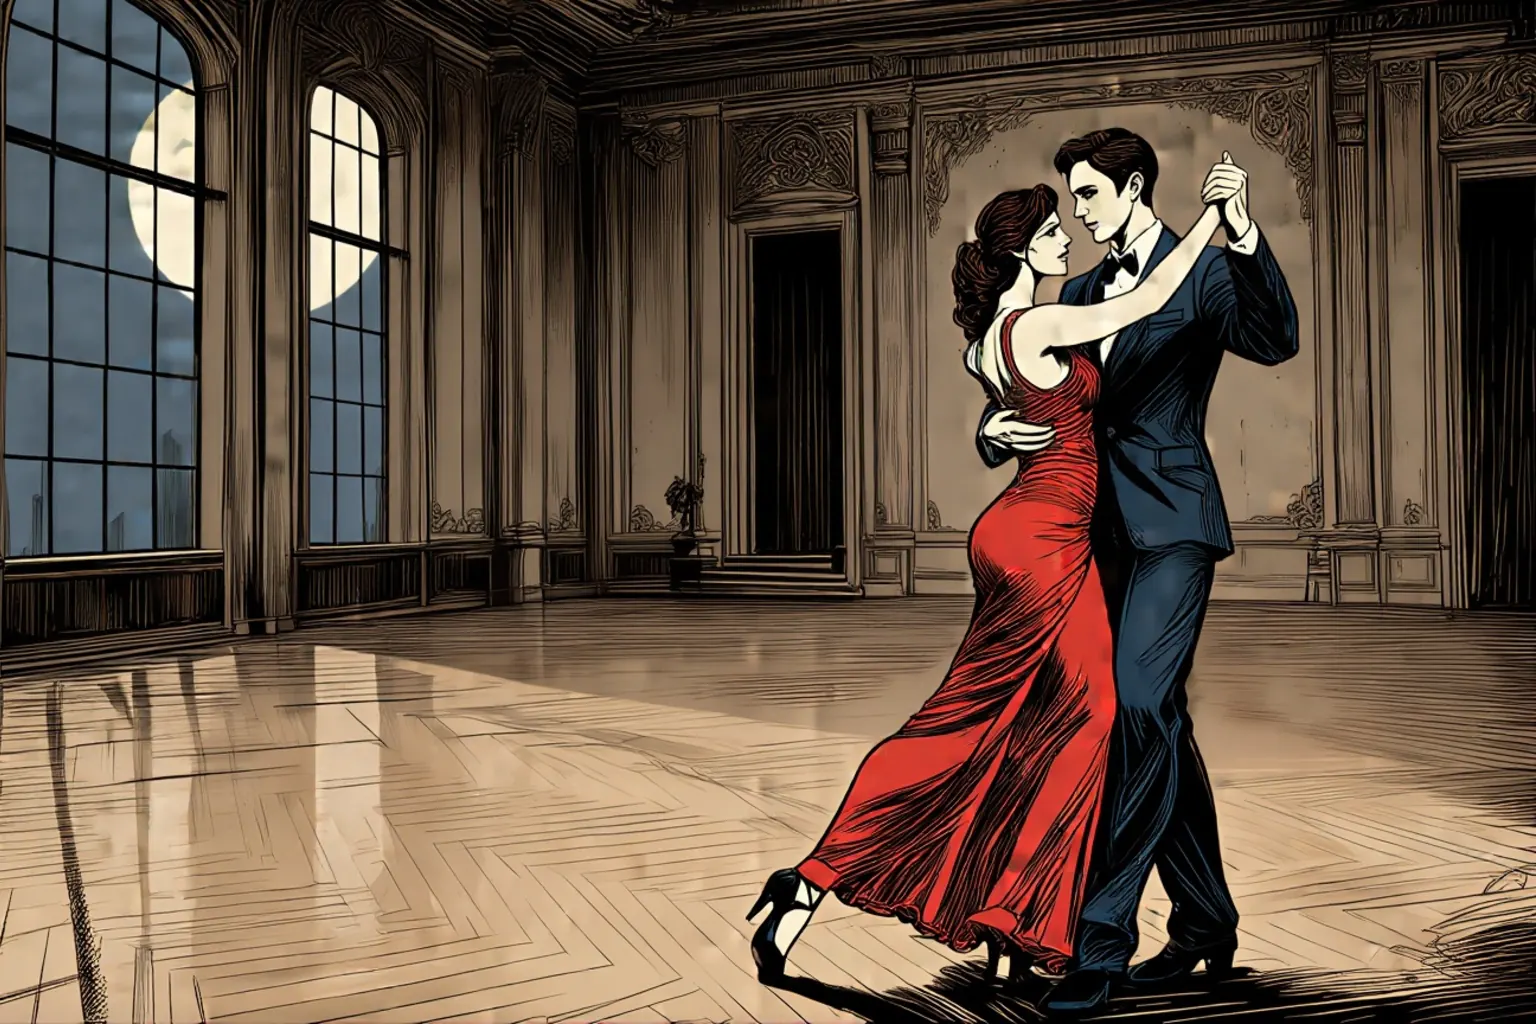
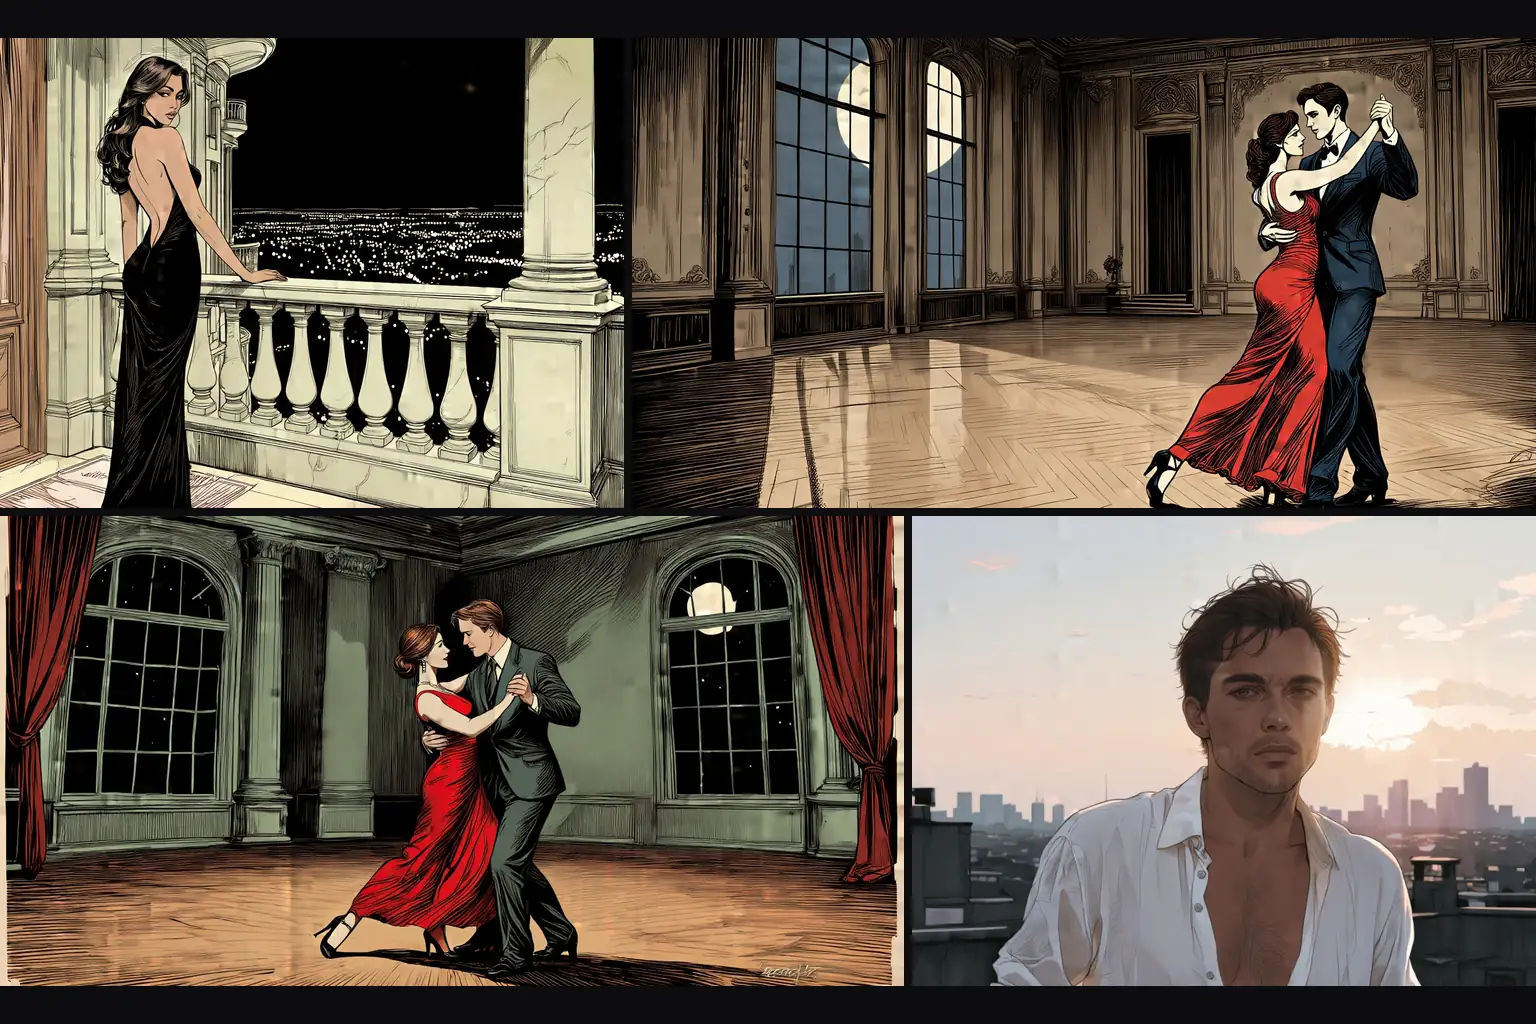
    Com a LoRA mikkoani em 1, nossos prompts de uma dança no salão, de uma sacada à noite e de um casal num salão ao luar saíram como ilustração nanquinada de cores suaves. Mantenha a frase primeiro e escreva a cena em frases.

  • Uma foto transformada em ilustração

    Fotógrafos e retocadores

    Uma foto transformada em ilustração

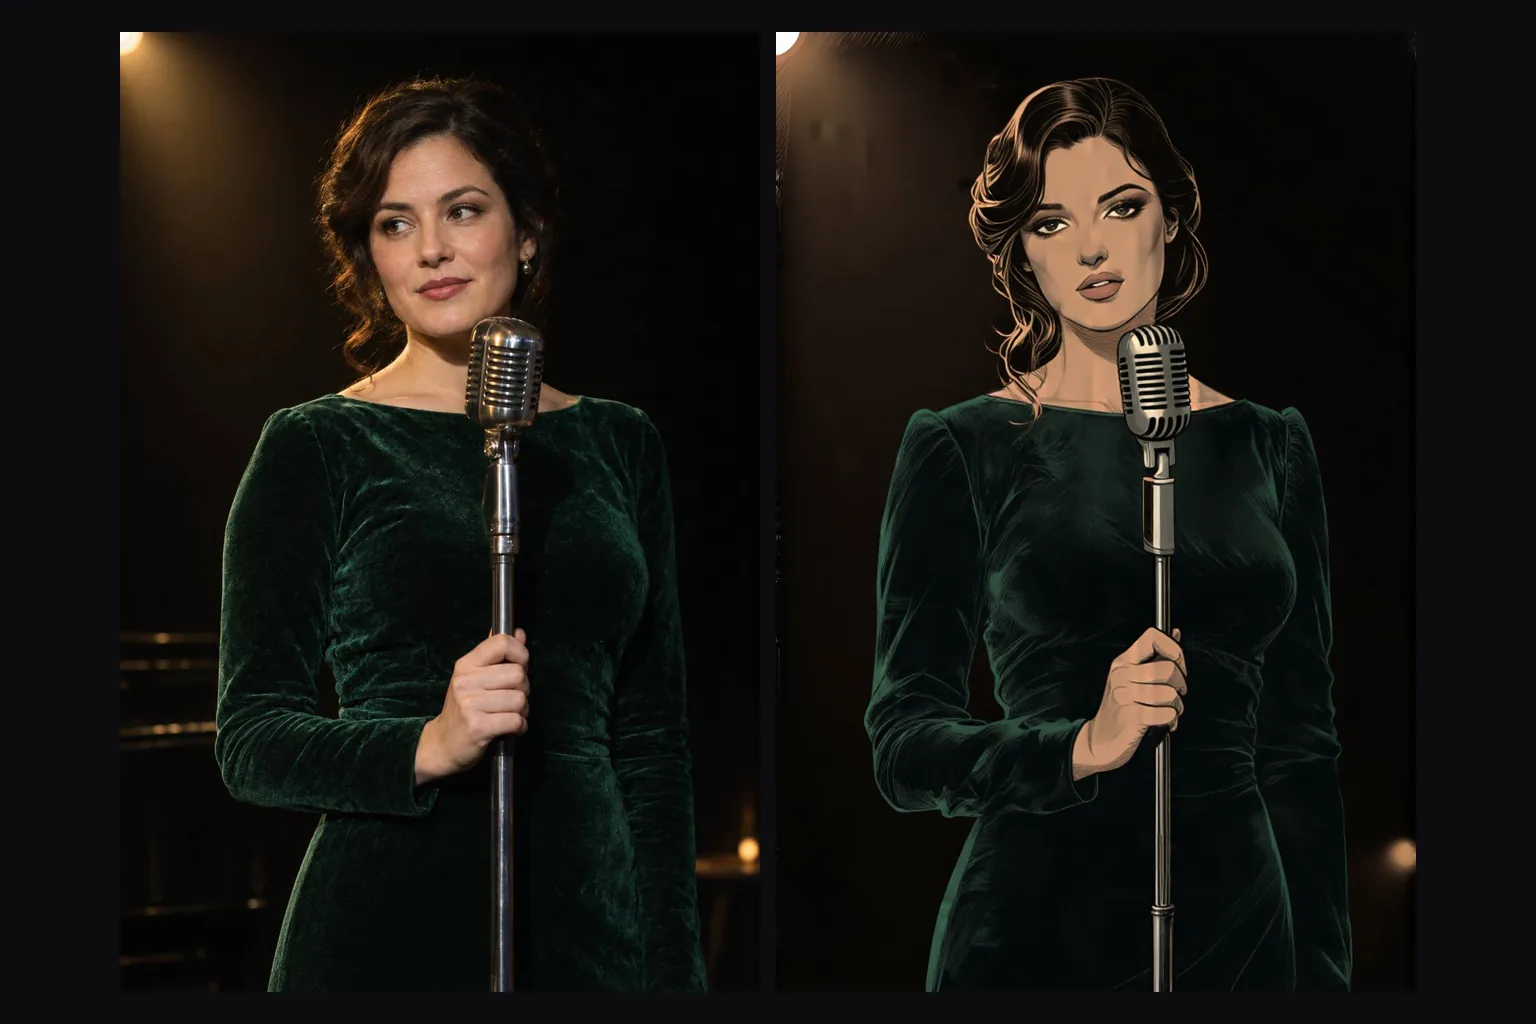
    À esquerda está uma foto de origem de uma cantora de vestido de veludo verde, à direita a edição com a LoRA mikkoani com strength 0.6. A pose, o microfone e o enquadramento ficaram no lugar, enquanto a renderização virou desenho.

  • Escolher até onde a variação vai

    Equipes de redes sociais e campanhas

    Escolher até onde a variação vai

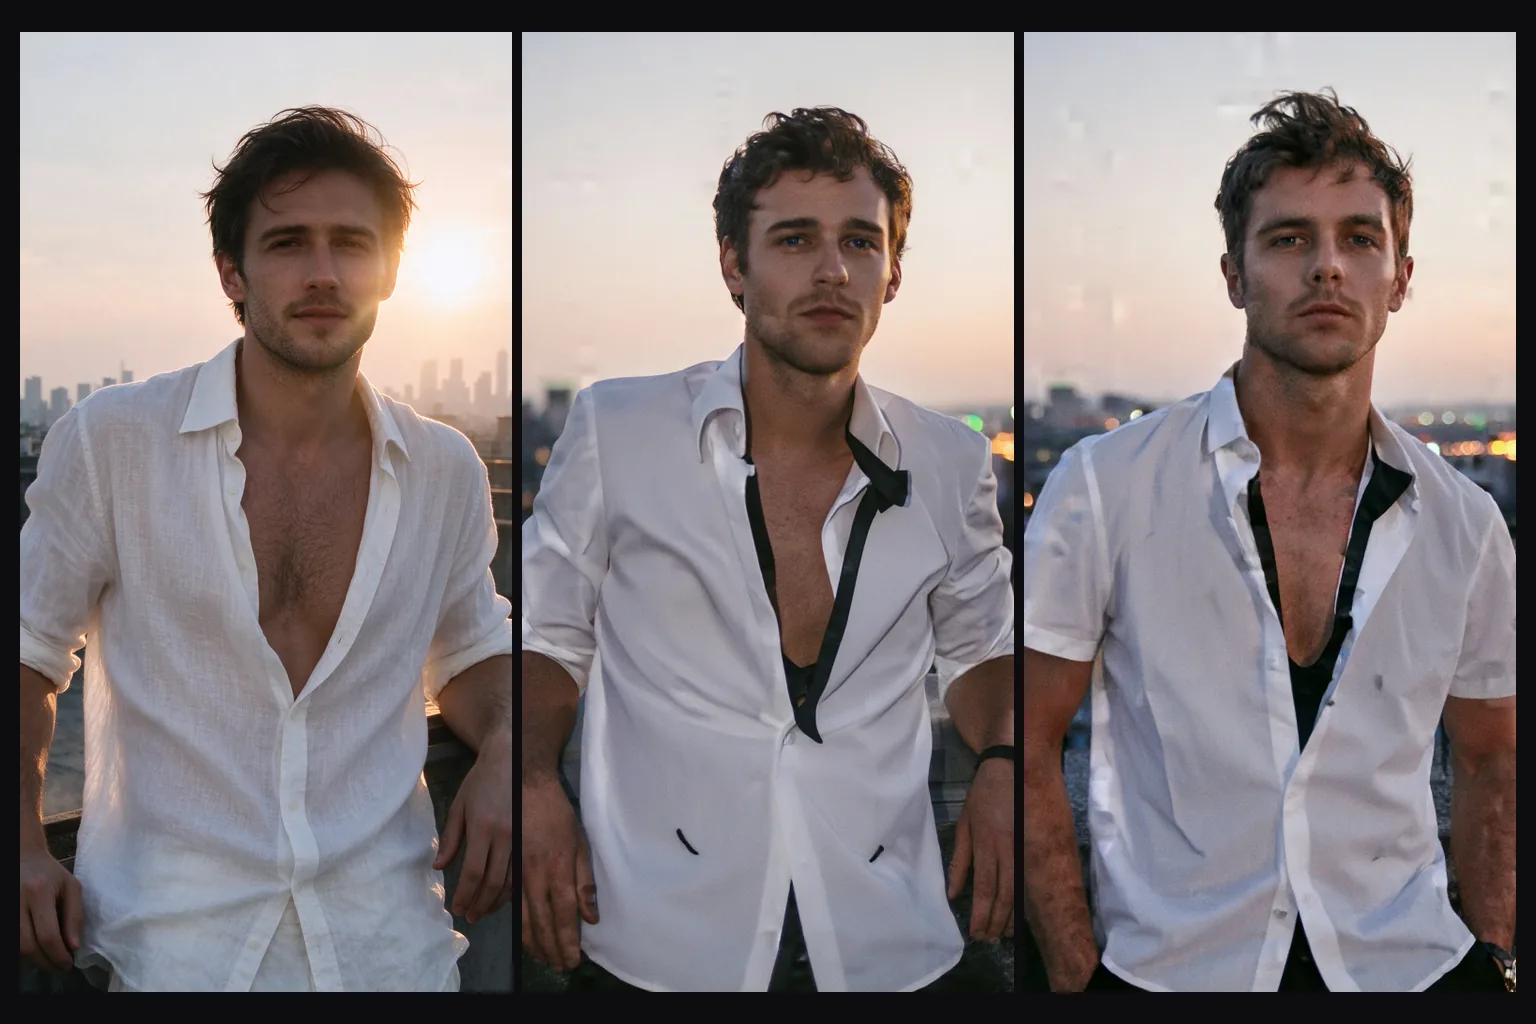
    Nosso retrato no terraço passou por uma edição sem LoRA pedindo um smoking com 0.7 e 0.8. Mudou pouco, e a composição ficou. Use a strength como controle de variação e reserve os valores mais altos para quando quiser um quadro diferente.

  • Cenas largas 21:9 com 1536 pixels

    Criadores de cinema e papéis de parede

    Cenas largas 21:9 com 1536 pixels

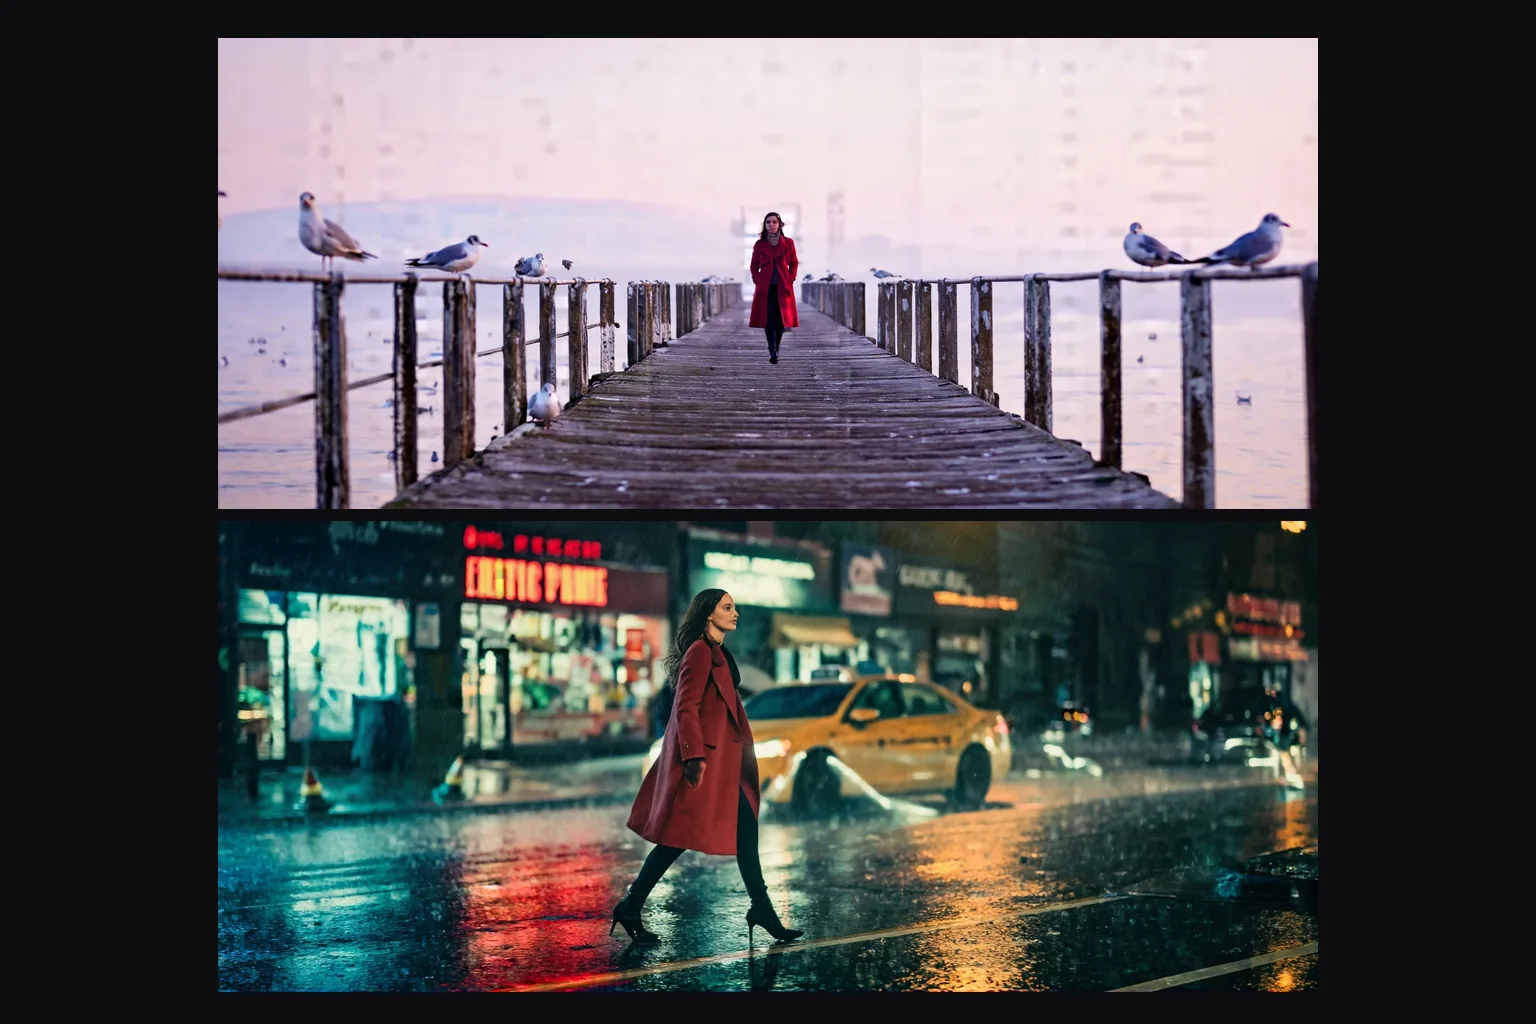
    Uma mulher de casaco vermelho num píer enevoado ao amanhecer e numa rua chuvosa iluminada por neon saíram de frases simples em 21:9 (1536×640), sem LoRA. A proporção larga faz parte do prompt, não é um recorte depois.

Do primeiro prompt à edição final com Z-Image Base LoRA

  1. Comece por um prompt de frases simples

    Rode primeiro texto para imagem sem LoRA, na proporção em que você vai publicar, para ver o que o modelo base entrega.

  2. Adicione uma LoRA treinada no Base

    Copie o link de download direto para o arquivo .safetensors e rode com e sem o arquivo na mesma seed.

  3. Confira o scale

    Experimente 0.5 e 1 e fique com o valor em que o visual aparece sem tomar conta do personagem.

  4. Edite com uma escada de strength

    Envie uma imagem de origem com o array loras e comece em 0.6; use 0.7 e 0.75 quando quiser a cena remontada.

  5. Descreva o resultado inteiro

    O modelo redesenha o quadro todo, então escreva a imagem completa, não só a mudança.

Prompts de Z-Image Base LoRA que valem a pena copiar

  • Uma foto em frases simples

    Sem LoRA; proporção vertical 2:3.

    A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.
  • Uma ilustração de cores suaves

    Com a LoRA mikkoani em scale 1 e a proporção 16:9; a frase fica primeiro.

    mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.
  • De foto a traço desenhado

    Para o endpoint de edição com a LoRA mikkoani em scale 1 e strength 0.6. Descreva a imagem inteira, não só a mudança.

    mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.

Mais perguntas sobre Z-Image Base LoRA

Use como seu laboratório do modelo base

Comece com um prompt de frases simples, adicione uma LoRA treinada no Base e comprove-a com um par com e sem o arquivo.

Na edição, suba a strength a partir de 0.6 e descreva o resultado inteiro. Se um arquivo não muda nada ou estraga a imagem, ele foi treinado para outro modelo.