Zum Hauptinhalt springen

Qwen Image 2512 LoRA Text-zu-Bild nutzt Alibabas offenes Qwen-Image-2512 mit bis zu drei eigenen LoRAs in Stärken von 0 bis 4. Es erzeugt ein Bild in neun Seitenverhältnissen mit bis zu 1536 Pixeln an der langen Seite.

Ab $0.03/Bild

Playground

Eingabe

Text zu Bild
548/5000
Setzen Sie die Triggerphrase der LoRA an den Anfang und beschreiben Sie dann Motiv, Umgebung und Licht. Qwen-Image folgt langen, detaillierten Prompts gut. mindestens 1 Zeichen · höchstens 5000 Zeichen
Neun Optionen von 21:9 bis 9:21. 1:1 ergibt 1328 x 1328 und 16:9 ergibt 1536 x 864; alle kosten gleich viel.
Stil-LoRAs1/3

Q2512 Reallife WOMEN

Bis zu drei Einträge {path, scale}, trainiert für Qwen-Image-2512; scale 0 bis 4, 1 ist neutral. höchstens 3 Einträge
Ausgabeformat
JPEGPNGWebP
Standardmäßig JPEG, bei Bedarf PNG oder WebP. Ändert den Preis nicht.
Seed
Hält eine Bildserie vergleichbar, während Sie jeweils nur einen LoRA-scale ändern. nicht kleiner als 0 · nicht größer als 2147483647
SicherheitsfilterAus

SpicyAPI führt bei diesem Modell keinen Sicherheitsfilter aus. Prompt und Material gehen unverändert an das Modell, und das Modell selbst entscheidet über das Ergebnis.

Wir prüfen Ihr Konto, bevor Absenden und Preisberechnung freigeschaltet werden.

Ausgabe

Bereit für einen neuen Lauf
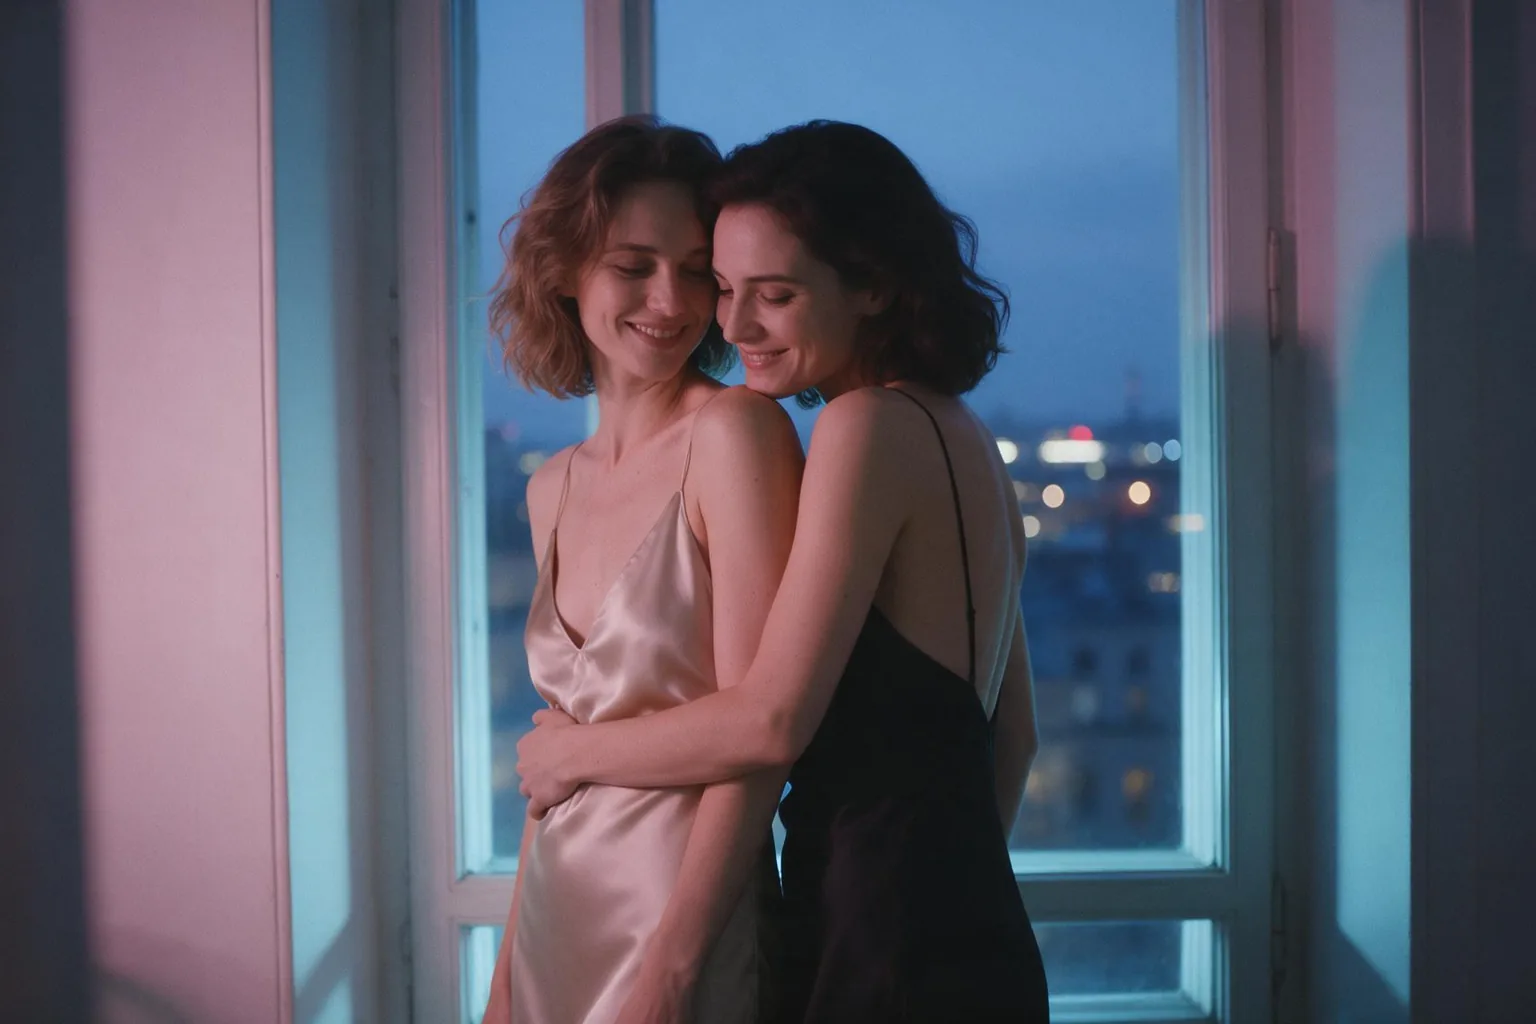
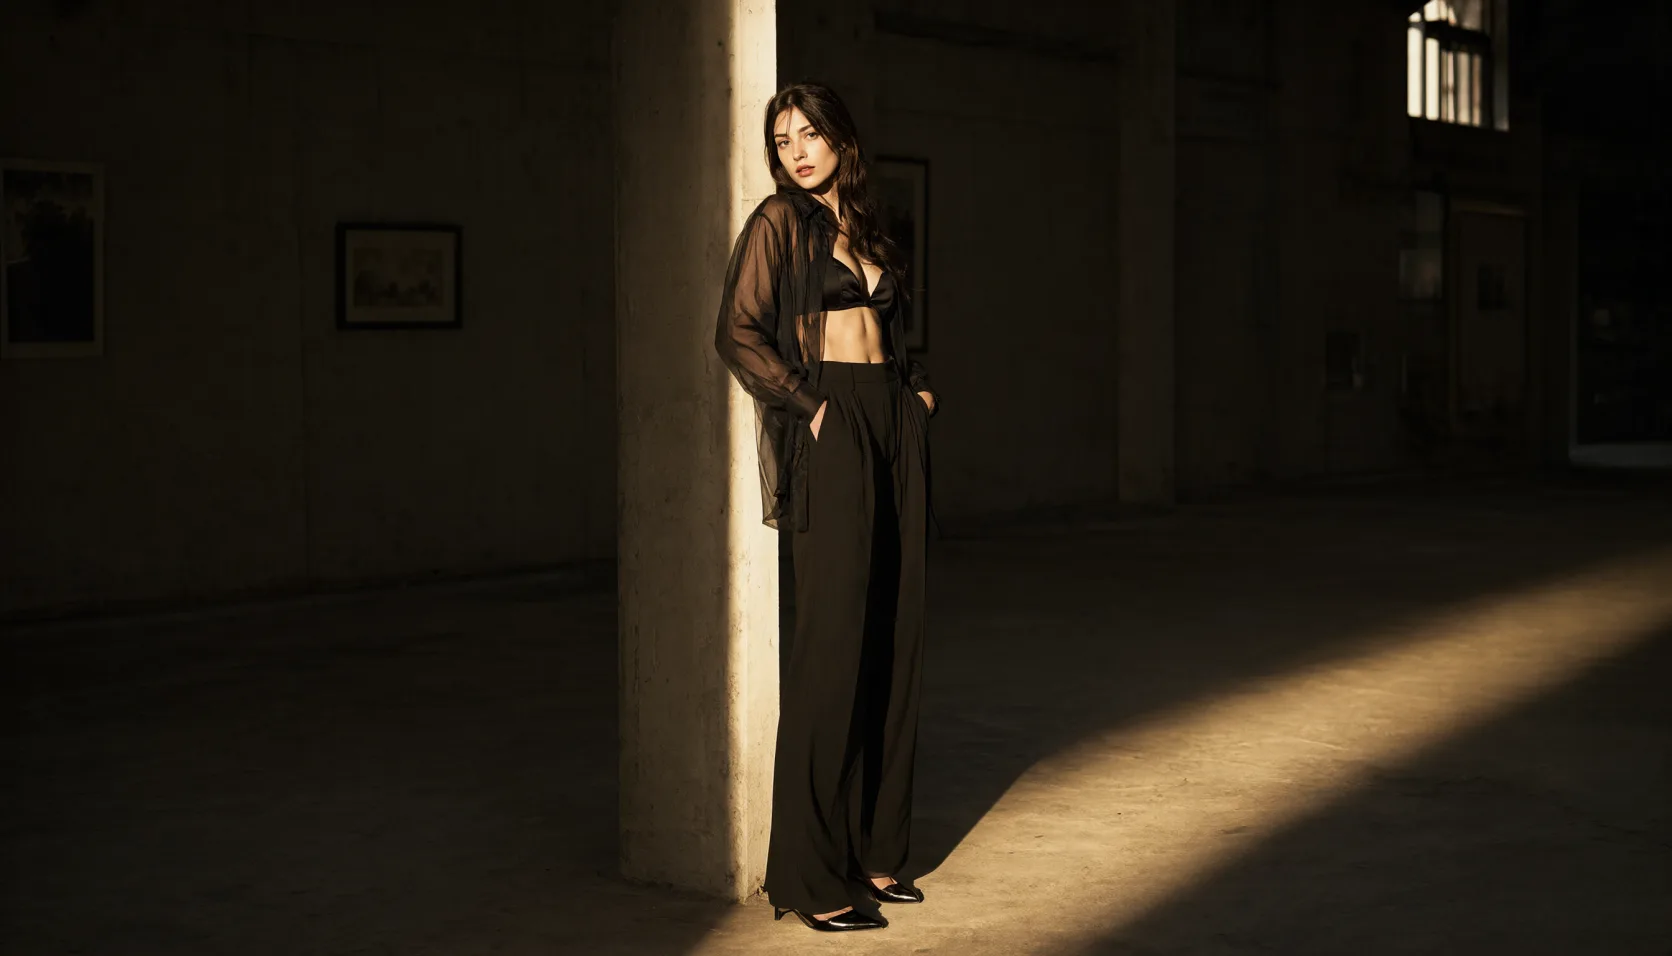
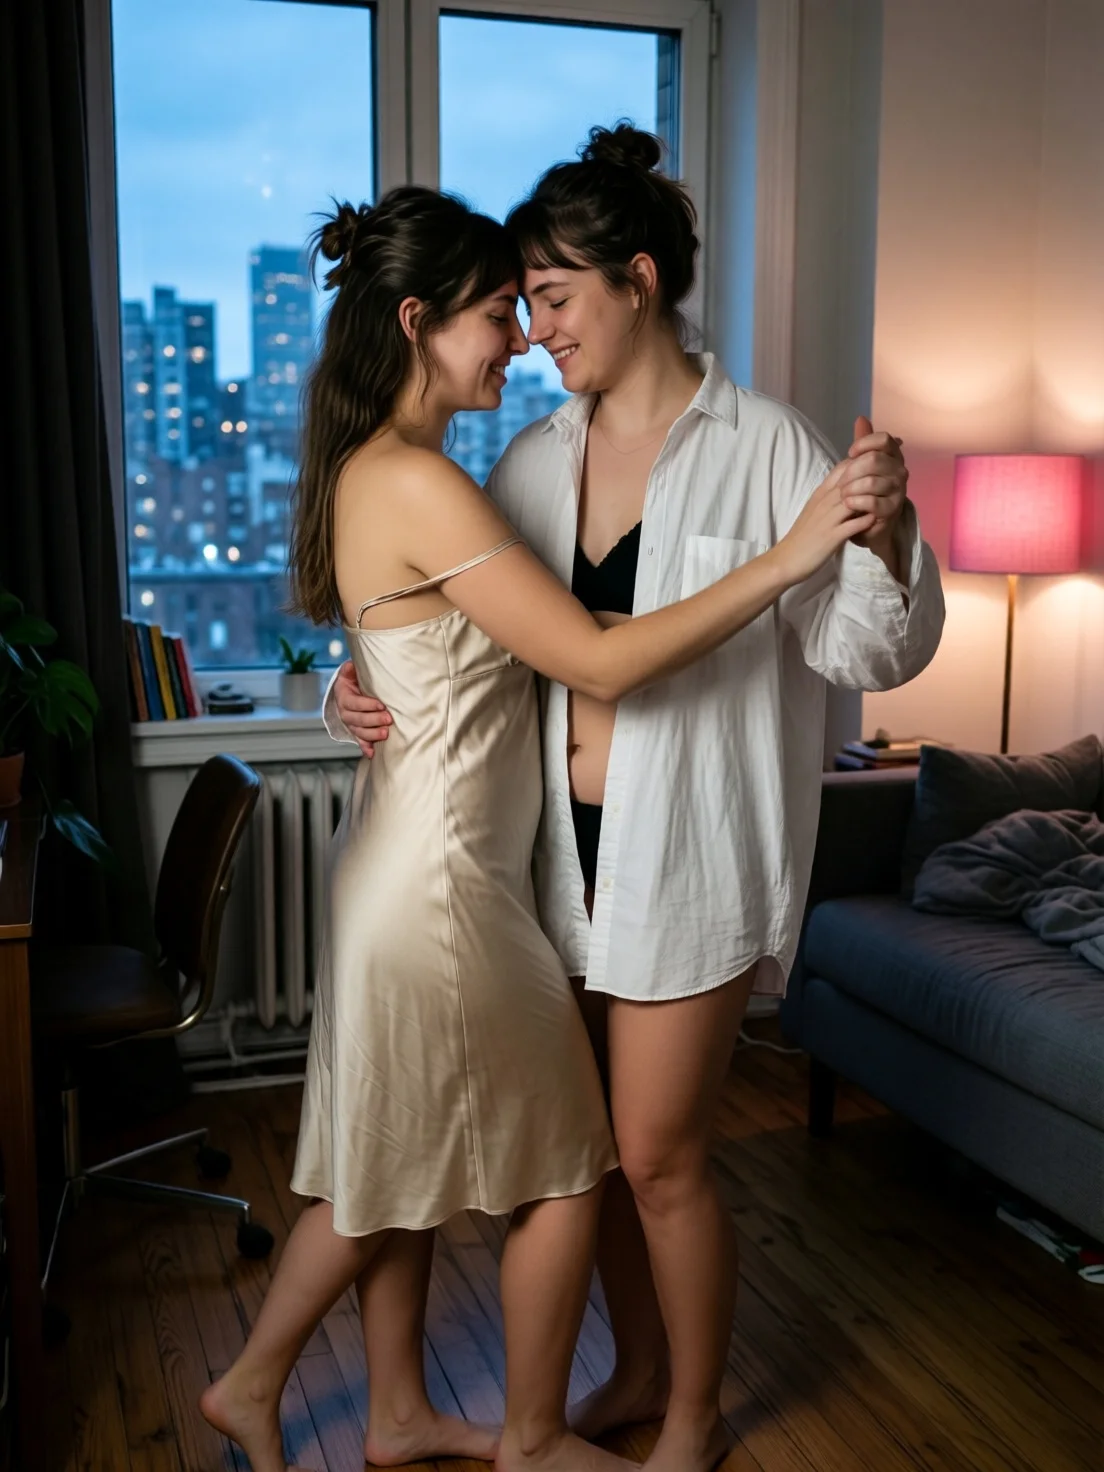
slow-dance-windowBeispielergebnis

Verwandte Modelle und nächste Schritte

Ihr Modell ist nicht dabei?

Sagen Sie uns, welches Modell fehlt und wofür Sie es brauchen. Ihre Anfrage geht direkt an das Team, das über die nächsten Modelle entscheidet.

Größere Bilder für Ihre LoRAs, und Bearbeitungen, die die Kamera versetzen

Qwen Image 2512 LoRA führt zwei offene Modelle von Alibaba aus und lädt dabei bis zu drei Ihrer eigenen LoRA-Dateien pro Anfrage: Qwen-Image-2512 für Text zu Bild, mit bis zu 1536 Pixeln an der langen Seite, und Qwen-Image-Edit-2511 für die Bearbeitung, aus einem bis drei Quellbildern. Beide nehmen unterschiedliche LoRAs, und genau das richtig zu machen, ist der erste Schritt. Auf einer Basis mit 20 Milliarden Parametern halten Stil-LoRAs Gesichter, Hände und kleine Gegenstände zusammen; Bearbeitungs-LoRAs können ein Foto aus einem neuen Winkel neu aufnehmen oder eine Zeichnung in ein Foto verwandeln. Jedes Bild kostet gleich viel, und nichts wird gefiltert.

Playground öffnen
Größere Bilder für Ihre LoRAs, und Bearbeitungen, die die Kamera versetzen
Text zu Bild
Qwen-Image-2512, 20 Mrd. Parameter; neun Seitenverhältnisse, bis 1536 px an der langen Seite
Bearbeitung
Qwen-Image-Edit-2511; 1 bis 3 Quellbilder, Ergebnis folgt dem ersten mit etwa einem Megapixel
LoRAs pro Anfrage
Bis zu 3, jeweils {path, scale}; scale 0 bis 4 bei Text zu Bild, 0 bis 2 bei Bearbeitung
Welche LoRAs
Für die eigene Basis des Endpunkts trainiert; andere Qwen-Image-Versionen bewirken wenig
Preis
Ein Einheitspreis pro Bild, unabhängig von Größe und Zahl der Quellbilder
Inhaltsfilter
Keiner; beide Endpunkte haben unseren härtesten Inhaltstest mit einer LoRA, die dafür trainiert wurde gerendert
Zwei Basismodelle
Jede LoRA zu ihrem EndpunktText zu Bild und Bearbeitung laufen auf verschiedenen Modellen, daher ist jede LoRA für das eine oder das andere trainiert. Eine Bearbeitungs-LoRA auf Text zu Bild, oder umgekehrt, lädt und bewirkt dann wenig. Führen Sie die beiden Listen in Ihrer Konfiguration getrennt, und der häufigste Fehler verschwindet.
Bildgröße
Mehr Pixel als ein Ein-Megapixel-BildText zu Bild rendert 1328 x 1328 bei 1:1, 1536 x 864 bei 16:9 und 1472 x 1104 bei 4:3, zum selben Preis wie jedes andere Seitenverhältnis. Die Bearbeitung liefert etwa ein Megapixel in der Form des ersten Quellbilds.
Grenzen
Drei Quellbilder und scale 2 bei der BearbeitungDer Bearbeitungs-Endpunkt nimmt höchstens drei Bilder, begrenzt jede LoRA-scale auf 2 und bietet keine Wahl des Seitenverhältnisses: Das Ergebnis folgt dem ersten Bild. Gewichte für andere Qwen-Image-Versionen, auch für die Basis hinter Qwen Image 2.1 LoRA, lassen sich nicht zuverlässig übertragen.

Mit LoRAs arbeiten auf Qwen Image 2512 LoRA

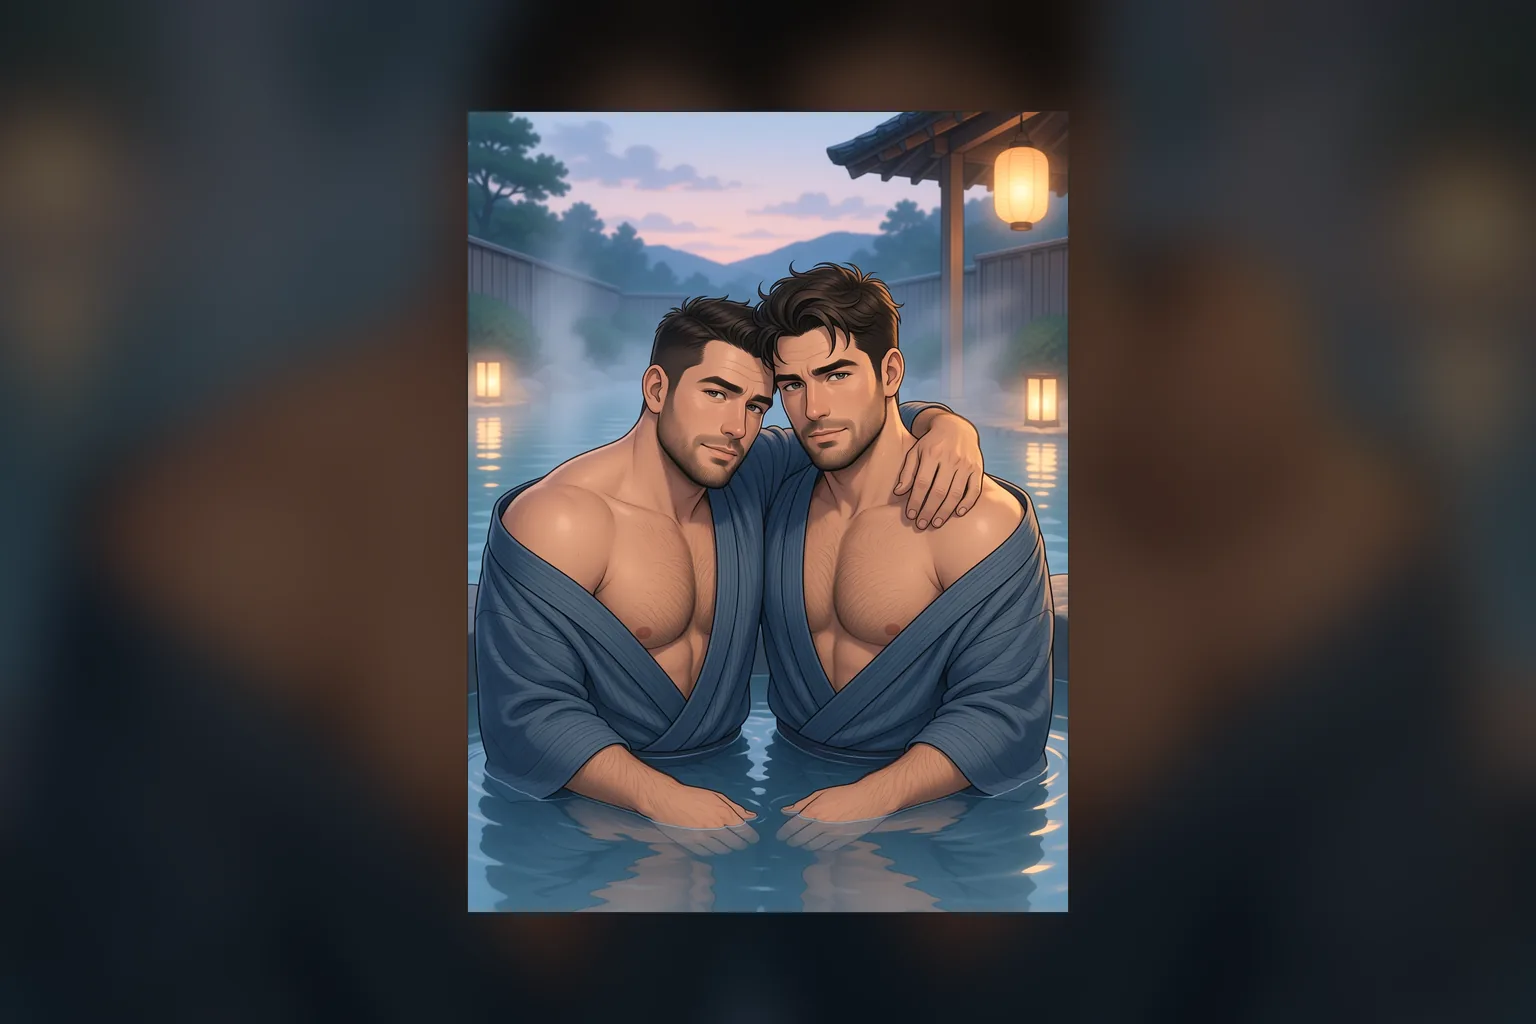
Stilisiert, mit allen Details

Stilisiert, mit allen Details

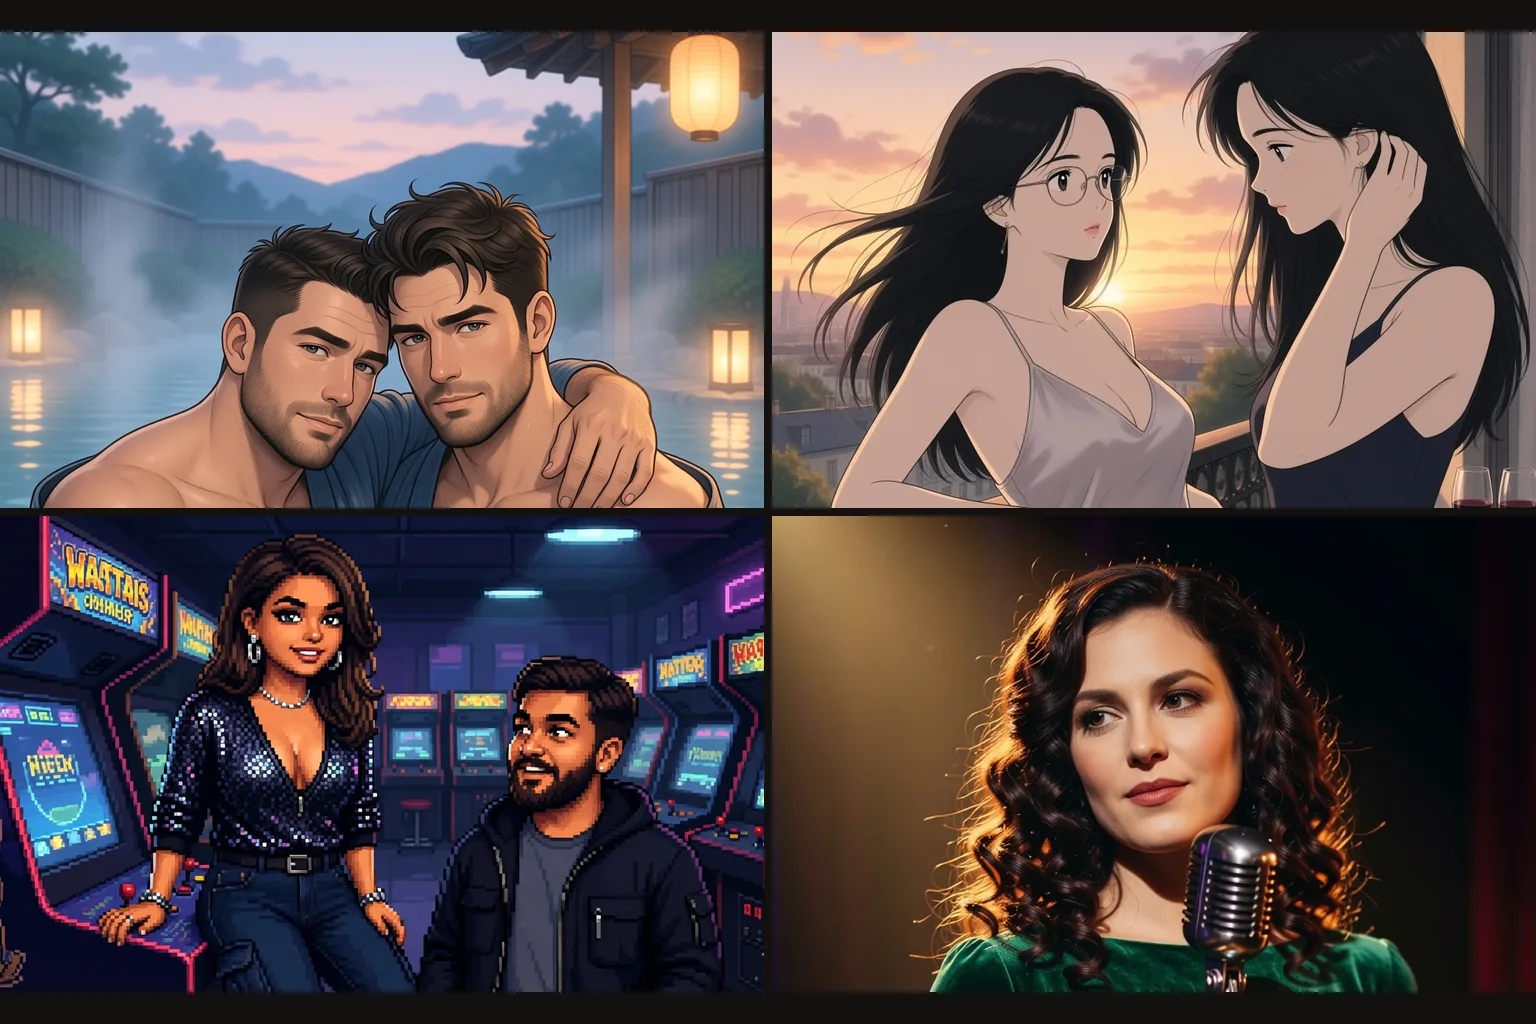
Eine Storybook-Anime-LoRA und eine Außen-Therme in der Dämmerung: zwei Männer, die gemeinsam ausruhen, Dampf, Laternen und eine weiche Pastellpalette. Der Stil gehört der LoRA, Gesichter und Hände halten, weil die Basis groß ist. Nennen Sie die Stilbegriffe, auf die die LoRA trainiert wurde, und schreiben Sie die Szene in ganzen Sätzen.

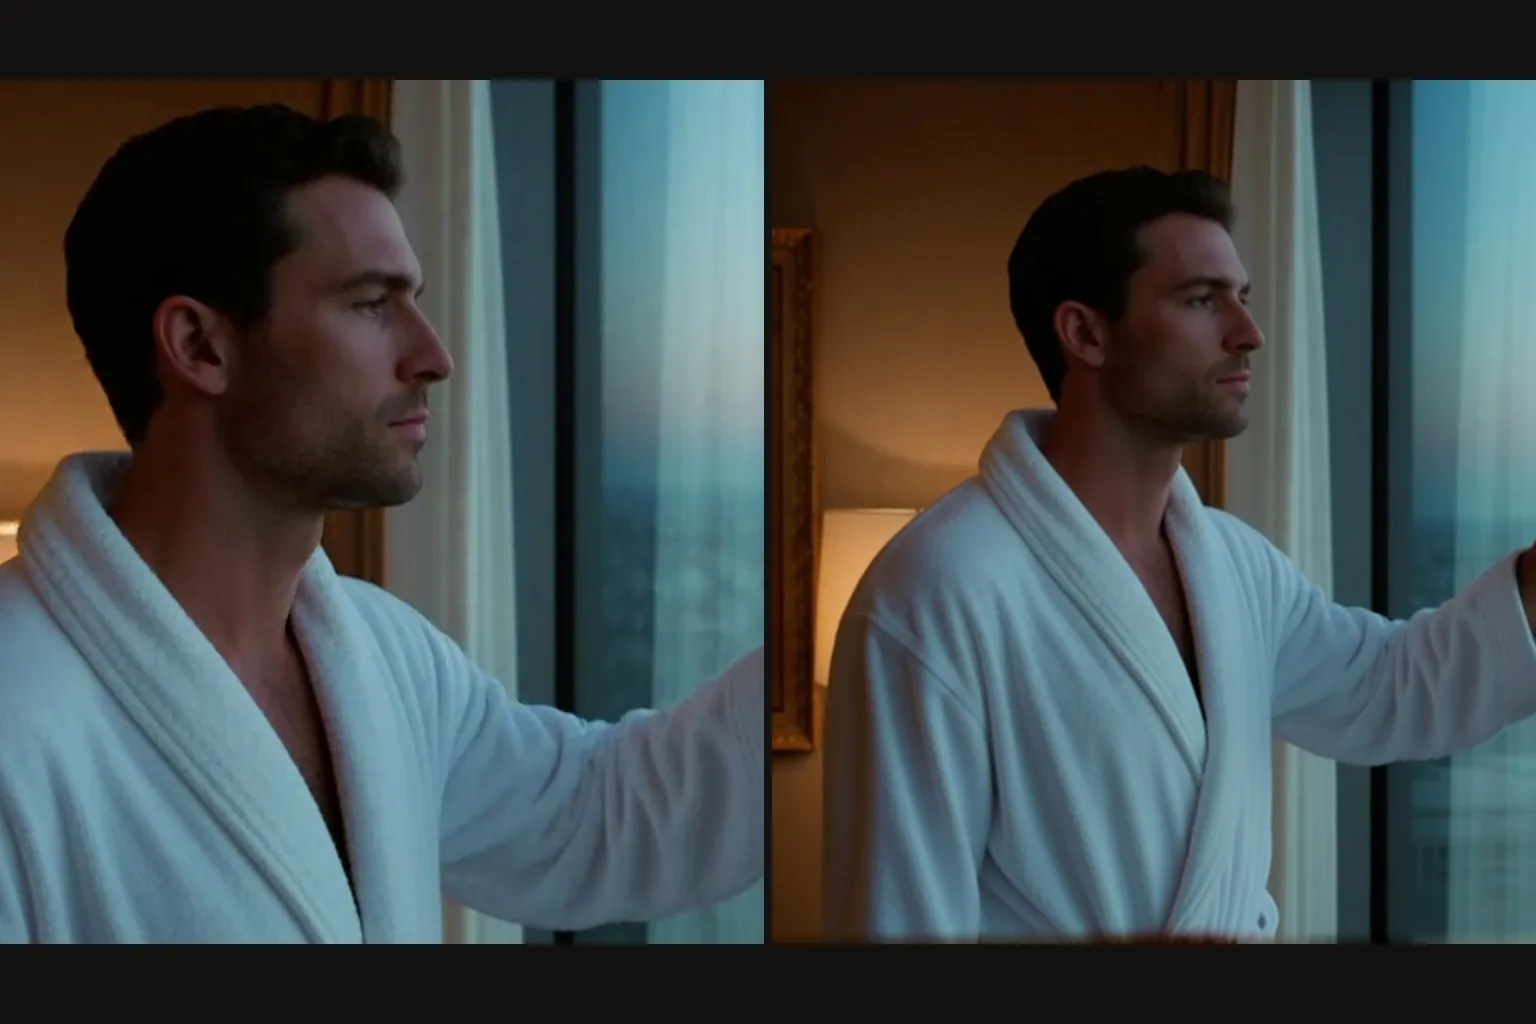
Die Kamera mit einer Bearbeitungs-LoRA versetzen

Die Kamera mit einer Bearbeitungs-LoRA versetzen

Die Multiple-Angles-LoRA auf dem Bearbeitungs-Endpunkt hat ein einzelnes Foto aus einer Dreiviertelansicht von vorn links neu aufgenommen: derselbe Mann, dieselbe Kleidung, dasselbe Hotelfenster. Sie erwartet ihre eigene feste Formulierung, „<sks>“ gefolgt von der Ansicht, wie ihre Model Card beschreibt. Die meisten Bearbeitungs-LoRAs sind für scale 1 gemacht, und diese lief auch mit 1.

  • Jedes Quellbild benennen, wenn es mehrere sind

    Bei zwei oder drei Bildern sagen Sie, was jedes beiträgt: Picture 1 ist die Person, Picture 2 der Raum. Das Ergebnis folgt der Form des ersten Bilds, setzen Sie also das Bild mit dem gewünschten Bildausschnitt an den Anfang. Ein, zwei oder drei Quellbilder kosten dasselbe.

  • Zeichnungen werden zu Fotos

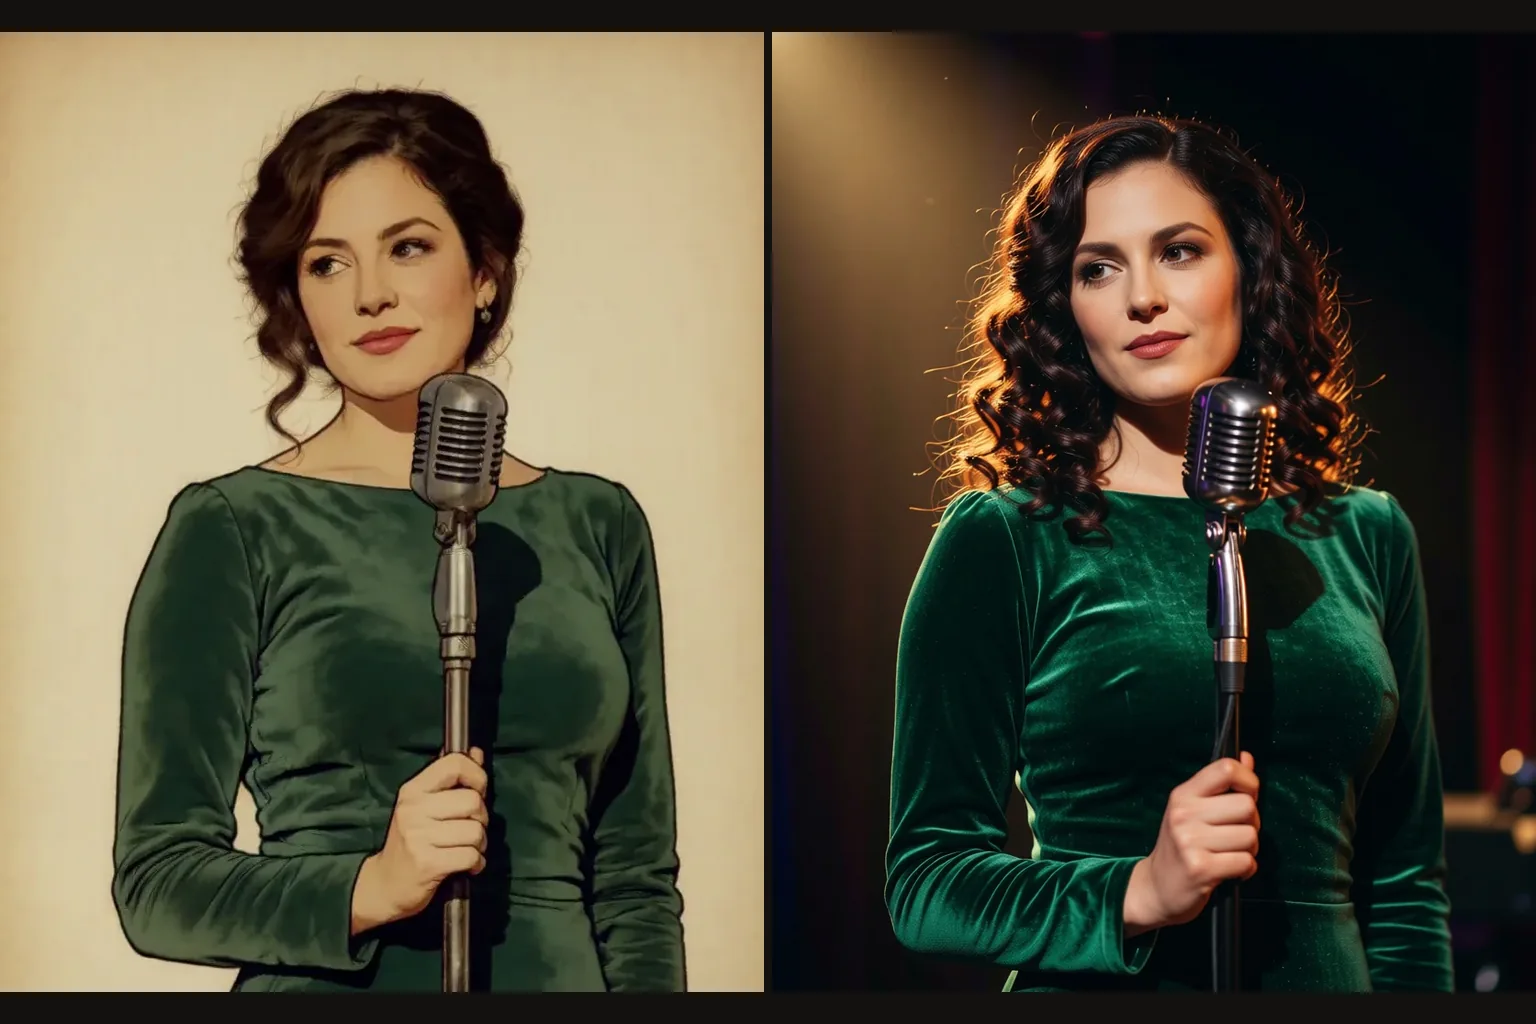
    Eine Fotorealismus-Bearbeitungs-LoRA bei 0.85 hat eine gezeichnete Sängerin in ein Foto verwandelt: dieselben Locken, derselbe grüne Samt, dasselbe Vintage-Mikrofon. Eine schlichte Anweisung genügte; den Realismus lieferte die LoRA.

  • Links, die die Datei herunterladen

    Jede Datei wird geladen, wenn die Anfrage läuft. Ein Link, der eine Anmeldung verlangt, lässt die Anfrage scheitern – geschützte Repositorys antworten mit HTTP 401 –, ebenso ein Link auf eine Webseite statt auf die Datei. Nutzen Sie eine öffentliche URL zur .safetensors-Datei. Fehlgeschlagene Anfragen werden nicht berechnet.

Wer Qwen Image 2512 LoRA nutzt

  • Ein handgezeichneter Look im großen Format

    Illustratoren und Story-Apps

    Ein handgezeichneter Look im großen Format

    Aquarell-, Storybook- und Pixel-Art-LoRAs geben einer Serie einen einheitlichen, handgemachten Look, und das Bild reicht bis 1536 Pixel an der langen Seite, für Cover und Banner. Fixieren Sie den Seed pro Layout und ändern Sie nur die Szene.

  • Pixel Art, in der die Details halten

    Game- und Retro-Art

    Pixel Art, in der die Details halten

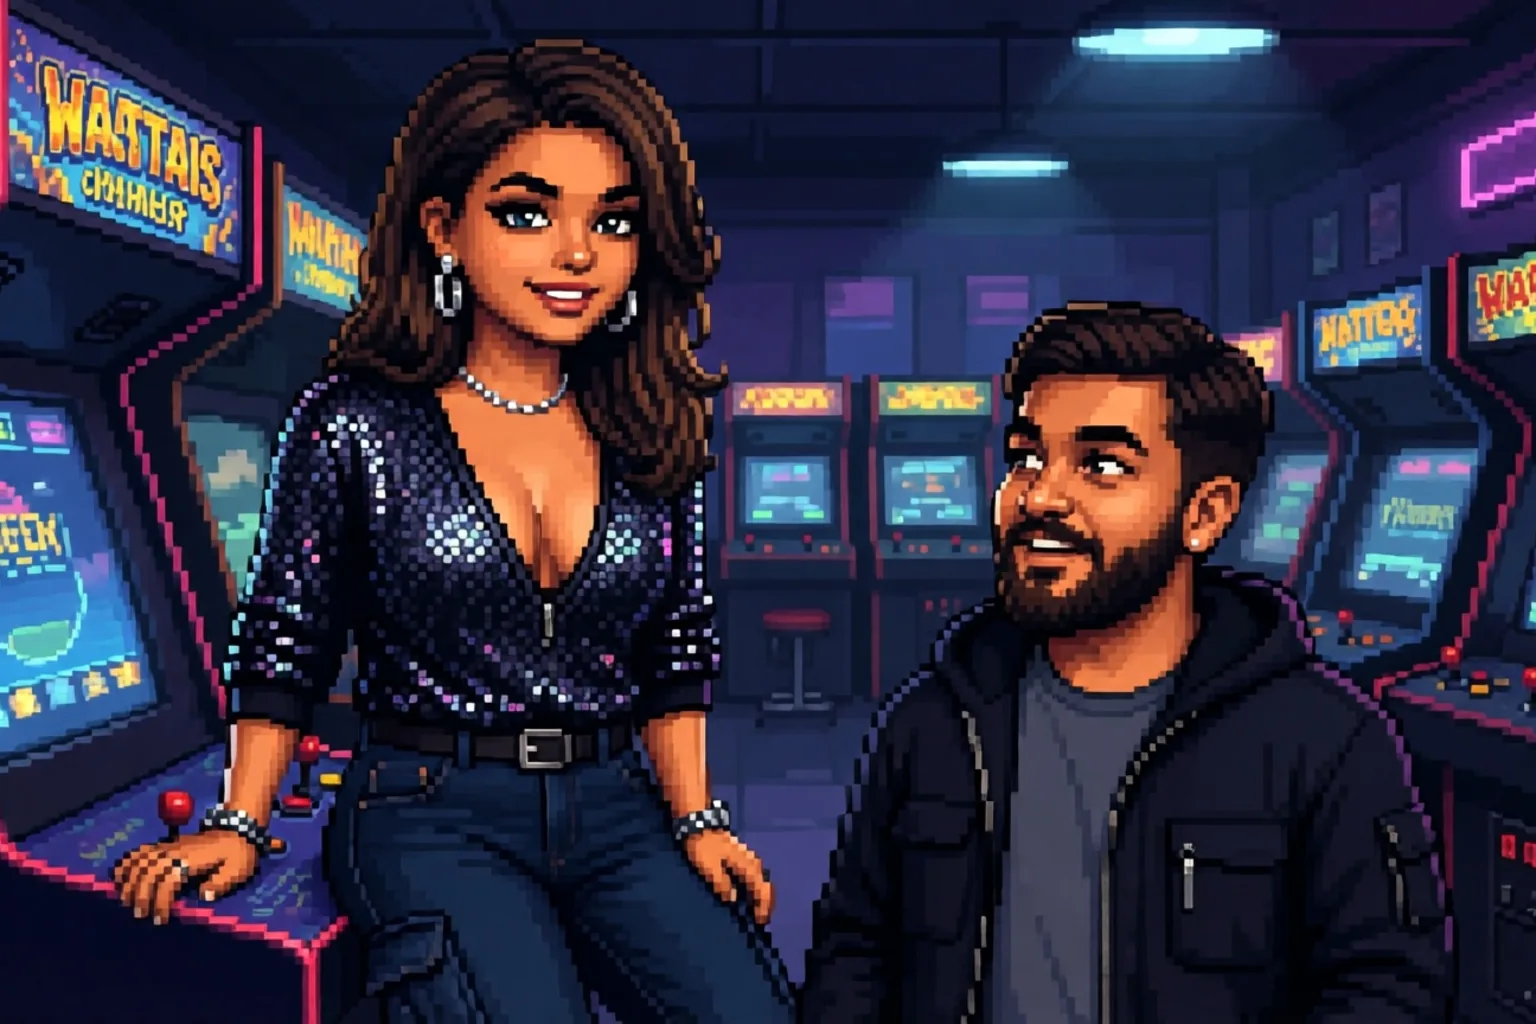
    Eine Pixel-Art-LoRA mit dem Trigger „Pixel Art“ bei 16:9, wo 2512 mit 1536 x 864 rendert: eine Neon-Spielhalle, Reihen von Automaten, zwei Menschen im Gespräch. Die große Basis hält Gesichter und kleine Gegenstände auch im Pixelraster zusammen.

  • Von der Zeichnung zum Foto

    Studios und Concept Artists

    Von der Zeichnung zum Foto

    Schicken Sie eine Illustration mit einer Fotorealismus-LoRA bei etwa 0.85 und einer schlichten Anweisung in die Bearbeitung. Unsere gezeichnete Sängerin kam als Foto mit denselben Locken, demselben Kleid und demselben Mikrofon zurück, brauchbar als Referenz oder als fertiges Bild.

  • Standbilder und Bearbeitungen, unzensiert

    Plattformen mit Community-LoRAs

    Standbilder und Bearbeitungen, unzensiert

    Community-LoRAs aller Art laden ohne Prüfung, und keiner der beiden Endpunkte filtert seine Ausgabe; beide haben unseren härtesten Inhaltstest so gerendert, wie er geschrieben war. Ein Einheitspreis pro Bild, unabhängig von Größe und Zahl der Quellbilder, macht die Kosten jeder Nutzeranfrage planbar.

Von der LoRA zum fertigen Bild mit Qwen Image 2512 LoRA

  1. Klären, zu welchem Endpunkt die LoRA gehört

    Ihre Model Card nennt die Basis: LoRAs für Qwen-Image-2512 gehen an Text zu Bild, LoRAs für Qwen-Image-Edit-2511 an die Bearbeitung.

  2. Den direkten Dateilink kopieren

    Nutzen Sie eine öffentliche URL, die die .safetensors-Datei herunterlädt. Geschützte Repositorys antworten mit HTTP 401, und die Anfrage scheitert.

  3. Im Format der LoRA schreiben

    Bei Stil-LoRAs die Triggerphrase zuerst. Manche Bearbeitungs-LoRAs erwarten eine feste Formulierung, etwa „<sks>“ gefolgt von der gewünschten Ansicht.

  4. Jede scale im erlaubten Bereich halten

    Beginnen Sie bei 1. Text zu Bild erlaubt bis 4 pro LoRA; die Bearbeitung begrenzt jede auf 2.

  5. Die Quellbilder ordnen

    Setzen Sie bei Bearbeitungen das Bild mit dem gewünschten Bildausschnitt an den Anfang, benennen Sie jedes im Prompt als Picture 1, 2 oder 3 und halten Sie den Seed fest, während Sie die Anweisung anpassen.

Prompts für Qwen Image 2512 LoRA zum Übernehmen

  • Eine Storybook-Serienzeile

    Für eine Storybook-Anime-LoRA bei Text zu Bild. Der Prompt beginnt mit den Stilbegriffen, auf die die LoRA trainiert wurde, danach folgt die Szene.

    storybook anime illustration of two old friends sharing a picnic under a cherry tree at dusk, paper lanterns in the branches, a thermos and two cups on the blanket, soft pastel palette
  • Ein neuer Kamerawinkel

    Auf dem Bearbeitungs-Endpunkt mit der Multiple-Angles-LoRA bei scale 1 und einem Quellfoto. Die Formulierung ist das eigene Format der LoRA; nur die Ansicht ändert sich.

    <sks> front-left quarter view eye-level shot medium shot
  • Zwei Quellbilder, eine Anweisung

    Auf dem Bearbeitungs-Endpunkt mit zwei Bildern. Sagen Sie, was jedes beiträgt; das Ergebnis übernimmt die Form von Picture 1.

    Picture 1 is the woman. Picture 2 is the room. Place her in the room, seated at the window table in the same grey knit sweater, soft morning light from the left

Weitere Fragen zu Qwen Image 2512 LoRA

Zwei Endpunkte, zwei Arten von LoRA

Sortieren Sie Ihre LoRAs vor allem anderen nach Basis: Dateien für Qwen-Image-2512 an Text zu Bild, Dateien für Qwen-Image-Edit-2511 an die Bearbeitung. Setzen Sie Triggerphrasen und feste Formate an den Anfang, halten Sie die scale bei der Bearbeitung bei 2 oder darunter und benennen Sie jedes Quellbild, wenn Sie mehrere schicken. Entwerfen Sie Text zu Bild im Format, in dem Sie veröffentlichen, denn auch das größte Bild kostet gleich viel, und überlassen Sie Bearbeitungs-LoRAs, was ein Prompt nicht kann, etwa die Kamera zu versetzen.