소개
Kling 3.0 텍스트→영상은 이미지나 구동 영상 없이 글로 쓴 프롬프트만으로 클립을 만듭니다. 길이는 3~15초 사이 정수 초, 해상도는 720p·1080p·4K, 화면비는 16:9·9:16·1:1 중에서 설정하세요. generate_audio를 켜면 대사, 효과음, 배경음이 같은 과정에서 생성되고, shot_type으로 하나의 연속 셋업을 유지할지 Kling이 알아서 멀티샷으로 나누게 할지 선택할 수 있습니다.
시작 소재별 Kling 3.0 모드 선택
| 시작 시점에 가진 것 | 모드 |
|---|---|
| 글로 쓴 장면이나 대본 | Kling 3.0 텍스트→영상(현재 모드) |
| 첫 프레임(선택적으로 마지막 프레임까지) | Kling 3.0 이미지→영상 |
| 캐릭터 사진과 구동 영상 | Kling 3.0 Motion Control |
핵심 기능 및 하이라이트
대사와 배경음이 같은 파일에
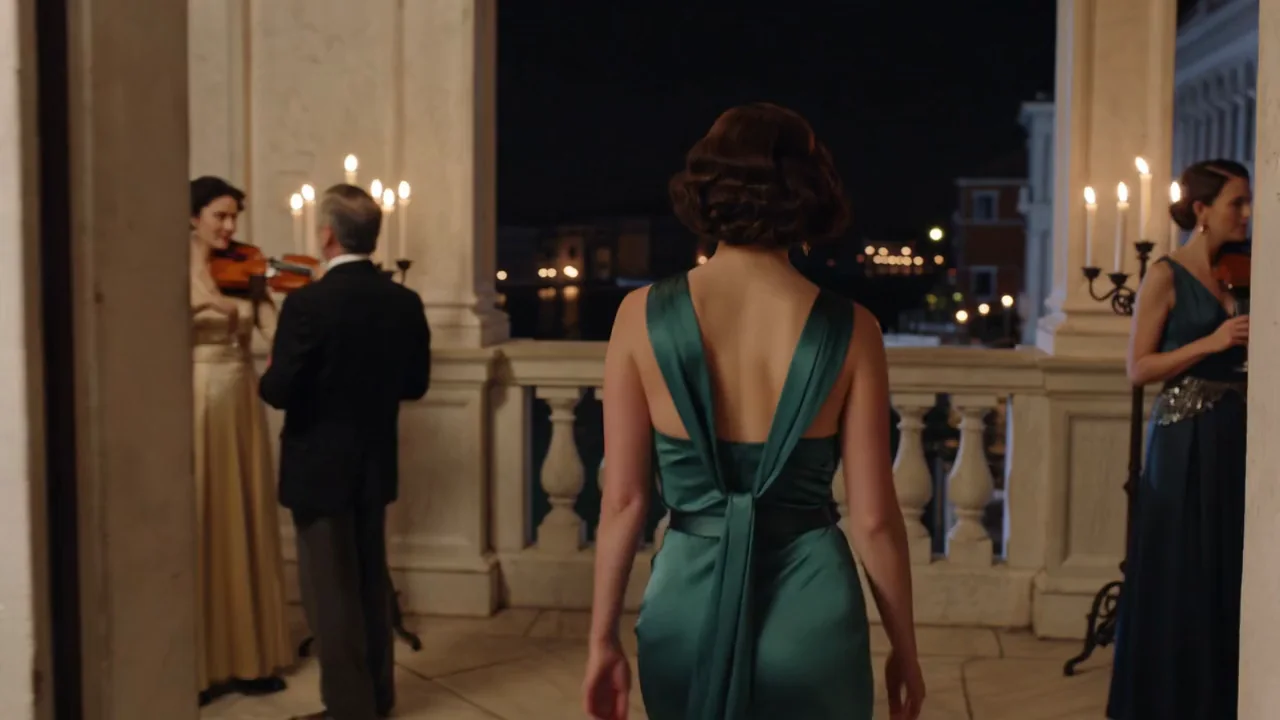
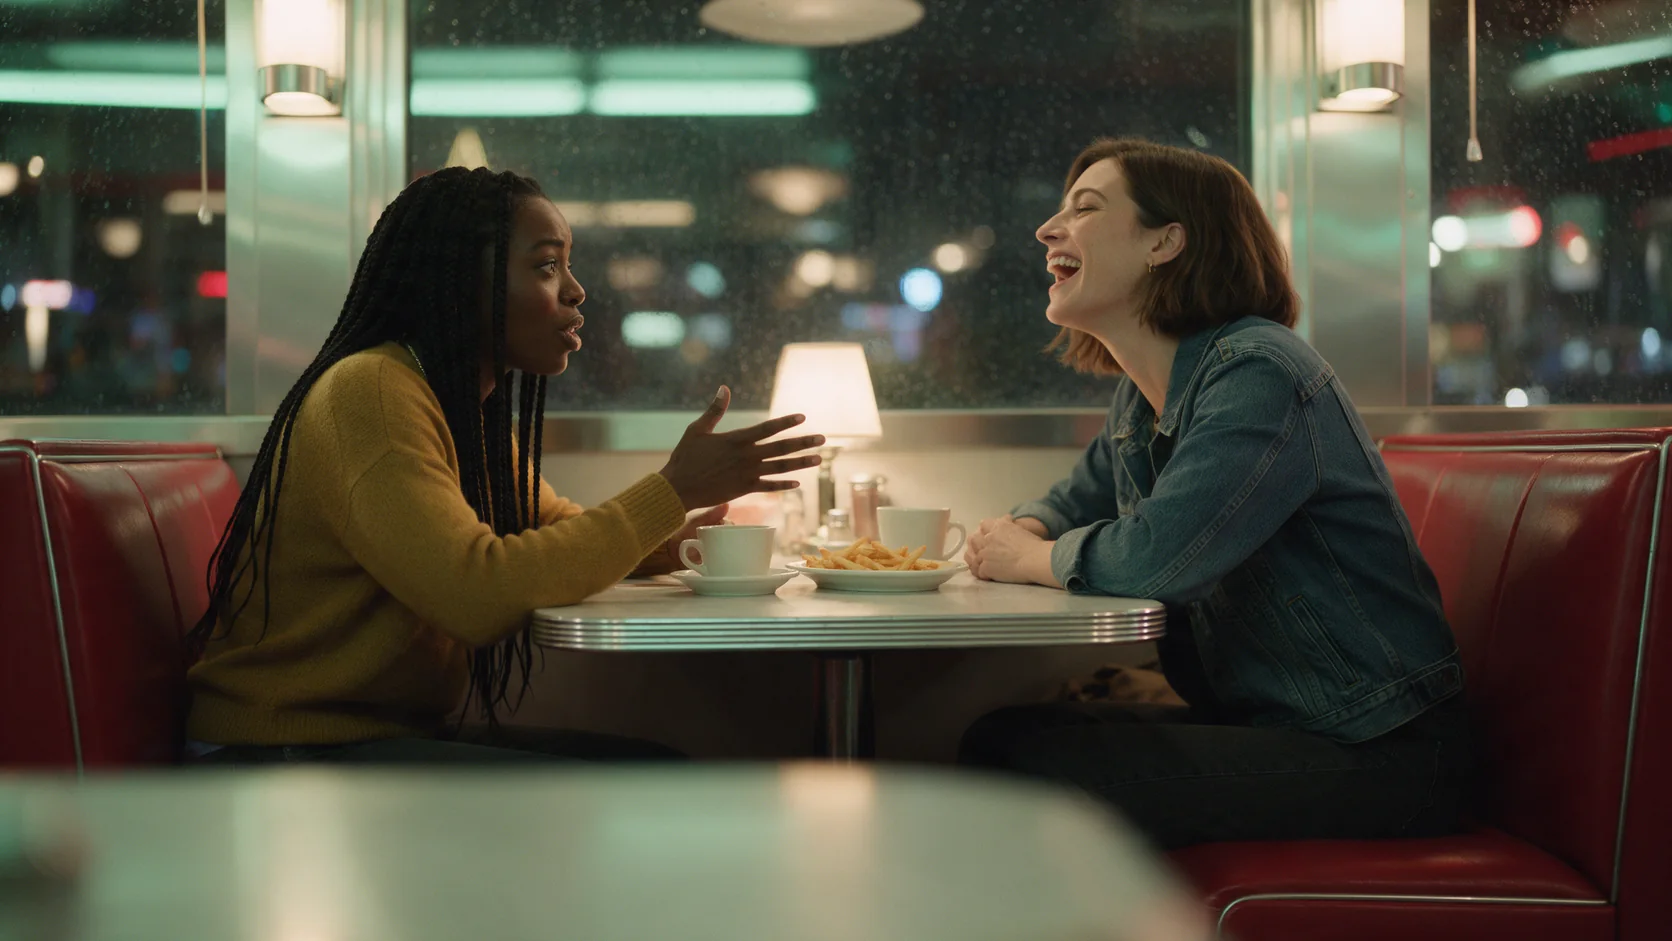
generate_audio를 켜면 프롬프트의 따옴표 안에 쓴 대사가 설명한 배경음과 함께, 영상에 맞춰 실제 들리는 대사로 돌아옵니다. 저희 테스트에서는 "Don't wait up"이라는 대사가 현악 4중주와 갈라 파티의 웅성거림 위로 실제 발화되어 돌아왔으며, 이 모든 것이 한 문단에서 나왔습니다.
여러 샷을 다루는 두 가지 방법
shot_type을 single로 설정하면 대부분의 구간에서 카메라가 하나의 셋업을 유지하지만 여전히 알아서 컷할 수 있습니다. 저희 테스트에서는 두 개의 싱글샷 클립이 진행 중간에 추가 컷을 얻었고, 한 번은 그와 함께 조명이 바뀌었습니다. 프롬프트에 "one continuous shot, no cuts"를 추가하니 재시도에서 샷이 하나로 유지됐습니다. shot_type을 multi로 설정하면 Kling이 알아서 컷을 결정합니다.
720p, 1080p, 4K
세 해상도와 오디오 스위치 모두 가격을 바꿉니다. 720p로 타이밍과 프레이밍을 초안 잡은 다음, 렌더링할 가치가 있는 테이크만 4K로 실행하세요.
요청 파라미터
| 파라미터 | 필수 | 설명 |
|---|---|---|
prompt | 예 | 피사체, 동작, 카메라, 그리고 사운드를 켠 경우 원하는 대사와 소리를 설명하세요. 1자 이상 · 2500자 이하 |
negative_prompt | 아니요 | 클립에서 빼고 싶은 요소(사물, 스타일, 움직임)를 최대 2,500자까지 적습니다. 선택 사항이며 가격에는 영향이 없습니다. 2500자 이하 |
aspect_ratio | 아니요 | 16:9, 9:16, 1:1 중 선택합니다. 클립 전체에 고정되며 따라갈 소스 프레임이 없습니다. |
resolution | 아니요 | 720p, 1080p, 4K 중 선택합니다. 상위 등급일수록 초당 비용이 더 듭니다. |
generate_audio | 아니요 | 따옴표로 쓴 대사, 효과음, 배경음이 담긴 사운드트랙을 같은 클립에 추가합니다. 720p와 1080p에서는 무음보다 초당 비용이 더 들지만, 4K에서는 음성을 켜든 끄든 가격이 같습니다. 기본값: |
duration_seconds | 아니요 | 정수 초 단위로 3~15초 사이입니다. 가격을 결정합니다. |
shot_type | 아니요 | single은 대부분의 구간에서 하나의 셋업을 유지하지만 여전히 알아서 컷할 수 있습니다. multi는 Kling이 알아서 멀티샷 편집을 하게 합니다. |
multi_prompt | 아니요 | shot_type이 customize일 때 쓰는 샷 목록입니다. 최대 6개 샷을 순서대로 넣고 각 샷에 프롬프트(최대 512자)와 정수 초 길이를 지정합니다. 1개 이상 · 6개 이하 |
guidance_scale | 아니요 | 클립이 프롬프트를 얼마나 충실히 따를지 0~1로 정합니다(기본값 0.5). 높을수록 문구에 가깝게, 낮을수록 모델에 더 많은 재량을 줍니다. |
요금
출력 초당 과금됩니다. 해상도와 오디오 스위치 모두 요율을 바꿉니다.
| 해상도 | 오디오 생성: 아니요 | 오디오 생성: 예 |
|---|---|---|
| $0.0672 / 초 | $0.1008 / 초 |
| $0.0896 / 초 | $0.1344 / 초 |
| $0.336 / 초 | $0.336 / 초 |
활용 사례
실제 사운드로 장면 열기
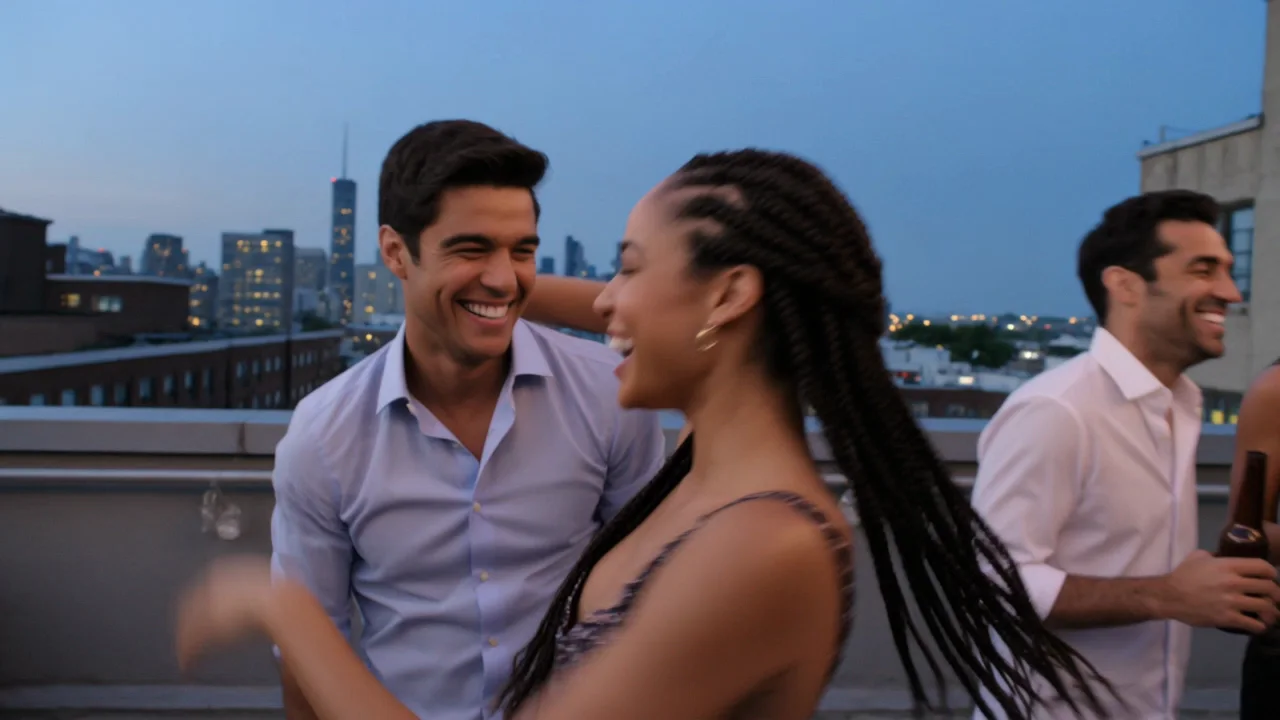
건배, 고백, 작별 인사—대사를 쓰고 오디오를 켜면 대사와 룸 톤, 영상이 한 파일로 도착합니다. 저희 루프탑 파티 예시는 그 아래 깔린 부딪히는 병 소리와 음악에 맞춰 그룹 전체가 한 줄을 함께 외치며 끝납니다.
4K로 확정하기 전에 룩 초안 잡기
텍스트→영상은 소스 이미지가 필요 없으므로, 4K 렌더링에 투자하기 전에 조명 아이디어나 카메라 움직임, 대사 한 줄을 테스트하는 가장 빠른 방법입니다.
연속성을 위해 이미지→영상으로 넘기기
텍스트→영상은 실행할 때마다 의상, 얼굴, 프레이밍을 새로 결정합니다. 캐릭터가 여러 클립에서 같은 모습을 유지해야 한다면 여기서 첫 샷을 생성한 다음 그 마지막 프레임을 다음 클립의 첫 프레임으로 이미지→영상에 넘기세요.
프롬프트 가이드 및 실전 팁
일어나는 순서대로 쓰세요
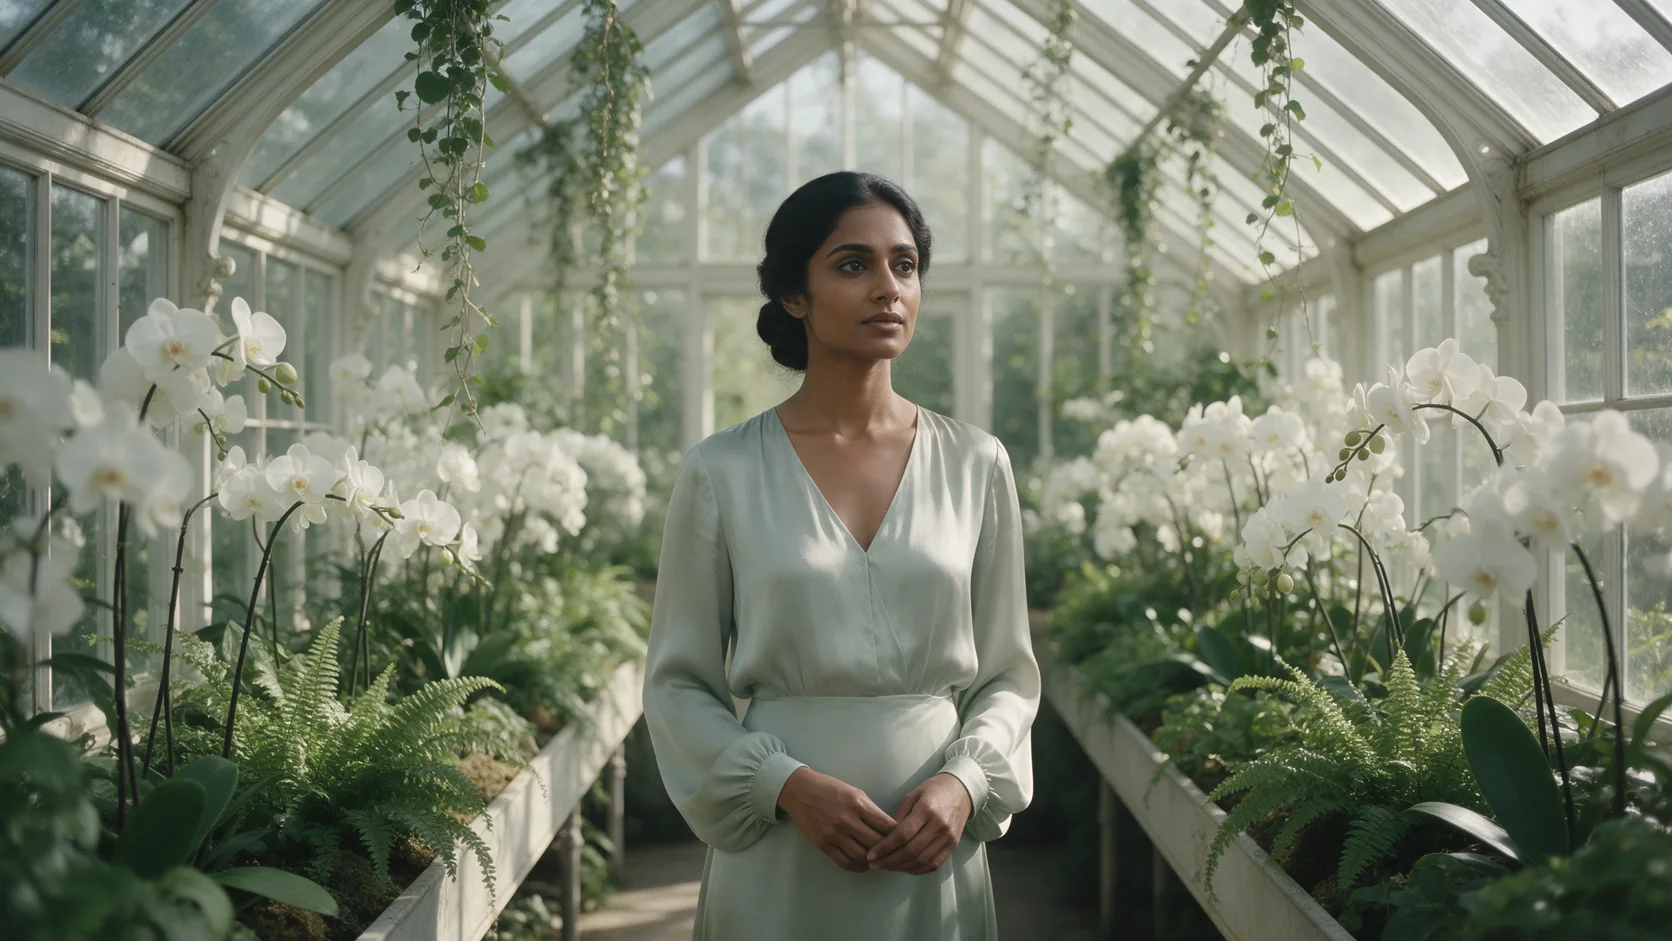
프롬프트를 피사체와 의상, 동작, 카메라 움직임, 룩, 사운드 순서로 구성하세요. 궁전 테라스 가운 예시가 이 순서를 따릅니다. 그녀가 누구이고 무엇을 입었는지, 무엇을 하는지(걷고, 돌아서고, 말하는), 카메라와 조명, 그다음 배경음입니다.
그룹 전체에 안착할 한 줄을 주세요
화면에 여러 사람이 있을 때, 브리프의 맨 끝에 한 순간—함께 말하는 한 줄—을 지정하면 여러 목소리가 겹쳐야 할 때를 모델이 추측하는 대신 대사를 안착시킬 명확한 박자를 줍니다.
중요할 때는 "one continuous shot, no cuts"라고 쓰세요
shot_type: single은 컷이 없다는 완전한 보장이 아닙니다. 테이크가 하나의 셋업으로 끝까지 유지되어야 한다면 그 지시를 프롬프트에 직접 추가하세요. 첫 시도에서 컷이 생기고 조명이 바뀐 샷을 재시도했을 때 이 방법이 프레이밍과 조명을 모두 안정적으로 유지했습니다.
API 빠른 시작
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "kling/3.0/text-to-video",
  "input": {
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "shot_type": "single",
    "resolution": "720p",
    "aspect_ratio": "16:9",
    "generate_audio": false,
    "duration_seconds": 5
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
인증, 전체 스키마, 폴링과 오류 처리는 API 레퍼런스에서 확인하세요.