Introduction
Qwen Image 2512 LoRA Texte vers image crée une image à partir d’un prompt écrit avec Qwen-Image-2512 d’Alibaba, un modèle ouvert de 20 milliards de paramètres publié en décembre 2025, en chargeant jusqu’à trois de vos propres fichiers LoRA. Choisissez l’un des neuf ratios d’image, jusqu’à 1536 pixels sur le grand côté, et récupérez un JPEG, un PNG ou un WebP à un prix fixe. La plateforme n’ajoute aucun filtre de contenu au prompt, aux poids ni à l’image.
Choisir un mode selon le matériau de départ
| Matériau de départ | Mode |
|---|---|
| une description écrite | Qwen Image 2512 LoRA Texte vers image |
| une à trois images à modifier | Qwen Image 2512 LoRA Retouche d’image |
Fonctionnalités et points forts
Une base plus grande sous votre LoRA
Alibaba présente Qwen-Image-2512 comme la version aux personnes plus réalistes, aux détails naturels plus fins, comme la fourrure et les paysages, et au meilleur rendu du texte. Les LoRA de style conservent ces détails : visages, mains et petits objets restent cohérents dans les rendus illustrés.
Des images plus grandes au même prix
Le 1:1 revient en 1328 x 1328 et le 16:9 en 1536 x 864, au-delà d’un mégapixel, et tous les ratios coûtent le même prix.
Sans censure, avec vos propres poids
Avec une LoRA sans filtre chargée, notre sonde de contenu la plus forte est revenue telle qu'écrite. Les poids ne sont jamais examinés et la sortie n'est jamais filtrée.
Paramètres de requête
| Paramètre | Obligatoire | Description |
|---|---|---|
prompt | Oui | Placez d’abord l’expression déclencheuse du LoRA, puis décrivez le sujet, le décor et la lumière. Qwen-Image suit bien les prompts longs et détaillés. 1 caractères minimum · 5000 caractères maximum |
aspect_ratio | Non | Neuf options, du 21:9 au 9:21. Le 1:1 donne 1328 x 1328 et le 16:9 donne 1536 x 864 ; tous coûtent le même prix. |
loras | Non | Jusqu’à trois entrées {path, scale} entraînées pour Qwen-Image-2512 ; scale de 0 à 4, 1 est neutre. Valeur par défaut: |
output_format | Non | JPEG par défaut, PNG ou WebP si besoin. Sans effet sur le prix. |
seed | Non | Garde une série d’images comparable pendant que vous changez un seul scale de LoRA à la fois. |
Tarification
$0.03 / image
Facturé à l’image, à un prix fixe quel que soit le ratio. Charger des LoRA n’entraîne aucun supplément.
Cas d’utilisation
Des séries d’illustrations
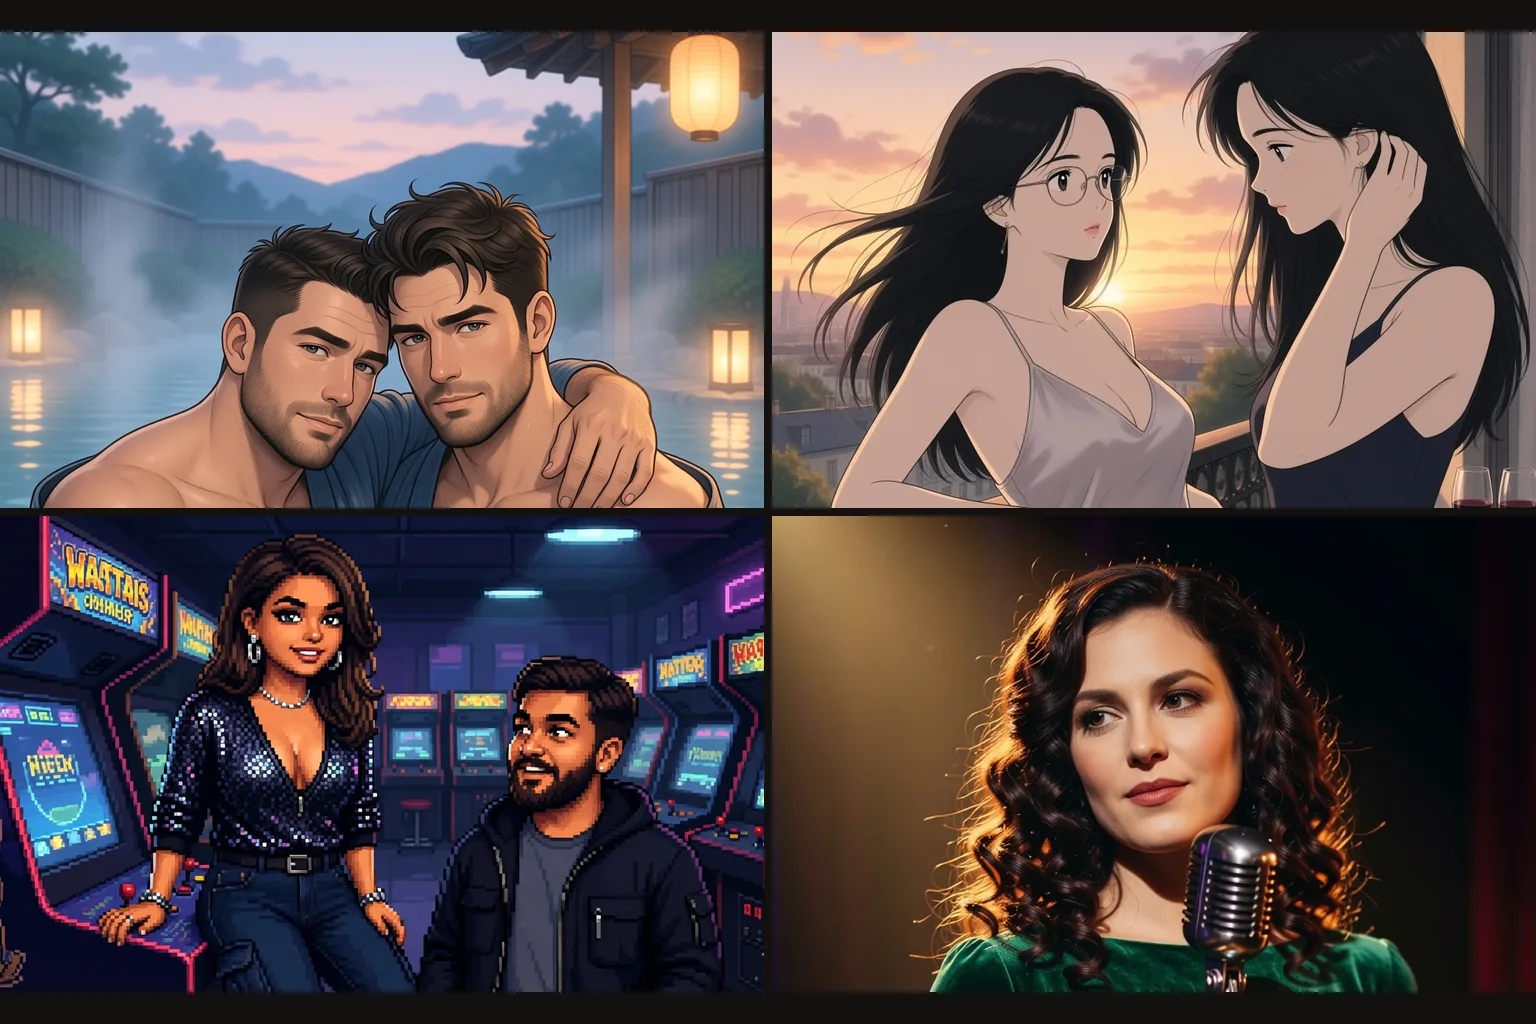
Les LoRA livre illustré, aquarelle et pixel art, avec un seed fixe, donnent une série cohérente de couvertures, de cases de BD ou de miniatures. Les images plus grandes laissent de la marge pour recadrer une même image vers plusieurs emplacements.
Des personnages détaillés
Un LoRA de personnage sur une base de 20 milliards de paramètres garde les visages et les mains lisibles dans des images stylisées, ce qui compte pour les planches de personnage et les visual novels où la même figure revient encore et encore.
Des images sans censure pour votre plateforme
Chargez le LoRA qu’attend votre public et décrivez directement l’image, sans indicateur de contenu ni seconde vérification du résultat.
Guide de prompt et conseils pratiques
Utilisez le déclencheur d’entraînement du LoRA
De nombreux LoRA 2512 réagissent à une expression de style comme « storybook anime illustration » ou « Pixel Art ». Placez-la au début du prompt, recopiée telle quelle depuis la fiche du modèle.
Écrivez des prompts longs et concrets
Qwen-Image lit bien les descriptions détaillées : sujet, vêtements, lieu, moment de la journée, lumière et palette en phrases complètes. Une courte liste de mots-clés gaspille le niveau de détail du modèle de base.
Vérifiez la base avant de charger
Un LoRA fait pour une base sans rapport se charge sans erreur mais fait peu de chose. Un LoRA entraîné pour la première version de Qwen-Image modifie souvent encore l’image ici, avec des résultats moins prévisibles. La fiche du modèle indique sa base ; cherchez Qwen-Image-2512 avant de dépenser une requête.
Comparez les intensités sur un même seed
Gardez le seed fixe et essayez le LoRA à 0,7, 1 et 1,3. Sur une grande base, les LoRA de style ont parfois besoin d’un peu plus d’intensité avant que le look ne prenne le dessus.
Démarrage rapide de l’API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "alibaba/qwen-image-2512-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
La référence API détaille l’authentification, le schéma complet, le polling et la gestion des erreurs.