본문으로 건너뛰기

daVinci-MagiHuman API

sand-ai/davinci-magihuman/image-to-video

daVinci-MagiHuman 이미지→동영상은 사진 한 장으로 5~10초 클립을 시작해 움직임과 목소리를 줍니다. 프롬프트에 대사를 따옴표로 적거나, 직접 준비한 오디오를 붙이십시오. 256p, 720p 또는 1080p, 16:9 또는 9:16입니다.

최저가 $0.024/초

플레이그라운드

입력

이미지→영상
211/5000
사진 다음에 일어나는 일을 적으십시오. 인물이 무엇을 하고 따옴표 안에서 무엇을 말하는지 쓰십시오. audio_url을 넣었다면 대사 단어는 빼고 분위기, 움직임, 빛만 적으십시오. 3자 이상 · 5000자 이하
1/1

파일이나 미디어 링크를 끌어오거나 붙여넣기 또는 선택 · 파일 1개 · 개당 최대 10 MB · JPG · PNG · WEBP

  • 1
파일 1 / 1개
첫 프레임입니다. 공개 링크로서 직접 내려받을 수 있어야 하며, 클립은 이 사진에서 시작합니다.
0/1

오디오 파일을 끌어다 놓거나 직접 선택하세요 · 파일 1개 · 개당 최대 90 MB · MP3 · WAV

파일 0 / 1개
선택 사항. 음성이나 노래 파일의 공개 링크입니다. 영상이 그 파일에 맞춰 만들어지며 목소리를 새로 만들지 않습니다. 저희 실행은 5초 녹음을 5초 클립에 썼습니다.
16:9(기본값) 또는 9:16. 저희 이미지→동영상 실행은 모두 16:9를 썼습니다. 화면 형태는 가격을 바꾸지 않습니다.
요금에 영향
256p, 720p(기본값) 또는 1080p. 상위 해상도일수록 초당 요금이 더 비쌉니다. 모델은 작게 렌더링하고 자체 초해상도 단계가 상위 해상도를 만듭니다. 저희 720p 실행은 약 1358 x 678로 나왔습니다.
길이요금에 영향
5~10초, 기본값 5. 초 단위로 과금됩니다. 5 이상 · 10 이하
시드
선택 사항인 정수. 같은 seed와 같은 입력이면 비슷하지만 똑같다고 보장되지 않는 결과가 나옵니다. 0 이상 · 2147483647 이하
안전 검사꺼짐

SpicyAPI는 이 모델에 안전 검사를 적용하지 않습니다. 프롬프트와 소재는 작성한 그대로 모델에 전달되며, 결과는 모델 자체가 결정합니다.

제출과 가격 계산을 열기 전에 계정을 확인하고 있습니다.

출력

실행 대기
샘플 결과

찾는 모델이 없나요?

필요한 모델과 쓰려는 목적을 알려 주세요. 다음에 무엇을 추가할지 정하는 팀에 바로 전달됩니다.

말하는 동영상 API

daVinci-MagiHuman API 한눈에 보기

150억 파라미터 모델 하나가 화면과 목소리를 함께 만듭니다. 텍스트나 사진 한 장으로 카메라를 보고 말하는 인물을 5~10초, 최대 1080p 클립으로 만들어 줍니다.

파라미터
15B
화면과 사운드트랙을 함께 만드는 모델 하나입니다. 가중치는 Apache 2.0으로 공개되어 있습니다.
클립 길이
5~10초
5초에서 10초 사이에서 고를 수 있으며 기본값은 5초입니다. 저희 클립은 25 fps로 나왔습니다.
최고 해상도
1080p
256p, 720p(기본값) 또는 1080p입니다. 모델은 작게 렌더링하고, 모델 자체의 초해상도 단계가 상위 해상도를 만듭니다. 크기는 요청한 값에 가깝게 나오며, 1080p에서는 약 1904 x 1088이 나왔습니다.
화면 형태
2
두 엔드포인트 모두 가로 16:9(기본값) 또는 세로 9:16입니다. 사운드와 화면 형태는 가격을 바꾸지 않습니다.
직접 준비한 오디오
선택 사항
음성이나 노래 파일을 audio_url로 보내면, 목소리를 새로 만드는 대신 영상이 그 녹음에 맞춰 만들어집니다.
음성 언어
6
중국어(만다린·광둥어), 영어, 일본어, 한국어, 독일어, 프랑스어를 출품사 목록 기준으로 제시합니다. 저희는 영어로 테스트했습니다.

결과물

daVinci-MagiHuman: 만들 수 있는 콘텐츠

  • 텍스트→동영상

    발코니에서 말하는 한 줄의 대사

    따옴표 대사가 들어간 프롬프트 하나로, 밤 발코니에 선 플래티넘 단발 여성의 1080p 클립을 만들었습니다. 약 1904 x 1088, 25 fps, 5.0초, 사운드 포함으로 나왔고, 사운드트랙을 받아 적은 결과가 대사와 한 단어도 틀리지 않게 일치했습니다. 처리에는 약 3분 53초가 걸렸습니다.

    텍스트→동영상, 1080p, 16:9, 5초. 따옴표 대사가 사운드트랙에 말로 담겼습니다.

  • 세로 영상

    웃음과 대사가 담긴 세로 클립

    화면 형태를 9:16으로 설정하자, 비 젖은 네온 거리에서 주근깨가 있는 짧은 진저 헤어의 남자가 웃으며 대사를 말합니다. 720p에서 약 726 x 1270, 5.0초로 나왔고, 받아 적은 결과가 한 단어도 틀리지 않게 일치했습니다. 처리에는 약 1분이 걸렸습니다. 셀피를 요청하는 대신 ‘looks straight into the camera’라고 썼습니다.

    세로형 텍스트→동영상, 9:16, 720p, 5초. 따옴표 대사가 사운드트랙에 말로 담겼습니다.

  • 이미지→동영상

    돌아서며 말하는 사진

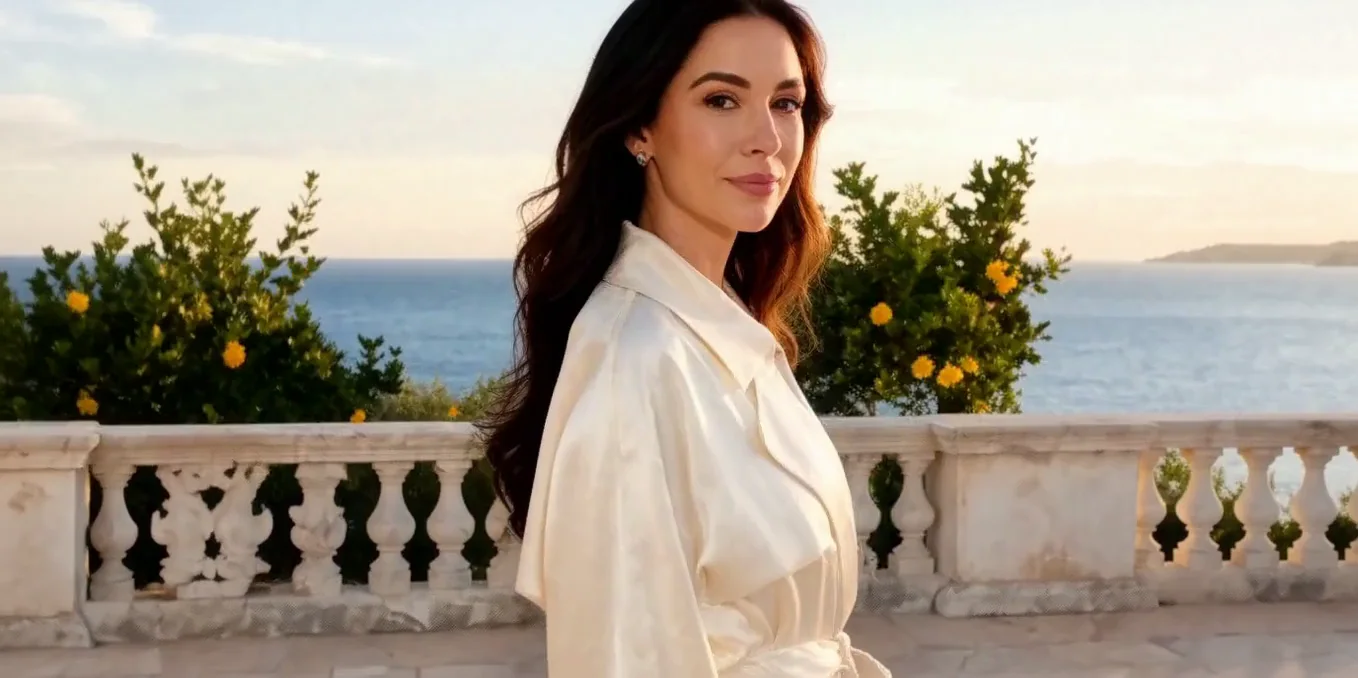
    첫 프레임 이미지와 프롬프트로, 음성 파일 없이 그녀가 바다 쪽에서 몸을 돌려 머리카락을 귀 뒤로 넘기고 대사를 말합니다. 받아 적은 결과가 한 단어도 틀리지 않게 일치했습니다. 720p에서 약 1358 x 678, 5.0초로 나왔고, 처리에는 약 1분 45초가 걸렸습니다.

    음성 파일 없이 만든 이미지→동영상, 16:9, 720p, 5초. 따옴표 대사가 사운드트랙에 말로 담겼습니다.

  • 직접 준비한 오디오

    녹음을 따라가는 인물 사진

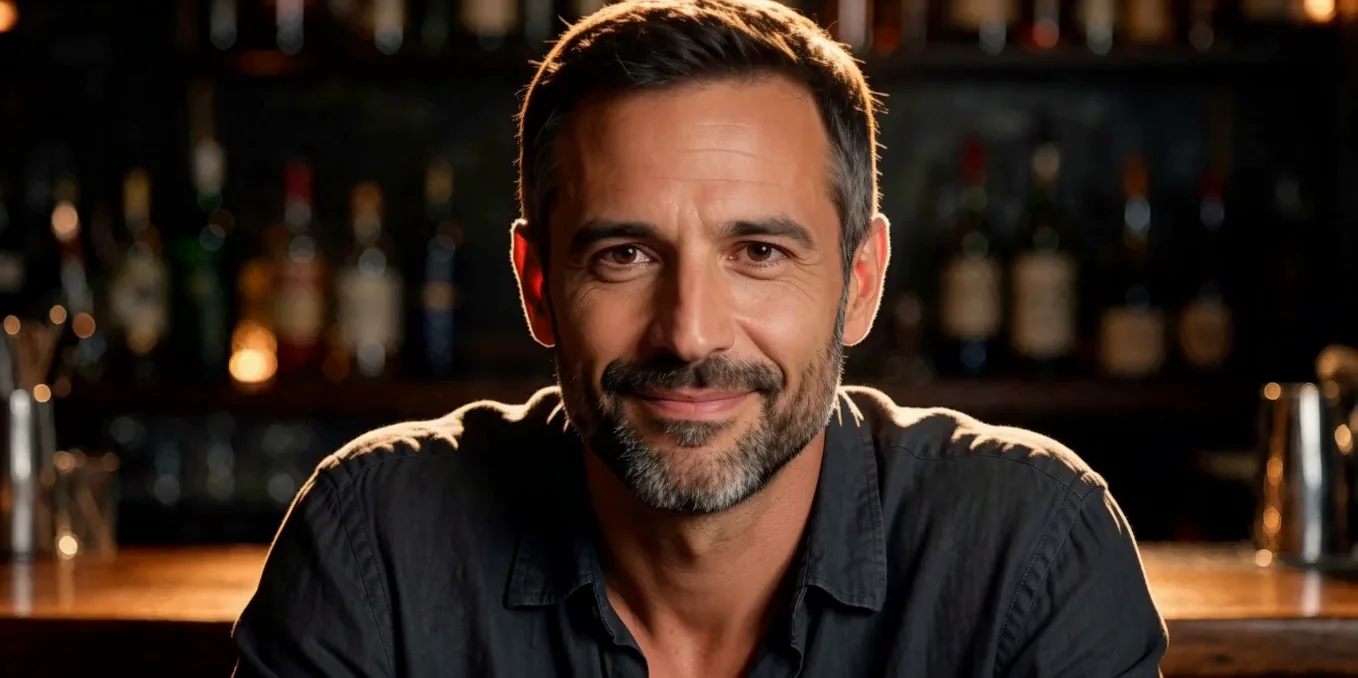
    5초짜리 음성 클립을 audio_url로 넣자, 입 모양이 제공된 오디오를 따랐고 반쯤 웃는 표정과 눈썹 움직임이 더해졌으며 얼굴은 입력한 인물 사진과 가깝게 유지되었습니다. 720p에서 약 1358 x 678, 5.0초로 나왔고, 처리에는 약 3분 7초가 걸렸습니다.

    5초짜리 음성 클립을 audio_url로 쓴 이미지→동영상, 16:9, 720p, 5초.

실행하기 전에

daVinci-MagiHuman 사용 전에 알아 둘 점

모든 모드
클립은 5~10초이며 256p, 720p 또는 1080p, 16:9 또는 9:16입니다. 크기는 요청한 값과 정확히 같지 않고 근접하게 나옵니다. 720p 16:9는 약 1358 x 678, 1080p는 약 1904 x 1088이었습니다. 영어 음성만 테스트했고 노래는 테스트하지 않았습니다. 클립에 무엇이 담기는지는 프롬프트와 저희 이용 정책에 따릅니다.
텍스트→영상
인물과 장면은 입력한 글에서 나오므로 화면 구도를 적으십시오. 셀피를 요청했을 때 추가 실행 한 번에서 프레임에 휴대폰이 들어갔습니다. 이 엔드포인트에서는 audio_url을 실행하지 않았습니다.
이미지→영상
첫 프레임 이미지는 필수이며 클립은 그 이미지에서 시작합니다. 저희의 image-to-video 실행은 모두 16:9를 썼습니다. audio_url은 5초 녹음을 5초 클립에 맞춰 테스트했고, 녹음이 클립보다 짧거나 긴 경우는 테스트하지 않았습니다.

활용 사례

daVinci-MagiHuman API로 만들 수 있는 것

  • 짧게 말하는 클립

    한 사람이 카메라를 보고 한 줄을 5~10초 동안 말합니다. 인트로, 예고, 인사말 등에 쓸 수 있으며 목소리는 자동으로 생성됩니다.

  • 휴대폰용 세로 클립

    피드와 스토리에 맞게 화면 형태를 9:16으로 설정하십시오. 저희 720p 세로 실행은 약 726 x 1270으로 나왔습니다.

  • 내 녹음에 맞춰 말하는 인물 사진

    사진으로 시작하고 음성 파일을 audio_url로 넣으십시오. 입 모양은 여러분의 오디오를 따르고, 얼굴은 사진과 가깝게 유지됩니다.

  • 캐릭터와 대사 테스트

    긴 작업을 만들기 전에, 첫 프레임 사진과 짧은 따옴표 대사로 캐릭터의 모습과 목소리를 먼저 확인해 보십시오. 저희는 영어로 테스트했고, 출품사는 영어 외에 다섯 개 언어를 더 제시합니다.

프롬프트

복사해서 쓰는 daVinci-MagiHuman 프롬프트 예시

하나를 그대로 플레이그라운드에 붙여 넣은 다음, 한 번에 하나씩만 바꿔 보십시오.

  • 텍스트→영상

    누가, 어디서, 따옴표 대사, 그다음 빛

    이 프롬프트의 결과

    Close-up at night on a hotel balcony, city lights blurred behind. A woman in her thirties with a short platinum bob and a black slip dress leans on the rail, looks into the camera with a sly smile and says softly: "You really thought I'd leave without saying goodbye?" Warm practical light, shallow depth of field.

    효과가 있는 이유. 인물과 장소를 먼저 쓰고, 대사는 말하는 방식과 함께 따옴표에 넣었으며, 마지막에 빛으로 프롬프트를 닫았습니다. 받아 적은 결과가 대사와 한 단어도 틀리지 않게 일치했습니다.

    이 프롬프트 써 보기
  • 텍스트→영상

    눈이 어디를 보는지 적으십시오

    이 프롬프트의 결과

    Vertical medium close-up on a rainy neon-lit street at night. A man in his late twenties with freckles, short ginger hair and a wet denim jacket looks straight into the camera, laughs and says: "Okay, I'm lost, but honestly? Best night of the trip." Rain drips from his hair, pink and blue sign reflections on the wet pavement behind him. Handheld, eye level.

    효과가 있는 이유. ‘looks straight into the camera’가 화면 구도를 정했습니다. 추가 실행에서 휴대폰으로 찍은 셀피를 요청하자, 프레임에는 휴대폰이 대신 들어갔습니다.

    이 프롬프트 써 보기
  • 이미지→영상

    사진에 다음 순간을 주십시오

    이 프롬프트의 결과

    On a sunlit stone terrace above the sea, she turns from the view to the camera, tucks her hair behind her ear and says warmly: "Stay for one more sunset. The boat can wait." Gentle sea breeze, soft golden light.

    효과가 있는 이유. 프롬프트는 사진 이후에 그녀가 하는 일을 적었습니다. 카메라 쪽으로 돌아서기, 머리카락 넘기기, 말하기가 모두 일어났고 받아 적은 결과도 맞았습니다.

    이 모드는 직접 준비한 이미지에서 시작합니다. 실행하기 전에 플레이그라운드에서 이미지를 추가하십시오.

    이 프롬프트 써 보기
  • 이미지→영상

    내 목소리로, 룩을 지시하십시오

    이 프롬프트의 결과

    Leaning on the bar, he speaks low and teasing, a slow half smile and a raised eyebrow, warm amber light.

    효과가 있는 이유. 대사는 보낸 음성에서 오므로 프롬프트는 분위기, 움직임, 빛만 정합니다. 입 모양이 오디오를 따랐고, 반쯤 웃는 표정과 눈썹 움직임이 나왔습니다.

    이 모드는 직접 준비한 이미지에서 시작합니다. 실행하기 전에 플레이그라운드에서 이미지를 추가하십시오.

    이 프롬프트 써 보기

비교

daVinci-MagiHuman과 유사 모델 비교: 어떤 모델을 고를까요?

모델모드최저가콘텐츠이럴 때 선택
OmniHuman 2.0말하는 아바타$0.108 / 출력 초필터 적용 — 이 모델은 모델 자체의 허용 범위를 넘는 요청을 명확히 거부합니다. 실측한 결과이며, 측정하지 않은 모델에는 표시가 붙지 않습니다.이미 목소리 녹음과 인물 사진이 있고, 그 오디오에 맞춰 최대 300초까지 더 긴 클립을 원한다면 OmniHuman 2.0이 맞습니다. 모델이 직접 쓴 따옴표 대사를 말하게 하거나 9:16 클립이 필요하다면 daVinci-MagiHuman을 고르십시오.
Kling Avatar 2.0말하는 아바타$0.051 / 출력 초필터 적용 — 이 모델은 모델 자체의 허용 범위를 넘는 요청을 명확히 거부합니다. 실측한 결과이며, 측정하지 않은 모델에는 표시가 붙지 않습니다.인물 사진과 직접 준비한 오디오가 있고, 그 오디오가 이끄는 클립을 원한다는 점에서 OmniHuman 2.0과 같은 방식입니다. 모델이 따옴표 안에 적은 대사를 말하게 하고 싶다면 daVinci-MagiHuman을 고르십시오.

가격

daVinci-MagiHuman API 가격

5초 클립은 256p에서 $0.12부터, 1080p에서 $0.36부터입니다.

생성한 만큼 미국 달러로 청구합니다. 실행하기 전에 플레이그라운드에서 설정에 맞는 정확한 가격을 확인할 수 있습니다. 실패하거나 시간이 초과된 작업에는 보통 요금이 부과되지 않습니다. 단, 모델 페이지에 명시된 일부 모델은 콘텐츠 거부에도 요금을 부과합니다. 제출 전에 해당 과금 조건을 확인하세요.

모든 가격 구간 보기

시작하기

세 단계로 daVinci-MagiHuman API 사용하기

  1. 1단계

    대사는 따옴표 안에 넣으십시오

    모델은 따옴표 안의 대사를 말합니다. 누가 어떻게(조용히, 다정하게, 웃으면서) 말하는지 쓰고, 그다음에 대사를 적으십시오. 5초 클립 기준으로 저희가 쓴 따옴표 대사 세 개는 8~10단어였고, 모두 한 단어도 틀리지 않게 나왔습니다.

  2. 2단계

    기기가 아니라 화면 구도를 적으십시오

    추가 9:16 실행에서 휴대폰으로 찍은 셀피를 요청했더니, 뒤쪽에서 카메라를 향한 휴대폰이 프레임에 들어갔습니다. 대신 ‘looks straight into the camera’라고 쓰고, 샷 크기(‘vertical medium close-up’)를 적으십시오.

  3. 3단계

    audio_url로 내 목소리 쓰기

    음성이나 노래 파일을 붙이면 프롬프트에 대사를 쓸 필요가 없습니다. 분위기, 움직임, 빛만 적으면 입 모양이 녹음을 따라갑니다. 저희 실행에서는 5초 녹음이 5초 클립과 맞았습니다.

파라미터 설명과 코드 예시는 이 페이지 상단의 API 탭과 Readme 탭에 있습니다.

SpicyAPI를 쓰는 이유

SpicyAPI에서 daVinci-MagiHuman 모델을 사용하는 이유

  • 자체 필터 없음

    저희는 콘텐츠 필터를 따로 추가하지 않습니다. 모델이 생성한 결과를 그대로 받습니다.

  • 추측이 아닌 실측

    콘텐츠 단계는 저희가 직접 생성하고 확인한 결과를 바탕으로 하며, 테스트 날짜를 페이지에 적어 둡니다.

  • 결과만큼 달러로 결제

    구독도 크레딧도 없습니다. 실패하거나 시간이 초과된 작업에는 보통 요금이 부과되지 않습니다. 단, 모델 페이지에 명시된 일부 모델은 콘텐츠 거부에도 요금을 부과합니다. 제출 전에 해당 과금 조건을 확인하세요.

  • 모든 모델에 키 하나

    API 키 하나와 같은 잔액으로 이미지·영상·오디오·채팅 모델을 이용할 수 있어, 한 계정에서 더 많은 모델을 살펴볼 수 있습니다.

FAQ

daVinci-MagiHuman API 자주 묻는 질문

daVinci-MagiHuman 소개

daVinci-MagiHuman은 Sand.ai와 SII-GAIR의 150억 파라미터 오픈 모델을 하나의 API로 제공합니다. 화면과 목소리를 함께 만드는 텍스트→동영상과 이미지→동영상을 5~10초, 256p, 720p 또는 1080p, 16:9 또는 9:16으로 쓸 수 있고, 직접 준비한 오디오를 가져올 수도 있습니다. 요청한 길이만큼 초 단위로 과금되며, 실패한 요청에는 요금이 부과되지 않습니다.

관련 모델과 다음 단계