소개
daVinci-MagiHuman 이미지→동영상은 사진 한 장을 움직이게 하고 목소리를 줍니다. daVinci-MagiHuman은 Sand.ai와 SII-GAIR가 공개한 오픈 150억 파라미터 모델로, 화면과 사운드트랙을 함께 생성합니다. 사진이 첫 프레임이 되고, 프롬프트는 다음에 일어나는 일과 따옴표 안의 대사를 적습니다. 이 엔드포인트는 256p, 720p 또는 1080p, 16:9 또는 9:16의 5~10초 클립을 돌려주며, 직접 준비한 음성이나 노래를 audio_url로 받을 수 있습니다.
시작 자료에 따라 모드 선택하기
| 가진 자료 | 모드 |
|---|---|
| 글로 쓴 설명 | daVinci-MagiHuman 텍스트→동영상 |
| 시작점으로 쓸 사진 (직접 준비한 오디오는 선택) | daVinci-MagiHuman 이미지→동영상 |
핵심 기능 및 하이라이트
움직이고 말하는 첫 프레임
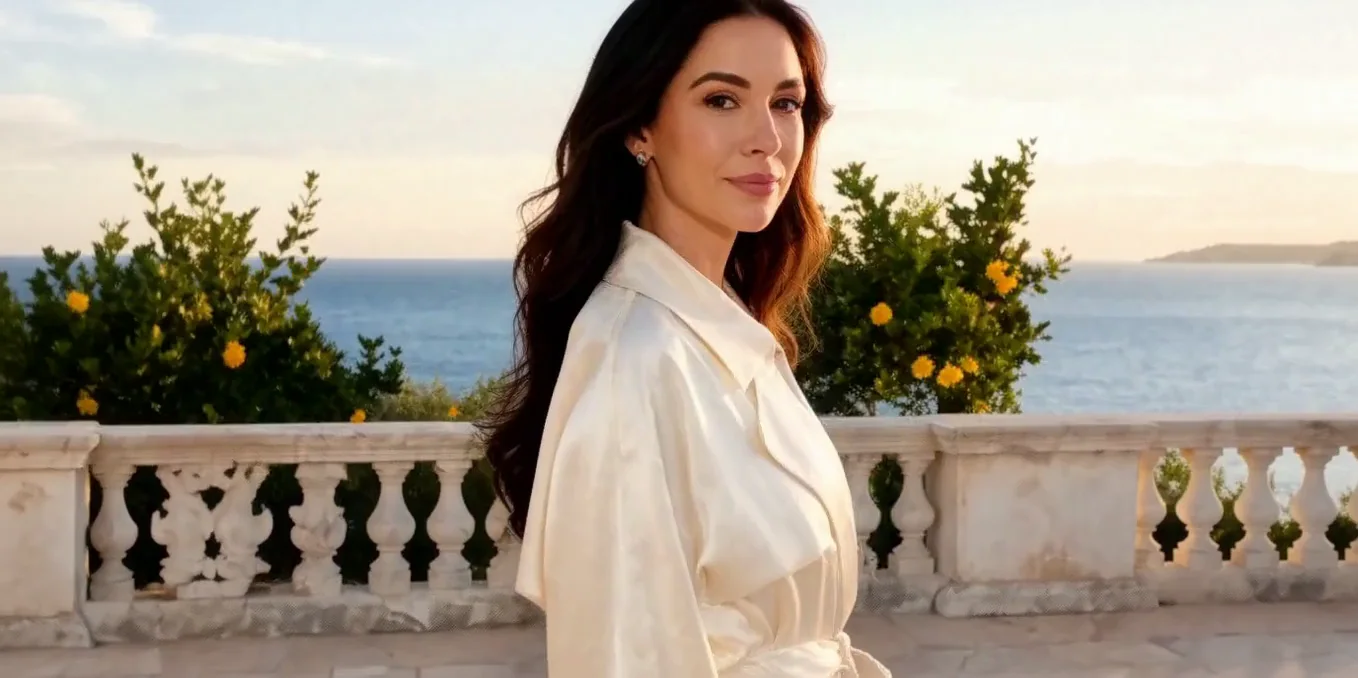
클립은 이미지에서 시작합니다. 음성 파일 없이 실행한 저희 테스트에서 그녀는 바다 쪽에서 몸을 돌리고, 머리카락을 귀 뒤로 넘기며, 따옴표 안의 대사를 말했습니다. 받아 적은 결과가 한 단어도 틀리지 않게 일치했습니다.
직접 준비한 목소리
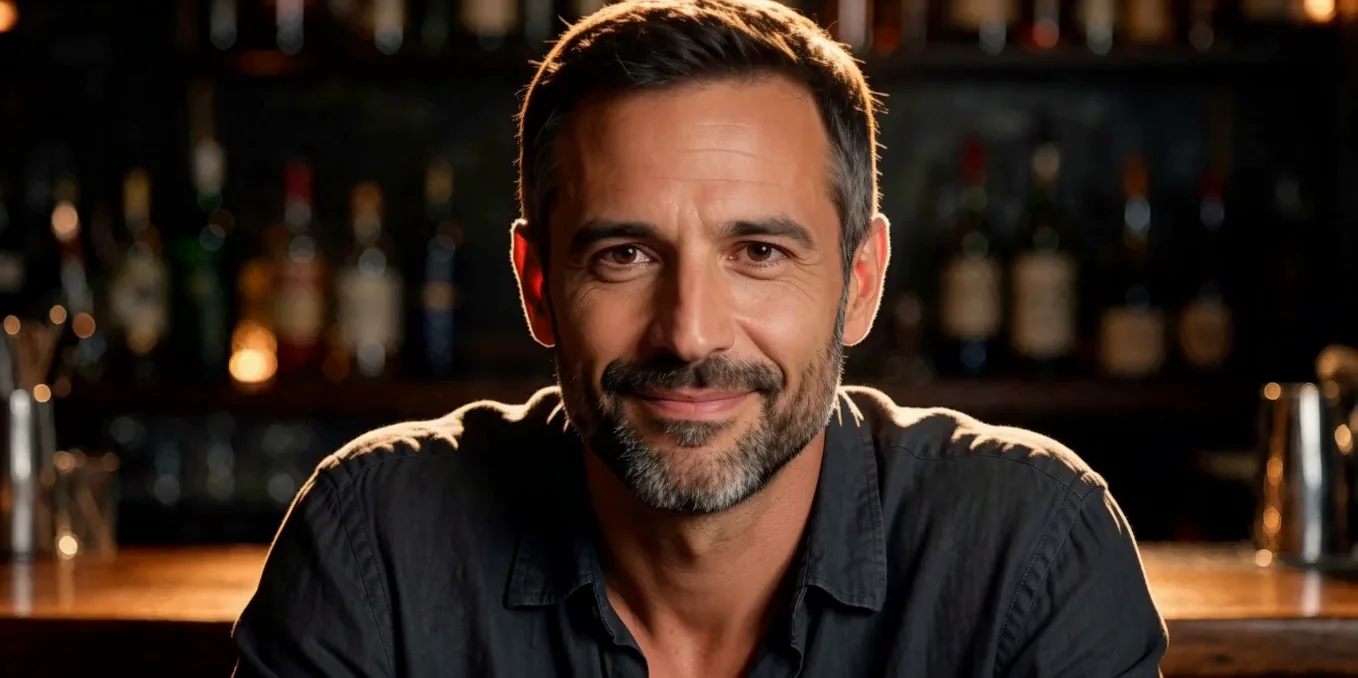
audio_url을 넣으면 목소리를 새로 만드는 대신 영상이 제공된 음성이나 노래에 맞춰 생성됩니다. 5초 음성 클립을 넣은 저희 실행에서는 입 모양이 오디오를 따랐고, 반쯤 웃는 표정과 눈썹 움직임이 나왔으며, 얼굴은 입력한 인물 사진과 가깝게 유지되었습니다.
저희가 측정한 결과
720p, 16:9 이미지→동영상 클립을 두 개 만들었고, 둘 다 5.0초에 약 1358 x 678, 25 fps였습니다. 그래서 720p는 정확히 1280 x 720이 아닙니다. 오디오 없는 실행은 약 1분 45초, 5초 음성 클립을 audio_url로 넣은 실행은 약 3분 7초가 걸렸습니다. 이 엔드포인트는 1080p, 9:16, 또는 클립과 길이가 다른 녹음으로는 실행하지 않았습니다.
해상도와 화면 형태
resolution은 256p, 720p(기본값) 또는 1080p이며, aspect_ratio는 16:9(기본값) 또는 9:16입니다. 모델은 낮은 기본 해상도로 렌더링하고, 자체 초해상도 단계가 상위 해상도를 만듭니다. 상위 해상도일수록 초당 요금이 더 비싸며, 사운드와 화면 형태는 가격을 바꾸지 않습니다.
요청 파라미터
| 파라미터 | 필수 | 설명 |
|---|---|---|
prompt | 예 | 사진 다음에 일어나는 일을 적으십시오. 인물이 무엇을 하고 따옴표 안에서 무엇을 말하는지 쓰십시오. 3자 이상 · 5000자 이하 |
image_url | 예 | 첫 프레임입니다. 공개 링크로서 직접 내려받을 수 있어야 하며, 클립은 이 사진에서 시작합니다. |
audio_url | 아니요 | 선택 사항. 음성이나 노래 파일의 공개 링크입니다. |
aspect_ratio | 아니요 | 16:9(기본값) 또는 9:16. 저희 이미지→동영상 실행은 모두 16:9를 썼습니다. |
resolution | 아니요 | 256p, 720p(기본값) 또는 1080p. 상위 해상도일수록 초당 요금이 더 비쌉니다. |
duration_seconds | 아니요 | 5~10초, 기본값 5. 초 단위로 과금됩니다. |
seed | 아니요 | 선택 사항인 정수. 같은 seed와 같은 입력이면 비슷하지만 똑같다고 보장되지 않는 결과가 나옵니다. |
요금
선택한 해상도에서 요청한 길이만큼 출력 초 단위로 과금됩니다. 초당 요금은 해상도에 따라 다르며, 사운드와 화면 형태는 요금을 바꾸지 않습니다. 실패한 요청에는 요금이 부과되지 않습니다.
| 사양 | 요금 |
|---|---|
| $0.024 / 초 |
| $0.048 / 초 |
| $0.072 / 초 |
활용 사례
내 녹음에 맞춰 말하는 인물 사진
인물 프로필 사진과 음성 파일을 넣으면 입 모양은 여러분의 오디오를 따르고, 얼굴은 사진과 가깝게 유지됩니다.
한 줄을 말하는 캐릭터
첫 프레임 이미지와 짧은 따옴표 대사로 캐릭터의 모습과 목소리를 먼저 확인한 뒤, 더 많은 작업에 투입하십시오.
사진으로 만드는 세로 클립
피드와 스토리에는 9:16을 고르십시오. 이 엔드포인트의 저희 실행은 모두 16:9였으니 첫 클립은 확인해 보십시오.
프롬프트 가이드 및 실전 팁
다음 순간을 묘사하십시오
사진을 찍은 뒤에 일어날 일을 적으십시오. 그녀가 카메라 쪽으로 돌아서고, 머리카락을 넘기고, 말하는 것입니다. 저희 실행에서는 세 가지가 모두 일어났습니다.
직접 준비한 오디오가 있다면 대사 단어는 빼십시오
목소리는 audio_url에서 오므로, 프롬프트에는 분위기, 움직임, 빛만 적으면 됩니다. 예: he speaks low and teasing, a slow half smile and a raised eyebrow, warm amber light.
녹음 길이를 클립에 맞추십시오
저희 실행은 5초 녹음을 5초 클립에 썼습니다. duration_seconds보다 짧거나 긴 녹음은 테스트하지 않았으니, 오디오를 설정한 길이에 맞춰 자르십시오.
음성 없이 쓴다면 대사는 따옴표에 넣으십시오
인물이 말할 내용은 따옴표 안에 넣으십시오. 모델이 그대로 말합니다. 저희는 영어로 테스트했습니다.
모델 고르기
이미 목소리 녹음과 인물 사진이 있고, 그 오디오에 맞춰 최대 300초까지 더 긴 클립을 원한다면 OmniHuman 2.0을 쓰십시오. Kling Avatar 2.0도 같은 방식입니다. 모델이 직접 쓴 대사를 말하게 하거나 9:16 클립이 필요하다면 daVinci-MagiHuman을 고르십시오.
API 빠른 시작
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "sand-ai/davinci-magihuman/image-to-video",
  "input": {
    "aspect_ratio": "16:9",
    "duration_seconds": 5,
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "resolution": "720p"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
인증, 전체 스키마, 폴링과 오류 처리는 API 레퍼런스에서 확인하세요.