본문으로 건너뛰기

Alibaba Tongyi-MAI 팀의 60억 파라미터 증류하지 않은 Z-Image 모델 Z-Image Base의 텍스트→이미지이며, 요청당 직접 만든 LoRA를 최대 3개 얹을 수 있습니다. 문장형 프롬프트, 화면비 9종, JPEG·PNG·WebP를 지원하고 프롬프트, 가중치, 결과 어디에도 필터가 없습니다.

최저가 $0.014/장

플레이그라운드

입력

텍스트→이미지
406/5000
완전한 문장이 가장 잘 통합니다. 피사체, 옷차림, 장소, 빛, 렌즈를 적으십시오. LoRA의 트리거 문구는 맨 앞에 둡니다. 최대 5,000자이며 네거티브 프롬프트는 없습니다. 1자 이상 · 5000자 이하
21:9(1536 x 640)부터 9:21까지 약 100만 화소의 형태 9가지이며 기본값은 1:1입니다. 비율은 모양만 바꾸고 가격은 바꾸지 않습니다.
스타일 LoRA1/3

Mikkoani

Z-Image Base로 학습한 {path, scale} 항목을 최대 3개 넣습니다. scale은 0에서 4까지이며 1이 중립입니다. Turbo LoRA는 호환되지 않습니다. .safetensors 파일로 가는 공개 직접 링크를 쓰십시오. 3개 이하
출력 형식
JPEGPNGWebP
기본은 JPEG이며 필요하면 PNG나 WebP를 고릅니다. 형식은 가격에 영향이 없습니다.
시드
LoRA나 문장을 한 번에 하나씩 바꾸는 동안 이미지 세트를 비교할 수 있게 유지합니다. 매번 픽셀까지 똑같은 결과를 보장하지는 않습니다. 0 이상 · 2147483647 이하
안전 검사꺼짐

SpicyAPI는 이 모델에 안전 검사를 적용하지 않습니다. 프롬프트와 소재는 작성한 그대로 모델에 전달되며, 결과는 모델 자체가 결정합니다.

제출과 가격 계산을 열기 전에 계정을 확인하고 있습니다.

출력

실행 대기
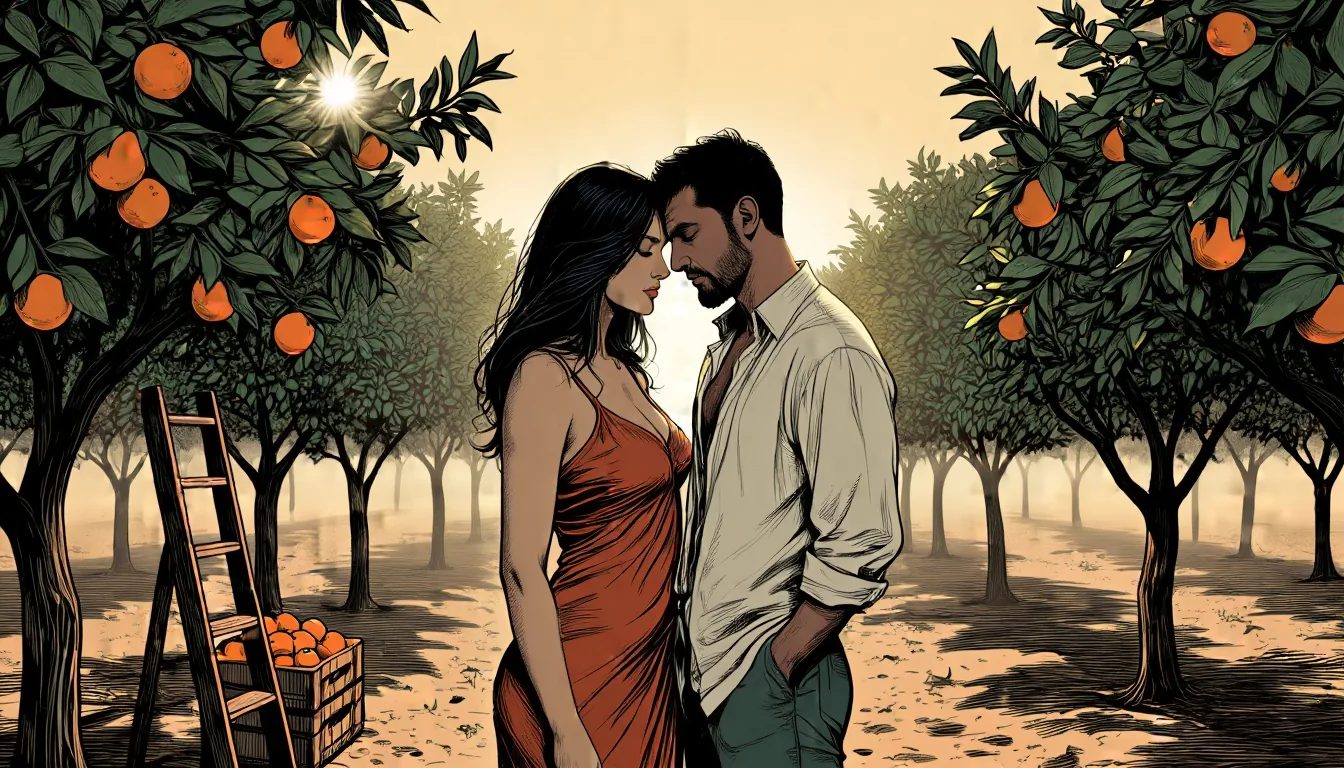
orange-grove-sunrise샘플 결과

관련 모델과 다음 단계

찾는 모델이 없나요?

필요한 모델과 쓰려는 목적을 알려 주세요. 다음에 무엇을 추가할지 정하는 팀에 바로 전달됩니다.

Z-Image Base용 LoRA를 실행하고, strength 다이얼로 사진의 화풍을 바꾸십시오

Z-Image Base LoRA는 알리바바 Tongyi-MAI의 파라미터 60억 개 파운데이션 모델 Z-Image Base에 최대 3개의 LoRA를 붙여 텍스트→이미지와 이미지→이미지로 실행합니다. Base는 커뮤니티가 학습에 쓰는 증류하지 않은 모델이어서 Turbo보다 느립니다. 텍스트→이미지는 9.8~56.7초(중앙값 32.8초), 편집은 4.9~41.7초(중앙값 16.8초)가 걸렸습니다. 프롬프트도 이미지도 걸러지지 않지만, 베이스 모델만으로는 '매우 강함' 단계를 잘 그리지 못하며 그런 용도로 학습된 LoRA가 따로 있습니다.

플레이그라운드 열기
Z-Image Base용 LoRA를 실행하고, strength 다이얼로 사진의 화풍을 바꾸십시오
요청당 LoRA
최대 3개, 각각 {path, scale}, 파일은 Turbo가 아니라 Z-Image Base로 학습된 것이어야 함
편집 strength
0~1, 기본값 0.7, 약 0.6은 LoRA로 화풍 변환, 0.75는 장면을 다시 연출
크기
한 변 최대 1536의 9가지 화면비, 편집은 긴 변 1k 또는 1.5k, 원본의 화면비 유지
속도
텍스트→이미지는 36회 중앙값 32.8초, 편집은 28회 중앙값 16.8초
가격
이미지당 단일 가격으로 과금, 크기·원본 이미지·LoRA 개수는 가격을 바꾸지 않음
제공하지 않는 항목
스텝, guidance, 네거티브 프롬프트, 엔드포인트에 해당 필드 없음
올바른 베이스 모델
다른 모델용 LoRA는 오류 없이 실패합니다Z-Image Turbo로 학습한 LoRA를 Base에 불러오자 이미지가 노이즈와 가짜 글자로 무너졌습니다. Pony LoRA와, 다른 키 형식으로 저장된 Z-Image 표기의 파일은 둘 다 로드되었지만 아무것도 바꾸지 못했습니다. Base로 학습된 파일을 쓰고, 먼저 있을 때와 없을 때를 한 쌍으로 돌려 보십시오.
편집의 한계
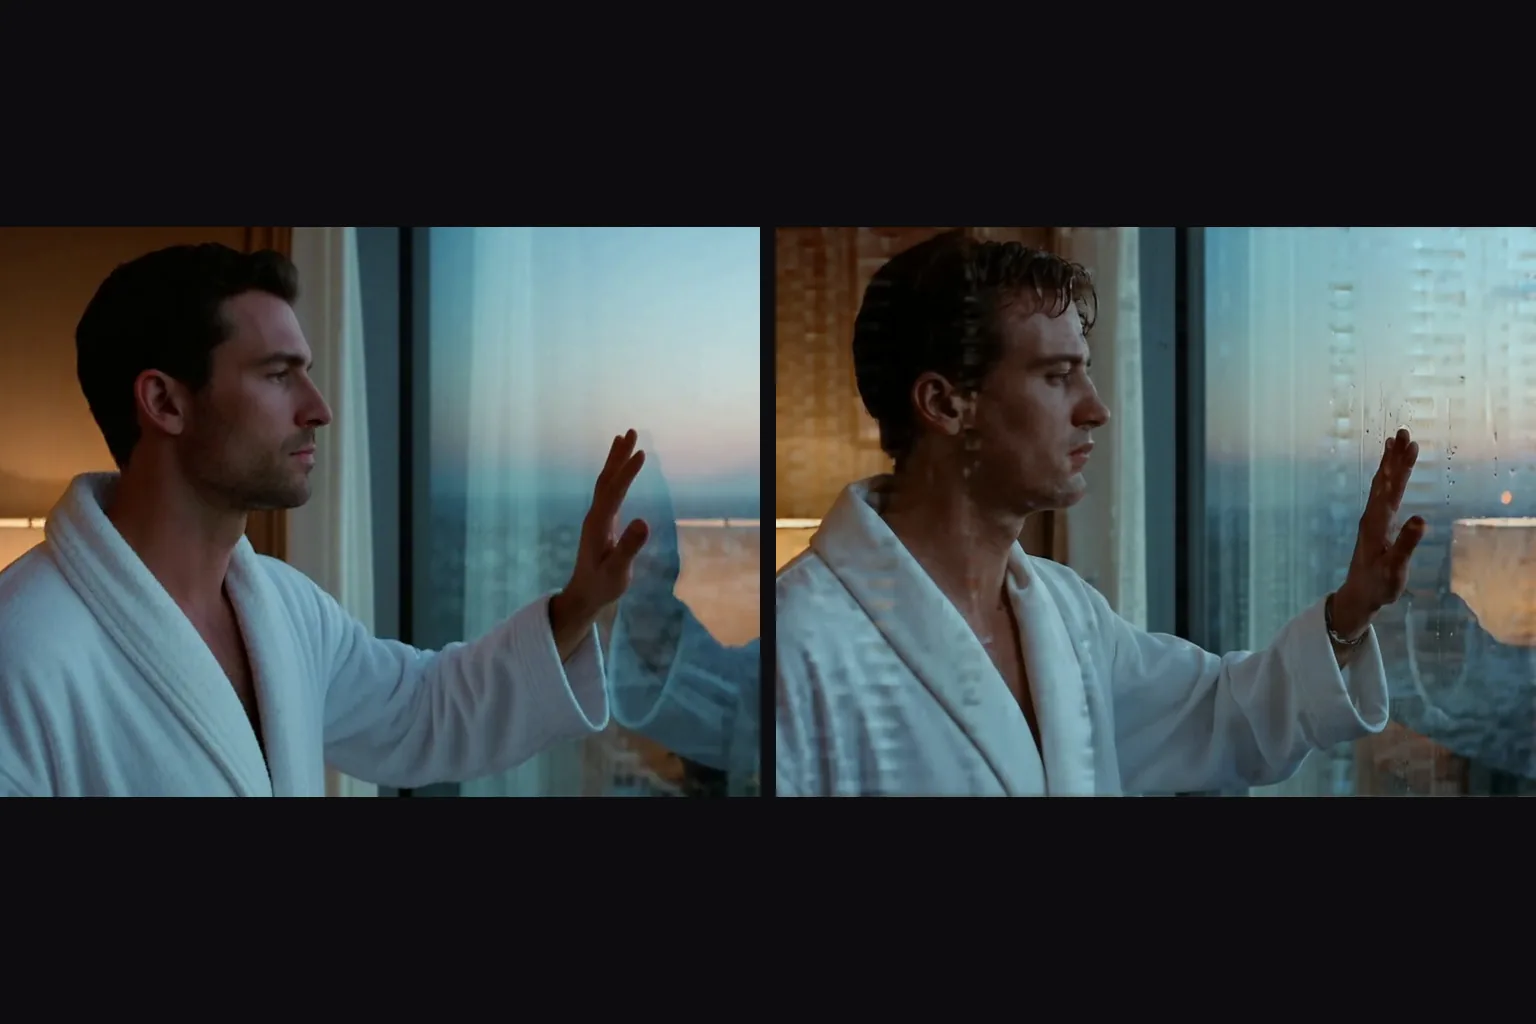
편집은 프레임을 다시 그릴 뿐 지시를 따르지 않습니다LoRA 없이 strength 0.65와 0.8에서 흑백을 요청해도 컬러 그대로였고, 0.7과 0.8에서 턱시도를 요청해도 거의 달라지지 않았습니다. 원하는 그림 전체를 묘사하고, 룩을 바꾸고 싶다면 스타일 LoRA를 쓰십시오.
솔직한 한계
콘텐츠 한 단계만 수위가 낮아져 나옵니다모델 앞에 콘텐츠 필터는 없으며, 두 엔드포인트 모두에서 저희 5단계 콘텐츠 테스트는 '매우 강함'을 제외한 모든 단계(최대 포함)를 렌더링했습니다. '매우 강함'은 세 번 시도해도 수위가 낮아져 돌아왔습니다. 베이스 모델은 이를 단독으로는 설득력 있게 그리지 못하며, 그런 용도로 학습된 LoRA가 있는 이유가 바로 이것입니다.

Z-Image Base LoRA 활용법

사진 프롬프트는 평범한 문장으로 쓰십시오

사진 프롬프트는 평범한 문장으로 쓰십시오

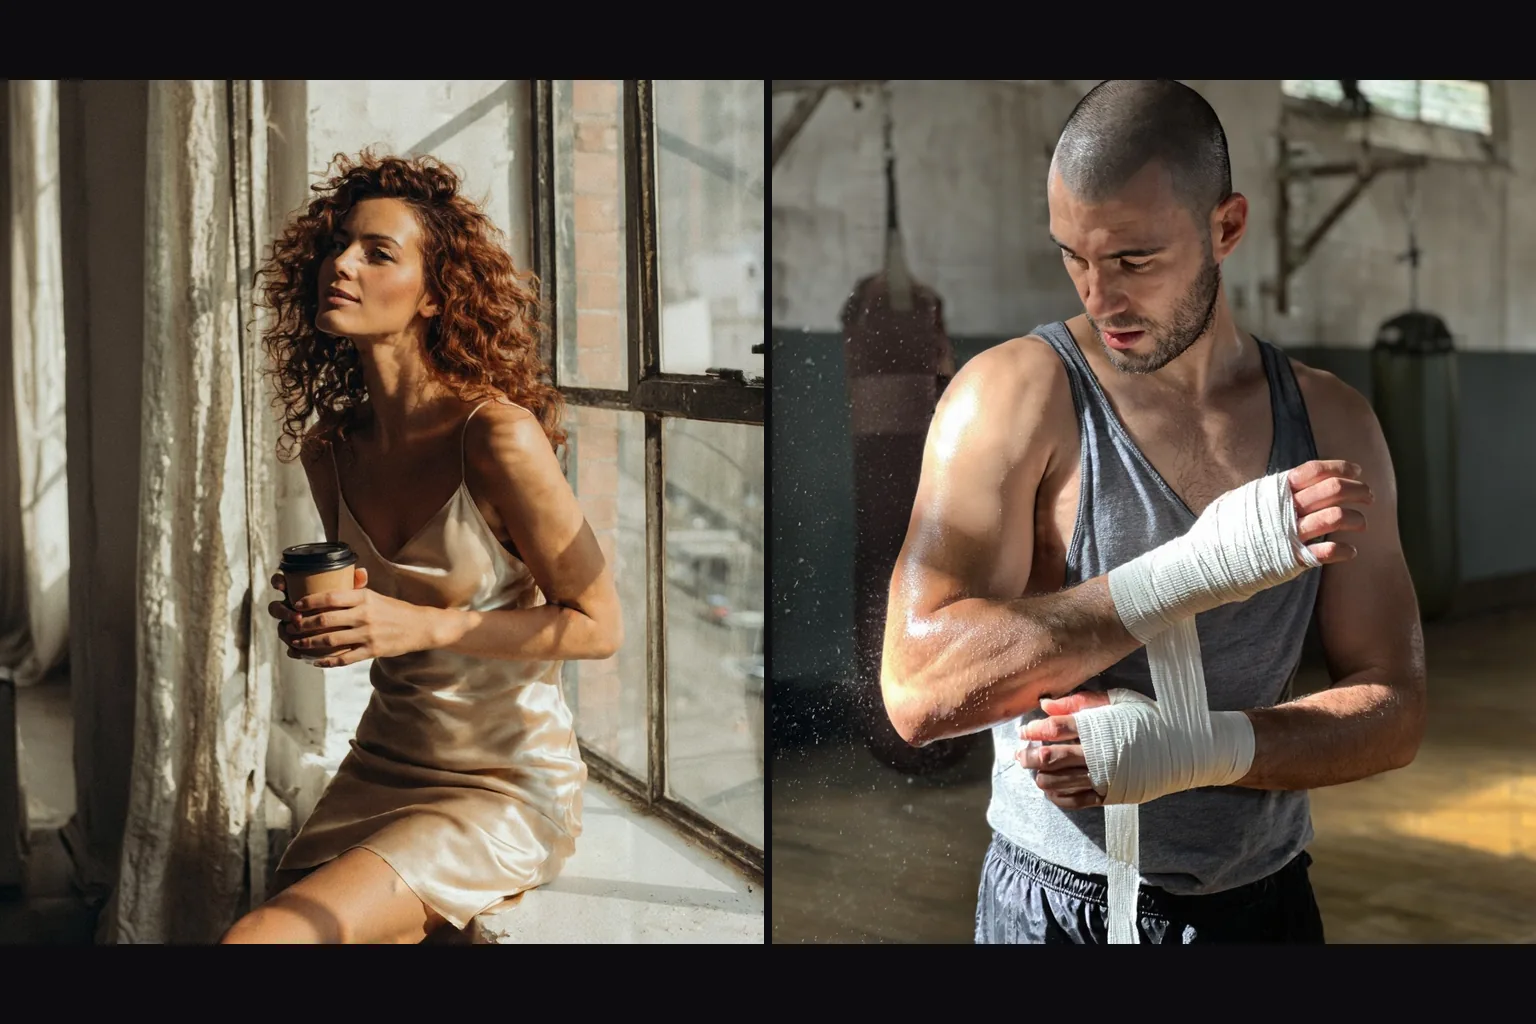
프롬프트 충실도가 높으므로, 사진가에게 의뢰하듯 사진을 묘사하십시오. 피사체, 옷, 장소, 빛, 그레인입니다. 저희 로프트와 헬스장 인물 컷은 각각 한 문장에서 나왔습니다. 같은 문장 구조에 피사체만 바꾸면 시리즈 전체를 만들 수 있습니다.

Base로 학습된 LoRA를 쓰십시오

Base로 학습된 LoRA를 쓰십시오

Z-Image Base로 학습된 LoRA는 0.5와 1에서 모두 작동했습니다. mikkoani 일러스트 LoRA는 프롬프트 맨 앞에 ‘mature illustration with muted color and complex linework’ 문구를 넣으면 켜지며, 파일 없이 이 문구만 써도 사진 프롬프트가 일러스트 쪽으로 기울었습니다.

  • 프롬프트를 고치기 전에 strength를 고르십시오

    편집에서는 strength가 원본이 얼마나 남을지를 정합니다. 저희 단계 테스트에서 0.3과 0.5는 그림이 거의 그대로였고 0.6은 약간 바뀌었습니다. 0.7에서는 구도를 유지한 채 내용이 바뀌기 시작했고, 0.75는 빛과 팔레트를 유지하면서 장면의 포즈와 연출을 다시 짰으며, 0.85는 새 그림이 되었습니다. 스타일 LoRA와 함께 쓴 0.6은 구도를 그대로 유지한 채 프레임 전체의 화풍을 바꾸었습니다.

  • 지시가 아니라 화풍 변환을 기대하십시오

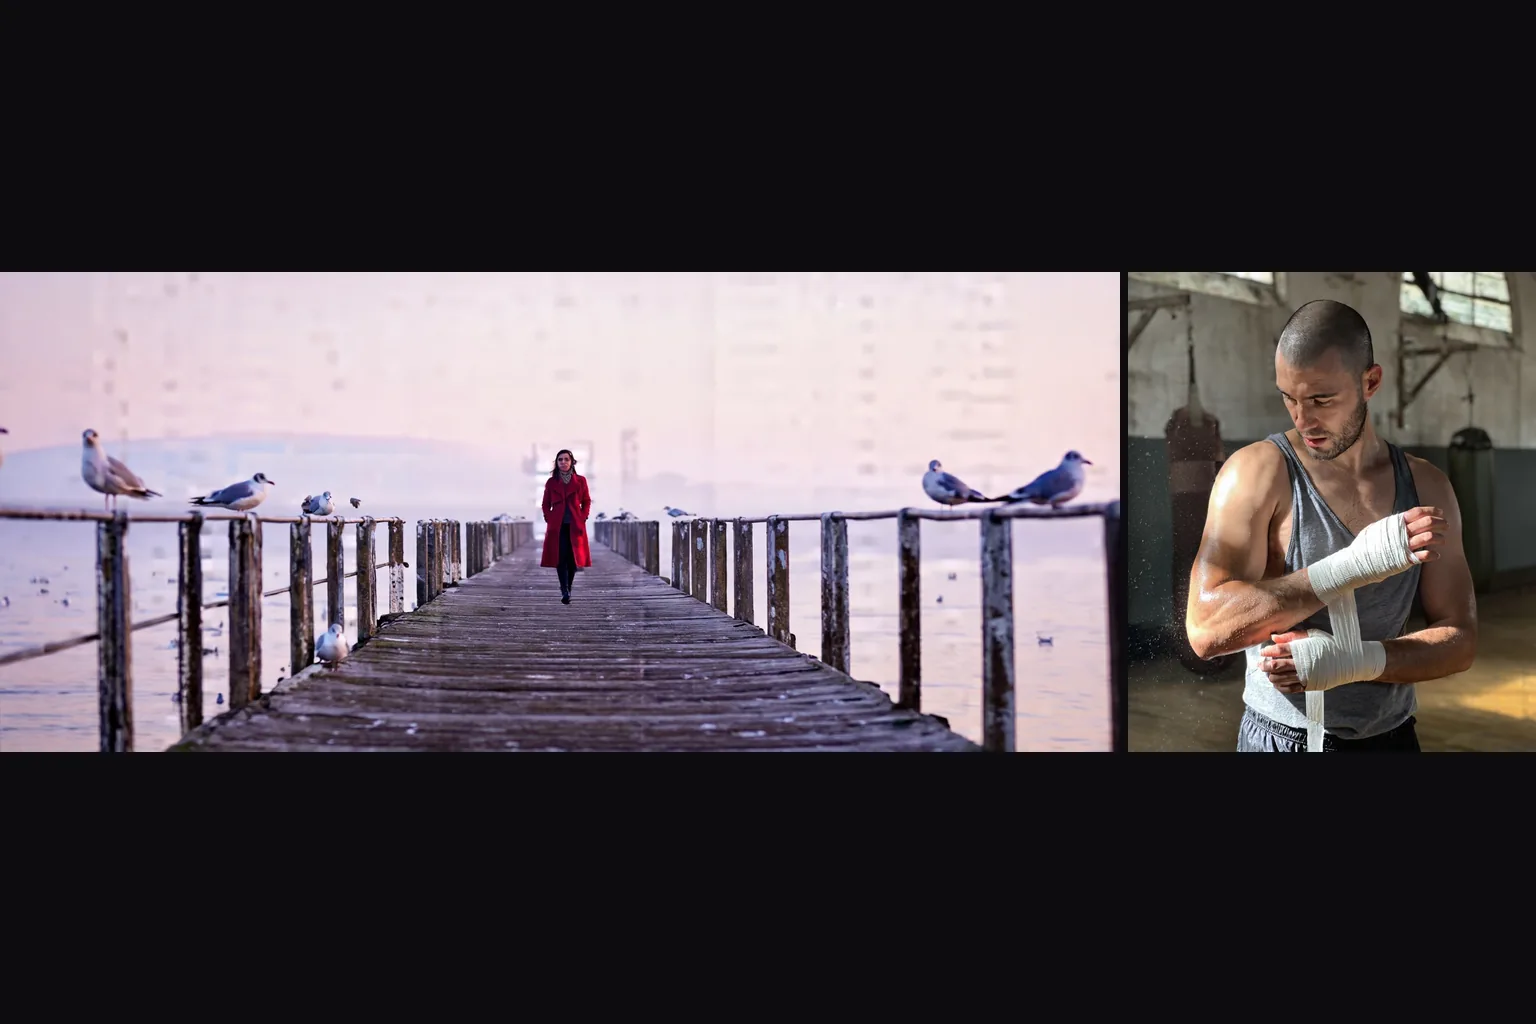
    편집 모델은 사용자의 묘사로 프레임을 다시 그립니다. 저희 테스트에서 ‘Make it black and white’는 0.65와 0.8에서 컬러 그대로였고, 오른쪽 그림이 그것을 보여 줍니다. 매체를 바꾸려면 스타일 LoRA를, 다른 장면을 원하면 그 장면을 충분히 묘사하십시오.

  • 크기에 유의하십시오

    텍스트→이미지는 1:1의 1024×1024부터 21:9의 1536×640까지 9가지 화면비를 제공하며, 모두 요청한 크기 그대로 돌아왔습니다. 편집에서는 1k와 1.5k가 긴 변을 정하고 원본의 화면비가 유지됩니다. 2:3 사진은 1k에서 680×1024, 16:9 사진은 1.5k에서 1536×856으로 돌아왔습니다.

Z-Image Base LoRA를 쓰는 사람들

  • 텍스트로 만드는 차분한 색감과 선이 많은 일러스트

    일러스트레이터와 콘셉트 아티스트

    텍스트로 만드는 차분한 색감과 선이 많은 일러스트

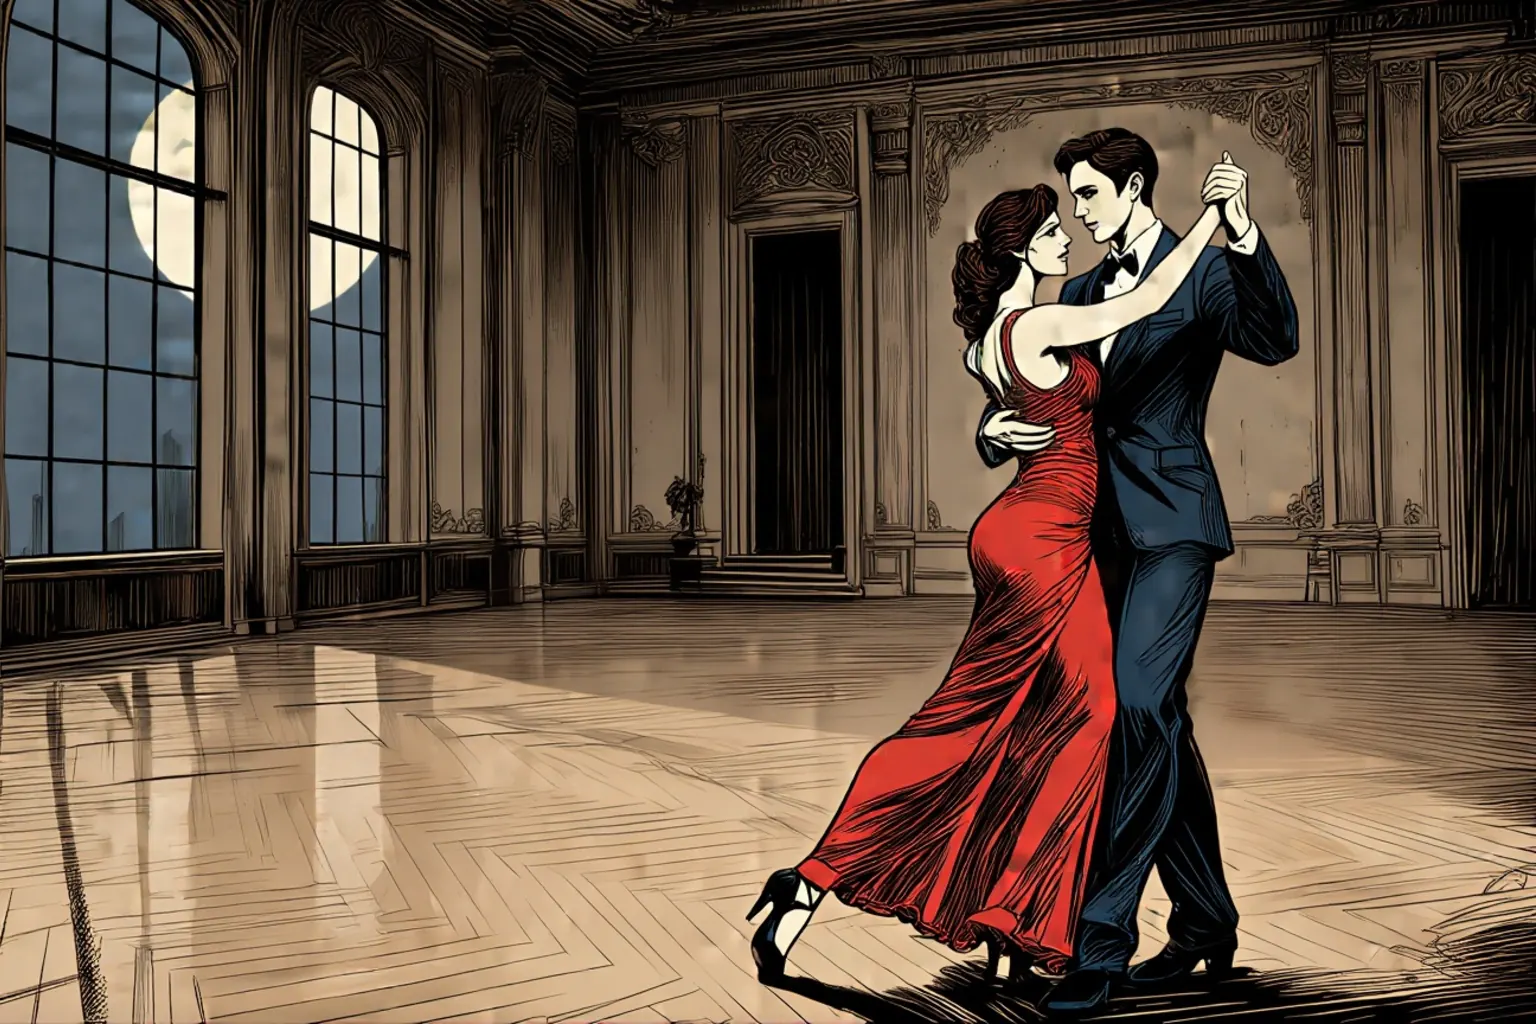
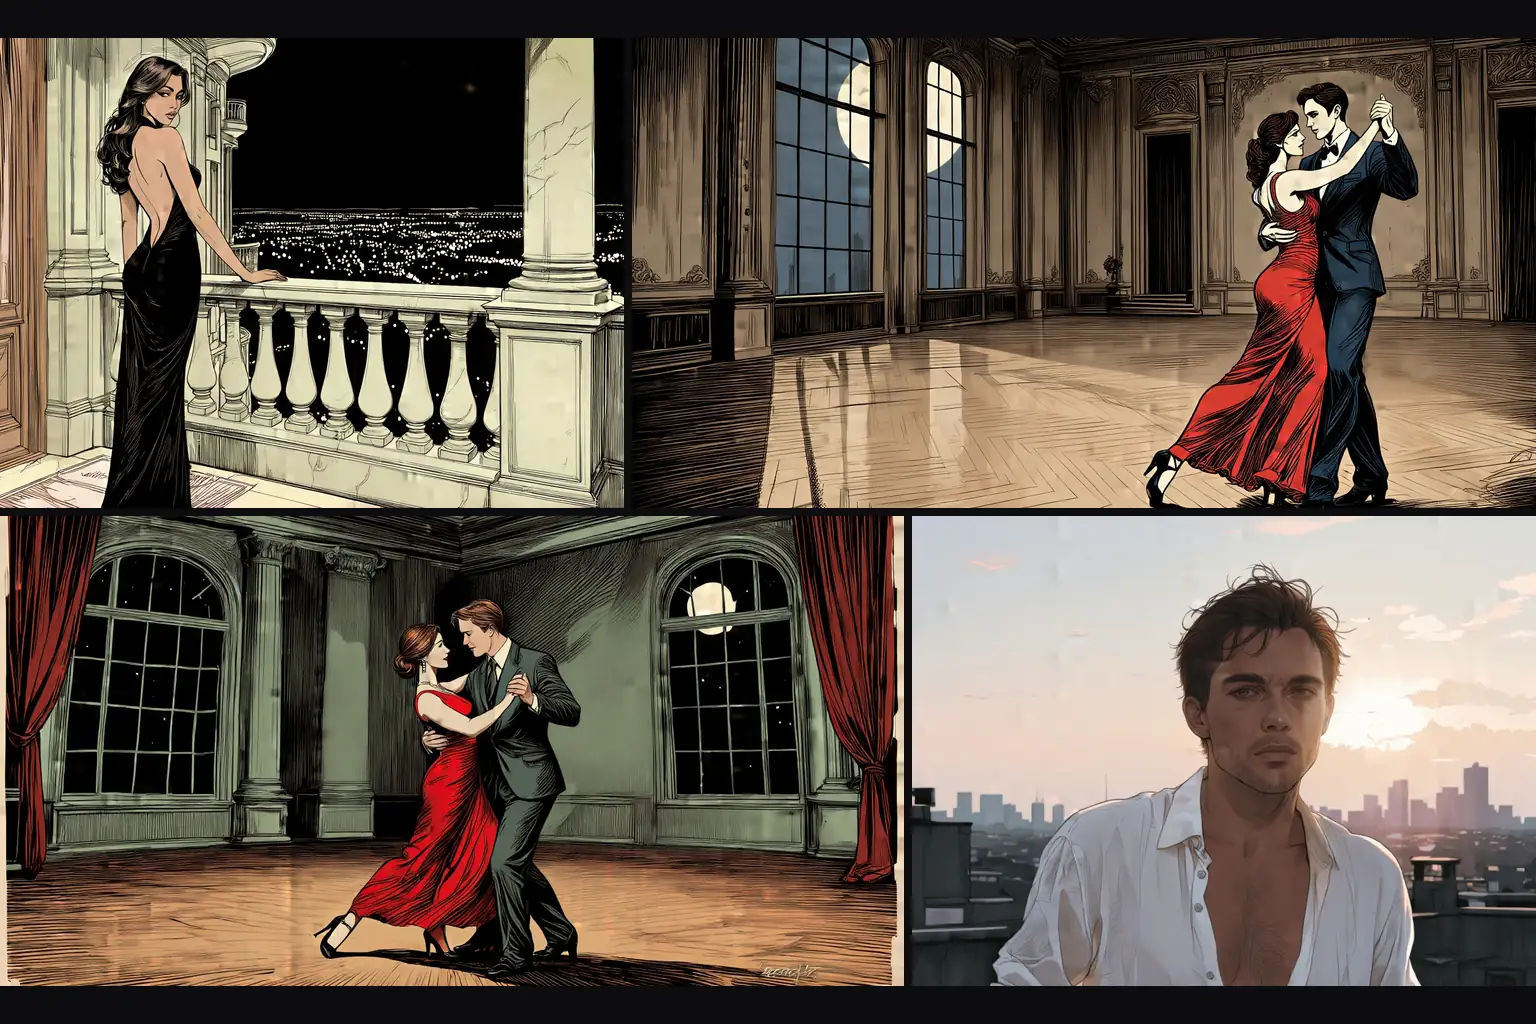
    mikkoani LoRA를 1로 쓰자 무도회장의 댄스, 밤의 발코니, 달빛이 드는 홀의 커플 프롬프트가 모두 잉크 선과 차분한 색감의 일러스트로 돌아왔습니다. 문구를 맨 앞에 두고 장면은 문장으로 쓰십시오.

  • 사진을 일러스트로 바꾸기

    사진가와 리터처

    사진을 일러스트로 바꾸기

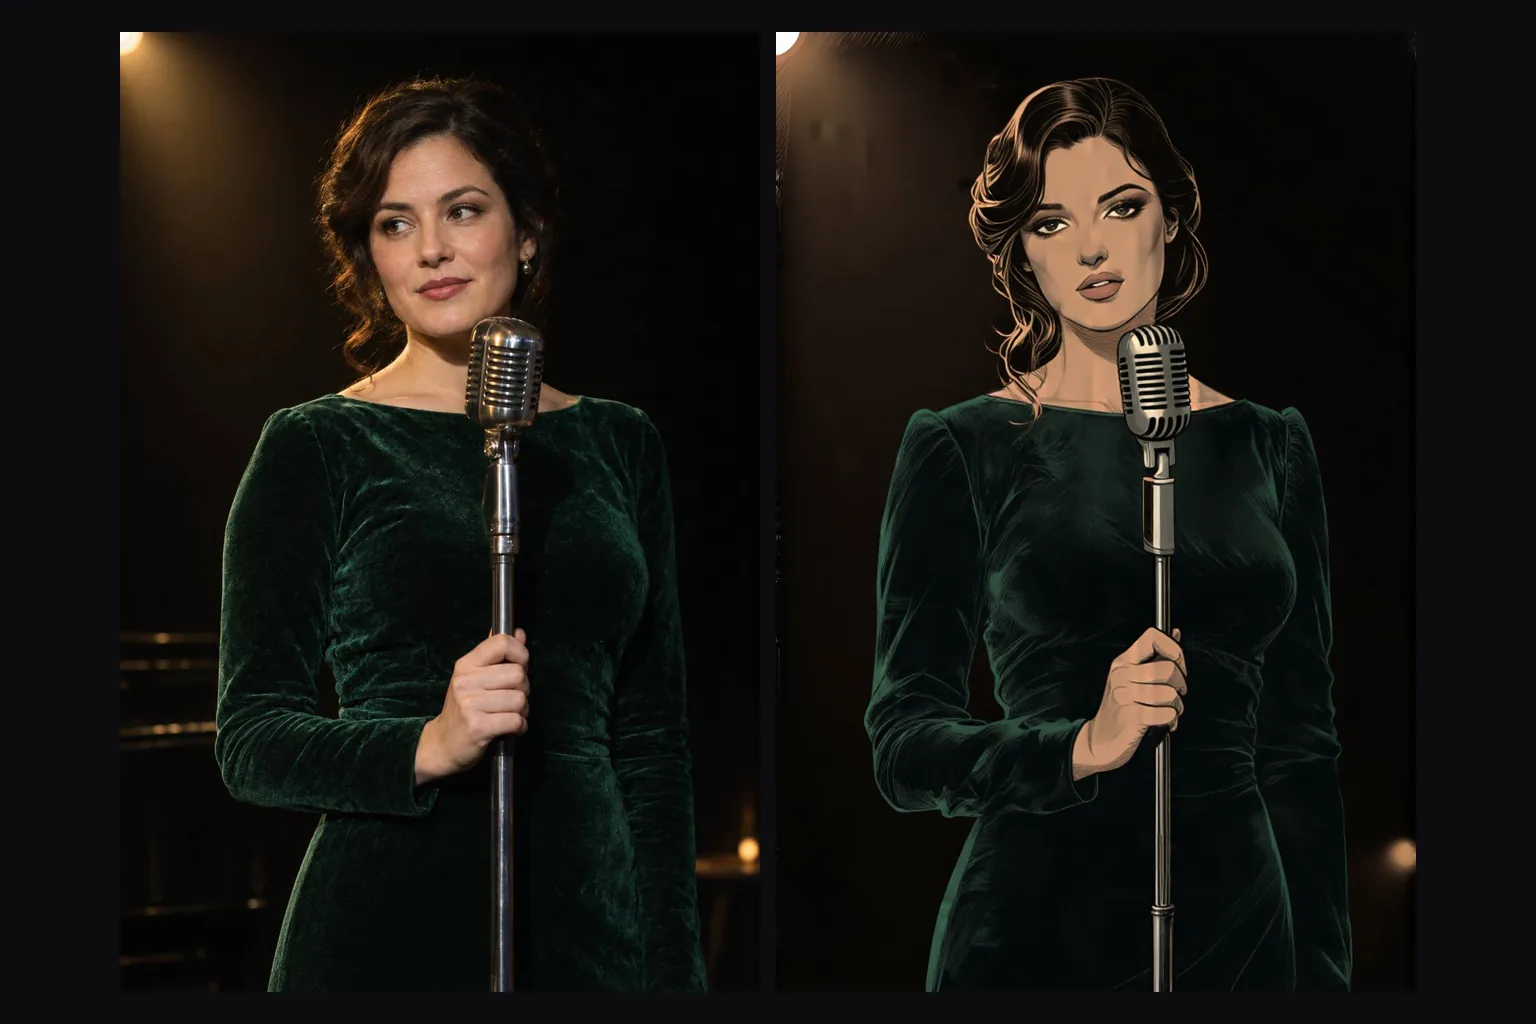
    왼쪽은 초록 벨벳 드레스를 입은 가수의 원본 사진이고, 오른쪽은 mikkoani LoRA를 strength 0.6으로 적용한 편집 결과입니다. 포즈, 마이크, 프레이밍은 그대로이고 렌더링만 그림으로 바뀌었습니다.

  • 변형을 얼마나 멀리 보낼지 고르기

    소셜·캠페인 팀

    변형을 얼마나 멀리 보낼지 고르기

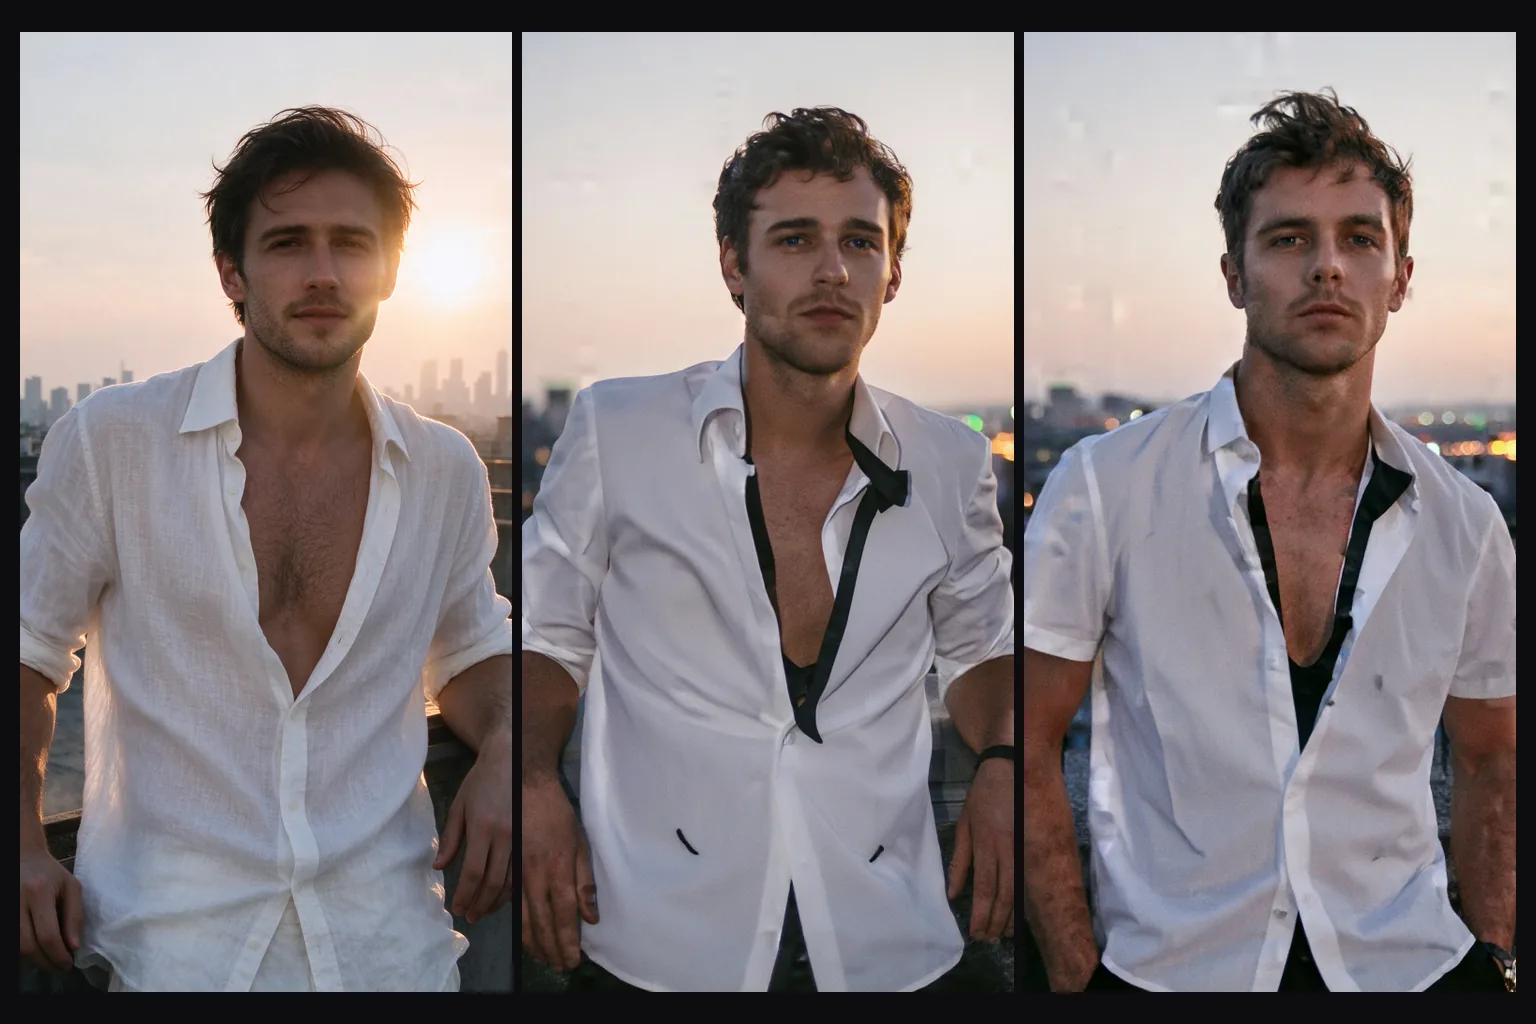
    저희 옥상 인물 컷을 LoRA 없이 0.7과 0.8에서 턱시도를 요청하며 편집했더니 거의 달라지지 않았고 구도는 유지되었습니다. strength를 변형의 다이얼로 쓰고, 더 강한 값은 다른 프레임을 원할 때를 위해 아껴 두십시오.

  • 1536픽셀의 와이드 21:9 장면

    시네마틱·배경화면 제작자

    1536픽셀의 와이드 21:9 장면

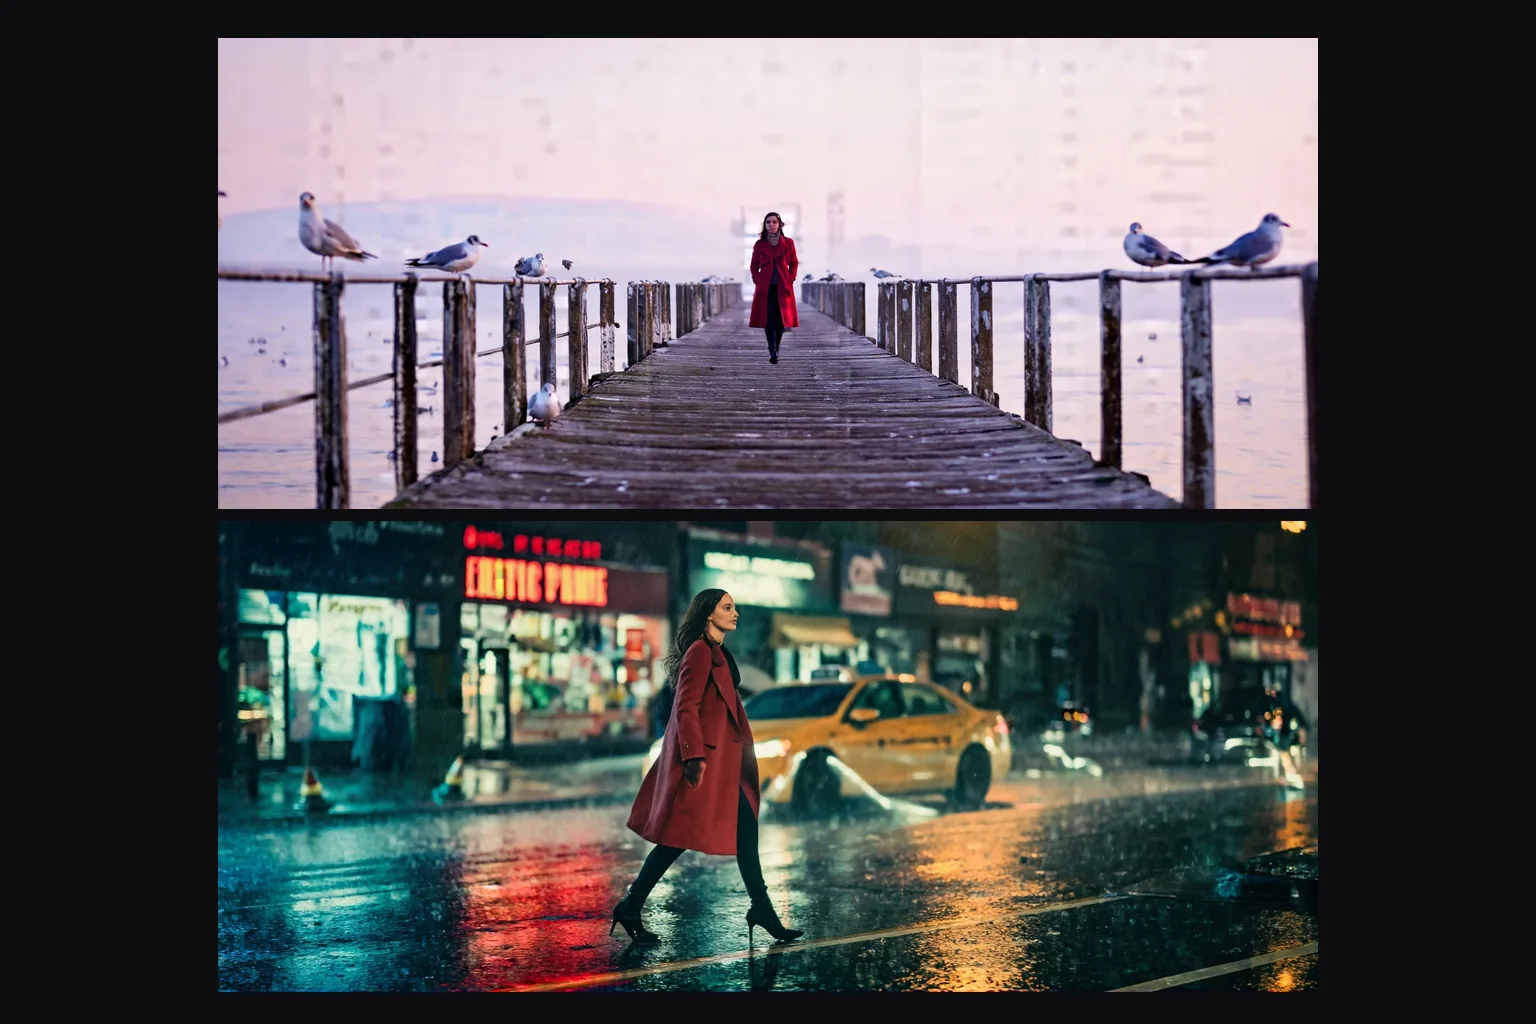
    새벽 안개 낀 부두의 붉은 코트 여성과 비 오는 네온 거리의 같은 여성이 모두 LoRA 없이 21:9(1536×640)로 평범한 문장에서 나왔습니다. 와이드 화면비는 나중에 자르는 것이 아니라 프롬프트의 일부입니다.

Z-Image Base LoRA로 첫 프롬프트부터 완성된 편집까지

  1. 평범한 문장 프롬프트로 시작하십시오

    게시할 화면비로 LoRA 없이 먼저 텍스트→이미지를 돌려, 베이스 모델이 무엇을 내놓는지 확인하십시오.

  2. Base로 학습된 LoRA를 추가하십시오

    .safetensors 파일의 직접 다운로드 링크를 복사하고, 같은 seed에서 파일이 있을 때와 없을 때를 돌려 보십시오.

  3. scale을 확인하십시오

    0.5와 1을 시험해 보고, 피사체를 압도하지 않으면서 룩이 드러나는 값을 유지하십시오.

  4. strength를 단계적으로 올리며 편집하십시오

    loras 배열과 함께 원본 이미지를 보내고 0.6에서 시작하십시오. 장면을 다시 연출하고 싶다면 0.7과 0.75를 쓰십시오.

  5. 결과 전체를 묘사하십시오

    모델은 프레임 전체를 다시 그리므로, 바뀌는 부분만이 아니라 그림 전체를 쓰십시오.

그대로 복사해 쓰기 좋은 Z-Image Base LoRA 프롬프트

  • 평범한 문장으로 쓴 사진

    LoRA 없이 2:3 세로 화면비입니다.

    A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.
  • 차분한 색감의 일러스트

    mikkoani LoRA를 scale 1, 16:9 화면비로 쓰며, 문구는 맨 앞에 둡니다.

    mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.
  • 사진을 손으로 그린 선화로

    mikkoani LoRA를 scale 1, strength 0.6으로 쓰는 편집 엔드포인트용입니다. 바뀌는 부분만이 아니라 그림 전체를 묘사하십시오.

    mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.

Z-Image Base LoRA에 대한 추가 질문

Base 모델 실험실로 쓰십시오

평범한 문장 프롬프트로 시작하고, Base로 학습된 LoRA를 더한 뒤 있을 때와 없을 때를 한 쌍으로 돌려 확인하십시오.

편집에서는 strength를 0.6부터 올리며 결과 전체를 묘사하십시오. 파일이 아무것도 바꾸지 못하거나 그림을 망가뜨린다면 다른 모델용으로 학습된 것입니다.