소개
텍스트 설명, 가중치 파일 직접 URL, 각 scale로 스타일 요청을 구성합니다. 선택 사항인 seed는 연결한 파일의 효과를 평가하는 데 도움이 됩니다.
| 항목 | 값 |
|---|---|
| 입력 | 텍스트 |
| 출력 | 이미지 |
| 지원 작업 | 텍스트 이미지 생성과 이미지 편집, 정지 이미지 |
| 모델 계열 | LoRA 연결을 지원하는 MiniMax H3-Image 오픈웨이트 |
| LoRA 파일 연결 | 직접 .safetensors 파일 URL 최대 3개 |
| LoRA 강도 | 파일별 0~4, 기본 1 |
| 프롬프트 길이 | 필수, 최대 5,000자 |
| 해상도 메뉴 | 1k, 1.5k, 2k, 3k, 4k, 기본 1k |
| 캔버스 선택 | 화면비 15가지, 텍스트 생성 기본 1:1 |
| 편집용 입력 | 1~9장, 편집 원본 뒤에 참조 최대 8장 |
| 참조 표기법 | 업로드 순서에 따라 <Picture 1>, <Picture 2> 이후 번호 |
| 출력 형식 | 기본 jpeg, png와 webp도 가능 |
| 비교 제어 | 선택 seed, 동일 출력 보장 없이 단일 변경 비교 지원 |
| 테스트한 출력 치수 | 1.5k 9:16: 1152 x 2048; 4k 16:9: 5472 x 3072 |
핵심 기능 및 하이라이트
캠코더 표현으로 본 네온빛
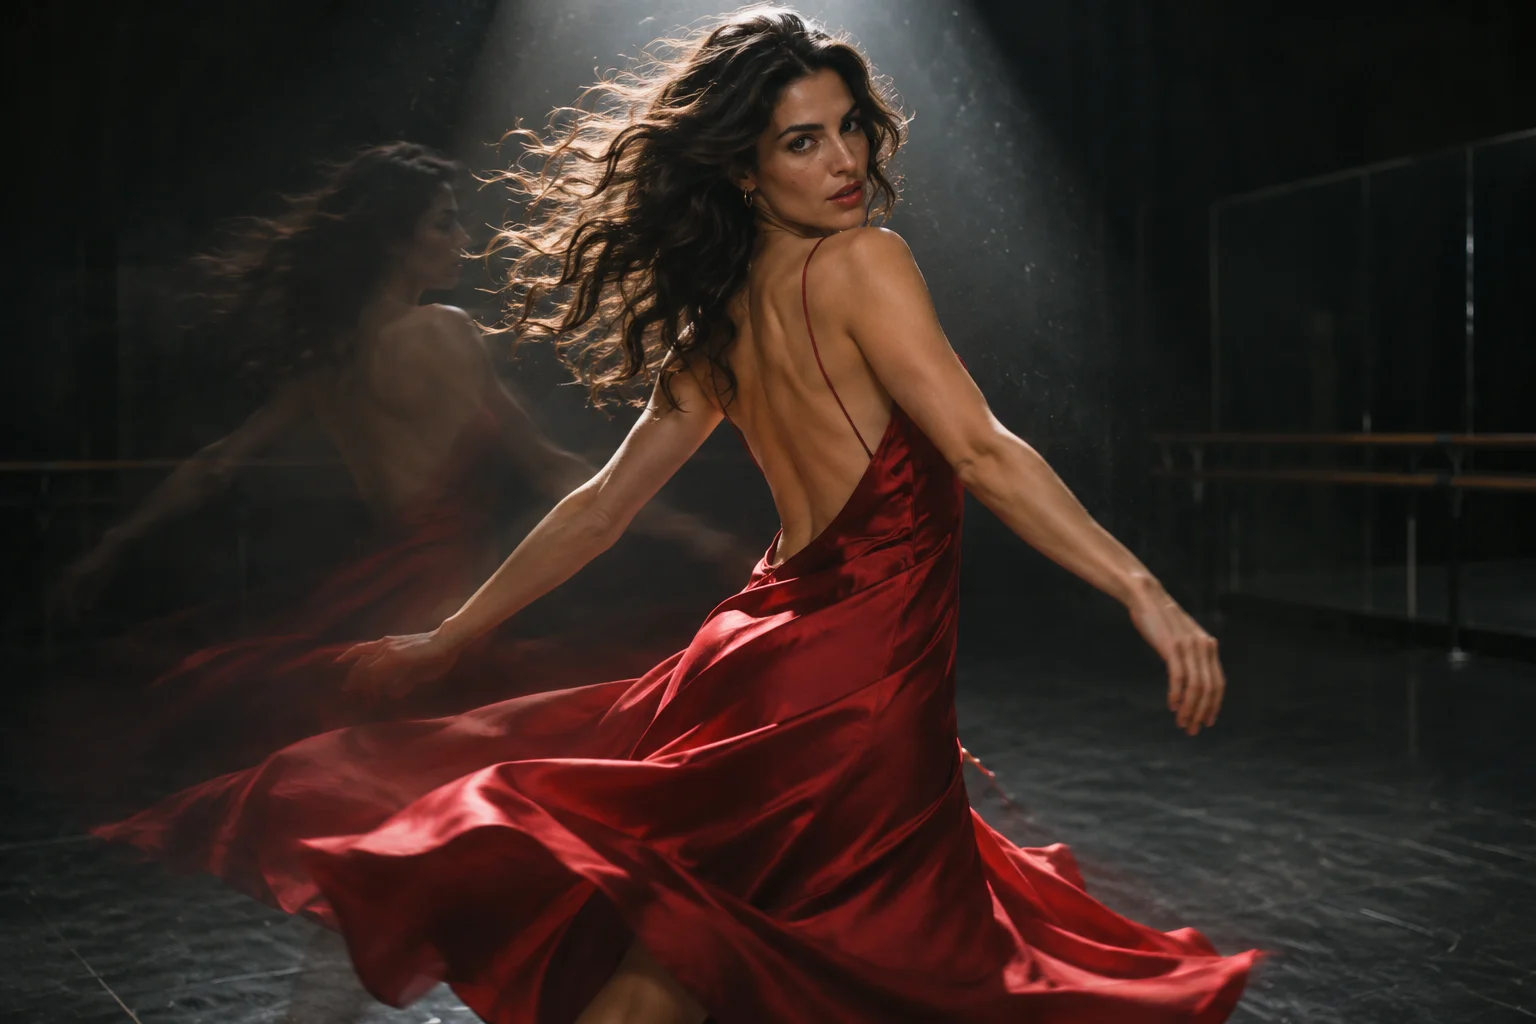
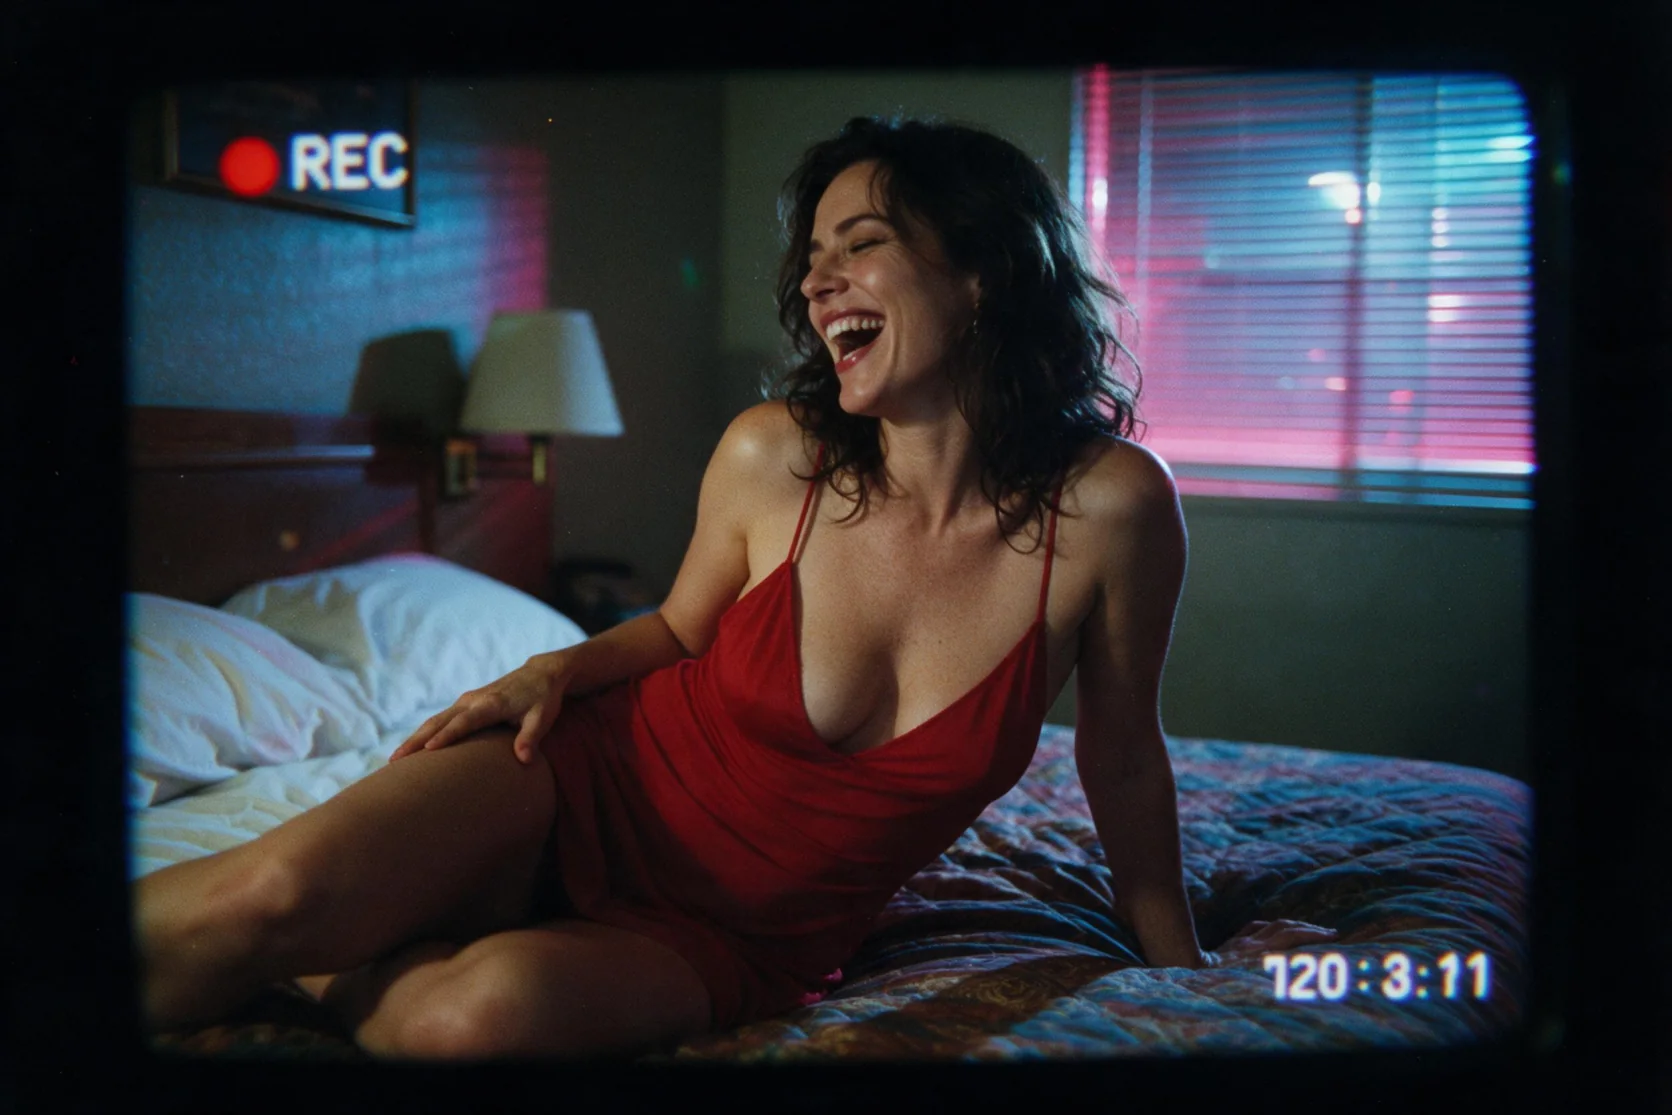
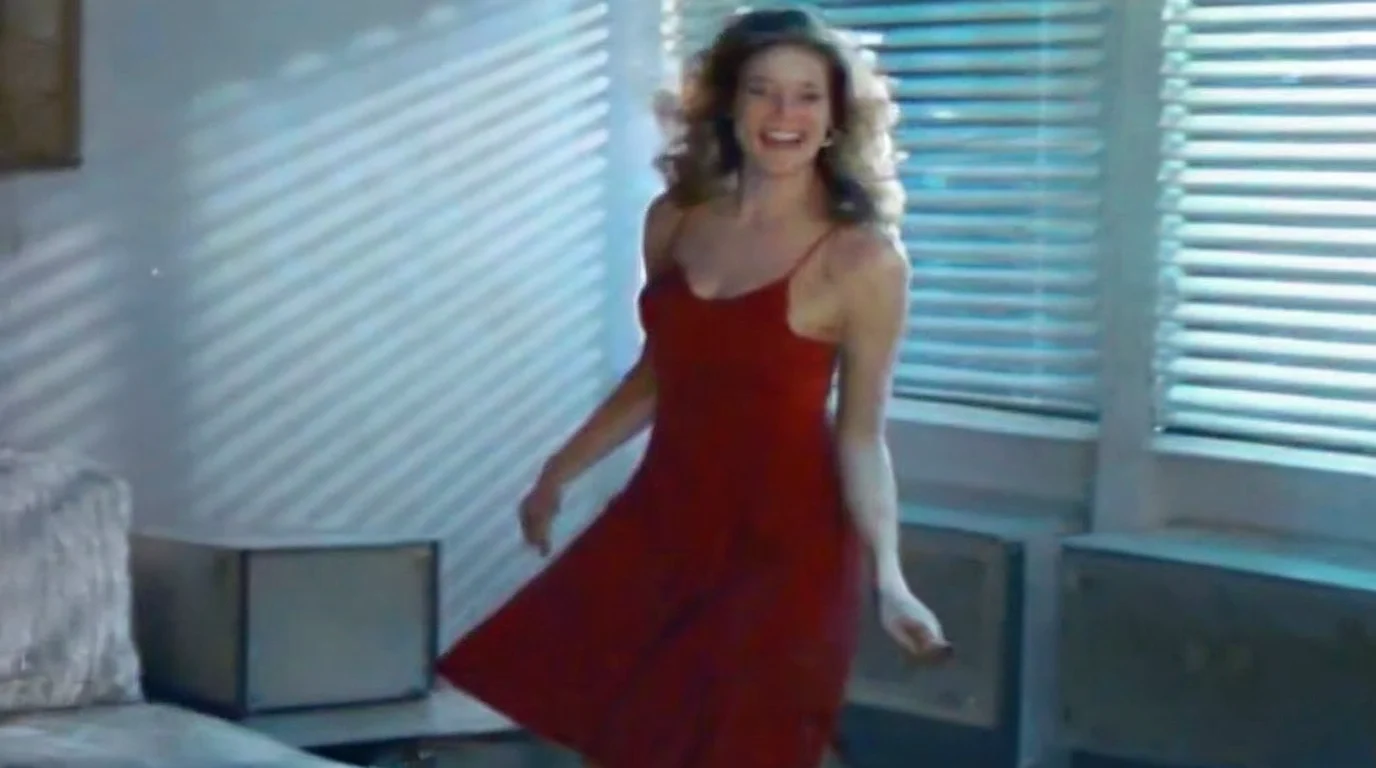
새 1k, 16:9 샘플에는 빨간 슬립 드레스 차림의 여성이 모텔 방에서 춤추는 모습이 보입니다. vh5tape와 scale 1의 VHS LoRA가 화면 전체에 부드러운 1990년대 홈비디오 느낌을 적용했습니다.
테이프 표현과 함께 따라오는 글자
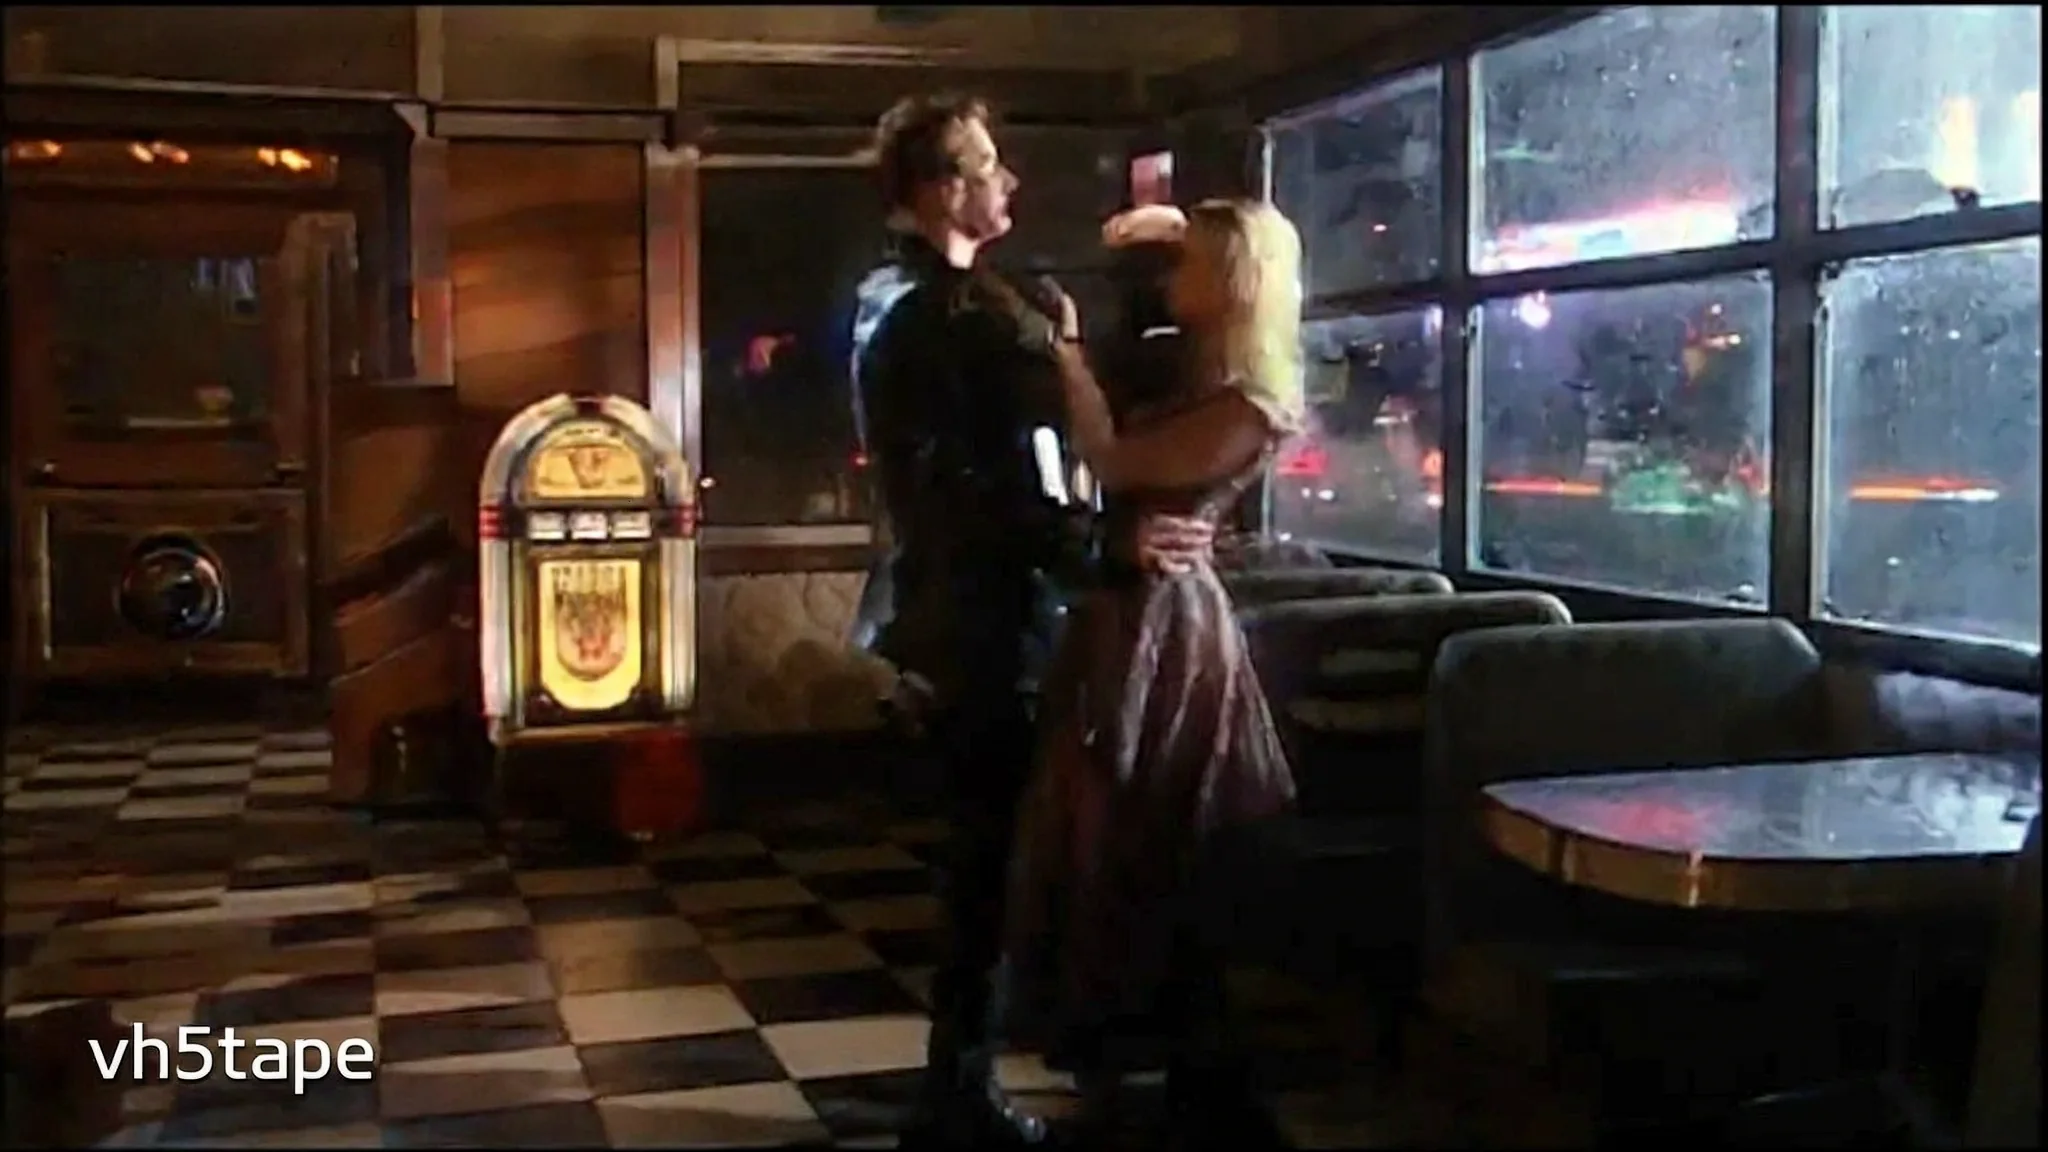
식당의 춤에는 녹화 입자와 왼쪽 아래 vh5tape 글자가 있습니다. 출력 선택 전 의도한 스타일뿐 아니라 글자도 살펴봐야 하는 가시적인 흔적입니다.
부드러운 녹화 화면의 레이싱 게임기
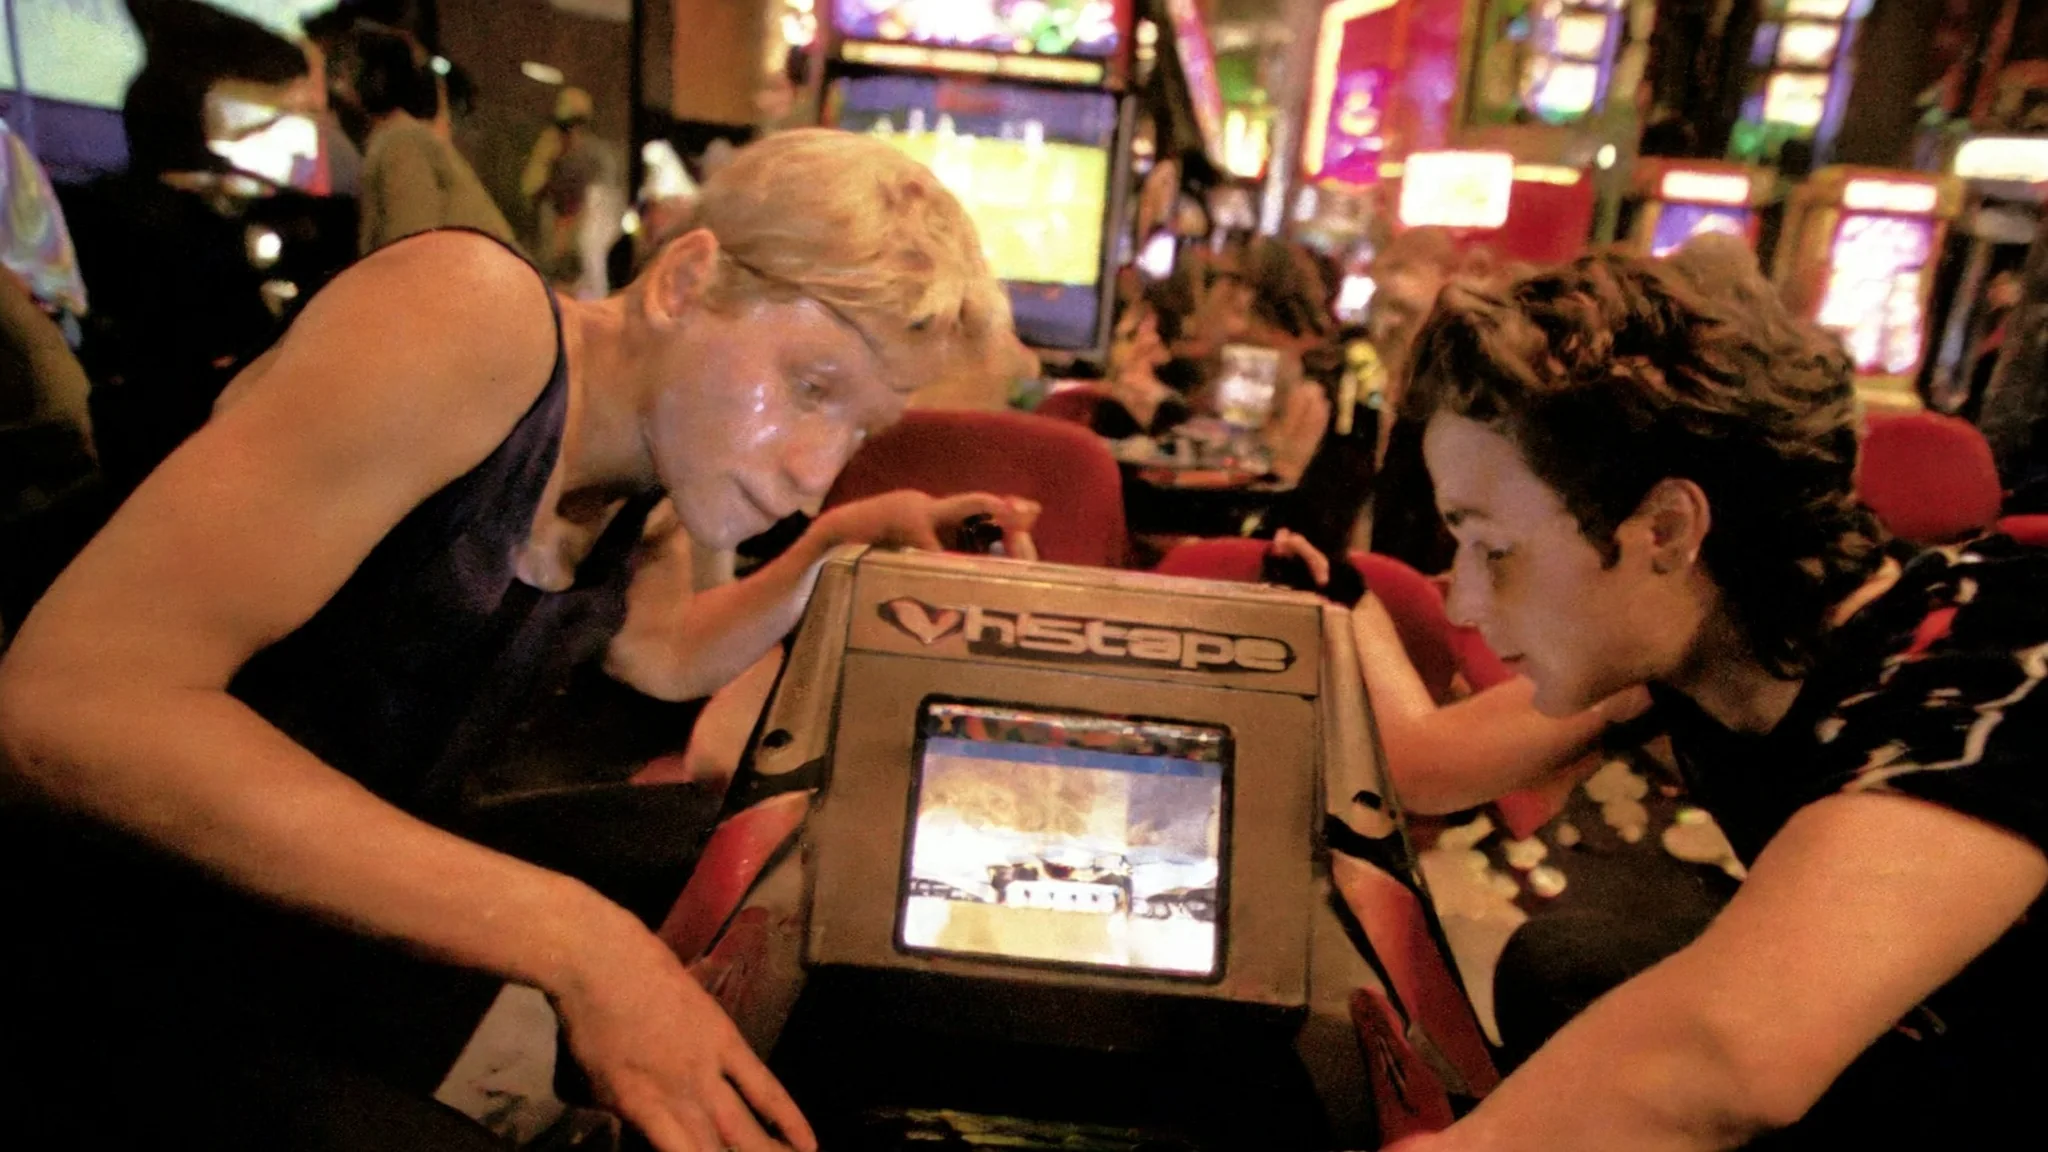
아케이드 예시는 네온빛 속 두 플레이어에 VHS 표현을 적용합니다. 어댑터가 인물과 주변의 외형을 바꾸는 방식을 판단할 두 번째 장면입니다.
항구를 다시 그리는 방식
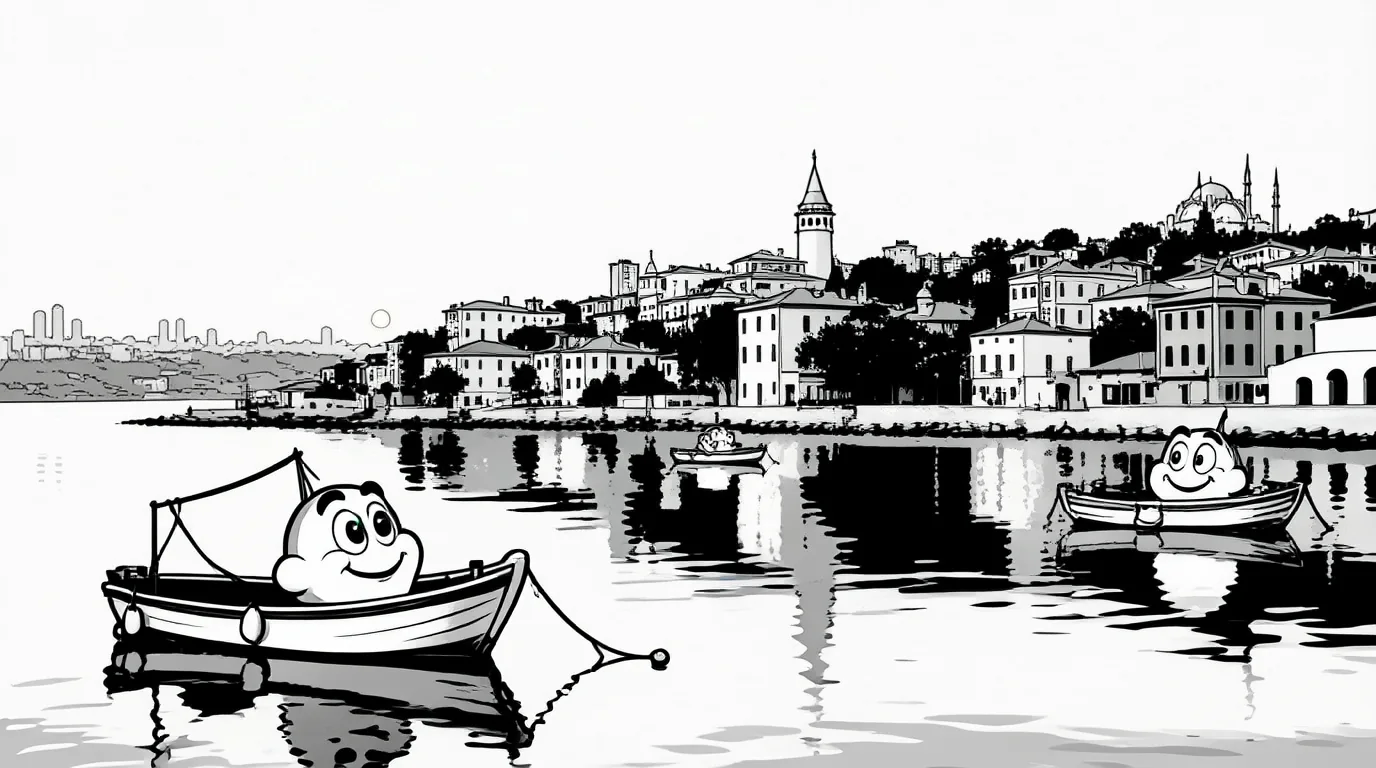
Studio1939 스타일 편집은 항구를 러버호스 만화 보트가 있는 흑백 그림으로 다시 그렸습니다. 이 샘플에서는 도시 윤곽 배치를 알아볼 수 있게 유지했습니다.
요청 파라미터
| 파라미터 | 필수 | 설명 |
|---|---|---|
prompt | 예 | 필수 설명은 최대 5,000자입니다. 가중치 파일의 트리거 단어를 먼저 쓰고 장면을 이어 적습니다. 1자 이상 · 5000자 이하 |
aspect_ratio | 아니요 | 생성 시 선택 가능한 화면비는 1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9입니다. 생성 기본값은 1:1이며 화면비를 선택해도 요금은 달라지지 않습니다. |
resolution | 아니요 | 스타일 생성의 기본 단계는 1k입니다. 더 높은 요금의 1.5k, 2k, 3k, 4k도 선택할 수 있습니다. |
loras | 아니요 | 선택 사항으로 {path, scale} 항목을 최대 3개 받습니다. Hugging Face /resolve/main/ 링크 같은 .safetensors 파일 직접 URL을 사용합니다. 기본값: |
output_format | 아니요 | png나 webp를 선택하지 않으면 정지 이미지는 jpeg로 인코딩됩니다. 인코딩은 가격에 영향을 주지 않습니다. |
seed | 아니요 | 선택 사항인 seed로 LoRA 적용·해제 결과를 비교합니다. 고정 기본값이나 수치 제한은 명시하지 않습니다. |
요금
완성된 정지 이미지에는 선택한 오픈웨이트 단계 요금에 고정 LoRA 추가 요금이 더해집니다. 파일을 연결하지 않아도 적용됩니다. 파일 1개와 3개의 추가 요금은 같으며 실패한 요청에는 요금이 없습니다.
| 사양 | 요금 |
|---|---|
| $0.042 / 장 |
| $0.054 / 장 |
| $0.066 / 장 |
| $0.114 / 장 |
| $0.162 / 장 |
활용 사례
네온 모텔 장면 구상
빨간 드레스 모텔 예시는 scale 1의 VHS LoRA로 밤의 춤을 부드러운 캠코더풍 정지 이미지로 바꿉니다. 테이프 시대 무드 보드에서 전체 화면의 표현을 참고합니다.
기존 사진의 스타일 변경
1930년대 만화 LoRA는 자세를 유지하며 사진을 러버호스 만화로 바꿨습니다. 항구 예시는 도시 윤곽 배치를 유지하는 관련 편집을 보여 줍니다.
확대 전에 어댑터 비교
seed와 장면 설명을 유지하며 LoRA를 켜고 끕니다. VHS 비교에서 질감뿐 아니라 프레이밍도 바뀌었으므로 더 큰 해상도를 고르기 전 둘 다 평가합니다.
인물 사진의 장소 재구성
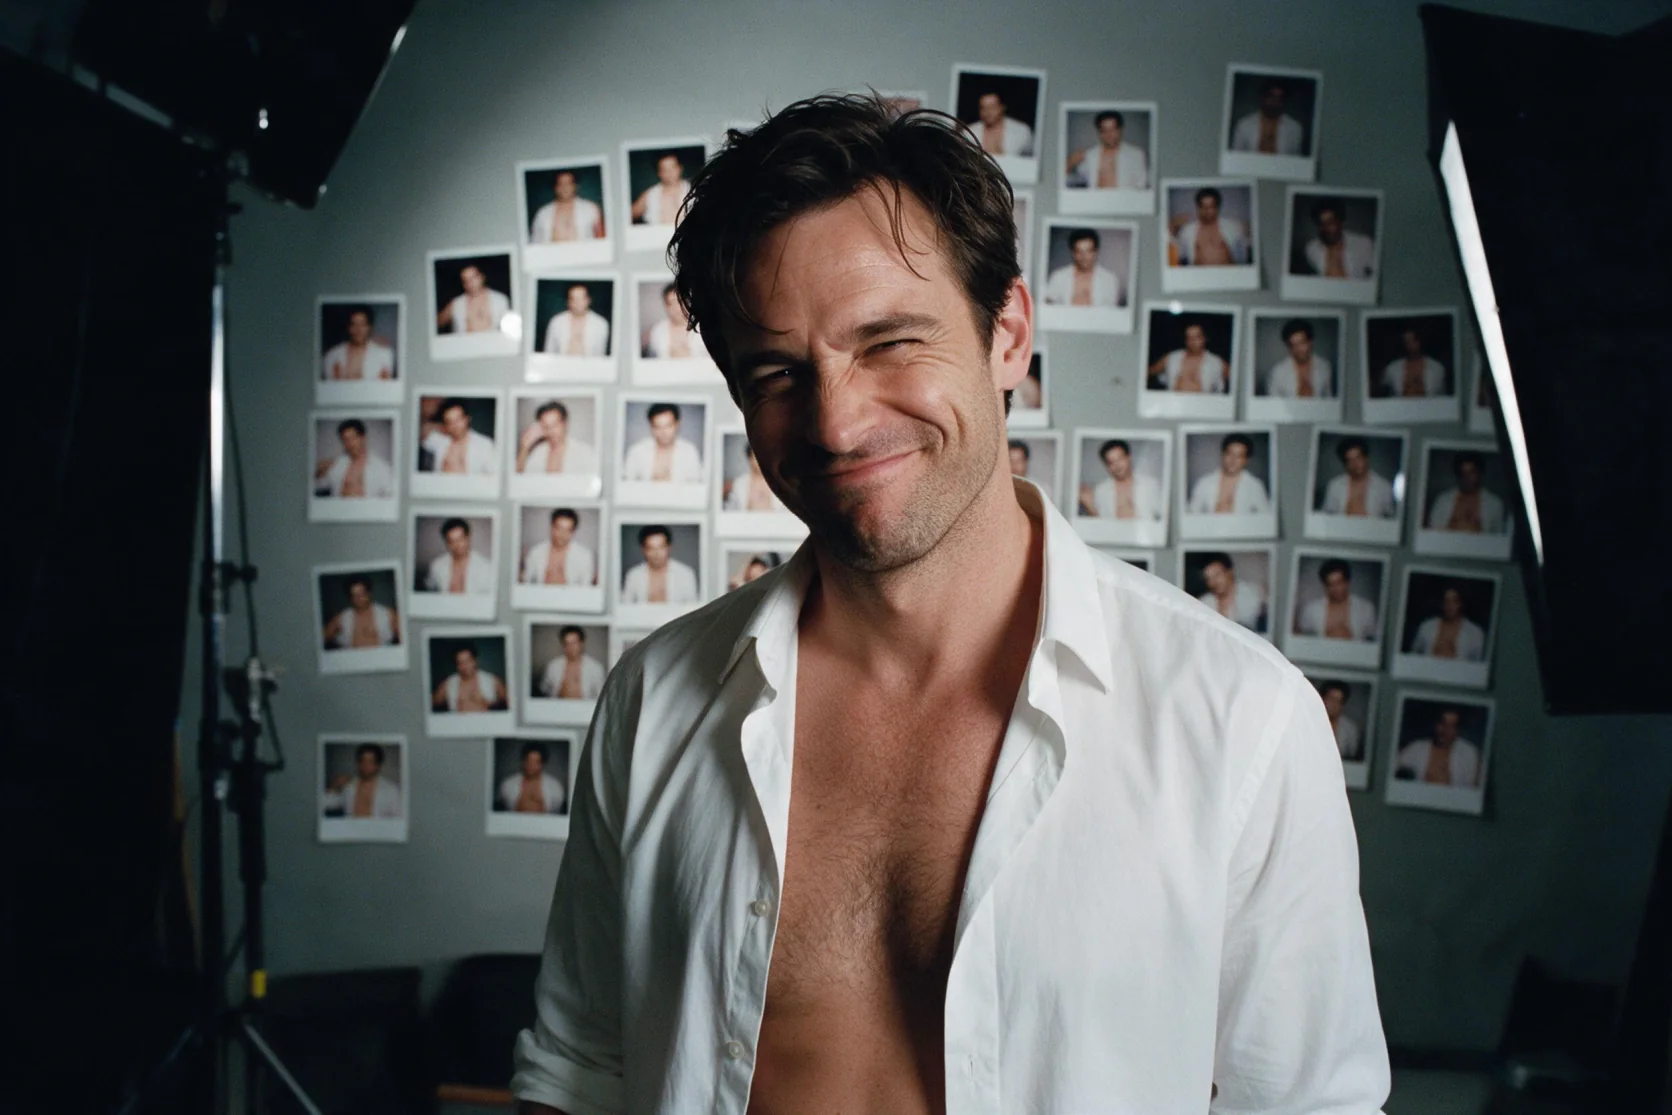
단일 사진의 의상·장소 편집은 테스트에서 얼굴을 유지했습니다. LoRA 적용은 별도로 비교해 인물과 주변에 미치는 영향을 판단합니다.
원본과 장면 참조 결합
두 사진 구도는 테스트에서 성공했습니다. 스타일 합성을 계획할 때 편집 원본을 장면 참조보다 앞에 놓고 지시에서 각 사진을 지정합니다.
프롬프트 가이드 및 실전 팁
생성 또는 편집으로 시작합니다
생성은 글로 적은 장면에서, 편집은 지원 참조보다 먼저 제공한 수정 원본에서 시작합니다. 편집 입력은 최대 9장입니다.
다운로드 가능한 LoRA를 연결합니다
path를 .safetensors 파일 자체로 지정하고 필요한 경우 Hugging Face /resolve/main/ 링크를 사용합니다. scale 1부터 시작합니다. 파일별 범위는 0~4이며 요청당 최대 3개입니다.
장면과 표현을 설명합니다
선택 LoRA 트리거 뒤에 의상, 행동, 빛, 주변의 자세한 영어 설명을 적습니다. 편집은 원본을 <Picture 1>로 지정하고 이후 참조에 번호를 부여합니다.
전체 구도를 비교하고 검토합니다
화면비, 해상도, 형식을 고르고 고정 seed로 LoRA 적용·미적용을 비교합니다. 스타일, 구도, 불필요한 글자를 확인합니다. seed는 동일 결과를 약속하지 않습니다.
가중치 표현을 연결해 정지 이미지 생성
MiniMax H3-Image Open Weights LoRA는 장면 설명과 LoRA 가중치 파일 최대 3개로 이미지를 만듭니다. 모텔·식당 예시의 VHS처럼 어댑터에서 원하는 외형을 가져오는 구상에 적합합니다. 결과는 정지 이미지이며 영상이나 사운드트랙은 만들지 않습니다.
테스트한 어댑터는 H3 영상 모델용으로 학습됐지만 이 이미지 체크포인트에도 영향을 줬습니다. 해당 파일의 근거이며 모든 H3 어댑터의 호환성을 약속하지는 않습니다. 알려진 파일과 의상·빛·주변을 살피기 쉬운 장면부터 시작합니다.
요청 제어 항목
| 파라미터 | 값과 동작 |
|---|---|
prompt | 필수, 최대 5,000자, 장면 앞에 어댑터 트리거 배치 |
loras | path, scale 항목 최대 3개, 직접 .safetensors 다운로드 URL |
loras[].scale | 파일별 0~4, 기본 1 |
aspect_ratio | 1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9, 기본 1:1 |
resolution | 기본 1k, 1.5k, 2k, 3k, 4k도 가능 |
output_format | 기본 jpeg, 또는 png, webp |
seed | 선택 비교 제어, 동일 결과 보장 없음 |
Hugging Face 링크는 /resolve/main/과 가중치 파일명으로 이어져야 합니다. 저장소 개요는 path에 필요한 다운로드 파일이 아닙니다. 트리거는 프롬프트에, URL과 강도는 LoRA 항목에 넣습니다. 트리거만 적는 것으로 연결되지는 않습니다.
표현을 적용할 장면 설명
대상, 행동, 의상, 장소, 빛을 연결된 영어 문단으로 작성합니다. VHS 구상에서는 vh5tape 트리거와 함께 30대 후반 여성, 빨간 슬립 드레스, 모텔 블라인드 옆의 춤과 웃음, 자홍색 네온과 따뜻한 침대 옆 조명, 1990년대 홈비디오 외형을 설명할 수 있습니다. 화면비와 해상도는 설명에 몰아넣지 말고 제어 항목으로 정합니다.
한 번에 한 조정 비교
- 설명, 캔버스, seed, 파일 링크를 함께 저장합니다.
- 파일 연결 요청과 연결을 제거한 비교 요청을 생성합니다.
- scale 변경 전 질감, 구도, 표정, 글자를 검토합니다.
- 전체 구상을 다시 쓰기보다 설정 하나를 조정합니다.
고정 seed는 변화를 분리하는 데 유용하지만 장면을 고정하지 않습니다. VHS 비교에서는 테이프 외형과 구도가 함께 바뀌었습니다. 여러 파일을 연결하면 각각이 독립적인 고정 레이어라고 가정하지 말고 결합 결과를 평가합니다.
샘플에서 확인한 점
새 모텔 샘플은 VHS 파일 scale 1, vh5tape, seed 11, 1k, 16:9로 모텔 방에서 빨간 슬립 드레스 차림으로 춤추는 여성과 화면 전체의 부드러운 캠코더 표현을 반환했습니다. 아케이드는 같은 표현을 다른 장소에서 살펴보는 샘플입니다.
식당 결과는 모서리에 vh5tape가 나타나는 흔적도 드러냈습니다. 어댑터는 학습 자료의 단어나 워터마크를 가져올 수 있습니다. 결과 선택 전 가장자리와 배경 간판을 확인합니다. H3-Image 테스트에서 짧은 간판과 라벨은 읽혔지만 긴 글이나 모든 어댑터의 글자를 보장하지 않습니다.
요금과 실패 요청
완료 이미지당 과금합니다. 큰 해상도일수록 기본 요금이 높으며 이 LoRA 버전은 Open Weights에 고정 요금을 더합니다. 연결 0개, 1개, 3개 모두 추가분이 같고 jpeg, png, webp에 따른 차이는 없습니다. 모델 페이지에서 현재 요금을 확인합니다.
누락 파일 테스트는 Failed to load LoRA로 중단됐으며 대체 이미지도 과금도 없었습니다. 실패 요청은 무료입니다. 다운로드 링크를 고친 뒤 다시 제출합니다.
한계와 관련 선택지
낯선 어댑터는 평가 대상으로 다룹니다. 관찰된 스타일 변화는 이후 장면의 동일 인물, 구도, 깨끗한 글자를 보장하지 않습니다. 콘텐츠 실행에는 거부가 없었지만 일부가 완화됐으며 표준 텍스트 생성 콘텐츠 테스트는 LoRA 없이 진행돼 어댑터 동작을 입증하지 못합니다.
연결 없이 5단계와 seed가 필요하면 Open Weights를 선택합니다. MiniMax H3-Image는 seed 없이 3단계와 편집 입력 최대 16장을 제공합니다. 기존 사진은 이 계열의 image-to-image를 사용합니다. 기존 H3 Image LoRA는 영상 모델로 단일 프레임을 만들지만 이 엔드포인트는 H3-Image 체크포인트를 씁니다. 별도 모델 P-H3-Image는 같은 프롬프트 비교에서도 사진이 일치하지 않았습니다.
API 빠른 시작
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "minimax/h3-image-open-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "resolution": "1k"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
인증, 전체 스키마, 폴링과 오류 처리는 API 레퍼런스에서 확인하세요.