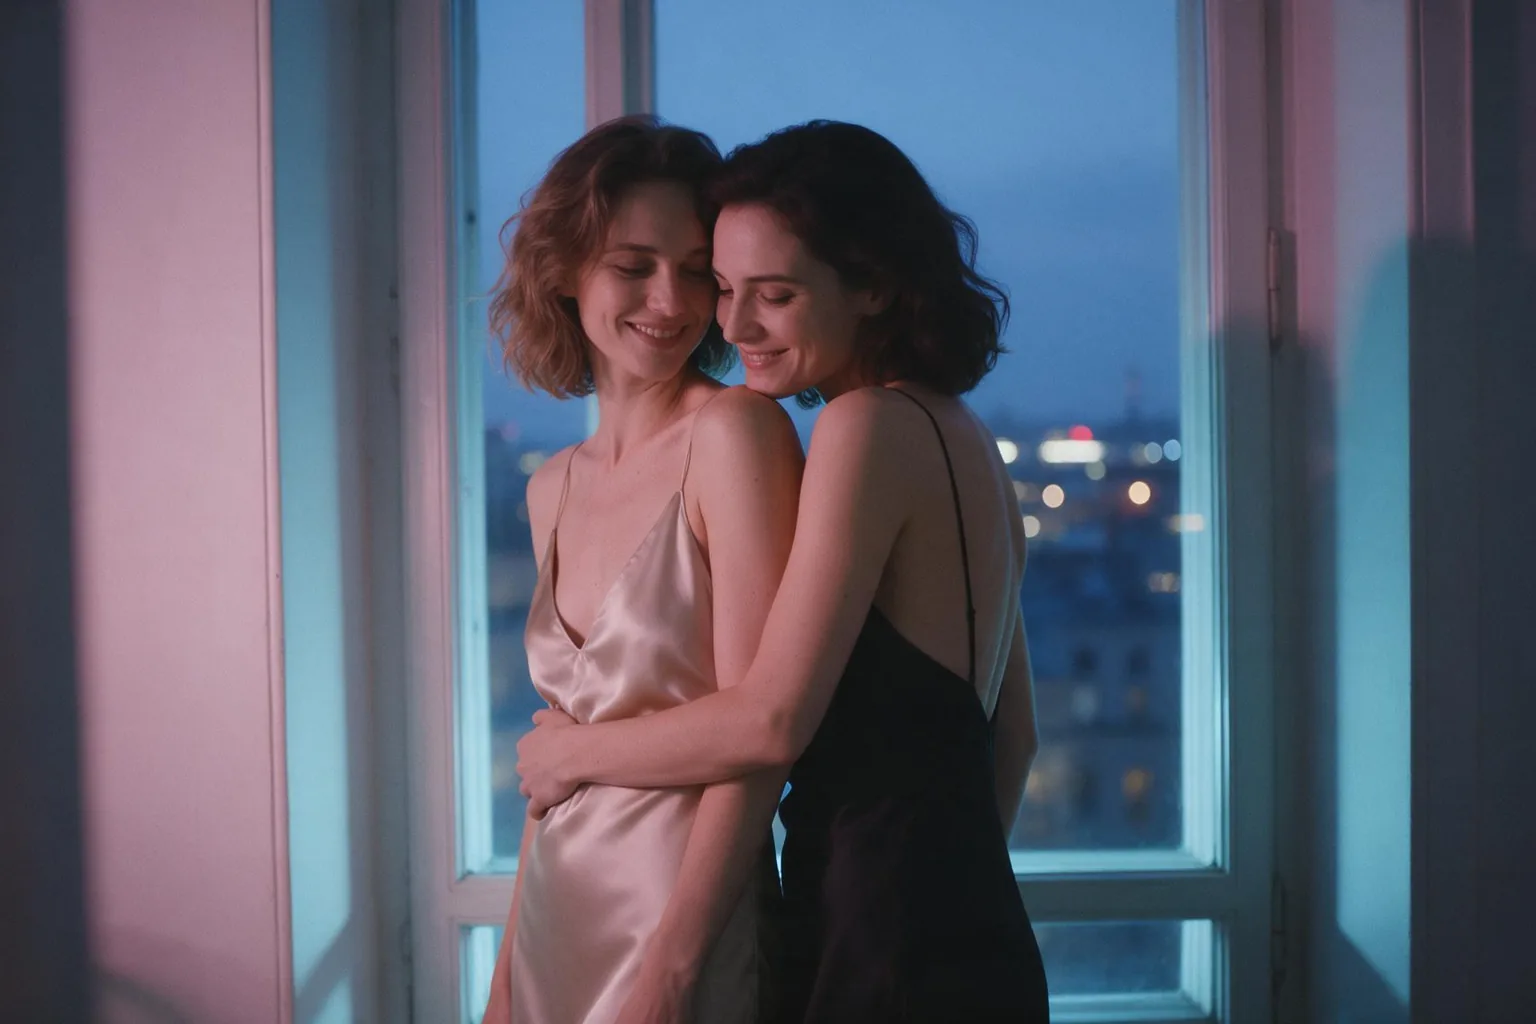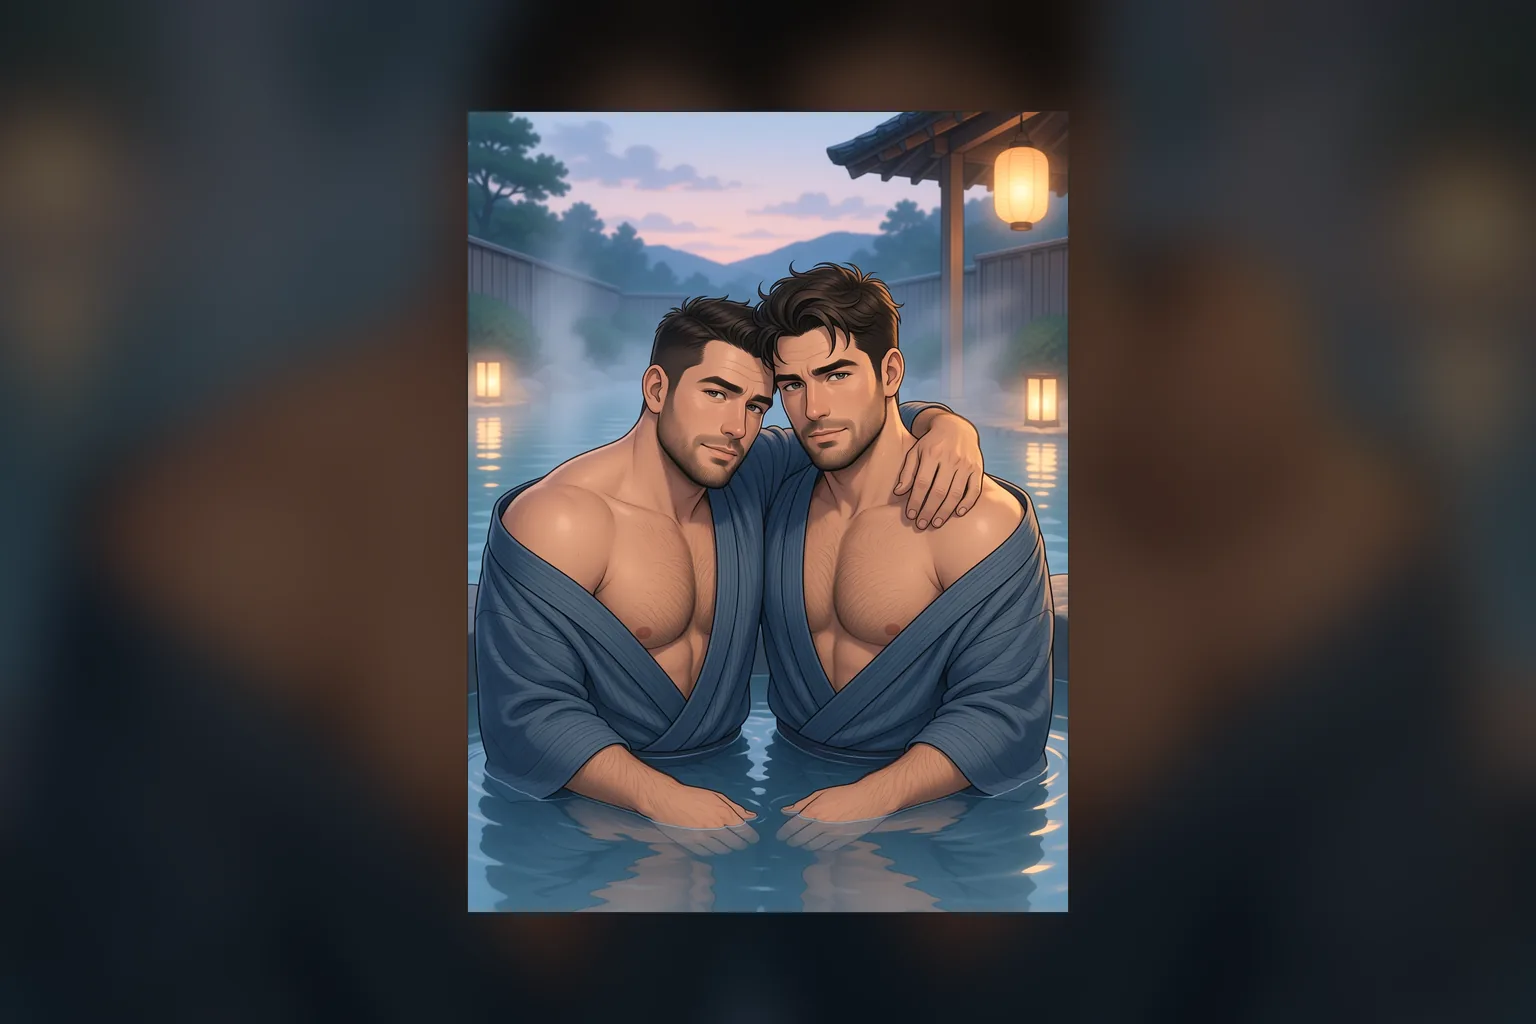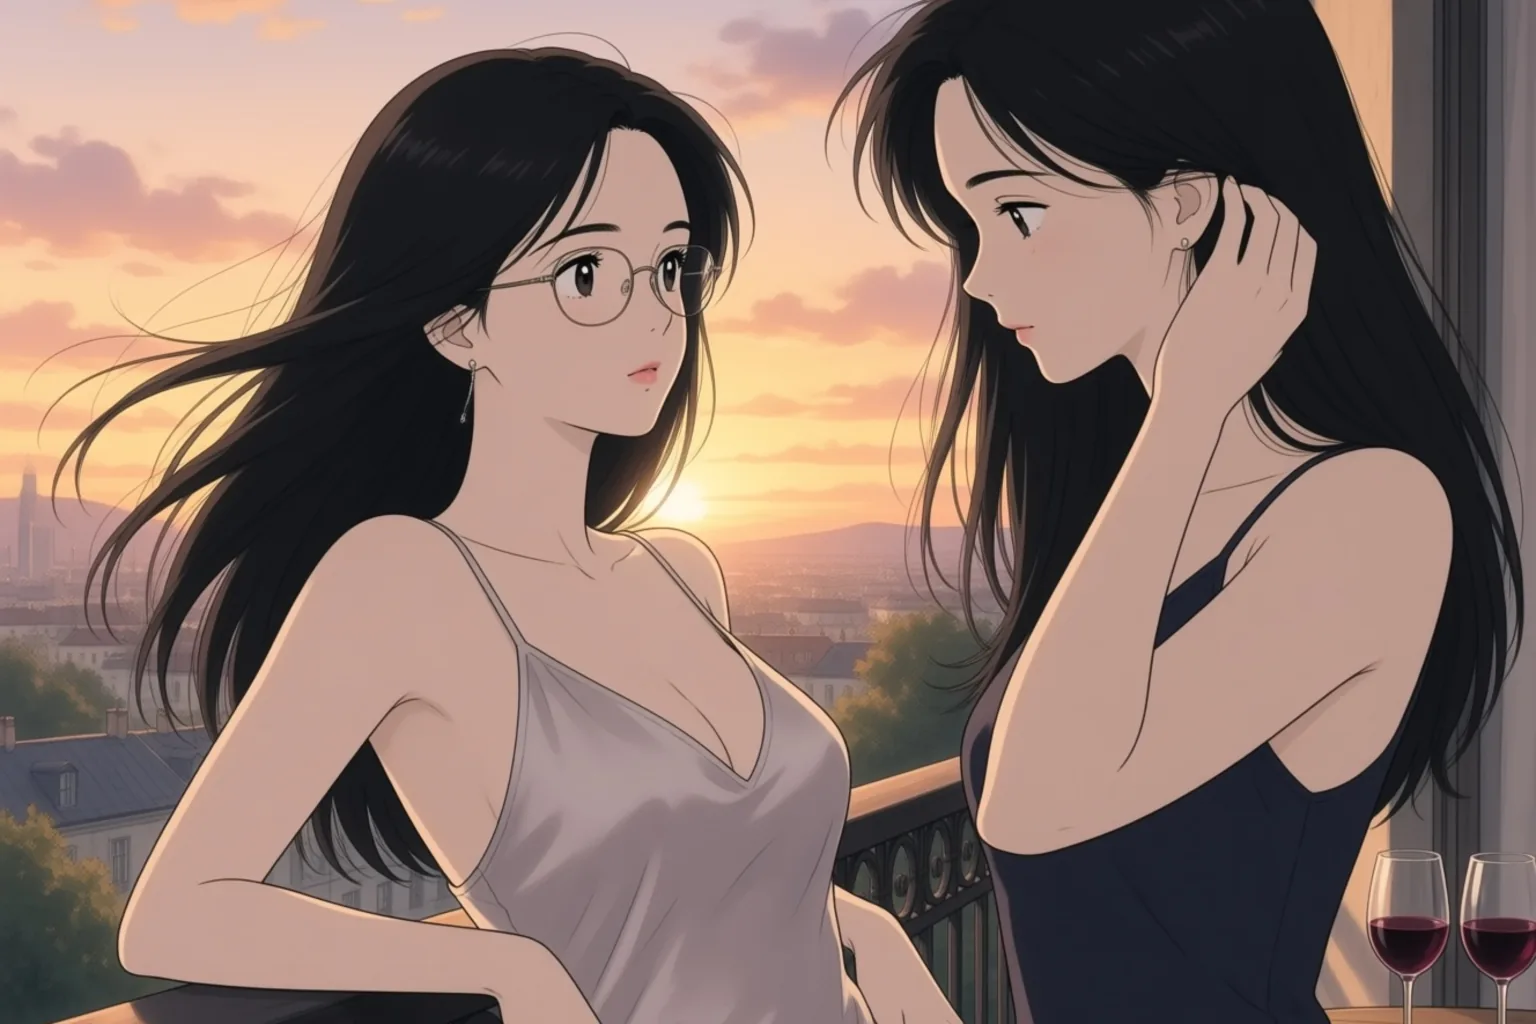
소개
Qwen Image 2512 LoRA 텍스트→이미지는 Alibaba가 2025년 12월에 공개한 200억 파라미터 오픈 모델 Qwen-Image-2512로 글로 쓴 프롬프트에서 이미지 한 장을 만들며, 직접 만든 LoRA 파일을 최대 3개까지 불러옵니다. 긴 변 최대 1536픽셀의 9가지 화면비 중 하나를 고르고, JPEG, PNG, WebP를 균일한 가격으로 받습니다. 플랫폼은 프롬프트, 가중치, 이미지 어디에도 콘텐츠 필터를 더하지 않습니다.
시작 자료에 따라 모드 선택하기
| 가진 자료 | 모드 |
|---|---|
| 글로 쓴 설명 | Qwen Image 2512 LoRA 텍스트→이미지 |
| 바꾸고 싶은 이미지 1~3장 | Qwen Image 2512 LoRA 이미지 편집 |
핵심 기능 및 하이라이트
LoRA 아래에 더 큰 기본 모델
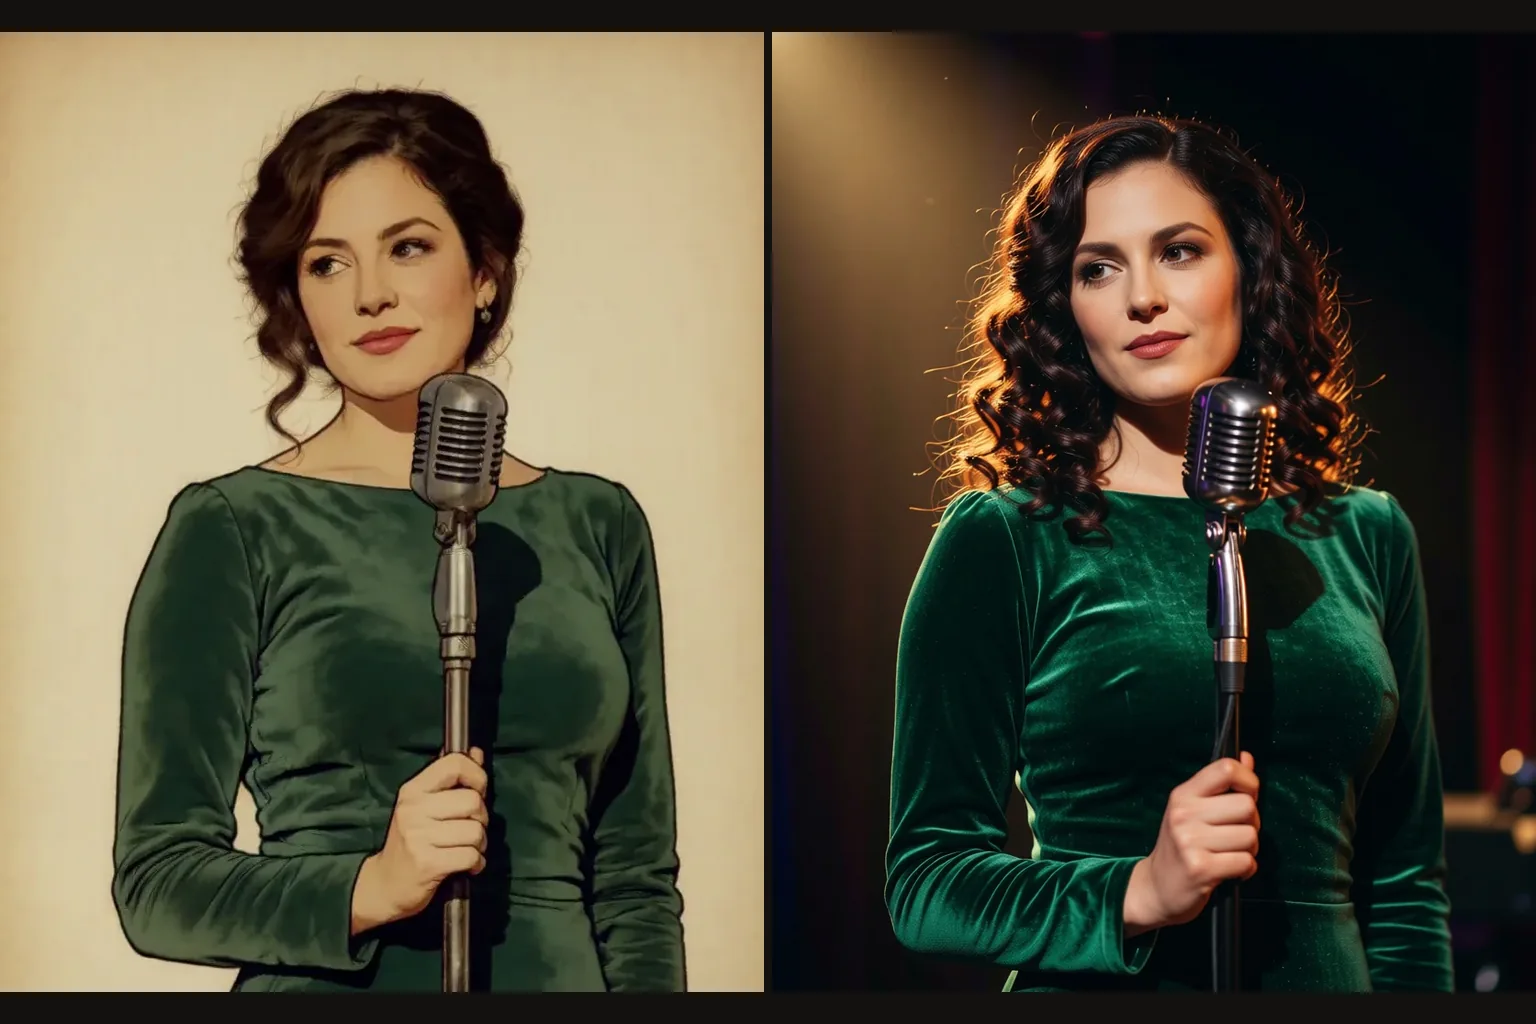
Alibaba는 Qwen-Image-2512를 인물이 더 사실적이고, 털과 풍경 같은 자연의 디테일이 더 섬세하며, 텍스트 렌더링이 나아진 릴리스로 소개합니다. 스타일 LoRA를 써도 그 디테일이 남아, 일러스트 룩에서도 얼굴, 손, 작은 소품이 흐트러지지 않습니다.
같은 가격에 더 큰 프레임
1:1은 1328 x 1328, 16:9는 1536 x 864로 나와 100만 화소를 넘고, 모든 비율의 가격이 같습니다.
커스텀 가중치에서도 무검열
필터 없는 LoRA를 불러오자 저희가 가장 강한 콘텐츠 점검 프롬프트도 적힌 그대로 나왔습니다. 가중치는 검토되지 않으며 출력도 결코 필터링되지 않습니다.
요청 파라미터
| 파라미터 | 필수 | 설명 |
|---|---|---|
prompt | 예 | LoRA의 트리거 문구를 맨 앞에 두고, 그다음 피사체, 배경, 빛을 묘사하십시오. Qwen-Image는 길고 자세한 프롬프트를 잘 따릅니다. 1자 이상 · 5000자 이하 |
aspect_ratio | 아니요 | 21:9부터 9:21까지 9가지입니다. 1:1은 1328 x 1328, 16:9는 1536 x 864이며, 모두 가격이 같습니다. |
loras | 아니요 | Qwen-Image-2512용으로 학습한 {path, scale} 항목을 최대 3개 넣습니다. scale은 0에서 4까지이며 1이 중립입니다. 기본값: |
output_format | 아니요 | 기본은 JPEG이며 필요하면 PNG나 WebP를 고릅니다. 가격에는 영향이 없습니다. |
seed | 아니요 | LoRA scale을 한 번에 하나씩 바꾸는 동안 이미지 세트를 비교할 수 있게 유지합니다. |
요금
$0.03 / 장
모든 화면비에서 이미지당 균일 요금으로 과금됩니다. LoRA를 불러와도 별도 요금은 없습니다.
활용 사례
일러스트 시리즈
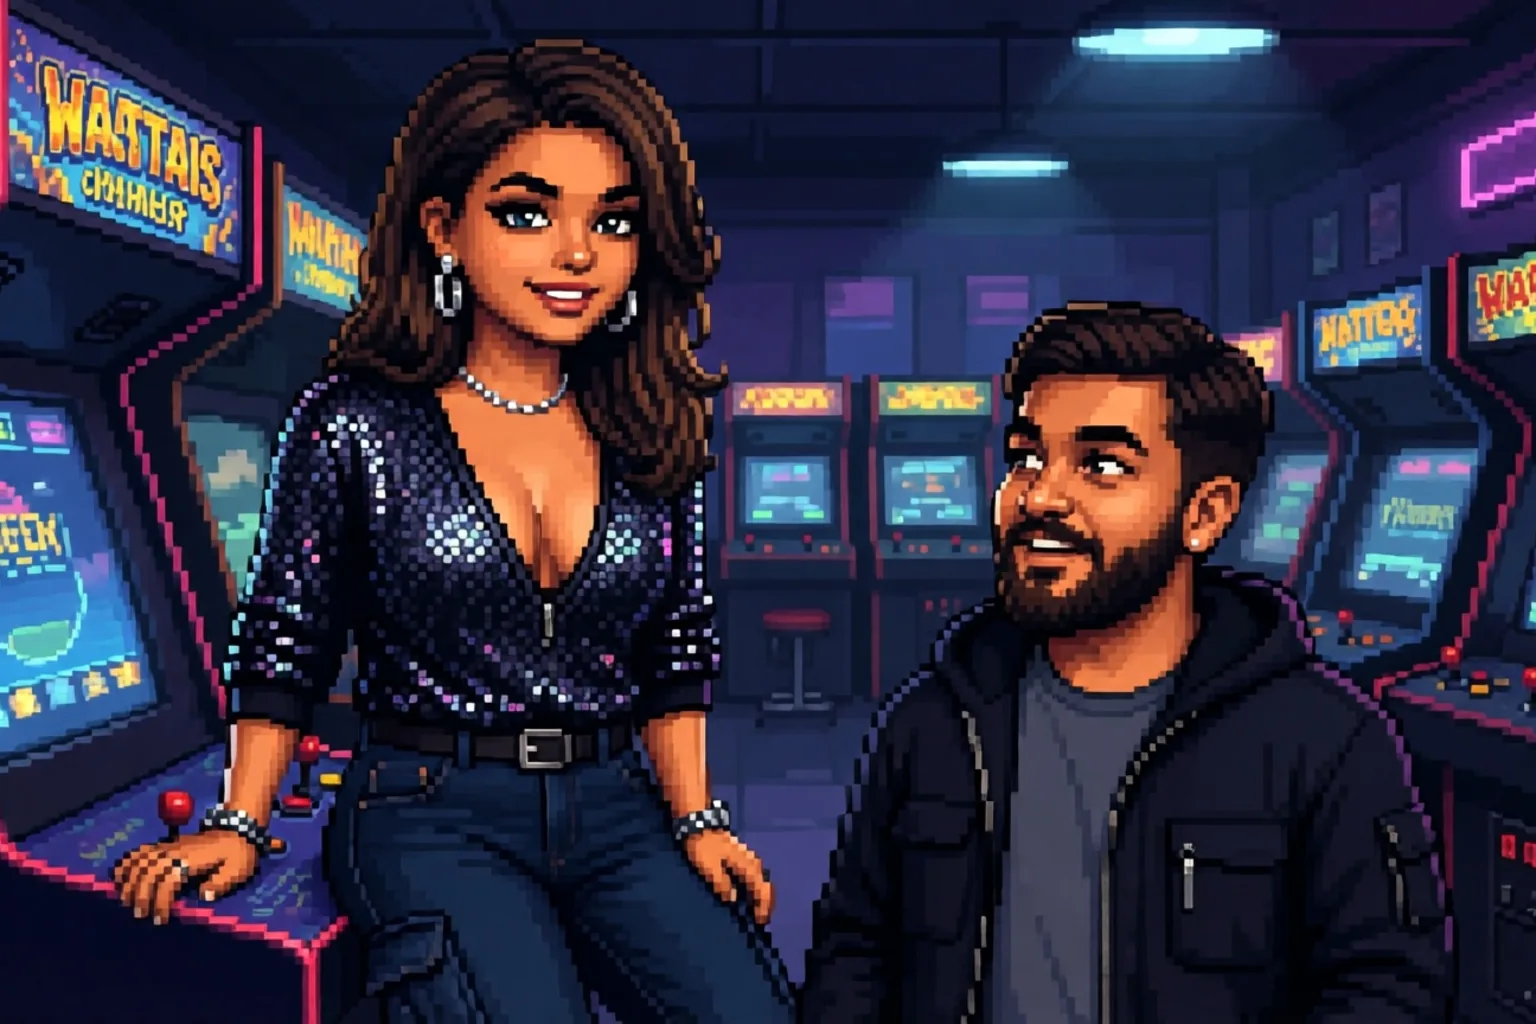
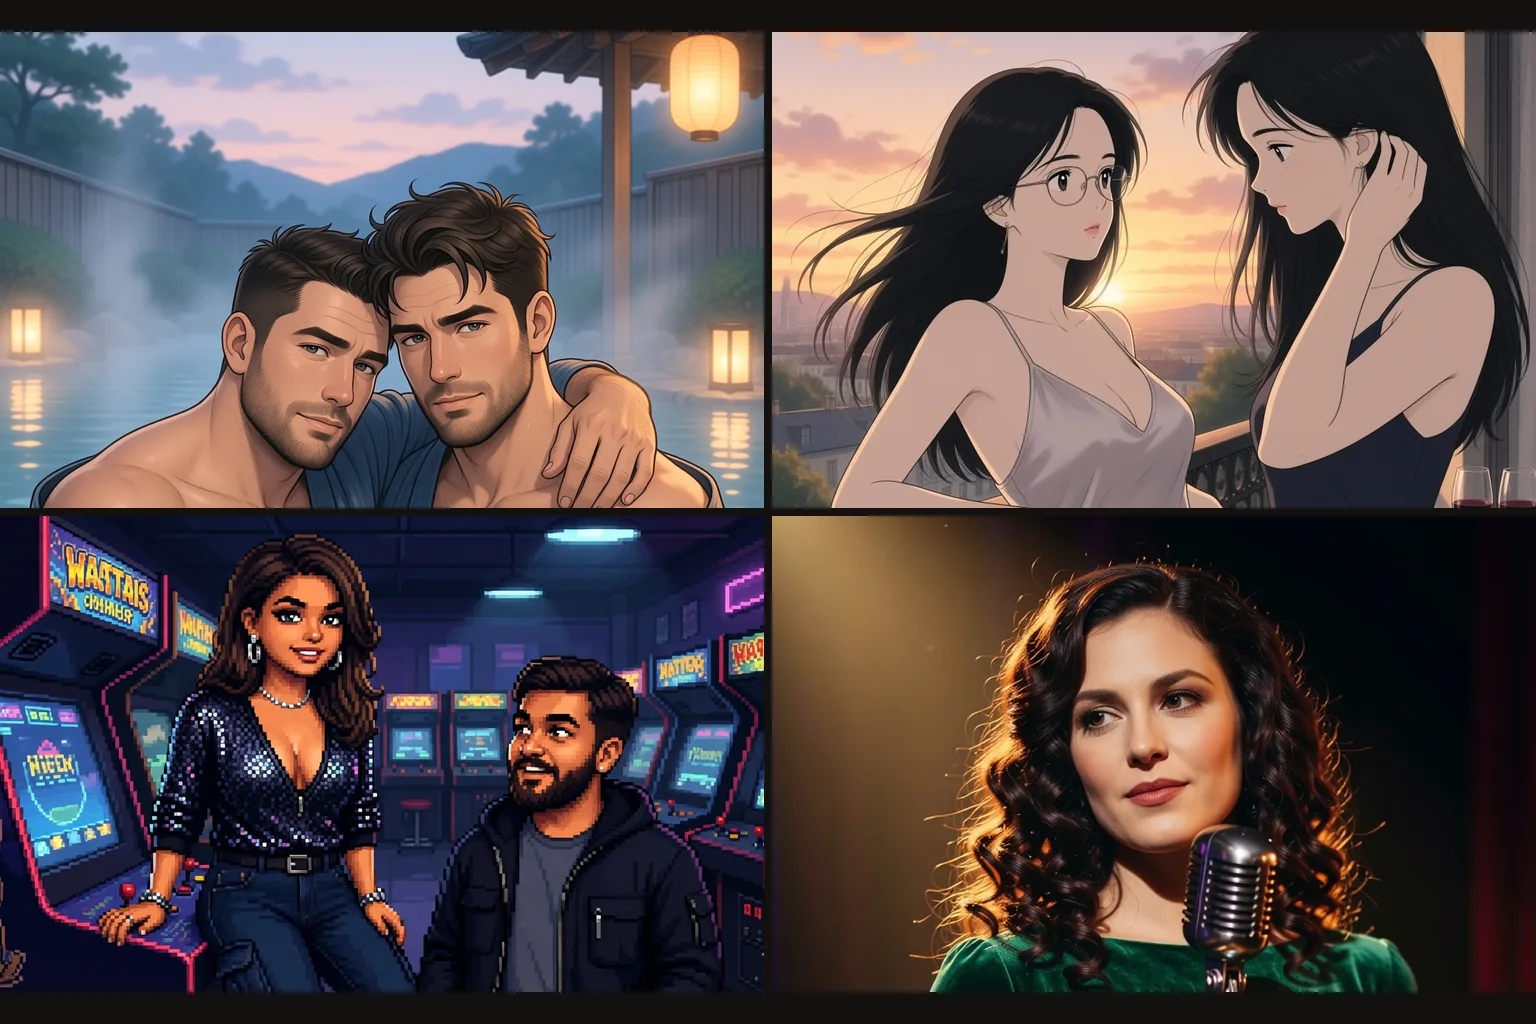
동화책, 수채화, 픽셀 아트 LoRA에 seed를 고정하면 표지, 컷, 썸네일의 일관된 세트가 나옵니다. 프레임이 커서 한 장을 여러 게재 위치에 맞게 잘라 낼 여유도 있습니다.
디테일이 살아 있는 캐릭터 아트
200억 파라미터 기본 모델 위의 캐릭터 LoRA는 스타일을 입힌 프레임에서도 얼굴과 손을 알아볼 수 있게 유지합니다. 같은 인물이 거듭 등장하는 캐릭터 시트와 비주얼 노벨에서는 이 점이 중요합니다.
플랫폼용 무검열 스틸
사용자가 기대하는 LoRA를 불러오고 이미지를 곧바로 글로 쓰십시오. 콘텐츠 플래그도, 결과에 대한 2차 심사도 없습니다.
프롬프트 가이드 및 실전 팁
LoRA가 학습한 트리거 쓰기
2512 LoRA 상당수는 "storybook anime illustration"이나 "Pixel Art" 같은 스타일 문구에 반응합니다. 모델 카드에서 그대로 복사해 프롬프트 맨 앞에 두십시오.
길고 구체적인 프롬프트 쓰기
Qwen-Image는 자세한 묘사를 잘 읽습니다. 피사체, 옷차림, 장소, 시간대, 빛, 색감을 완전한 문장으로 적으십시오. 짧은 키워드 목록은 기본 모델의 디테일을 낭비합니다.
불러오기 전에 기본 모델 확인하기
관련 없는 기본 모델용 LoRA는 오류 없이 불러와지지만 거의 효과가 없습니다. 첫 Qwen-Image 릴리스용으로 학습한 LoRA는 여기서도 그림을 바꾸는 경우가 많지만 결과는 예측하기 어렵습니다. 모델 카드에 기본 모델이 적혀 있으니, 요청을 쓰기 전에 Qwen-Image-2512인지 확인하십시오.
seed 하나로 scale 비교하기
seed를 고정하고 LoRA를 0.7, 1, 1.3으로 시험해 보십시오. 큰 기본 모델 위의 스타일 LoRA는 룩이 주도권을 잡기 전에 강도가 조금 더 필요할 때가 있습니다.
API 빠른 시작
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "alibaba/qwen-image-2512-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
인증, 전체 스키마, 폴링과 오류 처리는 API 레퍼런스에서 확인하세요.